
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
De DeepSeek-R1-0528 is de nieuwste iteratie van het DeepSeek R1-model, met verbeterde redeneer- en inferentiemogelijkheden. Het is vergelijkbaar met toonaangevende modellen zoals o3 en Gemini 2.5 Pro, waardoor het het beste open-source redeneermodel ter wereld is.
In deze tutorial gaan we het DeepSeek-R1-0528-Qwen3-8B-model fine-tunen op een Medical Reasoning Multiple Choice Question-(MCQ) dataset. Het fine-tuneproces introduceert een nieuwe redeneerstijl en antwoordgeneratie in de vorm van A-, B-, C-, D-opties.
Het mooiste? Dit kan op een consumentengpu zoals de RTX 4090, zodat je het model lokaal zonder problemen kunt fine-tunen. Bekijk onze volledige gids over DeepSeek-R1 en onze fine-tuninggids om meer te leren.
 Afbeelding door de auteur
We zetten een RunPod-instance op met een RTX 4090-gpu en het PyTorch 2.4.0-image.
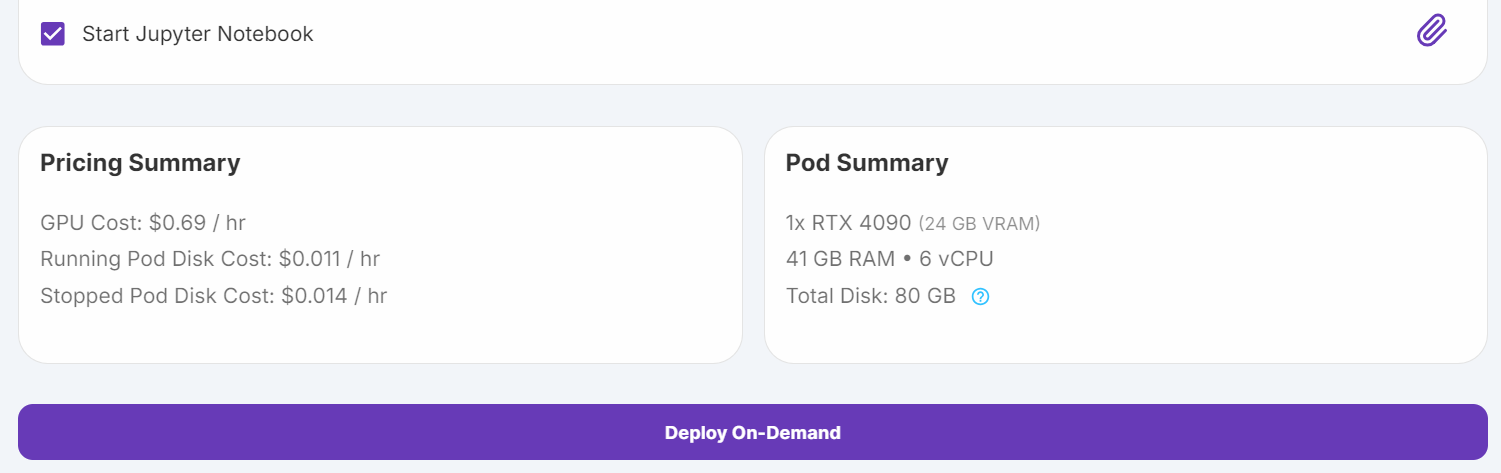
Bron: My Pods
Ga naar de sectie "My Pods" in de RunPod-console. Bewerk de podconfiguratie:
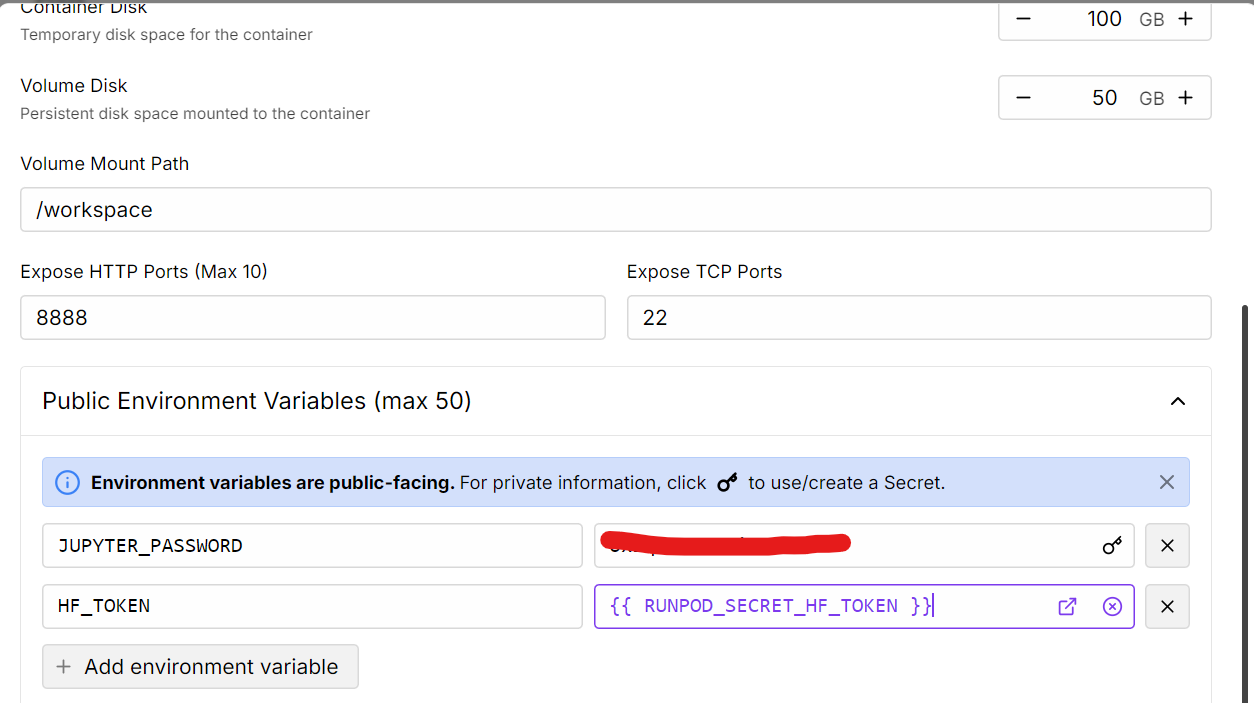
Bron: My Pods
Zodra de pod draait, installeer je de benodigde Python-packages.
Let op: de nieuwste versie van de Transformers-bibliotheek heeft enkele bekende issues, dus we installeren in plaats daarvan een oudere, stabiele versie.
%%capture
%pip install -U transformers==4.52.1
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
Om modellen te laden of updates naar de Hugging Face Hub te pushen, log je in op de Hugging Face CLI met je API-sleutel
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Hoewel we 24 GB VRAM hebben, wat voldoende is om het volledige model te laden, gebruiken we 4-bit kwantisatie om meer geheugen vrij te houden voor fine-tunen en stabiliteit te waarborgen. Deze aanpak laat ons VRAM-gebruik optimaliseren met behoud van performance.
We downloaden en laden het DeepSeek-R1-0528-Qwen3-8B-model en de tokenizer van de Hugging Face Hub. Je kunt meer leren over werken met Hugging Face en een gids voor de Hub in onze cursus.
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load tokenizer & model

model_dir = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)

model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    quantization_config=bnb_config,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True
)

model.config.use_cache = False
model.config.pretraining_tp = 1
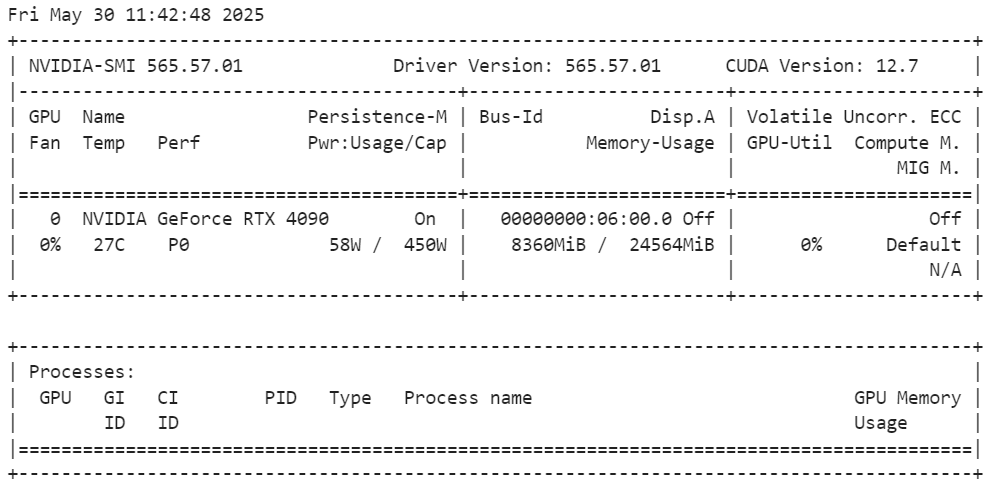
Om het VRAM-gebruik te controleren na het laden van het model, voer je de volgende opdracht uit:
!nvidia-smiHet VRAM-gebruik is ongeveer 8,3 GB, waardoor twee derde van het geheugen beschikbaar blijft voor fine-tunen.
In deze stap bereiden we de trainingprompts voor door een template te maken met placeholders voor de vraag en het antwoord. We definiëren ook een Python-functie om de dataset te formatteren volgens de promptstijl en maken een nieuwe kolom “text”.
train_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
{}

### Response:
{}"""


EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["input"]
    outputs = examples["output"]
    texts = []
    for question, response in zip(inputs, outputs):
        # Remove the "Q:" prefix from the question
        question = question.replace("Q:", "")

        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token

        text = train_prompt_style.format(question, response)
        texts.append(text)
    return {"text": texts}
Vervolgens laden we mamachang/medical-reasoning, passen we de functie formatting_prompts_func toe en tonen we de “text”-kolom van het 11e sample.
from datasets import load_dataset

dataset = load_dataset(
    "mamachang/medical-reasoning",
    split="train",
    trust_remote_code=True,
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
print(dataset["text"][10])
De tekstkolom bevat de systeemprompt, vraag, redenering en antwoord in het volgende formaat:
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood. A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease. A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance. When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity. Which of the following additional analyses would most likely address the concerns about this study's design??
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},

### Response:
<analysis>

This is a question about assessing the validity of a prospective cohort study. The study found an association between childhood diet and cardiovascular disease in adulthood. The peer reviewer is concerned that the researchers did not discuss the validity of the study design.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors that could influence the results. The additional analysis suggested should help control for confounding.Voordat we het model fine-tunen, testen we de basisprestaties om een nulmeting te hebben voor vergelijking. Dit houdt in dat we een inferenceprompt maken, een voorbeeldvraag uit de dataset kiezen en een antwoord genereren met het basismodel.
We maken een prompttemplate voor inference met een placeholder voor de vraag.
inference_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
{}

### Response:
<analysis>
"""
Daarna selecteren we de vraag uit het 11e sample en geven die aan het model door na formattering en omzetting naar tokens.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
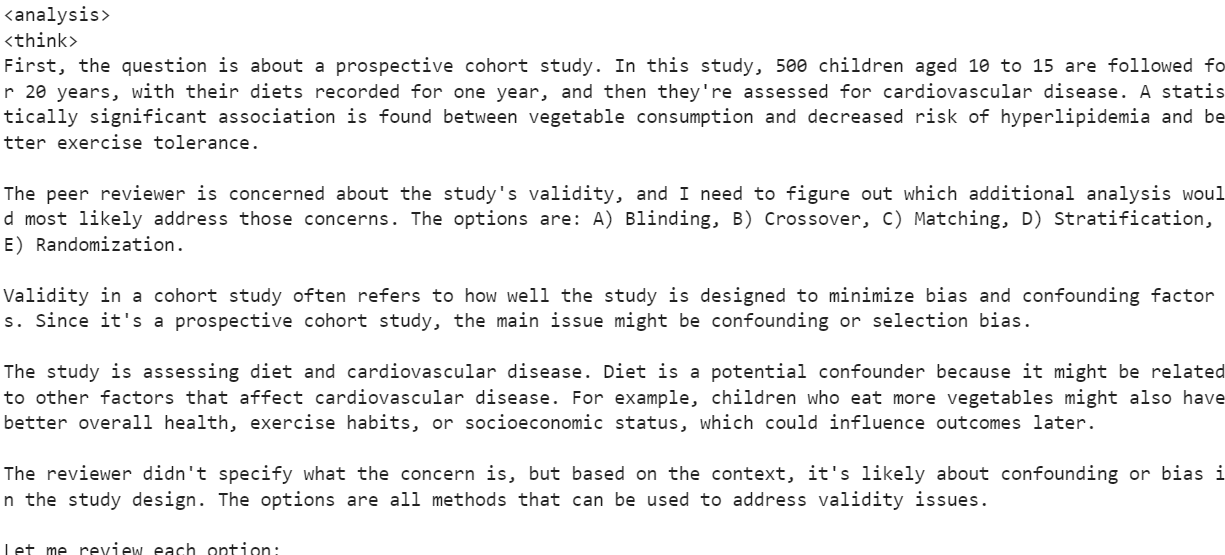
De reactie van het model was onbevredigend. De analyse-sectie was buitensporig lang, waardoor de tokenlimiet werd opgebruikt, en de antwoordsectie werd niet gegenereerd door de lange redenering.
In deze stap richten we het model en de tokenizer in voor fine-tunen.
1. De SFTTrainer accepteert niet direct een tokenizer. In plaats daarvan zetten we de tokenizer om in een data-collator met de DataCollatorForLanguageModeling-klasse uit de transformers-bibliotheek.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)
We gebruiken LoRA (Low-Rank Adaptation) om het model te fine-tunen. LoRA past slechts een klein deel van de modelparameters aan, waardoor het zeer geheugenefficiënt en sneller is dan volledig fine-tunen.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
De TrainingArguments stellen ons in staat het fine-tuneproces te configureren en de SFTTrainer vereenvoudigt het proces door model, dataset, data-collator, trainingargumenten en LoRA-configuratie in één workflow te integreren.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Voordat je met trainen begint, is het belangrijk om de cache te legen en ongewenste geheugen- en VRAM-sporen te verwijderen om Out of Memory (OOM)-fouten te voorkomen.
Zodra het geheugen is opgeschoond, kunnen we het trainingproces starten met de SFTTrainer.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
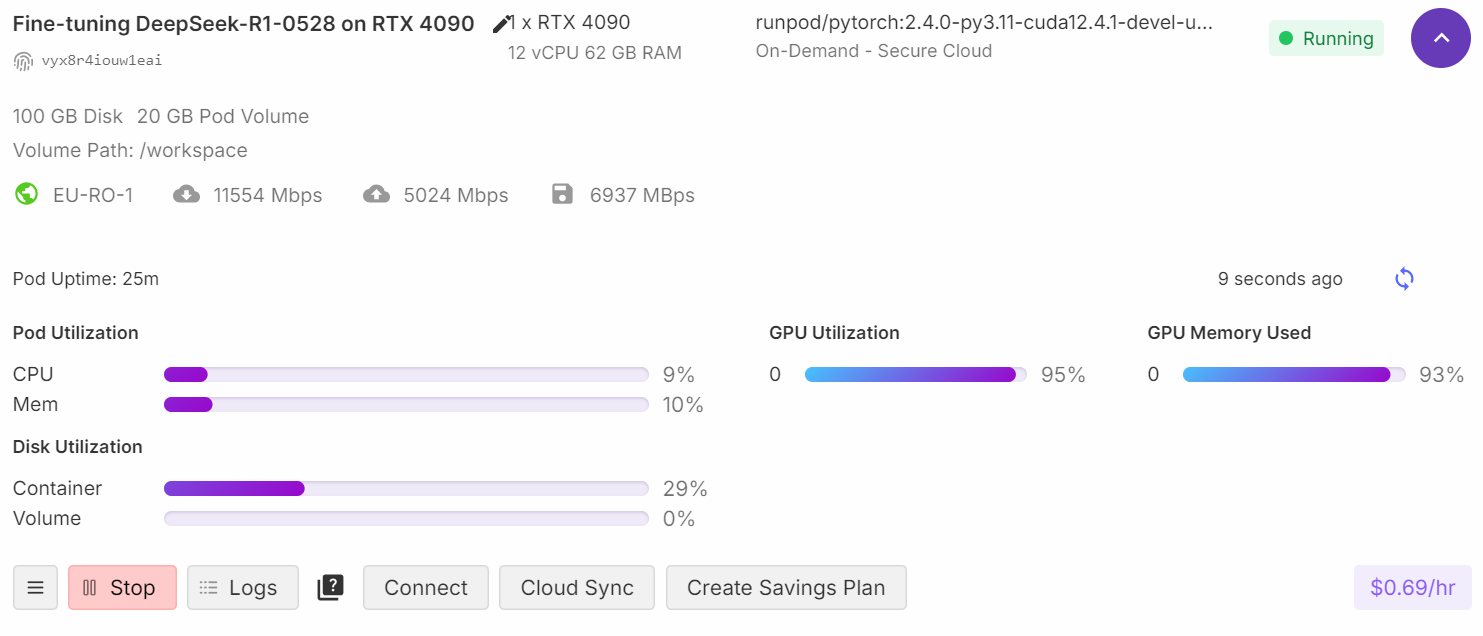
Tijdens het trainen kun je de gpu monitoren via je RunPod-dashboard. Je zou moeten zien dat de gpu-belasting dicht bij 100% ligt, wat aangeeft dat het model op de gpu traint (en niet op de cpu).
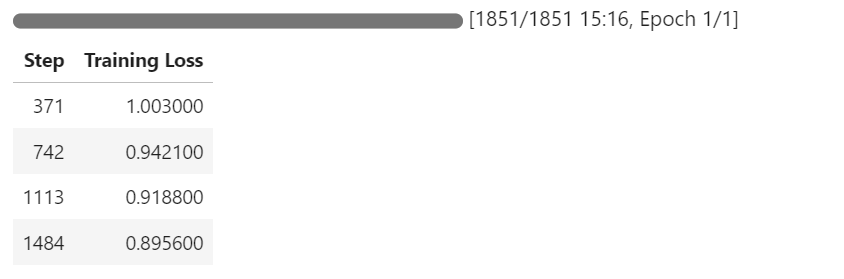
Naarmate de training vordert, zou je moeten merken dat de training loss geleidelijk afneemt. Dat duidt erop dat het model leert en dat het fine-tunen slaagt.
Na het fine-tunen testen we de prestaties door dezelfde 11e voorbeeldvraag uit de dataset te gebruiken. Zo kunnen we de resultaten vergelijken met het basismodel en de verbeteringen door het fine-tunen beoordelen.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question,) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
De reactie van het gefinetunede model laat duidelijke verbeteringen zien:
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer raised concerns about the study's validity, likely because it was an observational study without randomization or control group.

The question asks which additional analysis would most likely address the concerns about the study's design. The choices include blinding, crossover, matching, stratification, and randomization.

Randomization is the key to reducing bias in observational studies. By randomly assigning participants to different groups, you can control for confounding factors. The other choices do not directly address the lack of randomization in the original study design.
</analysis>
<answer>
E: Randomization
</answer>
Om het gefinetunede model verder te evalueren, testen we het op een ander sample uit de dataset en bekijken we de resultaten.
question = dataset[100]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Het gefinetunede model presteert uitstekend op dit sample:
<analysis>

This is a clinical vignette describing a 55-year-old man with burning and shooting pain in his feet and lower legs that worsens at night. He has a history of type 2 diabetes mellitus and hypertension. The description of the pain being burning and shooting in a symmetric distribution in the lower extremities, worsening at night, along with his history of diabetes, is most consistent with distal symmetric sensorimotor polyneuropathy. Autonomic neuropathy would not cause sensory symptoms. Isolated cranial nerve or peripheral nerve neuropathy would not explain the symmetric distribution. Radiculopathy would not explain the sensory symptoms.
</analysis>
<answer>
D: Distal symmetric sensorimotor polyneuropathy
</answer>De volgende stap is het gefinetunede model op te slaan en naar de Hugging Face Hub te pushen. Zo kunnen anderen het model gebruiken voor inference of verder fine-tunen.
new_model_name = "DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"
trainer.model.push_to_hub(new_model_name)
trainer.processing_class.push_to_hub(new_model_name)
Zodra het model succesvol is gepusht, is het beschikbaar op de Hugging Face Hub: kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning.
Na het opslaan van het gefinetunede model en de adapter op de Hugging Face Hub, testen we of het model naar verwachting presteert door het opnieuw te laden. Dit houdt in: gpu-geheugen opschonen, het basismodel en de LoRA-adapter laden en inference draaien op een voorbeeldprompt.
1. Maak het gpu-geheugen leeg om mogelijke Out of Memory (OOM)-problemen te voorkomen. Dit zorgt voor een schone omgeving om het model te laden.
del model
del trainer
torch.cuda.empty_cache()
2. laad het basismodel en de gefinetunede LoRA-adapter van de Hugging Face Hub. Het basismodel wordt in 4-bit kwantisatie geladen om geheugen te besparen, en de LoRA-adapter wordt ermee samengevoegd.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from peft import PeftModel
import torch

# Base model
base_model_id = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

# Your fine-tuned LoRA adapter repository
lora_adapter_id = "kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"

# Load the model in 4-bit
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config,
    trust_remote_code=True,
)

# Attach the LoRA adapter
model = PeftModel.from_pretrained(
    base_model,
    lora_adapter_id,
    device_map="auto",
    trust_remote_code=True,
)

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model_id, trust_remote_code=True)
3. We testen het gefinetunede model door een voorbeeldprompt aan te bieden. De prompt wordt getokenized, door het model gehaald en de reactie wordt gedecodeerd.
# Inference example
prompt = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood.
A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease.
A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance.
When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity.
Which of the following additional analyses would most likely address the concerns about this study's design?
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},
### Response:
<analysis>

"""

inputs = tokenizer(
    [prompt + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Het gefinetunede model produceert een reactie die lijkt op de dataset, wat bevestigt dat het model en de adapter correct zijn geladen.
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer was concerned about the study's validity.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors. The choices given are different statistical methods that can help control for confounding.

Blinding and crossover designs are not applicable to a prospective cohort study. Matching and stratification can help control for confounding by balancing the distribution of confounders between groups. Randomization is the best way to minimize confounding by randomly assigning participants to different exposure groups.
</analysis>
<answer>
E: Randomization
</answer>
Als je problemen tegenkomt bij het uitvoeren van bovenstaande code, raadpleeg dan het notebook fine-tuning-Deepseek-new-R1.ipynb. Dit notebook is meerdere keren getest en zou out-of-the-box moeten werken in RunPod of een vergelijkbare omgeving.
Het DeepSeek-R1-0528-model is een van de beste open-source redeneermodellen die vandaag beschikbaar zijn. De mogelijkheid om complexe redeneertaken uit te voeren, gecombineerd met het open-source karakter, maakt het een uitstekende keuze voor ontwikkelaars en onderzoekers. Hoewel het gefinetunede model al indrukwekkende resultaten levert, zijn er verschillende manieren om de fine-tuning verder te verbeteren:
Bovendien kun je deze gids gebruiken om het DeepSeek R1-model te fine-tunen op elke redeneerdataset, waaronder synthetische datasets die met andere modellen zoals OpenAI's o3 zijn gemaakt. Je kunt ook praktisch aan de slag met enkele technieken die hier zijn getoond in onze Fine-Tuning With Llama 3-cursus. Als je geïnteresseerd bent in het fine-tunen van andere modellen met medische datasets, bekijk dan onze tutorial Fine-tunen van MedGemma op een Brain MRI-dataset.
Topcursussen op DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


