
Corso
Fine-tuning con Llama 3
2 ore
4.1K
DeepSeek-R1-0528 è l’ultima iterazione del modello DeepSeek R1, con capacità migliorate di ragionamento e inferenza. È alla pari con modelli di punta come o3 e Gemini 2.5 Pro, il che lo rende il miglior modello open-source per il reasoning al mondo.
In questo tutorial effettueremo il fine-tuning del modello DeepSeek-R1-0528-Qwen3-8B su un dataset di domande a scelta multipla (MCQ) per il reasoning clinico. Il processo di fine-tuning introduce un nuovo stile di ragionamento e di generazione della risposta sotto forma di opzioni A, B, C, D.
La parte migliore? Puoi farlo con una GPU consumer come la RTX 4090, così da eseguire il fine-tuning in locale senza problemi. Puoi consultare la nostra guida completa su DeepSeek-R1 e la nostra guida al fine-tuning per saperne di più.
 Immagine dell’autore
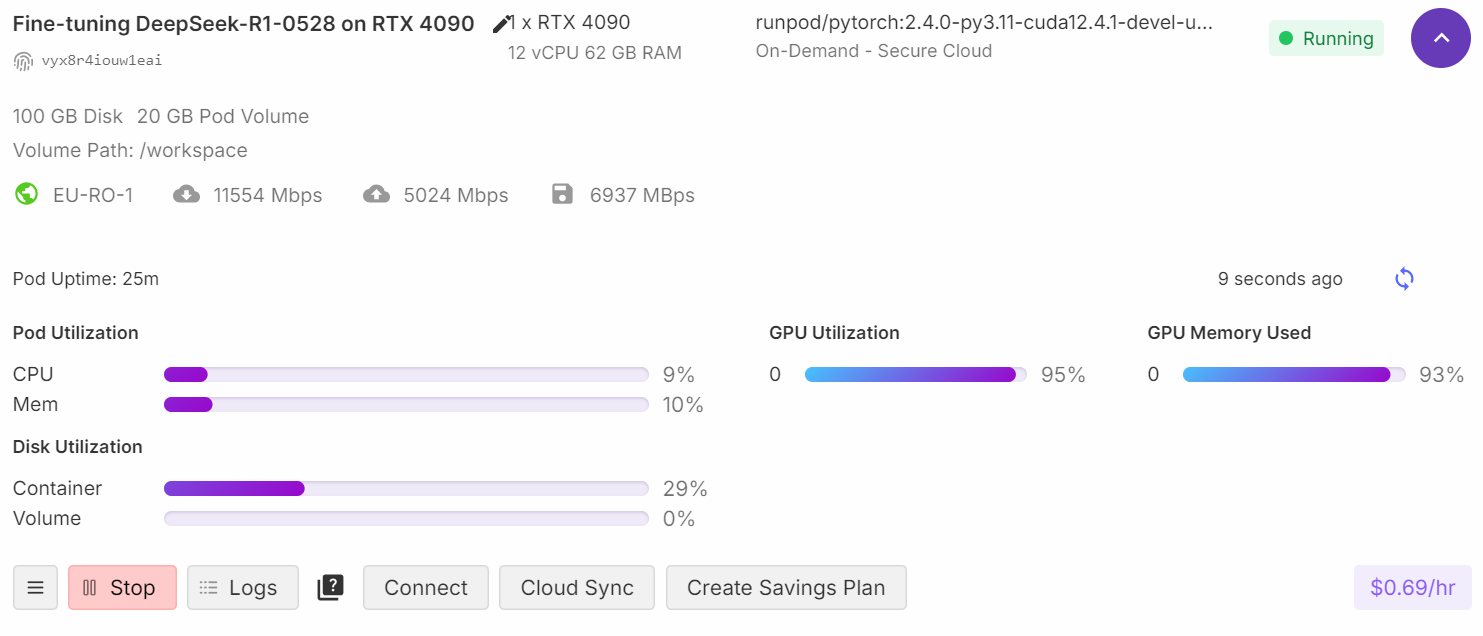
Imposteremo un’istanza RunPod con una GPU RTX 4090 e l’immagine PyTorch 2.4.0.
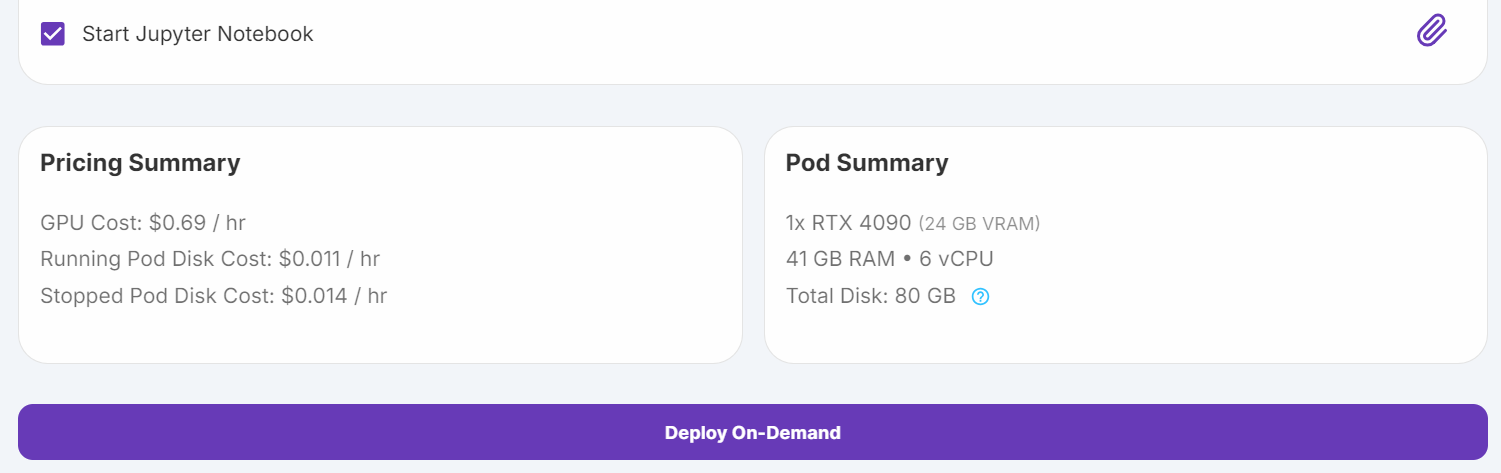
Fonte: My Pods
Vai alla sezione "My Pods" nella console RunPod. Modifica la configurazione del pod:
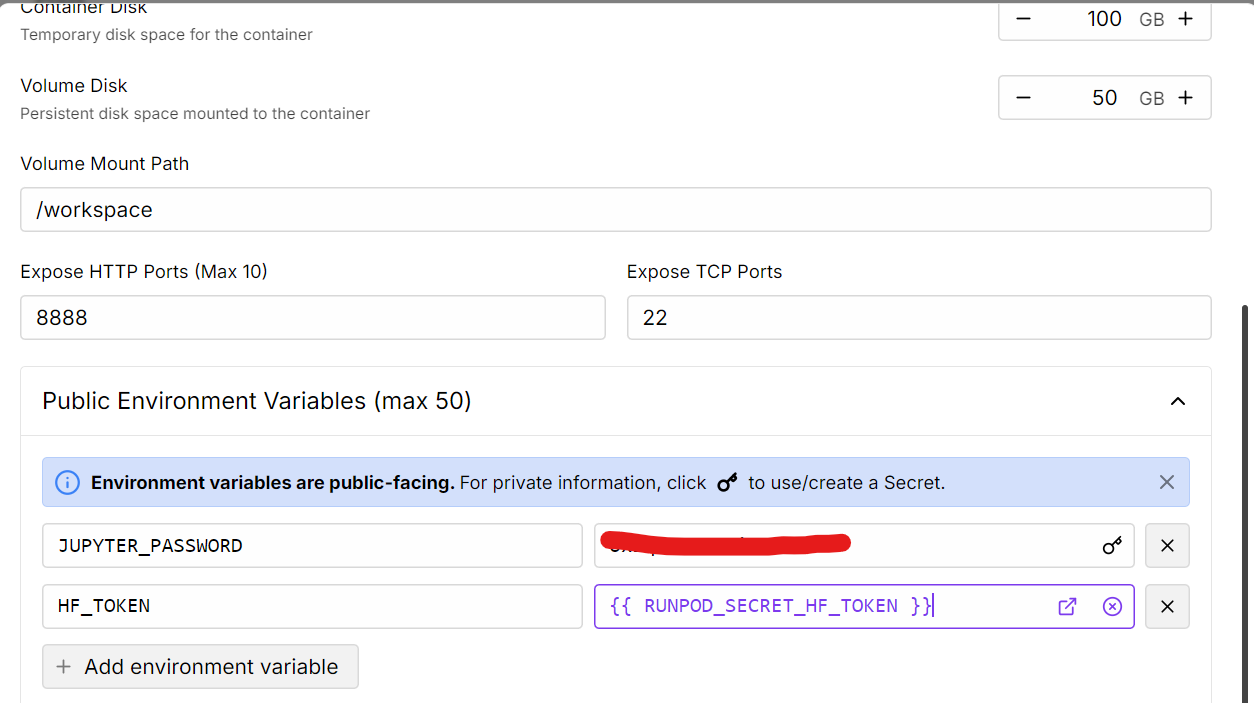
Fonte: My Pods
Una volta avviato il pod, installa i pacchetti Python necessari.
Nota: l’ultima versione della libreria Transformers presenta alcuni problemi noti, quindi installeremo una versione precedente stabile.
%%capture
%pip install -U transformers==4.52.1
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
Per caricare modelli o inviare aggiornamenti all’Hugging Face Hub, accedi alla CLI di Hugging Face usando la tua chiave API
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Anche se abbiamo 24 GB di VRAM, sufficienti per caricare il modello completo, useremo la quantizzazione a 4 bit per lasciare più memoria disponibile al fine-tuning e garantire stabilità. Questo approccio ci permette di ottimizzare l’uso della VRAM mantenendo le prestazioni.
Scaricheremo e caricheremo il modello e il tokenizer DeepSeek-R1-0528-Qwen3-8B dall’Hugging Face Hub. Puoi saperne di più su come lavorare con Hugging Face e una guida all’Hub con il nostro corso.
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load tokenizer & model

model_dir = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)

model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    quantization_config=bnb_config,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True
)

model.config.use_cache = False
model.config.pretraining_tp = 1
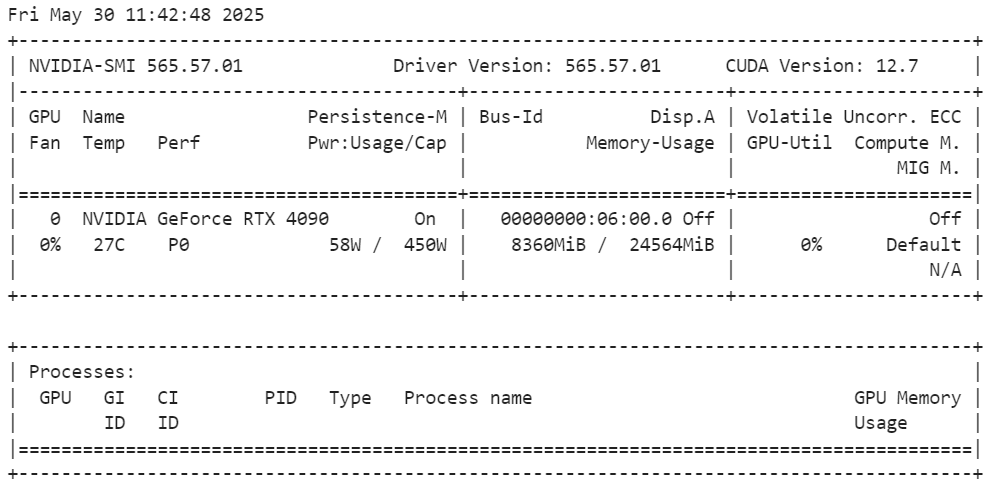
Per verificare l’uso della VRAM dopo il caricamento del modello, esegui il seguente comando:
!nvidia-smiL’uso della VRAM è di circa 8,3 GB, lasciando due terzi della memoria disponibili per il fine-tuning.
In questo passaggio prepareremo i prompt di training creando un template con segnaposto per domanda e risposta. Definiremo anche una funzione Python per formattare il dataset secondo lo stile del prompt e creare una nuova colonna “text”.
train_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
{}

### Response:
{}"""


EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["input"]
    outputs = examples["output"]
    texts = []
    for question, response in zip(inputs, outputs):
        # Remove the "Q:" prefix from the question
        question = question.replace("Q:", "")

        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token

        text = train_prompt_style.format(question, response)
        texts.append(text)
    return {"text": texts}
Quindi caricheremo mamachang/medical-reasoning, applicheremo la funzione formatting_prompts_func e mostreremo la colonna “text” dell’undicesimo campione.
from datasets import load_dataset

dataset = load_dataset(
    "mamachang/medical-reasoning",
    split="train",
    trust_remote_code=True,
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
print(dataset["text"][10])
La colonna text contiene il prompt di sistema, la domanda, il ragionamento e la risposta nel seguente formato:
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood. A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease. A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance. When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity. Which of the following additional analyses would most likely address the concerns about this study's design??
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},

### Response:
<analysis>

This is a question about assessing the validity of a prospective cohort study. The study found an association between childhood diet and cardiovascular disease in adulthood. The peer reviewer is concerned that the researchers did not discuss the validity of the study design.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors that could influence the results. The additional analysis suggested should help control for confounding.Prima di procedere al fine-tuning, testeremo le prestazioni del modello base per stabilire un riferimento. Questo comporta la creazione di un prompt di inferenza, la selezione di una domanda di esempio dal dataset e la generazione di una risposta con il modello base.
Creeremo un template di prompt per l’inferenza che includa un segnaposto per la domanda.
inference_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
{}

### Response:
<analysis>
"""
Quindi selezioneremo la domanda dell’undicesimo campione e la forniremo al modello dopo averla formattata e convertita in token.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
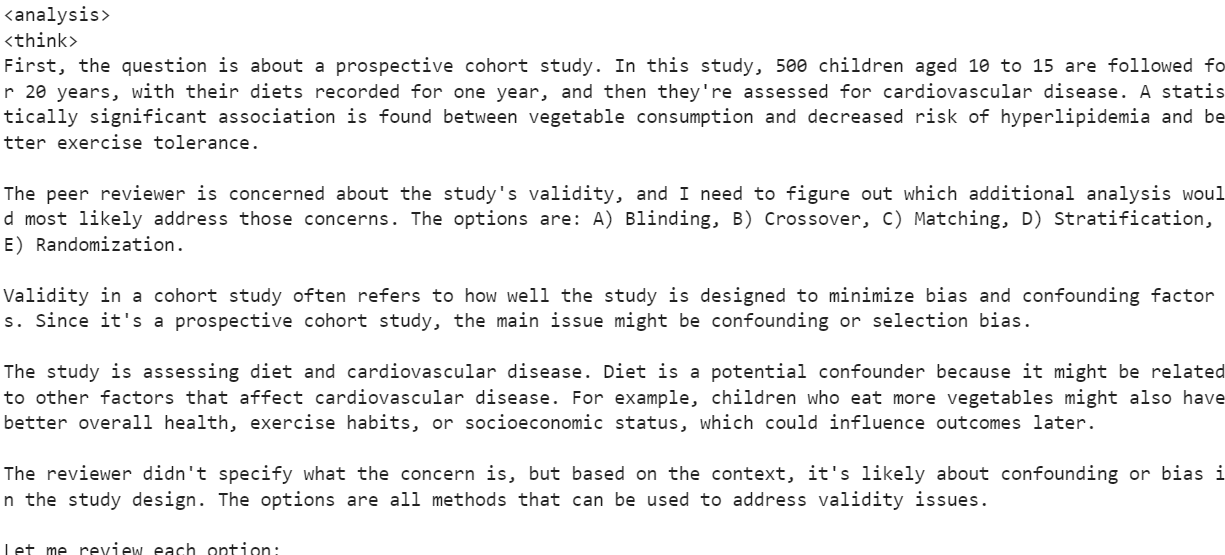
La risposta del modello non è stata soddisfacente. La sezione di analisi era eccessivamente lunga, ha consumato il limite di token e la sezione della risposta non è stata mai generata a causa del ragionamento prolisso.
In questo passaggio imposteremo il modello e il tokenizer per il fine-tuning.
1. SFTTrainer non accetta direttamente un tokenizer. Convertiremo invece il tokenizer in un data collator usando la classe DataCollatorForLanguageModeling della libreria transformers.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)
Useremo LoRA (Low-Rank Adaptation) per effettuare il fine-tuning. LoRA modifica solo un sottoinsieme ridotto dei parametri del modello, risultando molto efficiente in memoria e più veloce rispetto al fine-tuning completo.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
La classe TrainingArguments consente di configurare il processo di fine-tuning e SFTTrainer semplifica il flusso integrando modello, dataset, data collator, argomenti di training e configurazione LoRA in un’unica pipeline.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Prima di avviare l’addestramento, è importante svuotare la cache ed eliminare tracce inutili in memoria e VRAM per evitare errori di Out of Memory (OOM).
Una volta liberata la memoria, possiamo iniziare il training usando SFTTrainer.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
Durante l’addestramento puoi monitorare la GPU dalla dashboard di RunPod. Dovresti osservare un utilizzo vicino al 100%, segno che il training sta avvenendo su GPU (e non su CPU).
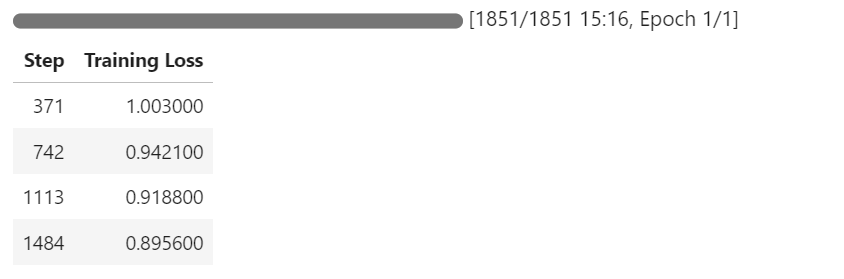
Con il progredire del training, dovresti notare una diminuzione graduale della training loss. Ciò indica che il modello sta apprendendo e il fine-tuning sta avendo successo.
Dopo il fine-tuning, testeremo le prestazioni fornendo di nuovo l’undicesima domanda del dataset. Questo ci permette di confrontare i risultati con il modello base e valutare i miglioramenti ottenuti.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question,) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
La risposta del modello ottimizzato mostra notevoli miglioramenti:
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer raised concerns about the study's validity, likely because it was an observational study without randomization or control group.

The question asks which additional analysis would most likely address the concerns about the study's design. The choices include blinding, crossover, matching, stratification, and randomization.

Randomization is the key to reducing bias in observational studies. By randomly assigning participants to different groups, you can control for confounding factors. The other choices do not directly address the lack of randomization in the original study design.
</analysis>
<answer>
E: Randomization
</answer>
Per valutare ulteriormente il modello fine-tuned, lo testeremo su un altro campione del dataset e osserveremo i risultati.
question = dataset[100]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Il modello fine-tuned si comporta in modo impeccabile su questo campione:
<analysis>

This is a clinical vignette describing a 55-year-old man with burning and shooting pain in his feet and lower legs that worsens at night. He has a history of type 2 diabetes mellitus and hypertension. The description of the pain being burning and shooting in a symmetric distribution in the lower extremities, worsening at night, along with his history of diabetes, is most consistent with distal symmetric sensorimotor polyneuropathy. Autonomic neuropathy would not cause sensory symptoms. Isolated cranial nerve or peripheral nerve neuropathy would not explain the symmetric distribution. Radiculopathy would not explain the sensory symptoms.
</analysis>
<answer>
D: Distal symmetric sensorimotor polyneuropathy
</answer>Il passo successivo è salvare il modello fine-tuned e pubblicarlo sull’Hugging Face Hub. In questo modo altri potranno accedere al modello per l’inferenza o per ulteriore fine-tuning.
new_model_name = "DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"
trainer.model.push_to_hub(new_model_name)
trainer.processing_class.push_to_hub(new_model_name)
Una volta pubblicato con successo, il modello sarà disponibile sull’Hugging Face Hub: kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning.
Dopo aver salvato il modello e l’adapter su Hugging Face Hub, testeremo che il modello funzioni come previsto ricaricandolo. Questo comporta svuotare la memoria GPU, caricare il modello base e l’adapter LoRA, ed eseguire l’inferenza su un prompt di esempio.
1. Svuota la memoria GPU per evitare possibili errori di Out of Memory (OOM). Garantisce un ambiente pulito per il caricamento del modello.
del model
del trainer
torch.cuda.empty_cache()
2. carica il modello base e l’adapter LoRA fine-tuned dall’Hugging Face Hub. Il modello base verrà caricato in quantizzazione a 4 bit per ottimizzare l’uso della memoria e l’adapter LoRA verrà unito ad esso.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from peft import PeftModel
import torch

# Base model
base_model_id = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

# Your fine-tuned LoRA adapter repository
lora_adapter_id = "kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"

# Load the model in 4-bit
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config,
    trust_remote_code=True,
)

# Attach the LoRA adapter
model = PeftModel.from_pretrained(
    base_model,
    lora_adapter_id,
    device_map="auto",
    trust_remote_code=True,
)

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model_id, trust_remote_code=True)
3. Ora testeremo il modello fine-tuned fornendo un prompt di esempio. Il prompt verrà tokenizzato, passato al modello e la risposta verrà decodificata.
# Inference example
prompt = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood.
A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease.
A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance.
When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity.
Which of the following additional analyses would most likely address the concerns about this study's design?
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},
### Response:
<analysis>

"""

inputs = tokenizer(
    [prompt + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Il modello fine-tuned produce una risposta simile al dataset, confermando che modello e adapter sono stati caricati correttamente.
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer was concerned about the study's validity.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors. The choices given are different statistical methods that can help control for confounding.

Blinding and crossover designs are not applicable to a prospective cohort study. Matching and stratification can help control for confounding by balancing the distribution of confounders between groups. Randomization is the best way to minimize confounding by randomly assigning participants to different exposure groups.
</analysis>
<answer>
E: Randomization
</answer>
Se riscontri problemi nell’esecuzione del codice sopra, consulta il notebook fine-tuning-Deepseek-new-R1.ipynb. Questo notebook è stato testato più volte e dovrebbe funzionare subito su RunPod o in un ambiente simile.
Il modello DeepSeek-R1-0528 è tra i migliori modelli open-source per il reasoning disponibili oggi. La sua capacità di eseguire compiti di ragionamento complessi, unita alla natura open-source, lo rende una scelta eccellente per sviluppatori e ricercatori. Sebbene il modello fine-tuned offra già risultati notevoli, ci sono diversi modi per migliorare ulteriormente gli esiti del fine-tuning:
Inoltre, questa guida può essere usata per effettuare il fine-tuning del modello DeepSeek R1 su qualsiasi dataset di reasoning, inclusi dataset sintetici creati con altri modelli come o3 di OpenAI. Puoi anche fare pratica con alcune delle tecniche mostrate qui nel nostro corso Fine-Tuning With Llama 3. Se ti interessa fare fine-tuning di altri modelli con dataset medici, dai un’occhiata al nostro tutorial Fine-Tuning di MedGemma su un dataset di risonanze magnetiche cerebrali.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



