
Kurs
Feinabstimmung mit Llama 3
2 Std.
4K
DeepSeek-R1-0528 ist die neueste Iteration des DeepSeek R1 Modells mit verbesserten Fähigkeiten für logisches Denken und Inferenz. Es liegt auf Augenhöhe mit führenden Modellen wie o3 und Gemini 2.5 Pro und ist damit das beste Open-Source-Reasoning-Modell weltweit.
In diesem Tutorial feinabstimmen wir das DeepSeek-R1-0528-Qwen3-8B-Modell auf einem Medical Reasoning Multiple Choice Question-Datensatz (MCQ). Die Feinabstimmung führt einen neuen Reasoning-Stil ein und erzeugt Antworten in Form von A-, B-, C-, D-Optionen.
Das Beste daran? Das geht auf einer Consumer-GPU wie der RTX 4090, sodass du das Modell lokal ohne Probleme feinabstimmen kannst. Mehr dazu findest du in unserem umfassenden Guide zu DeepSeek-R1 und in unserem Feinabstimmungs-Guide.
 Bild: Autor
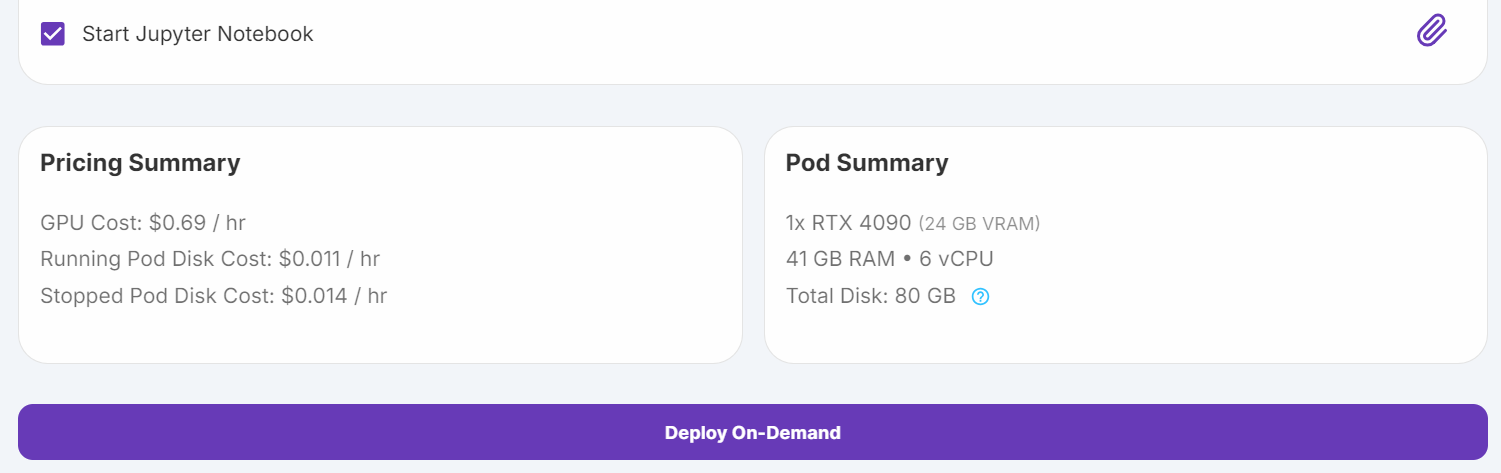
Wir richten eine RunPod-Instanz mit einer RTX 4090 GPU und dem PyTorch-2.4.0-Image ein.
Quelle: My Pods
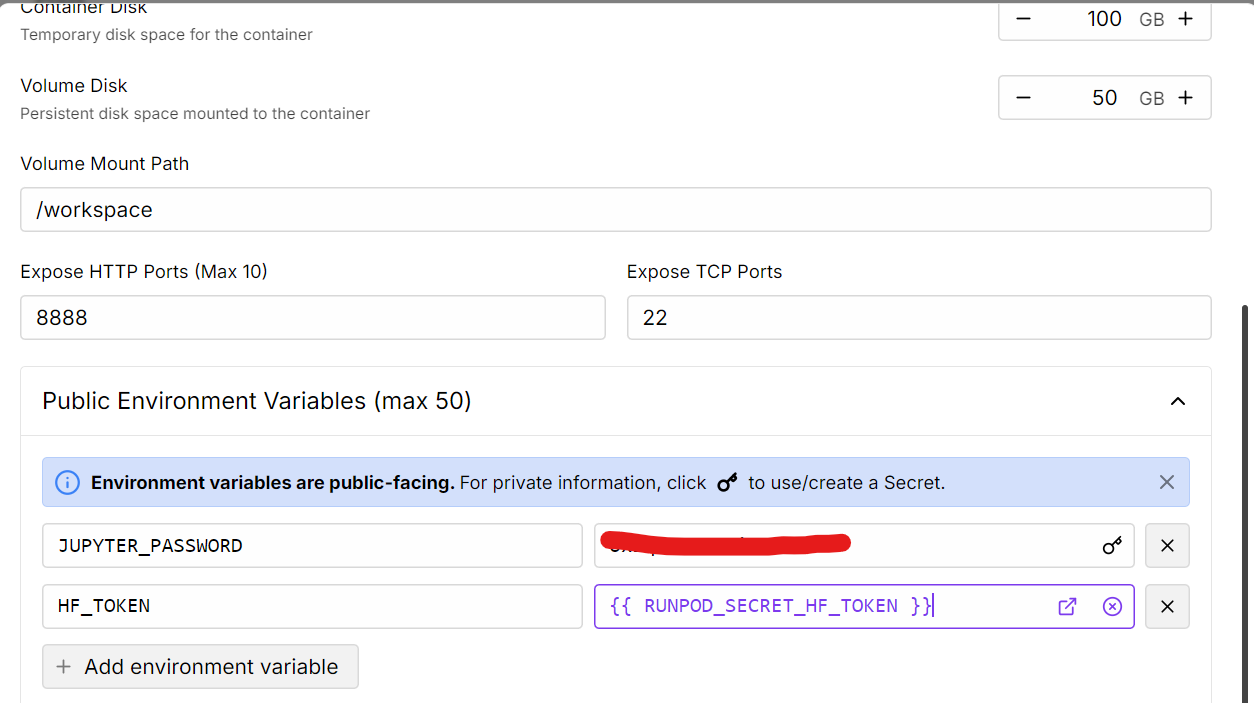
Navigiere in der RunPod-Konsole zum Bereich „My Pods“. Bearbeite die Pod-Konfiguration:
Quelle: My Pods
Sobald der Pod läuft, installiere die benötigten Python-Pakete.
Hinweis: In der neuesten Version der Transformers-Bibliothek gibt es bekannte Probleme, daher installieren wir stattdessen eine ältere, stabile Version.
%%capture
%pip install -U transformers==4.52.1
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
Um Modelle zu laden oder Updates in den Hugging Face Hub zu pushen, melde dich mit deinem API-Schlüssel über die Hugging Face CLI an.
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Obwohl wir 24 GB VRAM haben und das vollständige Modell laden könnten, nutzen wir 4-Bit-Quantisierung, um mehr Speicher für die Feinabstimmung freizuhalten und Stabilität zu sichern. So optimieren wir die VRAM-Nutzung bei gleichbleibender Performance.
Wir laden das DeepSeek-R1-0528-Qwen3-8B-Modell und den Tokenizer aus dem Hugging Face Hub. Mehr zu Arbeiten mit Hugging Face und dem Hub erfährst du in unserem Kurs.
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load tokenizer & model

model_dir = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)

model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    quantization_config=bnb_config,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True
)

model.config.use_cache = False
model.config.pretraining_tp = 1
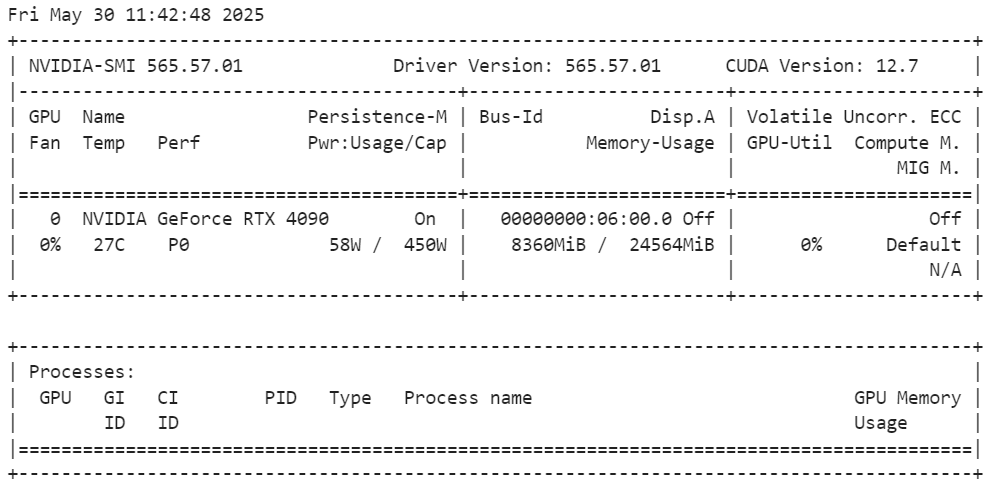
Um die VRAM-Nutzung nach dem Laden zu prüfen, führe folgenden Befehl aus:
!nvidia-smiDie VRAM-Nutzung liegt bei rund 8,3 GB, sodass zwei Drittel des Speichers für die Feinabstimmung frei bleiben.
Jetzt bereiten wir die Trainings-Prompts vor, indem wir eine Vorlage mit Platzhaltern für Frage und Antwort erstellen. Außerdem definieren wir eine Python-Funktion, die den Datensatz gemäß diesem Prompt-Stil formatiert und eine neue „text“-Spalte erzeugt.
train_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
{}

### Response:
{}"""


EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["input"]
    outputs = examples["output"]
    texts = []
    for question, response in zip(inputs, outputs):
        # Remove the "Q:" prefix from the question
        question = question.replace("Q:", "")

        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token

        text = train_prompt_style.format(question, response)
        texts.append(text)
    return {"text": texts}
Dann laden wir mamachang/medical-reasoning, wenden die Funktion formatting_prompts_func an und geben die „text“-Spalte des 11. Samples aus.
from datasets import load_dataset

dataset = load_dataset(
    "mamachang/medical-reasoning",
    split="train",
    trust_remote_code=True,
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
print(dataset["text"][10])
Die Textspalte enthält Systemprompt, Frage, Begründung und Antwort im folgenden Format:
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood. A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease. A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance. When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity. Which of the following additional analyses would most likely address the concerns about this study's design??
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},

### Response:
<analysis>

This is a question about assessing the validity of a prospective cohort study. The study found an association between childhood diet and cardiovascular disease in adulthood. The peer reviewer is concerned that the researchers did not discuss the validity of the study design.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors that could influence the results. The additional analysis suggested should help control for confounding.Bevor wir feinabstimmen, testen wir die Basisleistung des Modells als Vergleichswert. Dazu erstellen wir einen Inferenz-Prompt, wählen eine Beispiel-Frage aus dem Datensatz und generieren eine Antwort mit dem Basismodell.
Wir erstellen eine Prompt-Vorlage für die Inferenz mit Platzhalter für die Frage.
inference_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
{}

### Response:
<analysis>
"""
Anschließend wählen wir die Frage aus dem 11. Sample, formatieren sie, tokenisieren sie und übergeben sie dem Modell.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Die Antwort des Modells war unbefriedigend. Der Analyse-Abschnitt war übermäßig lang, verbrauchte das Token-Limit und der Antwort-Abschnitt wurde wegen der langen Begründung nicht erzeugt.
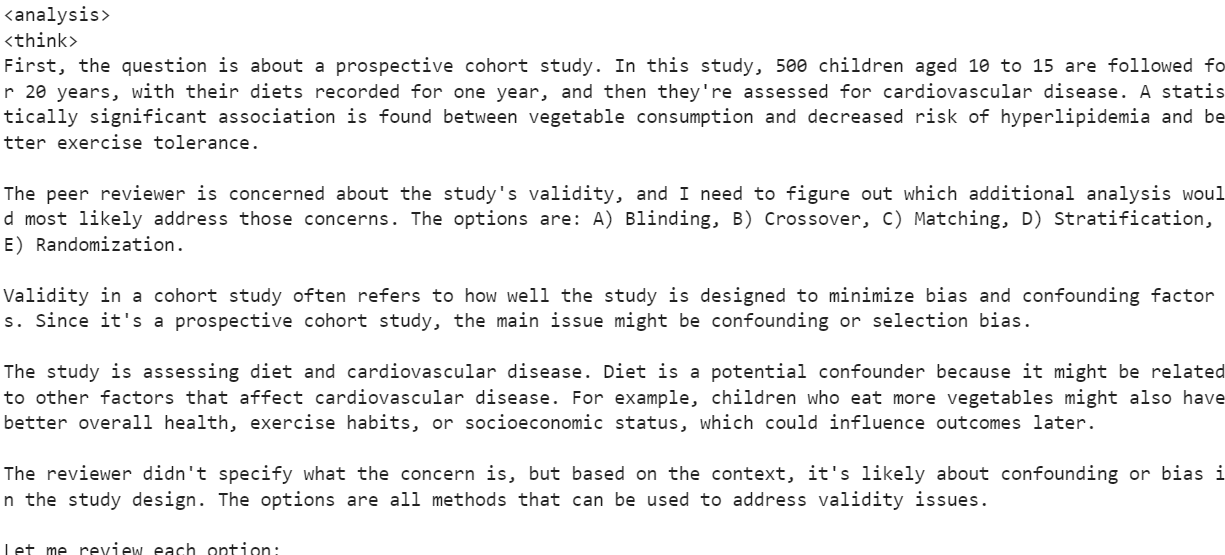
In diesem Schritt bereiten wir Modell und Tokenizer für die Feinabstimmung vor.
1. Der SFTTrainer akzeptiert nicht direkt einen Tokenizer. Stattdessen wandeln wir den Tokenizer mit der Klasse DataCollatorForLanguageModeling aus der transformers-Bibliothek in einen Data Collator um.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)
Wir verwenden LoRA (Low-Rank Adaptation) für die Feinabstimmung. LoRA verändert nur einen kleinen Teil der Modellparameter und ist dadurch speichereffizient und schneller als vollständige Feinabstimmung.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
Mit den TrainingArguments konfigurieren wir die Feinabstimmung und der SFTTrainer vereinfacht den Prozess, indem Modell, Datensatz, Data Collator, Trainingsargumente und LoRA-Konfiguration in einem Workflow zusammengeführt werden.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Bevor das Training startet, sollten Cache sowie ungenutzter Speicher und VRAM bereinigt werden, um Out-of-Memory-(OOM)-Fehler zu vermeiden.
Ist der Speicher bereinigt, starten wir das Training mit dem SFTTrainer.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
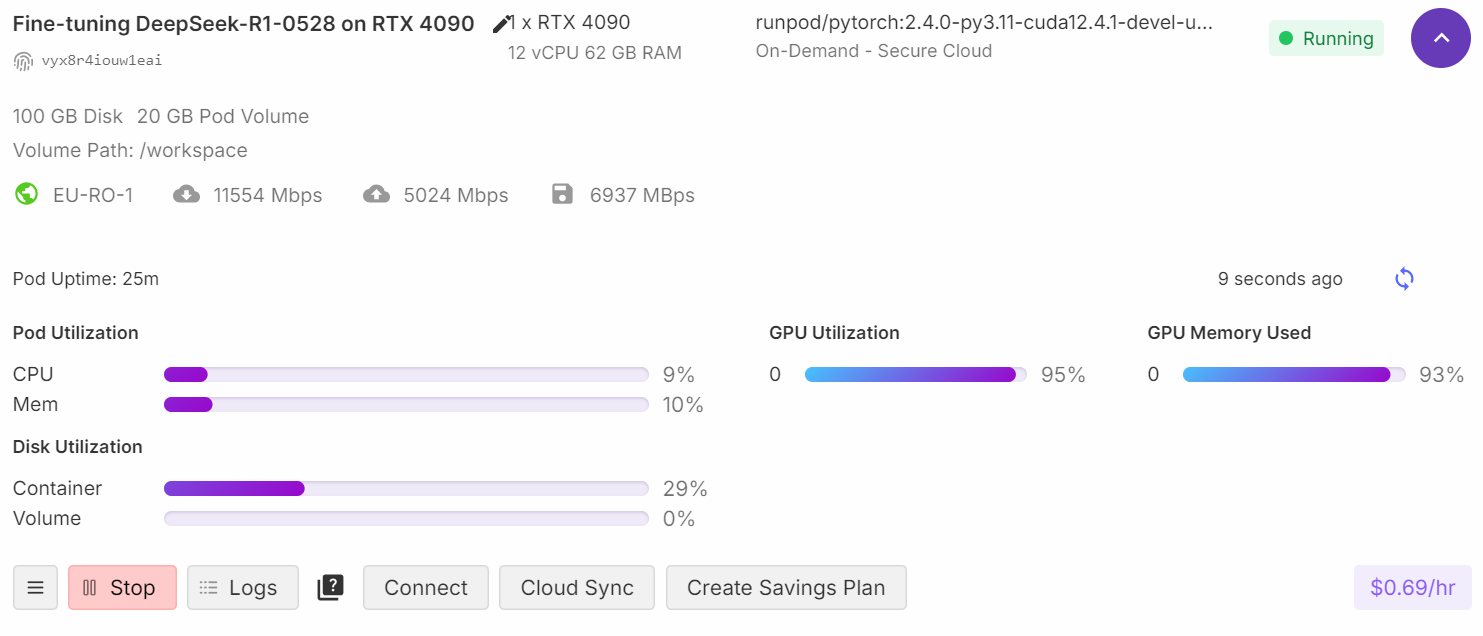
Während des Trainings kannst du die GPU im RunPod-Dashboard überwachen. Die GPU-Auslastung sollte nahe 100% liegen – ein Zeichen dafür, dass auf der GPU trainiert wird (und nicht auf der CPU).
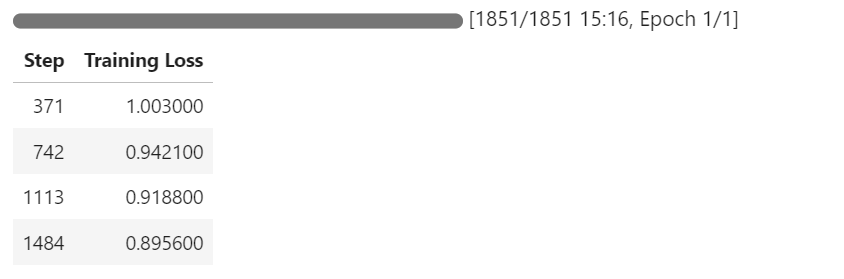
Mit fortschreitendem Training sollte der Trainingsverlust allmählich sinken. Das zeigt, dass das Modell lernt und die Feinabstimmung greift.
Nach der Feinabstimmung testen wir die Performance erneut mit derselben 11. Frage aus dem Datensatz. So vergleichen wir die Ergebnisse mit dem Basismodell und bewerten die Verbesserungen.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question,) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Die Antwort des feinabgestimmten Modells zeigt deutliche Verbesserungen:
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer raised concerns about the study's validity, likely because it was an observational study without randomization or control group.

The question asks which additional analysis would most likely address the concerns about the study's design. The choices include blinding, crossover, matching, stratification, and randomization.

Randomization is the key to reducing bias in observational studies. By randomly assigning participants to different groups, you can control for confounding factors. The other choices do not directly address the lack of randomization in the original study design.
</analysis>
<answer>
E: Randomization
</answer>
Um das feinabgestimmte Modell weiter zu evaluieren, testen wir es an einem weiteren Sample aus dem Datensatz und beobachten die Ergebnisse.
question = dataset[100]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Beim zweiten Sample liefert das feinabgestimmte Modell eine perfekte Antwort:
<analysis>

This is a clinical vignette describing a 55-year-old man with burning and shooting pain in his feet and lower legs that worsens at night. He has a history of type 2 diabetes mellitus and hypertension. The description of the pain being burning and shooting in a symmetric distribution in the lower extremities, worsening at night, along with his history of diabetes, is most consistent with distal symmetric sensorimotor polyneuropathy. Autonomic neuropathy would not cause sensory symptoms. Isolated cranial nerve or peripheral nerve neuropathy would not explain the symmetric distribution. Radiculopathy would not explain the sensory symptoms.
</analysis>
<answer>
D: Distal symmetric sensorimotor polyneuropathy
</answer>Als Nächstes speichern wir das feinabgestimmte Modell und pushen es in den Hugging Face Hub. So können andere es für Inferenz oder weitere Feinabstimmung nutzen.
new_model_name = "DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"
trainer.model.push_to_hub(new_model_name)
trainer.processing_class.push_to_hub(new_model_name)
Sobald das Modell erfolgreich gepusht wurde, ist es im Hugging Face Hub verfügbar: kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning.
Nachdem das feinabgestimmte Modell und der Adapter im Hugging Face Hub gespeichert sind, testen wir das Laden aus dem Hub. Dazu leeren wir den GPU-Speicher, laden das Basismodell und den LoRA-Adapter und führen eine Inferenz auf einem Beispielprompt aus.
1. Leere den GPU-Speicher, um mögliche Out-of-Memory-(OOM)-Probleme zu vermeiden. So startest du in einer sauberen Umgebung.
del model
del trainer
torch.cuda.empty_cache()
2. Lade das Basismodell und den feinabgestimmten LoRA-Adapter aus dem Hugging Face Hub. Das Basismodell wird in 4-Bit-Quantisierung geladen, der LoRA-Adapter wird angehängt.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from peft import PeftModel
import torch

# Base model
base_model_id = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

# Your fine-tuned LoRA adapter repository
lora_adapter_id = "kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"

# Load the model in 4-bit
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config,
    trust_remote_code=True,
)

# Attach the LoRA adapter
model = PeftModel.from_pretrained(
    base_model,
    lora_adapter_id,
    device_map="auto",
    trust_remote_code=True,
)

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model_id, trust_remote_code=True)
3. Teste das feinabgestimmte Modell mit einem Beispielprompt. Der Prompt wird tokenisiert, durch das Modell geschickt und die Antwort dekodiert.
# Inference example
prompt = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood.
A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease.
A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance.
When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity.
Which of the following additional analyses would most likely address the concerns about this study's design?
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},
### Response:
<analysis>

"""

inputs = tokenizer(
    [prompt + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Das feinabgestimmte Modell erzeugt eine Antwort im Stil des Datensatzes, was bestätigt, dass Modell und Adapter korrekt geladen wurden.
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer was concerned about the study's validity.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors. The choices given are different statistical methods that can help control for confounding.

Blinding and crossover designs are not applicable to a prospective cohort study. Matching and stratification can help control for confounding by balancing the distribution of confounders between groups. Randomization is the best way to minimize confounding by randomly assigning participants to different exposure groups.
</analysis>
<answer>
E: Randomization
</answer>
Wenn bei der Ausführung Probleme auftreten, sieh dir das Notebook fine-tuning-Deepseek-new-R1.ipynb an. Dieses Notebook wurde mehrfach getestet und läuft in RunPod oder einer ähnlichen Umgebung direkt.
DeepSeek-R1-0528 gehört zu den besten Open-Source-Reasoning-Modellen der Gegenwart. Die Fähigkeit zu komplexem Schlussfolgern in Kombination mit Open-Source macht es zur ersten Wahl für Entwicklerinnen, Entwickler und Forschende. Obwohl das feinabgestimmte Modell bereits starke Ergebnisse liefert, kannst du die Resultate weiter verbessern:
Außerdem kannst du diesen Leitfaden nutzen, um das DeepSeek R1 Modell auf beliebigen Reasoning-Datensätzen zu feinabstimmen – inklusive synthetischer Datensätze, die mit anderen Modellen wie OpenAI's o3 erstellt wurden. Praktische Übungen zu einigen der hier gezeigten Techniken findest du in unserem Kurs Fine-Tuning With Llama 3. Wenn du andere Modelle mit medizinischen Datensätzen feinabstimmen willst, schau dir unser Tutorial Fine-Tuning von MedGemma auf einem Brain-MRI-Datensatz an.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Blog
Nisha Arya Ahmed
15 Min.
Blog
Nathaniel Taylor-Leach
Tutorial
Matt Crabtree
5 Min.


