Curso
Ajuste fino con Llama 3
2 h
4K
DeepSeek-R1-0528 es la última iteración del modelo DeepSeek R1, con capacidades mejoradas de razonamiento e inferencia. Está a la altura de modelos líderes como o3 y Gemini 2.5 Pro, lo que lo convierte en el mejor modelo de razonamiento de código abierto del mundo.
En este tutorial, haremos fine-tuning del modelo DeepSeek-R1-0528-Qwen3-8B sobre un dataset de razonamiento médico con preguntas de opción múltiple (MCQ). El proceso de fine-tuning introduce un nuevo estilo de razonamiento y generación de respuestas en forma de opciones A, B, C, D.
¿Lo mejor? Puedes hacerlo con una GPU de consumo como la RTX 4090, lo que te permite afinar el modelo en local sin problemas. Échale un vistazo a nuestra guía completa sobre DeepSeek-R1 y a nuestra guía de fine-tuning para saber más.
 Imagen del autor
Configuraremos una instancia en RunPod con una GPU RTX 4090 y la imagen de PyTorch 2.4.0.
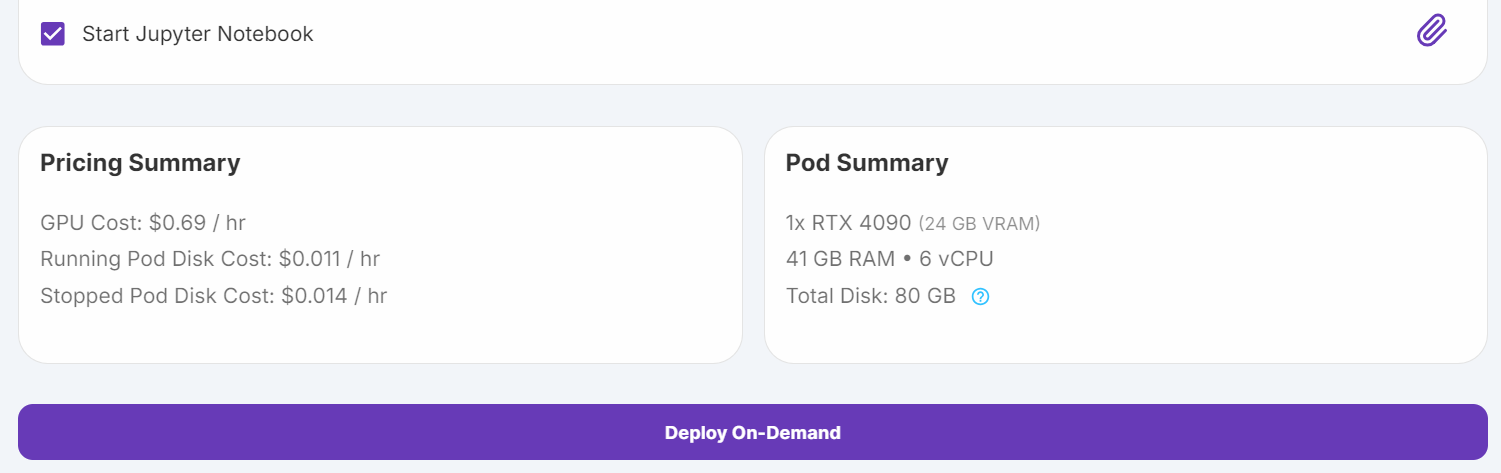
Fuente: My Pods
Ve a la sección "My Pods" en la consola de RunPod. Edita la configuración del pod:
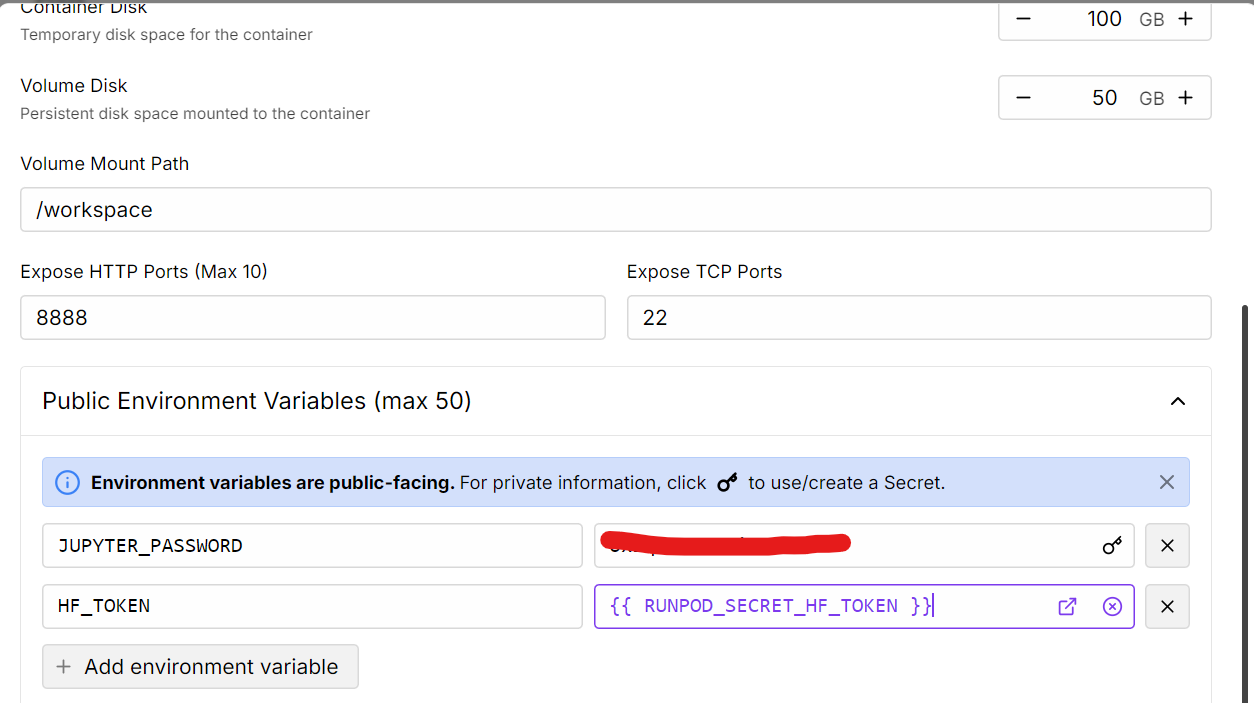
Fuente: My Pods
Cuando el pod esté en ejecución, instala los paquetes de Python necesarios.
Nota: la última versión de la librería Transformers tiene algunos problemas conocidos, así que instalaremos una versión anterior y estable.
%%capture
%pip install -U transformers==4.52.1
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
Para cargar modelos o subir actualizaciones a Hugging Face Hub, inicia sesión en la CLI de Hugging Face usando tu API key.
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)Aunque tenemos 24 GB de VRAM, suficiente para cargar el modelo completo, usaremos cuantización a 4 bits para dejar más memoria disponible para el fine-tuning y asegurar la estabilidad. Así optimizamos el uso de VRAM sin perder rendimiento.
Descargaremos y cargaremos el modelo y el tokenizador DeepSeek-R1-0528-Qwen3-8B desde Hugging Face Hub. Puedes aprender más sobre cómo trabajar con Hugging Face y una guía del Hub en nuestro curso.
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load tokenizer & model

model_dir = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

tokenizer = AutoTokenizer.from_pretrained(model_dir, use_fast=True)

model = AutoModelForCausalLM.from_pretrained(
    model_dir,
    quantization_config=bnb_config,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True
)

model.config.use_cache = False
model.config.pretraining_tp = 1
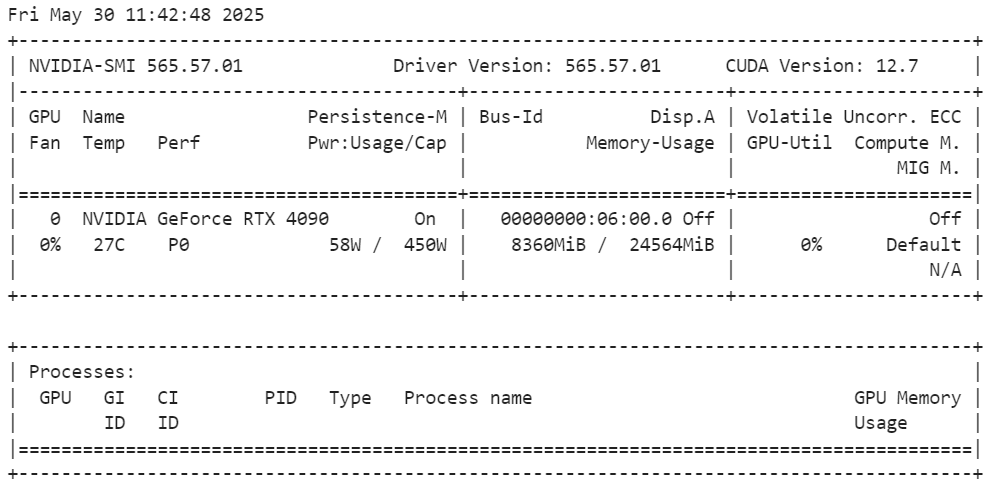
Para verificar el uso de VRAM tras cargar el modelo, ejecuta la siguiente orden:
!nvidia-smiEl uso de VRAM es de aproximadamente 8,3 GB, dejando dos tercios de la memoria disponible para el fine-tuning.
En este paso prepararemos los prompts de entrenamiento creando una plantilla con marcadores para la pregunta y la respuesta. También definiremos una función en Python para formatear el dataset según el estilo del prompt y crear una nueva columna “text”.
train_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
{}

### Response:
{}"""


EOS_TOKEN = tokenizer.eos_token  # Must add EOS_TOKEN

def formatting_prompts_func(examples):
    inputs = examples["input"]
    outputs = examples["output"]
    texts = []
    for question, response in zip(inputs, outputs):
        # Remove the "Q:" prefix from the question
        question = question.replace("Q:", "")

        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token

        text = train_prompt_style.format(question, response)
        texts.append(text)
    return {"text": texts}
Después cargaremos mamachang/medical-reasoning, aplicaremos la función formatting_prompts_func y mostraremos la columna “text” de la muestra 11.
from datasets import load_dataset

dataset = load_dataset(
    "mamachang/medical-reasoning",
    split="train",
    trust_remote_code=True,
)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
print(dataset["text"][10])
La columna de texto contiene el prompt del sistema, la pregunta, el razonamiento y la respuesta en el siguiente formato:
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.
### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood. A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease. A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance. When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity. Which of the following additional analyses would most likely address the concerns about this study's design??
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},

### Response:
<analysis>

This is a question about assessing the validity of a prospective cohort study. The study found an association between childhood diet and cardiovascular disease in adulthood. The peer reviewer is concerned that the researchers did not discuss the validity of the study design.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors that could influence the results. The additional analysis suggested should help control for confounding.Antes de afinar el modelo, probaremos su rendimiento base para establecer un punto de comparación. Esto implica crear un prompt de inferencia, seleccionar una pregunta de muestra del dataset y generar una respuesta con el modelo base.
Crearemos una plantilla de prompt para la inferencia que incluya un marcador para la pregunta.
inference_prompt_style = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
{}

### Response:
<analysis>
"""
Luego, seleccionaremos la pregunta de la muestra 11 y se la pasaremos al modelo tras formatearla y convertirla en tokens.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
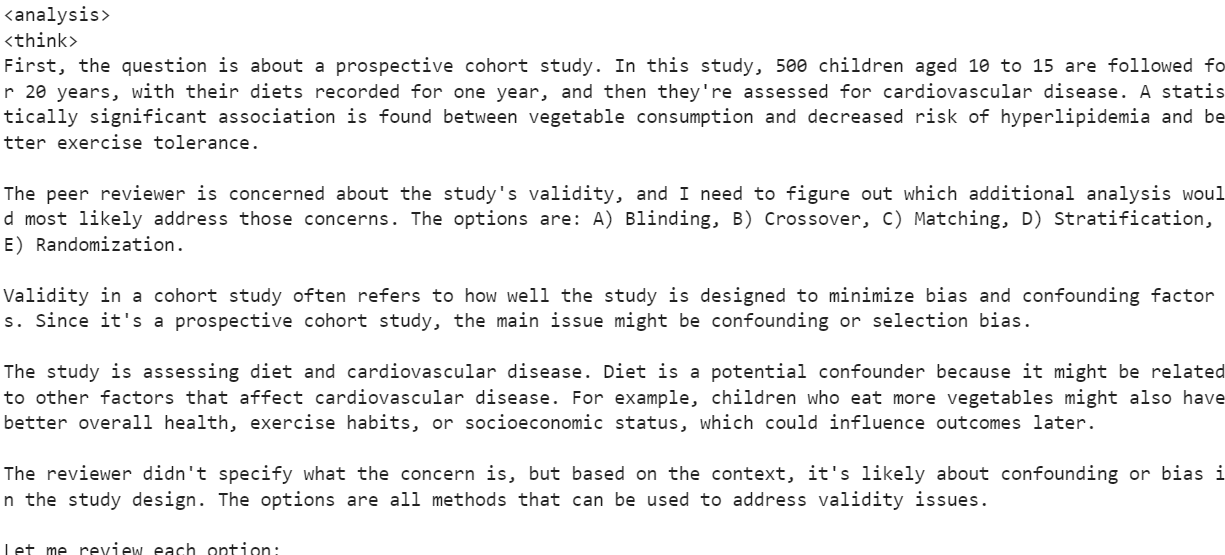
La respuesta del modelo fue insatisfactoria. La sección de análisis era excesivamente larga, consumió el límite de tokens y no llegó a generarse la sección de respuesta por el razonamiento tan extenso.
En este paso configuraremos el modelo y el tokenizador para el fine-tuning.
1. SFTTrainer no acepta directamente un tokenizador. En su lugar, convertiremos el tokenizador en un data collator usando la clase DataCollatorForLanguageModeling de la librería transformers.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False
)
Usaremos LoRA (Low-Rank Adaptation) para afinar el modelo. LoRA modifica solo un subconjunto pequeño de los parámetros del modelo, lo que la hace muy eficiente en memoria y más rápida que el fine-tuning completo.
from peft import LoraConfig, get_peft_model

# LoRA config
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)

model = get_peft_model(model, peft_config)
La clase TrainingArguments nos permite configurar el proceso de fine-tuning, y SFTTrainer simplifica todo al integrar modelo, dataset, data collator, argumentos de entrenamiento y configuración LoRA en un único flujo.
from trl import SFTTrainer
from transformers import TrainingArguments


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Antes de comenzar el entrenamiento, es importante vaciar la caché y liberar memoria y huellas de VRAM innecesarias para evitar errores de falta de memoria (OOM).
Una vez liberada la memoria, podemos iniciar el entrenamiento usando SFTTrainer.
import gc, torch
gc.collect()
torch.cuda.empty_cache()
model.config.use_cache = False
trainer.train()
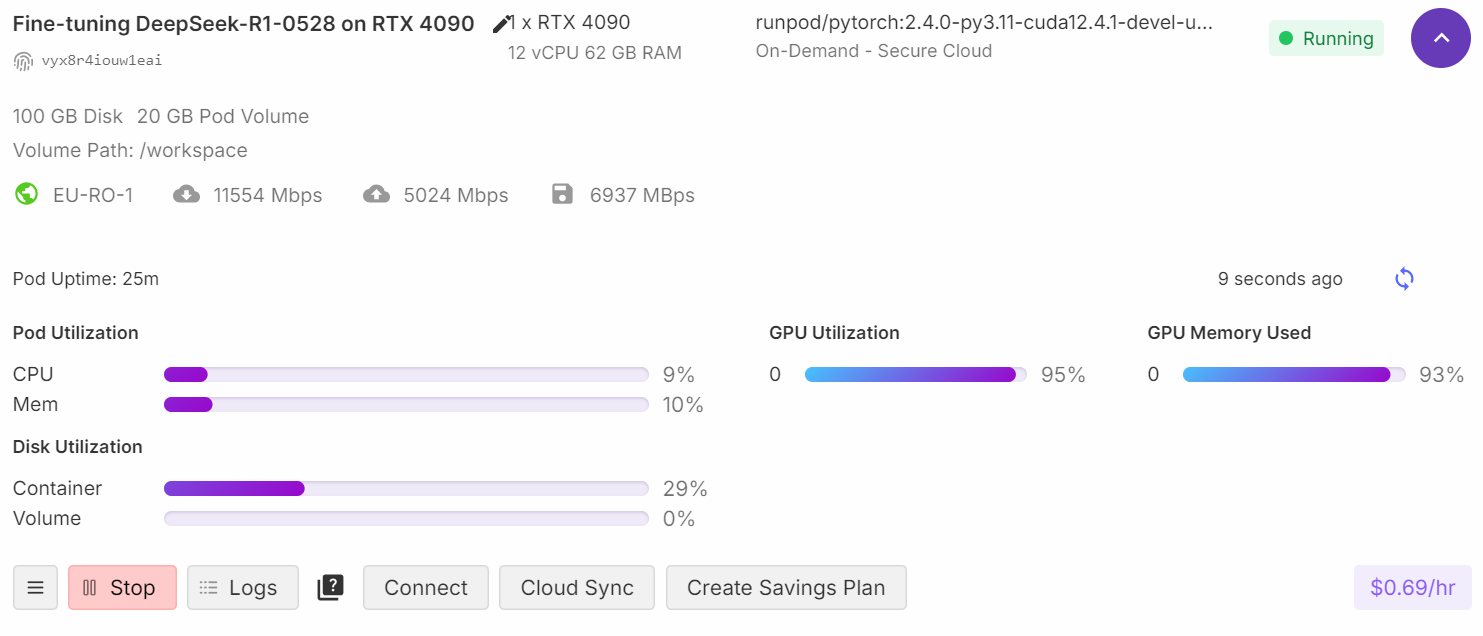
Durante el entrenamiento, puedes monitorizar la GPU desde tu panel de RunPod. Deberías ver la utilización de GPU cerca del 100%, lo que indica que el modelo se está entrenando en la GPU (no en la CPU).
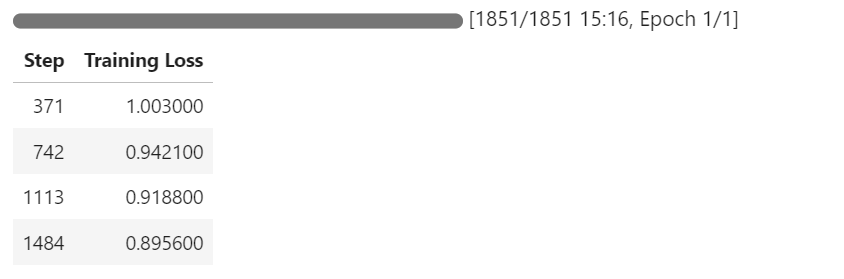
A medida que avanza el entrenamiento, deberías notar que la pérdida de entrenamiento disminuye de forma gradual. Eso indica que el modelo está aprendiendo y afinándose correctamente.
Después de afinar el modelo, probaremos su rendimiento usando la misma pregunta número 11 del dataset. Así podremos comparar con el modelo base y evaluar las mejoras logradas con el fine-tuning.
question = dataset[10]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question,) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
La respuesta del modelo afinado muestra mejoras claras:
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer raised concerns about the study's validity, likely because it was an observational study without randomization or control group.

The question asks which additional analysis would most likely address the concerns about the study's design. The choices include blinding, crossover, matching, stratification, and randomization.

Randomization is the key to reducing bias in observational studies. By randomly assigning participants to different groups, you can control for confounding factors. The other choices do not directly address the lack of randomization in the original study design.
</analysis>
<answer>
E: Randomization
</answer>
Para seguir evaluando el modelo afinado, lo probaremos con otra muestra del dataset y observaremos los resultados.
question = dataset[100]['input']
question = question.replace("Q:", "")

inputs = tokenizer(
    [inference_prompt_style.format(question) + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
En esta muestra, el modelo afinado rinde de forma impecable:
<analysis>

This is a clinical vignette describing a 55-year-old man with burning and shooting pain in his feet and lower legs that worsens at night. He has a history of type 2 diabetes mellitus and hypertension. The description of the pain being burning and shooting in a symmetric distribution in the lower extremities, worsening at night, along with his history of diabetes, is most consistent with distal symmetric sensorimotor polyneuropathy. Autonomic neuropathy would not cause sensory symptoms. Isolated cranial nerve or peripheral nerve neuropathy would not explain the symmetric distribution. Radiculopathy would not explain the sensory symptoms.
</analysis>
<answer>
D: Distal symmetric sensorimotor polyneuropathy
</answer>El siguiente paso es guardar el modelo afinado y subirlo a Hugging Face Hub. Así, otras personas podrán acceder y usar el modelo para inferencia o para seguir afinándolo.
new_model_name = "DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"
trainer.model.push_to_hub(new_model_name)
trainer.processing_class.push_to_hub(new_model_name)
Una vez subido el modelo, estará disponible en Hugging Face Hub: kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning.
Tras guardar el modelo y el adaptador en Hugging Face Hub, comprobaremos que funciona como se espera cargándolo de nuevo. Esto implica limpiar la memoria de la GPU, cargar el modelo base y el adaptador LoRA, y ejecutar una inferencia sobre un prompt de ejemplo.
1. Limpia la memoria de la GPU para evitar posibles errores OOM. Así tendrás un entorno limpio para cargar el modelo.
del model
del trainer
torch.cuda.empty_cache()
2. Carga el modelo base y el adaptador LoRA afinado desde Hugging Face Hub. El modelo base se cargará con cuantización a 4 bits para optimizar memoria y se fusionará el adaptador LoRA.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from peft import PeftModel
import torch

# Base model
base_model_id = "deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"

# Your fine-tuned LoRA adapter repository
lora_adapter_id = "kingabzpro/DeepSeek-R1-0528-Qwen3-8B-Medical-Reasoning"

# Load the model in 4-bit
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
    base_model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config,
    trust_remote_code=True,
)

# Attach the LoRA adapter
model = PeftModel.from_pretrained(
    base_model,
    lora_adapter_id,
    device_map="auto",
    trust_remote_code=True,
)

# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model_id, trust_remote_code=True)
3. Ahora probaremos el modelo afinado pasando un prompt de ejemplo. El prompt se tokeniza, pasa por el modelo y la respuesta se decodifica.
# Inference example
prompt = """
Please answer with one of the options in the bracket. Write reasoning in between <analysis></analysis>. Write the answer in between <answer></answer>.

### Question:
A research group wants to assess the relationship between childhood diet and cardiovascular disease in adulthood.
A prospective cohort study of 500 children between 10 to 15 years of age is conducted in which the participants' diets are recorded for 1 year and then the patients are assessed 20 years later for the presence of cardiovascular disease.
A statistically significant association is found between childhood consumption of vegetables and decreased risk of hyperlipidemia and exercise tolerance.
When these findings are submitted to a scientific journal, a peer reviewer comments that the researchers did not discuss the study's validity.
Which of the following additional analyses would most likely address the concerns about this study's design?
{'A': 'Blinding', 'B': 'Crossover', 'C': 'Matching', 'D': 'Stratification', 'E': 'Randomization'},
### Response:
<analysis>

"""

inputs = tokenizer(
    [prompt + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
El modelo afinado produce una respuesta similar al dataset, lo que confirma que el modelo y el adaptador se cargaron correctamente.
<analysis>
This is a question about evaluating the validity of a prospective cohort study design. The study looked at childhood diet and cardiovascular disease in adulthood. The peer reviewer was concerned about the study's validity.

To address concerns about validity in a prospective cohort study, we need to consider potential confounding factors. The choices given are different statistical methods that can help control for confounding.

Blinding and crossover designs are not applicable to a prospective cohort study. Matching and stratification can help control for confounding by balancing the distribution of confounders between groups. Randomization is the best way to minimize confounding by randomly assigning participants to different exposure groups.
</analysis>
<answer>
E: Randomization
</answer>
Si encuentras algún problema al ejecutar el código anterior, consulta el cuaderno fine-tuning-Deepseek-new-R1.ipynb. Este notebook se ha probado varias veces y debería funcionar sin ajustes al cargarlo en RunPod o un entorno similar.
DeepSeek-R1-0528 es uno de los mejores modelos open-source de razonamiento disponibles hoy. Su capacidad para abordar tareas de razonamiento complejas, unida a su naturaleza abierta, lo convierte en una opción destacada para desarrolladores e investigadores. Aunque el modelo afinado ya ofrece resultados notables, hay varias formas de mejorar aún más el fine-tuning:
Además, esta guía puede usarse para afinar el modelo DeepSeek R1 en cualquier dataset de razonamiento, incluidos datasets sintéticos creados con otros modelos como o3 de OpenAI. También puedes practicar varias de las técnicas que mostramos aquí en nuestro curso Fine-Tuning With Llama 3. Si te interesa afinar otros modelos con datasets médicos, echa un vistazo a nuestro tutorial Fine-Tuning MedGemma on a Brain MRI Dataset.
Los mejores cursos de DataCamp
Curso
Curso
Curso
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Zoumana Keita
12 min
Tutorial
Aashi Dutt
14 min
Tutorial
Moez Ali
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
12 min