Kursus
Pengantar R
4 jam
3.1M
Ketika bidang pembelajaran mesin berkembang pesat dengan hadirnya teknik-teknik yang semakin canggih, hanya sedikit perhatian yang diberikan pada masalah multi-tugas berdimensi tinggi yang memerlukan prediksi simultan atas banyak respons. Tutorial ini akan menunjukkan kekuatan Graph-Guided Fused LASSO (GFLASSO) dalam memprediksi banyak respons dalam satu kerangka regresi linear teratur.
Dalam pembelajaran terawasi, tujuan biasanya adalah memprediksi variabel dependen atau respons dari sekumpulan variabel penjelas atau prediktor di atas sekumpulan sampel atau observasi. Metode regularisasi memperkenalkan penalti yang mencegah overfitting pada data berdimensi tinggi, khususnya ketika jumlah prediktor melebihi jumlah observasi. Penalti ini ditambahkan ke fungsi objektif sehingga taksiran koefisien untuk prediktor yang tidak informatif (yang kontribusinya kecil terhadap minimisasi galat) turut diminimalkan. Least absolute shrinkage and selection operator (LASSO) [1] adalah salah satu metode tersebut.
Dibandingkan dengan ordinary least squares (OLS), LASSO mampu menyusutkan taksiran koefisien (β) tepat ke nol, sehingga menyingkirkan prediktor yang tidak informatif dan melakukan seleksi fitur, melalui
$$argmin_\beta \sum_n(y_n-\hat{y_n})^2+\lambda\sum_{j}|\beta_{j}|$$
di mana n dan j masing-masing menyatakan suatu observasi dan prediktor. Residual sum of squares (RSS), satu-satunya suku yang digunakan dalam OLS, dapat ditulis setara dalam bentuk aljabar $RSS = \sum_n(y_n-\hat{y_n})^2 = (y-X\beta)^T.(y-X\beta)$. Penalti LASSO adalah λ∑j|βj|, norma L1 dari taksiran koefisien yang dibobot oleh λ.
Bagaimana jika Anda hendak memprediksi beberapa respons yang saling terkait sekaligus, dari satu set prediktor yang sama? Secara praktis Anda bisa saja menggunakan beberapa model LASSO independen, satu per respons, namun hasilnya akan lebih baik jika prediksi tersebut dikoordinasikan berdasarkan kekuatan asosiasi antarrespons. Koordinasi ini menghilangkan variasi spesifik respons yang mengandung derau — inilah kekuatan utama GFLASSO.
Contoh yang baik diberikan dalam artikel asli, di mana penulis mengurai asosiasi antara 34 penanda genetik dan 53 sifat asma pada 543 pasien [2].
Misalkan X adalah matriks berukuran n × p, dengan n observasi dan p prediktor, dan Y matriks berukuran n × k, dengan n observasi yang sama dan k respons, misalnya 1390 catatan pembelian elektronik yang berbeda di 73 negara, untuk memprediksi penilaian atas 50 produksi Netflix di semua 73 negara.
Model yang tepat untuk memodelkan pasangan himpunan data berdimensi tinggi mencakup orthogonal two-way Partial Least Squares (O2PLS), Canonical Correlation Analysis (CCA), dan Co-Inertia Analysis (CIA), yang semuanya melibatkan dekomposisi matriks [3]. Selain itu, karena model-model ini berbasis variabel laten (yakni proyeksi berdasarkan prediktor asli), efisiensi komputasi didapat dengan mengorbankan interpretabilitas.
Namun, pengorbanan ini tidak selalu sepadan, dan dapat dihindari dengan prediksi langsung atas k respons individual dari fitur terpilih dalam X, dalam kerangka regresi terpadu yang mempertimbangkan hubungan antargaris respons.
Secara matematis, GFLASSO meminjam regularisasi dari LASSO [1] yang dibahas di atas dan membangun model pada struktur ketergantungan graf yang mendasari Y, sebagaimana dikuantifikasi oleh matriks korelasi k × k (yakni "kekuatan asosiasi" yang Anda baca sebelumnya). Akibatnya, respons yang serupa (atau tidak serupa) akan dijelaskan oleh subset prediktor terpilih yang serupa (atau tidak serupa).
Lebih formalnya, mengikuti notasi yang digunakan dalam naskah asli [2], fungsi objektif GFLASSO adalah
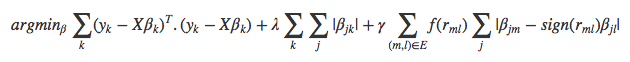
di mana, di atas semua k respons, ∑k(yk − X**βk)T.(yk − X**βk) memberikan RSS dan λ∑k∑j|βj**k| merupakan penalti regularisasi yang diadopsi dari LASSO, dibobot oleh parameter λ dan bekerja pada koefisien β dari setiap prediktor individual j. Kebaruan GFLASSO terletak pada
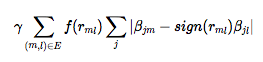
penalti fusi yang dibobot oleh γ yang memastikan selisih absolut antara koefisien βj**m dan βj**l, dari prediktor mana pun j dan pasangan respons m dan l, akan semakin kecil (resp. semakin besar) semakin positif (resp. semakin negatif) korelasi berpasangan mereka, ditransformasikan atau tidak, f(rm**l). Penalti fusi ini mengutamakan variasi yang bermakna secara global pada respons dibanding derau masing-masing. Ketika korelasi berpasangan mendekati nol, penalti ini tidak berpengaruh, sehingga Anda tinggal dengan LASSO murni. Struktur korelasi yang mendasari semua k respons, yang dapat direpresentasikan sebagai struktur jaringan berbobot, secara baku menggunakan korelasi absolut, f(rm**l)=|rm**l| namun dapat ditransformasikan untuk membuat varian GFLASSO dengan fungsi apa pun yang ditentukan pengguna, seperti
dengan masih banyak ruang untuk inovasi. Walaupun 2. jauh lebih ringan secara komputasi dibanding 1. dan korelasi absolut baku [2], ia membutuhkan nilai batas yang telah ditentukan, misalnya, τ = 0,8.
Singkatnya, untuk menyesuaikan model GFLASSO Anda memerlukan matriks prediktor X, matriks respons Y, dan matriks korelasi yang menggambarkan kekuatan asosiasi antara semua pasangan respons dalam Y. Perhatikan bahwa GFLASSO menghasilkan matriks p × k dari β, tidak seperti LASSO (p × 1), dan matriks koefisien ini memuat asosiasi antara respons tertentu k dan prediktor j.
Kris Sankaran dan saya sedang mengerjakan sebuah paket R eksperimental yang mengimplementasikan GFLASSO beserta metode validasi silang dan plotting. Baru-baru ini kami menerapkan multi-threading menggunakan paket doParallel, yang membuat rutinitas validasi silang (CV) jauh lebih cepat.
Untuk menjalankan GFLASSO di R Anda perlu memasang devtools, memuatnya, dan memasang paket gflasso dari repositori GitHub saya. Demonstrasi akan dilakukan pada dataset yang ada dalam paket bgsmtr. Saya juga merekomendasikan memasang corrplot dan pheatmap untuk memvisualisasikan hasil.
# Install the packages if necessary
#install.packages("devtools")
#install.packages("bgsmtr")
#install.packages("corrplot")
#install.packages("pheatmap")
library(devtools)
library(bgsmtr)
library(corrplot)
library(pheatmap)
#install_github("monogenea/gflasso")
library(gflasso)Anda dapat dengan mudah menjalankan simulasi yang diuraikan di halaman bantuan untuk fungsi CV cv_gflasso(). Secara baku, CV menghitung root mean squared error (RMSE) pada satu pengulangan CV 5-lipat, di semua pasangan yang mungkin antara λ ∈ {0, 0.1, 0.2, ..., 0.9, 1} dan γ ∈ {0, 0.1, 0.2, ..., 0.9, 1}, yaitu kisi penyetelan.
Catatan bahwa fungsi galat yang disediakan pengguna juga akan berfungsi!
Selain asumsi statistik yang melekat dan kinerja kecepatan, pilihan rentang kisi penyetelan sangat bergantung pada pemusatan rata-rata dan penskalaan varian satuan untuk semua kolom dalam X dan Y, jadi pastikan Anda melakukannya terlebih dahulu.
Pada contoh berikut Anda tidak membutuhkannya, karena Anda akan mengambil sampel acak dari distribusi normal standar. Anda bisa mencoba menurunkan penalti fusi dari jaringan korelasi tak berbobot, dengan nilai batas r > 0,8:
?cv_gflasso
set.seed(100)
X <- matrix(rnorm(100 * 10), 100, 10)
u <- matrix(rnorm(10), 10, 1)
B <- u %*% t(u) + matrix(rnorm(10 * 10, 0, 0.1), 10, 10)
Y <- X %*% B + matrix(rnorm(100 * 10), 100, 10)
R <- ifelse(cor(Y) > .8, 1, 0)
system.time(testCV <- cv_gflasso(X, Y, R, nCores = 1))

## [1] 1.826146 1.819430 1.384595 1.420058 1.408619

##    user  system elapsed
##  45.808   3.070  55.271

system.time(testCV <- cv_gflasso(X, Y, R, nCores = 2))

## [1] 1.595413 1.492953 1.469917 1.366832 1.441642

##    user  system elapsed
##  22.231   1.698  26.441

cv_plot_gflasso(testCV)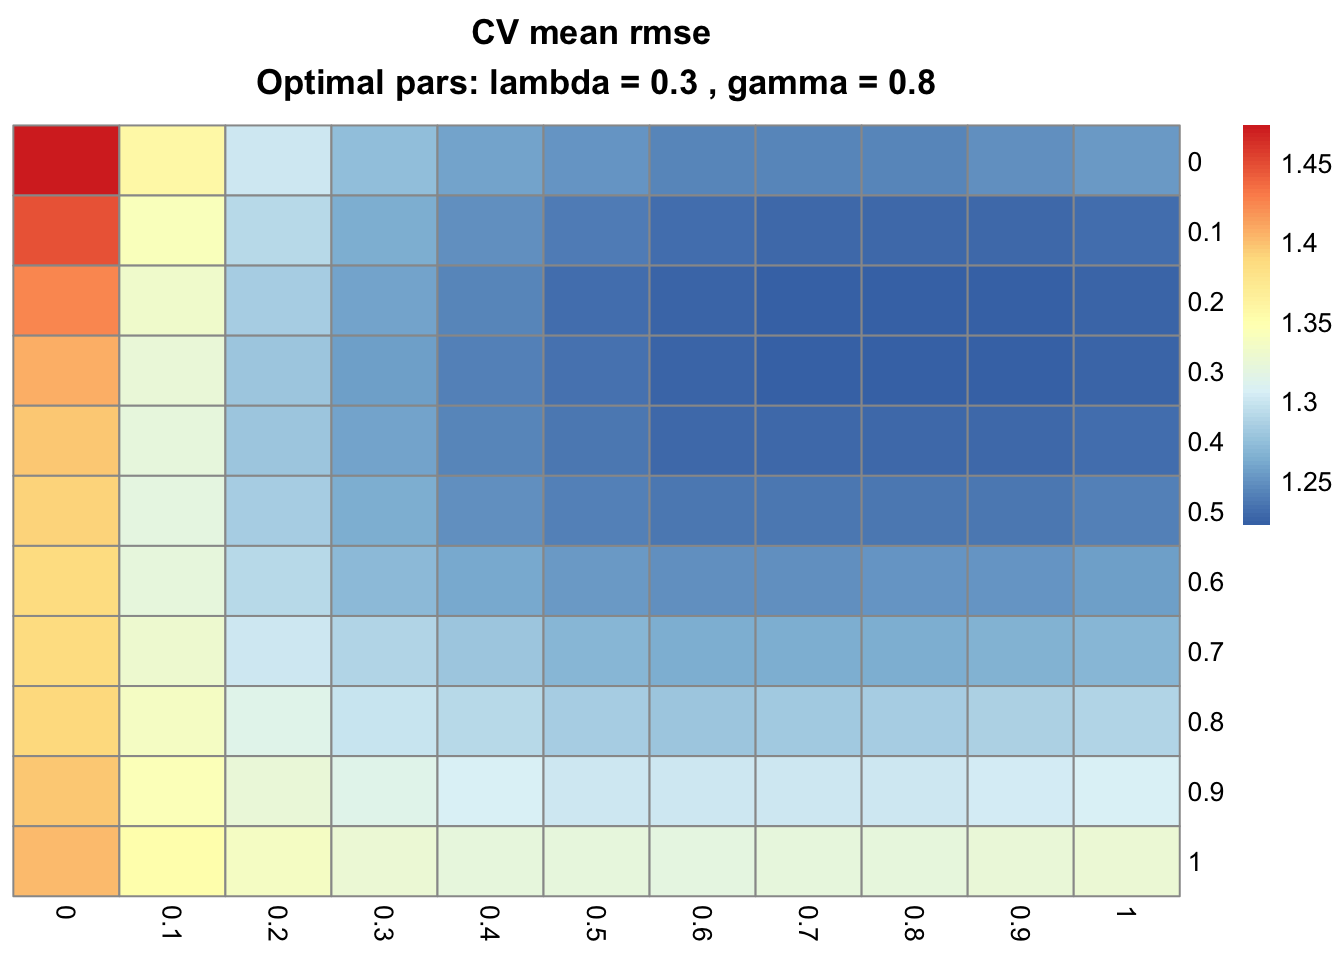
Nilai optimal λ (baris) dan γ (kolom) yang meminimalkan RMSE pada simulasi ini, masing-masing 0,3 dan 0,8, memang menangkap hubungan yang diterapkan.
Tips: Coba jalankan ulang contoh ini dengan metrik berbeda, koefisien determinasi (R2). Satu keunggulan utama menggunakan R2 adalah rentangnya dari 0 hingga 1.
Ingat bahwa ketika Anda menyediakan fungsi goodness-of-fit kustom err_fun(), Anda harus menentukan apakah akan memaksimalkan atau meminimalkan metrik yang dihasilkan dengan argumen err_opt.
Contoh berikut bertujuan memaksimalkan R2, menggunakan jaringan asosiasi berbobot dengan koefisien korelasi kuadrat (yakni f(rm**l)=rm**l2). Jika Anda memiliki lebih dari 2 core, Anda bisa mengubah argumen nCores untuk mempercepat!
# Write R2 function
R2 <- function(pred, y){
      cor(as.vector(pred), as.vector(y))**2
}

# X, u, B and Y are still in memory
R <- cor(Y)**2

# Change nCores, if you have more than 2, re-run CV
testCV <- cv_gflasso(X, Y, R, nCores = 2, err_fun = R2, err_opt = "max")

## [1] 0.6209191 0.7207394 0.7262781 0.7193907 0.6303187

cv_plot_gflasso(testCV)
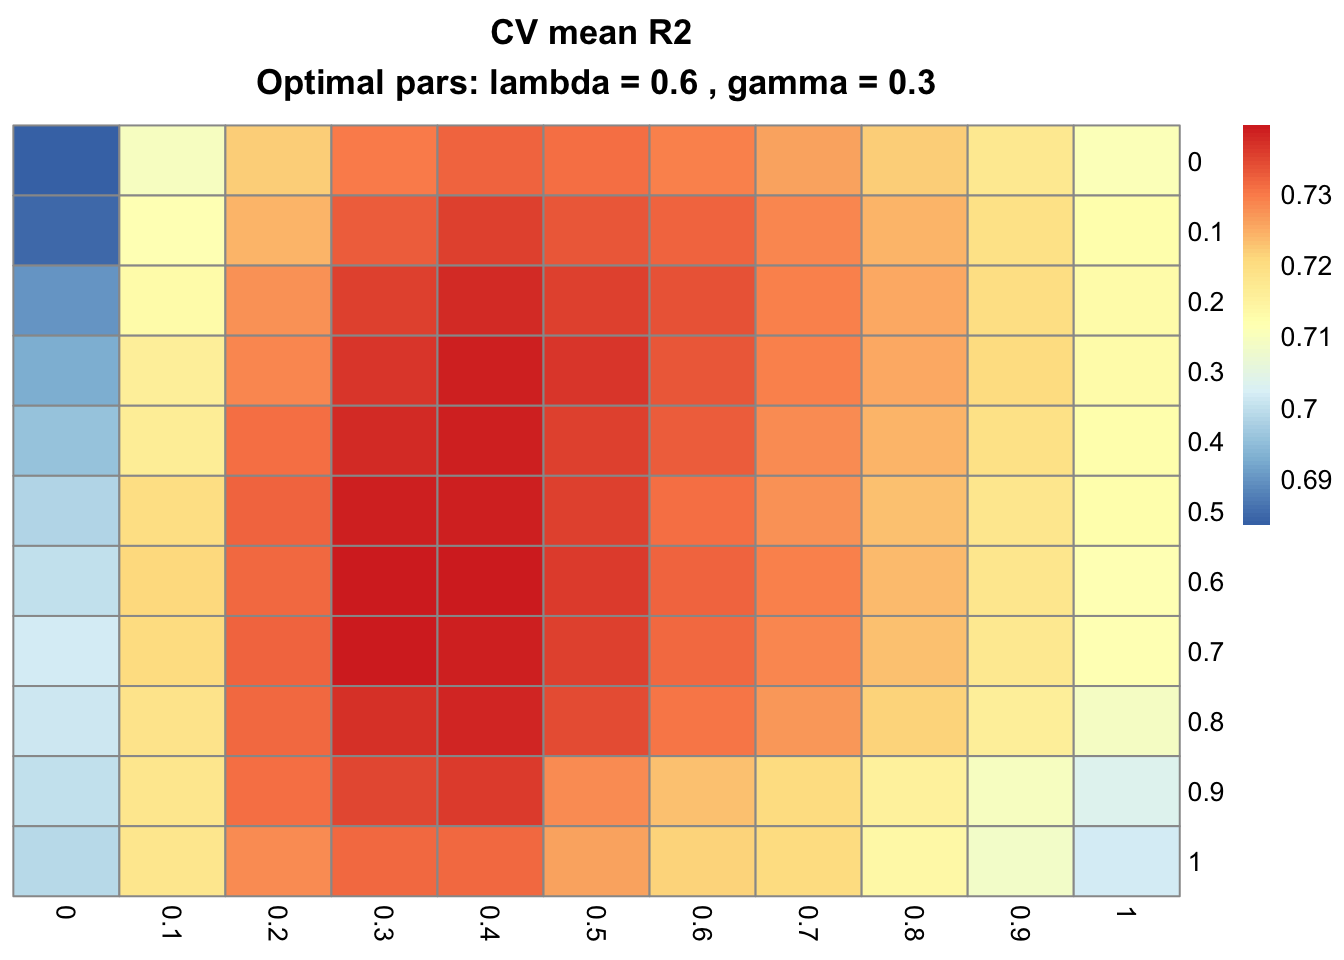
Parameter optimal λ dan γ kini masing-masing 0,6 dan 0,3.
Perhatikan juga bahwa objek cv_gflasso berupa daftar tunggal dengan empat elemen: rerata ($mean) dan galat baku ($SE) dari metrik di semua sel kisi, parameter λ dan γ yang optimal ($optimal) serta nama fungsi goodness-of-fit ($err_fun). Model tervalidasi-silang dari contoh ini jelas menyukai kelangkaan (λ) dan fusi (γ).
Terakhir, ingat bahwa Anda dapat menyetel parameter tambahan, seperti ambang konvergensi gradien Nesterov δ dan jumlah iterasi maksimum dengan meneruskan delta_conv dan iter_max ke additionalOpts. Ini akan digunakan pada contoh berikut.
Untuk mendemonstrasikan kesederhanaan dan ketangguhan GFLASSO pada masalah yang relatif berdimensi tinggi, Anda akan memodelkan dataset bgsmtr_example_data yang diperoleh dari basis data Alzheimer’s Disease Neuroimaging Initiative (ADNI-1).
Ini adalah objek daftar dengan 3 elemen, bagian dari paket bgsmtr yang terdiri dari 15 ukuran neuroimaging struktural dan 486 single nucleotide polymorphisms (SNP, penanda genetik) yang ditentukan dari sampel 632 subjek. Pentingnya, 486 SNP tersebut mencakup 33 gen yang dianggap terkait dengan penyakit Alzheimer.
Tugas Anda adalah memprediksi ukuran morfologi neuroimaging dari data SNP, dengan memanfaatkan struktur korelasi dari ukuran tersebut.
Mari mulai dengan mengorganisasi data dan menelaah ketergantungan antarfitur neuroimaging:
data(bgsmtr_example_data)
str(bgsmtr_example_data)

## List of 3
##  $ SNP_data     : int [1:486, 1:632] 2 0 2 0 0 0 0 1 0 1 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:486] "rs4305" "rs4309" "rs4311" "rs4329" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...
##  $ SNP_groups   : chr [1:486] "ACE" "ACE" "ACE" "ACE" ...
##  $ BrainMeasures: num [1:15, 1:632] 116.5 4477.9 28631.9 34.1 -473.4 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:15] "Left_AmygVol.adj" "Left_CerebCtx.adj" "Left_CerebWM.adj" "Left_HippVol.adj" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...

# Transpose, so that samples are distributed as rows, predictors / responses as columns
SNP <- t(bgsmtr_example_data$SNP_data)
BM <- t(bgsmtr_example_data$BrainMeasures)

# Define dependency structure
DS <- cor(BM)

# Plot correlation matrix of the 15 neuroimaging measures
corrplot(DS)
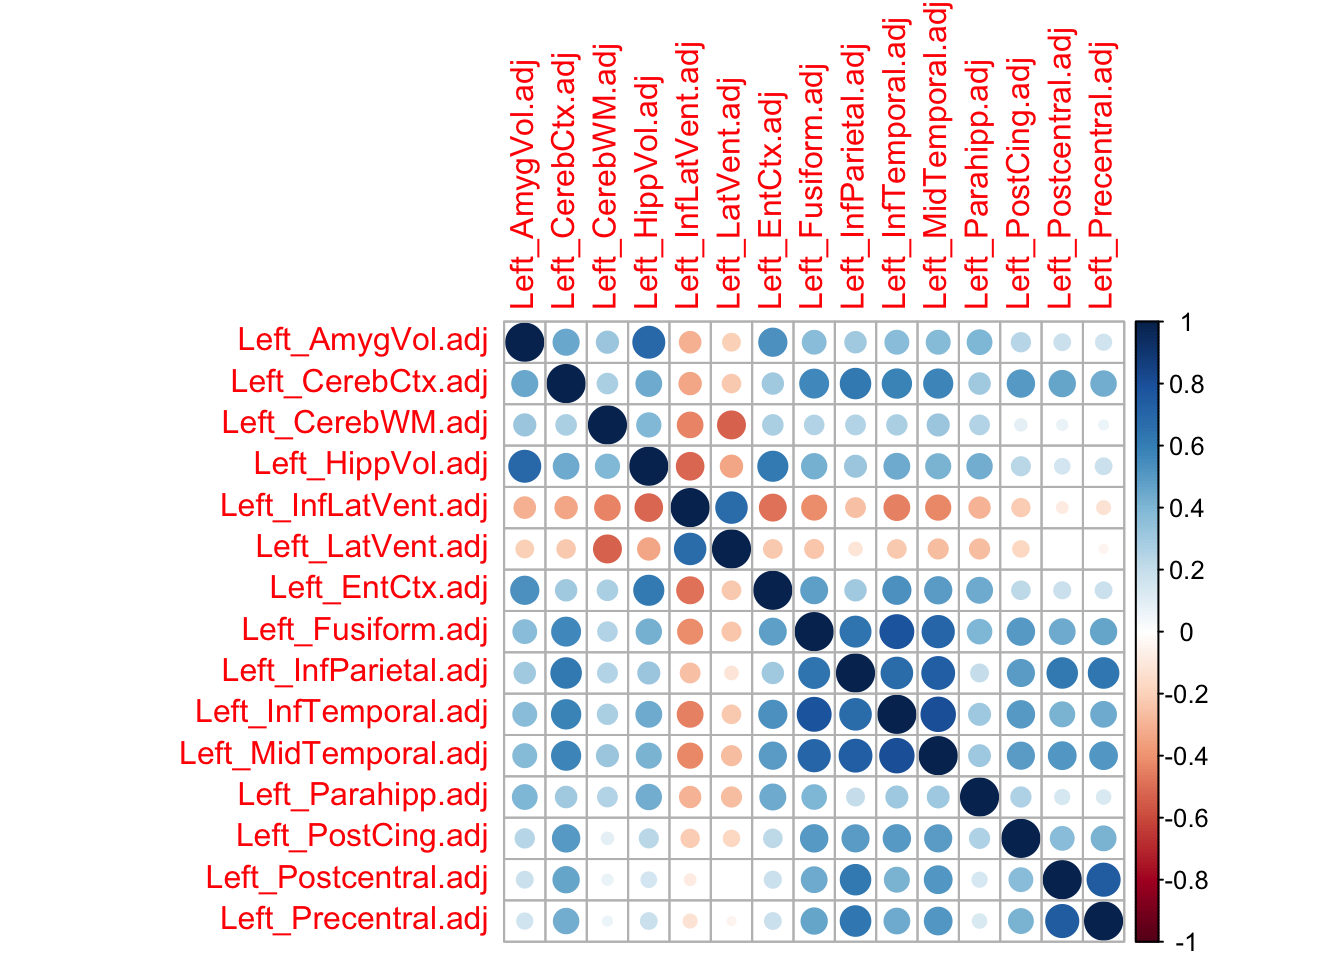
Gambar di atas menunjukkan ketergantungan antarfitur neuroimaging. Sekarang coba lakukan validasi silang GFLASSO (dapat memakan waktu hingga beberapa jam di laptop!) dan tentukan asosiasi SNP–neuroimaging.
Catatan bahwa pada contoh di bawah, toleransi konvergensi dan jumlah iterasi maksimum ditentukan. Silakan coba nilai lain sesuai keinginan!
system.time(CV <- cv_gflasso(X = scale(SNP), Y = scale(BM), R = DS, nCores = 2,
                 additionalOpts = list(delta_conv = 1e-5, iter_max = 1e5)))

## [1] 1.550294 1.471637 1.470133 1.514425 1.504215

##      user    system   elapsed
##  2611.492   323.441 51129.936

cv_plot_gflasso(CV)
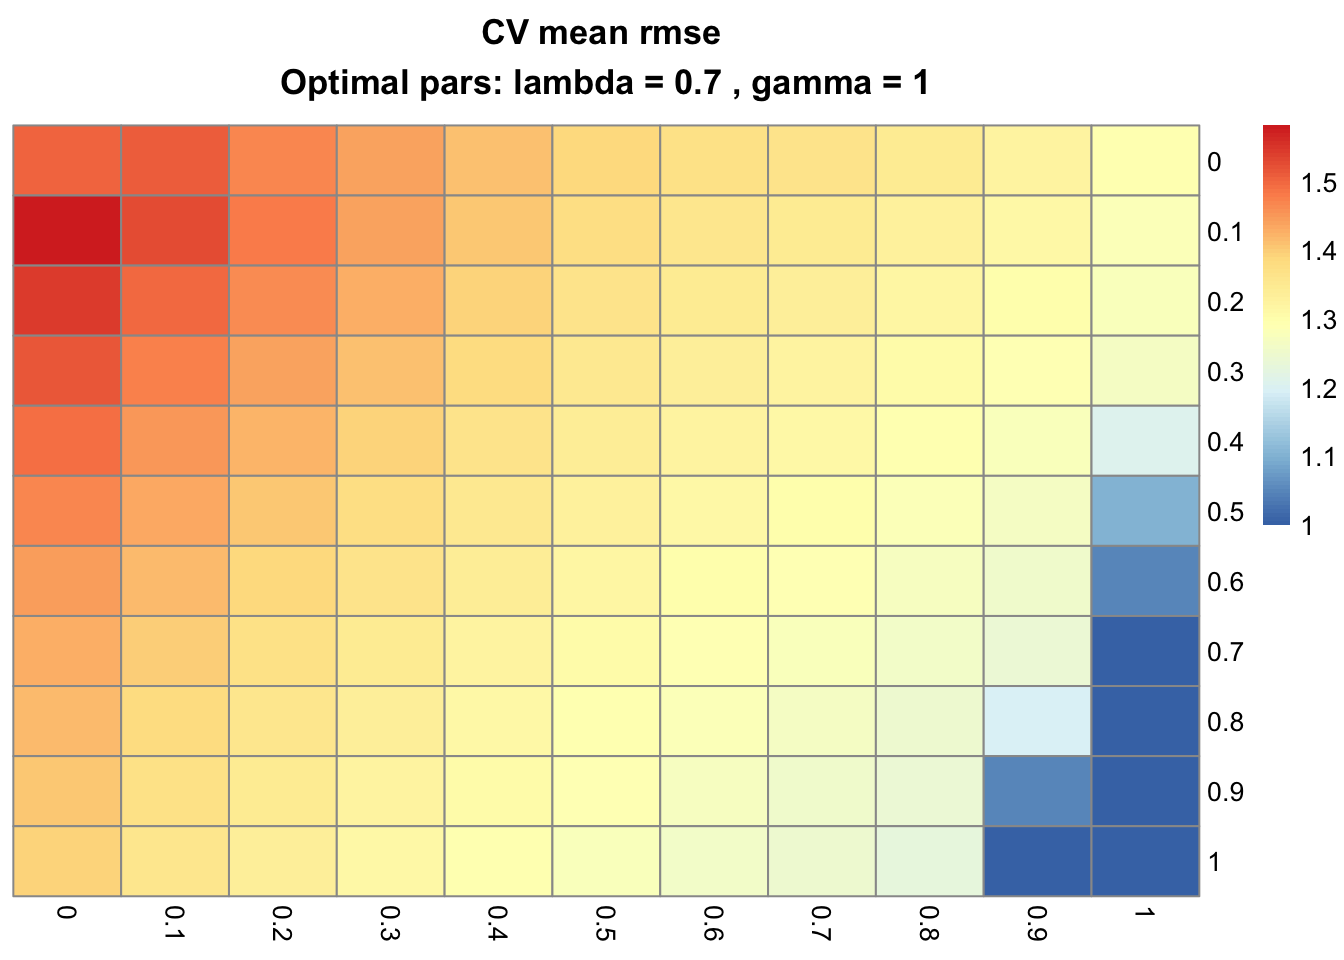
Dengan menantang GFLASSO menggunakan model LASSO murni (γ = 0, kolom pertama), pure fusion least squares (λ = 0, baris pertama) dan OLS (γ = 0 dan λ = 0, sel kiri atas), kita dapat menyimpulkan bahwa contoh ini paling baik dimodelkan dengan bobot penalti non-nol dan, konsekuensinya, dengan GFLASSO penuh. Ambil parameter CV optimal (λ = 0,7 dan γ = 1) untuk membangun model GFLASSO dan interpretasikan matriks koefisien yang dihasilkan:
gfMod <- gflasso(X = scale(SNP), Y = scale(BM), R = DS, opts = list(lambda = CV$optimal$lambda,
                                                                    gamma = CV$optimal$gamma,
                                                                    delta_conv = 1e-5,
                                                                    iter_max = 1e5))
colnames(gfMod$B) <- colnames(BM)
pheatmap(gfMod$B, annotation_row = data.frame("Gene" = bgsmtr_example_data$SNP_groups,
                                              row.names = rownames(gfMod$B)),
         show_rownames = F)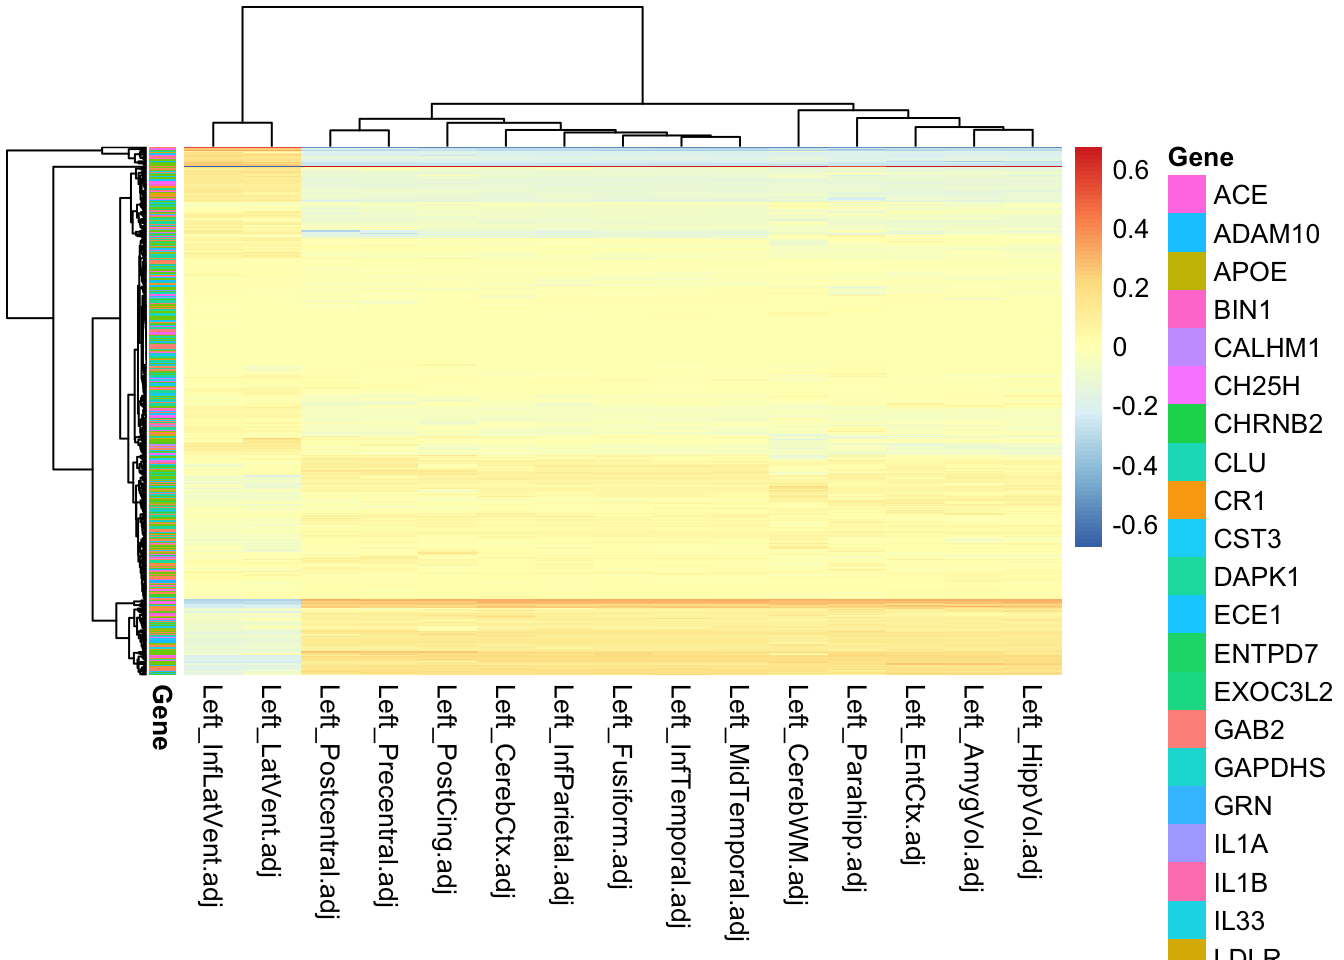
Gambar di atas memperlihatkan proporsi yang sangat besar dari koefisien bernilai nol atau mendekati nol. Meskipun tidak ada pengelompokan SNP yang jelas terhadap gen (lihat anotasi baris, perhatikan legenda tidak lengkap), ada asosiasi yang jelas antara SNP tertentu dan sifat.
Untuk memastikan keberadaan mekanisme prediktif non-acak, Anda dapat mengulangi prosedur setelah melakukan permutasi nilai pada X atau Y. Pekerjaan eksperimental dapat membantu menjelaskan kausalitas dan mekanisme dari SNP terpilih. Misalnya, SNP yang memengaruhi urutan dan struktur protein, sehingga mengganggu pembersihan plak β-Amiloid yang mendasari penyakit Alzheimer.
GFLASSO menerapkan regularisasi dan fusi saat memodelkan banyak respons, sehingga memudahkan identifikasi asosiasi antara prediktor (X) dan respons (Y). Metode ini paling baik digunakan saat menangani data berdimensi tinggi dari observasi yang sangat sedikit, karena jauh lebih lambat dibanding metode tandingan. Sparse conditional Gaussian graphical models [4] dan Bayesian group-sparse multi-task regression model [5], misalnya, mungkin lebih disukai terutama karena peningkatan kinerja. Namun demikian, GFLASSO sangat mudah ditafsirkan. Baru-baru ini saya menggunakan GFLASSO dalam pendekatan integratif omik untuk mengungkap gen lipid baru pada jagung [6].
Lihat juga Tutorial Regularisasi: Ridge, Lasso, dan Elastic Net dari DataCamp.
Kris dan saya akan sangat senang mendengar kabar dari Anda. Proyek ini saat ini dikelola oleh Kris di repo krisrs1128/gflasso dan juga melalui repo saya, meski sering berubah, di monogenea/gflasso. Silakan hubungi kapan saja (francisco.lima278@gmail.com), semua masukan sangat kami hargai.
Selamat ngoding!
Kursus R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



