
Last chance! 50% off DataCamp Premium
Sale ends in
जहाँ मशीन लर्निंग का क्षेत्र अधिकाधिक उन्नत तकनीकों के विकास के साथ तेज़ी से आगे बढ़ रहा है, वहीं एक साथ कई प्रतिक्रियाओं की भविष्यवाणी करने वाले उच्च-आयामी मल्टी-टास्क समस्याओं पर अपेक्षाकृत कम ध्यान दिया गया है। यह ट्यूटोरियल एकल नियतांकित लिनीयर रिग्रेशन रूपरेखा के अंतर्गत एकाधिक प्रतिक्रियाओं की भविष्यवाणी में ग्राफ-गाइडेड फ़्यूज्ड LASSO (GFLASSO) की शक्ति दर्शाएगा।
सुपरवाइज्ड लर्निंग में, आम तौर पर उद्देश्य एक सेट के स्पष्टीकरण चर या प्रेडिक्टर्स से एक आश्रित या प्रतिक्रिया चर की भविष्यवाणी करना होता है, जो नमूनों या प्रेक्षणों के एक सेट पर मापा गया हो। नियमितीकरण विधियाँ ऐसी पेनल्टी जोड़ती हैं जो उच्च-आयामी डेटा के ओवरफिटिंग को रोकती हैं, विशेषकर तब जब प्रेडिक्टर्स की संख्या प्रेक्षणों से अधिक हो। ये पेनल्टी उद्देश्य फ़ंक्शन में जोड़ी जाती हैं ताकि गैर-सूचनात्मक प्रेडिक्टर्स (जो त्रुटि को न्यूनतम करने में बहुत कम योगदान देते हैं) के गुणांक आकलन स्वयं कम हो जाएँ। लिस्ट एब्सोल्यूट श्रिंकेज ऐंड सेलेक्शन ऑपरेटर (LASSO) [1] ऐसी ही एक विधि है।
साधारण लिस्ट स्क्वेयर्स (OLS) की तुलना में, LASSO गुणांक आकलनों (β) को ठीक-ठीक शून्य तक सिकोड़ सकता है, इस प्रकार गैर-सूचनात्मक प्रेडिक्टर्स को बाहर कर फीचर चयन करता है, इस प्रकार:
$$argmin_\beta \sum_n(y_n-\hat{y_n})^2+\lambda\sum_{j}|\beta_{j}|$$
जहाँ n और j क्रमशः किसी दिए गए प्रेक्षण और प्रेडिक्टर को दर्शाते हैं। रेजिडुअल सम ऑफ स्क्वेयर्स (RSS), जो OLS में प्रयुक्त एकमात्र पद है, को बीजीय रूप में समतुल्य रूप से लिखा जा सकता है: $RSS = \sum_n(y_n-\hat{y_n})^2 = (y-X\beta)^T.(y-X\beta)$। LASSO पेनल्टी λ∑j|βj| है, जो λ द्वारा भारित गुणांकों का L1 नॉर्म है।
यदि आप एक सामान्य प्रेडिक्टर्स सेट से एक साथ कई आपस में संबंधित प्रतिक्रियाओं की भविष्यवाणी करना चाहें तो? यद्यपि व्यवहार में आप प्रत्येक प्रतिक्रिया के लिए एक स्वतंत्र LASSO मॉडल से भी ठीक-ठाक कर सकते हैं, प्रतिक्रियाओं के बीच संबद्धता की शक्ति के अनुरूप उन भविष्यवाणियों का समन्वय करना बेहतर रहेगा। ऐसा समन्वय प्रतिक्रिया-विशिष्ट विविधता, जिसमें शोर शामिल होता है, को रद्द करने में सहायक होता है—यही GFLASSO की प्रमुख ताकत है।
मूल लेख में एक अच्छा उदाहरण दिया गया है, जिसमें लेखकों ने 543 रोगियों में 34 आनुवंशिक मार्करों और 53 अस्थमा लक्षणों के बीच संघों का विश्लेषण किया [2]।
मान लें X आकार n × p का एक मैट्रिक्स है, जिसमें n प्रेक्षण और p प्रेडिक्टर्स हैं, और Y आकार n × k का एक मैट्रिक्स है, जिसमें वही n प्रेक्षण और k प्रतिक्रियाएँ हैं, मान लें 73 देशों में 1390 भिन्न इलेक्ट्रॉनिक्स खरीद रिकॉर्ड, जिनसे सभी 73 देशों में 50 Netflix प्रोडक्शंस की रेटिंग्स की भविष्यवाणी करनी है।
उच्च-आयामी डेटासेट की जोड़ियों के मॉडलिंग के लिए उपयुक्त मॉडल्स में ऑर्थोगोनल टू-वे पार्टियल लीस्ट स्क्वेयर्स (O2PLS), कैनॉनिकल कोरिलेशन एनालिसिस (CCA) और को-इनेर्शिया एनालिसिस (CIA) शामिल हैं, जो सभी मैट्रिक्स डीकंपोज़िशन पर आधारित हैं [3]। साथ ही, चूँकि ये मॉडल लैटेंट वेरिएबल्स पर आधारित होते हैं (यानी, मूल प्रेडिक्टर्स पर आधारित प्रोजेक्शन्स), इसलिए संगणनात्मक दक्षता व्याख्येयता की क़ीमत पर आती है।
हालाँकि, यह समझौता हर बार लाभकारी नहीं होता, और इसे इस तरह पलटा जा सकता है कि X में चयनित फीचर्स से k व्यक्तिगत प्रतिक्रियाओं की सीधे भविष्यवाणी की जाए, एकीकृत रिग्रेशन रूपरेखा में जो प्रतिक्रियाओं के पारस्परिक संबंधों को ध्यान में रखती है।
गणितीय रूप से, GFLASSO ऊपर चर्चा किए गए LASSO [1] के नियमितीकरण को अपनाता है और Y के अंतर्निहित ग्राफ निर्भरता संरचना पर मॉडल बनाता है, जिसे k × k सहसंबंध मैट्रिक्स द्वारा मापा जाता है (यही ‘संबद्धता की शक्ति’ है जिसके बारे में आपने पहले पढ़ा)। परिणामस्वरूप, मिलते-जुलते (या असमान) प्रतिक्रियाएँ समान (या असमान) चयनित प्रेडिक्टर्स के उपसमूह द्वारा समझाई जाएँगी।
और अधिक औपचारिक रूप से, तथा मूल पांडुलिपि [2] में प्रयुक्त संकेतन का अनुसरण करते हुए, GFLASSO का उद्देश्य फ़ंक्शन है
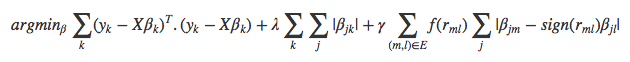
जहाँ, सभी k प्रतिक्रियाओं पर, ∑k(yk − X**βk)T.(yk − X**βk) RSS प्रदान करता है और λ∑k∑j|βj**k| LASSO से ली गई नियमितीकरण पेनल्टी है, जो पैरामीटर λ द्वारा भारित है और प्रत्येक व्यक्तिगत प्रेडिक्टर j के गुणांकों β पर कार्य करती है। GFLASSO की नवीनता निहित है
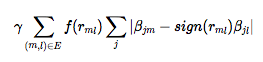
उस फ़्यूज़न पेनल्टी में जो γ द्वारा भारित है और यह सुनिश्चित करती है कि किसी भी प्रेडिक्टर j तथा प्रतिक्रियाओं की किसी जोड़ी m और l से आने वाले गुणांकों βj**m और βj**l के बीच का परास अपसोल्यूट अंतर, जितना अधिक उनका युग्मिक सहसंबंध सकारात्मक होगा (क्रमशः जितना अधिक नकारात्मक होगा), उतना ही छोटा (क्रमशः बड़ा) होगा, चाहे रूपांतरित हो या न हो, f(rm**l)। यह फ़्यूज़न पेनल्टी प्रतिक्रियाओं में वैश्विक रूप से सार्थक विविधता को प्रत्येक से आने वाले शोर पर वरीयता देती है। जब युग्मिक सहसंबंध शून्य के निकट हो, तो यह कुछ नहीं करती, और ऐसी स्थिति में आपके पास शुद्ध LASSO रह जाता है। सभी k प्रतिक्रियाओं की यह अंतर्निहित सहसंबंध संरचना, जिसे एक वेटेड नेटवर्क संरचना के रूप में दर्शाया जा सकता है, डिफ़ॉल्ट रूप से अपसोल्यूट कोरिलेशन होती है, f(rm**l)=|rm**l|, लेकिन इसे उपयोगकर्ता-निर्दिष्ट किसी भी फ़ंक्शन से रूपांतरित कर GFLASSO के विभिन्न प्रकार बनाए जा सकते हैं, जैसे
और नवाचार की भरपूर संभावनाएँ हैं। यद्यपि 2. गणनात्मक रूप से 1. और डिफ़ॉल्ट अपसोल्यूट कोरिलेशन [2] की तुलना में बहुत कम महँगी है, यह एक पूर्वनिर्धारित कटऑफ की माँग करती है, उदाहरण के लिए, τ = 0.8।
संक्षेप में, GFLASSO मॉडल फिट करने के लिए आपको एक प्रेडिक्टर मैट्रिक्स X, एक प्रतिक्रिया मैट्रिक्स Y और Y की सभी प्रतिक्रियाओं के युग्मों के बीच संबद्धता की शक्ति दर्शाने वाला एक सहसंबंध मैट्रिक्स चाहिए। ध्यान दें कि GFLASSO p × k आकार का β मैट्रिक्स देता है, जबकि LASSO (p × 1) देता है, और यह गुणांक मैट्रिक्स किसी भी दी गई प्रतिक्रिया k और प्रेडिक्टर j के बीच के संघों को वहन करता है।
Kris Sankaran और मैं एक प्रायोगिक R पैकेज पर काम कर रहे हैं जो GFLASSO को क्रॉस-वैलिडेशन और प्लॉटिंग विधियों के साथ लागू करता है। हमने हाल ही में doParallel पैकेज का उपयोग करते हुए मल्टी-थ्रेडिंग लागू की है, जिससे क्रॉस-वैलिडेशन (CV) प्रक्रियाएँ काफी तेज़ हो गई हैं।
R में GFLASSO चलाने के लिए आपको devtools इंस्टॉल करना होगा, उसे लोड करना होगा और मेरे GitHub रेपो से gflasso पैकेज इंस्टॉल करना होगा। डेमोंस्ट्रेशन पैकेज bgsmtr में निहित एक डेटासेट पर किया जाएगा। परिणामों के विज़ुअलाइज़ेशन के लिए मैं corrplot और pheatmap भी स्थापित करने की अनुशंसा करता हूँ।
# Install the packages if necessary
#install.packages("devtools")
#install.packages("bgsmtr")
#install.packages("corrplot")
#install.packages("pheatmap")
library(devtools)
library(bgsmtr)
library(corrplot)
library(pheatmap)
#install_github("monogenea/gflasso")
library(gflasso)आप आसानी से cv_gflasso() CV फ़ंक्शन के हेल्प पेज में उल्लिखित सिमुलेशन चला सकते हैं। डिफ़ॉल्ट रूप से, CV एक 5-फोल्ड CV के एकल रिपीटेशन पर रूट मीन स्क्वेयर्ड एरर (RMSE) की गणना करता है, सभी संभावित युग्मों पर जहाँ λ ∈ {0, 0.1, 0.2, ..., 0.9, 1} और γ ∈ {0, 0.1, 0.2, ..., 0.9, 1}, यही ट्यूनिंग ग्रिड है।
नोट कि उपयोगकर्ता द्वारा प्रदान किए गए एरर फ़ंक्शन भी काम करेंगे!
आंतरिक सांख्यिकीय मान्यताओं और गति प्रदर्शन के अलावा, ट्यूनिंग ग्रिड की सीमाएँ काफी हद तक X और Y की सभी कॉलम्स का मीन-सेंटरिंग और यूनिट-वैरिएंस स्केलिंग करने पर निर्भर करती हैं, इसलिए कृपया पहले यह सुनिश्चित करें।
निम्नलिखित उदाहरण में इसकी ज़रूरत नहीं पड़ेगी, क्योंकि आप मानक सामान्य वितरण से रैंडम सैम्पल खींचेंगे। आप 0.8 के कटऑफ के साथ एक अनवेटेड कोरिलेशन नेटवर्क से फ़्यूज़न पेनल्टी निकालने की कोशिश कर सकते हैं, जहाँ r > 0.8:
?cv_gflasso
set.seed(100)
X <- matrix(rnorm(100 * 10), 100, 10)
u <- matrix(rnorm(10), 10, 1)
B <- u %*% t(u) + matrix(rnorm(10 * 10, 0, 0.1), 10, 10)
Y <- X %*% B + matrix(rnorm(100 * 10), 100, 10)
R <- ifelse(cor(Y) > .8, 1, 0)
system.time(testCV <- cv_gflasso(X, Y, R, nCores = 1))

## [1] 1.826146 1.819430 1.384595 1.420058 1.408619

##    user  system elapsed
##  45.808   3.070  55.271

system.time(testCV <- cv_gflasso(X, Y, R, nCores = 2))

## [1] 1.595413 1.492953 1.469917 1.366832 1.441642

##    user  system elapsed
##  22.231   1.698  26.441

cv_plot_gflasso(testCV)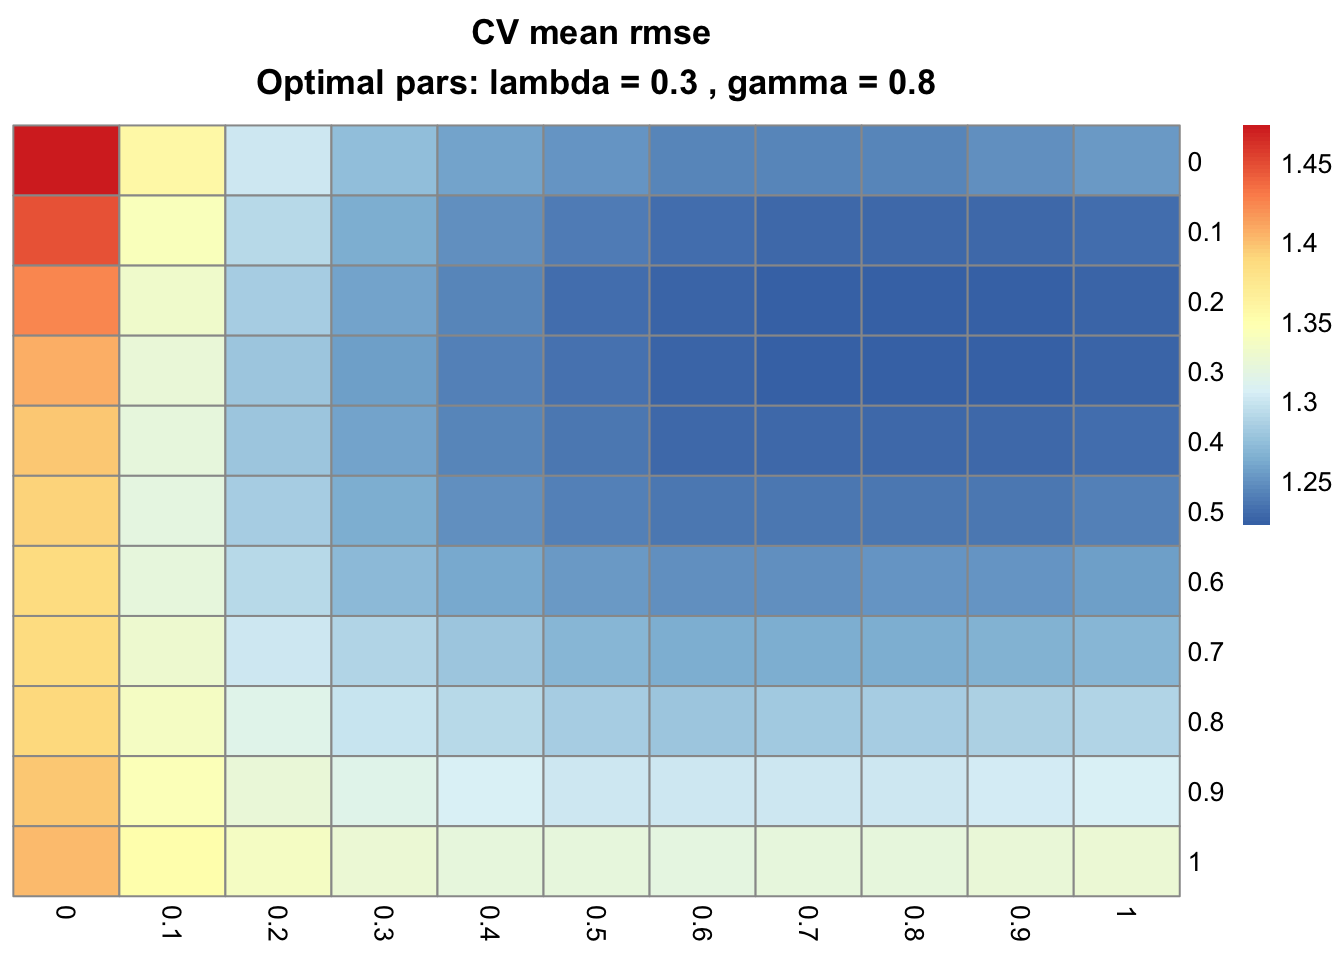
इस सिमुलेशन में RMSE को न्यूनतम करने वाले λ (पंक्तियाँ) और γ (स्तंभ) के इष्टतम मान क्रमशः 0.3 और 0.8 हैं, जो लगाए गए संबंधों को कैप्चर करते हैं।
टिप: इस उदाहरण को एक अलग मीट्रिक, निर्धारण गुणांक (R2) के साथ दोबारा चलाने का प्रयास करें। R2 का एक प्रमुख लाभ यह है कि यह 0 से 1 के बीच रहता है।
ध्यान रखें कि जब आप एक कस्टम गुडनेस-ऑफ-फिट फ़ंक्शन err_fun() प्रदान करते हैं, तो आपको तर्क err_opt का उपयोग करके यह परिभाषित करना होगा कि प्राप्त मीट्रिक को अधिकतम करना है या न्यूनतम।
निम्न उदाहरण का उद्देश्य वेटेड एसोसिएशन नेटवर्क के साथ वर्गित सहसंबंध गुणांक (अर्थात f(rm**l)=rm**l2)) का उपयोग करते हुए R2 को अधिकतम करना है। यदि आपके पास 2 से अधिक कोर हैं, तो आप nCores तर्क को बदलकर गति बढ़ा सकते हैं!
# Write R2 function
R2 <- function(pred, y){
      cor(as.vector(pred), as.vector(y))**2
}

# X, u, B and Y are still in memory
R <- cor(Y)**2

# Change nCores, if you have more than 2, re-run CV
testCV <- cv_gflasso(X, Y, R, nCores = 2, err_fun = R2, err_opt = "max")

## [1] 0.6209191 0.7207394 0.7262781 0.7193907 0.6303187

cv_plot_gflasso(testCV)
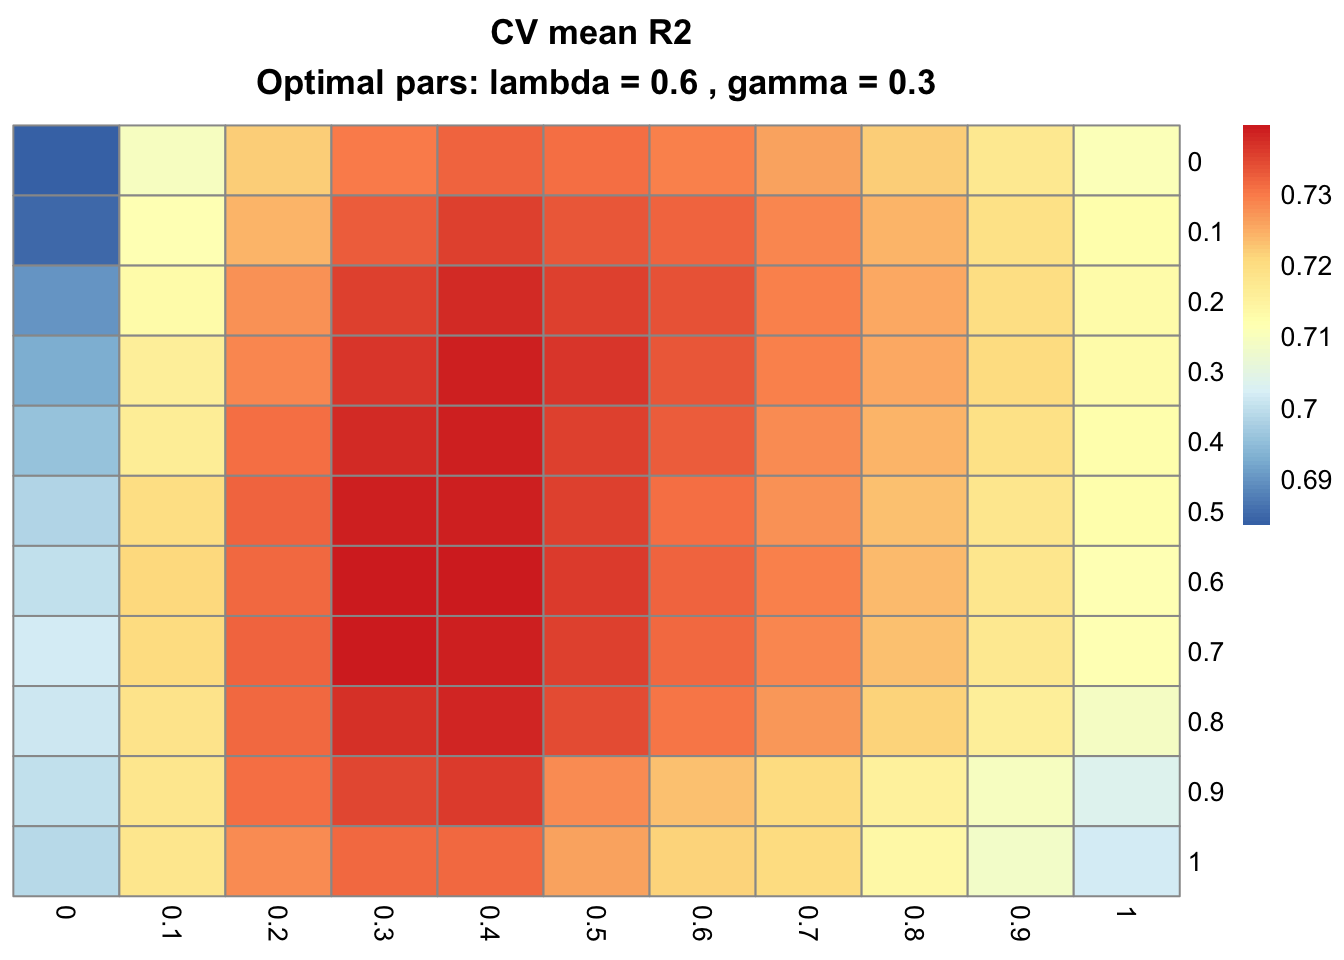
अब λ और γ के इष्टतम पैरामीटर क्रमशः 0.6 और 0.3 हैं।
साथ ही, ध्यान दें कि cv_gflasso ऑब्जेक्ट्स चार तत्वों वाली एकल लिस्ट होते हैं: ग्रिड की सभी कोशिकाओं पर मीट्रिक का औसत ($mean) और मानक त्रुटि ($SE), इष्टतम λ और γ पैरामीटर ($optimal) तथा गुडनेस-ऑफ-फिट फ़ंक्शन का नाम ($err_fun)। वर्तमान उदाहरण से क्रॉस-वैलिडेटेड मॉडल स्पष्ट रूप से विरलता (λ) और फ़्यूज़न (γ) दोनों का पक्षधर है।
अंत में, ध्यान रखें कि आप अतिरिक्त पैरामीटर्स को फाइन-ट्यून कर सकते हैं, जैसे Nesterov के ग्रेडिएंट अभिसरण थ्रेशोल्ड δ और अधिकतम इटरेशनों की संख्या, जिन्हें क्रमशः delta_conv और iter_max के रूप में additionalOpts को पास किया जा सकता है। इनका उपयोग अगले उदाहरण में किया जाएगा।
GFLASSO की सरलता और मज़बूती को अपेक्षाकृत उच्च-आयामी समस्या में प्रदर्शित करने के लिए, आप आगे bgsmtr_example_data डेटासेट्स का मॉडल बनाएँगे, जो Alzheimer’s Disease Neuroimaging Initiative (ADNI-1) डेटाबेस से प्राप्त हैं।
यह bgsmtr पैकेज का 3-तत्वों वाला लिस्ट ऑब्जेक्ट है, जिसमें 15 स्ट्रक्चरल न्यूरोइमेजिंग माप और 486 सिंगल न्यूक्लियोटाइड पॉलिमॉर्फिज़्म (SNPs, आनुवंशिक मार्कर) शामिल हैं, जो 632 विषयों के सैम्पल से निर्धारित हुए हैं। महत्वपूर्ण रूप से, ये 486 SNPs 33 जीनों को कवर करते हैं जिन्हें Alzheimer’s रोग से संबद्ध माना गया है।
आपका कार्य SNP डेटा से आकृति-विज्ञान संबंधी, न्यूरोइमेजिंग मापों की भविष्यवाणी करना है, जिसमें पूर्ववर्ती के सहसंबंध संरचना का लाभ उठाना है।
आइए डेटा को व्यवस्थित करने और सभी न्यूरोइमेजिंग फीचर्स के पारस्परिक-निर्भरताओं का अन्वेषण करने से शुरू करें:
data(bgsmtr_example_data)
str(bgsmtr_example_data)

## List of 3
##  $ SNP_data     : int [1:486, 1:632] 2 0 2 0 0 0 0 1 0 1 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:486] "rs4305" "rs4309" "rs4311" "rs4329" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...
##  $ SNP_groups   : chr [1:486] "ACE" "ACE" "ACE" "ACE" ...
##  $ BrainMeasures: num [1:15, 1:632] 116.5 4477.9 28631.9 34.1 -473.4 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:15] "Left_AmygVol.adj" "Left_CerebCtx.adj" "Left_CerebWM.adj" "Left_HippVol.adj" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...

# Transpose, so that samples are distributed as rows, predictors / responses as columns
SNP <- t(bgsmtr_example_data$SNP_data)
BM <- t(bgsmtr_example_data$BrainMeasures)

# Define dependency structure
DS <- cor(BM)

# Plot correlation matrix of the 15 neuroimaging measures
corrplot(DS)
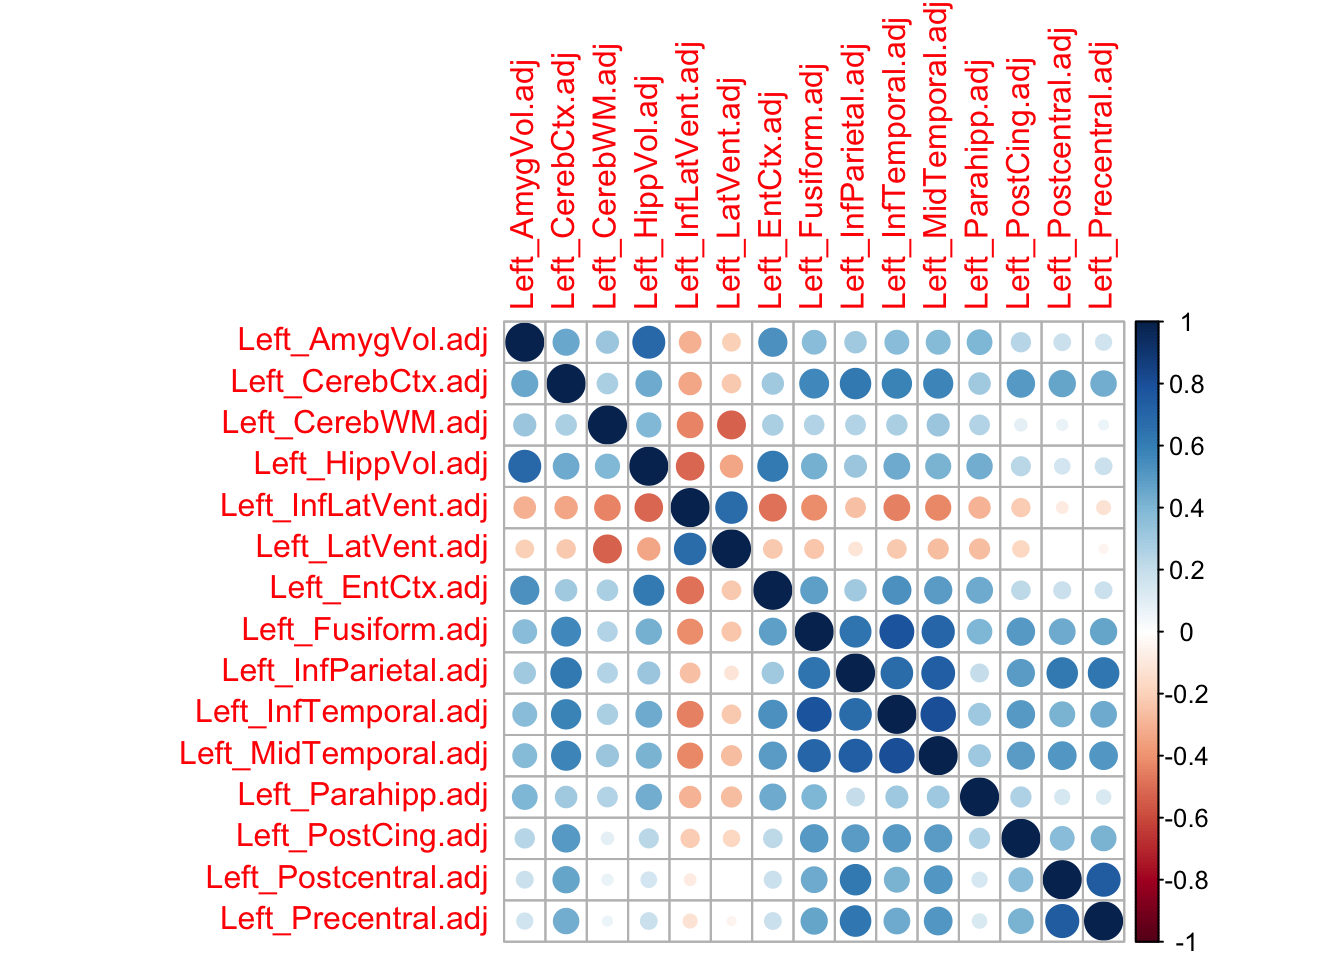
ऊपर दिया गया चित्र न्यूरोइमेजिंग फीचर्स के बीच पारस्परिक निर्भरताओं की ओर संकेत करता है। अब GFLASSO का क्रॉस-वैलिडेशन आज़माएँ (लैपटॉप पर कुछ घंटे लग सकते हैं!) और SNP-न्यूरोइमेजिंग संघों का निर्धारण करें।
नोट कि नीचे के उदाहरण में अभिसरण सहनशीलता और अधिकतम इटरेशनों की संख्या निर्दिष्ट है। निःसंकोच अपने स्तर पर भिन्न मान आज़माएँ!
system.time(CV <- cv_gflasso(X = scale(SNP), Y = scale(BM), R = DS, nCores = 2,
                 additionalOpts = list(delta_conv = 1e-5, iter_max = 1e5)))

## [1] 1.550294 1.471637 1.470133 1.514425 1.504215

##      user    system   elapsed
##  2611.492   323.441 51129.936

cv_plot_gflasso(CV)
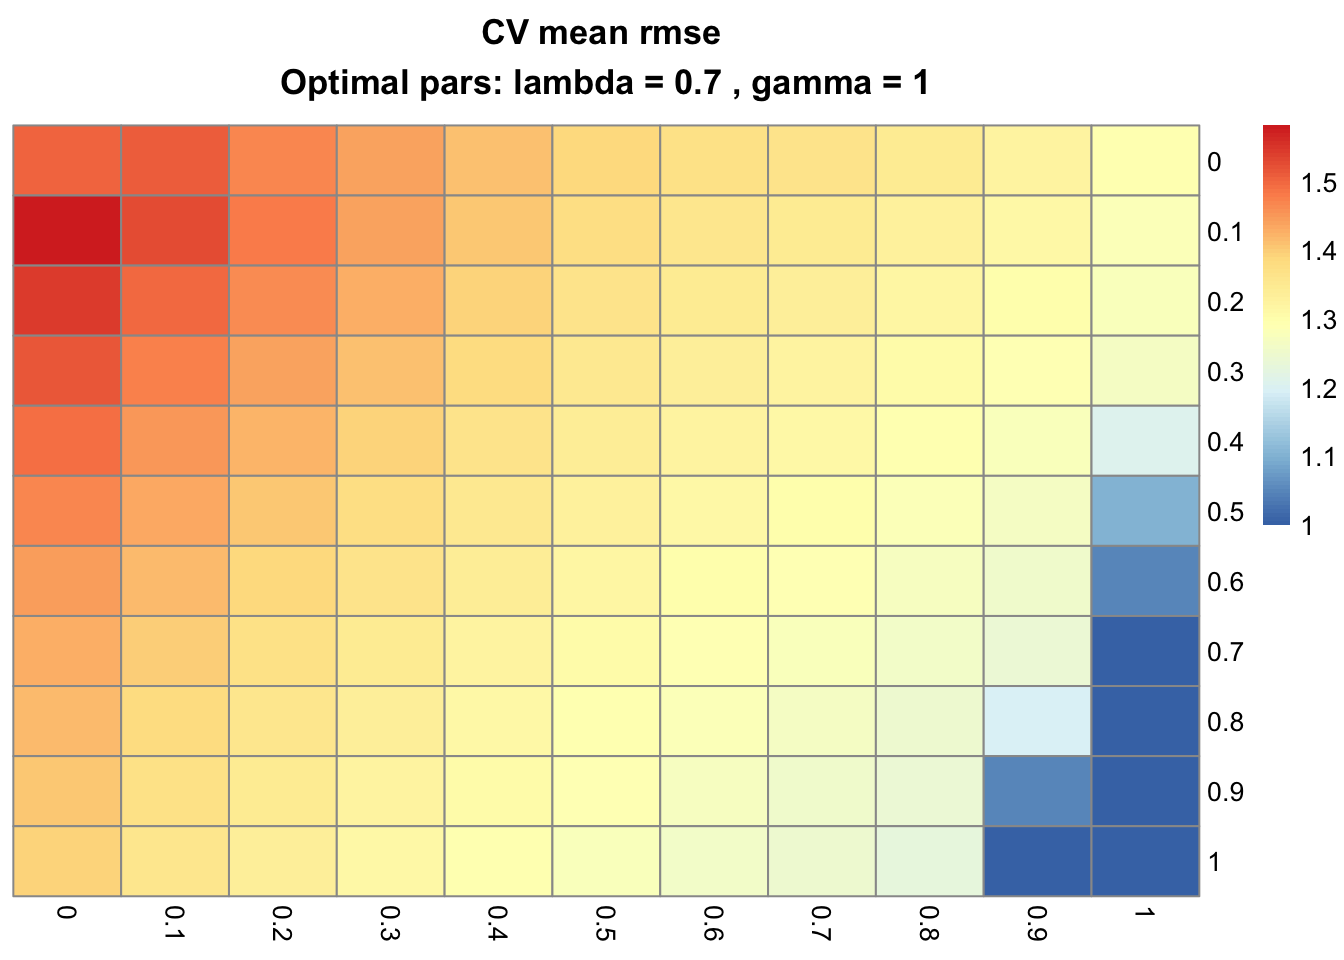
GFLASSO को शुद्ध LASSO मॉडलों (γ = 0, पहला स्तंभ), शुद्ध फ़्यूज़न लिस्ट स्क्वेयर्स (λ = 0, पहली पंक्ति) और OLS (&gamma = 0 और λ = 0, ऊपरी-बाएँ सेल) के साथ चुनौती देकर, हम निष्कर्ष निकाल सकते हैं कि वर्तमान उदाहरण गैर-शून्य पेनल्टी वेट्स और परिणामी रूप से पूर्ण GFLASSO के साथ सर्वश्रेष्ठ रूप से मॉडल होता है। इष्टतम CV पैरामीटर्स (λ = 0.7 और γ = 1) लेकर एक GFLASSO मॉडल बनाएँ और परिणामी गुणांक मैट्रिक्स की व्याख्या करें:
gfMod <- gflasso(X = scale(SNP), Y = scale(BM), R = DS, opts = list(lambda = CV$optimal$lambda,
                                                                    gamma = CV$optimal$gamma,
                                                                    delta_conv = 1e-5,
                                                                    iter_max = 1e5))
colnames(gfMod$B) <- colnames(BM)
pheatmap(gfMod$B, annotation_row = data.frame("Gene" = bgsmtr_example_data$SNP_groups,
                                              row.names = rownames(gfMod$B)),
         show_rownames = F)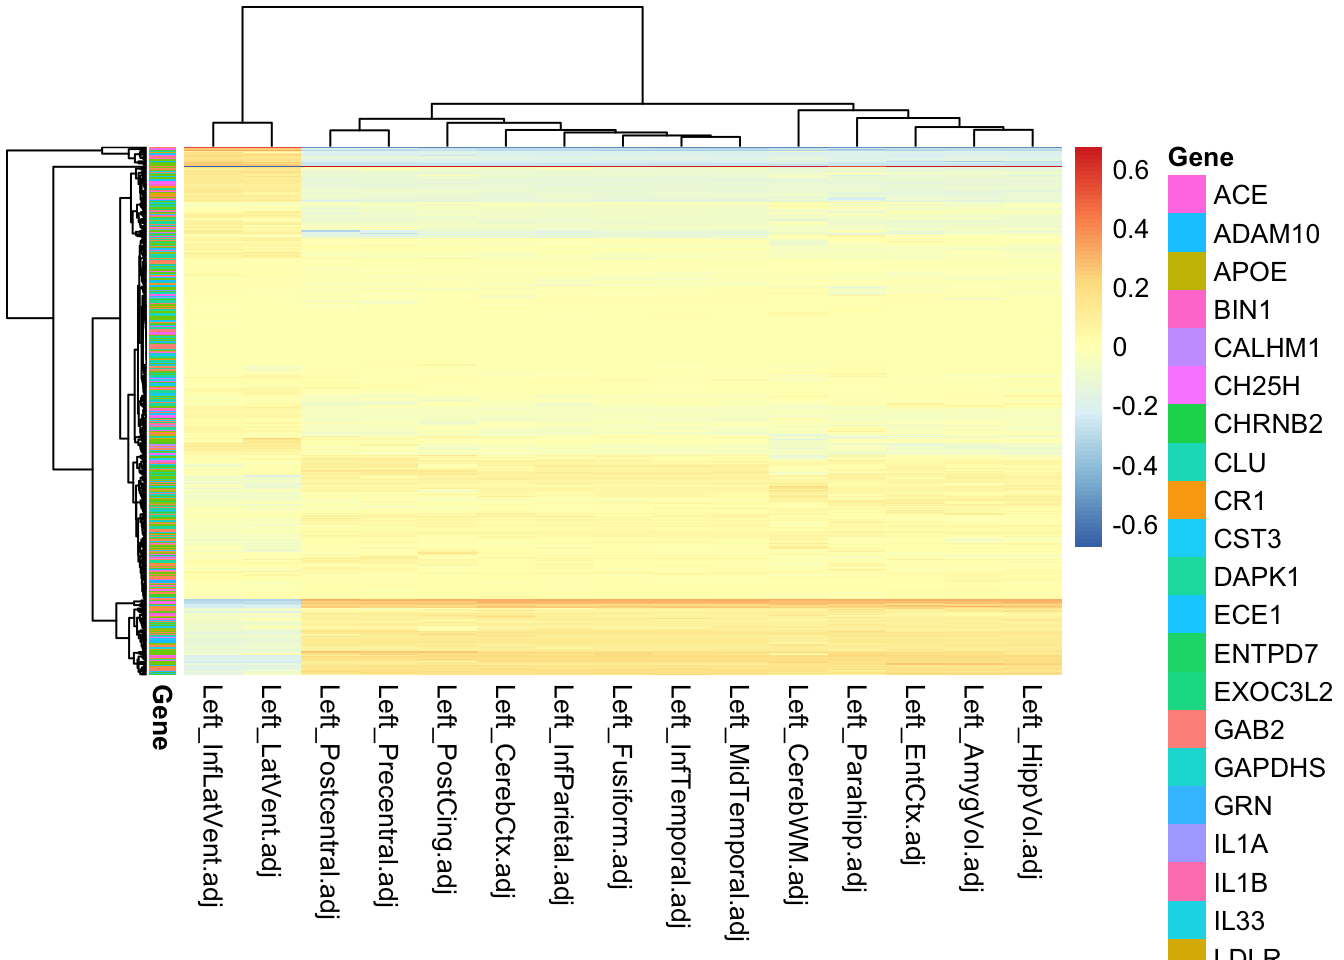
ऊपर का चित्र शून्य या निकट-शून्य मानों वाले गुणांकों के बहुत बड़े अनुपात को दर्शाता है। यद्यपि जीनों के संबंध में SNPs का कोई स्पष्ट क्लस्टरिंग नहीं दिखता (पंक्ति-वार एनोटेशन देखें, ध्यान दें कि लैजेंड अधूरा है), फिर भी कुछ SNPs और लक्षणों के बीच स्पष्ट संघ हैं।
एक गैर-रैंडम भविष्यसूचक तंत्र के अस्तित्व को परखने के लिए, आप अगला चरण X या Y में मानों के परम्यूटेशन के बाद यही प्रक्रिया दोहरा सकते हैं। चयनित SNPs से कारणता और तंत्रों को स्पष्ट करने में प्रायोगिक कार्य सहायक हो सकता है। उदाहरण के लिए, ऐसे SNPs जो प्रोटीन अनुक्रम और संरचना को प्रभावित करते हैं, जिससे Alzheimer’s रोग के अधिष्ठान β-Amyloid प्लाक्स की निकासी बाधित होती है।
GFLASSO अनेक प्रतिक्रियाओं का मॉडल बनाते समय नियमितीकरण और फ़्यूज़न दोनों का प्रयोग करता है, जिससे प्रेडिक्टर्स (X) और प्रतिक्रियाओं (Y) के बीच संघों की पहचान आसान हो जाती है। यह विशेष रूप से तब उपयुक्त है जब बहुत कम प्रेक्षणों से अत्यधिक आयाम वाले डेटा को संभालना हो, क्योंकि यह प्रतिस्पर्धी तरीकों की तुलना में काफ़ी धीमा है। उदाहरण के लिए, स्पार्स कंडीशनल गॉसियन ग्राफिकल मॉडल्स [4] और बेयज़ियन ग्रुप-स्पार्स मल्टी-टास्क रिग्रेशन मॉडल [5] मुख्यतः प्रदर्शन लाभों के कारण वरीय हो सकते हैं। फिर भी, GFLASSO अत्यधिक व्याख्येय है। मैंने हाल ही में मक्का में नए लिपिड जीन खोजने के लिए समय-समाधित मल्टी-ओमिक्स डेटा के साथ एक ओमिक्स-इंटीग्रेटिव दृष्टिकोण में GFLASSO का उपयोग किया [6]।
DataCamp का नियमितीकरण ट्यूटोरियल: Ridge, Lasso और Elastic Net देखें।
Kris और मैं आपसे सुनकर बहुत प्रसन्न होंगे। यह परियोजना वर्तमान में Kris द्वारा रेपो krisrs1128/gflasso के अंतर्गत मेंटेन की जाती है और मेरे रेपो पर भी, हालाँकि अक्सर बदलाव होते रहते हैं, monogenea/gflasso पर। मुझे कभी भी लिखें (francisco.lima278@gmail.com), हर तरह की प्रतिक्रिया का स्वागत है।
हैप्पी कोडिंग!
R पाठ्यक्रम
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}