Cours
Introduction à R
4 h
3.1M
Alors que le machine learning progresse à vive allure avec des techniques toujours plus sophistiquées, peu d’attention est portée aux problèmes multi‑tâches en grande dimension qui requièrent la prédiction simultanée de plusieurs réponses. Ce tutoriel vous montre la puissance du Graph-Guided Fused LASSO (GFLASSO) pour prédire plusieurs réponses au sein d’un unique cadre de régression linéaire régularisée.
En apprentissage supervisé, l’objectif est généralement de prédire une variable dépendante (ou réponse) à partir d’un ensemble de variables explicatives (ou prédicteurs) sur un ensemble d’observations. Les méthodes de régularisation introduisent des pénalités qui évitent le surapprentissage sur des données de grande dimension, en particulier lorsque le nombre de prédicteurs dépasse celui des observations. Ces pénalités sont ajoutées à la fonction objectif de sorte que les coefficients des prédicteurs peu informatifs (qui contribuent peu à la minimisation de l’erreur) soient eux‑mêmes minimisés. Le least absolute shrinkage and selection operator (LASSO) [1] est l’une de ces méthodes.
Comparé aux moindres carrés ordinaires (OLS), le LASSO peut contracter des estimations de coefficients (β) exactement à zéro, éliminant ainsi les prédicteurs non informatifs et réalisant une sélection de variables, via
$$argmin_\beta \sum_n(y_n-\hat{y_n})^2+\lambda\sum_{j}|\beta_{j}|$$
où n et j désignent respectivement une observation et un prédicteur quelconques. La somme des carrés des résidus (RSS), seul terme utilisé en OLS, peut aussi s’écrire algébriquement $RSS = \sum_n(y_n-\hat{y_n})^2 = (y-X\beta)^T.(y-X\beta)$. La pénalité LASSO est λ∑j|βj|, la norme L1 des coefficients pondérée par λ.
Et si vous deviez prédire simultanément plusieurs réponses liées à partir d’un même ensemble de prédicteurs ? Bien que vous puissiez entraîner plusieurs modèles LASSO indépendants, un par réponse, vous obtiendrez de meilleurs résultats en coordonnant ces prédictions selon l’intensité des associations entre réponses. Cette coordination atténue la variation spécifique à chaque réponse, notamment le bruit — un atout majeur du GFLASSO.
Un bon exemple est fourni dans l’article original, où les auteurs étudient les associations entre 34 marqueurs génétiques et 53 phénotypes de l’asthme chez 543 patients [2].
Soit X une matrice de taille n × p, avec n observations et p prédicteurs, et Y une matrice de taille n × k contenant les mêmes n observations et k réponses ; par exemple, 1 390 enregistrements d’achats d’électronique dans 73 pays, pour prédire les notes de 50 productions Netflix sur l’ensemble des 73 pays.
Parmi les modèles adaptés à des paires de jeux de données en grande dimension figurent l’orthogonal two-way Partial Least Squares (O2PLS), l’analyse canonique des corrélations (CCA) et la co‑inertie (CIA), qui reposent tous sur des décompositions matricielles [3]. En outre, comme ces modèles s’appuient sur des variables latentes (c’est‑à‑dire des projections des prédicteurs d’origine), leur efficacité de calcul se fait au détriment de l’interprétabilité.
Cet arbitrage n’est toutefois pas toujours payant et peut être évité en prédisant directement les k réponses à partir d’un sous‑ensemble de caractéristiques sélectionnées dans X, au sein d’un cadre unifié de régression tenant compte des relations entre réponses.
Mathématiquement, le GFLASSO reprend la régularisation du LASSO [1] décrite plus haut et construit le modèle sur la structure de dépendance en graphe sous‑jacente à Y, quantifiée par la matrice de corrélation k × k (c’est la « force d’association » évoquée précédemment). Ainsi, des réponses similaires (ou dissemblables) seront expliquées par un sous‑ensemble similaire (ou dissemblable) de prédicteurs sélectionnés.
Plus formellement, et en suivant la notation de l’article original [2], la fonction objectif du GFLASSO est
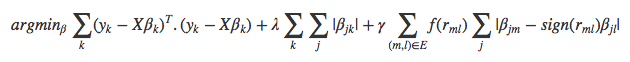
où, sur l’ensemble des k réponses, ∑k(yk − X**βk)T.(yk − X**βk) fournit le RSS et λ∑k∑j|βj**k| la pénalité de régularisation empruntée au LASSO, pondérée par λ et agissant sur les coefficients β de chaque prédicteur j. La nouveauté du GFLASSO réside dans
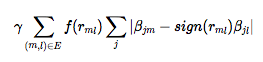
la pénalité de fusion, pondérée par γ, qui garantit que la différence absolue entre les coefficients βj**m et βj**l, pour un prédicteur j et une paire de réponses m et l, sera d’autant plus faible (resp. élevée) que leur corrélation par paire est plus positive (resp. plus négative), transformée ou non, f(rm**l). Cette pénalité de fusion favorise la variation globalement pertinente des réponses au détriment du bruit propre à chacune. Quand la corrélation par paire est proche de zéro, elle n’agit pas : on retombe alors sur un LASSO pur. Cette structure de corrélation sous‑jacente pour les k réponses, représentable en réseau pondéré, est par défaut la corrélation absolue, f(rm**l)=|rm**l|, mais peut être transformée pour créer des variantes du GFLASSO à l’aide de n’importe quelle fonction définie par l’utilisateur, par exemple :
avec une large marge pour l’innovation. Bien que l’option 2. soit bien moins coûteuse en calcul que 1. et que la corrélation absolue par défaut [2], elle nécessite un seuil prédéfini, par exemple τ = 0,8.
En résumé, pour ajuster un modèle GFLASSO, il vous faut une matrice de prédicteurs X, une matrice de réponses Y et une matrice de corrélation représentant la force d’association entre toutes les paires de réponses de Y. Notez que le GFLASSO produit une matrice de coefficients p × k (β), contrairement au LASSO (p × 1), et que cette matrice encode les associations entre une réponse k donnée et un prédicteur j.
Kris Sankaran et moi avons développé un package R expérimental qui implémente le GFLASSO, avec validation croisée et fonctions de visualisation. Nous avons récemment ajouté le multi‑threading via le package doParallel, ce qui accélère nettement les routines de validation croisée (CV).
Pour exécuter GFLASSO dans R, installez devtools, chargez‑le puis installez le package gflasso depuis mon dépôt GitHub. La démonstration s’appuie sur un jeu de données inclus dans le package bgsmtr. Nous vous recommandons aussi d’installer corrplot et pheatmap pour visualiser les résultats.
# Install the packages if necessary
#install.packages("devtools")
#install.packages("bgsmtr")
#install.packages("corrplot")
#install.packages("pheatmap")
library(devtools)
library(bgsmtr)
library(corrplot)
library(pheatmap)
#install_github("monogenea/gflasso")
library(gflasso)Vous pouvez facilement exécuter la simulation décrite dans l’aide de la fonction de CV cv_gflasso(). Par défaut, la CV calcule la root mean squared error (RMSE) sur une répétition d’une CV à 5 plis, pour toutes les paires possibles entre λ ∈ {0, 0.1, 0.2, ..., 0.9, 1} et γ ∈ {0, 0.1, 0.2, ..., 0.9, 1}, la grille d’ajustement.
Remarque : des fonctions d’erreur fournies par l’utilisateur sont également prises en charge !
Au‑delà des hypothèses statistiques et des performances, le choix des bornes de la grille dépend fortement du centrage‑réduction (moyenne 0, variance unitaire) de toutes les colonnes de X et Y. Veillez à le faire en amont.
Dans l’exemple suivant, ce ne sera pas nécessaire car vous tirerez des échantillons d’une loi normale standard. Vous pouvez tester une pénalité de fusion issue d’un réseau de corrélation non pondéré, avec un seuil r > 0,8 :
?cv_gflasso
set.seed(100)
X <- matrix(rnorm(100 * 10), 100, 10)
u <- matrix(rnorm(10), 10, 1)
B <- u %*% t(u) + matrix(rnorm(10 * 10, 0, 0.1), 10, 10)
Y <- X %*% B + matrix(rnorm(100 * 10), 100, 10)
R <- ifelse(cor(Y) > .8, 1, 0)
system.time(testCV <- cv_gflasso(X, Y, R, nCores = 1))

## [1] 1.826146 1.819430 1.384595 1.420058 1.408619

##    user  system elapsed
##  45.808   3.070  55.271

system.time(testCV <- cv_gflasso(X, Y, R, nCores = 2))

## [1] 1.595413 1.492953 1.469917 1.366832 1.441642

##    user  system elapsed
##  22.231   1.698  26.441

cv_plot_gflasso(testCV)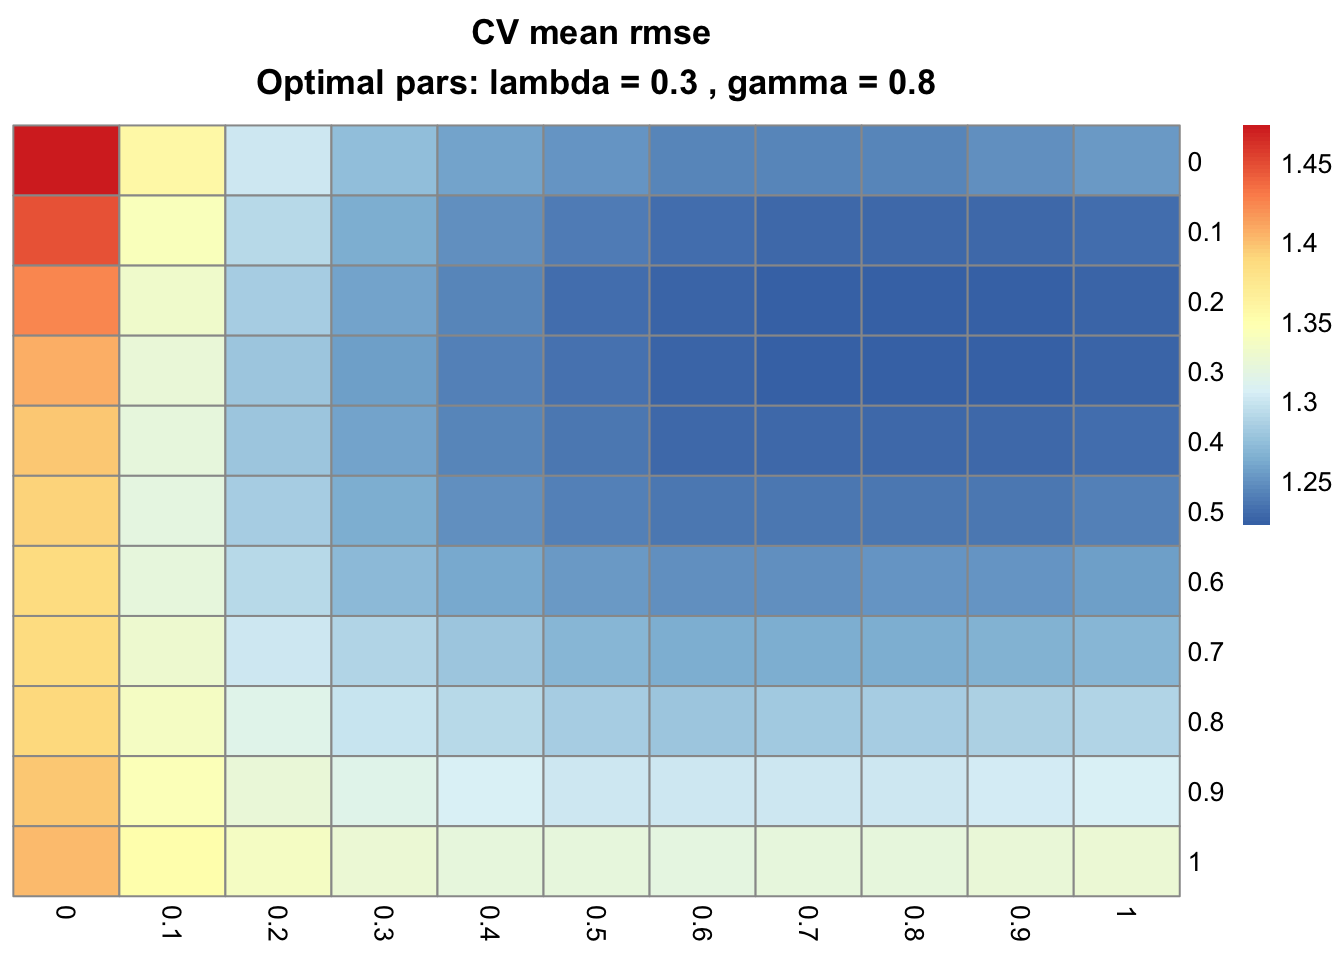
Les valeurs optimales de λ (lignes) et γ (colonnes) qui minimisent la RMSE dans cette simulation, 0,3 et 0,8 respectivement, capturent bien les relations imposées.
Astuce : réexécutez cet exemple avec une autre métrique, le coefficient de détermination (R2). Un avantage clé de R2 est qu’il est borné entre 0 et 1.
N’oubliez pas que si vous fournissez une fonction d’adéquation personnalisée err_fun(), vous devez préciser s’il faut maximiser ou minimiser la métrique via l’argument err_opt.
L’exemple suivant vise à maximiser R2, à l’aide d’un réseau d’association pondéré par les corrélations au carré (i.e. f(rm**l)=rm**l2). Si vous disposez de plus de 2 cœurs, augmentez l’argument nCores pour accélérer !
# Write R2 function
R2 <- function(pred, y){
      cor(as.vector(pred), as.vector(y))**2
}

# X, u, B and Y are still in memory
R <- cor(Y)**2

# Change nCores, if you have more than 2, re-run CV
testCV <- cv_gflasso(X, Y, R, nCores = 2, err_fun = R2, err_opt = "max")

## [1] 0.6209191 0.7207394 0.7262781 0.7193907 0.6303187

cv_plot_gflasso(testCV)
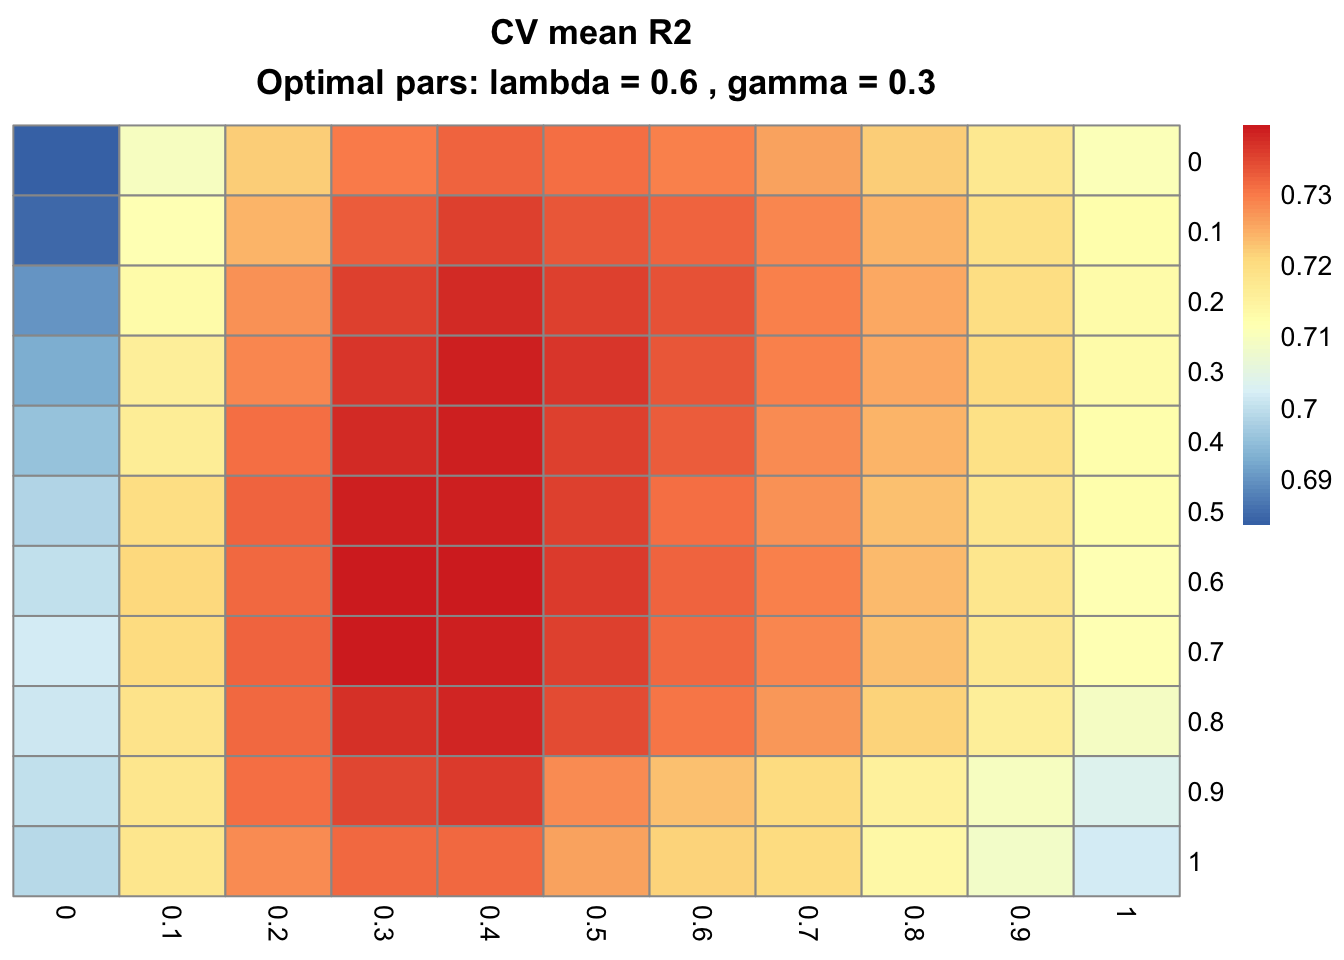
Les paramètres optimaux λ et γ sont maintenant 0,6 et 0,3 respectivement.
Notez aussi que les objets cv_gflasso sont des listes contenant quatre éléments : la moyenne ($mean) et l’erreur standard ($SE) de la métrique sur toutes les cases de la grille, les paramètres optimaux λ et γ ($optimal) et le nom de la fonction d’adéquation ($err_fun). Dans l’exemple présent, le modèle validé par CV privilégie clairement à la fois la parcimonie (λ) et la fusion (γ).
Enfin, gardez à l’esprit que vous pouvez affiner d’autres paramètres, tels que le seuil de convergence du gradient de Nesterov δ et le nombre maximal d’itérations, en passant delta_conv et iter_max via additionalOpts. Ils seront utilisés dans l’exemple suivant.
Pour illustrer la simplicité et la robustesse du GFLASSO sur un problème relativement haute dimension, vous allez modéliser les jeux de données bgsmtr_example_data issus de la base Alzheimer’s Disease Neuroimaging Initiative (ADNI‑1).
Il s’agit d’une liste à 3 éléments, partie du package bgsmtr, comprenant 15 mesures structurelles de neuro‑imagerie et 486 single nucleotide polymorphisms (SNP, marqueurs génétiques) mesurés sur 632 sujets. Point important : les 486 SNP couvrent 33 gènes associés à la maladie d’Alzheimer.
Votre objectif est de prédire les mesures morphologiques (neuroimagerie) à partir des SNP, en exploitant leur structure de corrélation.
Commençons par organiser les données et explorer les interdépendances entre toutes les caractéristiques de neuroimagerie :
data(bgsmtr_example_data)
str(bgsmtr_example_data)

## List of 3
##  $ SNP_data     : int [1:486, 1:632] 2 0 2 0 0 0 0 1 0 1 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:486] "rs4305" "rs4309" "rs4311" "rs4329" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...
##  $ SNP_groups   : chr [1:486] "ACE" "ACE" "ACE" "ACE" ...
##  $ BrainMeasures: num [1:15, 1:632] 116.5 4477.9 28631.9 34.1 -473.4 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:15] "Left_AmygVol.adj" "Left_CerebCtx.adj" "Left_CerebWM.adj" "Left_HippVol.adj" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...

# Transpose, so that samples are distributed as rows, predictors / responses as columns
SNP <- t(bgsmtr_example_data$SNP_data)
BM <- t(bgsmtr_example_data$BrainMeasures)

# Define dependency structure
DS <- cor(BM)

# Plot correlation matrix of the 15 neuroimaging measures
corrplot(DS)
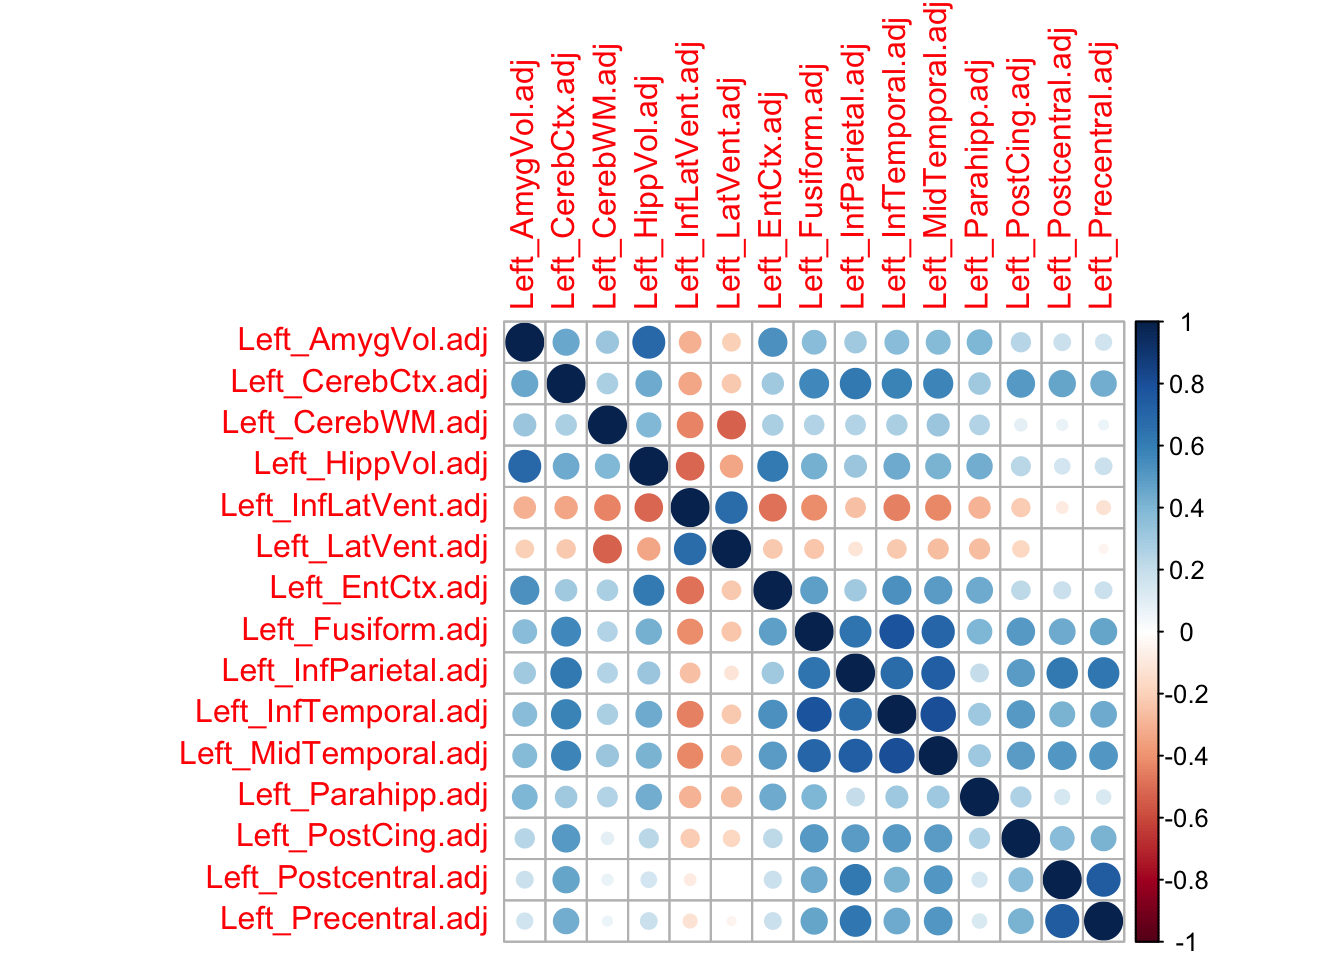
La figure ci‑dessus met en évidence les interdépendances entre les caractéristiques de neuroimagerie. Lancez maintenant la validation croisée du GFLASSO (cela peut prendre jusqu’à quelques heures sur un ordinateur portable) et identifiez les associations SNP‑neuroimagerie.
Remarque : dans l’exemple ci‑dessous, la tolérance de convergence et le nombre maximal d’itérations sont spécifiés. N’hésitez pas à tester d’autres valeurs.
system.time(CV <- cv_gflasso(X = scale(SNP), Y = scale(BM), R = DS, nCores = 2,
                 additionalOpts = list(delta_conv = 1e-5, iter_max = 1e5)))

## [1] 1.550294 1.471637 1.470133 1.514425 1.504215

##      user    system   elapsed
##  2611.492   323.441 51129.936

cv_plot_gflasso(CV)
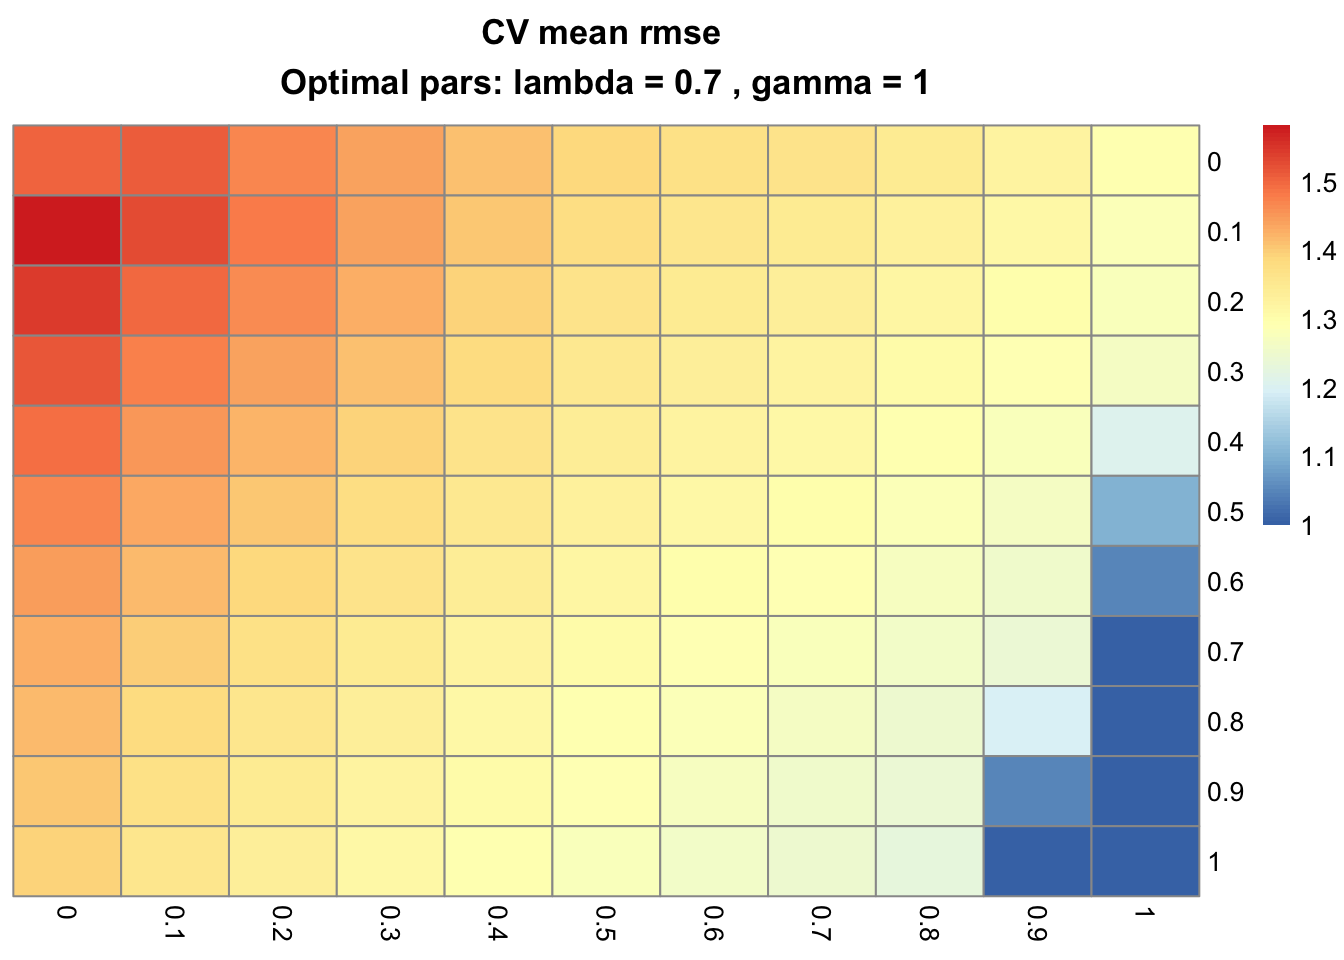
En confrontant le GFLASSO à des modèles LASSO purs (γ = 0, première colonne), à une fusion pure en moindres carrés (λ = 0, première ligne) et à l’OLS (γ = 0 et λ = 0, case en haut à gauche), on conclut que l’exemple présent est mieux modélisé avec des pénalités non nulles et, partant, avec le GFLASSO complet. Prenez les paramètres de CV optimaux (λ = 0,7 et γ = 1) pour entraîner un modèle GFLASSO et interpréter la matrice de coefficients obtenue :
gfMod <- gflasso(X = scale(SNP), Y = scale(BM), R = DS, opts = list(lambda = CV$optimal$lambda,
                                                                    gamma = CV$optimal$gamma,
                                                                    delta_conv = 1e-5,
                                                                    iter_max = 1e5))
colnames(gfMod$B) <- colnames(BM)
pheatmap(gfMod$B, annotation_row = data.frame("Gene" = bgsmtr_example_data$SNP_groups,
                                              row.names = rownames(gfMod$B)),
         show_rownames = F)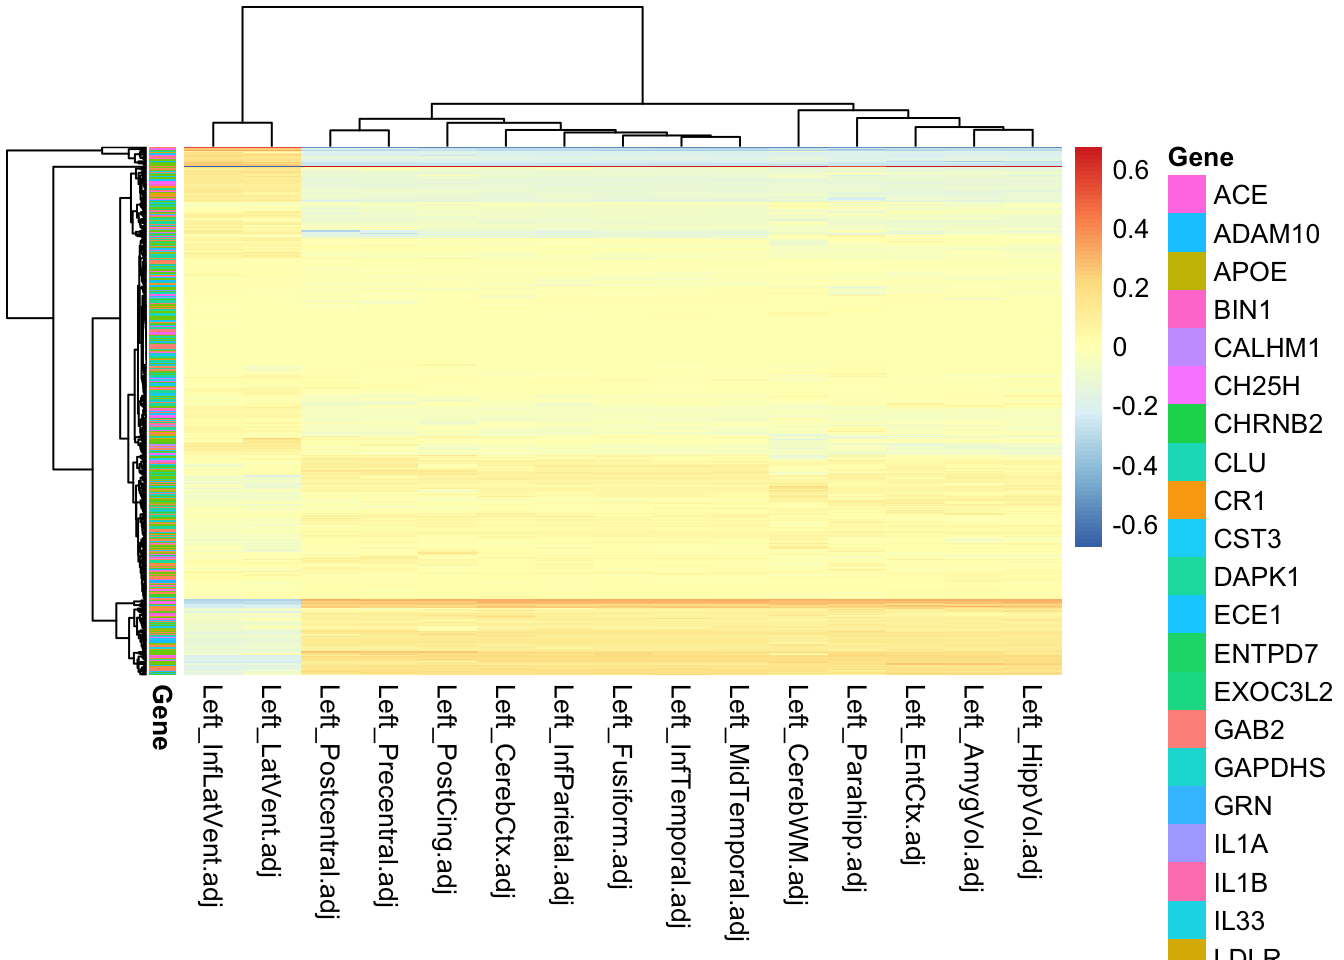
La figure ci‑dessus montre une très grande proportion de coefficients nuls ou quasi nuls. Bien qu’il n’y ait pas de regroupement évident des SNP par gènes (voir l’annotation par lignes, la légende est incomplète), on observe des associations nettes entre certains SNP et certains traits.
Pour vérifier l’existence d’un mécanisme prédictif non aléatoire, vous pouvez répéter la procédure après permutation des valeurs dans X ou Y. Des validations expérimentales pourraient aider à élucider la causalité et les mécanismes liés aux SNP sélectionnés. Par exemple, des SNP qui affectent la séquence et la structure des protéines, perturbant l’élimination des plaques d’β-amyloïde impliquées dans la maladie d’Alzheimer.
Le GFLASSO combine régularisation et fusion pour modéliser des réponses multiples, ce qui facilite l’identification des associations entre prédicteurs (X) et réponses (Y). Il est particulièrement utile avec des données de grande dimension et peu d’observations, bien qu’il soit plus lent que certaines méthodes concurrentes. Les modèles graphiques gaussiens conditionnels clairsemés [4] et la régression bayésienne multi‑tâches parcimonieuse par groupes [5], par exemple, peuvent être préférés pour leurs performances. Néanmoins, le GFLASSO reste très interprétable. Je l’ai récemment utilisé dans une approche intégrative multi‑omique pour identifier de nouveaux gènes lipidiques chez le maïs [6].
Découvrez le tutoriel DataCamp Régularisation : Ridge, Lasso et Elastic Net.
Kris et moi serons ravis d’avoir vos retours. Ce projet est actuellement maintenu par Kris sur le dépôt krisrs1128/gflasso et via le mien, bien que sujet à des évolutions fréquentes, sur monogenea/gflasso. Écrivez‑moi quand vous voulez (francisco.lima278@gmail.com), tous les retours sont les bienvenus.
Bon code !
Cours R
Cours
Cours
Cours