
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Hoewel het vakgebied van machine learning razendsnel vooruitgaat met de ontwikkeling van steeds geavanceerdere technieken, is er weinig aandacht besteed aan hoog-dimensionale multi-task problemen waarbij meerdere responsvariabelen tegelijk moeten worden voorspeld. Deze tutorial laat je de kracht zien van de Graph-Guided Fused LASSO (GFLASSO) bij het voorspellen van meerdere responsen binnen één geregulariseerd kader van lineaire regressie.
Bij supervised learning is het doel meestal om een afhankelijke of responsvariabele te voorspellen op basis van een set verklarende variabelen of predictoren over een set steekproeven of observaties. Regularisatiemethoden introduceren straffen die overfitting van hoog-dimensionale data voorkomen, vooral wanneer het aantal predictoren groter is dan het aantal observaties. Deze straffen worden toegevoegd aan de doelfunctie zodat de coëfficiëntschattingen van niet-informatieve predictoren (die weinig bijdragen aan het minimaliseren van de fout) zelf worden geminimaliseerd. De least absolute shrinkage and selection operator (LASSO) [1] is zo’n methode.
Vergeleken met ordinary least squares (OLS) kan de LASSO coëfficiëntschattingen (β) precies naar nul krimpen, waardoor niet-informatieve predictoren worden uitgesloten en featureselectie wordt uitgevoerd, via
$$argmin_\beta \sum_n(y_n-\hat{y_n})^2+\lambda\sum_{j}|\beta_{j}|$$
waarbij n en j respectievelijk staan voor een willekeurige observatie en predictor. De residual sum of squares (RSS), de enige term die in OLS wordt gebruikt, kan equivalent worden geschreven in algebraïsche vorm als $RSS = \sum_n(y_n-\hat{y_n})^2 = (y-X\beta)^T.(y-X\beta)$. De LASSO-straf is λ∑j|βj|, de L1-norm van de coëfficiëntschattingen gewogen door λ.
Wat als je meerdere gerelateerde responsen tegelijk wilt voorspellen, vanuit een gemeenschappelijke set predictoren? Hoewel je in principe goed uit de voeten kunt met meerdere onafhankelijke LASSO-modellen, één per respons, ben je beter af als je die voorspellingen coördineert op basis van de sterkte van de associatie tussen responsen. Die coördinatie haalt namelijk respons-specifieke variatie eruit die ruis bevat – de kernkracht van de GFLASSO.
Een goed voorbeeld staat in het oorspronkelijke artikel, waarin de auteurs de associaties ontrafelen tussen 34 genetische markers en 53 astma-eigenschappen bij 543 patiënten [2].
Laat X een matrix zijn van grootte n × p, met n observaties en p predictoren, en Y een matrix van grootte n × k, met dezelfde n observaties en k responsen, bijvoorbeeld 1390 afzonderlijke aankoopregistraties van elektronica in 73 landen, om de beoordelingen van 50 Netflix-producties over alle 73 landen te voorspellen.
Modellen die geschikt zijn voor het modelleren van paren hoog-dimensionale datasets zijn onder andere orthogonal two-way Partial Least Squares (O2PLS), Canonical Correlation Analysis (CCA) en Co-Inertia Analysis (CIA), die allemaal matrixdecompositie omvatten [3]. Aangezien deze modellen bovendien zijn gebaseerd op latente variabelen (dus projecties op basis van de oorspronkelijke predictoren), gaat hun rekenefficiëntie ten koste van de interpretatie.
Die trade-off loont echter niet altijd, en kan worden omgekeerd door de directe voorspelling van k individuele responsen op basis van geselecteerde kenmerken in X, in een uniform regressiekader dat rekening houdt met de relaties tussen de responsen.
Wiskundig leent de GFLASSO de regularisatie van de LASSO [1] zoals hierboven besproken en bouwt het model op de graafafhankelijkheidsstructuur die ten grondslag ligt aan Y, gekwantificeerd door de k × k correlatiematrix (dat is de ‘sterkte van associatie’ waar je eerder over las). Daardoor zullen vergelijkbare (of onvergelijkbare) responsen worden verklaard door een vergelijkbare (of onvergelijkbare) subset van geselecteerde predictoren.
Formeler, en in de notatie van het oorspronkelijke manuscript [2], is de doelfunctie van de GFLASSO
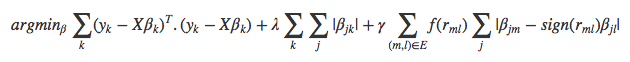
waar, over alle k responsen, ∑k(yk − X**βk)T.(yk − X**βk) de RSS geeft en λ∑k∑j|βj**k| de regularisatiestraf geleend van de LASSO, gewogen door parameter λ en werkend op de coëfficiënten β van iedere individuele predictor j. De vernieuwing van de GFLASSO zit in
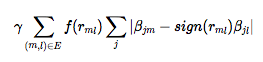
de fusiestraf gewogen door γ, die ervoor zorgt dat het absolute verschil tussen de coëfficiënten βj**m en βj**l, van eender welke predictor j en paar responsen m en l, des te kleiner (resp. groter) is naarmate hun paarse correlatie positiever (resp. negatiever) is, al dan niet getransformeerd, f(rm**l). Deze fusiestraf bevoordeelt globaal betekenisvolle variatie in de responsen boven ruis in elk van hen. Als de paarse correlatie dicht bij nul ligt, doet ze niets en houd je dus een pure LASSO over. Deze onderliggende correlatiestructuur van alle k responsen, die kan worden weergegeven als een gewogen netwerkstructuur, is standaard de absolute correlatie, f(rm**l)=|rm**l| maar kan worden getransformeerd om GFLASSO-varianten te maken met elke door de gebruiker opgegeven functie, zoals
met volop ruimte voor verdere innovatie. Hoewel 2. veel minder rekenintensief is dan 1. en de standaard absolute correlatie [2], vereist het wel een vooraf gedefinieerde afkapwaarde, bijvoorbeeld τ = 0,8.
Samengevat: om een GFLASSO-model te fitten heb je een predictormatrix X, een responsmatrix Y en een correlatiematrix nodig die de sterkte van associatie tussen alle paren responsen in Y weergeeft. Merk op dat de GFLASSO een p × k-matrix van β oplevert, in tegenstelling tot de LASSO (p × 1), en dat deze coëfficiëntenmatrix de associaties draagt tussen een gegeven respons k en predictor j.
Kris Sankaran en ik werken aan een experimenteel R-pakket dat de GFLASSO implementeert, naast kruisvalidatie- en plotmethoden. Onlangs hebben we multi-threading geïmplementeerd met het doParallel-pakket, waardoor de kruisvalidatieroutines (CV) veel sneller zijn.
Om GFLASSO in R te draaien moet je devtools installeren, laden en het pakket gflasso installeren vanaf mijn GitHub-repository. De demo wordt uitgevoerd op een dataset in het pakket bgsmtr. Ik raad ook aan om corrplot en pheatmap te installeren om de resultaten te visualiseren.
# Install the packages if necessary
#install.packages("devtools")
#install.packages("bgsmtr")
#install.packages("corrplot")
#install.packages("pheatmap")
library(devtools)
library(bgsmtr)
library(corrplot)
library(pheatmap)
#install_github("monogenea/gflasso")
library(gflasso)Je kunt eenvoudig de simulatie draaien die is beschreven op de helppagina voor de CV-functie cv_gflasso(). Standaard berekent de CV de root mean squared error (RMSE) over één herhaling van een 5-voudige CV, over alle mogelijke paren tussen λ ∈ {0, 0.1, 0.2, ..., 0.9, 1} en γ ∈ {0, 0.1, 0.2, ..., 0.9, 1}, het tuningraster.
Let op dat door de gebruiker aangeleverde foutfuncties ook werken!
Naast de inherente statistische aannames en snelheidsperformance hangt de keuze van de tuningbereiken sterk af van het mean-centeren en schalen naar eenheidsvariantie van alle kolommen in X en Y, dus zorg dat je dit vooraf doet.
In het volgende voorbeeld is dat niet nodig, omdat je willekeurige steekproeven trekt uit een standaard normale verdeling. Je kunt proberen de fusiestraf af te leiden uit een ongewogen correlatienetwerk, met een afkapwaarde van r > 0,8:
?cv_gflasso
set.seed(100)
X <- matrix(rnorm(100 * 10), 100, 10)
u <- matrix(rnorm(10), 10, 1)
B <- u %*% t(u) + matrix(rnorm(10 * 10, 0, 0.1), 10, 10)
Y <- X %*% B + matrix(rnorm(100 * 10), 100, 10)
R <- ifelse(cor(Y) > .8, 1, 0)
system.time(testCV <- cv_gflasso(X, Y, R, nCores = 1))

## [1] 1.826146 1.819430 1.384595 1.420058 1.408619

##    user  system elapsed
##  45.808   3.070  55.271

system.time(testCV <- cv_gflasso(X, Y, R, nCores = 2))

## [1] 1.595413 1.492953 1.469917 1.366832 1.441642

##    user  system elapsed
##  22.231   1.698  26.441

cv_plot_gflasso(testCV)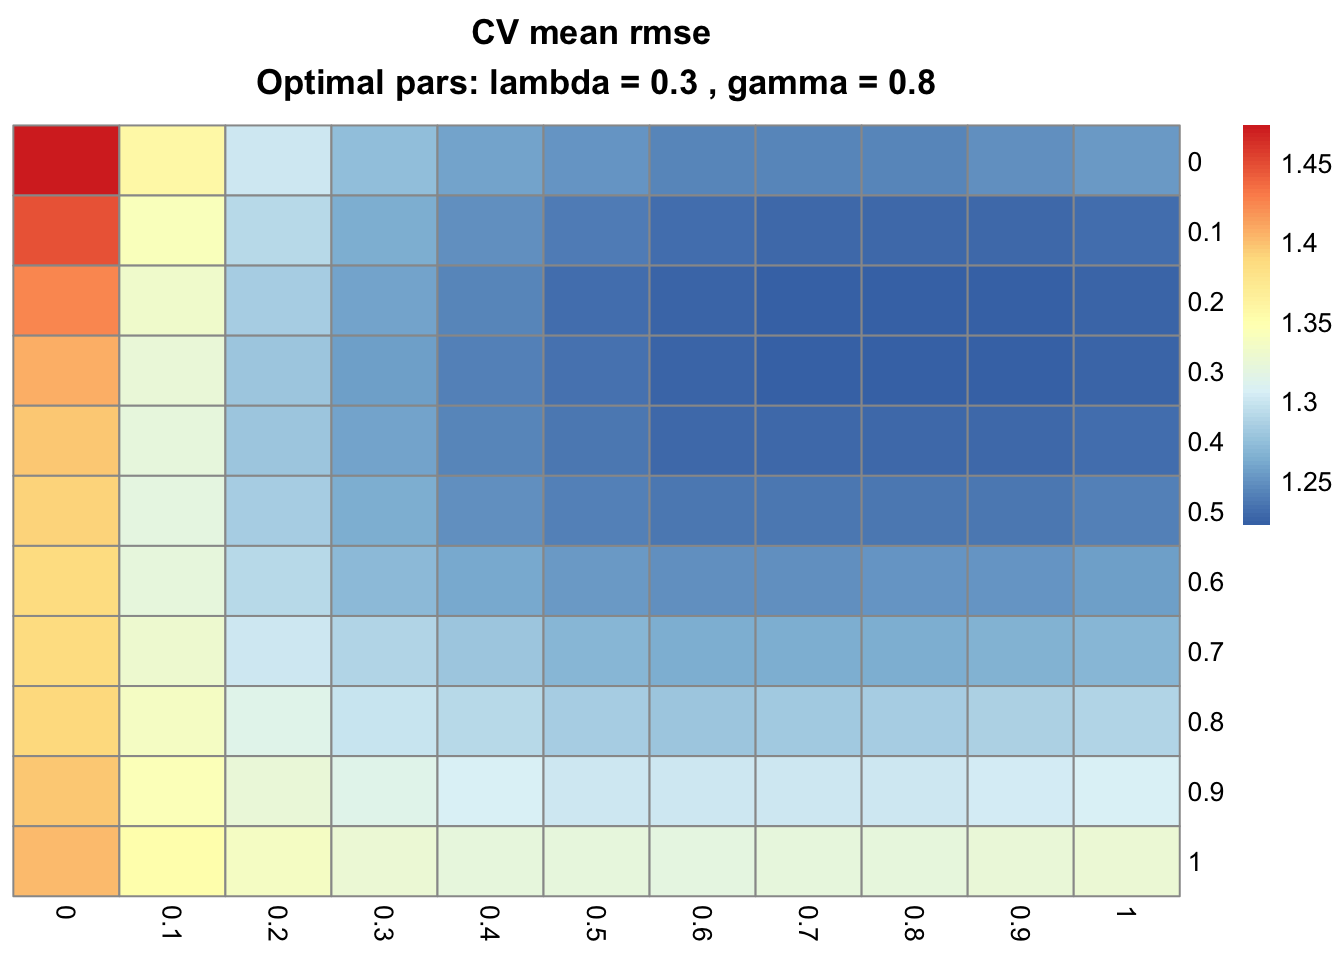
De optimale waarden van λ (rijen) en γ (kolommen) die de RMSE in deze simulatie minimaliseren, respectievelijk 0,3 en 0,8, vangen de opgelegde relaties goed.
Tip: Probeer dit voorbeeld opnieuw te draaien met een andere maat, de determinatiecoëfficiënt (R2). Een belangrijk voordeel van R2 is dat deze loopt van 0 tot 1.
Onthoud dat wanneer je een eigen goodness-of-fit-functie err_fun() opgeeft, je moet definiëren of je de resulterende maat wilt maximaliseren of minimaliseren met het argument err_opt.
Het volgende voorbeeld is gericht op het maximaliseren van R2, met gebruik van een gewogen associatienetwerk met gekwadrateerde correlatiecoëfficiënten (i.e. f(rm**l)=rm**l2). Als je meer dan 2 cores hebt, kun je het argument nCores verhogen voor extra snelheid!
# Write R2 function
R2 <- function(pred, y){
      cor(as.vector(pred), as.vector(y))**2
}

# X, u, B and Y are still in memory
R <- cor(Y)**2

# Change nCores, if you have more than 2, re-run CV
testCV <- cv_gflasso(X, Y, R, nCores = 2, err_fun = R2, err_opt = "max")

## [1] 0.6209191 0.7207394 0.7262781 0.7193907 0.6303187

cv_plot_gflasso(testCV)
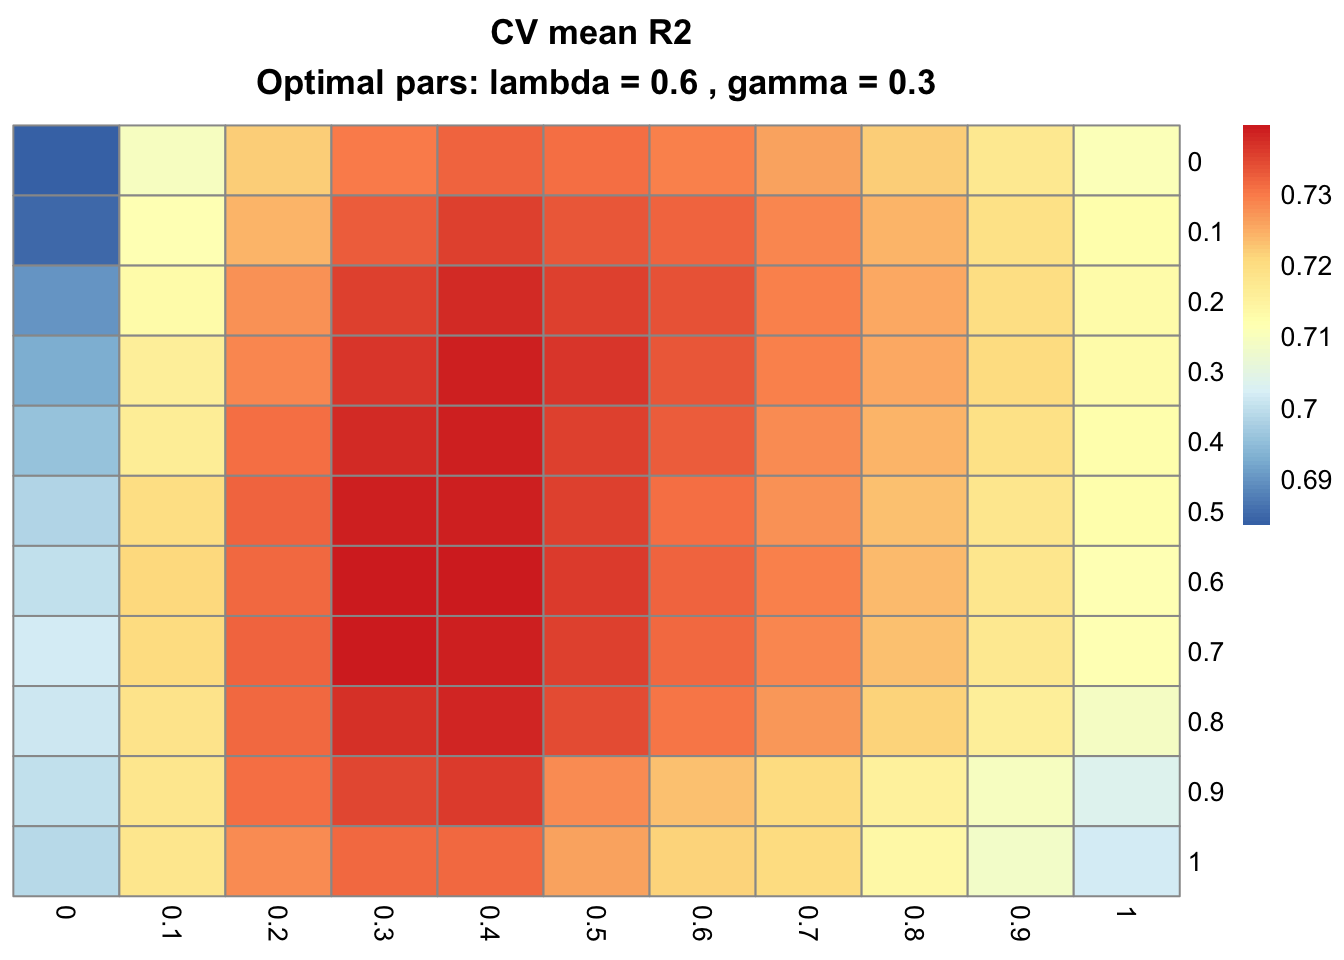
De optimale parameters λ en γ zijn nu respectievelijk 0,6 en 0,3.
Merk ook op dat cv_gflasso-objecten enkele lijsten zijn met vier elementen: het gemiddelde ($mean) en de standaardfout ($SE) van de maat over alle cellen van het raster, de optimale parameters λ en γ ($optimal) en de naam van de goodness-of-fit-functie ($err_fun). Het gekruisvalideerde model uit dit voorbeeld geeft duidelijk de voorkeur aan zowel sparsity (λ) als fusie (γ).
Houd er ten slotte rekening mee dat je extra parameters kunt fijnstemmen, zoals de convergentiedrempel δ van Nesterovs gradiënt en het maximum aantal iteraties door respectievelijk delta_conv en iter_max door te geven aan additionalOpts. Deze zullen in het volgende voorbeeld worden gebruikt.
Om de eenvoud en robuustheid van de GFLASSO te demonstreren in een relatief hoog-dimensionaal probleem, modelleer je hierna de datasets bgsmtr_example_data uit de Alzheimer’s Disease Neuroimaging Initiative (ADNI-1)-database.
Dit is een object met 3 elementen, onderdeel van het pakket bgsmtr, dat bestaat uit 15 structurele neuromaging-metingen en 486 single nucleotide polymorphisms (SNP’s, genetische markers) bepaald bij een steekproef van 632 proefpersonen. Belangrijk is dat de 486 SNP’s 33 genen omvatten die geassocieerd worden met de ziekte van Alzheimer.
Jouw taak is om de morfologische neuroimaging-metingen te voorspellen op basis van de SNP-gegevens, waarbij je de correlatiestructuur van de eerste benut.
Laten we beginnen met het ordenen van de data en het verkennen van de onderlinge afhankelijkheden tussen alle neuroimaging-kenmerken:
data(bgsmtr_example_data)
str(bgsmtr_example_data)

## List of 3
##  $ SNP_data     : int [1:486, 1:632] 2 0 2 0 0 0 0 1 0 1 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:486] "rs4305" "rs4309" "rs4311" "rs4329" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...
##  $ SNP_groups   : chr [1:486] "ACE" "ACE" "ACE" "ACE" ...
##  $ BrainMeasures: num [1:15, 1:632] 116.5 4477.9 28631.9 34.1 -473.4 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:15] "Left_AmygVol.adj" "Left_CerebCtx.adj" "Left_CerebWM.adj" "Left_HippVol.adj" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...

# Transpose, so that samples are distributed as rows, predictors / responses as columns
SNP <- t(bgsmtr_example_data$SNP_data)
BM <- t(bgsmtr_example_data$BrainMeasures)

# Define dependency structure
DS <- cor(BM)

# Plot correlation matrix of the 15 neuroimaging measures
corrplot(DS)
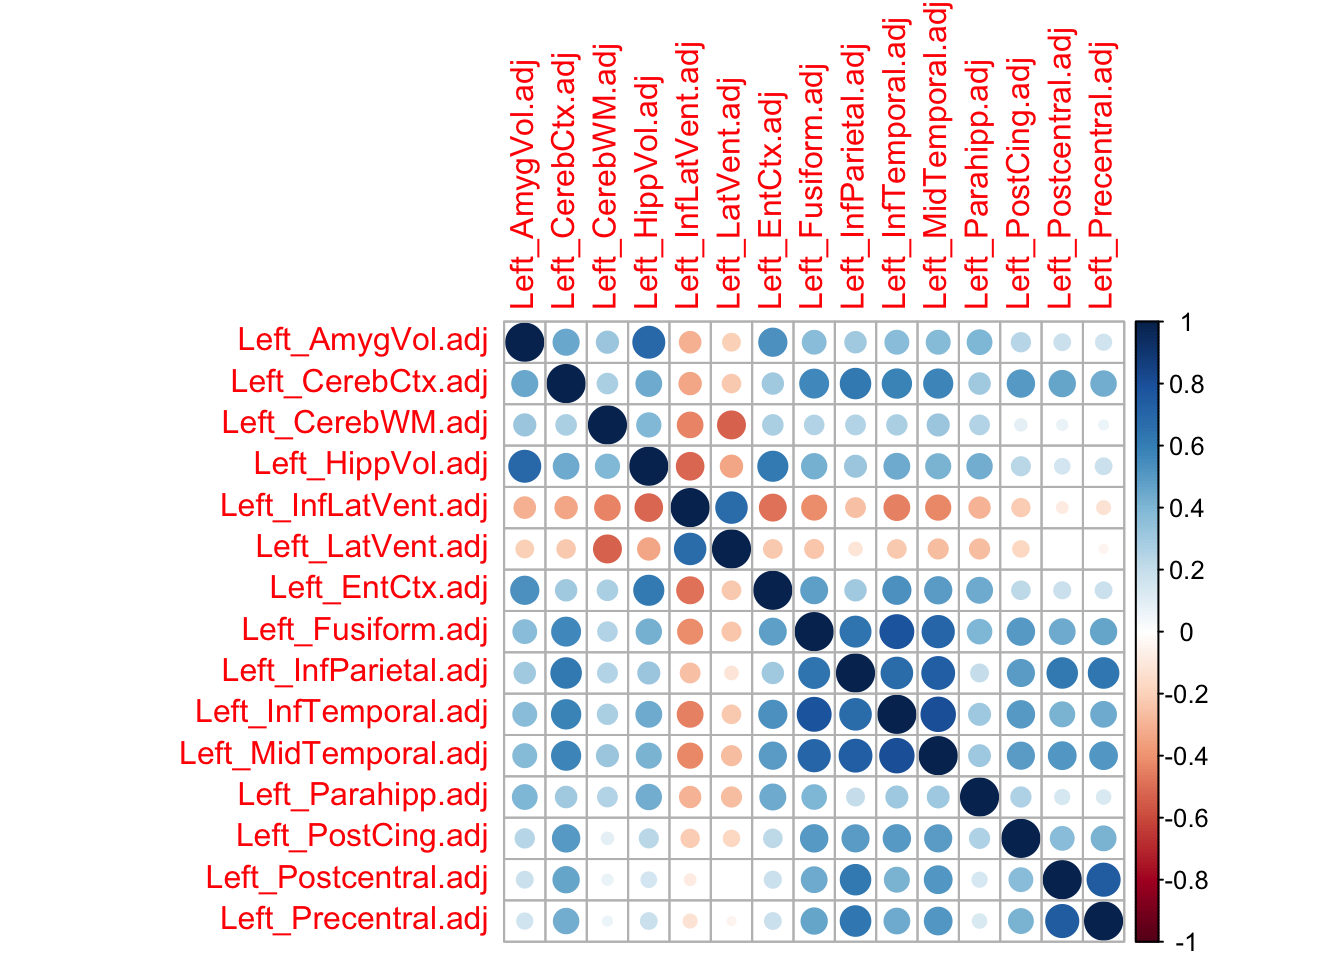
De figuur hierboven wijst op de onderlinge afhankelijkheden tussen de neuroimaging-kenmerken. Probeer nu de GFLASSO te kruisvalideren (kan op een laptop tot een paar uur duren!) en bepaal SNP-neuroimagingassociaties.
Let op dat in het onderstaande voorbeeld de convergentietolerantie en het maximale aantal iteraties zijn gespecificeerd. Voel je vrij om zelf met andere waarden te experimenteren!
system.time(CV <- cv_gflasso(X = scale(SNP), Y = scale(BM), R = DS, nCores = 2,
                 additionalOpts = list(delta_conv = 1e-5, iter_max = 1e5)))

## [1] 1.550294 1.471637 1.470133 1.514425 1.504215

##      user    system   elapsed
##  2611.492   323.441 51129.936

cv_plot_gflasso(CV)
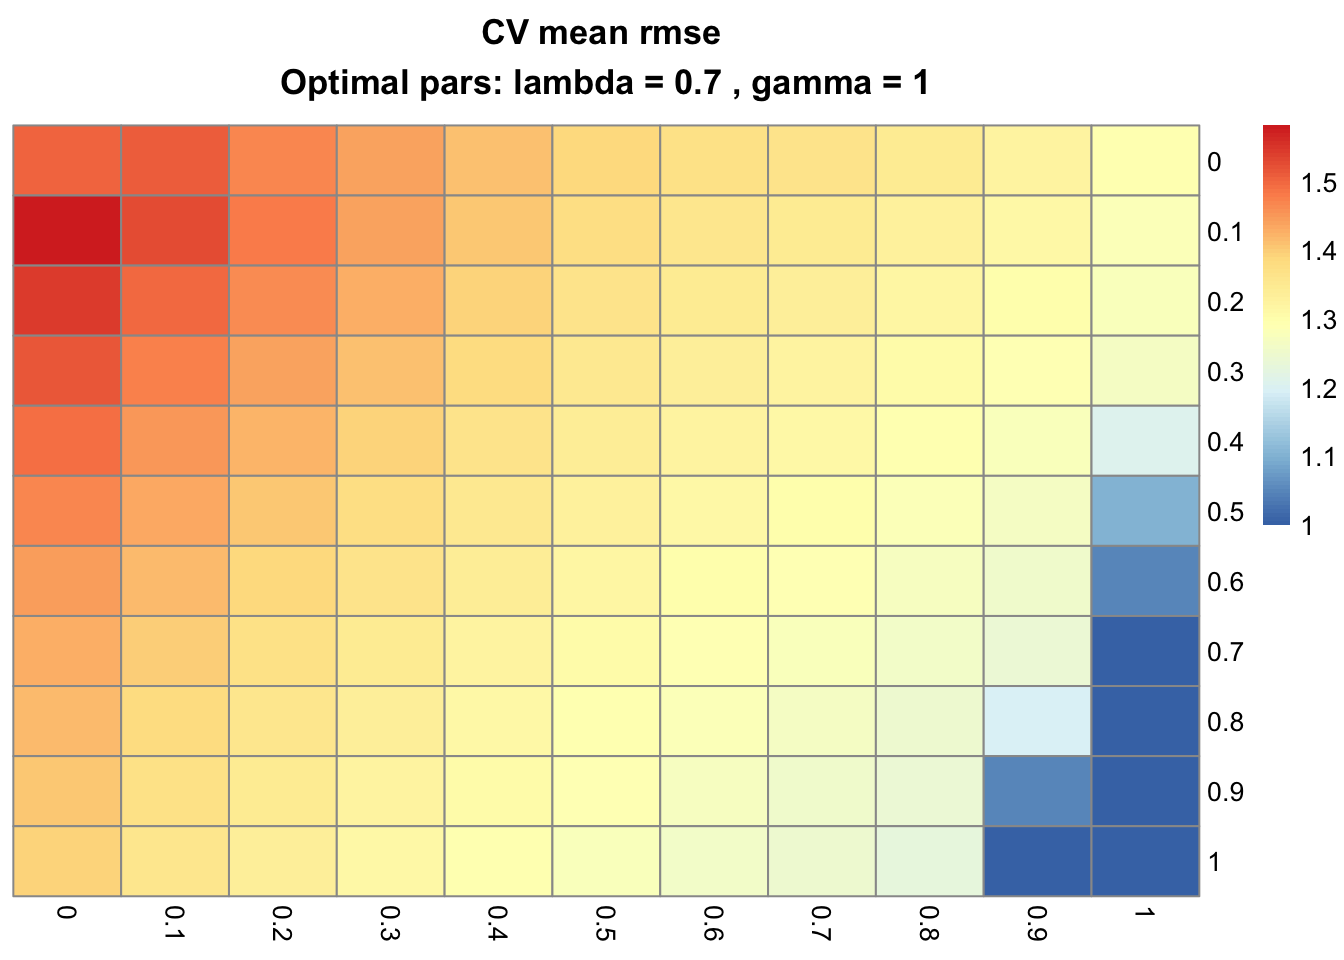
Door de GFLASSO uit te dagen met pure LASSO-modellen (γ = 0, eerste kolom), een pure fusion least squares (λ = 0, eerste rij) en OLS (γ = 0 en λ = 0, cel linksboven), kunnen we concluderen dat dit voorbeeld het best wordt gemodelleerd met niet-nul strafgewichten en dus met de volledige GFLASSO. Neem de optimale CV-parameters (λ = 0,7 en γ = 1) om een GFLASSO-model te bouwen en interpreteer de resulterende coëfficiëntenmatrix:
gfMod <- gflasso(X = scale(SNP), Y = scale(BM), R = DS, opts = list(lambda = CV$optimal$lambda,
                                                                    gamma = CV$optimal$gamma,
                                                                    delta_conv = 1e-5,
                                                                    iter_max = 1e5))
colnames(gfMod$B) <- colnames(BM)
pheatmap(gfMod$B, annotation_row = data.frame("Gene" = bgsmtr_example_data$SNP_groups,
                                              row.names = rownames(gfMod$B)),
         show_rownames = F)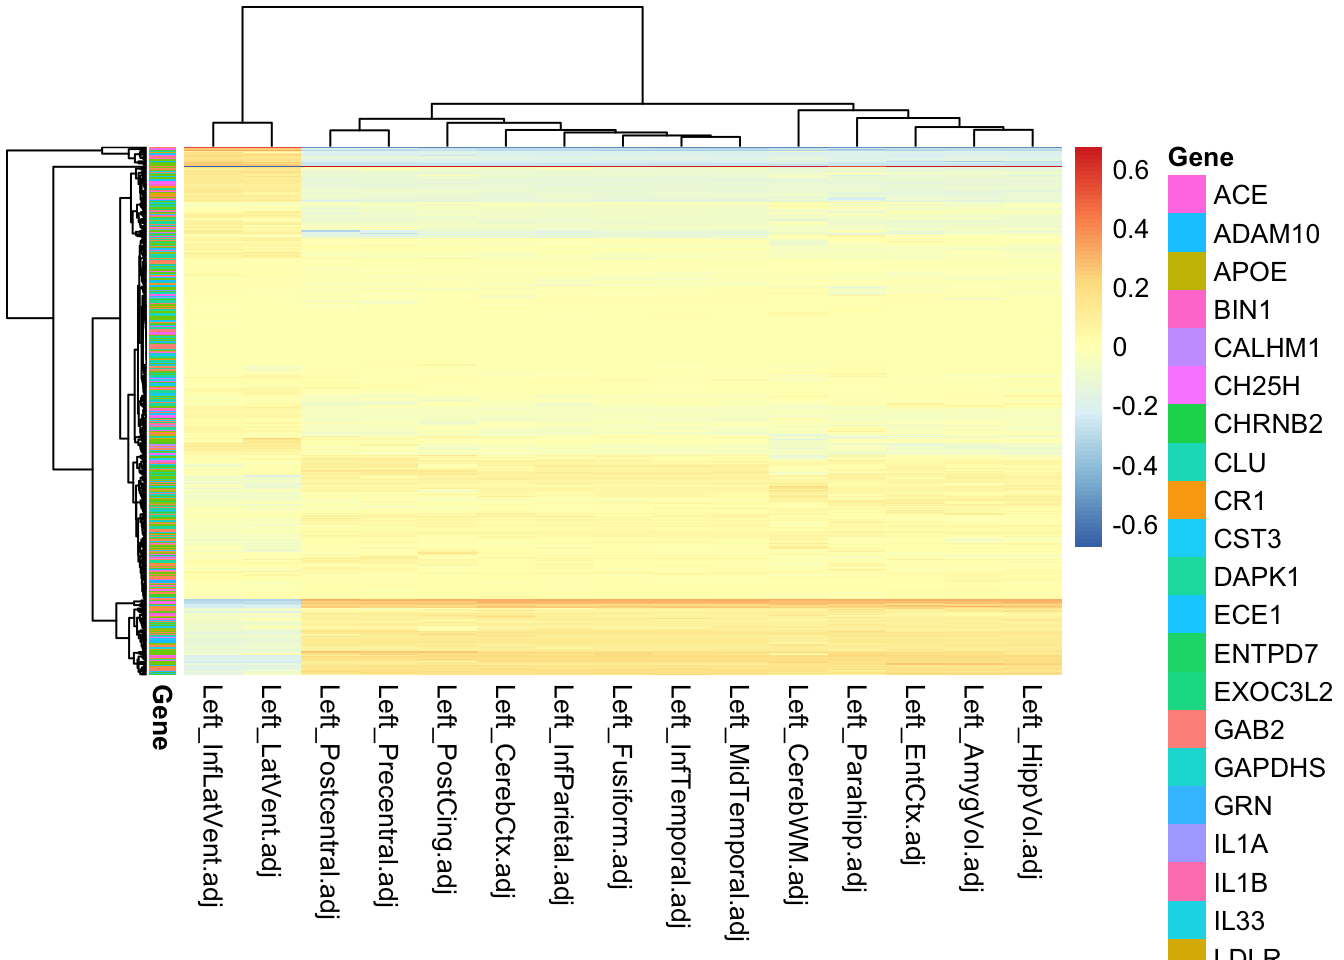
De figuur hierboven toont een zeer groot aandeel coëfficiënten met nul- of nabij-nulwaarden. Hoewel er geen duidelijke clustering van SNP’s is met betrekking tot de genen (zie de annotatie per rij; let op: de legenda is onvolledig), zijn er wel duidelijke associaties tussen bepaalde SNP’s en kenmerken.
Om het bestaan van een niet-willekeurig voorspellingsmechanisme vast te stellen, kun je de procedure vervolgens herhalen na permutatie van de waarden in X of Y. Experimenteel werk kan helpen om causaliteit en mechanismen te verduidelijken vanuit geselecteerde SNP’s. Bijvoorbeeld SNP’s die de eiwitsequentie en -structuur beïnvloeden en zo de klaring verstoren van de β-Amyloïde plaques die ten grondslag liggen aan de ziekte van Alzheimer.
De GFLASSO past zowel regularisatie als fusie toe bij het modelleren van meerdere responsen, en vergemakkelijkt zo het identificeren van associaties tussen predictoren (X) en responsen (Y). Het is het meest geschikt bij hoog-dimensionale data met zeer weinig observaties, omdat het veel trager is dan concurrerende methoden. Sparse conditional Gaussian graphical models [4] en Bayesian group-sparse multi-task regression model [5] kunnen bijvoorbeeld de voorkeur krijgen, met name om prestatiewinst. Desondanks is de GFLASSO zeer goed interpreteerbaar. Ik heb de GFLASSO onlangs gebruikt in een omics-integratieve aanpak om nieuwe lipidegenen in maïs te ontdekken [6].
Bekijk ook DataCamp’s Regularization Tutorial: Ridge, Lasso and Elastic Net.
Kris en ik horen graag van je. Dit project wordt momenteel onderhouden door Kris onder de repo krisrs1128/gflasso en via de mijne, hoewel onder frequente wijzigingen, op monogenea/gflasso. Mail me gerust (francisco.lima278@gmail.com), alle feedback is welkom.
Happy coding!
R-cursussen
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

