Kurs
Einführung in R
4 Std.
3.1M
Während sich das Feld des Machine Learnings rasant mit immer ausgefeilteren Techniken weiterentwickelt, bekommen hochdimensionale Multi-Task-Probleme, bei denen mehrere Zielgrößen gleichzeitig vorhergesagt werden müssen, oft zu wenig Aufmerksamkeit. Dieses Tutorial zeigt dir, wie stark das Graph-Guided Fused LASSO (GFLASSO) ist, wenn es darum geht, mehrere Zielgrößen in einem einzigen regularisierten Rahmen der linearen Regression vorherzusagen.
Im überwachten Lernen geht es in der Regel darum, eine abhängige Variable (Response) aus einer Menge erklärender Variablen (Prädiktoren) über eine Stichprobe von Beobachtungen vorherzusagen. Regularisierungsmethoden fügen Strafterme hinzu, die ein Overfitting bei hochdimensionalen Daten verhindern, insbesondere wenn die Anzahl der Prädiktoren die Anzahl der Beobachtungen übersteigt. Diese Strafen werden zur Zielfunktion addiert, sodass die Koeffizientenschätzer wenig informativer Prädiktoren (die nur wenig zur Fehlerreduktion beitragen) selbst klein werden. Der Least Absolute Shrinkage and Selection Operator (LASSO) [1] ist eine solche Methode.
Im Vergleich zu den gewöhnlichen kleinsten Quadraten (OLS) kann das LASSO Koeffizientenschätzer (β) exakt auf Null schrumpfen. Dadurch werden uninformative Prädiktoren ausgeschlossen und eine Feature-Selektion durchgeführt, via
$$argmin_\beta \sum_n(y_n-\hat{y_n})^2+\lambda\sum_{j}|\beta_{j}|$$
wobei n und j jeweils eine Beobachtung bzw. einen Prädiktor bezeichnen. Die Residuenquadratsumme (RSS), der einzige Term in OLS, lässt sich äquivalent als $RSS = \sum_n(y_n-\hat{y_n})^2 = (y-X\beta)^T.(y-X\beta)$ schreiben. Die LASSO-Strafe ist λ∑j|βj|, also die L1-Norm der Koeffizienten, gewichtet mit λ.
Was ist, wenn du mehrere zusammenhängende Zielgrößen gleichzeitig aus einem gemeinsamen Satz an Prädiktoren vorhersagen willst? Du könntest zwar für jede Response ein eigenes LASSO fitten und damit gut fahren, noch besser ist jedoch, diese Vorhersagen anhand der Stärke der Zusammenhänge zwischen den Responses zu koordinieren. Genau diese Koordination eliminiert response-spezifische Variation inklusive Rauschen – die zentrale Stärke des GFLASSO.
Ein gutes Beispiel liefert der Originalartikel, in dem die Autorinnen und Autoren die Zusammenhänge zwischen 34 genetischen Markern und 53 Asthma-Merkmalen bei 543 Patientinnen und Patienten aufklären [2].
Sei X eine Matrix der Größe n × p mit n Beobachtungen und p Prädiktoren und Y eine Matrix der Größe n × k mit denselben n Beobachtungen und k Responses, etwa 1390 unterschiedliche Elektronikkaufdatensätze aus 73 Ländern, um die Bewertungen von 50 Netflix-Produktionen über alle 73 Länder zu prognostizieren.
Für die Modellierung gepaarter hochdimensionaler Datensätze eignen sich unter anderem Orthogonal Two-way Partial Least Squares (O2PLS), Canonical Correlation Analysis (CCA) und Co-Inertia Analysis (CIA), die allesamt Matrixzerlegungen beinhalten [3]. Da diese Modelle auf latenten Variablen basieren (Projektionen der ursprünglichen Prädiktoren), geht die Recheneffizienz jedoch zulasten der Interpretierbarkeit.
Dieser Trade-off zahlt sich nicht immer aus und lässt sich umgehen, indem man die k einzelnen Responses direkt aus ausgewählten Features in X vorhersagt – in einem einheitlichen Regressionsrahmen, der die Beziehungen zwischen den Responses berücksichtigt.
Mathematisch übernimmt das GFLASSO die oben besprochene Regularisierung des LASSO [1] und baut das Modell auf der graphischen Abhängigkeitsstruktur in Y auf, quantifiziert durch die k × k-Korrelationsmatrix (also die „Stärke der Zusammenhänge“, von der zuvor die Rede war). Dadurch werden ähnliche (bzw. unähnliche) Responses durch ähnliche (bzw. unähnliche) Teilmengen an ausgewählten Prädiktoren erklärt.
Formaler, in der Notation des Originalpapers [2], lautet die Zielfunktion des GFLASSO
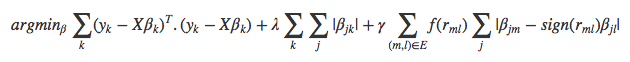
wobei über alle k Responses ∑k(yk − X**βk)T.(yk − X**βk) die RSS liefert und λ∑k∑j|β| die vom LASSO übernommene Regularisierungsstrafe ist, gewichtet durch λ und wirkend auf die Koeffizienten β jedes einzelnen Prädiktors j. Die Neuerung des GFLASSO liegt in
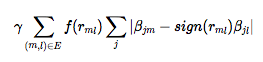
der Fusionsstrafe, gewichtet mit γ, die sicherstellt, dass die absolute Differenz zwischen den Koeffizienten βj**m und βj**l eines beliebigen Prädiktors j und Response-Paares m und l umso kleiner (bzw. größer) wird, je positiver (bzw. negativer) ihre paarweise Korrelation ist, transformiert oder nicht, f(rm**l). Diese Fusionsstrafe begünstigt global sinnvolle Variation in den Responses gegenüber individuellem Rauschen. Liegt die paarweise Korrelation nahe Null, greift sie nicht – dann bleibt ein reines LASSO. Die zugrunde liegende Korrelationsstruktur aller k Responses lässt sich als gewichtetes Netzwerk darstellen und ist standardmäßig die absolute Korrelation, f(rm**l)=|rm**l|, kann aber über eine beliebige, vom Nutzer vorgegebene Funktion transformiert werden, etwa
mit reichlich Spielraum für weitere Varianten. Obwohl 2. deutlich weniger rechenintensiv ist als 1. und die Standard-Absolute-Korrelation [2], erfordert es einen vordefinierten Schwellenwert, zum Beispiel τ = 0,8.
Zusammengefasst brauchst du zum Fitten eines GFLASSO-Modells eine Prädiktormatrix X, eine Responsematrix Y und eine Korrelationsmatrix, die die Stärke der Zusammenhänge zwischen allen Response-Paaren in Y abbildet. Beachte, dass das GFLASSO eine p × k-Matrix an β liefert, im Gegensatz zum LASSO (p × 1). Diese Koeffizientenmatrix trägt die Beziehungen zwischen jeder Response k und jedem Prädiktor j.
Kris Sankaran und ich arbeiten an einem experimentellen R-Paket, das das GFLASSO samt Cross-Validation und Plot-Funktionen implementiert. Kürzlich haben wir mit dem Paket doParallel Multithreading integriert, wodurch die Cross-Validation (CV) deutlich schneller läuft.
Um GFLASSO in R auszuführen, musst du devtools installieren und laden und dann das Paket gflasso aus meinem GitHub-Repository installieren. Die Demo läuft auf einem Datensatz aus dem Paket bgsmtr. Für die Visualisierung empfehle ich außerdem corrplot und pheatmap.
# Install the packages if necessary
#install.packages("devtools")
#install.packages("bgsmtr")
#install.packages("corrplot")
#install.packages("pheatmap")
library(devtools)
library(bgsmtr)
library(corrplot)
library(pheatmap)
#install_github("monogenea/gflasso")
library(gflasso)Du kannst die in der Hilfeseite zur CV-Funktion cv_gflasso() skizzierte Simulation leicht ausführen. Standardmäßig berechnet die CV den Root Mean Squared Error (RMSE) über eine einzelne Wiederholung einer 5-fach-CV, für alle möglichen Paare aus λ ∈ {0, 0.1, 0.2, ..., 0.9, 1} und γ ∈ {0, 0.1, 0.2, ..., 0.9, 1} im Tuning-Grid.
Hinweis: Eigene Fehlermetriken funktionieren ebenfalls!
Neben den statistischen Annahmen und der Laufzeit hängt die Wahl der Tuning-Bereiche stark davon ab, ob alle Spalten in X und Y mittelwertzentriert und auf Einheitsvarianz skaliert sind. Stell sicher, dass du das vorher erledigst.
Im folgenden Beispiel brauchst du es nicht, da du Zufallsstichproben aus einer Standardnormalverteilung ziehst. Du kannst versuchen, die Fusionsstrafe aus einem ungewichteten Korrelationsnetz mit einem Schwellenwert von r > 0,8 abzuleiten:
?cv_gflasso
set.seed(100)
X <- matrix(rnorm(100 * 10), 100, 10)
u <- matrix(rnorm(10), 10, 1)
B <- u %*% t(u) + matrix(rnorm(10 * 10, 0, 0.1), 10, 10)
Y <- X %*% B + matrix(rnorm(100 * 10), 100, 10)
R <- ifelse(cor(Y) > .8, 1, 0)
system.time(testCV <- cv_gflasso(X, Y, R, nCores = 1))

## [1] 1.826146 1.819430 1.384595 1.420058 1.408619

##    user  system elapsed
##  45.808   3.070  55.271

system.time(testCV <- cv_gflasso(X, Y, R, nCores = 2))

## [1] 1.595413 1.492953 1.469917 1.366832 1.441642

##    user  system elapsed
##  22.231   1.698  26.441

cv_plot_gflasso(testCV)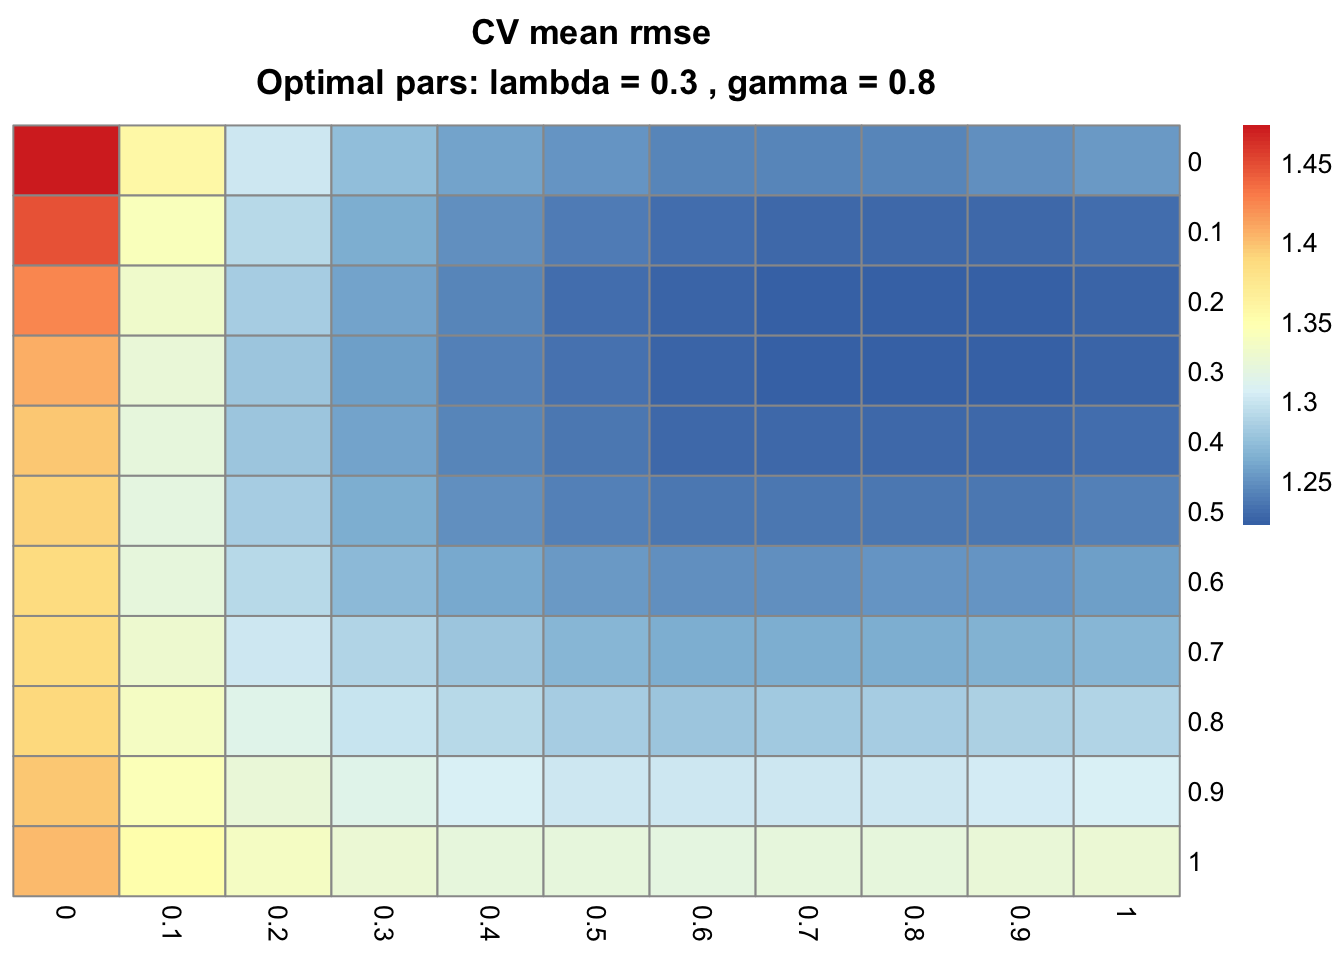
Die optimalen Werte von λ (Zeilen) und γ (Spalten), die in dieser Simulation den RMSE minimieren, sind 0,3 bzw. 0,8 und spiegeln die auferlegten Zusammenhänge gut wider.
Tipp: Starte das Beispiel mit einer anderen Metrik neu, dem Bestimmtheitsmaß (R2). Ein Vorteil von R2 ist, dass es zwischen 0 und 1 liegt.
Denk daran: Wenn du eine eigene Gütemaß-Funktion err_fun() angibst, musst du über das Argument err_opt festlegen, ob die Metrik maximiert oder minimiert werden soll.
Im folgenden Beispiel soll R2 maximiert werden, mit einem gewichteten Assoziationsnetz aus quadrierten Korrelationskoeffizienten (f(rm**l)=rm**l2). Wenn du mehr als 2 Kerne hast, erhöhe den Wert von nCores und gib dem Ganzen einen Boost!
# Write R2 function
R2 <- function(pred, y){
      cor(as.vector(pred), as.vector(y))**2
}

# X, u, B and Y are still in memory
R <- cor(Y)**2

# Change nCores, if you have more than 2, re-run CV
testCV <- cv_gflasso(X, Y, R, nCores = 2, err_fun = R2, err_opt = "max")

## [1] 0.6209191 0.7207394 0.7262781 0.7193907 0.6303187

cv_plot_gflasso(testCV)
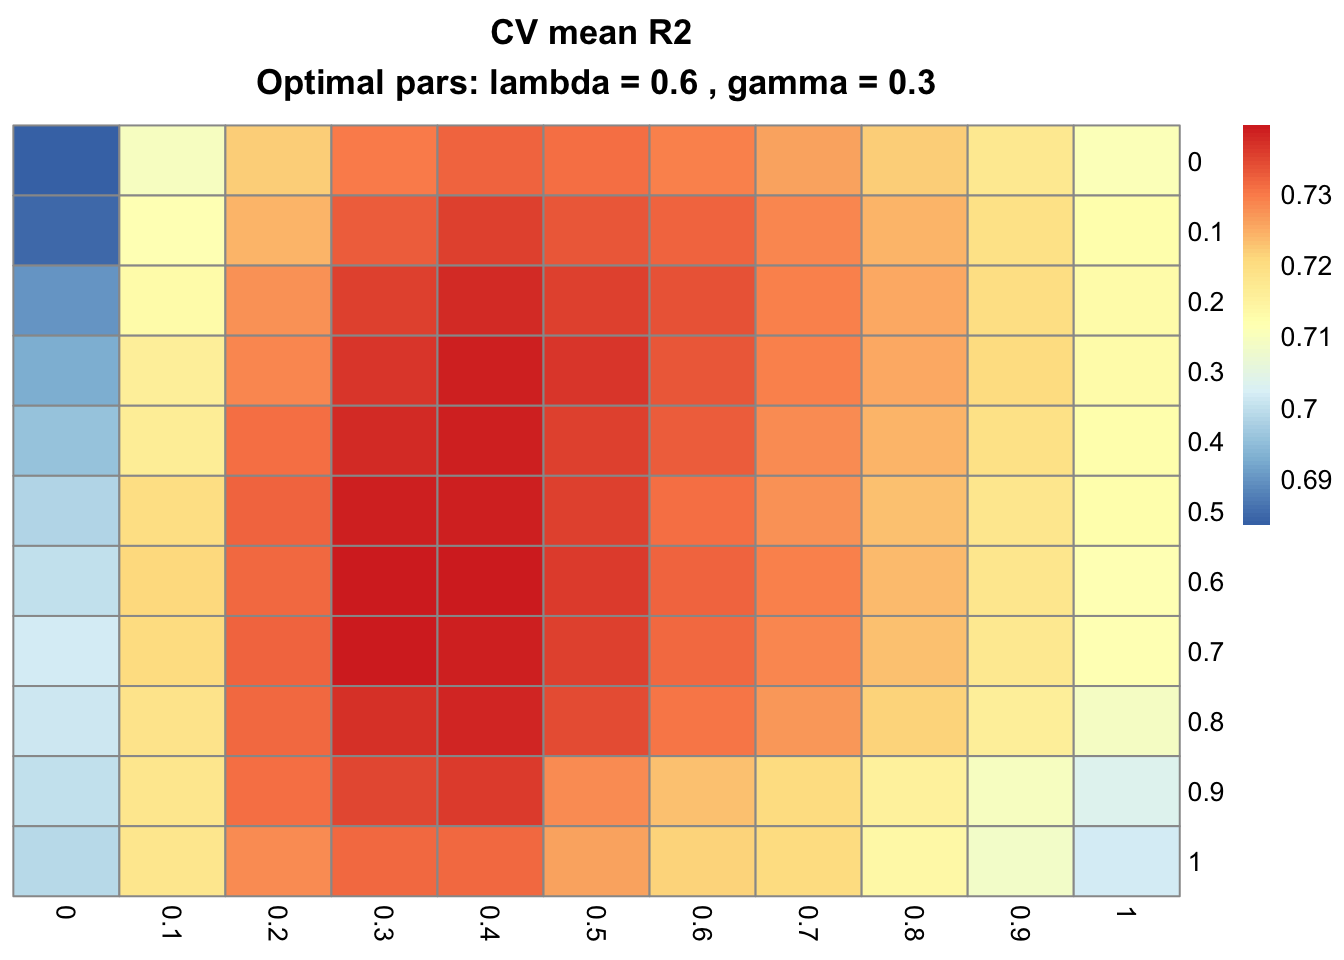
Die optimalen Parameter λ und γ sind nun 0,6 bzw. 0,3.
Beachte außerdem: cv_gflasso-Objekte sind Listen mit vier Elementen: dem Mittelwert ($mean) und dem Standardfehler ($SE) der Metrik über alle Zellen des Grids, den optimalen Parametern λ und γ ($optimal) und dem Namen der Gütemaß-Funktion ($err_fun). Das hier validierte Modell bevorzugt klar sowohl Sparsität (λ) als auch Fusion (γ).
Denke schließlich daran, dass du weitere Parameter feinjustieren kannst, zum Beispiel die Konvergenzschwelle des Nesterov-Gradienten δ und die maximale Anzahl an Iterationen über delta_conv und iter_max in additionalOpts. Diese werden im nächsten Beispiel verwendet.
Um die Einfachheit und Robustheit des GFLASSO in einem relativ hochdimensionalen Problem zu zeigen, modellierst du als Nächstes die Datensätze bgsmtr_example_data aus der Alzheimer’s Disease Neuroimaging Initiative (ADNI-1).
Das ist ein Liste-Objekt mit drei Elementen aus dem Paket bgsmtr, bestehend aus 15 strukturellen Neuroimaging-Messgrößen und 486 Single-Nucleotide-Polymorphismen (SNPs, genetische Marker), erhoben an 632 Probandinnen und Probanden. Wichtig: Die 486 SNPs decken 33 Gene ab, die mit Alzheimer in Verbindung gebracht werden.
Deine Aufgabe ist es, die morphologischen Neuroimaging-Messgrößen aus den SNP-Daten vorherzusagen – und dabei die Korrelationsstruktur der Messgrößen zu nutzen.
Los geht’s mit der Aufbereitung der Daten und einem Blick auf die Abhängigkeiten zwischen allen Neuroimaging-Features:
data(bgsmtr_example_data)
str(bgsmtr_example_data)

## List of 3
##  $ SNP_data     : int [1:486, 1:632] 2 0 2 0 0 0 0 1 0 1 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:486] "rs4305" "rs4309" "rs4311" "rs4329" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...
##  $ SNP_groups   : chr [1:486] "ACE" "ACE" "ACE" "ACE" ...
##  $ BrainMeasures: num [1:15, 1:632] 116.5 4477.9 28631.9 34.1 -473.4 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:15] "Left_AmygVol.adj" "Left_CerebCtx.adj" "Left_CerebWM.adj" "Left_HippVol.adj" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...

# Transpose, so that samples are distributed as rows, predictors / responses as columns
SNP <- t(bgsmtr_example_data$SNP_data)
BM <- t(bgsmtr_example_data$BrainMeasures)

# Define dependency structure
DS <- cor(BM)

# Plot correlation matrix of the 15 neuroimaging measures
corrplot(DS)
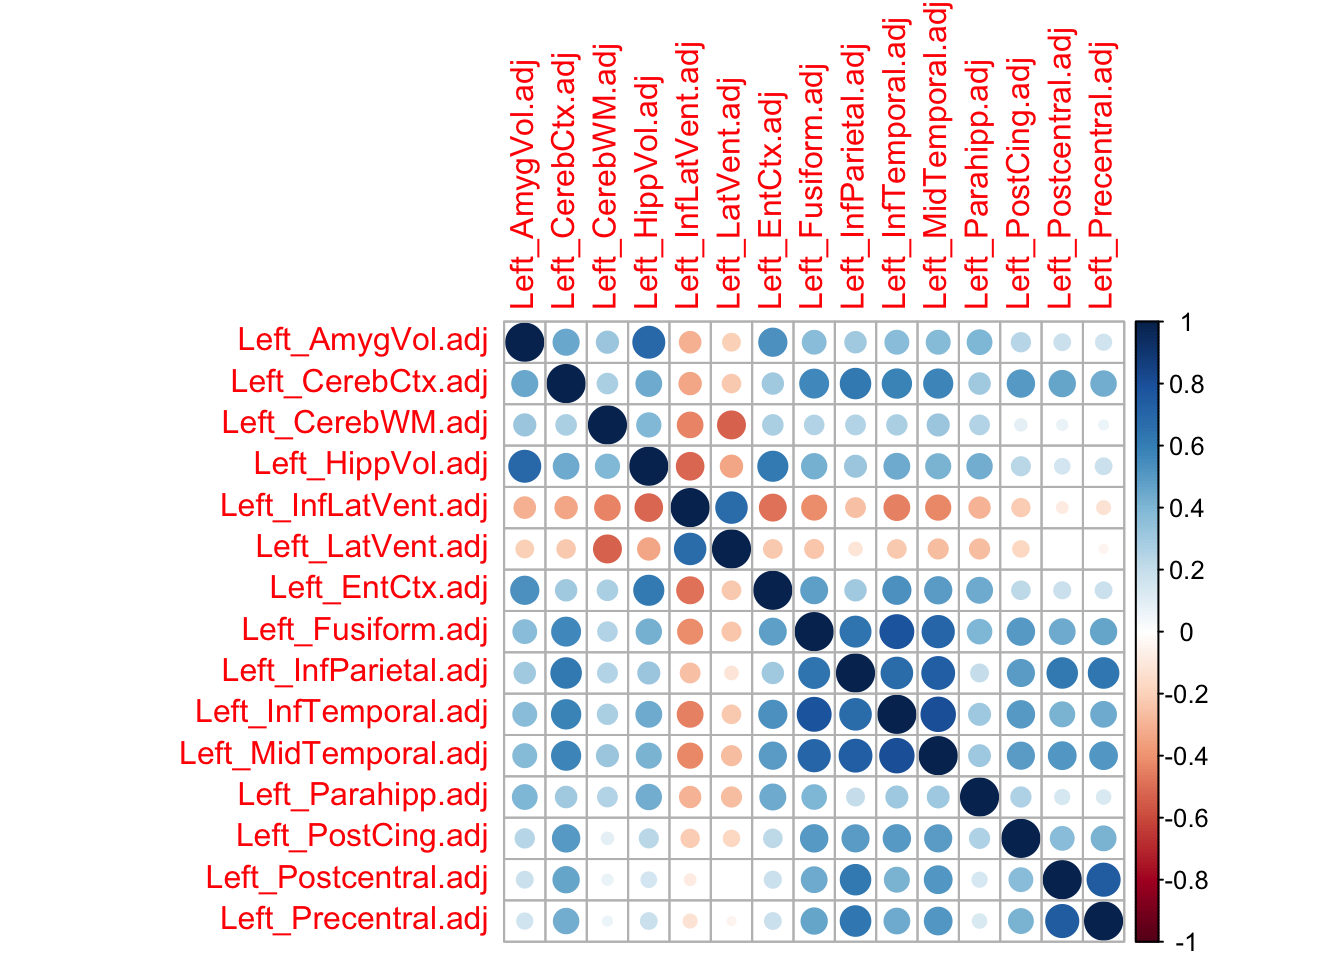
Die Abbildung zeigt die wechselseitigen Abhängigkeiten zwischen den Neuroimaging-Features. Führe nun die Cross-Validation für das GFLASSO durch (kann auf einem Laptop ein paar Stunden dauern!) und bestimme SNP–Neuroimaging-Zusammenhänge.
Hinweis: Im folgenden Beispiel sind die Konvergenztoleranz und die maximale Anzahl an Iterationen explizit gesetzt. Probier gern eigene Werte aus!
system.time(CV <- cv_gflasso(X = scale(SNP), Y = scale(BM), R = DS, nCores = 2,
                 additionalOpts = list(delta_conv = 1e-5, iter_max = 1e5)))

## [1] 1.550294 1.471637 1.470133 1.514425 1.504215

##      user    system   elapsed
##  2611.492   323.441 51129.936

cv_plot_gflasso(CV)
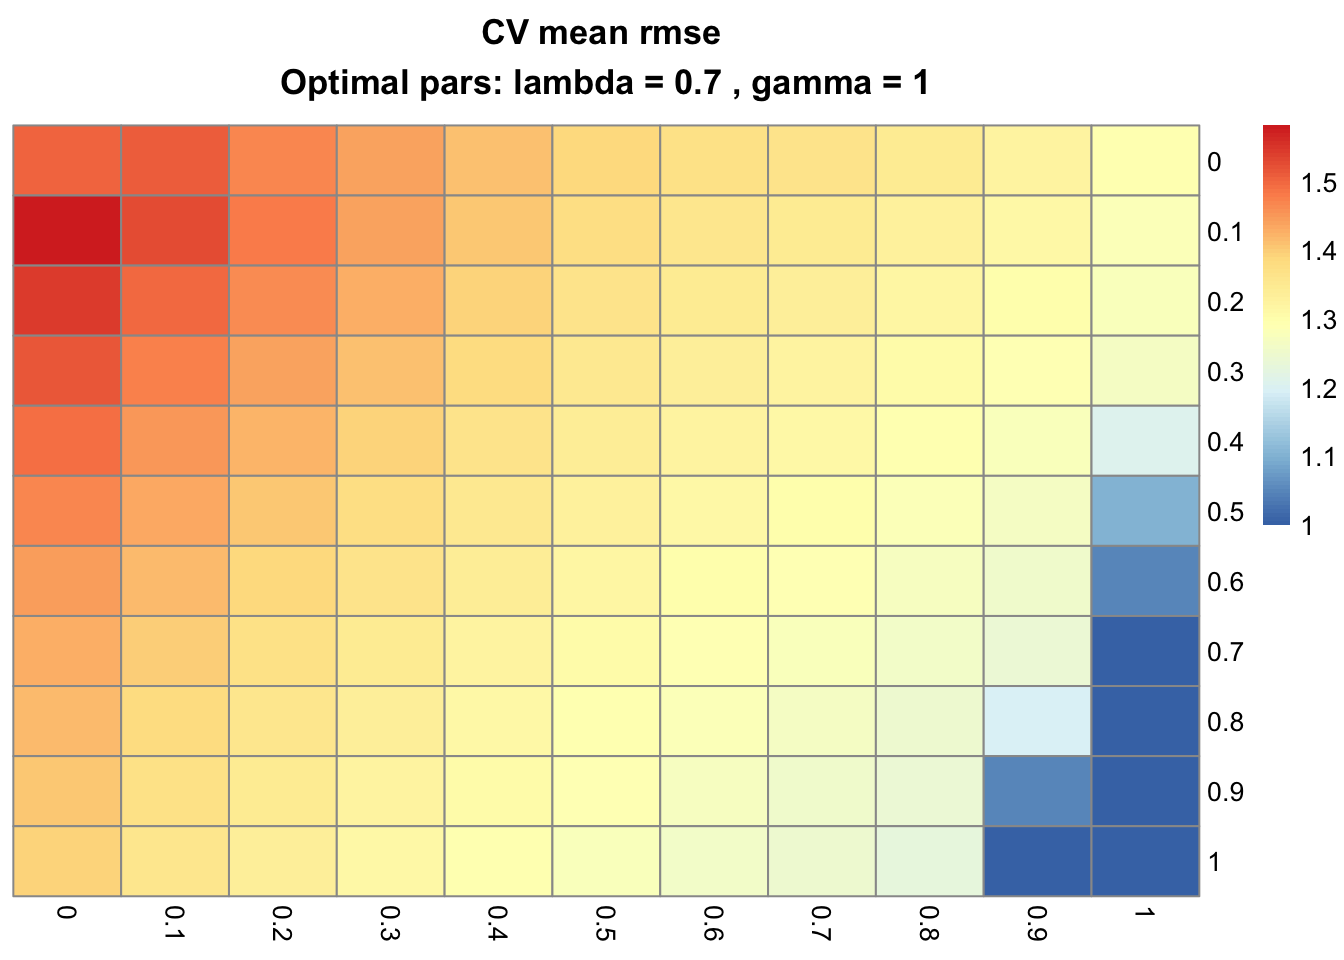
Indem wir das GFLASSO gegen reine LASSO-Modelle (γ = 0, erste Spalte), eine reine Fusion-Least-Squares-Lösung (λ = 0, erste Zeile) und OLS (γ = 0 und λ = 0, oben links) antreten lassen, zeigt sich: Dieses Beispiel wird am besten mit ungleich Null gesetzten Strafen und damit mit dem vollständigen GFLASSO modelliert. Nimm die optimalen CV-Parameter (λ = 0,7 und γ = 1), baue ein GFLASSO-Modell und interpretiere die resultierende Koeffizientenmatrix:
gfMod <- gflasso(X = scale(SNP), Y = scale(BM), R = DS, opts = list(lambda = CV$optimal$lambda,
                                                                    gamma = CV$optimal$gamma,
                                                                    delta_conv = 1e-5,
                                                                    iter_max = 1e5))
colnames(gfMod$B) <- colnames(BM)
pheatmap(gfMod$B, annotation_row = data.frame("Gene" = bgsmtr_example_data$SNP_groups,
                                              row.names = rownames(gfMod$B)),
         show_rownames = F)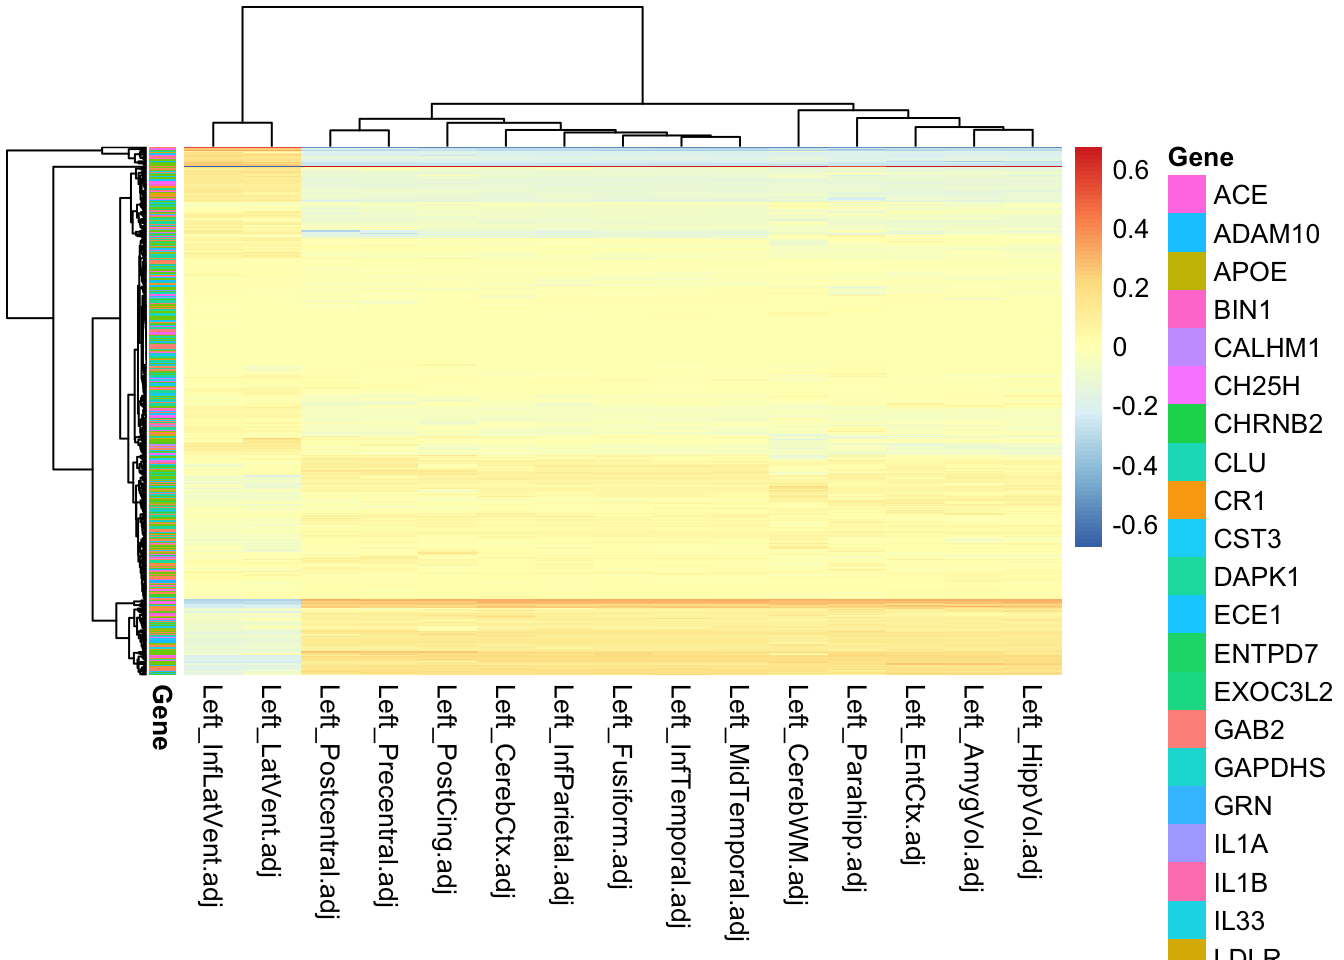
Die Abbildung zeigt, dass ein sehr großer Anteil der Koeffizienten Null oder nahe Null ist. Auch wenn sich bezüglich der Gene keine offensichtliche Clusterung der SNPs erkennen lässt (siehe zeilenweise Annotation; die Legende ist unvollständig), sind klare Zusammenhänge zwischen bestimmten SNPs und Merkmalen sichtbar.
Um zu prüfen, ob ein nicht-zufälliger Vorhersagemechanismus vorliegt, kannst du das Verfahren nach einer Permutation der Werte in X oder Y wiederholen. Experimentelle Arbeiten könnten Kausalitäten und Mechanismen ausgewählter SNPs aufklären. Beispielsweise SNPs, die Proteins equenz und -struktur beeinflussen und so die Clearance der β-Amyloid-Plaques stören, die Alzheimer zugrunde liegen.
Das GFLASSO kombiniert Regularisierung und Fusion zur Modellierung mehrerer Responses und erleichtert so die Identifikation von Zusammenhängen zwischen Prädiktoren (X) und Responses (Y). Es eignet sich besonders für hochdimensionale Daten mit wenigen Beobachtungen, da es deutlich langsamer ist als manche Alternativen. Sparse Conditional Gaussian Graphical Models [4] und das Bayesian Group-Sparse Multi-Task Regression Model [5] können zum Beispiel aus Performancegründen vorzuziehen sein. Das GFLASSO ist dafür ausgesprochen gut interpretierbar. Ich habe es kürzlich in einem omics-integrativen Ansatz eingesetzt, um neue Lipid-Gene in Mais zu identifizieren [6].
Sieh dir auch DataCamps Regularization Tutorial: Ridge, Lasso and Elastic Net an.
Kris und ich freuen uns über Feedback. Das Projekt wird derzeit von Kris im Repo krisrs1128/gflasso gepflegt und auch in meinem Repo, wenn auch mit häufigen Änderungen: monogenea/gflasso. Schreib mir jederzeit (francisco.lima278@gmail.com), jedes Feedback ist willkommen.
Viel Spaß beim Coden!
R-Kurse
Kurs
Kurs
Kurs