Curso
Introdução ao R
4 h
3.1M
Embora o campo de machine learning avance rapidamente com o desenvolvimento de técnicas cada vez mais sofisticadas, pouca atenção tem sido dada a problemas multi-tarefa de alta dimensionalidade que exigem a previsão simultânea de múltiplas respostas. Este tutorial vai mostrar a você o poder do Graph-Guided Fused LASSO (GFLASSO) para prever várias respostas dentro de um único framework de regressão linear com regularização.
No aprendizado supervisionado, geralmente buscamos prever uma variável dependente (ou resposta) a partir de um conjunto de variáveis explicativas ou preditores, em um conjunto de amostras ou observações. Métodos de regularização introduzem penalidades que evitam overfitting em dados de alta dimensionalidade, especialmente quando o número de preditores supera o número de observações. Essas penalidades são adicionadas à função objetivo para que os coeficientes de preditores pouco informativos (que pouco contribuem para minimizar o erro) também sejam minimizados. O least absolute shrinkage and selection operator (LASSO) [1] é um desses métodos.
Em comparação ao método dos mínimos quadrados ordinários (OLS), o LASSO consegue reduzir estimativas de coeficientes (β) exatamente a zero, descartando preditores pouco informativos e realizando seleção de variáveis, via
$$argmin_\beta \sum_n(y_n-\hat{y_n})^2+\lambda\sum_{j}|\beta_{j}|$$
em que n e j denotam, respectivamente, uma observação e um preditor quaisquer. A soma dos quadrados dos resíduos (RSS), o único termo usado no OLS, pode ser escrita de forma equivalente em álgebra como $RSS = \sum_n(y_n-\hat{y_n})^2 = (y-X\beta)^T.(y-X\beta)$. A penalidade do LASSO é λ∑j|βj|, a norma L1 dos coeficientes, ponderada por λ.
E se você quiser prever várias respostas relacionadas de uma vez, a partir de um mesmo conjunto de preditores? Embora você possa usar vários modelos LASSO independentes, um por resposta, é melhor coordenar essas previsões considerando a força da associação entre as respostas. Essa coordenação cancela a variação específica de cada resposta, incluindo ruído — a principal força do GFLASSO.
Um bom exemplo está no artigo original, no qual os autores analisam as associações entre 34 marcadores genéticos e 53 características de asma em 543 pacientes [2].
Seja X uma matriz de dimensão n × p, com n observações e p preditores, e Y uma matriz de dimensão n × k, com as mesmas n observações e k respostas, por exemplo, 1390 registros distintos de compra de eletrônicos em 73 países, para prever as avaliações de 50 produções da Netflix ao longo dos 73 países.
Modelos adequados para pares de conjuntos de dados de alta dimensionalidade incluem Partial Least Squares bidirecional ortogonal (O2PLS), Análise de Correlação Canônica (CCA) e Análise de Co-inércia (CIA), todos baseados em decomposição matricial [3]. Como esses modelos se apoiam em variáveis latentes (projeções baseadas nos preditores originais), a eficiência computacional vem com perda de interpretabilidade.
Nem sempre esse trade-off compensa, e pode ser evitado com a previsão direta das k respostas individuais a partir de features selecionadas em X, em um framework unificado de regressão que leva em conta os relacionamentos entre as respostas.
Matematicamente, o GFLASSO herda a regularização do LASSO [1] discutida acima e constrói o modelo sobre a estrutura de dependência em grafo subjacente a Y, quantificada pela matriz de correlação k × k (aquela "força de associação" mencionada antes). Como resultado, respostas semelhantes (ou diferentes) serão explicadas por subconjuntos semelhantes (ou diferentes) de preditores selecionados.
Mais formalmente, seguindo a notação do manuscrito original [2], a função objetivo do GFLASSO é
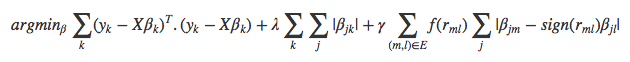
em que, sobre todas as k respostas, ∑k(yk − X**βk)T.(yk − X**βk) fornece o RSS e λ∑k∑j|βj**k| é a penalidade de regularização herdada do LASSO, ponderada por λ e aplicada aos coeficientes β de cada preditor j. A novidade do GFLASSO está em
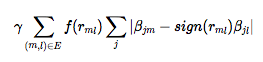
a penalidade de fusão ponderada por γ, que garante que a diferença absoluta entre os coeficientes βj**m e βj**l, de qualquer preditor j e par de respostas m e l, será menor (resp. maior) quanto mais positiva (resp. mais negativa) for a correlação entre essas respostas, transformada ou não, f(rm**l). Essa penalidade de fusão favorece a variação globalmente relevante nas respostas em detrimento do ruído individual. Quando a correlação entre pares está próxima de zero, ela não atua; nesse caso, você fica com um LASSO puro. Essa estrutura de correlação subjacente das k respostas, que pode ser representada como uma rede ponderada, por padrão usa a correlação absoluta, f(rm**l)=|rm**l|, mas pode ser transformada para criar variantes do GFLASSO com qualquer função definida pelo usuário, como
com bastante espaço para inovação. Embora a opção 2 seja muito menos custosa computacionalmente do que a 1 e a correlação absoluta padrão [2], ela exige um cutoff pré-definido, por exemplo, τ = 0,8.
Resumindo: para ajustar um modelo GFLASSO, você vai precisar de uma matriz de preditores X, uma matriz de respostas Y e uma matriz de correlação que represente a força de associação entre todos os pares de respostas em Y. Note que o GFLASSO produz uma matriz p × k de β, diferente do LASSO (p × 1), e essa matriz de coeficientes carrega as associações entre cada resposta k e cada preditor j.
Kris Sankaran e eu estamos trabalhando em um pacote R experimental que implementa o GFLASSO com métodos de validação cruzada e visualização. Recentemente implementamos multi-threading com o pacote doParallel, deixando as rotinas de validação cruzada (CV) muito mais rápidas.
Para rodar o GFLASSO no R você vai precisar instalar o devtools, carregá-lo e instalar o pacote gflasso a partir do meu repositório no GitHub. A demonstração será feita com um dataset do pacote bgsmtr. Recomendo também instalar corrplot e pheatmap para visualizar os resultados.
# Install the packages if necessary
#install.packages("devtools")
#install.packages("bgsmtr")
#install.packages("corrplot")
#install.packages("pheatmap")
library(devtools)
library(bgsmtr)
library(corrplot)
library(pheatmap)
#install_github("monogenea/gflasso")
library(gflasso)Você pode rodar facilmente a simulação descrita na página de ajuda da função de CV cv_gflasso(). Por padrão, a CV calcula o root mean squared error (RMSE) em uma repetição de uma CV de 5 folds, em todas as combinações entre λ ∈ {0, 0.1, 0.2, ..., 0.9, 1} e γ ∈ {0, 0.1, 0.2, ..., 0.9, 1}, a grade de hiperparâmetros.
Observação: funções de erro fornecidas pelo usuário também funcionam!
Além das suposições estatísticas e do desempenho, a escolha dos intervalos da grade depende muito de centralizar a média e escalar para variância unitária todas as colunas em X e Y, então certifique-se de fazer isso antes.
No exemplo a seguir não será necessário, já que os dados serão amostrados de uma distribuição normal padrão. Você pode testar a penalidade de fusão a partir de uma rede de correlação não ponderada, com cutoff de r > 0,8:
?cv_gflasso
set.seed(100)
X <- matrix(rnorm(100 * 10), 100, 10)
u <- matrix(rnorm(10), 10, 1)
B <- u %*% t(u) + matrix(rnorm(10 * 10, 0, 0.1), 10, 10)
Y <- X %*% B + matrix(rnorm(100 * 10), 100, 10)
R <- ifelse(cor(Y) > .8, 1, 0)
system.time(testCV <- cv_gflasso(X, Y, R, nCores = 1))

## [1] 1.826146 1.819430 1.384595 1.420058 1.408619

##    user  system elapsed
##  45.808   3.070  55.271

system.time(testCV <- cv_gflasso(X, Y, R, nCores = 2))

## [1] 1.595413 1.492953 1.469917 1.366832 1.441642

##    user  system elapsed
##  22.231   1.698  26.441

cv_plot_gflasso(testCV)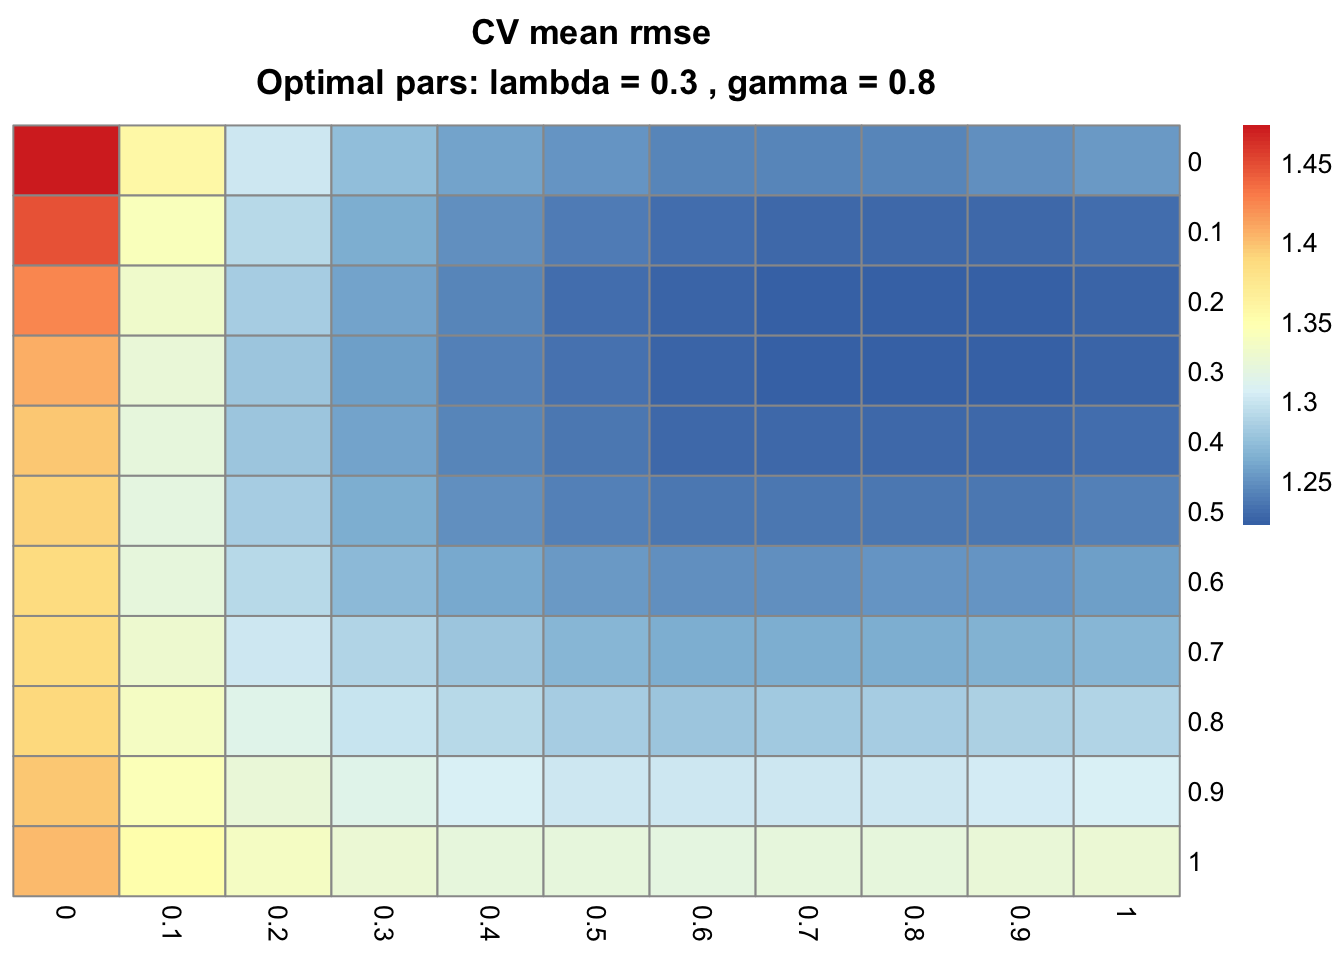
Os valores ótimos de λ (linhas) e γ (colunas) que minimizam o RMSE nesta simulação, 0,3 e 0,8 respectivamente, capturam bem os relacionamentos impostos.
Dica: tente rodar novamente com outra métrica, o coeficiente de determinação (R2). Uma vantagem do R2 é variar de 0 a 1.
Lembre-se: ao fornecer uma função de ajuste personalizada err_fun(), você precisa definir se a métrica deve ser maximizada ou minimizada usando o argumento err_opt.
No exemplo a seguir, buscamos maximizar o R2, usando uma rede de associações ponderada com correlações ao quadrado (isto é, f(rm**l)=rm**l2). Se você tiver mais de 2 núcleos, ajuste o argumento nCores para ganhar desempenho!
# Write R2 function
R2 <- function(pred, y){
      cor(as.vector(pred), as.vector(y))**2
}

# X, u, B and Y are still in memory
R <- cor(Y)**2

# Change nCores, if you have more than 2, re-run CV
testCV <- cv_gflasso(X, Y, R, nCores = 2, err_fun = R2, err_opt = "max")

## [1] 0.6209191 0.7207394 0.7262781 0.7193907 0.6303187

cv_plot_gflasso(testCV)
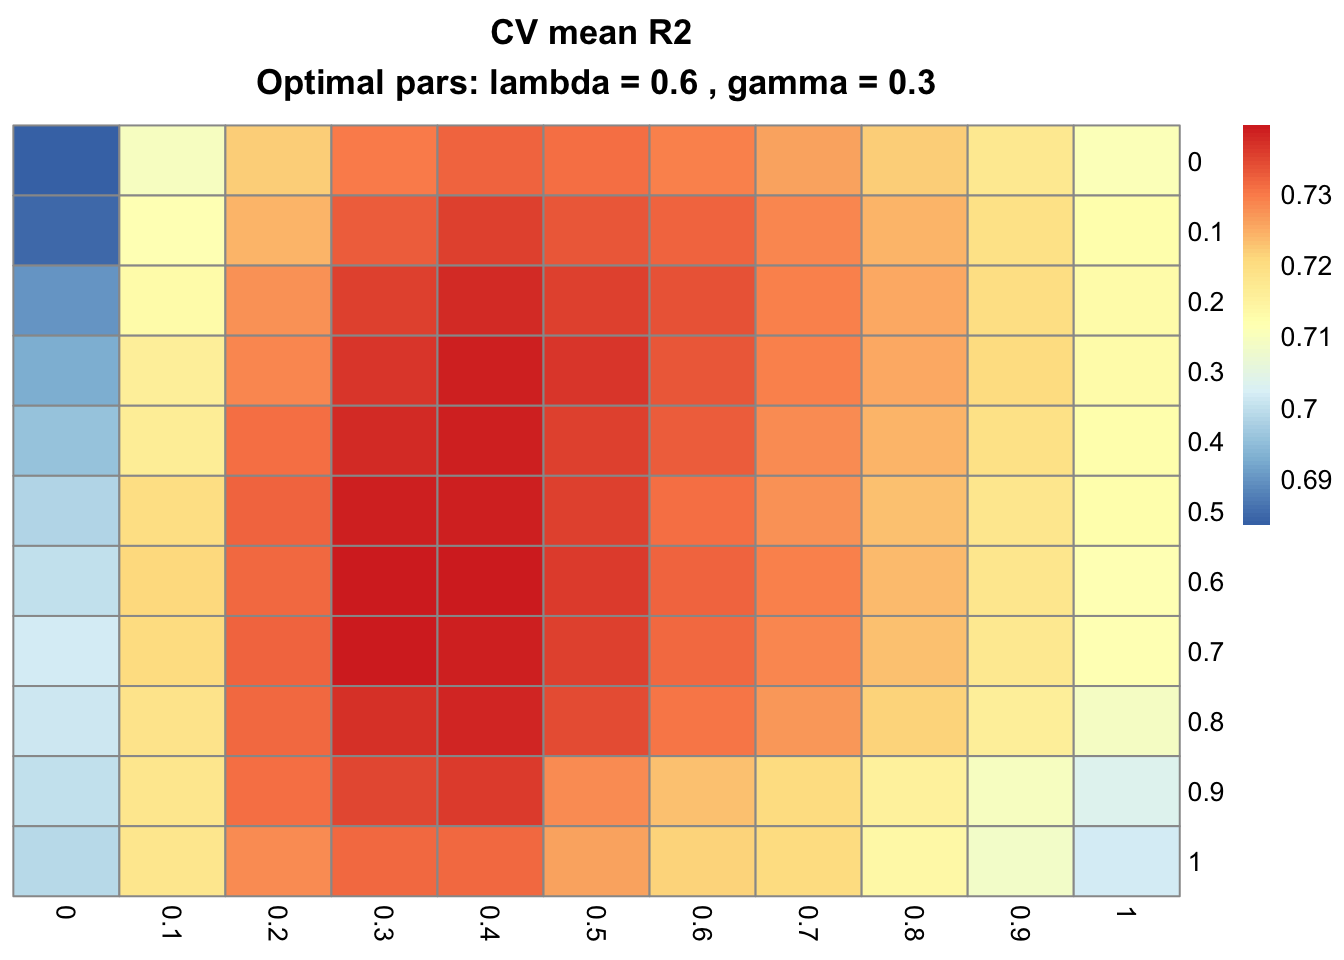
Os parâmetros ótimos λ e γ agora são 0,6 e 0,3, respectivamente.
Note também que objetos cv_gflasso são listas simples com quatro elementos: a média ($mean) e o erro padrão ($SE) da métrica em todas as células da grade, os parâmetros ótimos λ e γ ($optimal) e o nome da função de ajuste ($err_fun). O modelo com validação cruzada deste exemplo favorece claramente tanto a esparsidade (λ) quanto a fusão (γ).
Por fim, lembre-se de que você pode ajustar parâmetros adicionais, como o limiar de convergência do gradiente de Nesterov δ e o número máximo de iterações, passando delta_conv e iter_max para additionalOpts, respectivamente. Eles serão usados no exemplo seguinte.
Para demonstrar a simplicidade e a robustez do GFLASSO em um problema relativamente de alta dimensionalidade, vamos modelar os datasets bgsmtr_example_data obtidos do banco de dados do Alzheimer’s Disease Neuroimaging Initiative (ADNI-1).
Este é um objeto lista com 3 elementos, parte do pacote bgsmtr, composto por 15 medidas estruturais de neuroimagem e 486 polimorfismos de nucleotídeo único (SNPs, marcadores genéticos) determinados a partir de uma amostra de 632 indivíduos. Importante: os 486 SNPs cobrem 33 genes associados à doença de Alzheimer.
Seu objetivo é prever as medidas morfológicas de neuroimagem a partir dos dados de SNP, aproveitando a estrutura de correlação das primeiras.
Vamos começar organizando os dados e explorando as interdependências entre todas as features de neuroimagem:
data(bgsmtr_example_data)
str(bgsmtr_example_data)

## List of 3
##  $ SNP_data     : int [1:486, 1:632] 2 0 2 0 0 0 0 1 0 1 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:486] "rs4305" "rs4309" "rs4311" "rs4329" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...
##  $ SNP_groups   : chr [1:486] "ACE" "ACE" "ACE" "ACE" ...
##  $ BrainMeasures: num [1:15, 1:632] 116.5 4477.9 28631.9 34.1 -473.4 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:15] "Left_AmygVol.adj" "Left_CerebCtx.adj" "Left_CerebWM.adj" "Left_HippVol.adj" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...

# Transpose, so that samples are distributed as rows, predictors / responses as columns
SNP <- t(bgsmtr_example_data$SNP_data)
BM <- t(bgsmtr_example_data$BrainMeasures)

# Define dependency structure
DS <- cor(BM)

# Plot correlation matrix of the 15 neuroimaging measures
corrplot(DS)
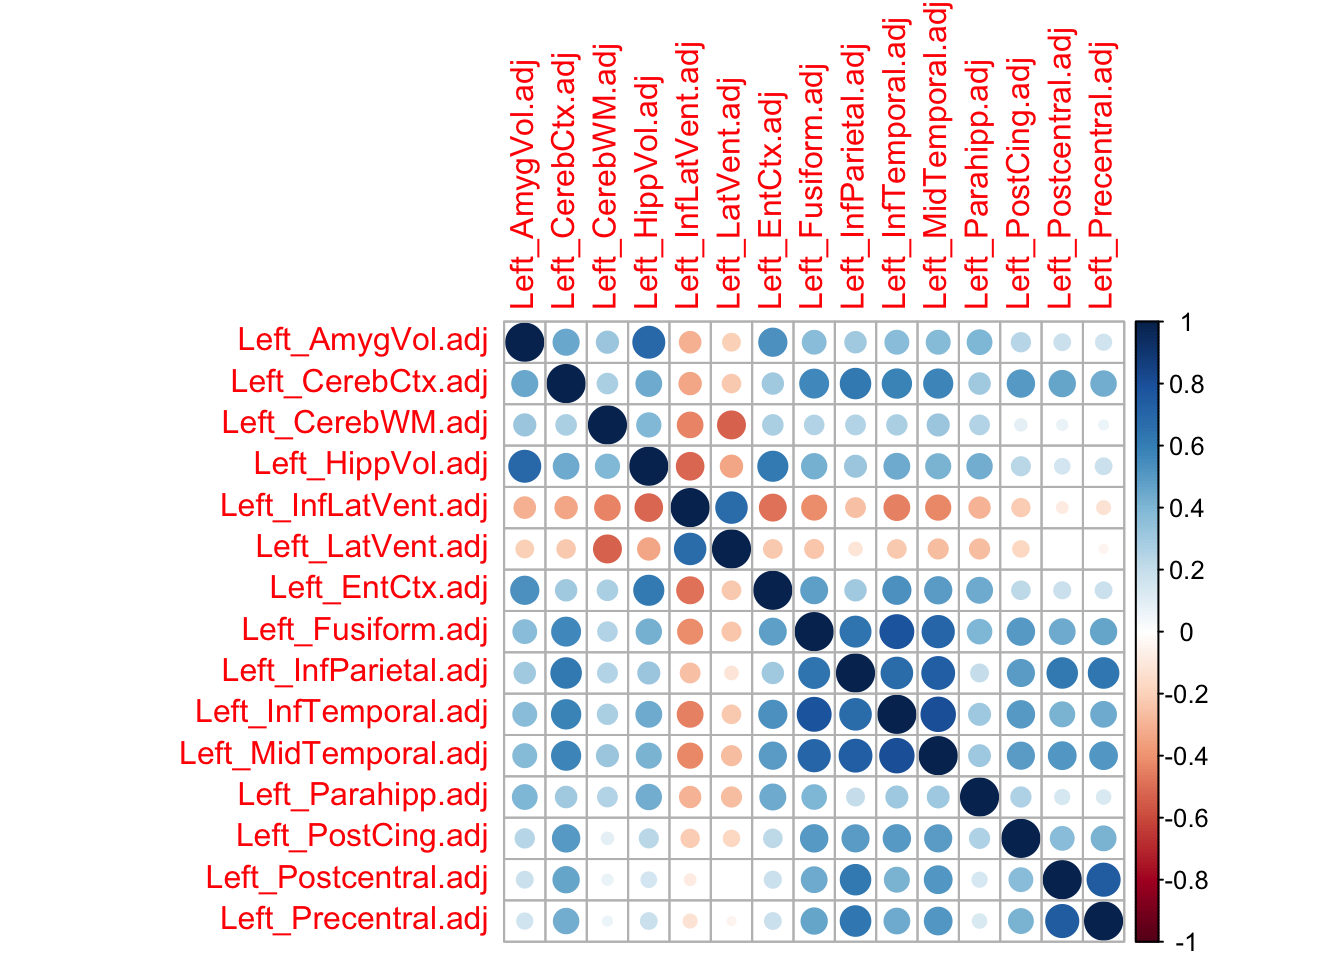
A figura acima evidencia as interdependências entre as medidas de neuroimagem. Agora, valide o GFLASSO por cross-validation (pode levar algumas horas em um laptop!) e determine as associações SNP–neuroimagem.
Observação: no exemplo abaixo, a tolerância de convergência e o número máximo de iterações são especificados. Sinta-se à vontade para testar outros valores!
system.time(CV <- cv_gflasso(X = scale(SNP), Y = scale(BM), R = DS, nCores = 2,
                 additionalOpts = list(delta_conv = 1e-5, iter_max = 1e5)))

## [1] 1.550294 1.471637 1.470133 1.514425 1.504215

##      user    system   elapsed
##  2611.492   323.441 51129.936

cv_plot_gflasso(CV)
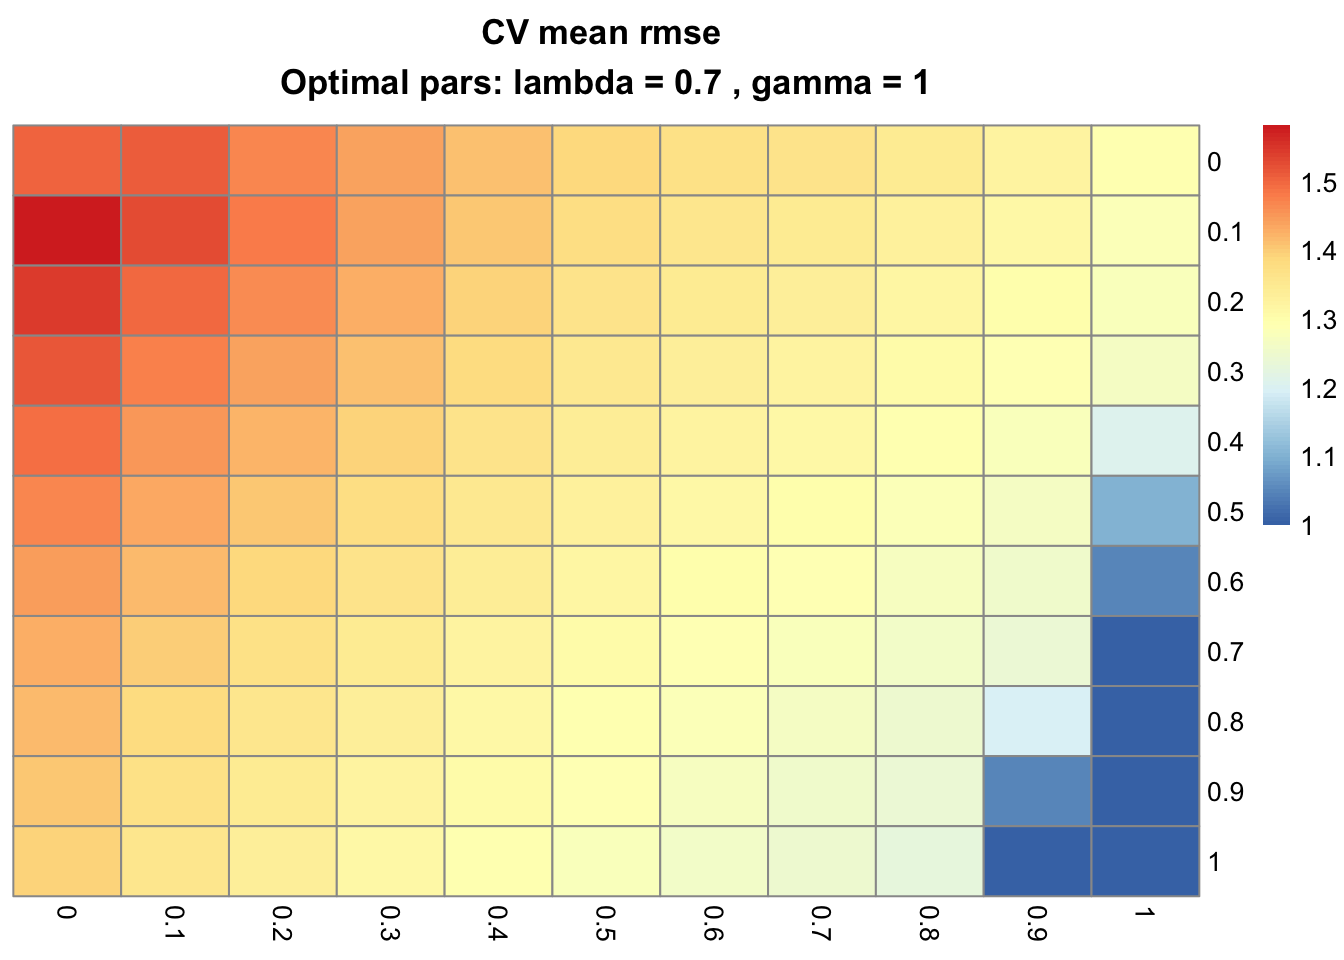
Ao desafiar o GFLASSO com modelos LASSO puros (γ = 0, primeira coluna), uma fusão de mínimos quadrados pura (λ = 0, primeira linha) e OLS (γ = 0 e λ = 0, célula superior esquerda), concluímos que este exemplo é melhor modelado com penalidades não nulas e, portanto, com o GFLASSO completo. Use os parâmetros ótimos da CV (λ = 0,7 e γ = 1) para ajustar um modelo GFLASSO e interpretar a matriz de coeficientes resultante:
gfMod <- gflasso(X = scale(SNP), Y = scale(BM), R = DS, opts = list(lambda = CV$optimal$lambda,
                                                                    gamma = CV$optimal$gamma,
                                                                    delta_conv = 1e-5,
                                                                    iter_max = 1e5))
colnames(gfMod$B) <- colnames(BM)
pheatmap(gfMod$B, annotation_row = data.frame("Gene" = bgsmtr_example_data$SNP_groups,
                                              row.names = rownames(gfMod$B)),
         show_rownames = F)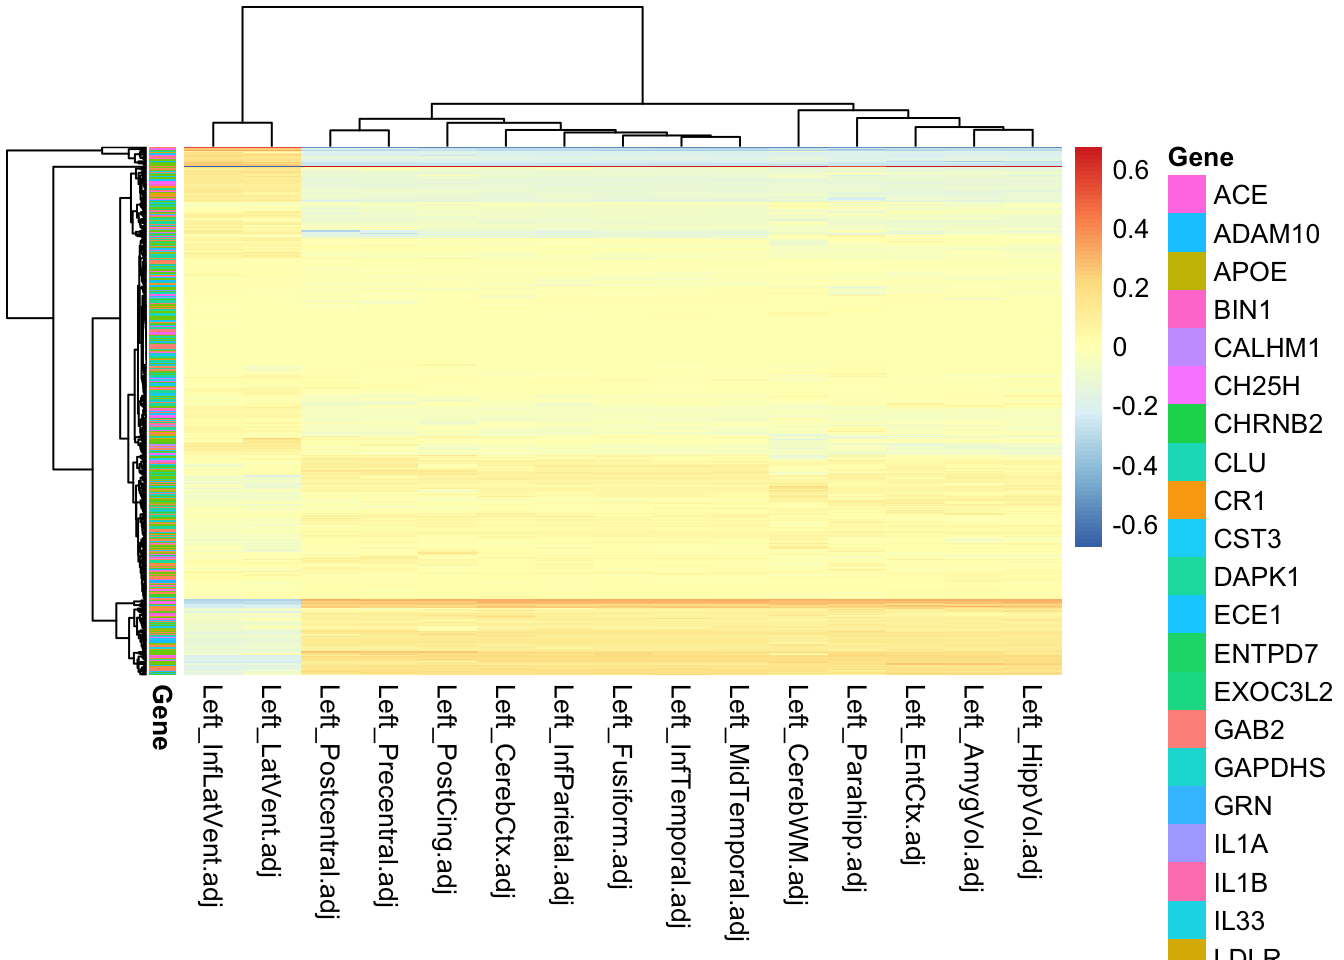
A figura acima mostra uma proporção muito grande de coeficientes iguais ou próximos de zero. Embora não haja um agrupamento óbvio de SNPs por genes (veja a anotação por linhas; a legenda está incompleta), há associações claras entre certos SNPs e traits.
Para verificar a existência de um mecanismo preditivo não aleatório, você pode repetir o procedimento após permutar os valores em X ou Y. Experimentos podem ajudar a elucidar causalidade e mecanismos a partir dos SNPs selecionados. Por exemplo, SNPs que afetam sequência e estrutura de proteína, prejudicando a depuração das placas de β-Amiloide associadas à doença de Alzheimer.
O GFLASSO combina regularização e fusão ao modelar múltiplas respostas, facilitando a identificação de associações entre preditores (X) e respostas (Y). Ele é mais indicado para dados de alta dimensionalidade com poucas observações, já que costuma ser mais lento que métodos concorrentes. Modelos gráficos gaussianos condicionais esparsos [4] e o modelo Bayesiano group-sparse de regressão multi-tarefa [5], por exemplo, podem ser preferidos sobretudo por ganhos de performance. Ainda assim, o GFLASSO é altamente interpretável. Recentemente usei o GFLASSO em uma abordagem integrativa de ômicas para descobrir novos genes lipídicos em milho [6].
Confira o tutorial de regularização da DataCamp: Ridge, Lasso e Elastic Net.
Kris e eu vamos adorar receber seu feedback. Este projeto é mantido pelo Kris no repositório krisrs1128/gflasso e também no meu, embora com mudanças frequentes, em monogenea/gflasso. Escreva quando quiser (francisco.lima278@gmail.com), todo feedback é bem-vindo.
Boa codificação!
Cursos de R
Curso
Curso
Curso
Tutorial
Zoumana Keita
12 min
Tutorial
Vidhi Chugh
14 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
DataCamp Team
10 min
Tutorial
DataCamp Team
2 min
Tutorial
Abid Ali Awan
11 min


