Corso
Introduzione a R
4 ore
3.1M
Mentre il campo del machine learning avanza rapidamente con lo sviluppo di tecniche sempre più sofisticate, poca attenzione è stata dedicata ai problemi multi-task ad alta dimensionalità che richiedono la previsione simultanea di più risposte. Questo tutorial ti mostrerà la potenza del Graph-Guided Fused LASSO (GFLASSO) nel prevedere più risposte all’interno di un unico framework di regressione lineare con regolarizzazione.
Nell’apprendimento supervisionato, in genere si punta a prevedere una variabile dipendente o di risposta a partire da un insieme di variabili esplicative o predittori su un insieme di campioni o osservazioni. I metodi di regolarizzazione introducono penalizzazioni che prevengono l’overfitting con dati ad alta dimensionalità, in particolare quando il numero di predittori supera quello delle osservazioni. Queste penalizzazioni si aggiungono alla funzione obiettivo così che le stime dei coefficienti dei predittori non informativi (che contribuiscono poco alla minimizzazione dell’errore) vengano a loro volta ridotte. Il least absolute shrinkage and selection operator (LASSO) [1] è uno di questi metodi.
Rispetto ai minimi quadrati ordinari (OLS), il LASSO è in grado di ridurre a zero esatto le stime dei coefficienti (β), escludendo così i predittori non informativi ed eseguendo una selezione delle variabili, tramite
$$argmin_\beta \sum_n(y_n-\hat{y_n})^2+\lambda\sum_{j}|\beta_{j}|$$
dove n e j denotano rispettivamente una data osservazione e un predittore. La somma dei quadrati dei residui (RSS), l’unico termine usato in OLS, può essere scritta in forma algebrica come $RSS = \sum_n(y_n-\hat{y_n})^2 = (y-X\beta)^T.(y-X\beta)$. La penalizzazione del LASSO è λ∑j|βj|, la norma L1 delle stime dei coefficienti pesata da λ.
E se dovessi prevedere più risposte correlate contemporaneamente, a partire da un insieme comune di predittori? Pur potendo cavartela con più modelli LASSO indipendenti, uno per ogni risposta, faresti meglio a coordinare quelle previsioni in base all’intensità dell’associazione tra le risposte. Questo perché tale coordinamento cancella la variazione specifica della risposta che include rumore: il punto di forza chiave del GFLASSO.
Un buon esempio è fornito nell’articolo originale, in cui gli autori risolvono le associazioni tra 34 marcatori genetici e 53 tratti dell’asma in 543 pazienti [2].
Sia X una matrice di dimensione n × p, con n osservazioni e p predittori, e Y una matrice di dimensione n × k, con le stesse n osservazioni e k risposte, ad esempio 1390 registrazioni distinte di acquisti di elettronica in 73 paesi, per prevedere le valutazioni di 50 produzioni Netflix in tutti i 73 paesi.
Modelli adatti a gestire coppie di dataset ad alta dimensionalità includono l’orthogonal two-way Partial Least Squares (O2PLS), la Canonical Correlation Analysis (CCA) e la Co-Inertia Analysis (CIA), tutti basati su decomposizione matriciale [3]. Inoltre, poiché questi modelli si fondano su variabili latenti (cioè proiezioni basate sui predittori originali), l’efficienza computazionale ha un costo in termini di interpretabilità.
Tuttavia, questo compromesso non sempre paga e può essere superato con la previsione diretta di k risposte individuali da un sottoinsieme selezionato di caratteristiche in X, in un framework di regressione unificato che tiene conto delle relazioni tra le risposte.
Matematicamente, il GFLASSO prende in prestito la regolarizzazione del LASSO [1] discussa sopra e costruisce il modello sulla struttura di dipendenza a grafo sottostante Y, quantificata dalla matrice di correlazione k × k (cioè la “forza dell’associazione” di cui si è parlato prima). Di conseguenza, risposte simili (o dissimili) saranno spiegate da un sottoinsieme simile (o dissimile) di predittori selezionati.
Più formalmente, seguendo la notazione usata nel manoscritto originale [2], la funzione obiettivo del GFLASSO è
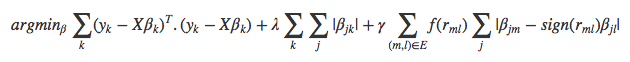
dove, su tutte le k risposte, ∑k(yk − X**βk)T.(yk − X**βk) fornisce l’RSS e λ∑k∑j|βj**k| la penalizzazione di regolarizzazione presa dal LASSO, pesata dal parametro λ e applicata ai coefficienti β di ogni singolo predittore j. La novità del GFLASSO risiede in
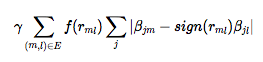
la penalizzazione di fusione pesata da γ, che fa sì che la differenza assoluta tra i coefficienti βj**m e βj**l, per qualsiasi predittore j e coppia di risposte m e l, sia tanto più piccola (risp. più grande) quanto più positiva (risp. più negativa) è la loro correlazione a coppie, trasformata o meno, f(rm**l). Questa penalizzazione di fusione privilegia la variazione globalmente significativa nelle risposte rispetto al rumore di ciascuna di esse. Quando la correlazione a coppie è prossima a zero, non ha effetto, e in tal caso rimani con un puro LASSO. Questa struttura di correlazione sottostante di tutte le k risposte, che può essere rappresentata come una rete pesata, di default è la correlazione assoluta, f(rm**l)=|rm**l|, ma può essere trasformata per creare varianti del GFLASSO con qualsiasi funzione specificata dall’utente, come
con ampio margine per innovare. Sebbene la 2. sia molto meno intensiva computazionalmente rispetto alla 1. e alla correlazione assoluta di default [2], richiede comunque una soglia predefinita, per esempio τ = 0,8.
In sintesi, per adattare un modello GFLASSO ti serviranno una matrice di predittori X, una matrice di risposte Y e una matrice di correlazione che rappresenti la forza di associazione tra tutte le coppie di risposte in Y. Nota che il GFLASSO produce una matrice di β di dimensione p × k, a differenza del LASSO (p × 1), e questa matrice di coefficienti porta le associazioni tra una data risposta k e un predittore j.
Io e Kris Sankaran stiamo lavorando a un pacchetto R sperimentale che implementa il GFLASSO insieme a metodi di cross-validation e di visualizzazione. Abbiamo recentemente implementato il multi-threading usando il pacchetto doParallel, ottenendo routine di cross-validation (CV) molto più veloci.
Per eseguire GFLASSO in R dovrai installare devtools, caricarlo e installare il pacchetto gflasso dal mio repository GitHub. La dimostrazione sarà condotta su un dataset contenuto nel pacchetto bgsmtr. Ti consiglio anche di installare corrplot e pheatmap per visualizzare i risultati.
# Install the packages if necessary
#install.packages("devtools")
#install.packages("bgsmtr")
#install.packages("corrplot")
#install.packages("pheatmap")
library(devtools)
library(bgsmtr)
library(corrplot)
library(pheatmap)
#install_github("monogenea/gflasso")
library(gflasso)Puoi eseguire facilmente la simulazione descritta nella pagina di aiuto della funzione di CV cv_gflasso(). Di default, la CV calcola la root mean squared error (RMSE) su una singola ripetizione di una CV a 5 fold, su tutte le coppie possibili tra λ ∈ {0, 0.1, 0.2, ..., 0.9, 1} e γ ∈ {0, 0.1, 0.2, ..., 0.9, 1}, ovvero la griglia di tuning.
Nota che funzionano anche funzioni di errore fornite dall’utente!
Oltre alle assunzioni statistiche intrinseche e alle prestazioni in velocità, la scelta dei range della griglia di tuning dipende in larga parte dal mean-centering e dallo scaling a varianza unitaria di tutte le colonne in X e Y, quindi assicurati di farlo prima.
Nell’esempio seguente non ne avrai bisogno, poiché estrarrai campioni casuali da una distribuzione normale standard. Puoi provare a derivare la penalizzazione di fusione da una rete di correlazione non pesata, con una soglia di r > 0,8:
?cv_gflasso
set.seed(100)
X <- matrix(rnorm(100 * 10), 100, 10)
u <- matrix(rnorm(10), 10, 1)
B <- u %*% t(u) + matrix(rnorm(10 * 10, 0, 0.1), 10, 10)
Y <- X %*% B + matrix(rnorm(100 * 10), 100, 10)
R <- ifelse(cor(Y) > .8, 1, 0)
system.time(testCV <- cv_gflasso(X, Y, R, nCores = 1))

## [1] 1.826146 1.819430 1.384595 1.420058 1.408619

##    user  system elapsed
##  45.808   3.070  55.271

system.time(testCV <- cv_gflasso(X, Y, R, nCores = 2))

## [1] 1.595413 1.492953 1.469917 1.366832 1.441642

##    user  system elapsed
##  22.231   1.698  26.441

cv_plot_gflasso(testCV)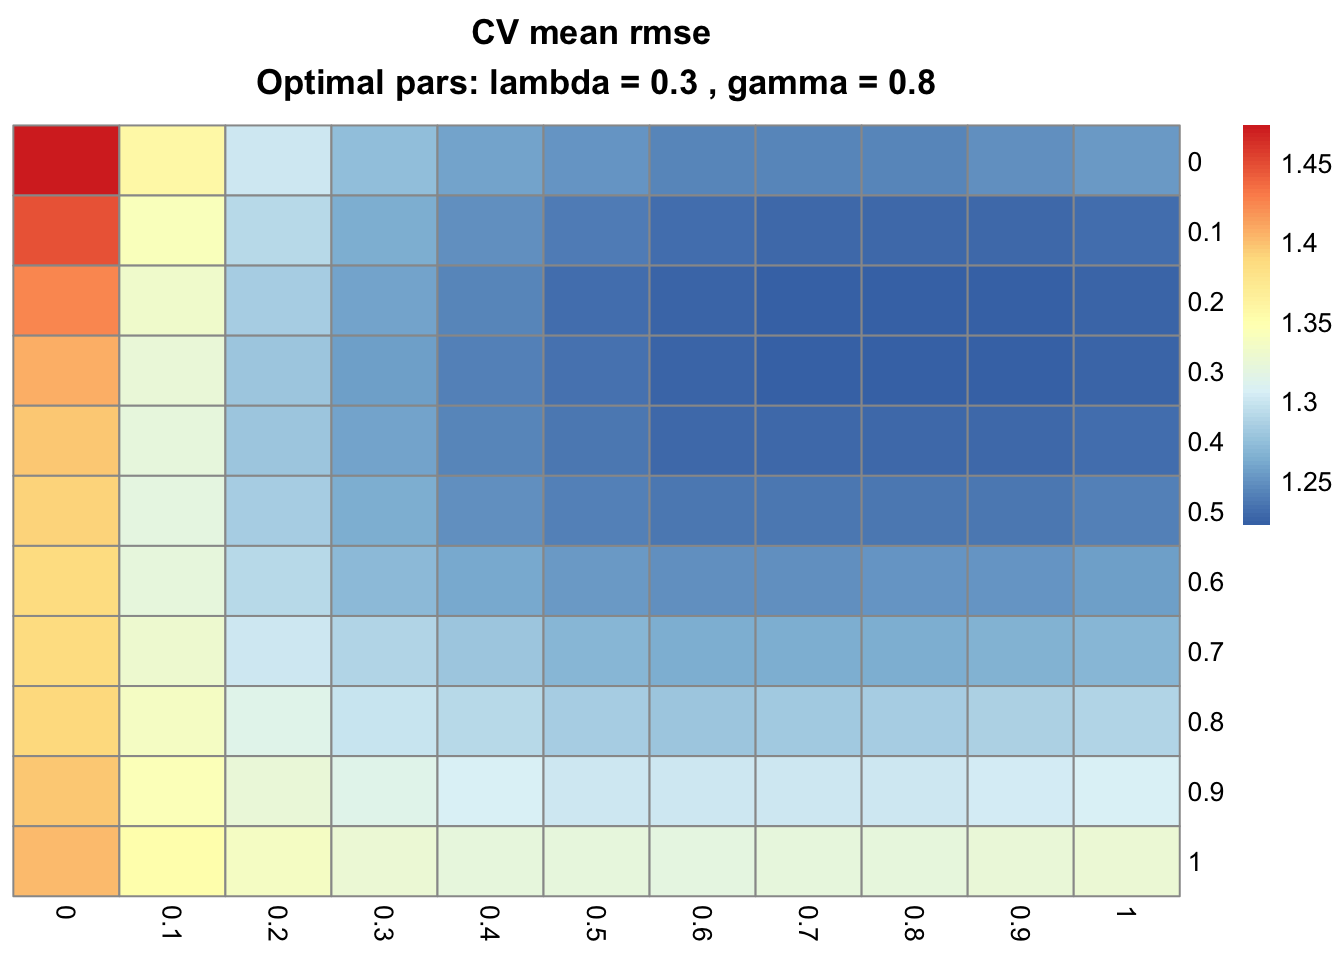
I valori ottimali di λ (righe) e γ (colonne) che minimizzano la RMSE in questa simulazione, 0,3 e 0,8 rispettivamente, catturano effettivamente le relazioni imposte.
Suggerimento: prova a rieseguire questo esempio con una metrica diversa, il coefficiente di determinazione (R2). Un vantaggio chiave dell’uso di R2 è che varia da 0 a 1.
Ricorda che quando fornisci una funzione di bontà di adattamento personalizzata err_fun(), devi definire se massimizzare o minimizzare la metrica risultante usando l’argomento err_opt.
Il seguente esempio mira a massimizzare R2, usando una rete di associazione pesata con coefficienti di correlazione al quadrato (cioè f(rm**l)=rm**l2). Se hai più di 2 core, modifica pure l’argomento nCores per dargli una spinta!
# Write R2 function
R2 <- function(pred, y){
      cor(as.vector(pred), as.vector(y))**2
}

# X, u, B and Y are still in memory
R <- cor(Y)**2

# Change nCores, if you have more than 2, re-run CV
testCV <- cv_gflasso(X, Y, R, nCores = 2, err_fun = R2, err_opt = "max")

## [1] 0.6209191 0.7207394 0.7262781 0.7193907 0.6303187

cv_plot_gflasso(testCV)
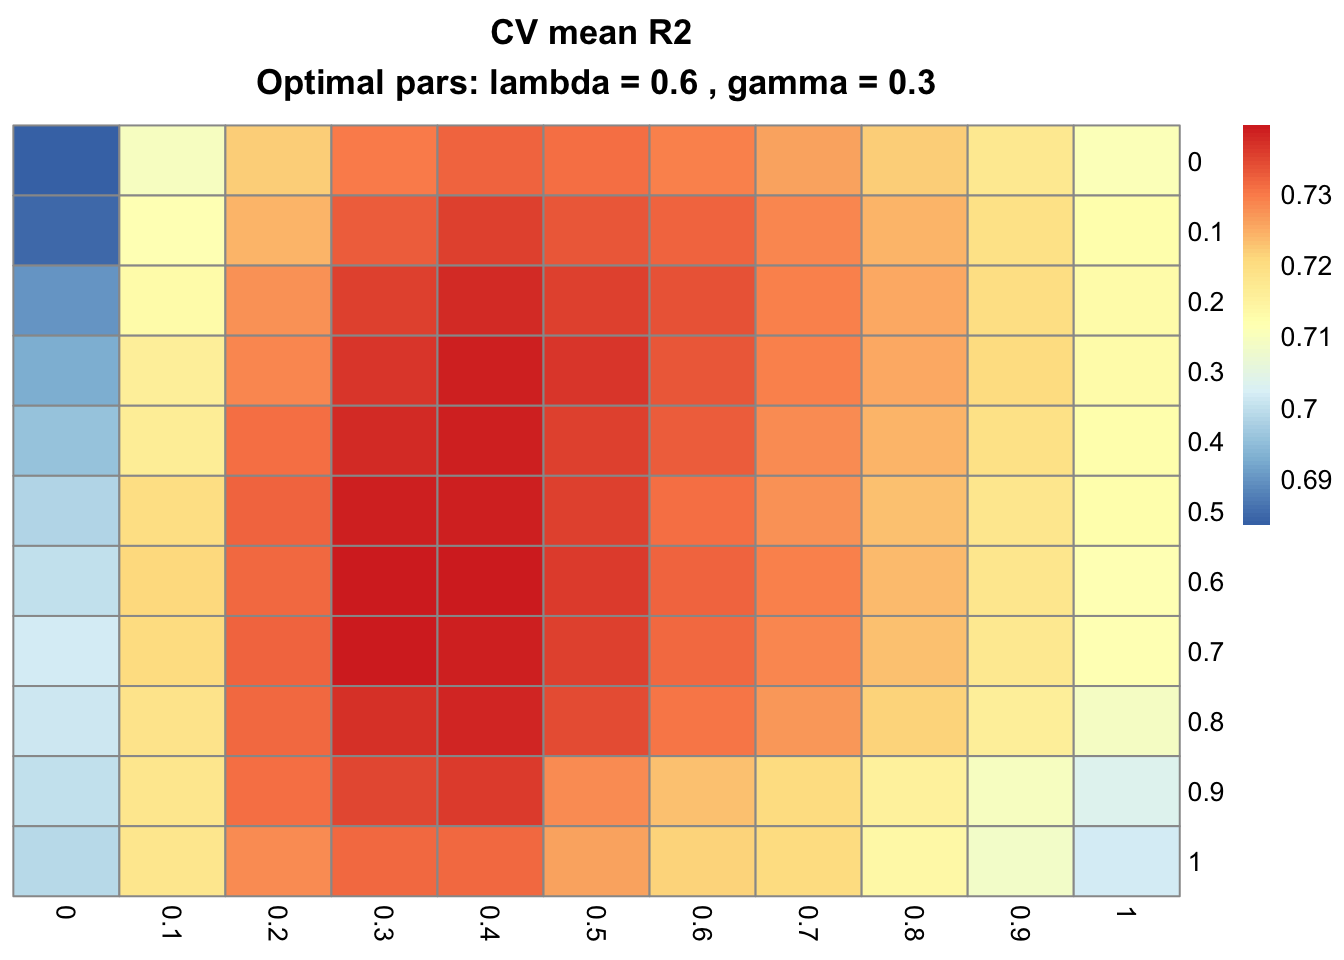
I parametri ottimali λ e γ sono ora 0,6 e 0,3 rispettivamente.
Nota anche che gli oggetti cv_gflasso sono liste singole con quattro elementi: la media ($mean) e l’errore standard ($SE) della metrica su tutte le celle della griglia, i parametri ottimali λ e γ ($optimal) e il nome della funzione di bontà di adattamento ($err_fun). Il modello cross-validato di questo esempio privilegia chiaramente sia la sparsità (λ) sia la fusione (γ).
Infine, ricorda che puoi perfezionare ulteriori parametri, come la soglia di convergenza del gradiente di Nesterov δ e il numero massimo di iterazioni, passando rispettivamente delta_conv e iter_max a additionalOpts. Questi verranno usati nell’esempio seguente.
Per dimostrare la semplicità e la robustezza del GFLASSO in un problema relativamente ad alta dimensionalità, modellerai ora i dataset bgsmtr_example_data ottenuti dall’Alzheimer’s Disease Neuroimaging Initiative (ADNI-1).
Si tratta di un oggetto lista con 3 elementi, parte del pacchetto bgsmtr, che consiste in 15 misure di neuroimaging strutturale e 486 single nucleotide polymorphisms (SNP, marcatori genetici) determinati su un campione di 632 soggetti. È importante notare che i 486 SNP coprono 33 geni ritenuti associati al morbo di Alzheimer.
Il tuo compito è prevedere le misure morfologiche di neuroimaging a partire dai dati SNP, sfruttando la struttura di correlazione delle prime.
Iniziamo organizzando i dati ed esplorando le interdipendenze tra tutte le feature di neuroimaging:
data(bgsmtr_example_data)
str(bgsmtr_example_data)

## List of 3
##  $ SNP_data     : int [1:486, 1:632] 2 0 2 0 0 0 0 1 0 1 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:486] "rs4305" "rs4309" "rs4311" "rs4329" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...
##  $ SNP_groups   : chr [1:486] "ACE" "ACE" "ACE" "ACE" ...
##  $ BrainMeasures: num [1:15, 1:632] 116.5 4477.9 28631.9 34.1 -473.4 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:15] "Left_AmygVol.adj" "Left_CerebCtx.adj" "Left_CerebWM.adj" "Left_HippVol.adj" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...

# Transpose, so that samples are distributed as rows, predictors / responses as columns
SNP <- t(bgsmtr_example_data$SNP_data)
BM <- t(bgsmtr_example_data$BrainMeasures)

# Define dependency structure
DS <- cor(BM)

# Plot correlation matrix of the 15 neuroimaging measures
corrplot(DS)
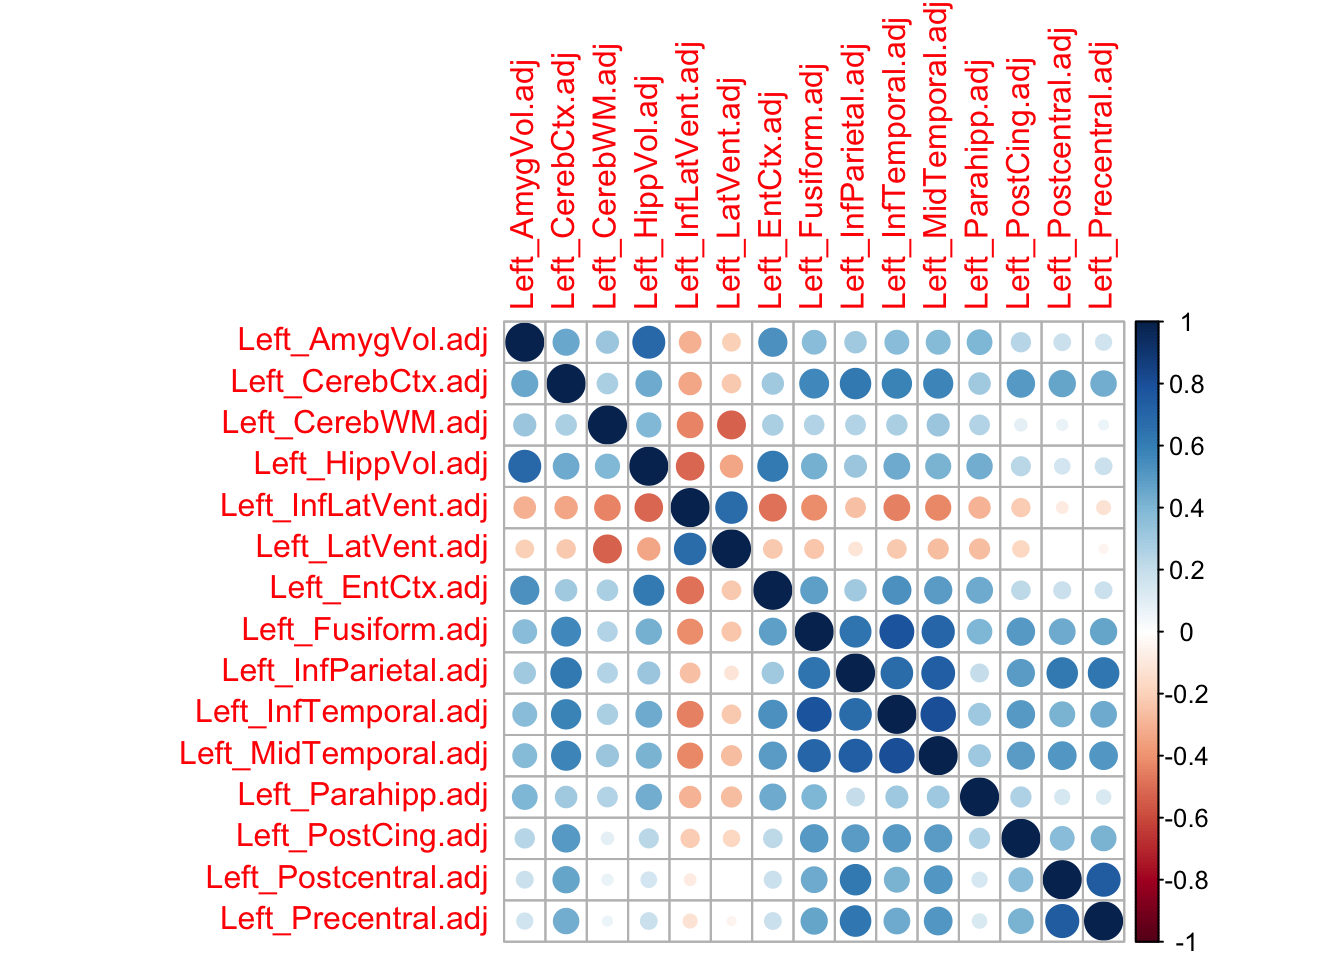
La figura sopra evidenzia le interdipendenze tra le feature di neuroimaging. Prova ora a eseguire la cross-validation del GFLASSO (può richiedere fino a un paio d’ore su un laptop!) e determina le associazioni SNP–neuroimaging.
Nota che nell’esempio seguente sono specificate la tolleranza di convergenza e il numero massimo di iterazioni. Sentiti libero di provare valori diversi!
system.time(CV <- cv_gflasso(X = scale(SNP), Y = scale(BM), R = DS, nCores = 2,
                 additionalOpts = list(delta_conv = 1e-5, iter_max = 1e5)))

## [1] 1.550294 1.471637 1.470133 1.514425 1.504215

##      user    system   elapsed
##  2611.492   323.441 51129.936

cv_plot_gflasso(CV)
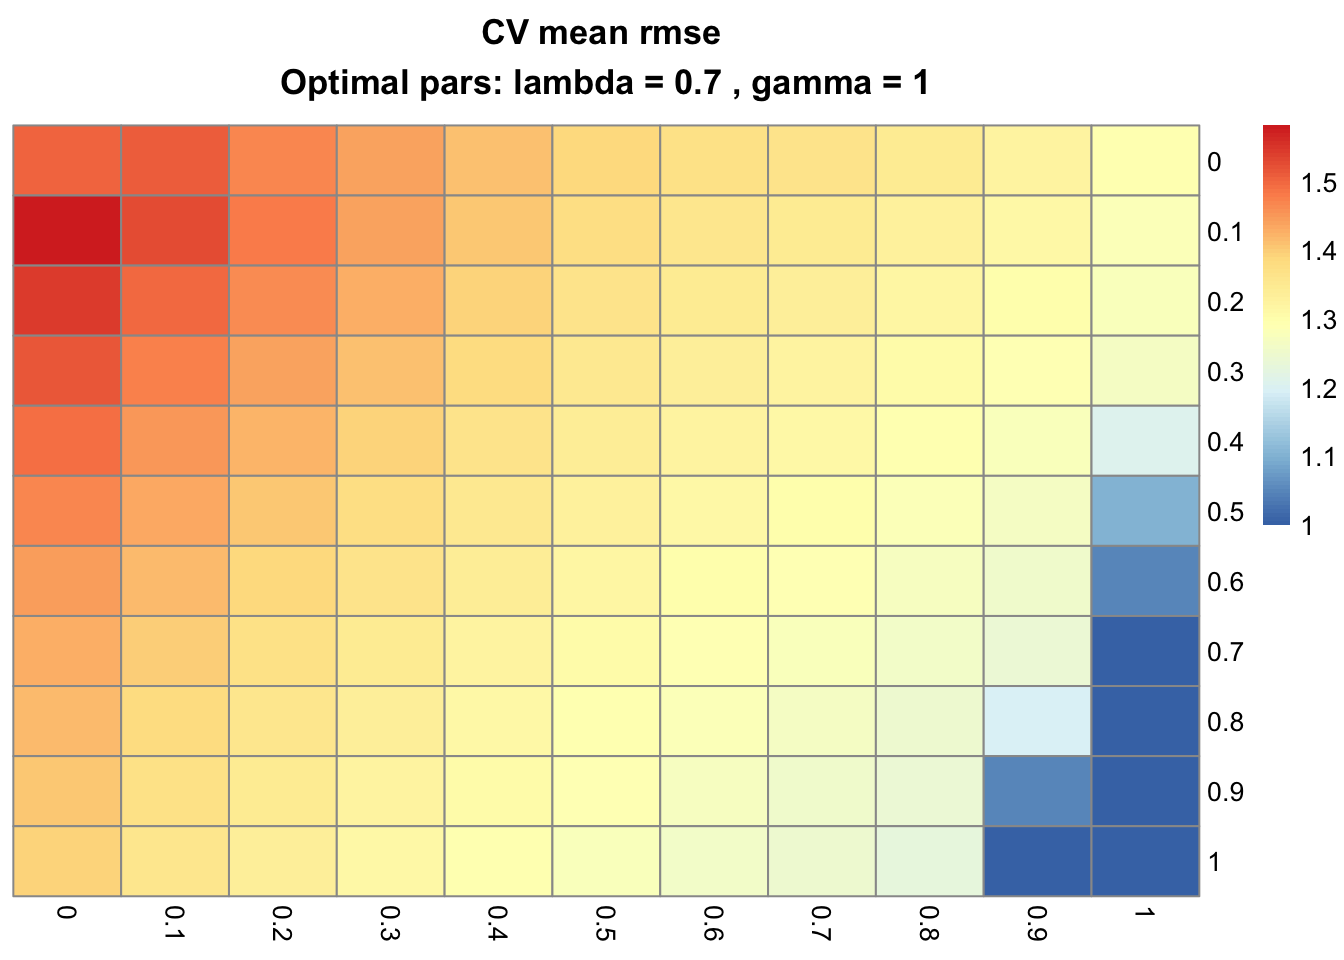
Confrontando il GFLASSO con modelli LASSO puri (γ = 0, prima colonna), un pure fusion least squares (λ = 0, prima riga) e OLS (&gamma = 0 e λ = 0, cella in alto a sinistra), possiamo concludere che il presente esempio è meglio modellato con pesi di penalizzazione non nulli e, di conseguenza, con il GFLASSO completo. Prendi i parametri CV ottimali (λ = 0,7 e γ = 1) per costruire un modello GFLASSO e interpreta la matrice dei coefficienti risultante:
gfMod <- gflasso(X = scale(SNP), Y = scale(BM), R = DS, opts = list(lambda = CV$optimal$lambda,
                                                                    gamma = CV$optimal$gamma,
                                                                    delta_conv = 1e-5,
                                                                    iter_max = 1e5))
colnames(gfMod$B) <- colnames(BM)
pheatmap(gfMod$B, annotation_row = data.frame("Gene" = bgsmtr_example_data$SNP_groups,
                                              row.names = rownames(gfMod$B)),
         show_rownames = F)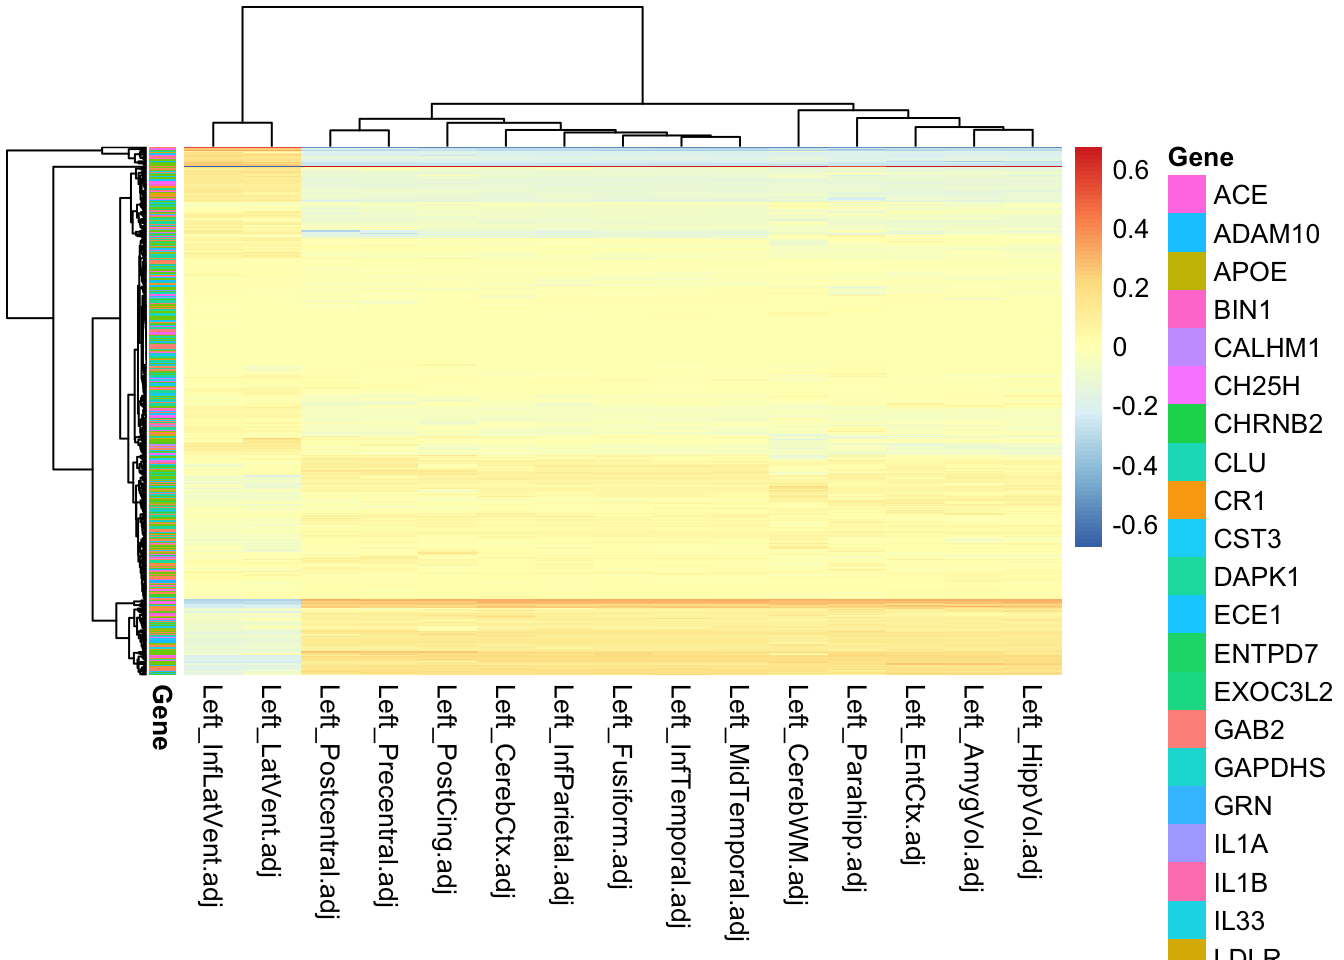
La figura sopra mostra una proporzione molto elevata di coefficienti con valori zero o prossimi allo zero. Sebbene non emerga un chiaro raggruppamento degli SNP rispetto ai geni (vedi annotazione per riga, nota che la legenda è incompleta), ci sono chiare associazioni tra alcuni SNP e tratti.
Per accertare l’esistenza di un meccanismo predittivo non casuale, potresti ripetere la procedura dopo aver permutato i valori in X o in Y. L’attività sperimentale potrebbe aiutare a chiarire causalità e meccanismi a partire dagli SNP selezionati. Ad esempio, SNP che influenzano la sequenza e la struttura della proteina, compromettendo la rimozione delle placche di β-amiloide alla base del morbo di Alzheimer.
Il GFLASSO impiega sia la regolarizzazione sia la fusione quando modella più risposte, facilitando così l’identificazione delle associazioni tra predittori (X) e risposte (Y). È particolarmente utile con dati ad alta dimensionalità e pochissime osservazioni, poiché è molto più lento rispetto a metodi concorrenti. I modelli grafici gaussiani condizionali sparsi [4] e il modello bayesiano group-sparse multi-task regression [5], ad esempio, potrebbero essere preferiti soprattutto per i guadagni prestazionali. Tuttavia, il GFLASSO è altamente interpretabile. Ho utilizzato recentemente il GFLASSO in un approccio integrativo omico per scoprire nuovi geni lipidici nel mais [6].
Dai un’occhiata al tutorial sulla regolarizzazione: Ridge, Lasso ed Elastic Net di DataCamp.
Io e Kris saremo felicissimi di sentirti. Questo progetto è attualmente mantenuto da Kris nel repo krisrs1128/gflasso e anche tramite il mio, sebbene soggetto a frequenti cambiamenti, su monogenea/gflasso. Scrivimi quando vuoi (francisco.lima278@gmail.com), ogni feedback è benvenuto.
Buon coding!
Corsi R
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



