{count, plural, one {Kurs} other {Kurs}}
R’ye Giriş
{hours} sa
3.1M
Makine öğrenmesi alanı giderek daha gelişmiş tekniklerle hızla ilerlerken, birden çok yanıtın eşzamanlı tahminini gerektiren yüksek boyutlu çoklu görev problemlerine nispeten az dikkat gösterildi. Bu eğitim, tek bir düzenlileştirilmiş doğrusal regresyon çerçevesinde birden çok yanıtın tahmininde Grafik Rehberli Birleşik LASSO’nun (GFLASSO) gücünü gösterecek.
Gözetimli öğrenmede, genellikle bir örneklem kümesi üzerindeki bir dizi açıklayıcı değişken ya da yordayıcıdan bağımlı veya yanıt değişkenini tahmin etmeyi amaçlarsınız. Düzenlileştirme yöntemleri, özellikle yordayıcı sayısının gözlem sayısını aştığı yüksek boyutlu verilerde, aşırı uyumu önleyen cezalar getirir. Bu cezalar amaç fonksiyonuna eklenir; böylece bilgilendirici olmayan yordayıcıların (hata minimizasyonuna çok az katkıda bulunan) katsayı tahminleri de küçültülür. En küçük mutlak büzüşme ve seçim operatörü (LASSO) [1] bu yöntemlerden biridir.
Sıradan en küçük karelere (OLS) kıyasla LASSO, katsayı tahminlerini (β) tam olarak sıfıra küçültebilir; böylece bilgilendirici olmayan yordayıcıları dışlar ve özellik seçimi yapar; şu şekilde:
$$argmin_\beta \sum_n(y_n-\hat{y_n})^2+\lambda\sum_{j}|\beta_{j}|$$
burada n ve j sırasıyla herhangi bir gözlemi ve yordayıcıyı ifade eder. OLS’de kullanılan tek terim olan artık kareler toplamı (RSS), cebirsel olarak eşdeğer biçimde $RSS = \sum_n(y_n-\hat{y_n})^2 = (y-X\beta)^T.(y-X\beta)$ olarak yazılabilir. LASSO cezası, katsayı tahminlerinin L1 normu olan ve λ ile ağırlıklandırılan λ∑j|βj|’dır.
Peki, ortak bir yordayıcı kümesinden aynı anda birden çok ilişkili yanıtı tahmin etmeye kalkışsaydınız? Etkin olarak her yanıt için birer bağımsız LASSO modeliyle de idare edebilirsiniz; ancak bu tahminleri yanıtlar arasındaki ilişki gücüyle koordine etmek daha iyi sonuç verebilir. Çünkü bu tür bir koordinasyon, gürültüyü de içeren yanıta özgü varyasyonu giderir — GFLASSO’nun kilit gücü budur.
Orijinal makalede iyi bir örnek verilmiştir; yazarlar 543 hastada 34 genetik belirteç ile 53 astım özelliği arasındaki ilişkileri çözümler [2].
X’in n × p boyutunda, n gözlem ve p yordayıcıdan oluşan bir matris; Y’nin ise aynı n gözleme ve k yanıta sahip, n × k boyutunda bir matris olduğunu varsayalım; örneğin 73 ülkede 1390 farklı elektronik alışveriş kaydı üzerinden 50 Netflix yapımının tüm 73 ülkedeki puanlarını tahmin etmek.
Yüksek boyutlu veri çiftlerini modellemeye elverişli modeller arasında ortogonal iki yönlü Kısmi En Küçük Kareler (O2PLS), Kanonik Korelasyon Analizi (CCA) ve Eş-atalet Analizi (CIA) bulunur; bunların tümü matris ayrışımı içerir [3]. Ayrıca, bu modeller gizli değişkenlere dayandığı (yani özgün yordayıcılara dayalı izdüşümler) için hesaplama verimliliği yorumlanabilirlik pahasına elde edilir.
Ne var ki, bu ödünleşim her zaman karşılığını vermez ve X’te seçilen özelliklerden k bireysel yanıtın doğrudan tahminiyle, yanıtlar arası ilişkileri dikkate alan birleşik bir regresyon çerçevesinde tersine çevrilebilir.
Matematiksel olarak GFLASSO, yukarıda tartışılan LASSO’nun düzenlileştirmesini [1] ödünç alır ve modeli, Y’nin altında yatan ve k × k korelasyon matrisiyle nicelenen grafik bağımlılık yapısı üzerine kurar (yani az önce okuduğunuz ‘ilişki gücü’). Sonuç olarak, benzer (ya da benzer olmayan) yanıtlar, seçilmiş yordayıcıların benzer (ya da benzer olmayan) bir altkümesiyle açıklanacaktır.
Daha biçimsel olarak, ve özgün makaledeki [2] gösterimi izleyerek, GFLASSO’nun amaç fonksiyonu şöyledir
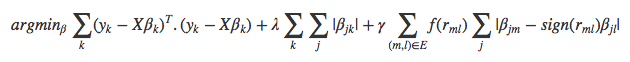
burada tüm k yanıt boyunca, ∑k(yk − X**βk)T.(yk − X**βk) RSS’yi sağlar ve λ∑k∑j|βj**k|, LASSO’dan ödünç alınan ve parametre λ ile ağırlıklandırılan, her bir yordayıcı j’nin katsayıları β üzerinde etkili düzenlileştirme cezasıdır. GFLASSO’nun yeniliği şuradadır:
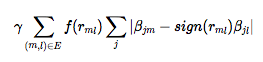
γ ile ağırlıklandırılan birleşim cezası, herhangi bir yordayıcı j ile bir yanıt çifti m ve l’den gelen βj**m ve βj**l katsayıları arasındaki mutlak farkın, ikili korelasyonları ne kadar pozitifse (sırasıyla ne kadar negatifse) o kadar küçük (sırasıyla o kadar büyük) olmasını sağlar; dönüştürülmüş olsun ya da olmasın, f(rm**l). Bu birleşim cezası, yanıtların her birinden gelen gürültüye karşı, yanıtlar arasındaki küresel olarak anlamlı varyasyonu tercih eder. İkili korelasyon sıfıra yakınsa bir etkisi yoktur; bu durumda elinizde saf bir LASSO kalır. Tüm k yanıtın bu temel korelasyon yapısı, ağırlıklı bir ağ yapısı olarak temsil edilebilir ve varsayılan olarak mutlak korelasyondur, f(rm**l)=|rm**l|; ancak aşağıdaki gibi, kullanıcının belirleyeceği herhangi bir fonksiyonla dönüştürülerek GFLASSO varyantları oluşturulabilir:
yenilik için daha pek çok alan vardır. 2. seçenek, 1.’e ve varsayılan mutlak korelasyona [2] kıyasla çok daha az hesaplama yüküne sahiptir; ancak önceden tanımlı bir eşik gerektirir; örneğin τ = 0.8.
Özetle, bir GFLASSO modeli kurmak için bir yordayıcı matrisi X, bir yanıt matrisi Y ve Y’deki tüm yanıt çiftleri arasındaki ilişki gücünü betimleyen bir korelasyon matrisi gerekir. GFLASSO’nun, LASSO’dan farklı olarak (p × 1), p × k boyutunda bir β matrisi verdiğini ve bu katsayı matrisinin herhangi bir yanıt k ile yordayıcı j arasındaki ilişkileri taşıdığını unutmayın.
Kris Sankaran ile birlikte, GFLASSO’yu çapraz doğrulama ve görselleştirme yöntemleriyle birlikte uygulayan deneysel bir R paketi üzerinde çalışıyoruz. Kısa süre önce doParallel paketini kullanarak çoklu iş parçacığı desteği ekledik ve çapraz doğrulama (CV) rutinlerini çok daha hızlı hale getirdik.
R’da GFLASSO’yu çalıştırmak için devtools’u kurmanız, yüklemeniz ve GitHub depomdan gflasso paketini kurmanız gerekir. Gösterimi, bgsmtr paketinde yer alan bir veri kümesi üzerinde yapacağız. Sonuçları görselleştirmek için corrplot ve pheatmap kurmanızı da öneririm.
# Install the packages if necessary
#install.packages("devtools")
#install.packages("bgsmtr")
#install.packages("corrplot")
#install.packages("pheatmap")
library(devtools)
library(bgsmtr)
library(corrplot)
library(pheatmap)
#install_github("monogenea/gflasso")
library(gflasso)cv_gflasso() CV fonksiyonunun yardım sayfasında özetlenen simülasyonu kolayca çalıştırabilirsiniz. Varsayılan olarak CV, ayar ızgarasında λ ∈ {0, 0.1, 0.2, ..., 0.9, 1} ile γ ∈ {0, 0.1, 0.2, ..., 0.9, 1} arasındaki tüm olası ikililer üzerinde, 5 katlı bir CV’nin tek yinelemesi boyunca kök ortalama kare hatayı (RMSE) hesaplar.
Not: Kullanıcı tarafından sağlanan hata fonksiyonları da çalışır!
Doğal istatistiksel varsayımlar ve hız performansına ek olarak, ayar ızgarası aralıklarının seçimi büyük ölçüde X ve Y’deki tüm sütunların ortalama-merkezleme ve birim-varyans ölçeklemesine bağlıdır; lütfen bunu önceden yaptığınızdan emin olun.
Aşağıdaki örnekte buna gerek yok; çünkü standart normal dağılımdan rastgele örnekler çekilecektir. Ağırlıksız bir korelasyon ağından, r > 0.8 eşiğiyle bir birleşim cezası türetmeyi deneyebilirsiniz:
?cv_gflasso
set.seed(100)
X <- matrix(rnorm(100 * 10), 100, 10)
u <- matrix(rnorm(10), 10, 1)
B <- u %*% t(u) + matrix(rnorm(10 * 10, 0, 0.1), 10, 10)
Y <- X %*% B + matrix(rnorm(100 * 10), 100, 10)
R <- ifelse(cor(Y) > .8, 1, 0)
system.time(testCV <- cv_gflasso(X, Y, R, nCores = 1))

## [1] 1.826146 1.819430 1.384595 1.420058 1.408619

##    user  system elapsed
##  45.808   3.070  55.271

system.time(testCV <- cv_gflasso(X, Y, R, nCores = 2))

## [1] 1.595413 1.492953 1.469917 1.366832 1.441642

##    user  system elapsed
##  22.231   1.698  26.441

cv_plot_gflasso(testCV)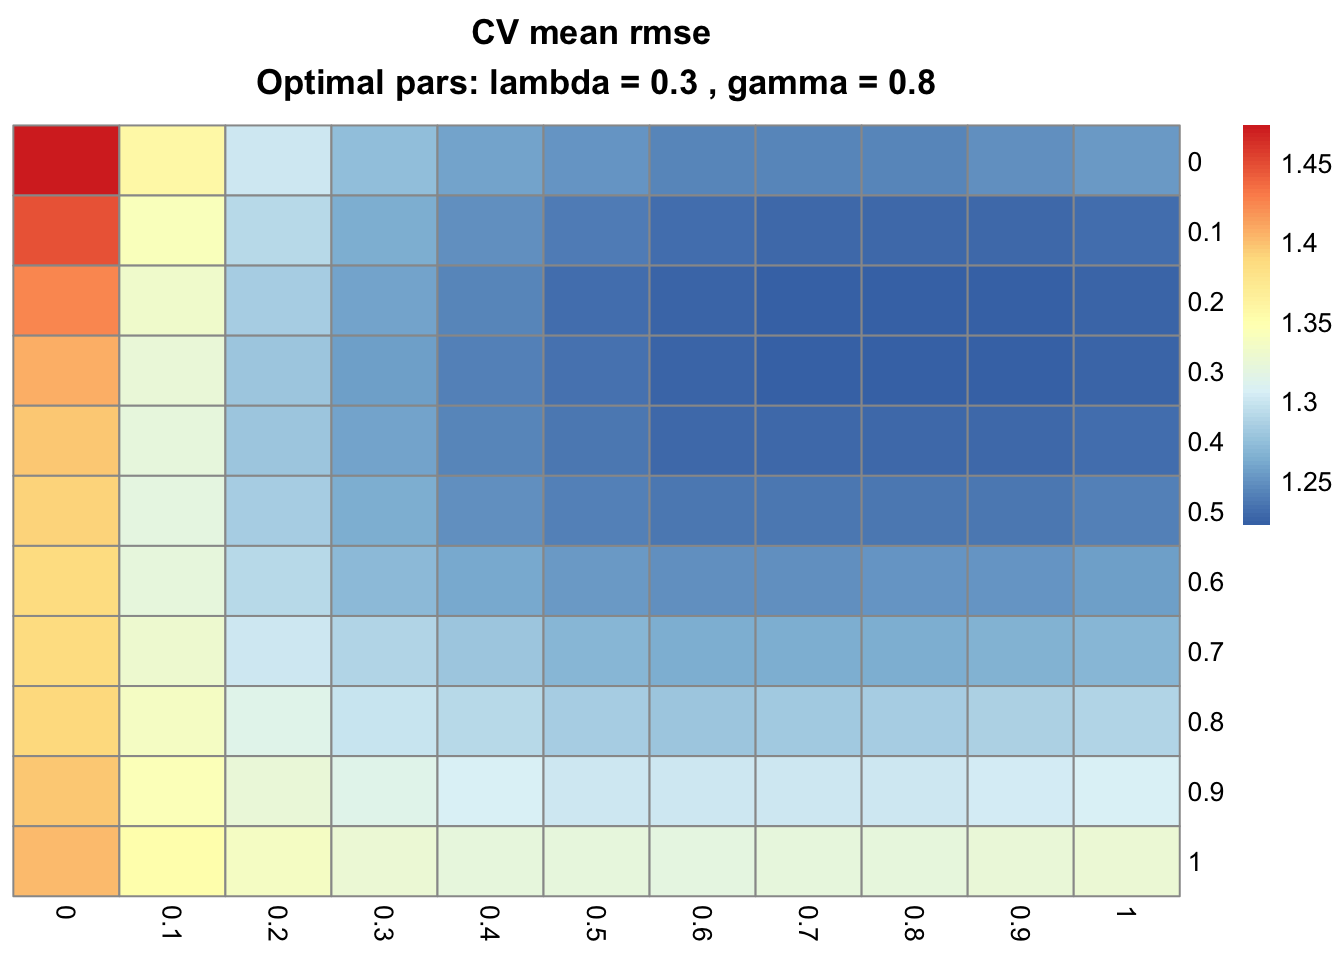
Bu simülasyonda RMSE’yi en aza indiren en iyi λ (satırlar) ve γ (sütunlar) değerleri, sırasıyla 0.3 ve 0.8, dayatılan ilişkileri yakalamaktadır.
İpucu: Bu örneği, belirleme katsayısı (R2) gibi farklı bir metrikle yeniden çalıştırmayı deneyin. R2 kullanmanın önemli bir avantajı, 0 ile 1 arasında değişmesidir.
Özel bir uyum iyiliği fonksiyonu err_fun() sağladığınızda, ortaya çıkan metriğin err_opt bağımsız değişkeniyle en büyüklenip en küçüklenmeyeceğini belirtmeniz gerektiğini unutmayın.
Aşağıdaki örnek, kare korelasyon katsayılarıyla ağırlıklandırılmış bir ilişki ağı kullanarak (yani f(rm**l)=rm**l2), R2’yi en büyüklemeyi amaçlar. İkiden fazla çekirdeğiniz varsa, nCores bağımsız değişkenini değiştirip hızlandırabilirsiniz!
# Write R2 function
R2 <- function(pred, y){
      cor(as.vector(pred), as.vector(y))**2
}

# X, u, B and Y are still in memory
R <- cor(Y)**2

# Change nCores, if you have more than 2, re-run CV
testCV <- cv_gflasso(X, Y, R, nCores = 2, err_fun = R2, err_opt = "max")

## [1] 0.6209191 0.7207394 0.7262781 0.7193907 0.6303187

cv_plot_gflasso(testCV)
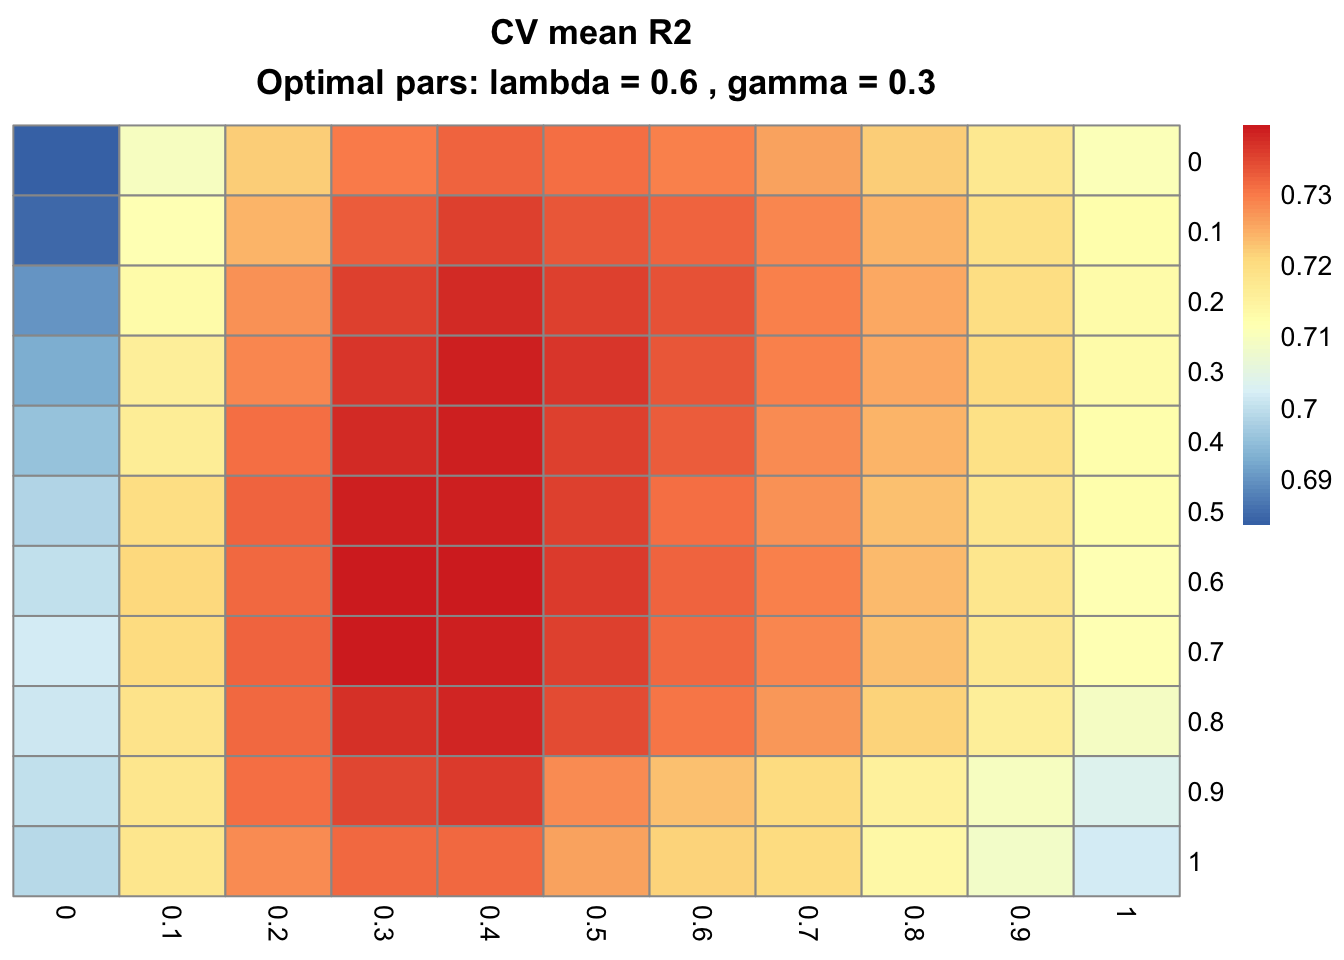
En iyi λ ve γ parametreleri artık sırasıyla 0.6 ve 0.3.
Ayrıca, cv_gflasso nesnelerinin dört öğeli tek listelerden oluştuğunu unutmayın: ızgaranın tüm hücreleri üzerindeki metrik ortalaması ($mean) ve standart hatası ($SE), en iyi λ ve γ parametreleri ($optimal) ve uyum iyiliği fonksiyonunun adı ($err_fun). Mevcut örnekteki çapraz doğrulanmış model, hem seyrekliği (λ) hem de birleşimi (γ) açıkça tercih ediyor.
Son olarak, Nesterov gradyan yakınsama eşiği δ ve en fazla yineleme sayısı gibi ek parametreleri, sırasıyla delta_conv ve iter_max’i additionalOpts aracılığıyla geçirerek ince ayar yapabileceğinizi unutmayın. Bunlar bir sonraki örnekte kullanılacaktır.
GFLASSO’nun nispeten yüksek boyutlu bir problemdeki sadeliğini ve sağlamlığını göstermek için, bir sonraki adımda Alzheimer Hastalığı Nörogörüntüleme Girişimi (ADNI-1) veritabanından elde edilen bgsmtr_example_data veri setlerini modelleyeceksiniz.
Bu, bgsmtr paketinin bir parçası olan ve 632 denekten belirlenen 15 yapısal nörogörüntüleme ölçümü ile 486 tek nükleotit polimorfizmini (SNP, genetik belirteç) içeren 3 öğeli bir liste nesnesidir. Önemli olarak, 486 SNP, Alzheimer hastalığıyla ilişkili olduğu düşünülen 33 geni kapsamaktadır.
Göreviniz, SNP verilerinden nörogörüntüleme ölçümlerini, ilkinin korelasyon yapısından yararlanarak tahmin etmektir.
Verileri düzenleyerek ve tüm nörogörüntüleme özellikleri arasındaki karşılıklı bağımlılıkları inceleyerek başlayalım:
data(bgsmtr_example_data)
str(bgsmtr_example_data)

## List of 3
##  $ SNP_data     : int [1:486, 1:632] 2 0 2 0 0 0 0 1 0 1 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:486] "rs4305" "rs4309" "rs4311" "rs4329" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...
##  $ SNP_groups   : chr [1:486] "ACE" "ACE" "ACE" "ACE" ...
##  $ BrainMeasures: num [1:15, 1:632] 116.5 4477.9 28631.9 34.1 -473.4 ...
##   ..- attr(*, "dimnames")=List of 2
##   .. ..$ : chr [1:15] "Left_AmygVol.adj" "Left_CerebCtx.adj" "Left_CerebWM.adj" "Left_HippVol.adj" ...
##   .. ..$ : chr [1:632] "V1" "V2" "V3" "V4" ...

# Transpose, so that samples are distributed as rows, predictors / responses as columns
SNP <- t(bgsmtr_example_data$SNP_data)
BM <- t(bgsmtr_example_data$BrainMeasures)

# Define dependency structure
DS <- cor(BM)

# Plot correlation matrix of the 15 neuroimaging measures
corrplot(DS)
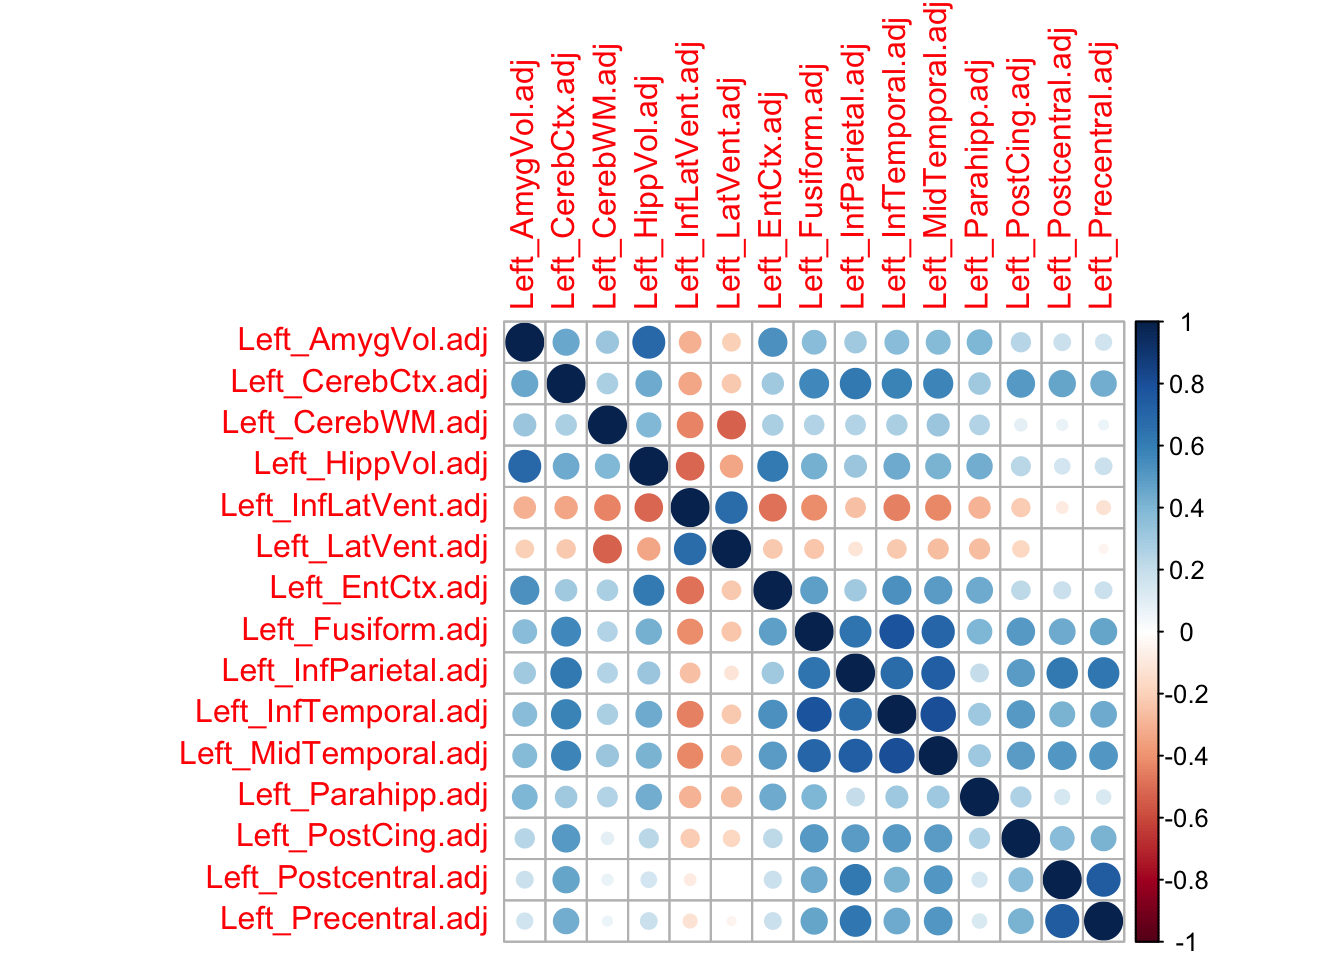
Yukarıdaki şekil, nörogörüntüleme özellikleri arasındaki karşılıklı bağımlılıklara işaret etmektedir. Şimdi GFLASSO’yu çapraz doğrulamayı deneyin (bir dizüstü bilgisayarda birkaç saate kadar sürebilir!) ve SNP-nörogörüntüleme ilişkilerini belirleyin.
Not: Aşağıdaki örnekte yakınsama toleransı ve maksimum yineleme sayısı belirtilmiştir. Kendi başınıza farklı değerler denemekte özgürsünüz!
system.time(CV <- cv_gflasso(X = scale(SNP), Y = scale(BM), R = DS, nCores = 2,
                 additionalOpts = list(delta_conv = 1e-5, iter_max = 1e5)))

## [1] 1.550294 1.471637 1.470133 1.514425 1.504215

##      user    system   elapsed
##  2611.492   323.441 51129.936

cv_plot_gflasso(CV)
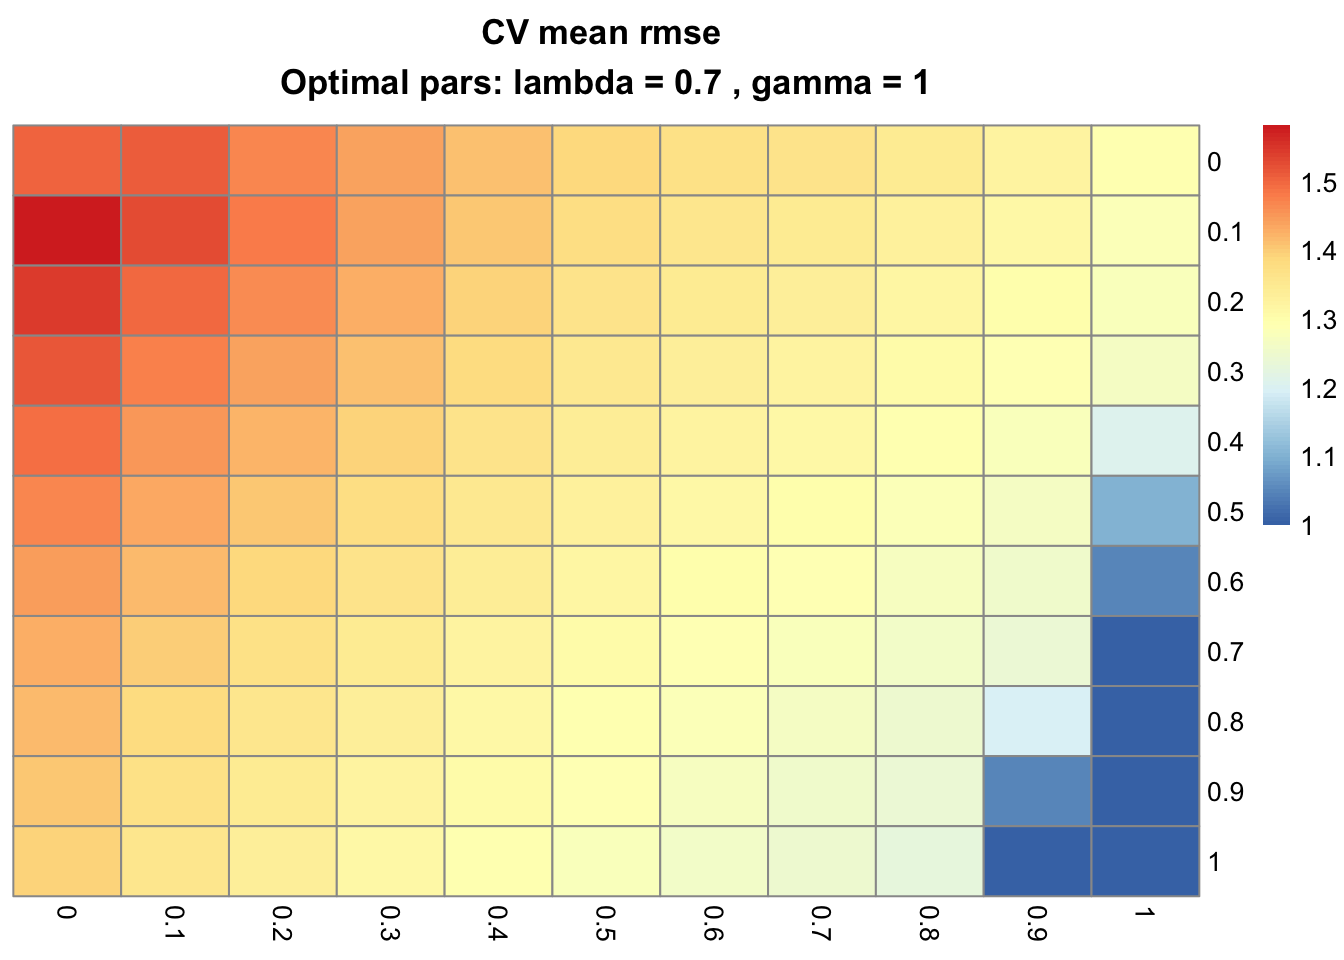
GFLASSO’yu saf LASSO modelleriyle (γ = 0, ilk sütun), saf birleşik en küçük karelerle (λ = 0, ilk satır) ve OLS ile (γ = 0 ve λ = 0, sol üst hücre) karşı karşıya getirerek, mevcut örneğin sıfır olmayan ceza ağırlıklarıyla ve dolayısıyla tam GFLASSO ile en iyi modellendiği sonucuna varabiliriz. En iyi CV parametrelerini (λ = 0.7 ve γ = 1) alarak bir GFLASSO modeli kurun ve ortaya çıkan katsayı matrisini yorumlayın:
gfMod <- gflasso(X = scale(SNP), Y = scale(BM), R = DS, opts = list(lambda = CV$optimal$lambda,
                                                                    gamma = CV$optimal$gamma,
                                                                    delta_conv = 1e-5,
                                                                    iter_max = 1e5))
colnames(gfMod$B) <- colnames(BM)
pheatmap(gfMod$B, annotation_row = data.frame("Gene" = bgsmtr_example_data$SNP_groups,
                                              row.names = rownames(gfMod$B)),
         show_rownames = F)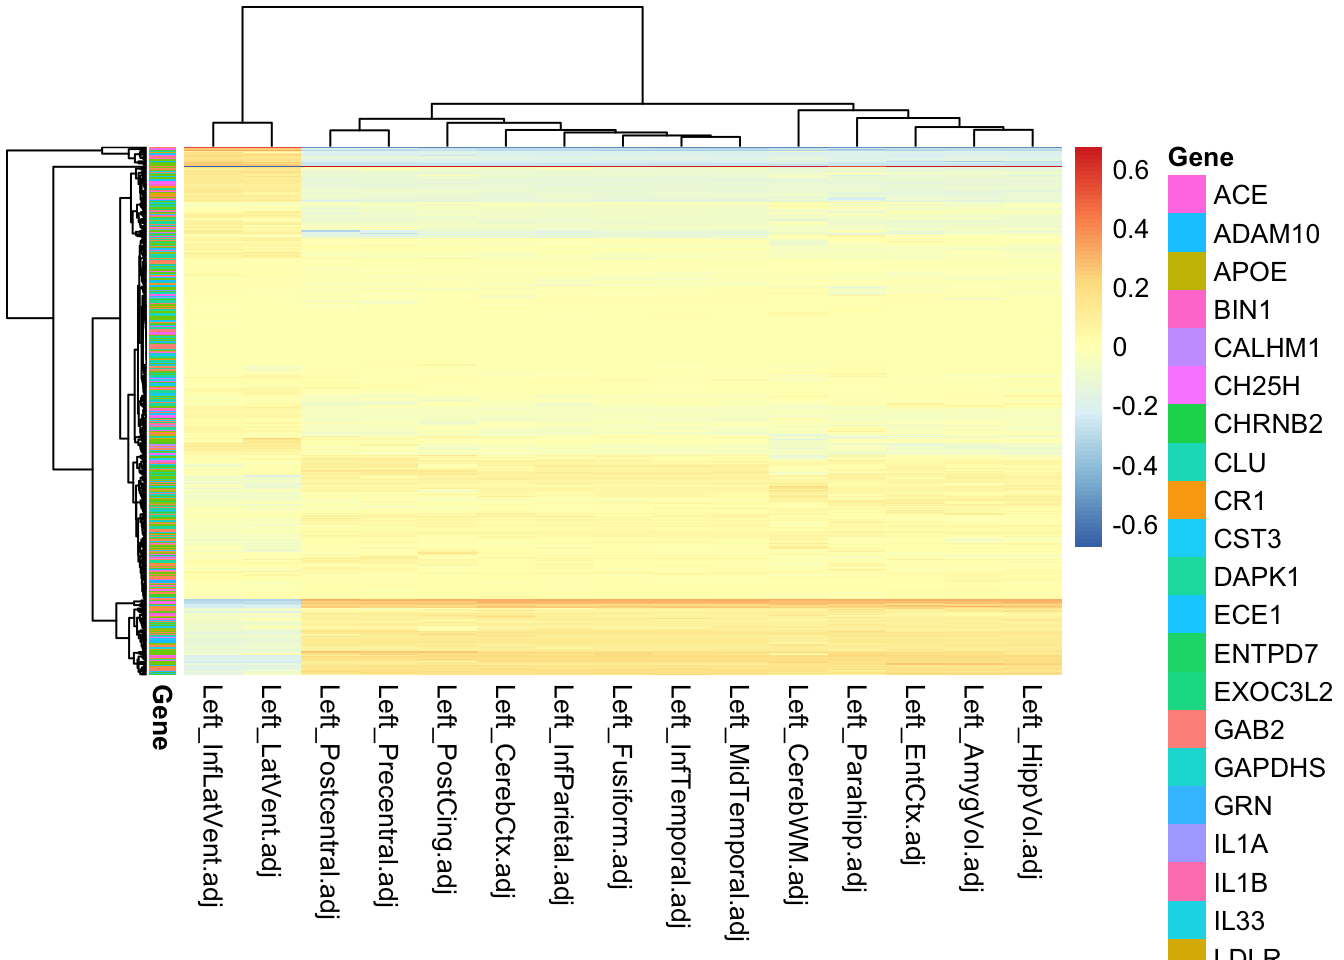
Yukarıdaki şekil, katsayıların çok büyük bir bölümünün sıfır veya sıfıra yakın değerlere sahip olduğunu göstermektedir. Genlere göre SNP’lerin bariz bir kümeleşmesi olmasa da (satır bazlı açıklamaya bakınız; açıklama işareti eksik), belirli SNP’ler ile özellikler arasında açık ilişkiler bulunmaktadır.
Rastlantısal olmayan bir öngörücü mekanizmanın varlığını doğrulamak için, sonraki adımda X veya Y’deki değerleri permütasyonladıktan sonra prosedürü tekrarlayabilirsiniz. Deneysel çalışmalar, seçilen SNP’lerden nedenselliği ve mekanizmaları aydınlatmaya yardımcı olabilir. Örneğin, protein dizisini ve yapısını etkileyen, Alzheimer hastalığının temelindeki β-Amiloid plaklarının temizlenmesini bozan SNP’ler.
GFLASSO, birden çok yanıtı modelerken hem düzenlileştirme hem de birleşim uygular; böylece yordayıcılar (X) ile yanıtlar (Y) arasındaki ilişkilerin belirlenmesini kolaylaştırır. Çok az gözlemden gelen yüksek boyutlu verilerle çalışırken en iyi şekilde kullanılır; çünkü rakip yöntemlerden çok daha yavaştır. Örneğin, seyrek koşullu Gauss grafik modelleri [4] ve Bayesyen grup-seyrek çoklu görev regresyon modeli [5] özellikle performans kazanımları nedeniyle tercih edilebilir. Bununla birlikte, GFLASSO yüksek ölçüde yorumlanabilirdir. Yakın zamanda mısırda yeni lipid genlerini ortaya çıkarmak için çoklu omik bütünleştirmeli bir yaklaşımda GFLASSO’yu kullandım [6].
DataCamp’in Düzenlileştirme Eğitimi: Ridge, Lasso ve Elastic Net içeriğine göz atın.
Kris ve ben sizden haber almaktan memnuniyet duyarız. Bu proje şu anda krisrs1128/gflasso deposu altında Kris tarafından ve sık değişikliklere rağmen benim depom üzerinden, monogenea/gflasso, bakım görmektedir. Bana istediğiniz zaman yazabilirsiniz (francisco.lima278@gmail.com); her türlü geri bildirim memnuniyetle karşılanır.
Keyifli kodlamalar!
R Kursları
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.




