
Kursus
Analisis Klaster di Python
4 jam
65.9K
Jadi Anda baru saja diminta menganalisis dataset besar, dan Anda harus menyajikan analisis klaster yang mendalam. Anda menemukan istilah “clustering hierarkis”, tetapi apa sebenarnya itu, dan bagaimana cara kerjanya?
Dalam artikel ini, kita akan mengeksplorasi konsep clustering hierarkis dan menyajikan contoh dunia nyata untuk membantu Anda memahami penerapannya dengan lebih baik.
Clustering hierarkis adalah algoritma pembelajaran tanpa pengawasan yang digunakan untuk mengelompokkan titik data serupa ke dalam klaster. Algoritma ini membangun hierarki multilevel dari klaster dengan menggabungkan klaster kecil menjadi lebih besar (agglomerative) atau membagi klaster besar menjadi yang lebih kecil (divisive). Hasilnya adalah struktur seperti pohon yang dikenal sebagai dendrogram.
Dendrogram adalah representasi visual yang menggambarkan susunan klaster dan hubungan di antara mereka. Ketinggian cabang pada dendrogram merepresentasikan jarak atau ketidakmiripan saat klaster bergabung. Ketinggian yang lebih rendah menunjukkan klaster yang bergabung pada jarak lebih kecil, sehingga merepresentasikan kemiripan yang lebih tinggi.
Clustering hierarkis sangat berguna ketika jumlah klaster belum diketahui sebelumnya. Teknik ini memungkinkan analis data dan ilmuwan data untuk menelusuri struktur data secara visual melalui dendrogram.
Teknik ini juga mampu mengungkap klaster bertingkat (nested) dan banyak digunakan di bidang seperti genomik, segmentasi pelanggan, dan pengorganisasian dokumen.
Sebagai contoh, misalkan kita memiliki dataset catatan pembelian pelanggan. Dengan clustering hierarkis, kita dapat mengelompokkan pelanggan dengan pola pembelian serupa ke dalam klaster dan mengidentifikasi segmen pasar potensial untuk strategi pemasaran yang terarah.
Saat mengerjakan tugas pengelompokan, kebanyakan orang bimbang pada dua metode utama: Clustering hierarkis atau K-means.
Namun apa yang membedakan keduanya? Mari kita lihat perbedaannya di bawah ini untuk gambaran yang lebih jelas.
Saat membandingkan keduanya, ada beberapa hal yang membuat clustering hierarkis menonjol.
Berikut beberapa area di mana clustering hierarkis unggul:
Namun, ada juga beberapa kelemahan, seperti:
Anda mungkin bertanya: Kapan saya harus menggunakan clustering hierarkis?
Clustering hierarkis merupakan pilihan yang sangat baik dalam penerapan berikut:
Di dalam teknik clustering hierarkis, ada beberapa jenis, masing-masing memberikan wawasan dan hasil yang berbeda. Dua jenis utama clustering hierarkis adalah agglomerative (bottom-up) dan divisive (top-down).
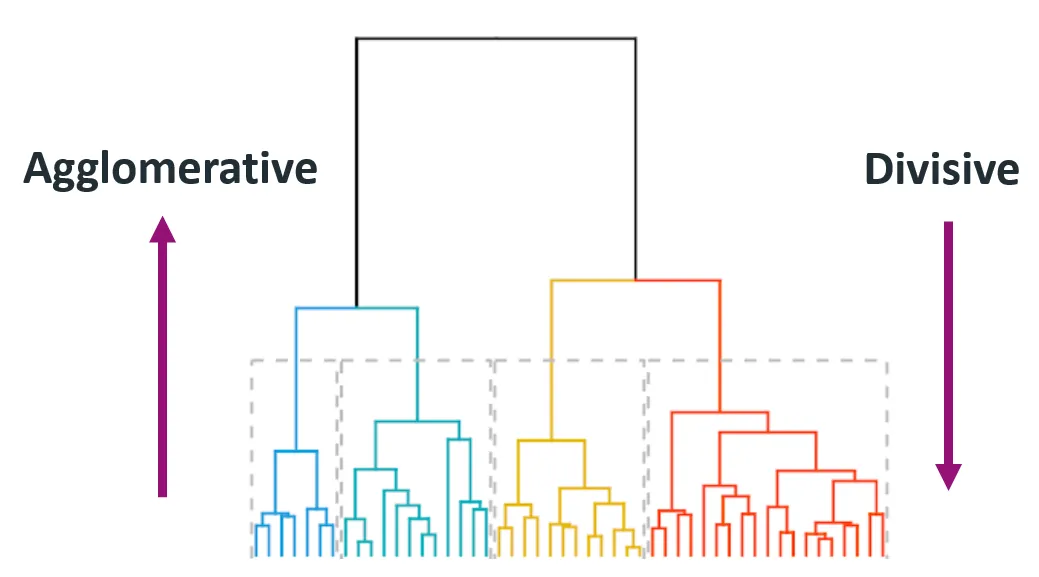
Sumber: Himanshu Sharma di Medium
Clustering agglomerative dimulai dengan setiap titik data sebagai klaster individu dan secara iteratif menggabungkan pasangan klaster terdekat hingga hanya tersisa satu klaster atau hingga memenuhi kondisi penghentian (misalnya jumlah klaster yang diinginkan).
Metode ini juga disebut bottom-up karena dimulai dari bawah (titik data individual) dan membangun ke atas (klaster akhir).
Panduan langkah demi langkah:
Metode ini banyak digunakan karena kesederhanaan dan kemudahan implementasinya.
Berikut contoh bagaimana ini dapat diimplementasikan di Python:
import numpy as np
from scipy.cluster.hierarchy import linkage, dendrogram, fcluster
import matplotlib.pyplot as plt

# Samples data
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])

# Applies agglomerative clustering using Ward's method
Z = linkage(data, method='ward')

# Plots dendrogram
plt.figure(figsize=(8, 4))
dendrogram(Z)
plt.title('Agglomerative Clustering Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()

# Extracts clusters (e.g., form 2 clusters)
clusters = fcluster(Z, t=2, criterion='maxclust')
print("Cluster assignments:", clusters)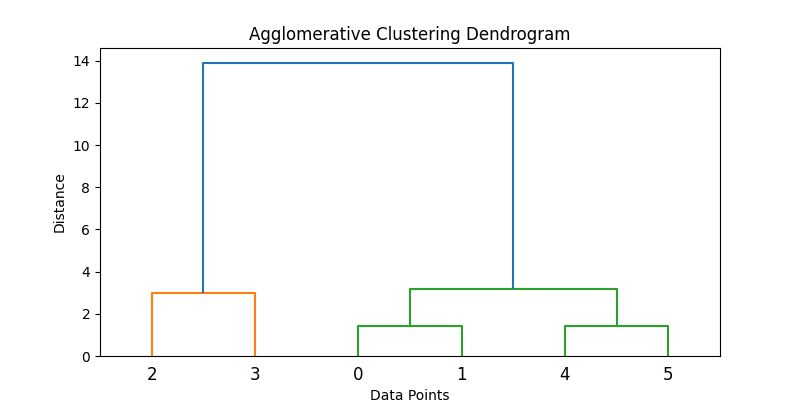
Clustering divisive dimulai dengan semua titik data dalam satu klaster dan secara rekursif membaginya menjadi klaster yang lebih kecil. Proses berlanjut hingga setiap titik data berada di klaster individualnya sendiri.
Pendekatan ini juga dikenal sebagai top-down, karena dimulai dari atas (satu klaster) dan dipecah menjadi klaster yang lebih kecil.
Panduan langkah demi langkah:
Metode divisive umumnya lebih mahal secara komputasi karena sifatnya yang rekursif, dan akurasinya sangat bergantung pada strategi pembagian. Metode agglomerative lebih umum digunakan karena kemudahan implementasi dan dukungan luas pada perangkat lunak.
Catatan: Clustering hierarkis divisive tidak didukung secara langsung di pustaka Python standar seperti clustering agglomerative. Salah satu pendekatan adalah menggunakan algoritma clustering seperti k-means secara rekursif.
Berikut konsep kode dari pembagian k-means rekursif yang disimulasikan:
from sklearn.cluster import KMeans

def divisive_clustering(data, depth=2):
    if depth == 0 or len(data) <= 1:
        return [data]

    kmeans = KMeans(n_clusters=2, random_state=42).fit(data)
    labels = kmeans.labels_
    cluster1 = data[labels == 0]
    cluster2 = data[labels == 1]

    return divisive_clustering(cluster1, depth - 1) + divisive_clustering(cluster2, depth - 1)

# Run recursive splitting to simulate divisive clustering
split_clusters = divisive_clustering(data, depth=2)
for i, cluster in enumerate(split_clusters):
    print(f"Cluster {i+1} size: {len(cluster)}")
Kode yang disederhanakan ini mengilustrasikan pendekatan konseptual untuk clustering divisive menggunakan k-means rekursif. Perlu dicatat, metode divisive standar seperti DIANA menggunakan kriteria pembagian yang berbeda.
Clustering hierarkis melibatkan sejumlah konsep dan istilah kunci yang penting untuk dipahami. Untuk memahami prosesnya sepenuhnya, kita akan membahas konsep-konsep ini lebih rinci di bawah.
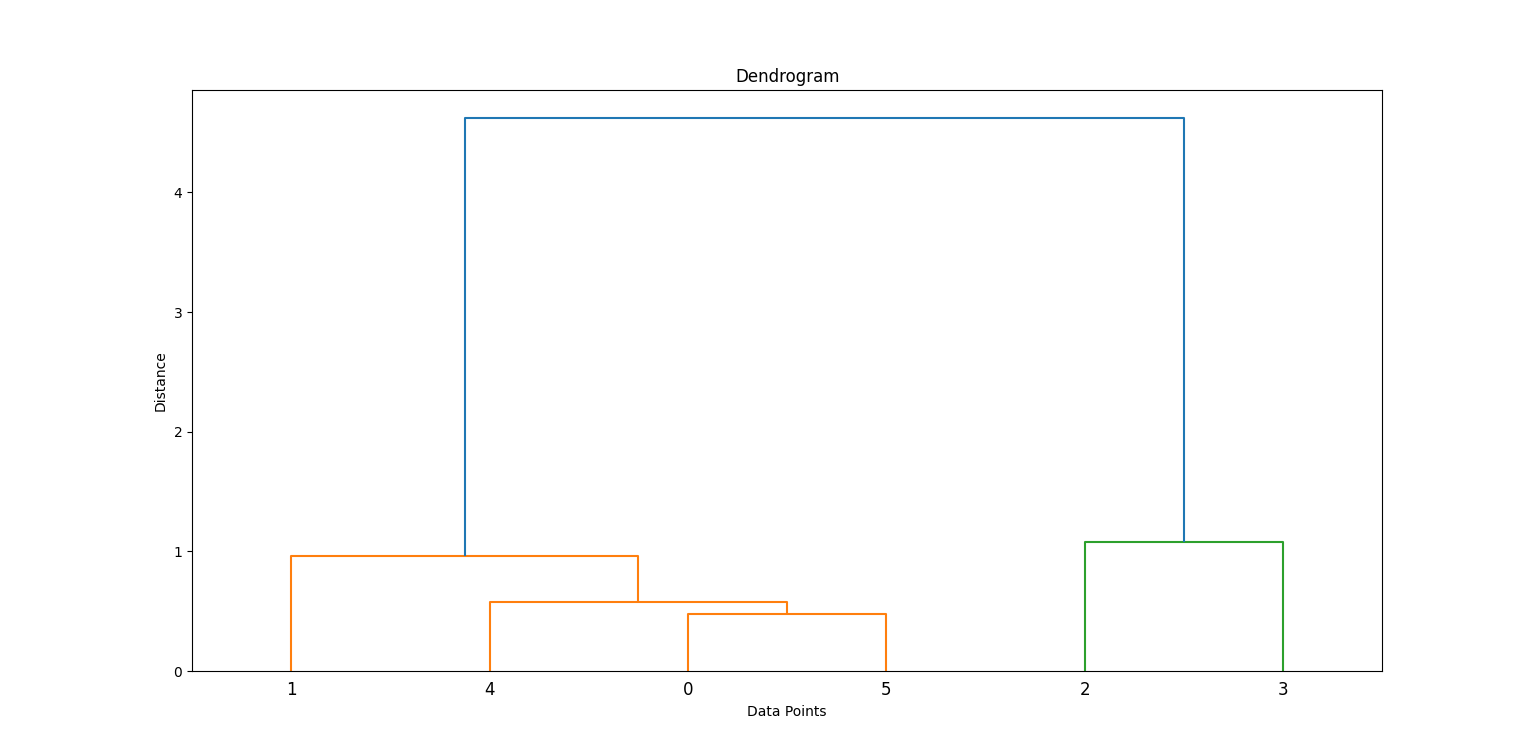
Dendrogram adalah struktur seperti pohon yang memvisualisasikan proses clustering hierarkis. Setiap tingkat pada pohon merepresentasikan operasi penggabungan atau pembagian, dan ketinggian cabang merepresentasikan jarak (atau ketidakmiripan) saat klaster digabung.
Berikut alasan mengapa ini penting:
Kriteria linkage menentukan bagaimana jarak antar klaster dihitung selama proses penggabungan.
Berikut beberapa jenis kriteria linkage:
Kriteria ini melihat jarak antara titik terdekat dari dua klaster. Ini dapat menghasilkan klaster yang memanjang seperti rantai.
from scipy.spatial.distance import pdist, squareform
data = np.array([[1, 2], [2, 3], [5, 8]])
distance_matrix = squareform(pdist(data, metric='euclidean'))
single_linkage_min = np.min(distance_matrix[0, 1:])
print("Single Linkage Distance between Cluster A (point 1) and Cluster B (point 2, 3):", single_linkage_min)Kriteria ini melihat jarak antara titik terjauh dari dua klaster. Ini cenderung menghasilkan klaster yang kompak dan berukuran seragam.
single_linkage_max = np.max(distance_matrix[0, 1:])
print("Complete Linkage Distance between Cluster A and B:", single_linkage_max)Kriteria ini melihat jarak rata-rata antara semua titik di satu klaster dengan semua titik di klaster lain. Ini memberikan keseimbangan antara single dan complete linkage.
average_linkage = np.mean(distance_matrix[0, 1:])
print("Average Linkage Distance between Cluster A and B:", average_linkage)
Contoh yang disederhanakan ini mengilustrasikan bagaimana jarak dihitung pada awalnya. Namun, selama proses clustering, kriteria ini (single, complete, average linkage) menerapkan jarak secara iteratif antar seluruh klaster, bukan hanya titik individual.
Metode Ward adalah variasi dari pendekatan average linkage yang meminimalkan jumlah kuadrat selisih dalam semua klaster. Metode ini cenderung menghasilkan klaster yang lebih seragam ukurannya dibanding metode lain. Sering kali juga menghasilkan klaster yang terpisah baik dan berbentuk sferis.
from scipy.cluster.hierarchy import linkage
linkage_ward = linkage(data, method='ward')
print("Ward's Linkage Matrix:\n", linkage_ward)
Setiap metode memiliki kelebihan masing-masing dan harus dipilih berdasarkan data serta kasus penggunaan.
Metrik jarak yang digunakan sangat memengaruhi hasil clustering.
Jarak Euclidean adalah jarak garis lurus antara dua titik dalam ruang multidimensi. Ini adalah metrik jarak yang paling umum digunakan, terutama untuk data yang terdistribusi secara geometris.
Jarak Manhattan, juga dikenal sebagai jarak taksi atau L1, adalah jumlah selisih absolut di seluruh dimensi. Berguna untuk data seperti kisi, misalnya blok kota atau transaksi keuangan.
Kemiripan kosinus mengukur kosinus sudut antara dua vektor non-nol. Metrik ini ideal untuk data teks atau ketika besarannya tidak penting (misalnya vektor frekuensi kata).
Pada bagian ini, kita akan menelusuri implementasi praktis clustering hierarkis agglomerative menggunakan Python. Kita akan membahas mulai dari prapemrosesan data hingga memvisualisasikan hasil menggunakan dendrogram.
Kita mulai dengan mengimpor pustaka yang diperlukan:
import numpy as np
import pandas as pd
from scipy.cluster.hierarchy import dendrogram, linkage, fcluster
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
Berikut yang kita impor pada kode di atas:
numpy dan pandas untuk manipulasi datascipy.cluster.hierarchy untuk clustering dan pembuatan dendrogramsklearn.preprocessing.StandardScaler untuk penskalaan fiturmatplotlib untuk visualisasiSebelum memulai analisis, mari kita buat dataset mainan berupa titik 2D dan melakukan penskalaan. Penskalaan sangat penting untuk algoritma berbasis jarak.
Berikut tampilan dataset contoh kita.
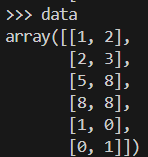
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])
scaler = StandardScaler()
data_scaled = scaler.fit_transform(data)
Berikut seperti apa array data setelah diskalakan.
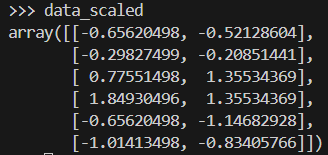
Kita menerapkan metode Ward untuk menghasilkan matriks linkage, yang berisi informasi clustering hierarkis. Lalu, kita plot dendrogram.
linkage_matrix = linkage(data_scaled, method='ward')
plt.figure(figsize=(8, 4))
dendrogram(linkage_matrix)
plt.title('Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()
Pada kode di atas, linkage membangun hierarki klaster, dan dendrogram membantu memvisualisasikan bagaimana klaster terbentuk.
Dengan memeriksa di mana garis vertikal paling panjang sebelum penggabungan, kita dapat memutuskan di mana harus “memotong” untuk membentuk klaster. Carilah garis vertikal tertinggi yang tidak berpotongan dengan klaster lain mana pun. Di situlah Anda harus melakukan pemotongan.
Dalam kasus ini, Anda perlu memotong pada 2 klaster.
Selanjutnya, kita memotong dendrogram untuk mendapatkan jumlah klaster tertentu menggunakan fcluster:
clusters = fcluster(linkage_matrix, t=2, criterion='maxclust')
print(clusters)

plt.scatter(data_scaled[:, 0], data_scaled[:, 1], c=clusters, cmap='rainbow')
plt.title('Clusters')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()
Ini menetapkan setiap titik data ke salah satu dari dua klaster.
Beberapa informasi tambahan tentang kode:
t=2: Menentukan jumlah klaster yang diinginkan.criterion='maxclust': Memastikan kita mendapatkan tepat t klaster.Anda dapat mengubah t untuk bereksperimen dengan jumlah klaster yang berbeda.
Clustering hierarkis umumnya digunakan dalam segmentasi pelanggan. Mari kita lihat seperti apa implementasi praktisnya.
Mari kita simulasikan dataset yang merepresentasikan pelanggan dengan dua fitur: usia dan pendapatan. Kita akan menggunakan make_blobs untuk menghasilkan data sintetis ini.
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=100, centers=3, n_features=2, random_state=42)Selanjutnya, kita perlu menstandarkan fitur untuk menormalkan skala dan meningkatkan akurasi clustering.
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Berikut tampilan data yang telah diskalakan:
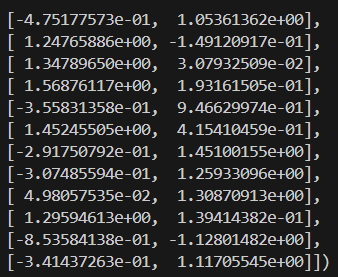
Setelah data diproses, kita akan memplot dendrogram untuk memvisualisasikan bagaimana klaster terbentuk.
linkage_matrix = linkage(X_scaled, method='ward')
plt.figure(figsize=(10, 5))
dendrogram(linkage_matrix)
plt.title('Customer Dendrogram')
plt.xlabel('Sample Index')
plt.ylabel('Distance')
plt.show()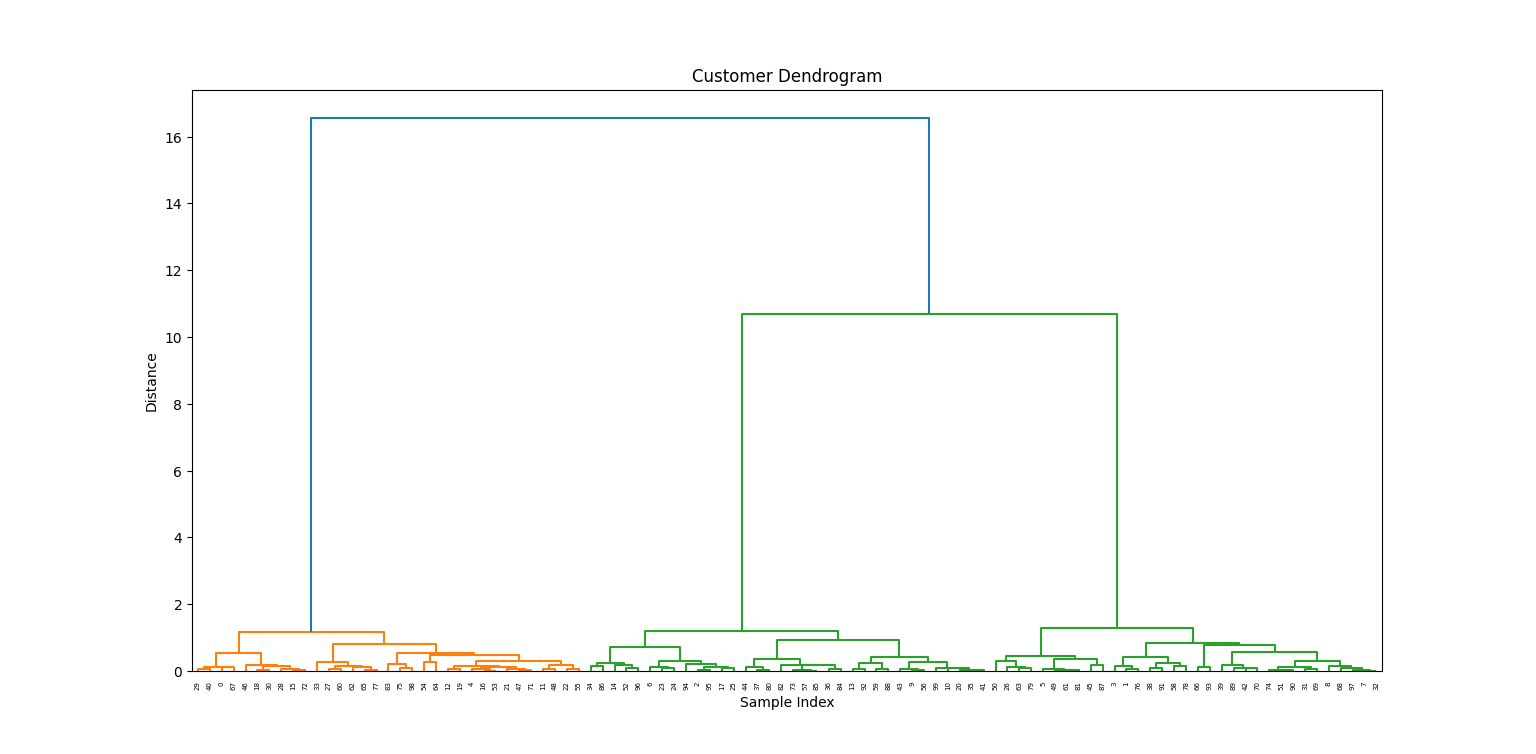
Dari dendrogram, kita memilih ketinggian untuk “memotong” dan membuat tiga klaster:
labels = fcluster(linkage_matrix, t=3, criterion='maxclust')
plt.scatter(X_scaled[:, 0], X_scaled[:, 1], c=labels, cmap='rainbow')
plt.title('Customer Segments')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()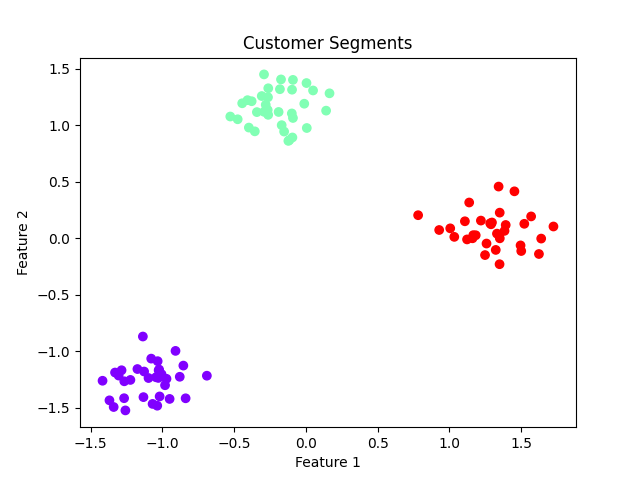
Implikasi bisnis:
Memilih clustering hierarkis untuk analisis Anda memiliki sejumlah kelebihan dan keterbatasan.
Lihat di bawah untuk beberapa yang umum:
Clustering hierarkis adalah teknik clustering yang serbaguna dan mudah ditafsirkan, terutama berguna dalam analisis data eksploratori serta domain seperti genomik dan segmentasi pelanggan. Terlepas dari biayanya secara komputasi, kekuatannya terletak pada kemampuannya mengungkap pengelompokan bertingkat dan fleksibilitas dalam memilih jumlah klaster secara pasca-analisis melalui visualisasi dendrogram.
Untuk dataset kecil hingga menengah di mana interpretabilitas menjadi kunci, clustering hierarkis tetap menjadi metode andalan bagi ilmuwan data dan analis.
Ingin mempelajari lebih lanjut detail machine learning? Machine Learning Fundamentals in Python track dan tutorial Introduction to Hierarchical Clustering in Python kami adalah tempat yang tepat untuk memulai.
Kursus Teratas di DataCamp
Kursus
Program
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



