
Cursus
Clusteranalyse in Python
4 uur
65.9K
Je hebt net de taak gekregen om een grote dataset te analyseren en je moet een diepgaande clusteranalyse opleveren. Je bent de term “hiërarchische clustering” tegengekomen, maar wat is het precies en hoe werkt het?
In dit artikel verkennen we het concept van hiërarchische clustering en geven we voorbeelden uit de praktijk om je te helpen de toepassingen beter te begrijpen.
Hiërarchische clustering is een unsupervised learning-algoritme dat wordt gebruikt om vergelijkbare datapunten te groeperen in clusters. Het bouwt een meerlagige hiërarchie van clusters door ofwel kleinere clusters samen te voegen tot grotere (agglomeratief) of een groot cluster op te splitsen in kleinere (divisief). Dit resulteert in een boomachtige structuur die een dendrogram wordt genoemd.
Een dendrogram is een visuele weergave die de rangschikking van clusters en hun onderlinge relaties illustreert. De hoogte van de takken in een dendrogram stelt de afstand of ongelijkheid voor waarbij clusters samenkomen. Lagere hoogtes duiden op clusters die op kleinere afstanden zijn samengevoegd en dus een hogere gelijkenis vertegenwoordigen.
Hiërarchische clustering is vooral nuttig wanneer het aantal clusters niet vooraf bekend is. Het stelt data-analisten en data scientists in staat om de structuur van de data visueel te verkennen via dendrogrammen.
Deze techniek kan ook geneste clusters blootleggen en wordt veel gebruikt in vakgebieden zoals genomica, klantsegmentatie en documentorganisatie.
Stel bijvoorbeeld dat we een dataset met aankoopgegevens van klanten hebben. Met hiërarchische clustering kunnen we klanten met vergelijkbare kooppatronen groeperen in clusters en potentiële marktsegmenten identificeren voor gerichte marketingstrategieën.
Bij clusteringtaken twijfelen de meesten tussen twee hoofdmethoden: hiërarchische clustering of k-means clustering.
Maar wat maakt ze anders? Laten we hieronder naar de verschillen kijken voor een duidelijker beeld.
Bij het vergelijken van de twee zijn er enkele punten die hiërarchische clustering tot een opvallende optie maken.
Hier zijn enkele gebieden waar hiërarchische clustering goed in is:
Er zijn echter ook nadelen, zoals:
Je vraagt je misschien af: wanneer moet ik hiërarchische clustering gebruiken?
Hiërarchische clustering is een uitstekende keuze in de volgende toepassingen:
Binnen de techniek van hiërarchische clustering kun je verschillende typen verwachten, elk met andere inzichten en resultaten. De twee belangrijkste typen hiërarchische clustering zijn agglomeratief (bottom-up) en divisief (top-down).
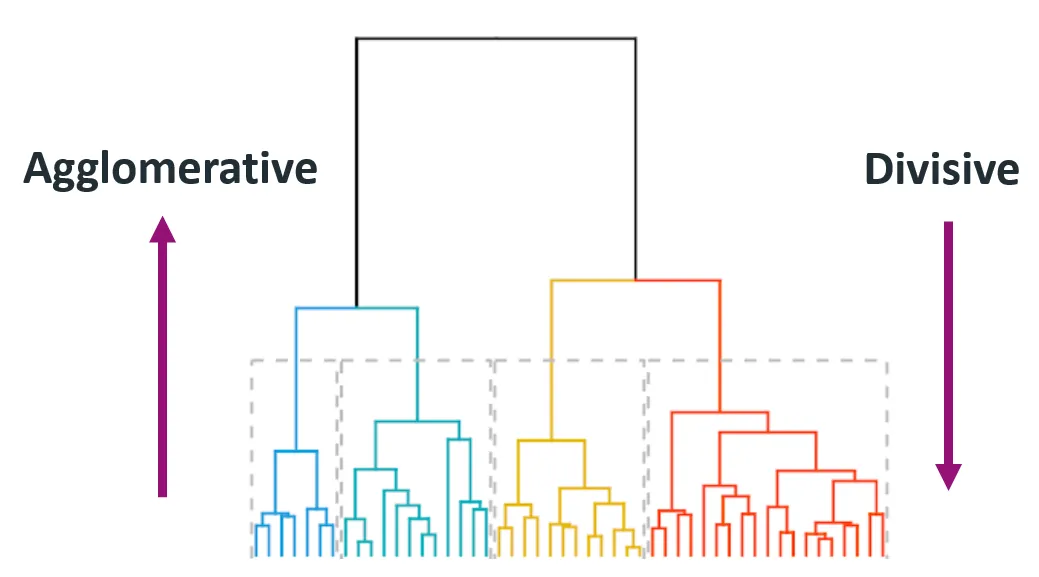
Bron: Himanshu Sharma op Medium
Agglomeratieve clustering begint met elk datapunt als een individueel cluster en voegt iteratief het dichtstbijzijnde paar clusters samen totdat er nog maar één cluster overblijft of totdat een stopvoorwaarde is bereikt (zoals een gewenst aantal clusters).
Deze methode wordt ook wel bottom-up genoemd omdat ze onderaan begint (individuele datapunten) en opbouwt naar boven (het uiteindelijke cluster).
Stapsgewijze handleiding:
Deze methode is wijdverbreid door de eenvoud en het gemak van implementatie.
Hier is een voorbeeld van hoe je dit in Python kunt implementeren:
import numpy as np
from scipy.cluster.hierarchy import linkage, dendrogram, fcluster
import matplotlib.pyplot as plt

# Samples data
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])

# Applies agglomerative clustering using Ward's method
Z = linkage(data, method='ward')

# Plots dendrogram
plt.figure(figsize=(8, 4))
dendrogram(Z)
plt.title('Agglomerative Clustering Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()

# Extracts clusters (e.g., form 2 clusters)
clusters = fcluster(Z, t=2, criterion='maxclust')
print("Cluster assignments:", clusters)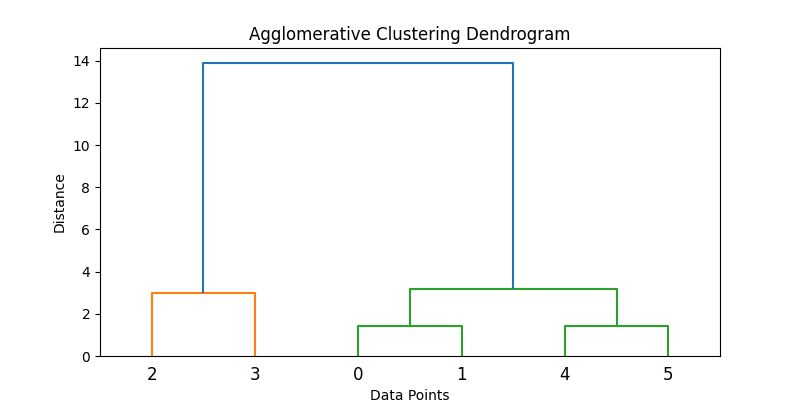
Divisieve clustering begint met alle datapunten in één cluster en splitst deze vervolgens recursief in kleinere clusters. Het proces gaat door totdat elk datapunt een eigen individueel cluster vormt.
Dit staat ook bekend als een top-downbenadering, omdat het bovenaan begint (één cluster) en wordt opgesplitst in kleinere clusters.
Stapsgewijze handleiding:
Divisieve methoden zijn doorgaans rekenkundig zwaarder door hun recursieve aard, en de nauwkeurigheid hangt sterk af van de splitsingsstrategie. Agglomeratieve methoden komen vaker voor vanwege de eenvoud van implementatie en brede software-ondersteuning.
Opmerking: divisieve hiërarchische clustering wordt in standaard Python-bibliotheken niet zo gemakkelijk ondersteund als agglomeratieve clustering. Een aanpak is om clusteringalgoritmen zoals k-means recursief te gebruiken.
Hier is een codeconcept van een gesimuleerde recursieve k-means-splitsing:
from sklearn.cluster import KMeans

def divisive_clustering(data, depth=2):
    if depth == 0 or len(data) <= 1:
        return [data]

    kmeans = KMeans(n_clusters=2, random_state=42).fit(data)
    labels = kmeans.labels_
    cluster1 = data[labels == 0]
    cluster2 = data[labels == 1]

    return divisive_clustering(cluster1, depth - 1) + divisive_clustering(cluster2, depth - 1)

# Run recursive splitting to simulate divisive clustering
split_clusters = divisive_clustering(data, depth=2)
for i, cluster in enumerate(split_clusters):
    print(f"Cluster {i+1} size: {len(cluster)}")
Deze vereenvoudigde code illustreert een conceptuele benadering van divisieve clustering met recursieve k-means. Let wel dat standaard divisieve methoden zoals DIANA andere splitsingscriteria gebruiken.
Hiërarchische clustering omvat enkele kernconcepten en termen die belangrijk zijn om te begrijpen. Om het proces volledig te begrijpen, gaan we hieronder dieper in op deze concepten.
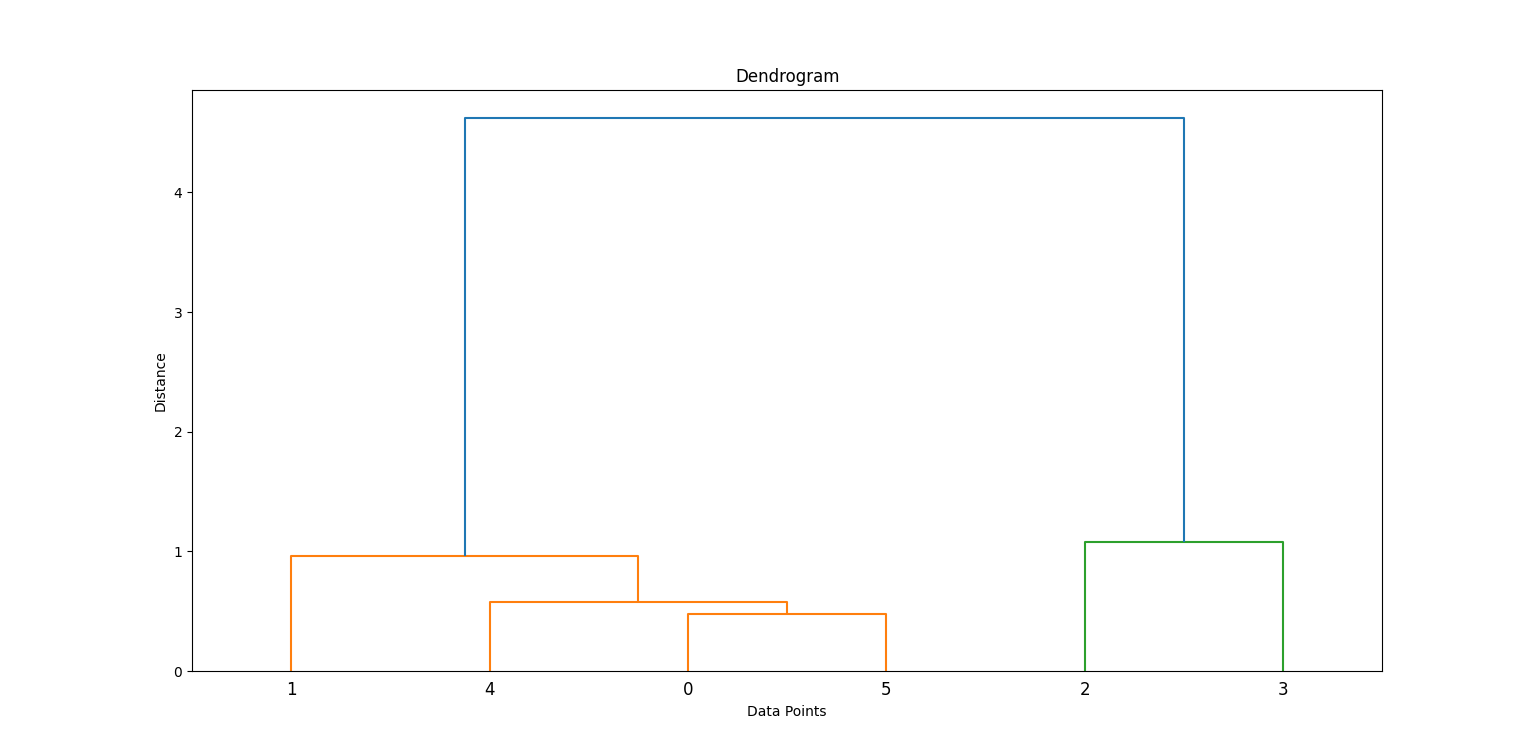
Een dendrogram is een boomachtige structuur die het proces van hiërarchische clustering visualiseert. Elk niveau van de boom staat voor een samenvoegings- of splitsingsstap, en de hoogte van de takken staat voor de afstand (of ongelijkheid) waarbij clusters zijn samengevoegd.
Hierom is het belangrijk:
Koppelingscriteria bepalen hoe afstanden tussen clusters worden berekend tijdens het samenvoegen.
Hier zijn enkele typen koppelingscriteria:
Dit criterium kijkt naar de afstand tussen de dichtstbijzijnde punten van twee clusters. Dit kan resulteren in langgerekte, kettingachtige clusters.
from scipy.spatial.distance import pdist, squareform
data = np.array([[1, 2], [2, 3], [5, 8]])
distance_matrix = squareform(pdist(data, metric='euclidean'))
single_linkage_min = np.min(distance_matrix[0, 1:])
print("Single Linkage Distance between Cluster A (point 1) and Cluster B (point 2, 3):", single_linkage_min)Dit criterium kijkt naar de afstand tussen de verst uit elkaar liggende punten van twee clusters. Dit heeft de neiging compacte, gelijkmatig grote clusters te produceren.
single_linkage_max = np.max(distance_matrix[0, 1:])
print("Complete Linkage Distance between Cluster A and B:", single_linkage_max)Dit criterium kijkt naar de gemiddelde afstand tussen alle punten in het ene cluster en alle punten in een ander cluster. Dit biedt een balans tussen single en complete linkage.
average_linkage = np.mean(distance_matrix[0, 1:])
print("Average Linkage Distance between Cluster A and B:", average_linkage)
Deze vereenvoudigde voorbeelden illustreren hoe afstanden aanvankelijk worden berekend. Tijdens het clusteren worden deze criteria (single, complete, average linkage) echter iteratief toegepast tussen hele clusters, niet alleen individuele punten.
Wards methode is een variant op average linkage die de som van gekwadrateerde verschillen binnen alle clusters minimaliseert. Deze methode levert vaak gelijkmatigere clusters op dan andere methoden en resulteert vaak in goed gescheiden, bolvormige clusters.
from scipy.cluster.hierarchy import linkage
linkage_ward = linkage(data, method='ward')
print("Ward's Linkage Matrix:\n", linkage_ward)
Elke methode heeft zijn eigen sterke punten en moet worden gekozen op basis van de data en de usecase.
De gebruikte afstandsmetriek beïnvloedt het clusterresultaat aanzienlijk.
De Euclidische afstand is de kortste lijn tussen twee punten in een multidimensionale ruimte. Het is de meest gebruikte afstandsmetriek, vooral voor geometrisch verdeelde data.
Manhattan-afstand, ook wel taxicab- of L1-afstand genoemd, is de som van absolute verschillen over dimensies. Het is nuttig voor roosterachtige data zoals stadsblokken of financiële transacties.
Cosinusovereenkomst meet de cosinus van de hoek tussen twee niet-nulvectoren. Deze metriek is ideaal voor tekstdata of wanneer de grootte niet uitmaakt (bijv. woordfrequentievectoren).
In deze sectie lopen we door een praktische implementatie van agglomeratieve hiërarchische clustering met Python. We behandelen alles van datapreprocessing tot het visualiseren van resultaten met een dendrogram.
We beginnen met het importeren van de benodigde bibliotheken:
import numpy as np
import pandas as pd
from scipy.cluster.hierarchy import dendrogram, linkage, fcluster
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
Dit is wat we hierboven hebben geïmporteerd:
numpy en pandas voor datamanipulatiescipy.cluster.hierarchy voor clusteren en het genereren van dendrogrammensklearn.preprocessing.StandardScaler voor feature-scalingmatplotlib voor visualisatieVoordat we beginnen met onze analyse, maken we een eenvoudige dataset van 2D-punten en schalen we die. Schalen is cruciaal voor afstandsgebaseerde algoritmen.
Zo ziet onze voorbeelddataset eruit.
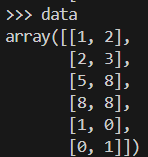
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])
scaler = StandardScaler()
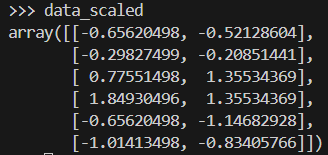
data_scaled = scaler.fit_transform(data)
Zo ziet de array met data eruit nadat deze is geschaald.
We passen Wards methode toe om een linkage-matrix te genereren, die informatie over de hiërarchische clustering bevat. Vervolgens plotten we een dendrogram.
linkage_matrix = linkage(data_scaled, method='ward')
plt.figure(figsize=(8, 4))
dendrogram(linkage_matrix)
plt.title('Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()
In de bovenstaande code bouwt linkage de clusterhiërarchie en helpt dendrogram visualiseren hoe clusters zijn gevormd.
Door te kijken waar de verticale lijnen het langst zijn vóór een samenvoeging, kunnen we beslissen waar we moeten “knippen” om clusters te vormen. Zoek naar de hoogste verticale lijn die niet met andere clusters kruist. Daar moet je de knip maken.
In dit geval moet je knippen op 2 clusters.
Vervolgens knippen we het dendrogram om een specifiek aantal clusters te krijgen met fcluster:
clusters = fcluster(linkage_matrix, t=2, criterion='maxclust')
print(clusters)

plt.scatter(data_scaled[:, 0], data_scaled[:, 1], c=clusters, cmap='rainbow')
plt.title('Clusters')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()
Dit kent elk datapunt toe aan een van de twee clusters.
Wat extra informatie over de code:
t=2: specificeert het gewenste aantal clusters.criterion='maxclust': zorgt ervoor dat we exact t clusters krijgen.Je kunt t aanpassen om met verschillende aantallen clusters te experimenteren.
Hiërarchische clustering wordt vaak gebruikt voor klantsegmentatie. Laten we bekijken hoe dit eruitziet in een praktische implementatie.
Laten we een dataset simuleren die klanten voorstelt met twee kenmerken: leeftijd en inkomen. We gebruiken make_blobs om deze synthetische data te genereren.
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=100, centers=3, n_features=2, random_state=42)Vervolgens standaardiseren we de features om schalen te normaliseren en de clusteringnauwkeurigheid te verbeteren.
scaler = StandardScaler()
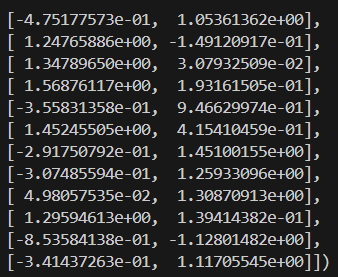
X_scaled = scaler.fit_transform(X)
Zo ziet de geschaalde data eruit:
Nu onze data is verwerkt, plotten we het dendrogram om te visualiseren hoe clusters ontstaan.
linkage_matrix = linkage(X_scaled, method='ward')
plt.figure(figsize=(10, 5))
dendrogram(linkage_matrix)
plt.title('Customer Dendrogram')
plt.xlabel('Sample Index')
plt.ylabel('Distance')
plt.show()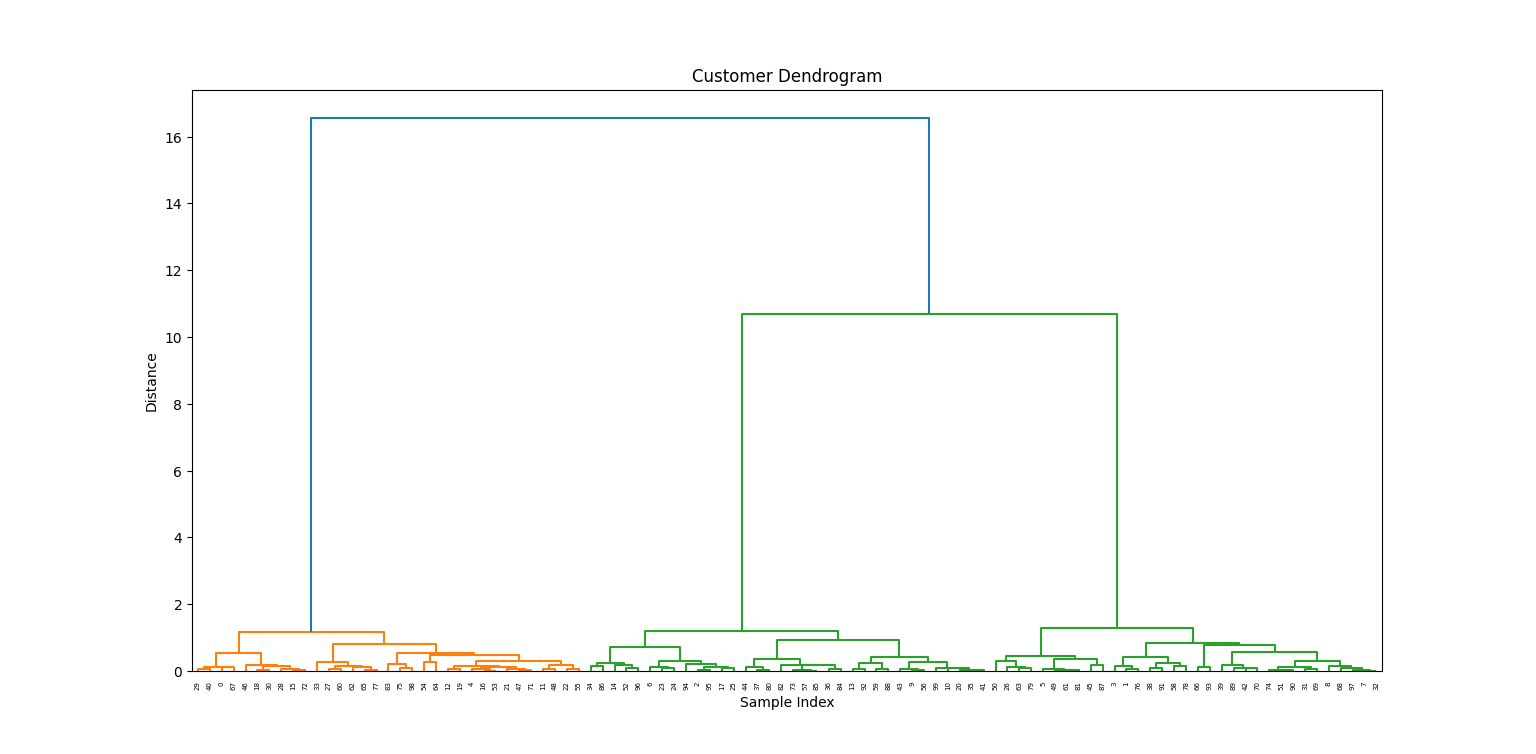
Op basis van het dendrogram kiezen we een hoogte om te “knippen” en maken we drie clusters:
labels = fcluster(linkage_matrix, t=3, criterion='maxclust')
plt.scatter(X_scaled[:, 0], X_scaled[:, 1], c=labels, cmap='rainbow')
plt.title('Customer Segments')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()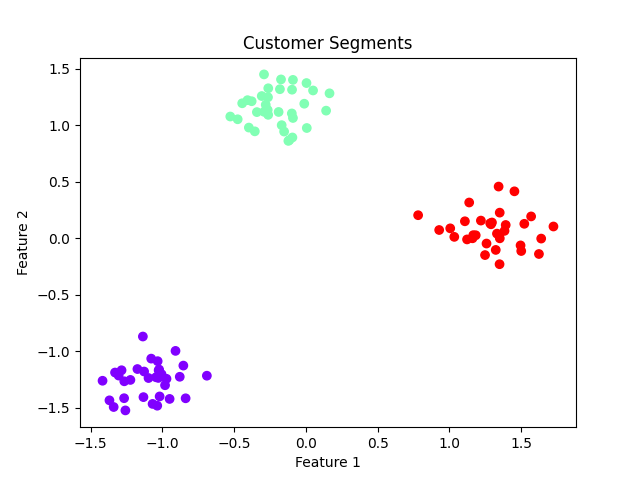
Zakelijke implicaties:
Kiezen voor hiërarchische clustering voor je analyse heeft verschillende voordelen en beperkingen.
Bekijk hieronder enkele veelvoorkomende punten:
Hiërarchische clustering is een veelzijdige en goed te interpreteren clusteringtechniek die vooral nuttig is in exploratieve data-analyse en domeinen zoals genomica en klantsegmentatie. Ondanks de rekenkundige kosten ligt de kracht in het blootleggen van geneste groeperingen en de flexibiliteit om achteraf het aantal clusters te kiezen via visualisatie met een dendrogram.
Voor kleine tot middelgrote datasets waar uitlegbaarheid centraal staat, blijft hiërarchische clustering een favoriete methode voor data scientists en analisten.
Wil je meer leren over de details van machine learning? Onze Machine Learning Fundamentals in Python track en Introductie tot hiërarchische clustering in Python-tutorial zijn geweldige startpunten.
Topcursussen op DataCamp
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

