
कोर्स
Python में क्लस्टर विश्लेषण
4 घंटा
65.9K
मान लीजिए आपको अभी-अभी एक बड़े डेटासेट का विश्लेषण सौंपा गया है, और आपसे गहन क्लस्टर विश्लेषण देने की अपेक्षा है। आपने “हायरार्किकल क्लस्टरिंग” शब्द सुना है—पर यह है क्या, और काम कैसे करती है?
इस लेख में, हम हायरार्किकल क्लस्टरिंग की अवधारणा को समझेंगे और इसके अनुप्रयोगों को बेहतर ढंग से समझने के लिए वास्तविक जीवन के उदाहरण देंगे।
हायरार्किकल क्लस्टरिंग एक अनसुपरवाइज्ड लर्निंग एल्गोरिदम है जो समान डेटा बिंदुओं को क्लस्टरों में समूहित करने के लिए उपयोग किया जाता है। यह या तो छोटे क्लस्टरों को बड़े क्लस्टरों में मिलाकर (एग्लोमेरेटिव) या एक बड़े क्लस्टर को छोटे क्लस्टरों में विभाजित करके (डिवाइसिव) बहु-स्तरीय पदानुक्रम बनाता है। इससे एक वृक्ष-जैसी संरचना बनती है जिसे डेंडोग्राम कहते हैं।
डेंडोग्राम एक दृश्य प्रस्तुति है जो क्लस्टरों की व्यवस्था और उनके परस्पर संबंधों को दर्शाती है। डेंडोग्राम में शाखाओं की ऊँचाई वह दूरी या असमानता दर्शाती है जिस पर क्लस्टर आपस में मिलते हैं। कम ऊँचाई का अर्थ है छोटी दूरी पर जुड़ना, यानी अधिक समानता।
हायरार्किकल क्लस्टरिंग तब विशेष रूप से उपयोगी होती है जब क्लस्टरों की संख्या पहले से ज्ञात न हो। यह डेटा विश्लेषकों और डेटा वैज्ञानिकों को डेंडोग्राम के माध्यम से डेटा की संरचना को दृश्य रूप से तलाशने की सुविधा देती है।
यह तकनीक नेस्टेड क्लस्टरों को उजागर करने में सक्षम है और जीनोमिक्स, कस्टमर सेगमेंटेशन और दस्तावेज़ संगठन जैसे क्षेत्रों में व्यापक रूप से प्रयोग होती है।
उदाहरण के लिए, मान लीजिए हमारे पास ग्राहक खरीद रिकॉर्ड का डेटासेट है। हायरार्किकल क्लस्टरिंग का उपयोग करके, हम समान खरीद पैटर्न वाले ग्राहकों को क्लस्टरों में समूहित कर सकते हैं और लक्षित मार्केटिंग रणनीतियों के लिए संभावित बाज़ार खंडों की पहचान कर सकते हैं।
क्लस्टरिंग कार्यों के लिए, अधिकांश लोग दो प्रमुख तरीकों के बीच असमंजस में रहते हैं: हायरार्किकल क्लस्टरिंग या K-means क्लस्टरिंग।
पर अंतर क्या है? एक स्पष्ट तस्वीर के लिए नीचे इनके बीच के फर्क देखें।
दोनों की तुलना में, कुछ स्थितियाँ हायरार्किकल क्लस्टरिंग को बेहतर विकल्प बनाती हैं।
यहाँ वे क्षेत्र हैं जहाँ हायरार्किकल क्लस्टरिंग अच्छी है:
हालाँकि, इसके कुछ नकारात्मक पक्ष भी हो सकते हैं, जैसे:
आप पूछ सकते हैं: हायरार्किकल क्लस्टरिंग कब उपयोग करनी चाहिए?
निम्नलिखित अनुप्रयोगों में हायरार्किकल क्लस्टरिंग उत्कृष्ट विकल्प है:
हायरार्किकल क्लस्टरिंग तकनीक में कई प्रकार मिलते हैं, जिनमें से प्रत्येक अलग अंतर्दृष्टि और परिणाम देता है। हायरार्किकल क्लस्टरिंग के दो मुख्य प्रकार हैं: एग्लोमेरेटिव (बॉटम-अप) और डिवाइसिव (टॉप-डाउन)।
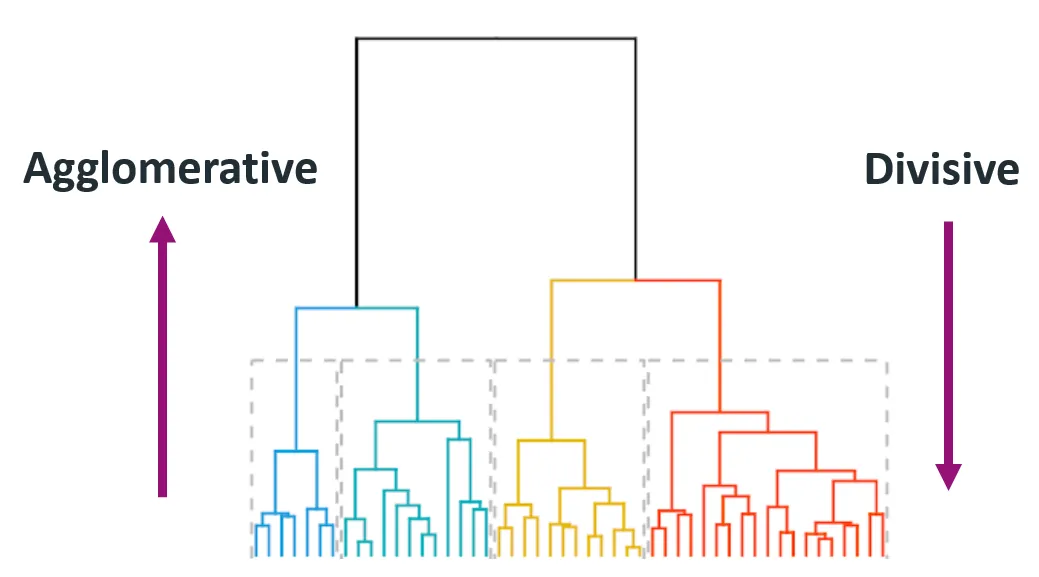
स्रोत: Himanshu Sharma on Medium
एग्लोमेरेटिव क्लस्टरिंग में प्रत्येक डेटा बिंदु को एक अलग क्लस्टर से शुरू किया जाता है और निकटतम क्लस्टर-युग्मों को क्रमिक रूप से मिलाया जाता है, जब तक कि केवल एक क्लस्टर न रह जाए या तब तक जब तक कोई स्टॉपिंग कंडीशन (जैसे इच्छित क्लस्टरों की संख्या) पूरी न हो जाए।
इसे बॉटम-अप भी कहते हैं, क्योंकि यह नीचे (व्यक्तिगत डेटा बिंदु) से शुरू होकर ऊपर (अंतिम क्लस्टर) तक बनता है।
स्टेप-बाय-स्टेप गाइड:
यह विधि अपनी सरलता और आसानी से लागू होने के कारण व्यापक रूप से प्रयुक्त होती है।
यहाँ Python में इसे लागू करने का एक उदाहरण है:
import numpy as np
from scipy.cluster.hierarchy import linkage, dendrogram, fcluster
import matplotlib.pyplot as plt

# Samples data
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])

# Applies agglomerative clustering using Ward's method
Z = linkage(data, method='ward')

# Plots dendrogram
plt.figure(figsize=(8, 4))
dendrogram(Z)
plt.title('Agglomerative Clustering Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()

# Extracts clusters (e.g., form 2 clusters)
clusters = fcluster(Z, t=2, criterion='maxclust')
print("Cluster assignments:", clusters)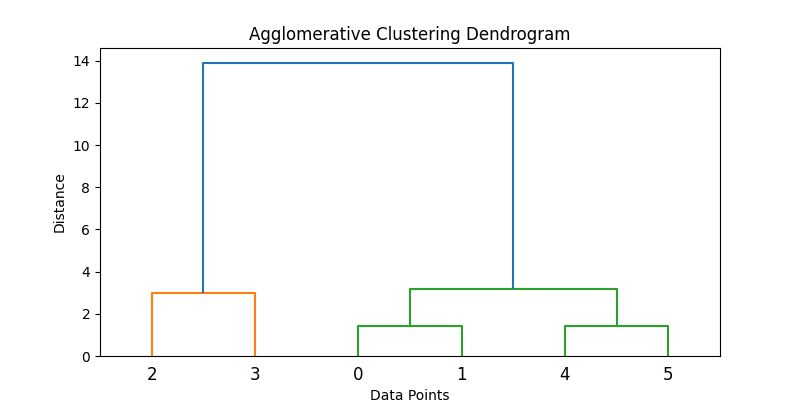
डिवाइसिव क्लस्टरिंग में सभी डेटा बिंदुओं को एक ही क्लस्टर में लेकर शुरुआत की जाती है और उन्हें बार-बार छोटे क्लस्टरों में विभाजित किया जाता है। यह प्रक्रिया तब तक चलती है जब तक हर डेटा बिंदु अपने अलग-अलग क्लस्टर में न आ जाए।
इसे टॉप-डाउन अप्रोच भी कहा जाता है, क्योंकि यह ऊपर (एकल क्लस्टर) से शुरू होकर छोटे क्लस्टरों में टूटता जाता है।
स्टेप-बाय-स्टेप गाइड:
डिवाइसिव विधियाँ अपनी रिकर्सिव प्रकृति के कारण सामान्यतः अधिक गणनात्मक रूप से महंगी होती हैं, और शुद्धता विभाजन रणनीति पर काफ़ी निर्भर करती है। एग्लोमेरेटिव विधियाँ लागू करने में सरलता और व्यापक सॉफ़्टवेयर समर्थन के कारण अधिक सामान्य हैं।
नोट: डिवाइसिव हायरार्किकल क्लस्टरिंग को मानक Python लाइब्रेरियों में एग्लोमेरेटिव क्लस्टरिंग जितना समर्थन नहीं मिलता। एक तरीका यह है कि k-means जैसे क्लस्टरिंग एल्गोरिदम को रिकर्सिव रूप से उपयोग किया जाए।
यहाँ रिकर्सिव k-means स्प्लिटिंग का एक सांकेतिक कोड-सं概 है:
from sklearn.cluster import KMeans

def divisive_clustering(data, depth=2):
    if depth == 0 or len(data) <= 1:
        return [data]

    kmeans = KMeans(n_clusters=2, random_state=42).fit(data)
    labels = kmeans.labels_
    cluster1 = data[labels == 0]
    cluster2 = data[labels == 1]

    return divisive_clustering(cluster1, depth - 1) + divisive_clustering(cluster2, depth - 1)

# Run recursive splitting to simulate divisive clustering
split_clusters = divisive_clustering(data, depth=2)
for i, cluster in enumerate(split_clusters):
    print(f"Cluster {i+1} size: {len(cluster)}")
यह सरल कोड रिकर्सिव k-means का उपयोग कर डिवाइसिव क्लस्टरिंग का वैचारिक तरीका दर्शाता है। ध्यान दें, मानक डिवाइसिव विधियाँ जैसे DIANA भिन्न स्प्लिटिंग मानदंड अपनाती हैं।
हायरार्किकल क्लस्टरिंग में कुछ प्रमुख अवधारणाएँ और पारिभाषिक शब्द होते हैं जिन्हें समझना ज़रूरी है। प्रक्रिया को पूरी तरह समझने के लिए, नीचे हम इन्हें विस्तार से देखते हैं।
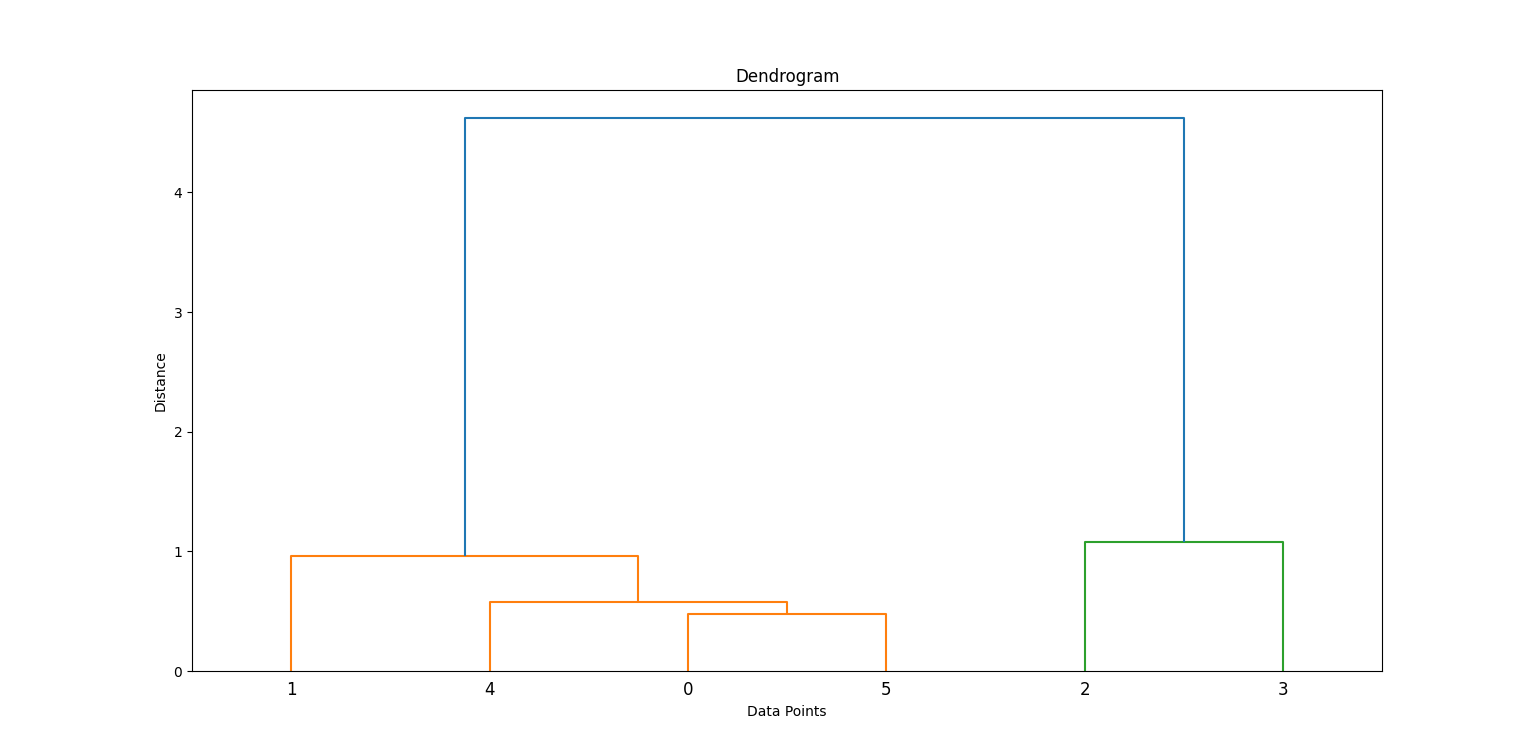
डेंडोग्राम एक वृक्ष-जैसी संरचना है जो हायरार्किकल क्लस्टरिंग की प्रक्रिया को विज़ुअलाइज़ करती है। वृक्ष का प्रत्येक स्तर किसी मर्ज या स्प्लिट ऑपरेशन का प्रतिनिधित्व करता है, और शाखाओं की ऊँचाई वह दूरी (या असमानता) दर्शाती है जिस पर क्लस्टर जुड़े।
यह क्यों महत्वपूर्ण है:
लिंकेंज मानदंड यह निर्धारित करते हैं कि मर्जिंग प्रक्रिया के दौरान क्लस्टरों के बीच दूरी कैसे गणना की जाए।
यहाँ कुछ प्रकार दिए गए हैं:
यह मानदंड दो क्लस्टरों के सबसे निकट बिंदुओं के बीच दूरी देखता है। इससे लंबे, चेन-जैसे क्लस्टर बन सकते हैं।
from scipy.spatial.distance import pdist, squareform
data = np.array([[1, 2], [2, 3], [5, 8]])
distance_matrix = squareform(pdist(data, metric='euclidean'))
single_linkage_min = np.min(distance_matrix[0, 1:])
print("Single Linkage Distance between Cluster A (point 1) and Cluster B (point 2, 3):", single_linkage_min)यह मानदंड दो क्लस्टरों के सबसे दूर बिंदुओं के बीच दूरी देखता है। यह प्रायः सघन, समान आकार के क्लस्टर पैदा करता है।
single_linkage_max = np.max(distance_matrix[0, 1:])
print("Complete Linkage Distance between Cluster A and B:", single_linkage_max)यह मानदंड एक क्लस्टर के सभी बिंदुओं से दूसरे क्लस्टर के सभी बिंदुओं तक की औसत दूरी देखता है। यह सिंगल और कम्प्लीट लिंकेंज के बीच संतुलन देता है।
average_linkage = np.mean(distance_matrix[0, 1:])
print("Average Linkage Distance between Cluster A and B:", average_linkage)
ये सरल उदाहरण दिखाते हैं कि प्रारम्भ में दूरी कैसे गणना होती है। हालाँकि, क्लस्टरिंग के दौरान ये मानदंड (सिंगल, कम्प्लीट, एवरेज लिंकेंज) दूरी को क्रमिक रूप से पूरे क्लस्टरों के बीच लागू करते हैं, सिर्फ़ व्यक्तिगत बिंदुओं के बीच नहीं।
वॉर्ड्स मेथड एवरेज लिंकेंज का एक रूपांतर है जो सभी क्लस्टरों के भीतर स्क्वेयर्ड डिफरेंसेज़ के योग को न्यूनतम करता है। यह अन्य तरीकों की तुलना में अधिक समान आकार के क्लस्टर पैदा करने की प्रवृत्ति रखता है। यह अक्सर अच्छे से अलग, गोलाकार क्लस्टरों का परिणाम देता है।
from scipy.cluster.hierarchy import linkage
linkage_ward = linkage(data, method='ward')
print("Ward's Linkage Matrix:\n", linkage_ward)
हर विधि की अपनी-अपनी ताकतें हैं, और चुनाव डेटा व उपयोग-केस के आधार पर करना चाहिए।
उपयोग की गई दूरी मीट्रिक क्लस्टरिंग के परिणाम को काफी प्रभावित करती है।
यूक्लिडियन दूरी बहु-आयामी स्थान में दो बिंदुओं के बीच सीधी रेखा की दूरी है। यह विशेष रूप से ज्यामितीय रूप से वितरित डेटा के लिए सबसे सामान्य दूरी मीट्रिक है।
Manhattan distance, जिसे टैक्सीकैब या L1 दूरी भी कहा जाता है, आयामों में परास्परिक पारम्परिक निरपेक्ष अंतरों का योग है। यह ग्रिड-जैसे डेटा, जैसे सिटी ब्लॉक्स या वित्तीय लेनदेन, के लिए उपयोगी होती है।
कोसाइन सिमिलैरिटी दो नॉन-ज़ीरो वेक्टरों के बीच कोण के कोसाइन को मापती है। यह मीट्रिक टेक्स्ट डेटा या तब आदर्श है जब मैग्निट्यूड मायने नहीं रखता (जैसे, शब्द आवृत्ति वेक्टर)।
इस खंड में, हम Python का उपयोग कर एग्लोमेरेटिव हायरार्किकल क्लस्टरिंग का व्यावहारिक कार्यान्वयन देखेंगे। हम डेटा प्रीप्रोसेसिंग से लेकर डेंडोग्राम द्वारा परिणामों का विज़ुअलाइज़ेशन तक सब कवर करेंगे।
हम आवश्यक लाइब्रेरी इम्पोर्ट करके शुरू करते हैं:
import numpy as np
import pandas as pd
from scipy.cluster.hierarchy import dendrogram, linkage, fcluster
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
ऊपर के कोड में हमने यह इम्पोर्ट किया है:
numpy और pandas डेटा मैनिपुलेशन के लिएscipy.cluster.hierarchy क्लस्टरिंग और डेंडोग्राम जनरेशन के लिएsklearn.preprocessing.StandardScaler फीचर स्केलिंग के लिएmatplotlib विज़ुअलाइज़ेशन के लिएविश्लेषण शुरू करने से पहले, चलिए 2D बिंदुओं का एक टॉय डेटासेट बनाते हैं और उसे स्केल करते हैं। दूरी-आधारित एल्गोरिदम के लिए स्केलिंग अत्यंत महत्वपूर्ण है।
हमारा नमूना डेटासेट कुछ ऐसा दिखेगा।
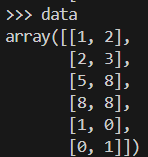
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])
scaler = StandardScaler()
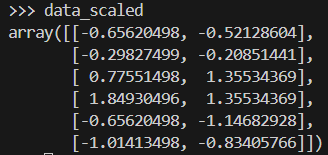
data_scaled = scaler.fit_transform(data)
स्केल होने के बाद डेटा का ऐरे ऐसा दिखेगा।
हम वॉर्ड्स मेथड लागू करके लिंकेंज मैट्रिक्स बनाते हैं, जो हायरार्किकल क्लस्टरिंग की जानकारी रखती है। फिर हम डेंडोग्राम प्लॉट करते हैं।
linkage_matrix = linkage(data_scaled, method='ward')
plt.figure(figsize=(8, 4))
dendrogram(linkage_matrix)
plt.title('Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()
ऊपर के कोड में, linkage क्लस्टर पदानुक्रम बनाता है, और dendrogram क्लस्टर बनने की प्रक्रिया को विज़ुअलाइज़ करता है।
जहाँ मर्ज से पहले वर्टिकल रेखाएँ सबसे लंबी हैं, उन्हें देखकर हम तय कर सकते हैं कि क्लस्टर बनाने के लिए कहाँ “कट” करें। उस सबसे ऊँची वर्टिकल रेखा को देखें जो किसी अन्य क्लस्टर से नहीं टकराती। कट वहीं करना चाहिए।
इस मामले में, आपको 2 क्लस्टरों पर कट करना होगा।
अगले चरण में, हम fcluster का उपयोग कर डेंडोग्राम को काटकर विशिष्ट संख्या के क्लस्टर प्राप्त करते हैं:
clusters = fcluster(linkage_matrix, t=2, criterion='maxclust')
print(clusters)

plt.scatter(data_scaled[:, 0], data_scaled[:, 1], c=clusters, cmap='rainbow')
plt.title('Clusters')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()
यह प्रत्येक डेटा बिंदु को दो में से किसी एक क्लस्टर में असाइन करता है।
कोड से संबंधित कुछ अतिरिक्त जानकारी:
t=2: इच्छित क्लस्टरों की संख्या निर्दिष्ट करता है।criterion='maxclust': सुनिश्चित करता है कि हमें ठीक t क्लस्टर मिलें।आप विभिन्न क्लस्टर संख्याओं के साथ प्रयोग करने के लिए t बदल सकते हैं।
हायरार्किकल क्लस्टरिंग का प्रायः ग्राहक विभाजन में उपयोग होता है। देखते हैं व्यावहारिक कार्यान्वयन में यह कैसा दिखता है।
मान लीजिए हम ग्राहकों का एक डेटासेट सिमुलेट करते हैं जिसमें दो फीचर हैं: आयु और आय। हम यह सिंथेटिक डेटा बनाने के लिए make_blobs का उपयोग करेंगे।
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=100, centers=3, n_features=2, random_state=42)अगले चरण में, हम स्केलों को सामान्य करने और क्लस्टरिंग की सटीकता बढ़ाने के लिए फीचरों को मानकीकृत करेंगे।
scaler = StandardScaler()
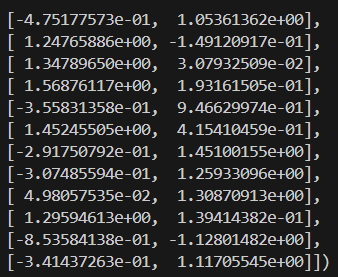
X_scaled = scaler.fit_transform(X)
स्केल किया हुआ डेटा कुछ ऐसा दिखता है:
अब जब हमारा डेटा प्रोसेस हो गया है, हम डेंडोग्राम प्लॉट करेंगे ताकि क्लस्टर बनने की प्रक्रिया को देख सकें।
linkage_matrix = linkage(X_scaled, method='ward')
plt.figure(figsize=(10, 5))
dendrogram(linkage_matrix)
plt.title('Customer Dendrogram')
plt.xlabel('Sample Index')
plt.ylabel('Distance')
plt.show()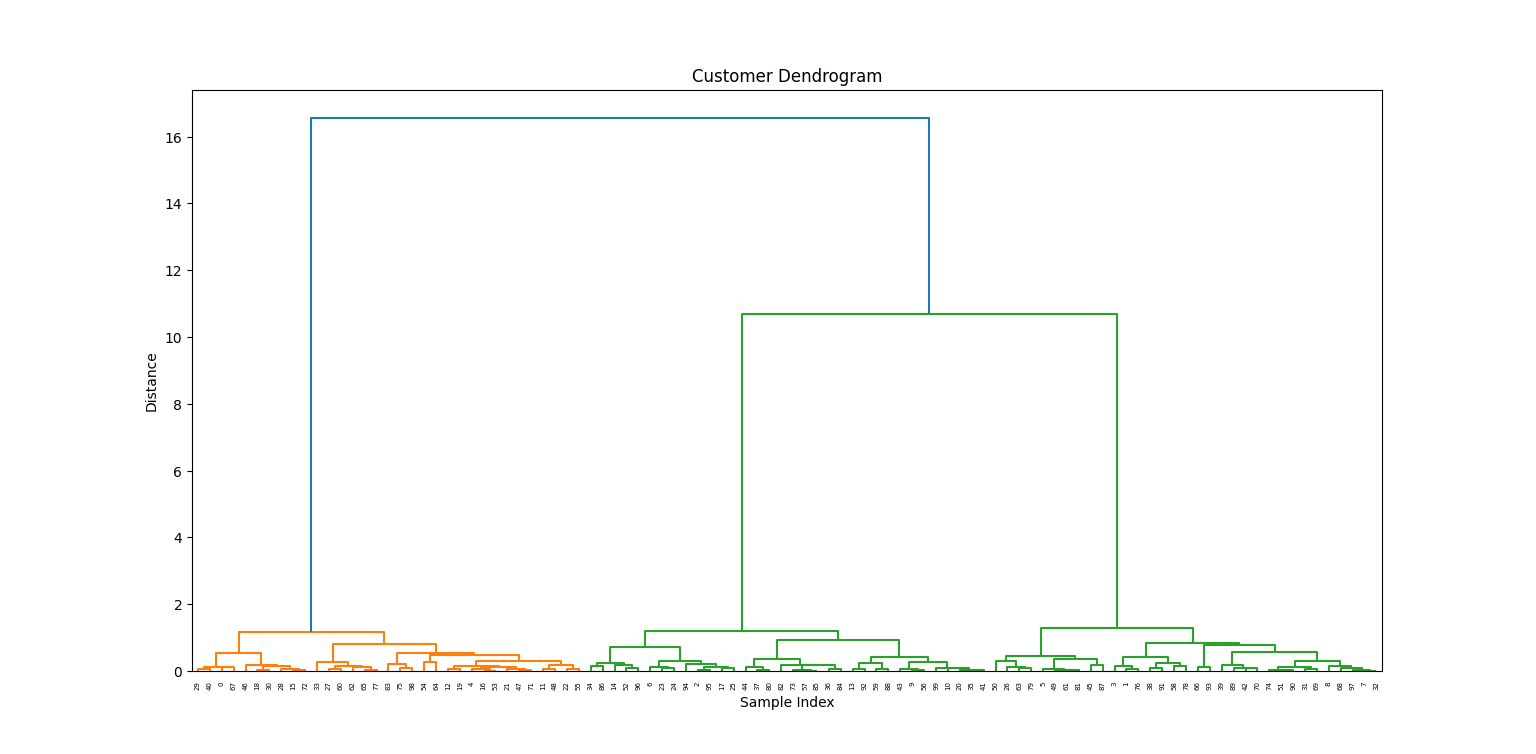
डेंडोग्राम से, हम “कट” करने की ऊँचाई चुनकर तीन क्लस्टर बनाते हैं:
labels = fcluster(linkage_matrix, t=3, criterion='maxclust')
plt.scatter(X_scaled[:, 0], X_scaled[:, 1], c=labels, cmap='rainbow')
plt.title('Customer Segments')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()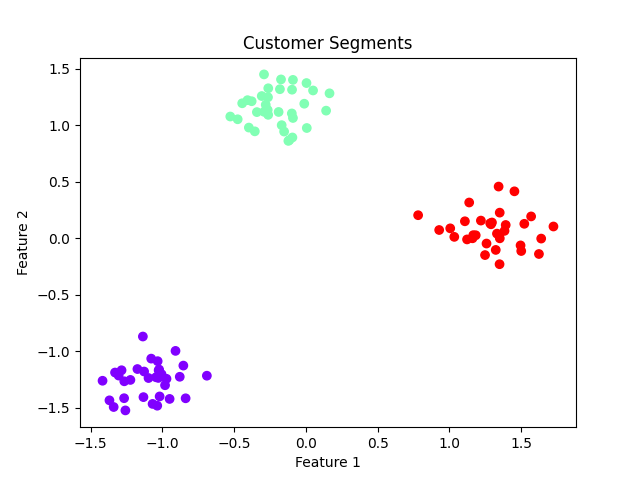
व्यावसायिक निहितार्थ:
अपने विश्लेषण के लिए हायरार्किकल क्लस्टरिंग चुनने के कई फायदे और सीमाएँ हैं।
नीचे कुछ आम बिंदु देखें:
हायरार्किकल क्लस्टरिंग एक बहुउपयोगी और व्याख्यात्मक क्लस्टरिंग तकनीक है, जो विशेष रूप से एक्सप्लोरेटरी डेटा एनालिसिस और जीनोमिक्स व ग्राहक विभाजन जैसे क्षेत्रों में उपयोगी है। यद्यपि इसकी गणनात्मक लागत अधिक हो सकती है, इसकी ताकत नेस्टेड समूहों का पता लगाने की क्षमता और डेंडोग्राम विज़ुअलाइज़ेशन के माध्यम से बाद में क्लस्टरों की संख्या चुनने में लचीलापन है।
छोटे से मध्यम आकार के डेटासेट के लिए, जहाँ व्याख्यात्मकता प्रमुख है, हायरार्किकल क्लस्टरिंग डेटा वैज्ञानिकों और विश्लेषकों के लिए एक विश्वसनीय विधि बनी रहती है।
मशीन लर्निंग के विवरण के बारे में और सीखना चाहते हैं? हमारा Machine Learning Fundamentals in Python ट्रैक और Introduction to Hierarchical Clustering in Python ट्यूटोरियल शुरुआत करने के लिए बेहतरीन संसाधन हैं।
शीर्ष DataCamp कोर्स
कोर्स
लर्निंग पाथ
कोर्स