
Last chance! 50% off DataCamp Premium
Sale ends in
Diyelim ki büyük bir veri kümesini analiz etmekle görevlendirildiniz ve derinlemesine bir küme analizi sunmanız gerekiyor. “Hiyerarşik kümeleme” terimiyle karşılaştınız, ancak bu tam olarak nedir ve nasıl çalışır?
Bu yazıda, hiyerarşik kümeleme kavramını inceleyecek ve uygulamalarını daha iyi anlamanıza yardımcı olacak gerçek hayattan örnekler sunacağız.
Hiyerarşik kümeleme, benzer veri noktalarını kümeler halinde gruplamak için kullanılan bir denetimsiz öğrenme algoritmasıdır. Küçük kümeleri daha büyük olanlarla birleştirerek (birleştirici) veya büyük bir kümeyi daha küçük parçalara ayırarak (bölücü) çok seviyeli bir küme hiyerarşisi oluşturur. Bunun sonucu, dendrogram olarak bilinen ağaç benzeri bir yapıdır.
Dendrogram, kümelerin düzenini ve birbirleriyle olan ilişkilerini gösteren görsel bir temsildir. Dendrogramdaki dalların yüksekliği, kümelerin birleştiği mesafeyi veya benzerlik düzeyini temsil eder. Daha düşük yükseklikler, daha küçük mesafelerde birleşen kümeleri ifade eder ve böylece daha yüksek benzerliği gösterir.
Hiyerarşik kümeleme, küme sayısının önceden bilinmediği durumlarda özellikle kullanışlıdır. Veri analistlerinin ve veri bilimcilerinin dendrogramlar aracılığıyla verinin yapısını görsel olarak keşfetmesine olanak tanır.
Bu teknik, iç içe kümeleri ortaya çıkarabilme özelliğine de sahiptir ve genomik, müşteri segmentasyonu ve belge organizasyonu gibi alanlarda yaygın olarak kullanılır.
Örneğin, müşteri satın alma kayıtlarından oluşan bir veri kümesine sahip olduğumuzu varsayalım. Hiyerarşik kümeleme kullanarak benzer satın alma kalıplarına sahip müşterileri kümeler halinde gruplandırabilir ve hedefli pazarlama stratejileri için potansiyel pazar segmentlerini belirleyebiliriz.
Kümeleme görevlerinde çoğu kişi iki temel yöntem arasında kararsız kalır: Hiyerarşik kümeleme veya K-means kümeleme.
Peki onları farklı kılan nedir? Daha net bir tablo için aşağıdaki farklarına bakalım.
İkisini karşılaştırırken, bazı yönler hiyerarşik kümelemeyi öne çıkarır.
Hiyerarşik kümelemenin iyi olduğu bazı alanlar şunlardır:
Bununla birlikte, bazı dezavantajları da olabilir, örneğin:
Şöyle sorabilirsiniz: Hiyerarşik kümelemeyi ne zaman kullanmalıyım?
Hiyerarşik kümeleme, aşağıdaki uygulamalarda mükemmel bir seçimdir:
Hiyerarşik kümeleme tekniği içinde, her biri farklı içgörüler ve sonuçlar sunan çeşitli türlerle karşılaşırsınız. Hiyerarşik kümelemenin iki ana türü birleştirici (aşağıdan yukarıya) ve bölücü (yukarıdan aşağıya) yaklaşımlardır.
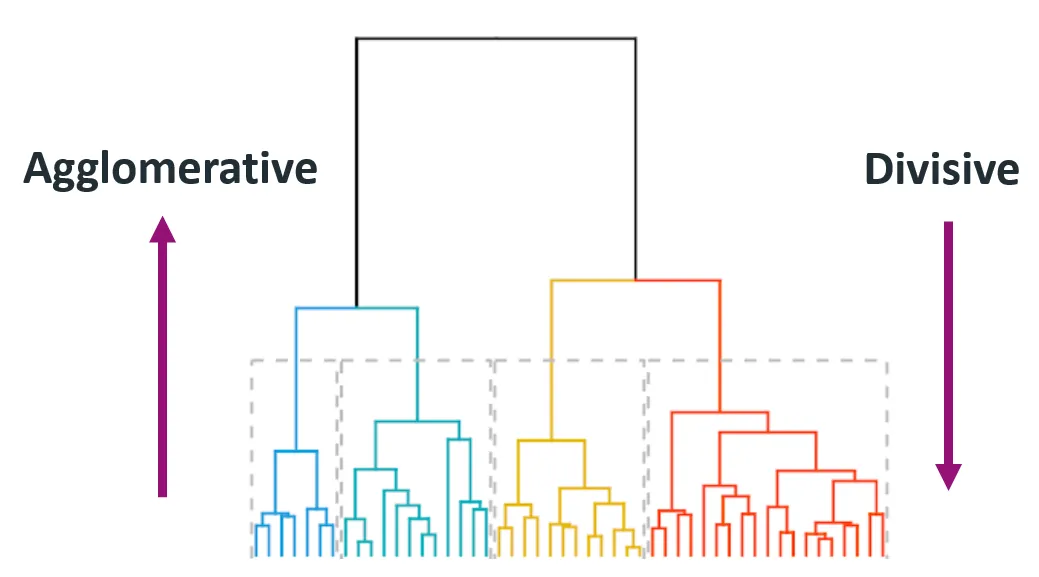
Kaynak: Himanshu Sharma, Medium
Birleştirici kümeleme, her veri noktasını tek başına bir küme olarak başlatır ve en yakın küme çiftlerini yinelemeli olarak birleştirir; bu işlem, yalnızca bir küme kalana kadar veya bir durdurma koşulu (örneğin, istenen küme sayısı) sağlanana kadar devam eder.
Bu yöntem, aşağıdan (tekil veri noktaları) başlayıp yukarıya (nihai küme) doğru ilerlediği için aşağıdan yukarıya yaklaşım olarak da adlandırılır.
Adım adım rehber:
Basitliği ve uygulanmasının kolay olması nedeniyle yaygın olarak kullanılır.
İşte bunun Python'da nasıl uygulanabileceğine dair bir örnek:
import numpy as np
from scipy.cluster.hierarchy import linkage, dendrogram, fcluster
import matplotlib.pyplot as plt

# Samples data
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])

# Applies agglomerative clustering using Ward's method
Z = linkage(data, method='ward')

# Plots dendrogram
plt.figure(figsize=(8, 4))
dendrogram(Z)
plt.title('Agglomerative Clustering Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()

# Extracts clusters (e.g., form 2 clusters)
clusters = fcluster(Z, t=2, criterion='maxclust')
print("Cluster assignments:", clusters)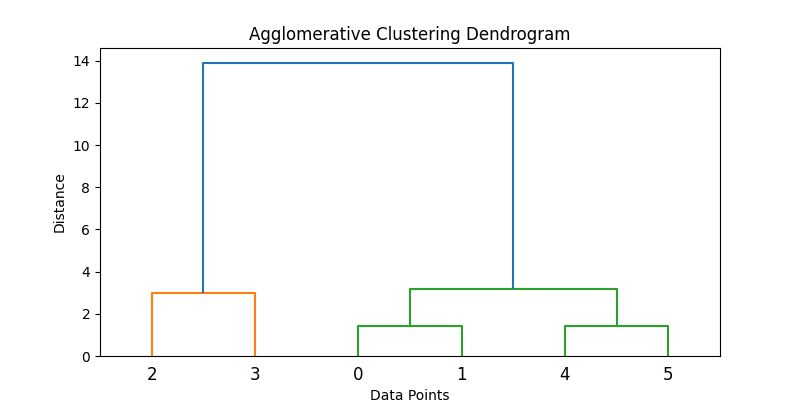
Bölücü kümeleme, tüm veri noktalarının tek bir kümede olduğu bir başlangıçla başlar ve bunları yinelemeli olarak daha küçük kümelere böler. Süreç, her veri noktası kendi başına bir küme olana kadar devam eder.
Tek bir küme ile en üstten başlayıp bunu daha küçük kümelere ayırdığı için yukarıdan aşağıya yaklaşım olarak da bilinir.
Adım adım rehber:
Bölücü yöntemler, yinelemeli doğaları nedeniyle tipik olarak daha hesaplama yoğun olup doğruluk, büyük ölçüde bölme stratejisine bağlıdır. Birleştirici yöntemler, uygulanmalarının kolay olması ve yaygın yazılım desteği nedeniyle daha yaygındır.
Not: Bölücü hiyerarşik kümeleme, birleştirici kümeleme kadar standart Python kütüphanelerinde hazır desteklenmez. Yaklaşımlardan biri, k-means gibi kümeleme algoritmalarını yinelemeli olarak kullanmaktır.
İşte yinelemeli k-means bölmenin simüle edildiği bir kod konsepti:
from sklearn.cluster import KMeans

def divisive_clustering(data, depth=2):
    if depth == 0 or len(data) <= 1:
        return [data]

    kmeans = KMeans(n_clusters=2, random_state=42).fit(data)
    labels = kmeans.labels_
    cluster1 = data[labels == 0]
    cluster2 = data[labels == 1]

    return divisive_clustering(cluster1, depth - 1) + divisive_clustering(cluster2, depth - 1)

# Run recursive splitting to simulate divisive clustering
split_clusters = divisive_clustering(data, depth=2)
for i, cluster in enumerate(split_clusters):
    print(f"Cluster {i+1} size: {len(cluster)}")
Bu basitleştirilmiş kod, yinelemeli K-means kullanarak bölücü kümelemeye kavramsal bir yaklaşımı göstermektedir. Ancak, DIANA gibi standart bölücü yöntemlerin farklı bölme ölçütleri kullandığını unutmayın.
Hiyerarşik kümeleme, anlaşılması önemli olan bazı temel kavramlar ve terimler içerir. Süreci tam olarak kavramak için bu kavramları aşağıda daha ayrıntılı olarak ele alacağız.
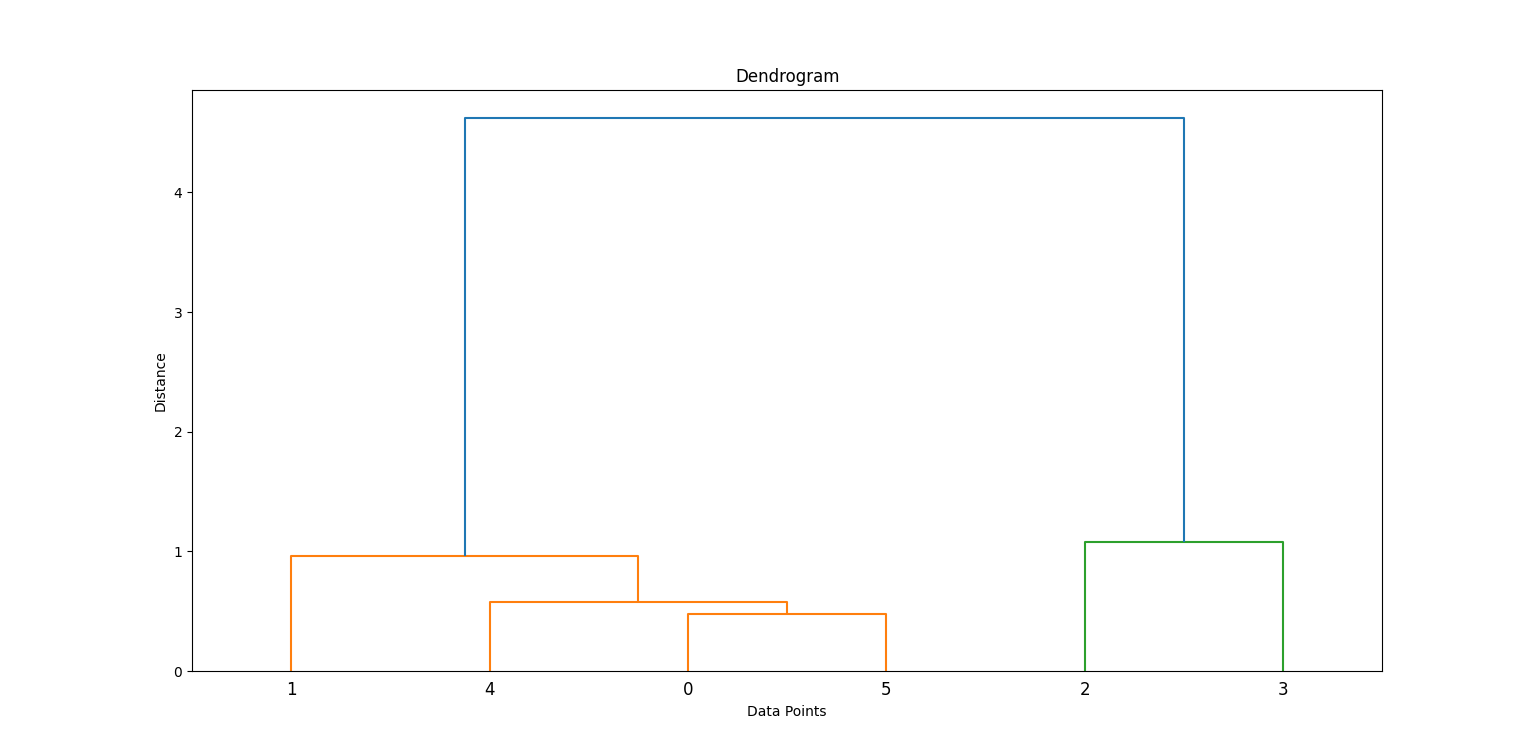
Dendrogram, hiyerarşik kümeleme sürecini görselleştiren ağaç benzeri bir yapıdır. Ağacın her seviyesi birleştirme veya bölme işlemini temsil eder ve dalların yüksekliği, kümelerin birleştirildiği mesafeyi (veya benzerlik düzeyini) gösterir.
Neden önemli olduğuna dair şunları söyleyebiliriz:
Bağlantı ölçütleri, birleştirme sürecinde kümeler arasındaki mesafelerin nasıl hesaplandığını belirler.
Bağlantı ölçütlerinden bazıları şunlardır:
Bu ölçüt, iki kümenin en yakın noktaları arasındaki mesafeye bakar. Uzamış, zincir benzeri kümelere yol açabilir.
from scipy.spatial.distance import pdist, squareform
data = np.array([[1, 2], [2, 3], [5, 8]])
distance_matrix = squareform(pdist(data, metric='euclidean'))
single_linkage_min = np.min(distance_matrix[0, 1:])
print("Single Linkage Distance between Cluster A (point 1) and Cluster B (point 2, 3):", single_linkage_min)Bu ölçüt, iki kümenin en uzak noktaları arasındaki mesafeye bakar. Daha sıkı, eşit boyutlu kümeler oluşturma eğilimindedir.
single_linkage_max = np.max(distance_matrix[0, 1:])
print("Complete Linkage Distance between Cluster A and B:", single_linkage_max)Bu ölçüt, bir kümedeki tüm noktaların diğer kümedeki tüm noktalara olan ortalama mesafesine bakar. Tek ve tam bağlantı arasında bir denge sağlar.
average_linkage = np.mean(distance_matrix[0, 1:])
print("Average Linkage Distance between Cluster A and B:", average_linkage)
Bu basitleştirilmiş örnekler, mesafelerin başlangıçta nasıl hesaplandığını gösterir. Ancak, kümeleme sırasında bu ölçütler (tek, tam, ortalama bağlantı) yalnızca tekil noktalar arasında değil, tüm kümeler arasında yinelemeli olarak uygulanır.
Ward yöntemi, tüm kümeler içindeki kareler toplamını en aza indiren, ortalama bağlantı yaklaşımının bir varyasyonudur. Diğer yöntemlere kıyasla daha eşit boyutlu kümeler oluşturma eğilimindedir. Ayrıca sıklıkla iyi ayrılmış, küresel kümeler üretir.
from scipy.cluster.hierarchy import linkage
linkage_ward = linkage(data, method='ward')
print("Ward's Linkage Matrix:\n", linkage_ward)
Her yöntemin kendi güçlü yönleri vardır ve veri ile kullanım durumuna göre seçilmelidir.
Kullanılan mesafe ölçütü, kümeleme sonucunu önemli ölçüde etkiler.
Öklidyen mesafe, çok boyutlu uzayda iki nokta arasındaki doğru parçası mesafesidir. Özellikle geometrik olarak dağıtılmış veriler için en yaygın kullanılan mesafe ölçütüdür.
Manhattan mesafesi, taksici mesafesi veya L1 mesafesi olarak da bilinir ve boyutlar boyunca mutlak farkların toplamıdır. Şehir blokları veya finansal işlemler gibi ızgara benzeri veriler için kullanışlıdır.
Kosinüs benzerliği, sıfır olmayan iki vektör arasındaki açının kosinüsünü ölçer. Büyüklüğün önemli olmadığı durumlar (ör. kelime sıklığı vektörleri) veya metin verileri için idealdir.
Bu bölümde, Python kullanarak birleştirici hiyerarşik kümelemenin pratik bir uygulamasını adım adım ele alacağız. Veri ön işleme aşamasından dendrogram kullanarak sonuçların görselleştirilmesine kadar her şeyi kapsayacağız.
Gerekli kütüphaneleri içe aktararak başlıyoruz:
import numpy as np
import pandas as pd
from scipy.cluster.hierarchy import dendrogram, linkage, fcluster
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
Yukarıdaki kodda şunları içe aktardık:
numpy ve pandas veri işleme içinscipy.cluster.hierarchy kümeleme ve dendrogram oluşturma içinsklearn.preprocessing.StandardScaler özellik ölçekleme içinmatplotlib görselleştirme içinAnalize başlamadan önce, 2B noktalardan oluşan küçük bir oyuncak veri kümesi oluşturalım ve bunu ölçekleyelim. Ölçekleme, mesafeye dayalı algoritmalar için kritiktir.
Örnek veri kümemiz aşağıdaki gibi görünecektir.
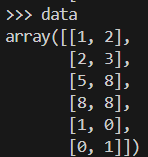
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])
scaler = StandardScaler()
data_scaled = scaler.fit_transform(data)
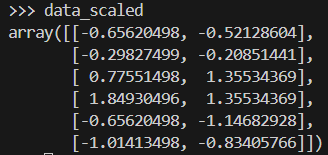
Ölçeklendirmeden sonra veri dizisi aşağıdaki gibidir.
Hiyerarşik kümeleme bilgilerini içeren bir bağlantı matrisi oluşturmak için Ward yöntemini uygularız. Ardından bir dendrogram çizeriz.
linkage_matrix = linkage(data_scaled, method='ward')
plt.figure(figsize=(8, 4))
dendrogram(linkage_matrix)
plt.title('Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()
Yukarıdaki kodda, linkage küme hiyerarşisini oluşturur ve dendrogram kümelerin nasıl oluştuğunu görselleştirmeye yardımcı olur.
Birleştirme öncesindeki en uzun dikey çizgilerin nerede olduğuna bakarak kümeleri oluşturmak için nereden “kesileceğine” karar verebiliriz. Diğer kümelerle kesişmeyen en yüksek dikey çizgiyi arayın. Kesmenin yapılması gereken yer burasıdır.
Bu durumda, 2 kümede kesmeniz gerekecektir.
Sonraki adımda, belirli sayıda küme elde etmek için fcluster kullanarak dendrogramı keseriz:
clusters = fcluster(linkage_matrix, t=2, criterion='maxclust')
print(clusters)

plt.scatter(data_scaled[:, 0], data_scaled[:, 1], c=clusters, cmap='rainbow')
plt.title('Clusters')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()
Bu, her veri noktasını iki kümeden birine atar.
Kodla ilgili bazı ek bilgiler:
t=2: İstenen küme sayısını belirtir.criterion='maxclust': Tam olarak t küme elde edilmesini sağlar.Farklı küme sayılarıyla denemek için t değerini değiştirebilirsiniz.
Hiyerarşik kümeleme, genellikle müşteri segmentasyonunda kullanılır. Bunun pratik bir uygulamada nasıl göründüğüne bakalım.
İki özellikten (yaş ve gelir) oluşan müşterileri temsil eden bir veri setini simüle edelim. Bu sentetik veriyi oluşturmak için make_blobs kullanacağız.
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=100, centers=3, n_features=2, random_state=42)Sonraki adımda, ölçekleri normalize etmek ve kümeleme doğruluğunu artırmak için özellikleri standartlaştıracağız.
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
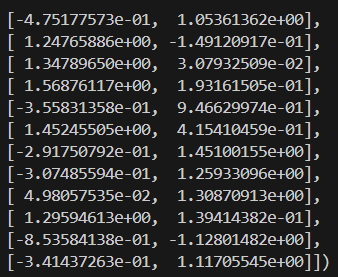
Ölçeklendirilmiş veriler şöyle görünür:
Verilerimiz işlendiğine göre, kümelerin nasıl oluştuğunu görselleştirmek için dendrogramı çizeceğiz.
linkage_matrix = linkage(X_scaled, method='ward')
plt.figure(figsize=(10, 5))
dendrogram(linkage_matrix)
plt.title('Customer Dendrogram')
plt.xlabel('Sample Index')
plt.ylabel('Distance')
plt.show()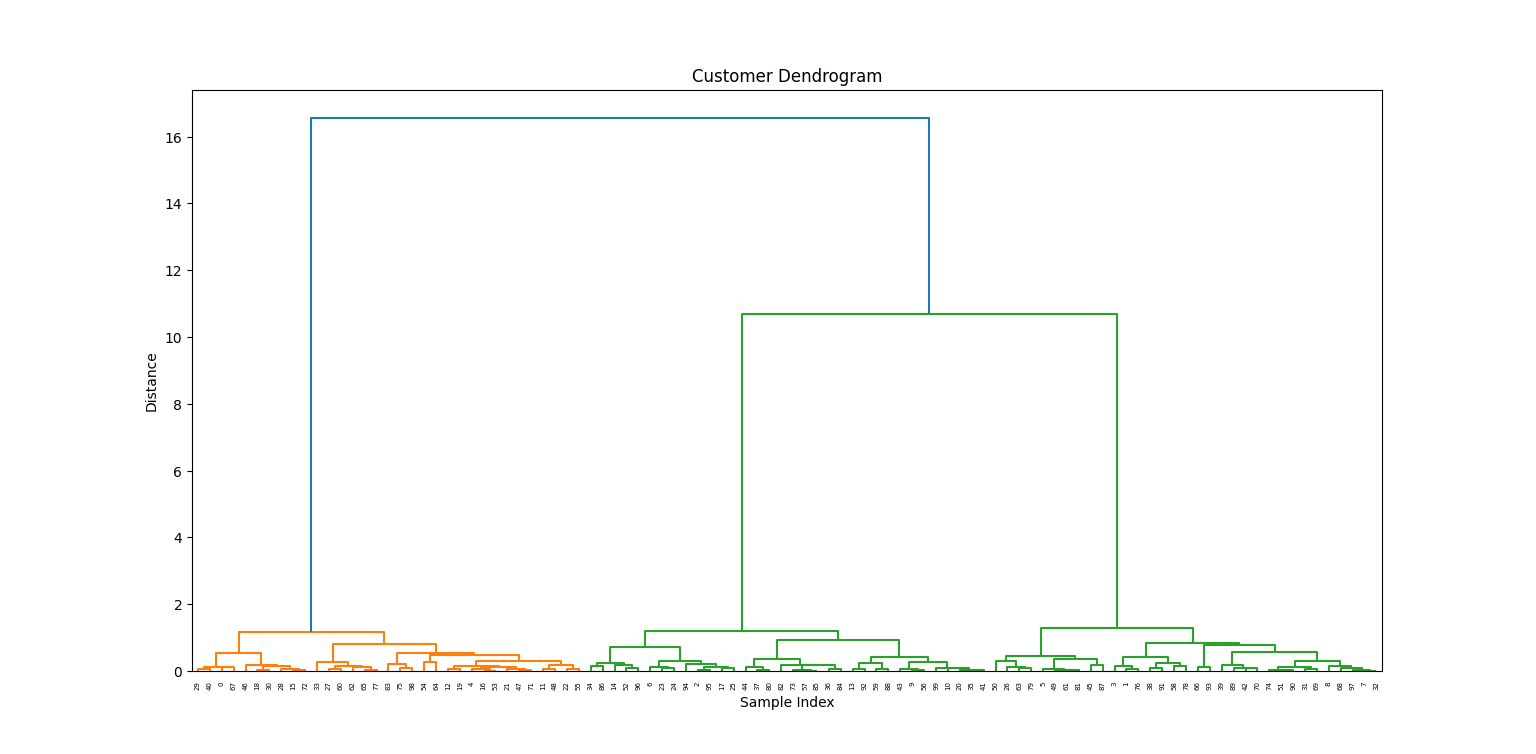
Dendrogramdan bir yükseklik seçerek “kesim” yapar ve üç küme oluştururuz:
labels = fcluster(linkage_matrix, t=3, criterion='maxclust')
plt.scatter(X_scaled[:, 0], X_scaled[:, 1], c=labels, cmap='rainbow')
plt.title('Customer Segments')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()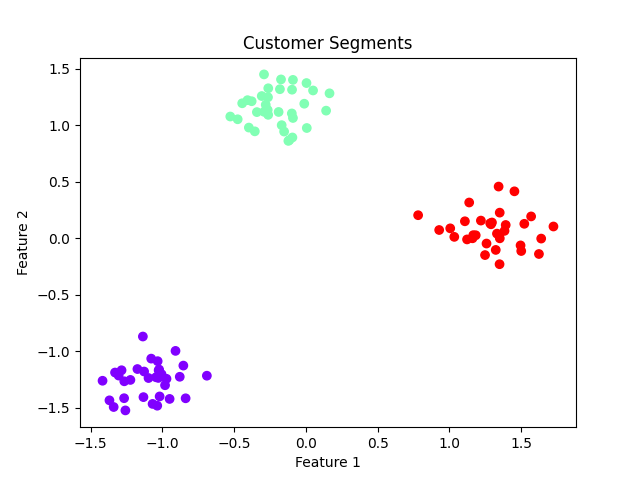
İşletme Etkileri:
Analiziniz için hiyerarşik kümelemeyi seçmenin çeşitli avantajları ve sınırlamaları vardır.
Aşağıda yaygın olan bazılarını görebilirsiniz:
Hiyerarşik kümeleme, özellikle keşifsel veri analizinde ve genomik ile müşteri segmentasyonu gibi alanlarda kullanışlı, çok yönlü ve yorumlanabilir bir kümeleme tekniğidir. Hesaplama maliyetine rağmen, iç içe grupları ortaya çıkarma yeteneği ve dendrogram görselleştirmesi yoluyla sonradan küme sayısını esnek biçimde seçme gücü en önemli avantajlarıdır.
Yorumlanabilirliğin önemli olduğu küçük ve orta ölçekli veri kümeleri için hiyerarşik kümeleme, veri bilimciler ve analistler için başvurulan bir yöntem olmaya devam etmektedir.
Makine öğreniminin ayrıntıları hakkında daha fazla bilgi edinmek ister misiniz? Python ile Makine Öğrenimi Temelleri eğitim yolu ve Python'da Hiyerarşik Kümelemenin Temelleri adlı öğretici, başlamak için harika yerlerdir.
En Popüler DataCamp Kursları
Kurs
Program
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.





