
Corso
Analisi di cluster in Python
4 ore
65.9K
Ti hanno appena affidato l’analisi di un grande dataset e ti viene richiesto di fornire un’analisi approfondita dei cluster. Ti sei imbattuto nel termine “clustering gerarchico”, ma che cos’è esattamente e come funziona?
In questo articolo esploreremo il concetto di clustering gerarchico e forniremo esempi reali per aiutarti a capire meglio le sue applicazioni.
Il clustering gerarchico è un algoritmo di apprendimento non supervisionato usato per raggruppare punti dati simili in cluster. Costruisce una gerarchia multilivello di cluster unendo cluster più piccoli in più grandi (agglomerativo) oppure dividendo un grande cluster in più piccoli (divisivo). Il risultato è una struttura ad albero chiamata dendrogramma.
Un dendrogramma è una rappresentazione visiva che illustra la disposizione dei cluster e le loro relazioni reciproche. L’altezza dei rami in un dendrogramma rappresenta la distanza o dissimilarità a cui i cluster si uniscono. Altezze più basse indicano unioni a distanze minori, quindi maggiore somiglianza.
Il clustering gerarchico è particolarmente utile quando il numero di cluster non è noto a priori. Permette a data analyst e data scientist di esplorare visivamente la struttura dei dati tramite i dendrogrammi.
Questa tecnica è in grado di scoprire cluster annidati ed è ampiamente usata in campi come la genomica, la segmentazione dei clienti e l’organizzazione di documenti.
Per esempio, supponiamo di avere un dataset di acquisti dei clienti. Usando il clustering gerarchico possiamo raggruppare i clienti con pattern di acquisto simili in cluster e identificare potenziali segmenti di mercato per strategie di marketing mirate.
Quando si tratta di compiti di clustering, molti esitano tra due metodi principali: clustering gerarchico o clustering K-means.
Ma cosa li distingue? Vediamo di seguito le differenze per avere un quadro più chiaro.
Confrontando i due, ci sono aspetti in cui il clustering gerarchico spicca.
Ecco alcune aree in cui il clustering gerarchico è valido:
Tuttavia, presenta anche alcuni svantaggi, come:
Potresti chiederti: quando dovrei usare il clustering gerarchico?
Il clustering gerarchico è un’ottima scelta nelle seguenti applicazioni:
All’interno della tecnica del clustering gerarchico puoi aspettarti diversi tipi, ognuno con intuizioni e risultati differenti. I due principali sono l’agglomerativo (dal basso verso l’alto) e il divisivo (dall’alto verso il basso).
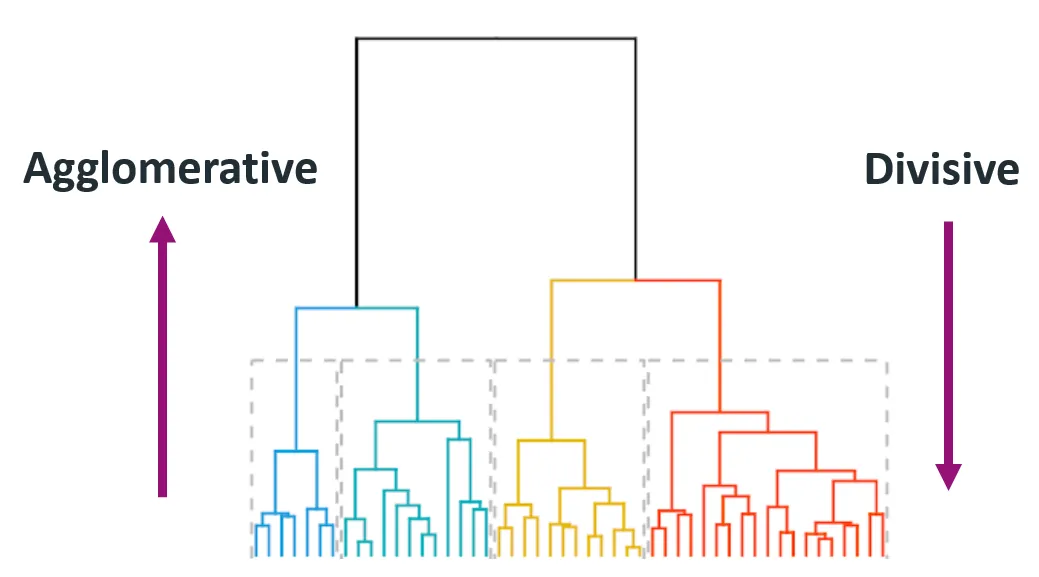
Fonte: Himanshu Sharma su Medium
Il clustering agglomerativo parte trattando ogni punto dati come un cluster individuale e unisce iterativamente la coppia di cluster più vicina finché rimane un solo cluster o finché non si soddisfa una condizione di arresto (come un numero desiderato di cluster).
Questo metodo è detto anche bottom-up perché parte dal basso (i singoli punti) e costruisce verso l’alto (cluster finale).
Guida passo passo:
Questo metodo è ampiamente usato per la sua semplicità e facilità di implementazione.
Ecco un esempio di implementazione in Python:
import numpy as np
from scipy.cluster.hierarchy import linkage, dendrogram, fcluster
import matplotlib.pyplot as plt

# Samples data
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])

# Applies agglomerative clustering using Ward's method
Z = linkage(data, method='ward')

# Plots dendrogram
plt.figure(figsize=(8, 4))
dendrogram(Z)
plt.title('Agglomerative Clustering Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()

# Extracts clusters (e.g., form 2 clusters)
clusters = fcluster(Z, t=2, criterion='maxclust')
print("Cluster assignments:", clusters)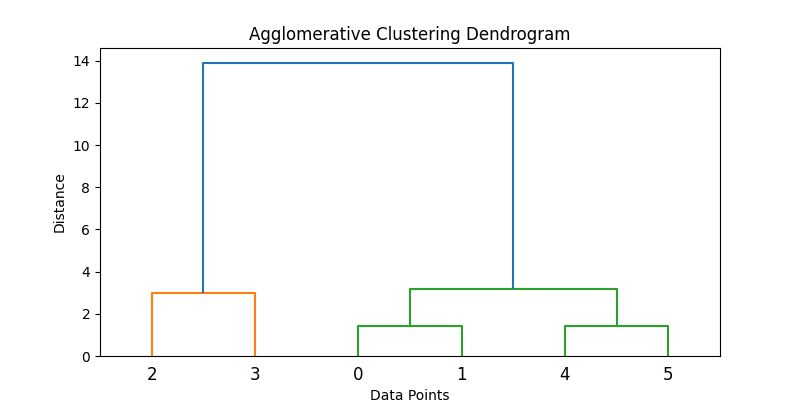
Il clustering divisivo parte con tutti i punti dati in un unico cluster e li suddivide ricorsivamente in cluster più piccoli. Il processo continua finché ogni punto dati non è nel proprio cluster individuale.
È noto anche come approccio top-down, poiché parte dall’alto (un singolo cluster) e lo suddivide in cluster più piccoli.
Guida passo passo:
I metodi divisivi sono in genere più costosi dal punto di vista computazionale per la loro natura ricorsiva e l’accuratezza dipende molto dalla strategia di suddivisione. I metodi agglomerativi sono più comuni per la facilità di implementazione e l’ampio supporto software.
Nota: il clustering gerarchico divisivo non è supportato così facilmente nelle librerie Python standard come quello agglomerativo. Un approccio consiste nell’usare algoritmi di clustering come k-means in modo ricorsivo.
Ecco un’idea di codice per una suddivisione ricorsiva con k-means simulata:
from sklearn.cluster import KMeans

def divisive_clustering(data, depth=2):
    if depth == 0 or len(data) <= 1:
        return [data]

    kmeans = KMeans(n_clusters=2, random_state=42).fit(data)
    labels = kmeans.labels_
    cluster1 = data[labels == 0]
    cluster2 = data[labels == 1]

    return divisive_clustering(cluster1, depth - 1) + divisive_clustering(cluster2, depth - 1)

# Run recursive splitting to simulate divisive clustering
split_clusters = divisive_clustering(data, depth=2)
for i, cluster in enumerate(split_clusters):
    print(f"Cluster {i+1} size: {len(cluster)}")
Questo codice semplificato illustra un approccio concettuale al clustering divisivo usando k-means ricorsivo. Nota, tuttavia, che i metodi divisivi standard come DIANA usano criteri di suddivisione diversi.
Il clustering gerarchico coinvolge alcuni concetti e termini chiave importanti da conoscere. Per comprendere appieno il processo, li approfondiamo qui sotto.
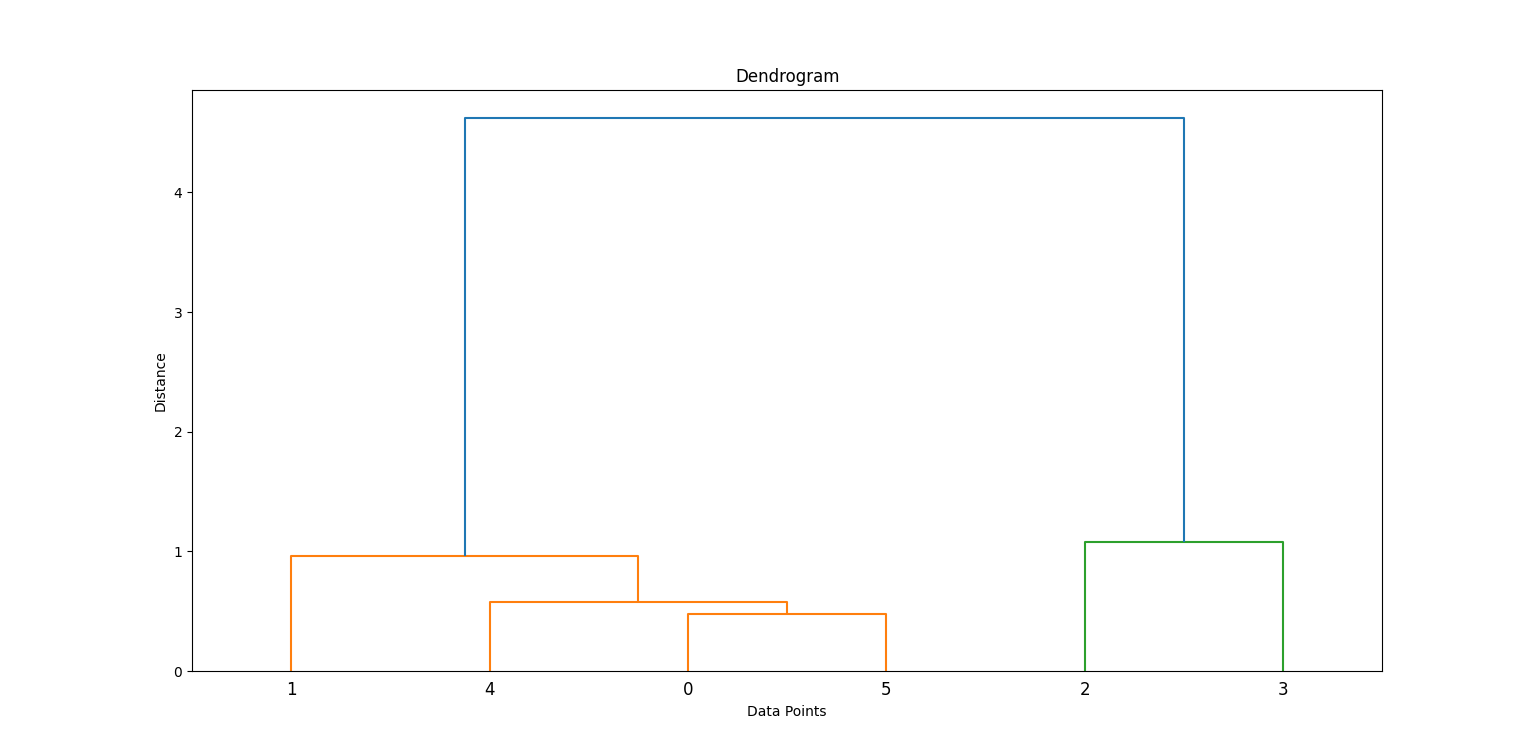
Un dendrogramma è una struttura ad albero che visualizza il processo di clustering gerarchico. Ogni livello dell’albero rappresenta un’operazione di unione o divisione e l’altezza dei rami rappresenta la distanza (o dissimilarità) alla quale i cluster sono stati uniti.
Ecco perché è importante:
I criteri di collegamento determinano come vengono calcolate le distanze tra cluster durante il processo di unione.
Ecco alcuni tipi di criteri di collegamento:
Questo criterio considera la distanza tra i punti più vicini di due cluster. Può produrre cluster allungati, a catena.
from scipy.spatial.distance import pdist, squareform
data = np.array([[1, 2], [2, 3], [5, 8]])
distance_matrix = squareform(pdist(data, metric='euclidean'))
single_linkage_min = np.min(distance_matrix[0, 1:])
print("Single Linkage Distance between Cluster A (point 1) and Cluster B (point 2, 3):", single_linkage_min)Questo criterio considera la distanza tra i punti più lontani di due cluster. Tende a produrre cluster compatti e di dimensioni uniformi.
single_linkage_max = np.max(distance_matrix[0, 1:])
print("Complete Linkage Distance between Cluster A and B:", single_linkage_max)Questo criterio considera la distanza media tra tutti i punti di un cluster e tutti i punti di un altro. Offre un equilibrio tra single e complete linkage.
average_linkage = np.mean(distance_matrix[0, 1:])
print("Average Linkage Distance between Cluster A and B:", average_linkage)
Questi esempi semplificati illustrano come le distanze vengano calcolate inizialmente. Tuttavia, durante il clustering, questi criteri (single, complete, average linkage) applicano le distanze in modo iterativo tra interi cluster, non solo tra singoli punti.
Il metodo di Ward è una variante dell’approccio average linkage che minimizza la somma dei quadrati delle differenze all’interno di tutti i cluster. Tende a produrre cluster più uniformi rispetto ad altri metodi e spesso genera cluster ben separati e sferici.
from scipy.cluster.hierarchy import linkage
linkage_ward = linkage(data, method='ward')
print("Ward's Linkage Matrix:\n", linkage_ward)
Ogni metodo ha i propri punti di forza e va scelto in base ai dati e al caso d’uso.
La metrica di distanza utilizzata influenza in modo significativo il risultato del clustering.
La distanza euclidea è la distanza in linea retta tra due punti nello spazio multidimensionale. È la metrica più comunemente usata, soprattutto per dati distribuiti geometricamente.
Distanza Manhattan, nota anche come distanza a tassista o L1, è la somma delle differenze assolute tra dimensioni. È utile per dati a griglia come isolati cittadini o transazioni finanziarie.
La similarità coseno misura il coseno dell’angolo tra due vettori non nulli. Questa metrica è ideale per dati testuali o quando la magnitudine non conta (ad es., vettori di frequenza delle parole).
In questa sezione vedremo un’implementazione pratica del clustering gerarchico agglomerativo con Python. Copriremo tutto, dal preprocessing dei dati alla visualizzazione dei risultati con un dendrogramma.
Iniziamo importando le librerie necessarie:
import numpy as np
import pandas as pd
from scipy.cluster.hierarchy import dendrogram, linkage, fcluster
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
Ecco cosa abbiamo importato nel codice sopra:
numpy e pandas per la manipolazione dei datiscipy.cluster.hierarchy per il clustering e la generazione del dendrogrammasklearn.preprocessing.StandardScaler per lo scaling delle featurematplotlib per la visualizzazionePrima di iniziare l’analisi, creiamo un dataset di prova di punti 2D e applichiamo lo scaling. Lo scaling è cruciale per gli algoritmi basati sulla distanza.
Ecco come appare il nostro dataset di esempio.
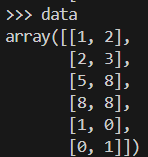
data = np.array([[1, 2], [2, 3], [5, 8], [8, 8], [1, 0], [0, 1]])
scaler = StandardScaler()
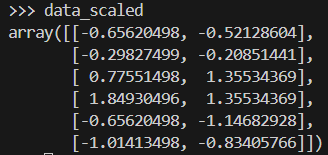
data_scaled = scaler.fit_transform(data)
Ecco com’è l’array di dati dopo lo scaling.
Applichiamo il metodo di Ward per generare una matrice di collegamento, che contiene le informazioni del clustering gerarchico. Quindi tracciamo un dendrogramma.
linkage_matrix = linkage(data_scaled, method='ward')
plt.figure(figsize=(8, 4))
dendrogram(linkage_matrix)
plt.title('Dendrogram')
plt.xlabel('Data Points')
plt.ylabel('Distance')
plt.show()
Nel codice sopra, linkage costruisce la gerarchia di cluster e dendrogram aiuta a visualizzare come si sono formati i cluster.
Osservando dove le linee verticali sono più lunghe prima di un’unione, possiamo decidere dove “tagliare” per formare i cluster. Cerca la linea verticale più alta che non interseca altri cluster. È lì che dovrai fare il taglio.
In questo caso, dovrai tagliare a 2 cluster.
Successivamente, tagliamo il dendrogramma per ottenere un numero specifico di cluster usando fcluster:
clusters = fcluster(linkage_matrix, t=2, criterion='maxclust')
print(clusters)

plt.scatter(data_scaled[:, 0], data_scaled[:, 1], c=clusters, cmap='rainbow')
plt.title('Clusters')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()
Questo assegna ciascun punto dati a uno dei due cluster.
Alcune informazioni aggiuntive sul codice:
t=2: specifica il numero desiderato di cluster.criterion='maxclust': garantisce di ottenere esattamente t cluster.Puoi cambiare t per sperimentare con numeri diversi di cluster.
Il clustering gerarchico è tipicamente usato nella segmentazione dei clienti. Vediamo come appare in un’implementazione pratica.
Simuliamo un dataset che rappresenta clienti con due feature: età e reddito. Useremo make_blobs per generare questi dati sintetici.
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=100, centers=3, n_features=2, random_state=42)Poi standardizziamo le feature per normalizzare le scale e migliorare l’accuratezza del clustering.
scaler = StandardScaler()
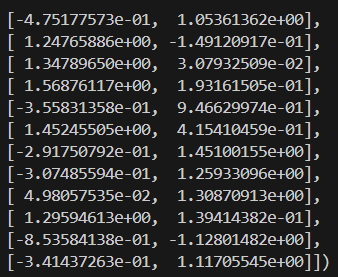
X_scaled = scaler.fit_transform(X)
Ecco come appaiono i dati scalati:
Ora che i dati sono stati elaborati, tracciamo il dendrogramma per visualizzare come si formano i cluster.
linkage_matrix = linkage(X_scaled, method='ward')
plt.figure(figsize=(10, 5))
dendrogram(linkage_matrix)
plt.title('Customer Dendrogram')
plt.xlabel('Sample Index')
plt.ylabel('Distance')
plt.show()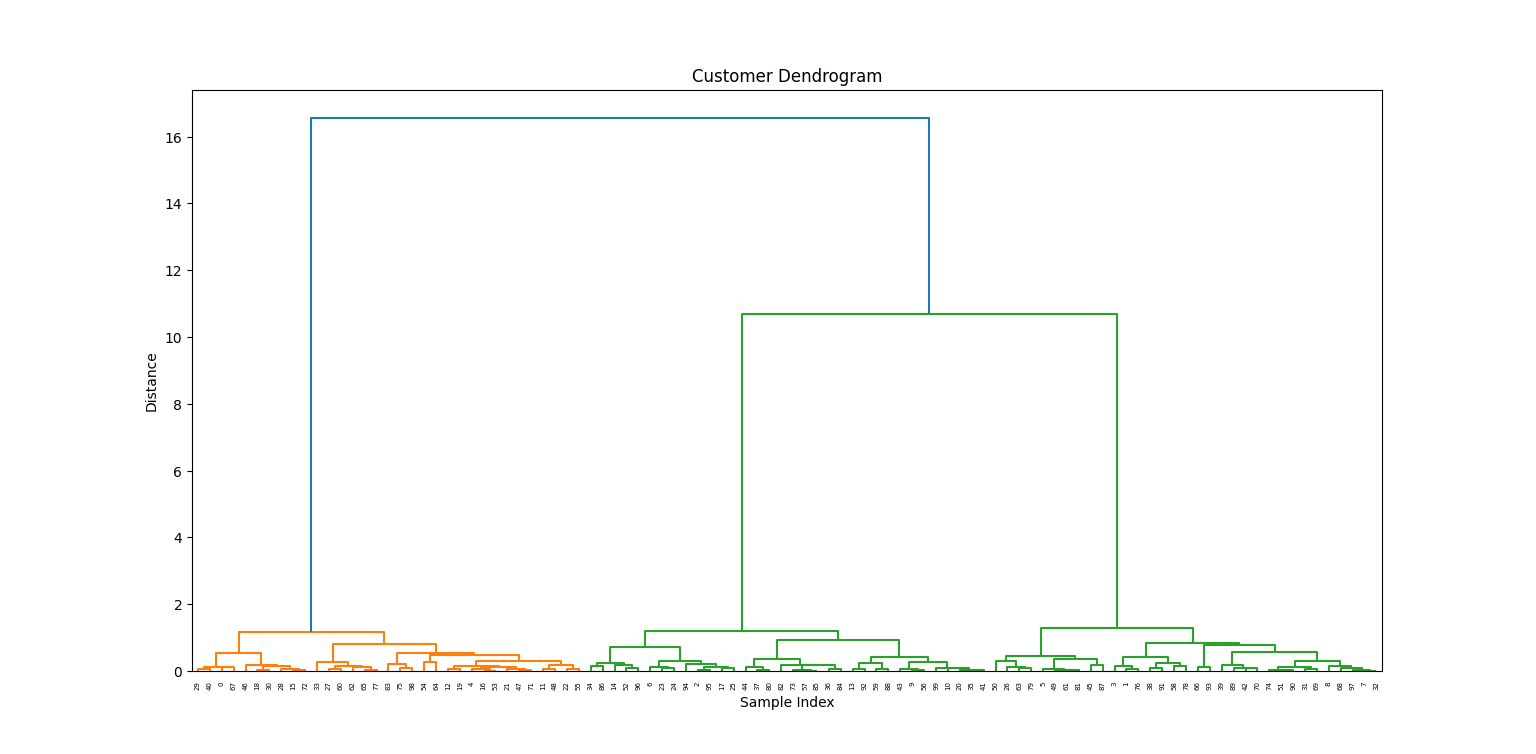
Dal dendrogramma, scegliamo un’altezza a cui “tagliare” e creare tre cluster:
labels = fcluster(linkage_matrix, t=3, criterion='maxclust')
plt.scatter(X_scaled[:, 0], X_scaled[:, 1], c=labels, cmap='rainbow')
plt.title('Customer Segments')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()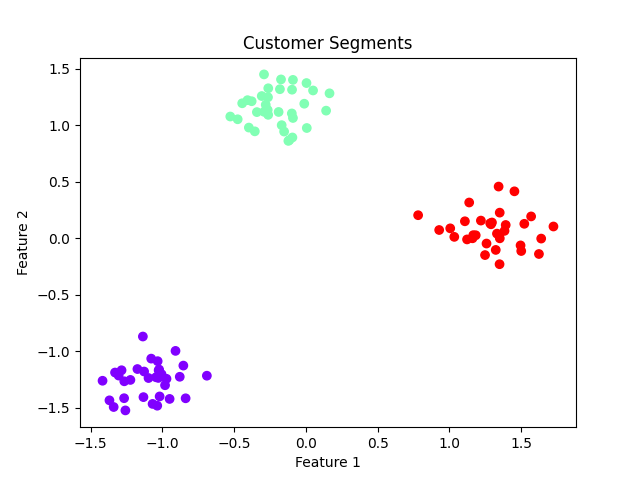
Implicazioni di business:
Scegliere il clustering gerarchico per la tua analisi comporta diversi vantaggi e limitazioni.
Dai un’occhiata qui sotto ad alcune tra le più comuni:
Il clustering gerarchico è una tecnica di clustering versatile e interpretabile, particolarmente utile nell’analisi esplorativa dei dati e in domini come la genomica e la segmentazione dei clienti. Nonostante il costo computazionale, il suo punto di forza è la capacità di scoprire raggruppamenti annidati e la flessibilità nella scelta del numero di cluster a posteriori tramite la visualizzazione del dendrogramma.
Per dataset di piccole e medie dimensioni in cui l’interpretabilità è fondamentale, il clustering gerarchico rimane un metodo di riferimento per data scientist e analyst.
Vuoi approfondire i dettagli del machine learning? Il nostro percorso Fondamenti di Machine Learning in Python e il tutorial Introduzione al clustering gerarchico in Python sono ottimi punti di partenza.
I migliori corsi DataCamp
Corso
Programma
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



