Kursus
Pengantar R
4 jam
3.1M
Dalam tutorial ini, Anda akan berkenalan dengan ekosistem Bioconductor. Dengan ini, Anda akan dapat melakukan analisis komputasional dan statistik pada hasil eksperimen biologis Anda, karena setiap peneliti perlu membuktikan signifikansi dari kesimpulan mereka. Dengan kata lain, Anda akan mampu menunjukkan apakah data yang digunakan konsisten dengan hipotesis Anda menggunakan proyek ini. Selain itu, Anda dapat memvalidasi pertanyaan ilmiah Anda secara statistik tanpa membuang terlalu banyak waktu dan biaya.
Secara singkat, tutorial ini akan membahas:
- Apa itu Bioconductor?
- Apa yang dimaksud dengan Paket R Bioconductor?
- Bagaimana cara menggunakannya?
Bioconductor adalah pengembangan perangkat lunak terbuka untuk biologi komputasional dan bioinformatika. Ini adalah proyek perangkat lunak sumber terbuka dan pengembangan terbuka untuk komunitas biologi komputasional. Disebut sumber terbuka karena siapa pun dapat membaca dan memodifikasi kode dasarnya, dan pengembangan terbuka karena siapa pun dapat berkontribusi dan berpartisipasi dalam pengembangan kode. Bioconductor menggunakan bahasa R yang banyak dipakai di data science karena fleksibel, terutama untuk analisis data. R juga memiliki kemampuan grafis berkualitas tinggi, dan dapat dengan mudah berinteraksi dengan bahasa lain. Bioconductor menyediakan akses ke metode statistik dan grafis yang kuat untuk analisis data genomik. Ia juga memfasilitasi integrasi metadata biologis seperti GenBank, GO, LocusLink, dan PubMed dalam analisis data eksperimental.
Selain itu, Bioconductor memungkinkan pengembangan cepat perangkat lunak yang dapat diperluas, saling beroperasi, dan terukur. Dokumentasi berkualitas tinggi dan riset yang reprodusibel juga dapat dipromosikan menggunakan Bioconductor. Ini mempersiapkan pelatihan dalam metode komputasional dan statistik. Secara ringkas, Bioconductor dapat dipisahkan menjadi tiga bagian berbeda seperti di bawah ini:
| Analisis Statistik | Pemahaman | Berkapasitas tinggi |
|---|---|---|
| Data besar | Konteks biologis | Pengurutan (sequencing) |
| Artefak teknologi | Visualisasi | Mikroarray |
| Eksperimen terdesain | Reprodusibilitas | Sitometri alir |
Analisis dalam biologi komputasional hampir selalu membutuhkan banyak alat berbeda yang harus digabungkan untuk menjawab pertanyaan tertentu. Biasanya, hal itu kemudian menjadi sebuah paket yang juga dapat dipakai peneliti lain. Jadi, Bioconductor juga merupakan repositori perangkat lunak berisi paket R dengan sejumlah aturan dan prinsip panduan. Versi 3.7 memiliki lebih dari 1500 paket. Paket-paket ini digunakan oleh ribuan peneliti di seluruh dunia dan umumnya memiliki dokumentasi yang sangat baik. Karena siapa pun bisa berkontribusi, sering ada beberapa pilihan paket untuk menyelesaikan masalah tertentu, sehingga menciptakan lingkungan yang kompetitif di antara pengembang paket.
Situs web mencakup materi tentang cara memasang, mempelajari, menggunakan, dan berkontribusi kembali pada proyek Bioconductor. Proyek ini dimulai pada musim gugur 2001 dan melibatkan lebih dari 20 pengembang inti di AS, Eropa, dan Australia.
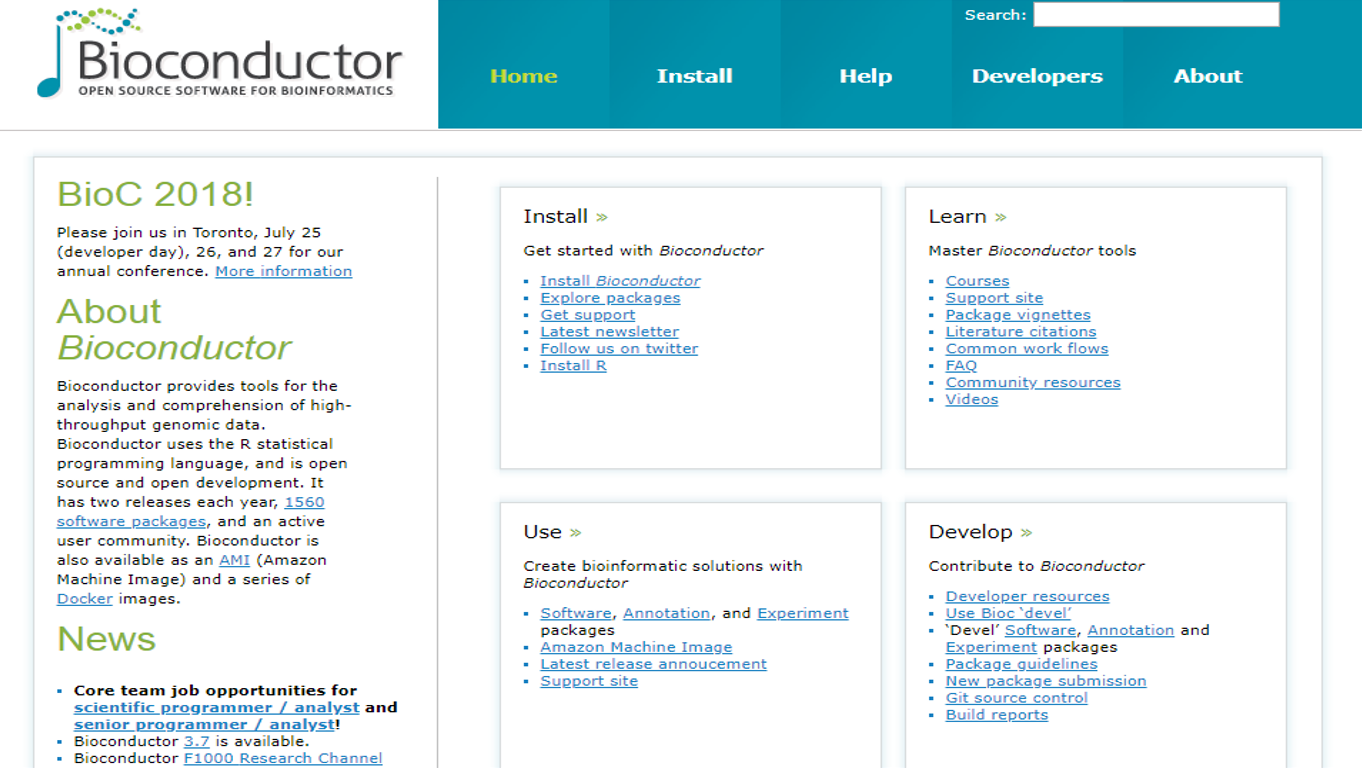
Secara ringkas, Bioconductor berfokus pada analisis statistik dan pemahaman data genomik berkapasitas tinggi. Fokus pada analisis statistik berasal dari sifat datanya. Metode modern menghasilkan volume data yang sangat besar sehingga memerlukan ringkasan statistik. Sebagai peneliti, kita harus melakukan eksperimen yang terfokus dan terdesain dalam kerangka statistik. Teknologi yang menghasilkan tipe data genetik modern dan protokol laboratorium yang digunakan menghasilkan artefak teknologi yang perlu ditangani dengan teknik statistik. Terakhir, tantangan integrasi data yang rumit membuat kita harus mempertimbangkan secara cermat konsekuensi statistik dari setiap langkah yang terlibat.
Perangkat lunak Bioconductor terdiri dari paket tambahan R. Paket R adalah kumpulan terstruktur dari kode (R, C, atau lainnya), dokumentasi, dan/atau data untuk melakukan jenis analisis tertentu, misalnya paket affy, cluster, graph. Paket-paket ini menyediakan implementasi metode statistik dan grafis tertentu.
Dalam rilis terbaru Bioconductor, tersedia lebih dari 1500 paket. Paket-paket tersebut dapat dikategorikan menjadi empat jenis:
• Paket perangkat lunak analisis: Alat untuk menganalisis data genomik berkapasitas tinggi, misalnya IMMAN, limma
• Paket anotasi: Basis data statis berisi peta pengenal, model gen, jalur, dll.; misalnya TxDb.Hsapiens.UCSC.hg19.knownGene
• Paket data eksperimen ilustratif: Kumpulan data yang digunakan untuk mengilustrasikan fungsi perangkat lunak, misalnya airway
• Paket alur kerja: Dokumen yang menjelaskan alur kerja bioinformatika yang melibatkan beberapa paket Bioconductor untuk menjelaskan bidang-bidang spesifik Biologi seperti Proteomik, misalnya highthroughputassays
GenomicRanges: ‘Ranges’ untuk mendeskripsikan data dan anotasi; GRanges(), GRangesList()
Biostrings: DNA dan sekuens lainnya, DNAStringSet()
GenomicAlignments: Bacaan yang terjajar; GAlignemts() dan sejenisnya
GenomicFeatures, AnnotationDbi: sumber daya anotasi, paket TxDb, dan org.
SummarizedExperiment: mengoordinasikan data eksperimental
rtracklayer: impor anotasi Genom seperti BED, WIG, GTF, dll.
Untuk pertama kali menggunakan Bioconductor, kita harus mendapatkan rilis R terbaru lalu memasang versi Bioconductor terbaru dengan menjalankan R dan memasukkan perintah berikut:
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
Dengan perintah ini, semua paket inti dari rilis versi Bioconductor terbaru akan terpasang. Untuk memasang paket spesifik seperti IMMAN dan GenomicRanges yang tersedia di repositori Bioconductor, kita dapat menggunakan instruksi pada halaman paket seperti perintah berikut:
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
Fungsi biocLite() dalam paket BiocInstaller digunakan untuk instalasi paket alih-alih fungsi umum install.packages() di R. Alasannya adalah Bioconductor memiliki repositori terpisah dari CRAN, dan jadwal rilisnya berbeda dari R. Ini dapat menyebabkan ketidaksesuaian antara jadwal rilis R dan Bioconductor. Versi yang diidentifikasi oleh install.packages() sering kali bukan ‘rilis’ terbaru yang tersedia.
Setelah instalasi awal, bagian ini menyediakan contoh sederhana ruang kerja Bioconductor agar Anda lebih familiar dengan konteksnya. Di sini, dua contoh berbeda dari komponen beragam proyek Bioconductor seperti pengurutan berkapasitas tinggi, Analisis Statistik, dan Pemahaman dikumpulkan bersama.
Untuk awalnya, agar mengenal data berkapasitas tinggi, Anda akan bekerja dengan sekuens DNA. Untuk ini, Anda harus menggunakan Biostring, yang merupakan paket utama untuk memanipulasi sekuens biologis berskala besar. Dari situ, Anda dapat menggunakan DNAStringSet() sebagai fungsi untuk menyimpan sekumpulan DNAString (string berbasis alfabet DNA yang menunjuk pada IUPAC Extended Genetic Alphabet). Ini dapat mengubah masukan menjadi objek XStringSet bertipe basa DNA. Huruf-huruf dikodekan dengan cara yang mengoptimalkan algoritma pencarian cepat.
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
Lalu, kita dapat menggunakan fungsi complement() untuk memperoleh komplemen sekuens DNA.
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
Belajar bekerja dengan paket seperti DNAStringSet dan Biostrings akan bermanfaat saat menggunakan paket lainnya.
Pada contoh lain, kita ingin menggunakan paket GenomicRanges yang dikhususkan untuk menunjukkan lokasi genomik dalam proyek Bioconductor. Paket ini menyediakan dasar untuk analisis genomik dengan menghadirkan tiga kelas (GRanges, GPos, dan GRangesList), yang digunakan untuk menampilkan rentang genomik, posisi genomik, dan kelompok rentang genomik.
Kelas GRanges digunakan untuk menggambarkan sekumpulan rentang genomik yang masing-masing memiliki lokasi awal dan akhir pada genom. Kelas ini menyimpan lokasi fitur genomik seperti situs pengikatan kontigu, transkrip, dan ekson. Kita dapat mengakses objek-objek ini menggunakan konstruktor GRanges seperti di bawah:
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
Hasilnya adalah objek GRanges dengan 10 rentang genomik. Seperti terlihat, fungsi ini membagi informasi menjadi bagian kiri dan kanan yang dipisahkan oleh simbol |. Koordinat genom (seqnames, ranges, dan strand) berada di sisi kiri, dan kolom metadata (anotasi) berada di sisi kanan. Pada contoh ini, metadata mencakup informasi skor dan GC. Namun, hampir apa pun dapat disimpan dalam bagian metadata dari objek GRanges.
Fungsi aksesori seqnames(), ranges(), dan strand() digunakan untuk mengekstrak komponen koordinat genom dalam sebuah objek GRanges. Sebagai contoh,
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
Pada contoh terakhir, disajikan contoh sederhana bagian analisis statistik dari proyek. Untuk tujuan ini, dapat dibahas klasifikasi Gene Ontology (GO). GO adalah kumpulan konsep (fungsi molekuler, komponen seluler, dan proses biologis) yang digunakan untuk menjelaskan fungsi gen, serta hubungan antar konsep tersebut. Lebih khusus, GO mengklasifikasikan gen dan produk gen secara hierarkis ke dalam sebuah grafik yang disebut ontologi. Untuk mengakses contoh yang sesuai, tiga paket Bioconductor yaitu clusterProfiler, DOSE dan org.Hs.eg.db dapat digunakan.
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
Paket clusterProfiler adalah seperangkat metode yang ditujukan untuk menganalisis dan memvisualisasikan profil fungsional seperti GO dari gen dan klaster gen. Dengan menggunakannya, Anda akan dapat mengelompokkan berbagai gen berdasarkan kemiripannya. Untuk contoh prosedur ini, himpunan data geneList yang digunakan dalam paket DOSE adalah pilihan yang baik. Himpunan ini berisi kandungan informasi dari ID gen. Di sisi lain, paket org.Hs.eg.db mencakup anotasi seluruh genom dan representasi sekuens materi genetik yang diperkaya dengan informasi terkait posisi genom, untuk manusia.
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
Fungsi enrichGO() melakukan Analisis Pengayaan GO pada sebuah vektor gen. Analisis pengayaan adalah pendekatan untuk membedakan sekelompok gen yang ditetapkan ke kelas kelompok pradefinisi menurut spesifikasi fungsionalnya. Hasil yang diperkaya mungkin mengandung istilah yang sangat umum. Untuk menggunakan fungsi ini, Anda harus mengisi argumen bernama “OrgDb”. Untuk itu, diperlukan paket org.Hs.eg.db yang mencakup anotasi seluruh genom manusia. Paket ini terdiri dari representasi sekuens materi genetik yang diperkaya dengan informasi terkait posisi genom.
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
Untuk memvisualisasikan peta pengayaan, fungsi emapplot() dapat digunakan. Fungsi ini menampilkan himpunan gen sebagai sebuah jaringan. Secara sederhana, himpunan gen yang saling tumpang tindih akan membentuk suatu klaster.
emapplot(ego)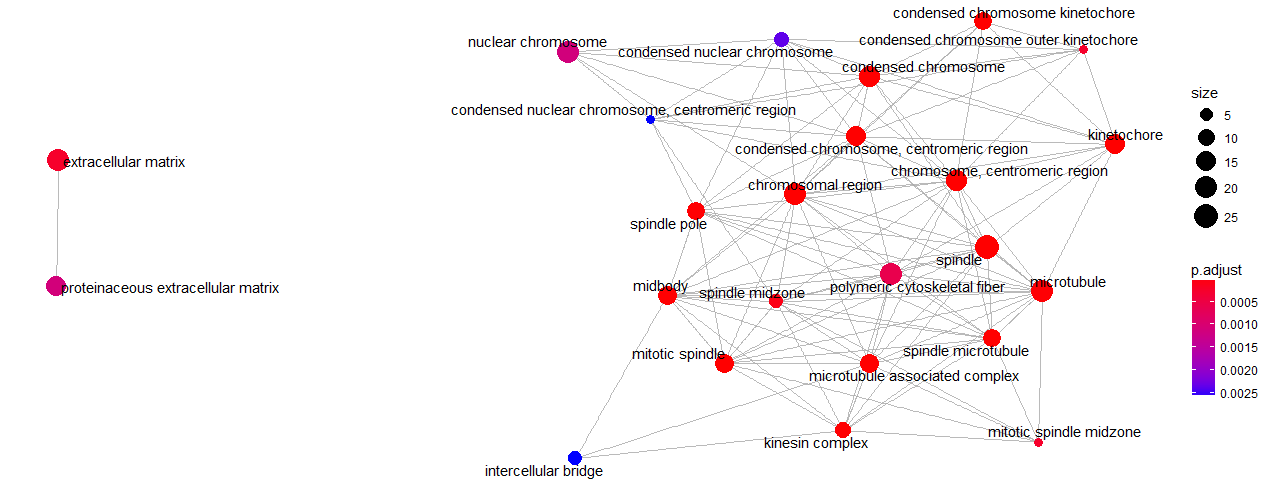
Selama menggunakan paket Bioconductor, jika Anda memerlukan bantuan, Anda dapat menggunakan perintah berikut:
class(dnaSequence) # Indicate the class of the input object

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # List all available methods for a S3 and S4 generic function or class

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Show the help page of the function

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Refers to all available vignettes of the input package
Selain itu, ada banyak halaman bantuan dan alur kerja yang praktis tersedia di situs Bioconductor:
Dengan membaca tutorial ini, Anda menjadi akrab dengan proyek Bioconductor dan peran fundamentalnya dalam penelitian biologis. Selain itu, jenis-jenis paket Bioconductor dan beberapa yang paling penting telah disebutkan. Pada langkah berikutnya, dijelaskan alur singkat cara memasang dan menggunakan proyek ini. Anda mempelajari cara bekerja dengan paket Biostring dan GenomicRanges, dan sebagai hasilnya Anda mengenal sekuens DNA dan rentang genom. Pada contoh lain, Anda mencoba menerapkan analisis pengayaan pada sekumpulan gen manusia. Dengan demikian, Anda mempelajari konsep analisis pengayaan dan GO. Pada bagian berikutnya, diuraikan berbagai cara mendapatkan bantuan saat bekerja dengan Bioconductor. Jika Anda ingin mengetahui lebih lanjut tentang proyek ini, jangan ragu untuk melihat Bioconductor_courses.
Jika Anda ingin mempelajari lebih lanjut tentang R, ikuti kursus Experimental Design in R dari DataCamp.
Kursus R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



