Kurs
R’ye Giriş
4 sa
3.1M
Bu eğitimde Bioconductor ekosistemiyle tanışacaksınız. Böylece, bir araştırmacının çıkarımlarının önemini kanıtlaması gerektiği gibi, biyolojik deneyinizin sonuçları üzerinde hesaplamalı ve istatistiksel analiz yapabileceksiniz. Başka bir deyişle, bu projeyi kullanarak verilerinizin hipotezinizle tutarlı olup olmadığını gösterebileceksiniz. Ayrıca, bilimsel sorunuzu istatistiksel olarak, çok fazla zaman ve para harcamadan doğrulayabilirsiniz.
Kısaca, bu eğitim şu konuları netleştirecek:
- Bioconductor nedir?
- Bioconductor R Paketleri neyi ifade eder?
- Nasıl kullanabiliriz?
Bioconductor, hesaplamalı biyoloji ve biyoinformatik için açık bir yazılım geliştirme girişimidir. Bu, hesaplamalı biyoloji topluluğuna yönelik açık kaynaklı ve açık geliştirme süreçli bir yazılım projesidir. Açık kaynaktır çünkü herkes alttaki kodu okuyup değiştirebilir; açık geliştirmedir çünkü herkes koda katkıda bulunabilir ve geliştirme sürecine katılabilir. Veri bilimi için yaygın olarak kullanılan ve özellikle veri analizi için esnek bir dil olan R dilini kullanır. R ayrıca yüksek kaliteli görselleştirme olanaklarına sahiptir ve diğer dillerle kolayca köprü kurabilir. Bioconductor, genomik verilerin analizi için güçlü istatistiksel ve grafiksel yöntemlere erişim sağlar. Ayrıca GenBank, GO, LocusLink ve PubMed gibi biyolojik üstverilerin deneysel veri analizine entegre edilmesini kolaylaştırır.
Ek olarak, genişletilebilir, birlikte çalışabilir ve ölçeklenebilir yazılımların hızla geliştirilmesine olanak tanır. Bioconductor kullanılarak yüksek kaliteli dokümantasyon ve tekrarlanabilir araştırma da teşvik edilebilir. Bu, hesaplamalı ve istatistiksel yöntemlerde eğitim sağlar. Özetle, Bioconductor aşağıdaki gibi üç farklı kısma ayrılabilir:
| İstatistiksel Analiz | Kavrayış | Yüksek verim |
|---|---|---|
| Büyük veriler | Biyolojik bağlam | Sekanslama |
| Teknolojik yapaylıklar | Görselleştirme | Mikrodiziler |
| Tasarlanmış deneyler | Tekrarlanabilirlik | Akış sitometrisi |
Hesaplamalı biyolojide yapılan analizler, çoğu zaman belirli bir soruyu yanıtlamak için pek çok farklı aracın bir araya getirilmesini gerektirir. Bu da genellikle diğer araştırmacıların da kullanacağı bir pakete dönüşür. Dolayısıyla, Bioconductor aynı zamanda belirli kurallar ve ilkelere sahip bir R paketi deposudur. 3.7 sürümünde 1500’den fazla paket bulunmaktadır. Bu paketler dünya çapında binlerce araştırmacı tarafından kullanılmaktadır. Genellikle mükemmel bir dokümantasyona sahiptirler. Herkes katkıda bulunabildiğinden, belirli bir sorunu çözmek için birden fazla paket seçeneği olabilir. Bu da paket geliştiricileri arasında rekabetçi bir ortam yaratır.
Web sitesi, Bioconductor projelerini nasıl kuracağınız, öğreneceğiniz, kullanacağınız ve katkı sağlayacağınızla ilgili materyaller içerir. Proje 2001 Sonbaharında başlatılmış olup ABD, Avrupa ve Avustralya’da 20’den fazla çekirdek geliştiriciyi kapsamaktadır.
Özetle, Bioconductor yüksek verimli genomik verilerin istatistiksel analizi ve kavranmasına odaklanır. İstatistiksel analize odaklanmanın nedeni verinin doğasıdır. Modern yöntemler, mutlaka istatistiksel bir özet gerektiren çok büyük miktarda veri üretir. Araştırmacılar olarak, istatistiksel bir çerçevede odaklı, tasarlanmış deneyler yürütmeliyiz. Modern genetik veri türlerini üreten teknoloji ve sonrasında uygulanan laboratuvar protokolleri, istatistiksel tekniklerle ele alınması gereken teknolojik yapaylıklar içerir. Son olarak, sıkıştırılmış veri entegrasyonu zorlukları, dâhil olan adımların istatistiksel sonuçlarını dikkatle düşünmemizi gerektirir.
Bioconductor yazılımı, R eklenti paketlerinden oluşur. Bir R paketi, belirli analiz türlerini gerçekleştirmek için (ör. affy, cluster, graph paketleri) kodların (R, C veya diğerleri), dokümantasyonun ve/veya verinin yapılandırılmış bir koleksiyonudur. Belirli istatistiksel ve grafiksel yöntemlerin uygulamalarını sağlar.
Bioconductor’ın en son sürümünde 1500’den fazla paket mevcuttur. Bunlar dört türde sınıflandırılabilir:
• Analiz yazılım paketleri: Yüksek verimli genomik verilerin analizine yönelik araçlar; ör. IMMAN, limma
• Açıklama paketleri: Tanımlayıcı eşlemler, gen modelleri, yolaklar vb. için statik veritabanları; ör. TxDb.Hsapiens.UCSC.hg19.knownGene
• Örnek deney verisi paketleri: Yazılım işlevselliğini göstermek için kullanılan veri kümeleri; ör. airway
• İş akışı paketleri: Biyolojinin belirli alanlarını, örneğin Proteomik gibi, açıklamak için birden fazla Bioconductor paketini içeren bir biyoinformatik iş akışını anlatan belgeler; ör. highthroughputassays
GenomicRanges: Verileri ve açıklamayı betimlemek için ‘Ranges’; GRanges(), GRangesList()
Biostrings: DNA ve diğer diziler, DNAStringSet()
GenomicAlignments: Hizalanmış okumalar; GAlignemts() ve türevleri
GenomicFeatures, AnnotationDbi: açıklama kaynakları, TxDb ve org paketleri.
SummarizedExperiment: deneysel verileri koordine etme
rtracklayer: Genom açıklamalarını içe aktarma; ör. BED, WIG, GTF vb.
Bioconductor’ı ilk kez kullanırken, önce R’ın en son sürümünü edinmeli ve ardından R’ı başlatıp aşağıdaki komutları girerek Bioconductor’ın en son sürümünü kurmalıyız:
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
Bu komutlarla, Bioconductor’ın son sürümündeki tüm çekirdek paketler kurulacaktır. Bioconductor deposunda bulunan IMMAN ve GenomicRanges gibi belirli paketleri kurmak için, paket sayfasındaki yönergeleri ya da aşağıdaki gibi bir komutu kullanabiliriz:
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
BiocInstaller paketindeki biocLite() işlevi, R’deki yaygın install.packages() işlevi yerine paket kurulumu için kullanılır. Bunun nedeni, Bioconductor’ın CRAN’den ayrı bir depoya sahip olması ve sürüm takviminin R’dan farklı olmasıdır. Bu durum R ve Bioconductor sürüm takvimleri arasında uyumsuzluğa yol açabilir. Bu nedenle install.packages()’ın belirlediği sürüm çoğu zaman mevcut en güncel ‘release’ olmayabilir.
İlk kurulumdan sonra, bu bölüm Bioconductor çalışma alanına daha aşina olmanız için basit örnekler sunar. Burada, Yüksek verimli sekanslama, İstatistiksel Analiz ve Kavrayış gibi Bioconductor projesinin farklı bileşenlerinden iki örnek bir araya getirilmiştir.
Başlangıç olarak, yüksek verimli verilerle tanışmak için DNA dizileriyle çalışacaksınız. Bunun için, büyük biyolojik dizileri işlemek üzere temel bir paket olan Biostring kullanmalısınız. Buradan, bir dizi DNAString’i (IUPAC Genişletilmiş Genetik Alfabeti’ni temel alan DNA alfabesine göre bir dize) depolamak için bir işlev olarak DNAStringSet()’i kullanabilirsiniz. Bu, girdiyi DNA baz tipinde bir XStringSet nesnesine dönüştürebilir. Harfler, hızlı arama algoritmalarını optimize edecek şekilde kodlanır.
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
Ardından, DNA dizilerini tamamlayıcısını almak için complement() işlevini kullanabiliriz.
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
DNAStringSet ve Biostrings gibi paketlerle çalışmayı öğrenmek, diğer paketlerde de işe yarar.
Başka bir örnekte, Bioconductor projesi içinde genomik konumları göstermek için özelleşmiş GenomicRanges paketini kullanmak istiyoruz. Bu paket, genomik aralıkları, genomik pozisyonları ve genomik aralık gruplarını göstermek için kullanılan üç sınıf (GRanges, GPos ve GRangesList) sunarak genomik analize bir temel sağlar.
GRanges sınıfı, her birinin gen üzerinde tek bir başlangıç ve bitiş konumuna sahip olduğu bir dizi genomik aralığı göstermek için kullanılır. Bitişik bağlanma bölgeleri, transkriptler ve ekzonlar gibi genomik özelliklerin konumunu depolar. Bu nesnelere aşağıdaki gibi GRanges kurucu işlevini kullanarak erişebiliriz:
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
Sonuç, 10 genomik aralığa sahip bir GRanges nesnesidir. Görüldüğü gibi işlev, bilgiyi | sembolleriyle ayrılan sol ve sağ bölgelere ayırır. Genom koordinatları (seqnames, ranges ve strand) sol tarafta, üstveri sütunları (açıklama) ise sağ tarafta yer alır. Bu örnekte, üstveri skor ve GC bilgisini içerir. Ancak, bir GRanges nesnesinin üstveri kısmında neredeyse her şey saklanabilir.
seqnames(), ranges() ve strand() yardımcı işlevleri, bir GRanges nesnesi içindeki genomik koordinat bileşenlerini indirgemek için kullanılır. Örneğin,
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
Son örnekte, projenin istatistiksel analiz kısmına dair basit bir örnek verilmektedir. Bu amaçla, Gen Ontolojisi (GO) sınıflandırması ele alınabilir. GO; gen işlevini ve bu kavramlar arasındaki ilişkileri açıklamak için kullanılan kavramların (moleküler işlev, hücresel bileşen ve biyolojik süreç) bir derlemesidir. Daha özelde, GO genleri ve gen ürünlerini ontoloji adı verilen bir grafiğe hiyerarşik olarak sınıflandırır. Uygun bir örneğe erişmek için clusterProfiler, DOSE ve org.Hs.eg.db adlı üç Bioconductor paketi kullanılabilir.
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
clusterProfiler paketi, genlerin ve gen kümelerinin GO gibi işlevsel profillerini analiz etmek ve görselleştirmek için belirlenmiş yöntemlerden oluşur. Bunu kullanarak, farklı genleri benzerliklerine göre kümeleyebilirsiniz. Bu işleme örnek vermek için, DOSE paketinde kullanılan geneList veri kümesi iyi bir seçimdir. Bu veri kümesi gen kimliklerinin bilgi içeriğini barındırır. Öte yandan, org.Hs.eg.db paketi İnsan için genom çapında açıklamaları, yani genomik konumla ilgili bilgilerle zenginleştirilmiş genetik materyalin dizi temsillerini içerir.
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
enrichGO() işlevi, verilen bir gen vektörü üzerinde GO Zenginleştirme Analizi yapar. Zenginleştirme analizi, işlevsel özelliklerine göre önceden tanımlanmış sınıflara atanmış gen gruplarını ayırt etmeye yönelik bir yaklaşımdır. Zenginleştirilmiş sonuç çok genel terimler içerebilir. Bu işlevi kullanmak için “OrgDb” adlı bir argümanı doldurmanız gerekir. Bunun için, insan genomu çapında açıklamaları içeren org.Hs.eg.db paketi gereklidir. Bu paket, genomik konumla ilgili bilgilerle zenginleştirilmiş genetik materyalin dizi temsillerinden oluşur.
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
Zenginleştirme haritasını görselleştirmek için emapplot() işlevi kullanılabilir. Bu işlev gen kümelerini bir ağ olarak gösterir. Basitçe ifade etmek gerekirse, karşılıklı olarak örtüşen gen kümeleri birlikte bir küme oluşturur.
emapplot(ego)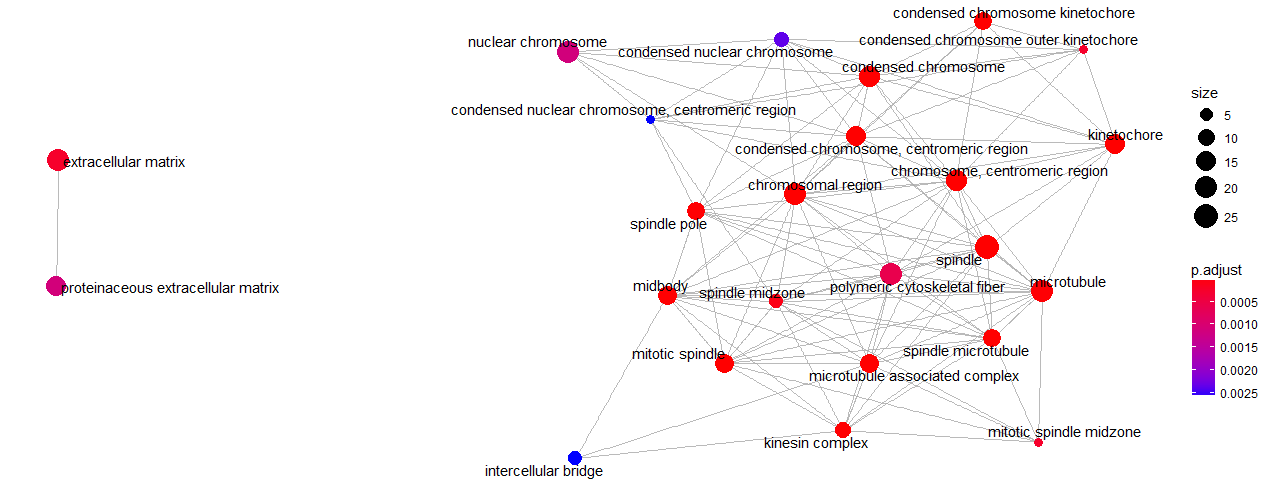
Bioconductor paketlerini kullanırken yardıma ihtiyacınız olursa aşağıdaki komutları kullanabilirsiniz:
class(dnaSequence) # Indicate the class of the input object

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # List all available methods for a S3 and S4 generic function or class

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Show the help page of the function

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Refers to all available vignettes of the input package
Ayrıca, Bioconductor sitelerinde birçok kullanışlı yardım sayfası ve iş akışı mevcuttur:
Bu eğitimi okuyarak Bioconductor projesini ve biyolojik araştırmalardaki temel rolünü öğrendiniz. Ayrıca, Bioconductor paket türleri ve en önemlilerinden bazıları anıldı. Sonraki adımda, projenin nasıl kurulup kullanılacağına dair kısa bir iş akışı açıklandı. Biostring ve GenomicRanges paketleriyle nasıl çalışılacağını öğrendiniz ve bunun sonucunda DNA dizileri ve genom aralıklarına aşina oldunuz. Başka bir örnekte, insan genlerinden oluşan bir küme üzerinde zenginleştirme analizi uygulamayı denediniz. Dolayısıyla, zenginleştirme analizi ve GO kavramlarını öğrendiniz. Son bölümde ise Bioconductor ile çalışırken yardım almanın çeşitli yolları gösterildi. Proje hakkında daha fazla bilgi edinmek isterseniz, Bioconductor_courses sayfasına bakmaktan çekinmeyin.
R hakkında daha fazla bilgi edinmek isterseniz, DataCamp’in R’de Deney Tasarımı kursunu alın.
R Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



