Curso
Introducción a R
4 h
3.1M
En este tutorial te adentrarás en el universo de Bioconductor. Con ello podrás realizar análisis computacionales y estadísticos de los resultados de tu experimento biológico, algo imprescindible para que cualquier investigador demuestre la solidez de sus conclusiones. En otras palabras, con este proyecto podrás comprobar si los datos que utilizas son coherentes con tu hipótesis. Además, podrás validar tu pregunta científica con métodos estadísticos sin malgastar tiempo ni presupuesto.
En resumen, este tutorial aclarará:
- ¿Qué es Bioconductor?
- ¿Qué son los paquetes de R de Bioconductor?
- ¿Cómo podemos utilizarlo?
Bioconductor es un ecosistema de desarrollo de software abierto para biología computacional y bioinformática. Es un proyecto de código abierto y desarrollo abierto para la comunidad de biología computacional: de código abierto porque cualquiera puede leer y modificar el código, y de desarrollo abierto porque cualquiera puede contribuir y participar en su evolución. Utiliza el lenguaje R, muy extendido en ciencia de datos por su flexibilidad para el análisis y sus gráficos de alta calidad, y puede integrarse fácilmente con otros lenguajes. Bioconductor proporciona acceso a potentes métodos estadísticos y gráficos para el análisis de datos genómicos. También facilita la integración, en el análisis de datos experimentales, de metadatos biológicos como GenBank, GO, LocusLink y PubMed.
Además, permite desarrollar software de forma rápida, extensible, interoperable y escalable. Bioconductor también promueve documentación de calidad y la investigación reproducible, y ofrece formación en métodos computacionales y estadísticos. A grandes rasgos, Bioconductor puede dividirse en tres partes:
| Análisis estadístico | Comprensión | Alto rendimiento |
|---|---|---|
| Grandes volúmenes de datos | Contexto biológico | Secuenciación |
| Artefactos técnicos | Visualización | Microarrays |
| Experimentos diseñados | Reproducibilidad | Citometría de flujo |
El análisis en biología computacional casi siempre requiere combinar muchas herramientas distintas para responder a una cuestión concreta. A menudo, el resultado termina siendo un paquete que también pueden usar otros investigadores. Por eso, Bioconductor es además un repositorio de paquetes de R con reglas y principios de calidad. La versión 3.7 cuenta con más de 1500 paquetes usados por miles de investigadores en todo el mundo y, por lo general, con una documentación excelente. Como cualquiera puede contribuir, puede haber múltiples opciones de paquetes para resolver un mismo problema, lo que crea un entorno competitivo y muy dinámico entre desarrolladores.
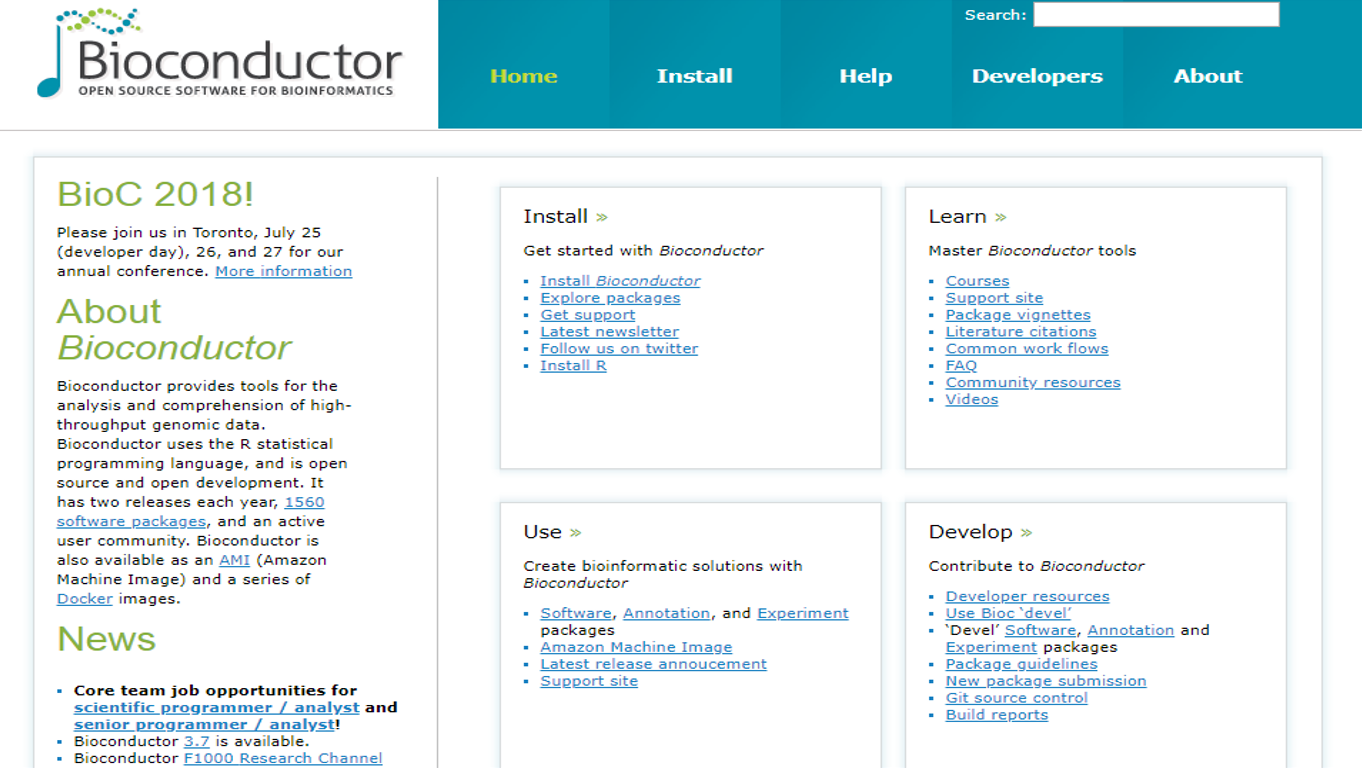
El sitio web incluye material sobre cómo instalar, aprender, usar y contribuir a los proyectos de Bioconductor. El proyecto comenzó en otoño de 2001 y cuenta con más de 20 desarrolladores principales en Estados Unidos, Europa y Australia.
En pocas palabras, Bioconductor se centra en el análisis estadístico y la comprensión de datos genómicos de alto rendimiento. El foco en el análisis estadístico viene dictado por la propia naturaleza de los datos: los métodos modernos generan grandes volúmenes de información que requieren un resumen estadístico. Como investigadores, debemos llevar a cabo experimentos bien diseñados dentro de un marco estadístico. La tecnología que genera los datos genéticos actuales y los protocolos de laboratorio incorporan artefactos técnicos que hay que tratar con técnicas estadísticas. Por último, los retos de integración de datos nos obligan a pensar con cuidado en las consecuencias estadísticas de cada paso del proceso.
El software de Bioconductor se compone de paquetes complementarios de R. Un paquete de R es una colección estructurada de código (R, C u otros), documentación y/o datos para realizar tipos concretos de análisis (por ejemplo, paquetes como affy, cluster o graph). Proporciona implementaciones de métodos estadísticos y gráficos específicos.
En la última versión estable de Bioconductor hay disponibles más de 1500 paquetes, que pueden agruparse en cuatro tipos:
• Paquetes de software de análisis: herramientas para analizar datos genómicos de alto rendimiento, p. ej., IMMAN, limma
• Paquetes de anotación: bases de datos estáticas de mapeos de identificadores, modelos génicos, rutas, etc.; p. ej., TxDb.Hsapiens.UCSC.hg19.knownGene
• Paquetes con datos experimentales ilustrativos: conjuntos de datos para mostrar la funcionalidad del software, p. ej., airway
• Paquetes de flujos de trabajo: documentos que describen un flujo de trabajo bioinformático que integra varios paquetes de Bioconductor para explicar áreas específicas de la biología como la proteómica; p. ej., highthroughputassays
GenomicRanges: "Ranges" para describir datos y anotaciones; GRanges(), GRangesList()
Biostrings: secuencias de ADN y otras, DNAStringSet()
GenomicAlignments: lecturas alineadas; GAlignemts() y funciones relacionadas
GenomicFeatures, AnnotationDbi: recursos de anotación, paquetes TxDb y org.
SummarizedExperiment: coordinación de datos experimentales
rtracklayer: importación de anotaciones del genoma (por ejemplo, BED, WIG, GTF, etc.)
Si vas a usar Bioconductor por primera vez, descarga la última versión de R e instala la versión más reciente de Bioconductor iniciando R y ejecutando estos comandos:
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
Con estos comandos se instalarán todos los paquetes principales de la última versión de Bioconductor. Para instalar paquetes concretos como IMMAN y GenomicRanges, disponibles en el repositorio de Bioconductor, sigue las instrucciones de la página del paquete, por ejemplo:
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
La función biocLite() del paquete BiocInstaller se utiliza para instalar paquetes en lugar de la función habitual install.packages() de R. El motivo es que Bioconductor tiene un repositorio separado de CRAN y un calendario de lanzamientos distinto al de R, lo que puede provocar desajustes entre versiones. Por ello, la versión que identifica install.packages() no suele ser la última versión estable disponible.
Tras la instalación inicial, esta sección te ofrece ejemplos sencillos del entorno de trabajo de Bioconductor para familiarizarte con su contexto. Aquí se reúnen dos ejemplos de distintos componentes del proyecto, como la secuenciación de alto rendimiento, el análisis estadístico y la comprensión de los datos.
Para empezar y conocer los datos de alto rendimiento, vas a trabajar con secuencias de ADN. Para ello, usarás Biostring, un paquete clave para manipular grandes secuencias biológicas. Con él puedes usar la función DNAStringSet() para almacenar un conjunto de DNAString (una cadena basada en el alfabeto de ADN que sigue el alfabeto genético extendido de la IUPAC). Esto transforma la entrada en un objeto XStringSet del tipo base ADN. Las letras se codifican de forma que optimizan los algoritmos de búsqueda rápida.
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
Después, podemos usar la función complement() para obtener el complemento de las secuencias de ADN.
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
Aprender a trabajar con paquetes como DNAStringSet y Biostrings te servirá en muchos otros paquetes.
En otro ejemplo, vamos a utilizar el paquete GenomicRanges, diseñado para indicar posiciones genómicas dentro del proyecto Bioconductor. Proporciona la base para el análisis genómico mediante tres clases (GRanges, GPos y GRangesList) que representan rangos genómicos, posiciones genómicas y grupos de rangos genómicos.
La clase GRanges se emplea para representar un conjunto de rangos genómicos, cada uno con una posición inicial y final en el genoma. Almacena la localización de elementos genómicos como sitios de unión contiguos, transcritos y exones. Podemos crear estos objetos con el constructor GRanges como sigue:
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
El resultado es un objeto GRanges con 10 rangos genómicos. Como se ve, la salida divide la información en dos partes separadas por el símbolo |. A la izquierda se ubican las coordenadas genómicas (seqnames, ranges y strand), y a la derecha las columnas de metadatos (anotación). En este ejemplo, los metadatos incluyen la puntuación y la información de GC, aunque prácticamente cualquier cosa puede almacenarse en la parte de metadatos de un objeto GRanges.
Las funciones accesorias seqnames(), ranges() y strand() se utilizan para extraer los componentes de las coordenadas genómicas dentro de un objeto GRanges. Por ejemplo:
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
Por último, incluimos un ejemplo sencillo de la parte de análisis estadístico del proyecto: la clasificación Gene Ontology (GO). GO es un conjunto de conceptos (función molecular, componente celular y proceso biológico) usados para describir la función génica y las relaciones entre conceptos. Más concretamente, GO clasifica genes y productos génicos de forma jerárquica en un grafo llamado ontología. Para ilustrarlo, emplearemos tres paquetes de Bioconductor: clusterProfiler, DOSE y org.Hs.eg.db.
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
El paquete clusterProfiler ofrece métodos para analizar y visualizar perfiles funcionales, como GO, de genes y clústeres de genes. Con él podrás agrupar genes según sus similitudes. Como ejemplo, el conjunto de datos geneList incluido en el paquete DOSE es una buena opción: contiene información de contenido para identificadores génicos. Por su parte, el paquete org.Hs.eg.db incluye anotación genómica a escala completa para humano, enriquecida con información de posición genómica.
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
La función enrichGO() realiza un análisis de enriquecimiento GO sobre un vector de genes. Este análisis identifica grupos de genes asignados a categorías predefinidas según sus funciones. El resultado enriquecido puede contener términos muy generales. Para usar esta función debes completar el argumento "OrgDb"; para ello se requiere el paquete org.Hs.eg.db con la anotación genómica humana.
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
Para visualizar el mapa de enriquecimiento, puedes usar la función emapplot(). Esta función representa los conjuntos de genes como una red; de forma intuitiva, los conjuntos que comparten muchos genes forman clústeres.
emapplot(ego)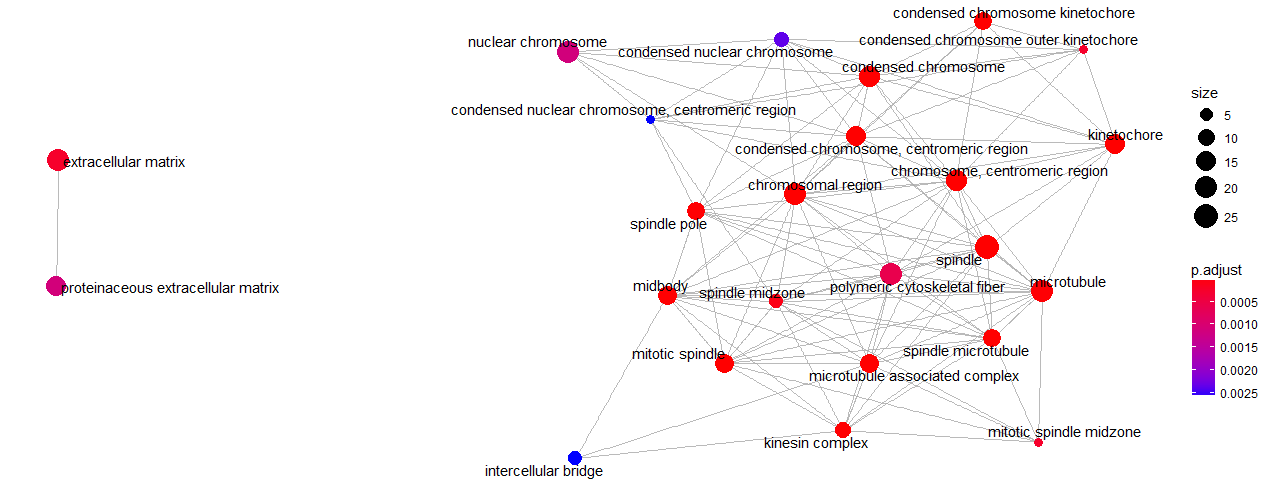
Mientras trabajas con paquetes de Bioconductor, si necesitas ayuda puedes utilizar estos comandos:
class(dnaSequence) # Indica la clase del objeto de entrada

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # Lista todos los métodos disponibles para una función o clase genérica S3 y S4

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Muestra la ayuda de la función

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Muestra todas las viñetas disponibles del paquete indicado
Además, hay muchas páginas de ayuda y flujos de trabajo útiles en los sitios de Bioconductor:
Con este tutorial te has familiarizado con el proyecto Bioconductor y su papel fundamental en la investigación biológica. También hemos visto los tipos de paquetes de Bioconductor y algunos de los más importantes. Después, hemos repasado un flujo de trabajo breve para instalar y usar el proyecto. Has aprendido a trabajar con los paquetes Biostring y GenomicRanges, y, como resultado, te has familiarizado con las secuencias de ADN y los rangos del genoma. En otro ejemplo, aplicaste un análisis de enriquecimiento a un conjunto de genes humanos, con lo que comprendiste los conceptos de análisis de enriquecimiento y GO. Por último, vimos distintas formas de obtener ayuda mientras trabajas con Bioconductor. Si quieres saber más sobre el proyecto, no dudes en visitar Bioconductor_courses.
Si quieres aprender más sobre R, haz el curso Experimental Design in R de DataCamp.
Cursos de R
Curso
Curso
Curso
blog
Elena Kosourova
14 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
DataCamp Team
15 min
Tutorial
Francisco Javier Carrera Arias
6 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Łukasz Deryło
10 min



