Kurs
Einführung in R
4 Std.
3.1M
In diesem Tutorial lernst du das Bioconductor-Ökosystem kennen. Damit kannst du die Ergebnisse deiner biologischen Experimente rechnerisch und statistisch auswerten – ein Muss für alle, die die Aussagekraft ihrer Schlussfolgerungen belegen wollen. Kurz gesagt: Du kannst prüfen, ob deine Daten mit deiner Hypothese vereinbar sind, und deine wissenschaftliche Fragestellung statistisch untermauern, ohne unnötig Zeit und Geld zu verbrauchen.
Im Überblick klärt dieses Tutorial:
- Was ist Bioconductor?
- Wofür stehen die R-Pakete von Bioconductor?
- Wie setzen wir sie praktisch ein?
Bioconductor ist ein offenes Softwareprojekt für Computational Biology und Bioinformatik. Es ist Open Source, weil jeder den Quellcode lesen und ändern kann, und Open Development, weil jede Person zur Weiterentwicklung beitragen kann. Die Plattform basiert auf der Sprache R, die in der Datenwissenschaft weit verbreitet ist – flexibel für Datenanalysen und mit hochwertiger Grafik. Bioconductor bietet leistungsstarke statistische und grafische Methoden zur Analyse von Genomdaten und erleichtert die Einbindung biologischer Metadaten wie GenBank, GO, LocusLink und PubMed in die Auswertung experimenteller Daten.
Zudem ermöglicht es die schnelle Entwicklung erweiterbarer, interoperabler und skalierbarer Software. Auch hochwertige Dokumentation und reproduzierbare Forschung werden durch Bioconductor gefördert. Es bietet Schulungsressourcen zu rechnergestützten und statistischen Methoden. Grob lässt sich Bioconductor in drei Bereiche gliedern:
| Statistische Analyse | Verständnis | Hochdurchsatz |
|---|---|---|
| Große Datenmengen | Biologischer Kontext | Sequenzierung |
| Technologische Artefakte | Visualisierung | Mikroarrays |
| Geplante Experimente | Reproduzierbarkeit | Durchflusszytometrie |
Analysen in der Computational Biology benötigen fast immer eine Kombination vieler Werkzeuge, um konkrete Fragestellungen zu beantworten. Häufig entsteht daraus ein Paket, das auch andere Forschende nutzen. Bioconductor ist daher zugleich ein Software-Repository für R-Pakete mit klaren Regeln und Leitlinien. Version 3.7 umfasst über 1.500 Pakete, die weltweit von Tausenden Forschenden genutzt werden – mit in der Regel exzellenter Dokumentation. Da jeder beitragen kann, gibt es oft mehrere Optionen für ein und dasselbe Problem – was einen gesunden Wettbewerb unter den Paketentwicklern schafft.
Auf der Website findest du alles zur Installation, zum Lernen, zur Nutzung und zum Mitwirken an Bioconductor-Projekten. Das Projekt startete im Herbst 2001 und wird von über 20 Kernentwicklern in den USA, Europa und Australien getragen.
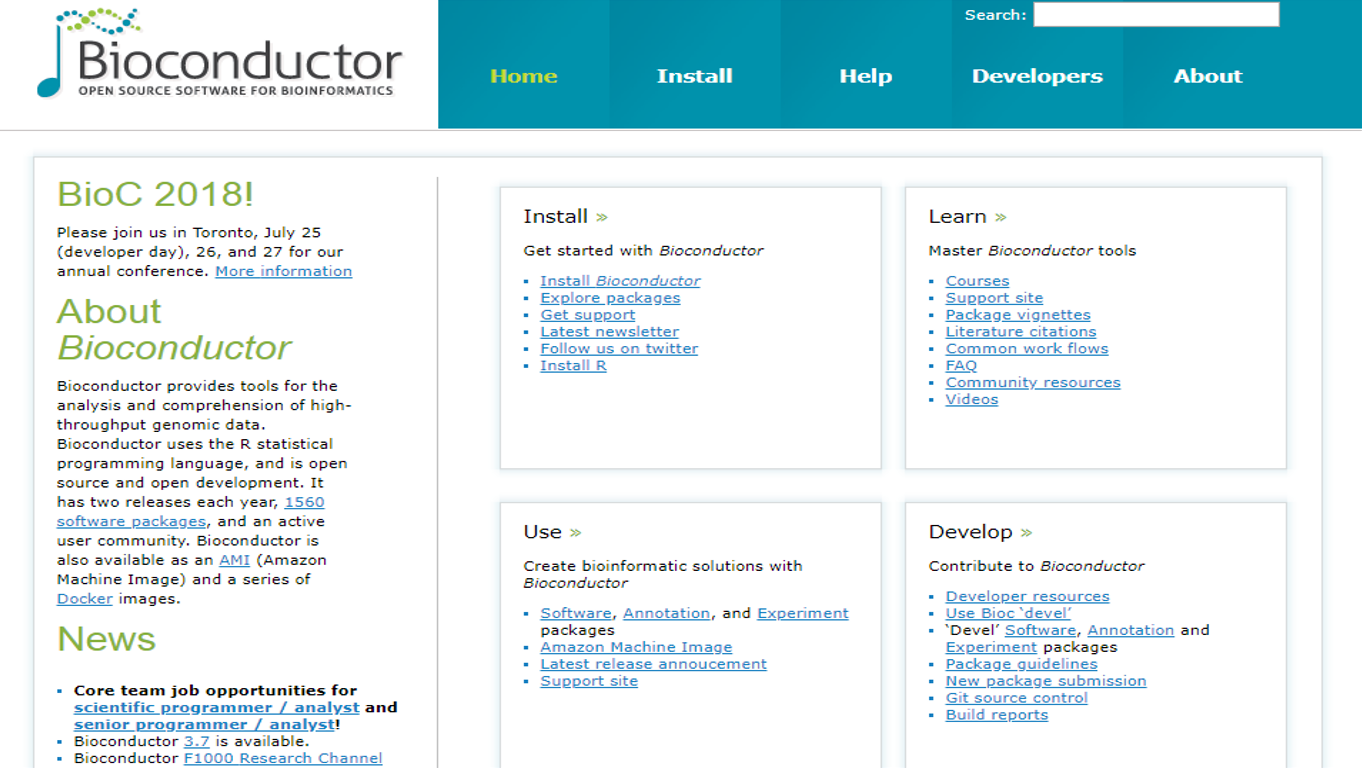
Kurz gesagt: Bioconductor steht für statistische Analyse und Verständnis von Hochdurchsatz-Genomdaten. Der Fokus auf Statistik ergibt sich aus der Natur der Daten: Moderne Methoden erzeugen enorme Datenmengen, die einer statistischen Zusammenfassung bedürfen. Wir müssen Experimente gezielt und im statistischen Rahmen planen. Die Technologien, die moderne genetische Datentypen liefern, und die Laborprotokolle bringen Artefakte mit sich, die statistisch adressiert werden müssen. Schließlich zwingt uns die kompakte Datenintegration dazu, die statistischen Konsequenzen jedes Verarbeitungsschritts genau zu bedenken.
Bioconductor-Software besteht aus R-Erweiterungspaketen. Ein R-Paket ist eine strukturierte Sammlung aus Code (R, C oder andere), Dokumentation und/oder Daten für bestimmte Analysen, z. B. affy-, cluster- oder graph-Pakete. Es liefert Implementierungen spezieller statistischer und grafischer Verfahren.
In der aktuellen Release-Version von Bioconductor stehen über 1.500 Pakete zur Verfügung. Sie lassen sich grob in vier Typen einteilen:
• Analysepakete: Werkzeuge zur Analyse von Hochdurchsatz-Genomdaten, z. B. IMMAN, limma
• Annotation-Pakete: Statische Datenbanken mit Identifier-Mappings, Genmodellen, Signalwegen etc.; z. B. TxDb.Hsapiens.UCSC.hg19.knownGene
• Experimentdaten-Pakete: Datensätze zur Veranschaulichung von Softwarefunktionen, z. B. airway
• Workflow-Pakete: Dokumente, die Bioinformatik-Workflows mit mehreren Bioconductor-Paketen beschreiben, um spezielle Bereiche der Biologie zu erklären, etwa Proteomik, z. B. highthroughputassays
GenomicRanges: „Ranges“ zur Beschreibung von Daten und Annotation; GRanges(), GRangesList()
Biostrings: DNA- und andere Sequenzen, DNAStringSet()
GenomicAlignments: Alignierte Reads; GAlignemts() und verwandte
GenomicFeatures, AnnotationDbi: Annotationsressourcen, TxDb- und org-Pakete.
SummarizedExperiment: Koordination experimenteller Daten
rtracklayer: Import von Genom-Annotationen, z. B. BED, WIG, GTF usw.
Wenn du Bioconductor zum ersten Mal nutzt, installiere zunächst die aktuelle R-Version und anschließend die neueste Version von Bioconductor, indem du R startest und folgende Befehle eingibst:
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
Diese Befehle installieren alle Kernpakete der aktuellen Bioconductor-Release-Version. Um spezielle Pakete wie IMMAN und GenomicRanges aus dem Bioconductor-Repository zu installieren, folge den Anweisungen auf der jeweiligen Paketseite, z. B.:
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
Die Funktion biocLite() aus dem Paket BiocInstaller wird für die Paketinstallation anstelle von install.packages() verwendet. Der Grund: Bioconductor besitzt ein eigenes Repository getrennt von CRAN und einen eigenen Release-Zyklus. Dadurch können R- und Bioconductor-Releases asynchron sein, und die von install.packages() identifizierte Version ist nicht immer die aktuellste verfügbare „Release“.
Nach der Grundinstallation zeigen wir dir hier einfache Beispiele aus dem Bioconductor-Arbeitsumfeld, um den Einstieg zu erleichtern. Zwei Beispiele vereinen unterschiedliche Komponenten des Projekts wie Hochdurchsatz-Sequenzierung, statistische Analyse und Interpretation.
Zum Einstieg in Hochdurchsatzdaten arbeitest du mit DNA-Sequenzen. Dafür nutzt du Biostring, ein zentrales Paket zur Verarbeitung großer biologischer Sequenzen. Mit DNAStringSet() speicherst du eine Menge von DNAStrings (Zeichenketten auf Basis des DNA-Alphabets gemäß dem erweiterten IUPAC-Genetalphabet). Die Eingabe wird in ein XStringSet-Objekt des DNA-Typs umgewandelt. Die Buchstaben sind so codiert, dass schnelle Suchalgorithmen effizient arbeiten.
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
Anschließend kannst du mit der Funktion complement() die komplementären DNA-Sequenzen berechnen.
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
Das Arbeiten mit Paketen wie DNAStringSet und Biostrings zahlt sich auch in anderen Paketen aus.
Im nächsten Beispiel nutzen wir das Paket GenomicRanges zur Darstellung genomischer Positionen innerhalb des Bioconductor-Projekts. Es bildet die Basis für Genomanalysen mit drei Klassen (GRanges, GPos und GRangesList) zur Darstellung genomischer Bereiche, Positionen und Gruppen von Bereichen.
Die Klasse GRanges beschreibt eine Menge genomischer Bereiche mit jeweils einem Start- und Endpunkt im Genom. Sie speichert die Lage genomischer Features wie Bindestellen, Transkripte und Exons. Du erstellst solche Objekte mit dem Konstruktor GRanges wie folgt:
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
Das Ergebnis ist ein GRanges-Objekt mit 10 genomischen Bereichen. Wie zu sehen, trennt die Darstellung Informationen in einen linken und rechten Teil, getrennt durch |. Links stehen die Genomkoordinaten (seqnames, ranges, strand), rechts die Metadaten-Spalten (Annotation). In diesem Beispiel enthalten die Metadaten Score und GC-Informationen. Grundsätzlich lassen sich in den Metadaten nahezu beliebige Informationen speichern.
Mit den Hilfsfunktionen seqnames(), ranges() und strand() greifst du auf die Komponenten der Genomkoordinaten innerhalb eines GRanges-Objekts zu. Zum Beispiel:
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
Zum Abschluss ein einfaches Beispiel für den statistischen Teil des Projekts: die Gene Ontology (GO). GO ist eine Sammlung von Begriffen (molekulare Funktion, zelluläre Komponente, biologischer Prozess) zur Beschreibung von Genfunktionen und ihrer Beziehungen. Konkret ordnet GO Gene und Genprodukte hierarchisch in einem Ontologie-Graphen. Für ein praktisches Beispiel nutzen wir drei Bioconductor-Pakete: clusterProfiler, DOSE und org.Hs.eg.db.
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
Das Paket clusterProfiler bietet Methoden zur Analyse und Visualisierung funktioneller Profile wie GO von Genen und Genclustern. Damit kannst du Gene nach Ähnlichkeiten clustern. Als Beispiel eignet sich der Datensatz geneList aus dem Paket DOSE; er enthält Informationsgehalte zu Gen-IDs. Das Paket org.Hs.eg.db liefert dazu die genomweite Annotation für den Menschen – also Sequenzrepräsentationen mit Positionsinformationen.
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
Die Funktion enrichGO() führt die GO-Enrichment-Analyse auf einem gegebenen Genvektor durch. Enrichment-Analysen identifizieren Gruppen von Genen, die entsprechend ihrer Funktion vordefinierten Klassen zugeordnet sind. Die Ergebnisse können sehr allgemeine Begriffe enthalten. Für die Nutzung musst du das Argument „OrgDb“ setzen – hier kommt org.Hs.eg.db mit der menschlichen Genomannotation ins Spiel.
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
Zur Visualisierung als Enrichment Map nutzt du emapplot(). Diese Funktion stellt Gensets als Netzwerk dar. Vereinfacht gesagt: Sich überlappende Gensets bilden Cluster.
emapplot(ego)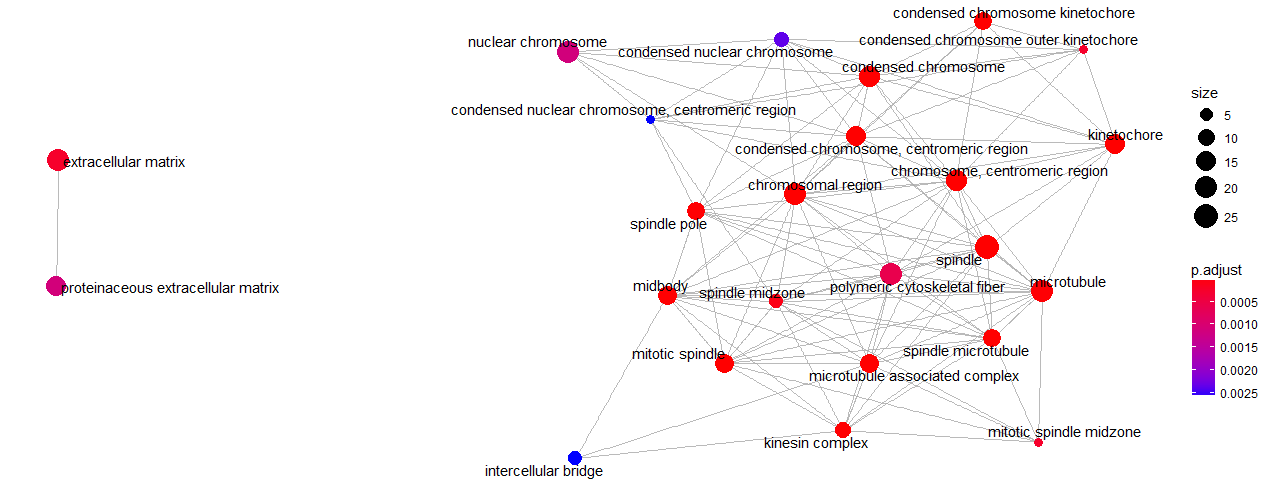
Wenn du während der Arbeit mit Bioconductor-Paketen Unterstützung brauchst, helfen dir diese Befehle:
class(dnaSequence) # Klasse des Eingabeobjekts anzeigen

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # Alle verfügbaren Methoden für eine S3-/S4-Generik oder Klasse auflisten

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Hilfeseite der Funktion anzeigen

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Zeigt alle verfügbaren Vignetten des Pakets an
Darüber hinaus findest du viele hilfreiche Seiten und Workflows auf den Bioconductor-Websites:
Mit diesem Tutorial hast du das Bioconductor-Projekt und seine grundlegende Rolle in der biologischen Forschung kennengelernt. Du weißt, welche Typen von Bioconductor-Paketen es gibt und welche besonders wichtig sind. Anschließend hast du einen kompakten Workflow zur Installation und Nutzung gesehen. Du hast mit den Paketen Biostring und GenomicRanges gearbeitet und damit DNA-Sequenzen und Genombereiche kennengelernt. In einem weiteren Beispiel hast du eine Enrichment-Analyse an menschlichen Genen durchgeführt und damit die Konzepte von Enrichment-Analyse und GO verstanden. Zum Schluss hast du verschiedene Wege gesehen, wie du bei der Arbeit mit Bioconductor Hilfe findest. Wenn du tiefer einsteigen willst, wirf einen Blick auf Bioconductor_courses.
Wenn du mehr über R lernen möchtest, schau dir den DataCamp-Kurs Experimental Design in R an.
R-Kurse
Kurs
Kurs
Kurs