Cours
Introduction à R
4 h
3.1M
Dans ce tutoriel, vous allez découvrir l’univers de Bioconductor. Vous serez ainsi en mesure d’effectuer des analyses informatiques et statistiques sur les résultats de vos expériences biologiques, étape indispensable pour démontrer la solidité de vos conclusions. En d’autres termes, vous pourrez vérifier si vos données sont cohérentes avec votre hypothèse à l’aide de ce projet. Vous pourrez aussi valider votre question scientifique de façon statistique, sans y consacrer trop de temps ni de budget.
En bref, ce tutoriel clarifiera :
- Qu’est-ce que Bioconductor ?
- Que recouvrent les packages R Bioconductor ?
- Comment l’utiliser concrètement ?
Bioconductor est un écosystème logiciel ouvert dédié à la biologie computationnelle et à la bioinformatique. Il s’agit d’un projet open source et en développement ouvert pour la communauté de la biologie computationnelle : open source, car chacun peut lire et modifier le code, et en développement ouvert, car chacun peut contribuer et participer à son évolution. Il s’appuie sur le langage R, largement utilisé en data science pour sa flexibilité, notamment en analyse de données. R offre également des capacités graphiques de haute qualité et s’interface facilement avec d’autres langages. Bioconductor donne accès à de puissantes méthodes statistiques et graphiques pour l’analyse de données génomiques. Il facilite aussi l’intégration de métadonnées biologiques comme GenBank, GO, LocusLink et PubMed dans l’analyse de données expérimentales.
Par ailleurs, il permet de développer rapidement des logiciels extensibles, interopérables et évolutifs. Bioconductor favorise également une documentation de qualité et la recherche reproductible, et constitue un support de formation aux méthodes statistiques et informatiques. En résumé, Bioconductor se décline en trois volets complémentaires :
| Analyse statistique | Compréhension | Haut débit |
|---|---|---|
| Grandes volumétries | Contexte biologique | Séquençage |
| Artéfacts technologiques | Visualisation | Micropuces |
| Expériences planifiées | Reproductibilité | Cytométrie en flux |
En biologie computationnelle, répondre à une question précise nécessite presque toujours d’assembler de nombreux outils. Cela conduit souvent à créer un package réutilisable par d’autres chercheurs. Bioconductor est ainsi aussi un dépôt de packages R avec des règles et des principes directeurs. La version 3.7 compte plus de 1 500 packages, utilisés par des milliers de chercheurs dans le monde, et généralement très bien documentés. Comme chacun peut contribuer, plusieurs packages peuvent coexister pour résoudre un même problème, ce qui stimule une saine émulation entre développeurs.
Le site web propose tout le nécessaire pour installer, apprendre, utiliser et contribuer aux projets Bioconductor. Lancé à l’automne 2001, le projet réunit plus de 20 développeurs principaux aux États‑Unis, en Europe et en Australie.
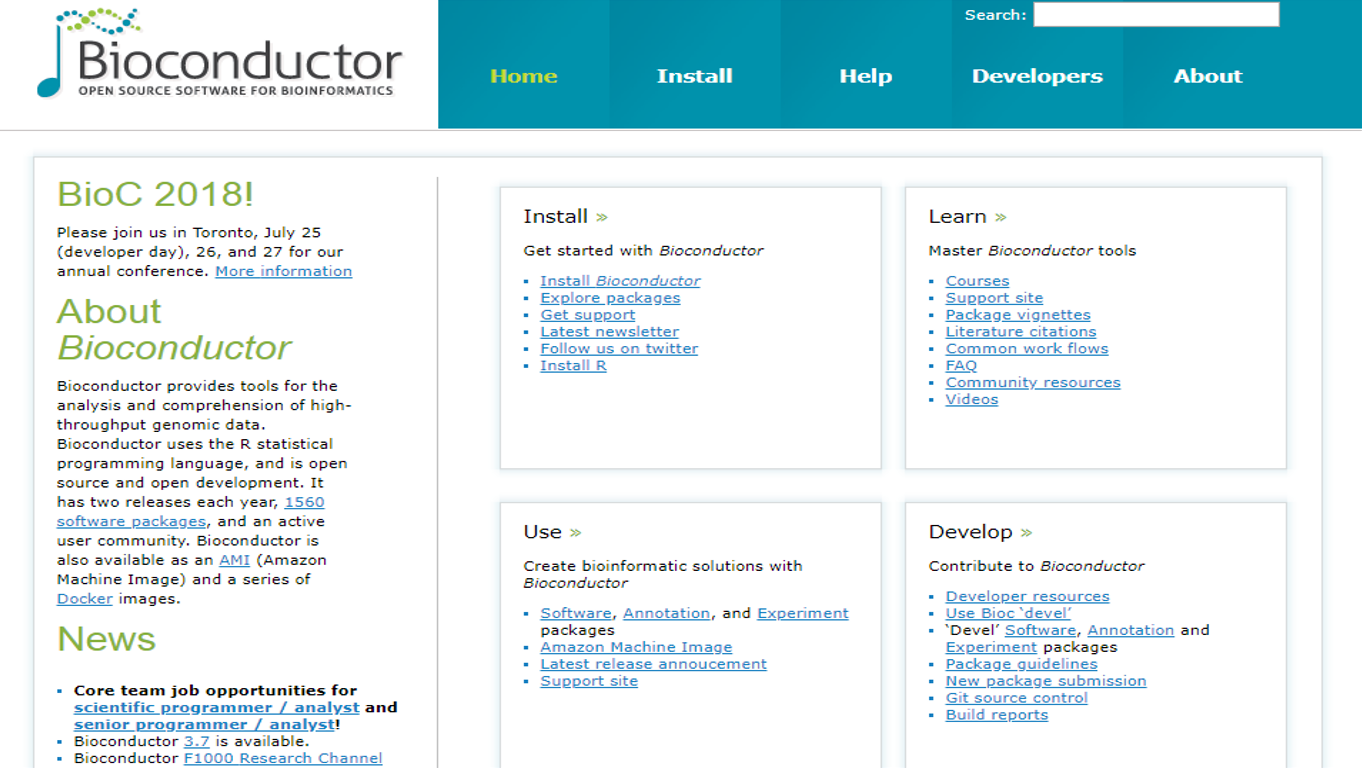
En résumé, Bioconductor se concentre sur l’analyse statistique et la compréhension des données génomiques à haut débit. L’accent mis sur l’analyse statistique découle de la nature même des données : les méthodes modernes génèrent des volumes massifs qui exigent des synthèses statistiques. En tant que chercheurs, nous devons mener des expériences ciblées et conçues dans un cadre statistique. La technologie qui produit les données génétiques modernes et les protocoles de laboratoire employés induisent des artéfacts qu’il faut traiter avec des techniques statistiques. Enfin, les enjeux d’intégration de données hétérogènes nous obligent à considérer attentivement les conséquences statistiques de chaque étape.
Le logiciel Bioconductor est constitué de packages additionnels pour R. Un package R est un ensemble structuré de code (R, C, ou autre), de documentation et/ou de données pour réaliser des analyses spécifiques (par ex. : affy, cluster, graph). Il fournit des implémentations de méthodes statistiques et graphiques dédiées.
Dans la dernière version de Bioconductor, plus de 1 500 packages sont disponibles. On peut les regrouper en quatre catégories :
• Packages d’analyse : outils pour analyser des données génomiques à haut débit, par ex. : IMMAN, limma
• Packages d’annotation : bases statiques de correspondances d’identifiants, modèles de gènes, voies métaboliques, etc. ; par ex. : TxDb.Hsapiens.UCSC.hg19.knownGene
• Packages de données d’expériences illustratives : jeux de données servant à démontrer les fonctionnalités logicielles, par ex. : airway
• Packages de workflows : documents décrivant un enchaînement bioinformatique impliquant plusieurs packages Bioconductor pour éclairer des domaines précis de la biologie (comme la protéomique), par ex. : highthroughputassays
GenomicRanges : des « Ranges » pour décrire données et annotations ; GRanges(), GRangesList()
Biostrings : séquences ADN et autres, DNAStringSet()
GenomicAlignments : lectures alignées ; GAlignemts() et apparentés
GenomicFeatures, AnnotationDbi : ressources d’annotation, packages TxDb et org.
SummarizedExperiment : organisation des données expérimentales
rtracklayer : import d’annotations génomiques (BED, WIG, GTF, etc.).
Pour une première utilisation de Bioconductor, installez la dernière version de R puis la dernière version de Bioconductor en démarrant R et en saisissant les commandes suivantes :
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
Ces commandes installent tous les packages cœur de la dernière version de Bioconductor. Pour installer des packages spécifiques comme IMMAN et GenomicRanges disponibles dans le dépôt Bioconductor, suivez les instructions de la page du package, par exemple :
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
La fonction biocLite() du package BiocInstaller est utilisée pour l’installation des packages à la place de la fonction standard install.packages() de R. En effet, Bioconductor possède un dépôt distinct de CRAN et un calendrier de publication différent de celui de R, ce qui peut entraîner des décalages. La version identifiée par install.packages() n’est donc pas toujours la plus récente « release » disponible.
Après l’installation initiale, cette section vous propose quelques exemples simples pour vous familiariser avec l’environnement Bioconductor. Deux illustrations de composantes variées du projet (séquençage à haut débit, analyse statistique et compréhension) sont réunies ici.
Pour commencer, afin de vous familiariser avec les données à haut débit, vous allez manipuler des séquences d’ADN. Pour cela, utilisez Biostrings, package de référence pour manipuler de grandes séquences biologiques. Vous pouvez notamment recourir à DNAStringSet() pour stocker un ensemble de DNAString (chaînes basées sur l’alphabet ADN selon l’alphabet génétique étendu IUPAC). Cette fonction convertit l’entrée en un objet XStringSet de type ADN. Les lettres sont encodées pour optimiser les algorithmes de recherche rapide.
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
Vous pouvez ensuite utiliser la fonction complement() pour calculer le complément des séquences d’ADN.
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
Apprendre à utiliser des packages comme DNAStringSet et Biostrings vous servira dans bien d’autres packages.
Dans un autre exemple, utilisons le package GenomicRanges, dédié à la représentation des positions génomiques dans le cadre de Bioconductor. Il constitue une base pour l’analyse génomique au travers de trois classes (GRanges, GPos et GRangesList) représentant respectivement des intervalles génomiques, des positions génomiques et des groupes d’intervalles.
La classe GRanges sert à décrire un ensemble d’intervalles génomiques, chacun ayant un début et une fin sur le génome. Elle stocke l’emplacement de caractéristiques génomiques telles que sites de liaison contigus, transcrits et exons. On crée ces objets avec le constructeur GRanges comme suit :
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
Le résultat est un objet GRanges contenant 10 intervalles génomiques. Comme on le voit, l’affichage sépare les informations en une zone gauche et droite, séparées par le symbole |. Les coordonnées génomiques (seqnames, ranges et strand) se trouvent à gauche, les colonnes de métadonnées (annotations) à droite. Ici, les métadonnées incluent un score et la teneur en GC. Toutefois, on peut stocker à peu près tout type d’information dans la partie métadonnées d’un objet GRanges.
Les fonctions d’accès seqnames(), ranges() et strand() permettent d’extraire les composants des coordonnées génomiques d’un objet GRanges. Par exemple :
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
Dernier exemple : un aperçu de la partie « analyse statistique » du projet avec la classification Gene Ontology (GO). GO est un ensemble de concepts (fonction moléculaire, composant cellulaire, processus biologique) décrivant la fonction des gènes et les relations entre ces concepts. Plus précisément, GO classe gènes et produits géniques de façon hiérarchique dans un graphe appelé ontologie. Pour illustrer cela, trois packages Bioconductor peuvent être utilisés : clusterProfiler, DOSE et org.Hs.eg.db.
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
Le package clusterProfiler regroupe des méthodes pour analyser et visualiser des profils fonctionnels (comme GO) de gènes et de clusters de gènes. Il permet, par exemple, de regrouper des gènes selon leurs similarités. Pour illustrer la démarche, l’ensemble de données geneList utilisé dans le package DOSE est un bon point de départ : il contient des informations de contenu pour des identifiants de gènes. De son côté, le package org.Hs.eg.db fournit des annotations à l’échelle du génome humain, c’est‑à‑dire une représentation des séquences enrichie d’informations de positionnement génomique.
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
La fonction enrichGO() réalise une analyse d’enrichissement GO sur un vecteur de gènes. L’analyse d’enrichissement vise à identifier des groupes de gènes associés à des catégories prédéfinies en fonction de leurs caractéristiques fonctionnelles. Les résultats peuvent inclure des termes très généraux. Pour utiliser cette fonction, vous devez renseigner l’argument « OrgDb ». Pour cela, le package org.Hs.eg.db (annotation du génome humain) est requis. Ce package fournit une représentation des séquences enrichie d’informations de position génomique.
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
Pour visualiser la carte d’enrichissement, utilisez la fonction emapplot(). Elle représente les ensembles de gènes sous forme de réseau. En simplifiant, des ensembles de gènes qui se recoupent forment des clusters.
emapplot(ego)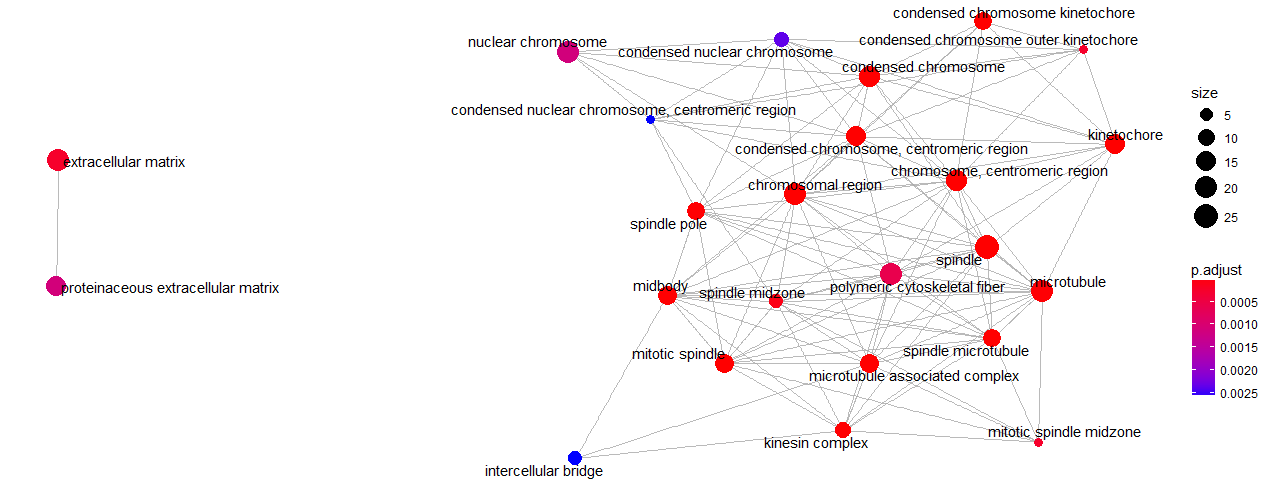
Lors de l’utilisation des packages Bioconductor, si vous avez besoin d’aide, vous pouvez recourir aux commandes suivantes :
class(dnaSequence) # Indique la classe de l'objet en entrée

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # Liste toutes les méthodes disponibles pour une fonction ou classe générique S3/S4

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Affiche la page d'aide de la fonction

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Liste toutes les vignettes disponibles du package
En complément, de nombreuses pages d’aide et workflows sont disponibles sur les sites Bioconductor :
En lisant ce tutoriel, vous avez découvert le projet Bioconductor et son rôle clé dans la recherche en biologie. Nous avons passé en revue les différents types de packages Bioconductor et certains des plus importants. Vous avez ensuite vu comment installer et utiliser le projet. Vous avez appris à travailler avec les packages Biostrings et GenomicRanges, et vous vous êtes ainsi familiarisé avec les séquences d’ADN et les intervalles génomiques. Dans un autre exemple, vous avez appliqué une analyse d’enrichissement à un ensemble de gènes humains, ce qui vous a permis de comprendre les principes de l’analyse d’enrichissement et de GO. Enfin, nous avons recensé différentes façons d’obtenir de l’aide lors de l’utilisation de Bioconductor. Pour aller plus loin, n’hésitez pas à consulter Bioconductor_courses.
Si vous souhaitez approfondir R, suivez le cours Experimental Design in R de DataCamp.
Cours R
Cours
Cours
Cours