Khóa học
Nhập môn Ngôn ngữ lập trình R
4 giờ
3.1M
Trong hướng dẫn này, bạn sẽ làm quen với hệ sinh thái Bioconductor. Nhờ đó, bạn có thể thực hiện phân tích tính toán và thống kê trên kết quả thí nghiệm sinh học của mình, vốn là điều cần thiết để bất kỳ nhà nghiên cứu nào chứng minh ý nghĩa của kết luận. Nói cách khác, bạn sẽ có khả năng chứng minh dữ liệu được sử dụng có phù hợp với giả thuyết của bạn hay không bằng cách sử dụng dự án này. Ngoài ra, bạn có thể kiểm định câu hỏi khoa học một cách thống kê mà không tốn quá nhiều thời gian và tiền bạc.
Tóm lược, hướng dẫn này sẽ làm rõ:
- Bioconductor là gì?
- Các gói R của Bioconductor có ý nghĩa gì?
- Chúng ta có thể sử dụng nó như thế nào?
Bioconductor là một nền tảng phát triển phần mềm mở dành cho sinh học tính toán và tin sinh học. Đây là một dự án phần mềm mã nguồn mở, phát triển mở cho cộng đồng sinh học tính toán. "Mã nguồn mở" vì bất kỳ ai cũng có thể đọc và sửa đổi mã nguồn, và "phát triển mở" vì bất kỳ ai cũng có thể đóng góp và tham gia phát triển mã. Nó sử dụng ngôn ngữ R, một ngôn ngữ được dùng rộng rãi cho khoa học dữ liệu nhờ tính linh hoạt, đặc biệt trong phân tích dữ liệu. R cũng có khả năng đồ họa chất lượng cao, và có thể dễ dàng là một công cụ trung gian cho các ngôn ngữ khác. Bioconductor cung cấp quyền truy cập vào các phương pháp thống kê và đồ họa mạnh mẽ cho việc phân tích dữ liệu hệ gen. Nó cũng hỗ trợ tích hợp siêu dữ liệu sinh học như GenBank, GO, LocusLink và PubMed vào phân tích dữ liệu thực nghiệm.
Bên cạnh đó, nó cho phép phát triển nhanh các phần mềm có thể mở rộng, tương tác và co giãn. Ngoài ra, có thể thúc đẩy tài liệu chất lượng cao và nghiên cứu có thể tái lập bằng cách sử dụng Bioconductor. Dự án này cũng chuẩn bị đào tạo về các phương pháp tính toán và thống kê. Tóm lại, Bioconductor có thể được chia thành ba phần như bên dưới:
| Phân tích thống kê | Diễn giải | Băng thông cao |
|---|---|---|
| Dữ liệu lớn | Ngữ cảnh sinh học | Giải trình tự |
| Tạo tác công nghệ | Trực quan hóa | Vi mảng |
| Thí nghiệm thiết kế | Tái lập | Dòng chảy tế bào |
Phân tích trong sinh học tính toán gần như luôn cần nhiều công cụ khác nhau phối hợp với nhau để trả lời một câu hỏi cụ thể. Thông thường, kết quả sẽ trở thành một gói để các nhà nghiên cứu khác cũng có thể sử dụng. Vì vậy, Bioconductor đồng thời là một kho phần mềm các gói R với một số quy tắc và nguyên tắc chỉ đạo. Phiên bản 3.7 có hơn 1500 gói. Chúng được hàng nghìn nhà nghiên cứu trên khắp thế giới sử dụng. Các gói này thường có tài liệu xuất sắc. Vì mọi người đều có thể đóng góp, có thể có nhiều lựa chọn gói để giải quyết một vấn đề cụ thể, tạo ra môi trường cạnh tranh giữa các nhà phát triển gói.
Trang web cung cấp tài liệu về cách cài đặt, học tập, sử dụng và đóng góp trở lại cho các dự án Bioconductor. Dự án bắt đầu vào mùa Thu năm 2001 và có hơn 20 nhà phát triển nòng cốt ở Mỹ, Châu Âu và Úc.
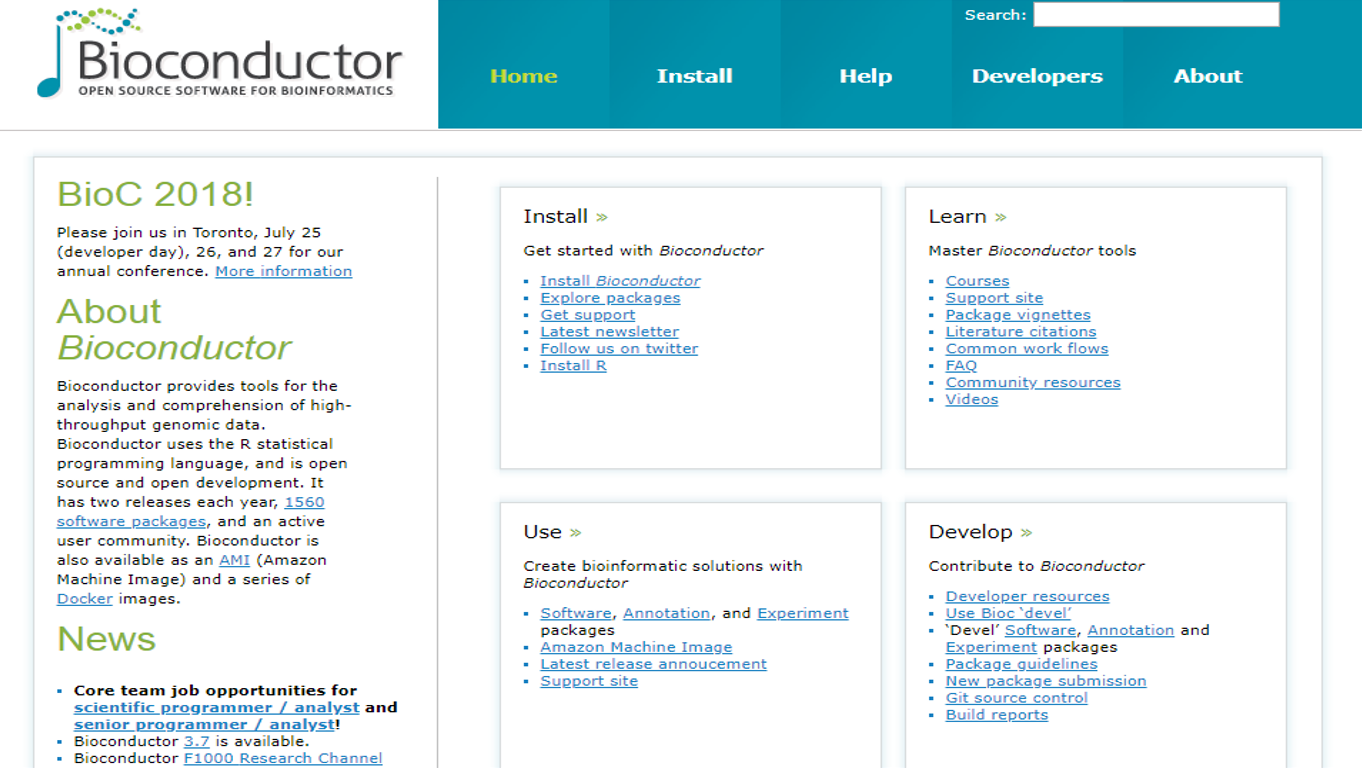
Tóm gọn, Bioconductor tập trung vào phân tích thống kê và diễn giải dữ liệu hệ gen băng thông cao. Trọng tâm vào phân tích thống kê xuất phát từ bản chất dữ liệu: các phương pháp hiện đại tạo ra lượng dữ liệu khổng lồ bắt buộc phải tóm tắt bằng thống kê. Là nhà nghiên cứu, chúng ta phải thực hiện các thí nghiệm có trọng tâm, được thiết kế trong một khung thống kê. Công nghệ tạo ra các kiểu dữ liệu di truyền hiện đại và các quy trình phòng thí nghiệm sau đó nảy sinh các tạo tác công nghệ cần được xử lý bằng kỹ thuật thống kê. Cuối cùng, thách thức tích hợp dữ liệu phức tạp buộc chúng ta suy xét kỹ lưỡng về hệ quả thống kê của các bước liên quan.
Phần mềm Bioconductor bao gồm các gói bổ sung cho R. Một gói R là một tập hợp có cấu trúc của mã (R, C, hoặc khác), tài liệu và/hoặc dữ liệu để thực hiện những loại phân tích cụ thể, ví dụ như các gói affy, cluster, graph. Nó cung cấp các hiện thực của các phương pháp thống kê và đồ họa cụ thể.
Trong phiên bản phát hành mới nhất của Bioconductor, có hơn 1500 gói sẵn có. Chúng có thể được phân loại thành bốn loại:
• Gói phần mềm phân tích: Công cụ để phân tích dữ liệu hệ gen băng thông cao, ví dụ, IMMAN, limma
• Gói chú giải: Cơ sở dữ liệu tĩnh của bản đồ định danh, mô hình gen, con đường, v.v.; ví dụ, TxDb.Hsapiens.UCSC.hg19.knownGene
• Gói dữ liệu thí nghiệm minh họa: Bộ dữ liệu dùng để minh họa chức năng phần mềm, ví dụ, airway
• Gói quy trình: Tài liệu mô tả một quy trình tin sinh học liên quan đến nhiều gói Bioconductor để giải thích các lĩnh vực Sinh học cụ thể như Proteomics, ví dụ, highthroughputassays
GenomicRanges: ‘Ranges’ để mô tả dữ liệu và chú giải; GRanges(), GRangesList()
Biostrings: Trình tự DNA và các trình tự khác, DNAStringSet()
GenomicAlignments: Các reads đã căn chỉnh; GAlignemts() và các hàm liên quan
GenomicFeatures, AnnotationDbi: tài nguyên chú giải, các gói TxDb và org.
SummarizedExperiment: điều phối dữ liệu thực nghiệm
rtracklayer: nhập chú giải hệ gen, ví dụ BED, WIG, GTF, v.v.
Lần đầu sử dụng Bioconductor, chúng ta cần có bản phát hành mới nhất của R, rồi cài phiên bản mới nhất của Bioconductor bằng cách khởi động R và nhập các lệnh sau:
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
Với các lệnh này, toàn bộ gói lõi của phiên bản Bioconductor mới nhất sẽ được cài đặt. Để cài các gói cụ thể như IMMAN và GenomicRanges có trong kho Bioconductor, chúng ta có thể dùng hướng dẫn trên trang của gói như lệnh sau:
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
Hàm biocLite() trong gói BiocInstaller được dùng để cài đặt gói thay cho hàm phổ biến install.packages() trong R. Lý do là Bioconductor có kho riêng biệt với CRAN, và lịch phát hành khác với R. Điều này có thể gây lệch phiên giữa R và Bioconductor. Vì vậy, phiên bản được install.packages() nhận diện thường không phải là bản ‘phát hành’ mới nhất.
Sau khi cài đặt ban đầu, phần này cung cấp các ví dụ đơn giản về không gian làm việc của Bioconductor để bạn quen với ngữ cảnh. Ở đây, hai ví dụ thuộc các thành phần khác nhau của dự án Bioconductor như giải trình tự băng thông cao, phân tích thống kê và diễn giải được tập hợp lại.
Khởi đầu, để làm quen với dữ liệu băng thông cao, bạn sẽ làm việc với các trình tự DNA. Để làm điều này, bạn cần dùng Biostring, một gói chủ đạo để thao tác các trình tự sinh học lớn. Từ đó, bạn có thể dùng DNAStringSet() như một hàm để lưu một tập hợp DNAString (chuỗi dựa trên bảng chữ cái DNA theo IUPAC Extended Genetic Alphabet). Hàm này chuyển đầu vào thành một đối tượng XStringSet kiểu DNA. Các ký tự được mã hóa theo cách tối ưu cho các thuật toán tìm kiếm nhanh.
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
Sau đó, chúng ta có thể dùng hàm complement() để lấy chuỗi bổ sung của DNA.
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
Học cách làm việc với các gói như DNAStringSet và Biostrings sẽ mang lại lợi ích khi sử dụng các gói khác.
Trong một ví dụ khác, chúng ta muốn dùng gói GenomicRanges vốn được thiết kế để biểu diễn vị trí hệ gen trong dự án Bioconductor. Gói này cung cấp nền tảng cho phân tích hệ gen bằng cách đưa ra ba lớp (GRanges, GPos và GRangesList), được dùng để biểu diễn các khoảng hệ gen, vị trí hệ gen và nhóm các khoảng hệ gen.
Lớp GRanges được dùng để minh họa một tập hợp các khoảng hệ gen, mỗi khoảng có một vị trí bắt đầu và kết thúc trên hệ gen. Nó lưu vị trí của các đặc trưng hệ gen như các vị trí gắn kết liên tục, phiên mã và exon. Chúng ta có thể truy cập các đối tượng này bằng hàm khởi tạo GRanges như bên dưới:
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
Kết quả là một đối tượng GRanges với 10 khoảng hệ gen. Như thể hiện, hàm chia thông tin thành vùng bên trái và bên phải, được phân tách bởi ký hiệu |. Tọa độ hệ gen (seqnames, ranges và strand) nằm ở bên trái, còn các cột siêu dữ liệu (chú giải) nằm ở bên phải. Trong ví dụ này, siêu dữ liệu gồm điểm số và thông tin GC. Tuy nhiên, gần như bất kỳ thông tin nào cũng có thể được lưu trong phần siêu dữ liệu của một đối tượng GRanges.
Các hàm phụ trợ seqnames(), ranges() và strand() được dùng để trích xuất các thành phần tọa độ hệ gen trong một đối tượng GRanges. Ví dụ,
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
Trong ví dụ cuối, đưa ra một ví dụ đơn giản về phần phân tích thống kê của dự án. Ở đây, có thể thảo luận về phân loại Gene Ontology (GO). GO là một tập hợp các khái niệm (chức năng phân tử, thành phần tế bào và quá trình sinh học) dùng để mô tả chức năng gen và mối quan hệ giữa các khái niệm này. Cụ thể hơn, GO phân loại các gen và sản phẩm gen theo hệ thống phân cấp thành một đồ thị gọi là ontology. Để truy cập một ví dụ phù hợp, có thể dùng ba gói của Bioconductor là clusterProfiler, DOSE và org.Hs.eg.db.
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
Gói clusterProfiler là một tập hợp phương pháp dành để phân tích và trực quan hóa hồ sơ chức năng như GO của các gen và cụm gen. Bằng cách sử dụng nó, bạn có thể phân cụm các gen khác nhau theo mức độ tương đồng. Để minh họa quy trình này, bộ dữ liệu geneList được dùng trong gói DOSE là một lựa chọn tốt. Nó chứa thông tin nội dung của các ID gen. Mặt khác, gói org.Hs.eg.db bao gồm chú giải toàn hệ gen, biểu diễn trình tự vật chất di truyền được làm giàu với thông tin liên quan đến vị trí hệ gen, dành cho người.
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
Hàm enrichGO() thực hiện Phân tích Làm giàu GO trên một vector gen cho trước. Phân tích làm giàu là một cách tiếp cận để xác định một nhóm gen được gán vào một lớp các nhóm định sẵn theo đặc tính chức năng của chúng. Kết quả làm giàu có thể chứa các thuật ngữ rất khái quát. Để dùng hàm này, bạn phải cung cấp đối số “OrgDb”. Khi đó, cần gói org.Hs.eg.db bao gồm chú giải toàn hệ gen người. Gói này bao gồm biểu diễn trình tự vật chất di truyền được làm giàu thông tin liên quan đến vị trí hệ gen.
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
Để minh họa bản đồ làm giàu, có thể dùng hàm emapplot(). Hàm này biểu diễn các tập gen như một mạng. Nói ngắn gọn, các tập gen chồng lấp lẫn nhau sẽ tụ lại thành một cụm.
emapplot(ego)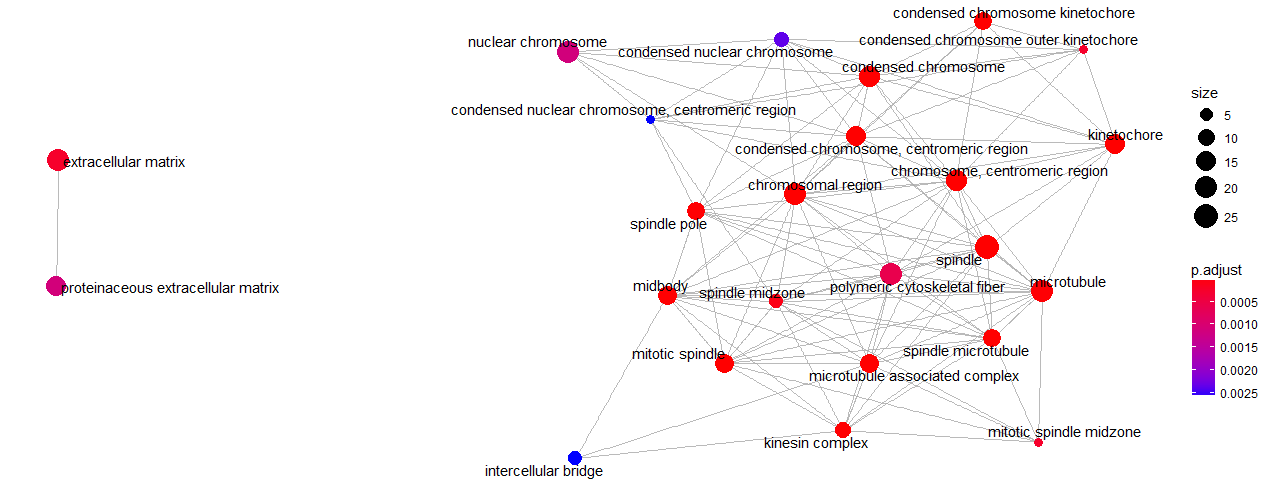
Trong quá trình sử dụng các gói Bioconductor, nếu cần trợ giúp bạn có thể dùng các lệnh sau:
class(dnaSequence) # Indicate the class of the input object

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # List all available methods for a S3 and S4 generic function or class

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Show the help page of the function

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Refers to all available vignettes of the input package
Ngoài ra, có rất nhiều trang trợ giúp và quy trình hữu ích có sẵn trên các trang của Bioconductor:
Sau khi đọc hướng dẫn này, bạn đã làm quen với dự án Bioconductor và vai trò nền tảng của nó trong các nghiên cứu sinh học. Bên cạnh đó, các loại gói của Bioconductor và một số gói quan trọng đã được đề cập. Ở bước tiếp theo, một quy trình ngắn về cách cài đặt và sử dụng dự án đã được giải thích. Bạn đã học cách làm việc với các gói Biostring và GenomicRanges, và nhờ đó, bạn đã làm quen với trình tự DNA và các khoảng hệ gen. Ở một ví dụ khác, bạn đã thử áp dụng phân tích làm giàu trên một tập gen người. Vì thế, bạn đã nắm các khái niệm về phân tích làm giàu và GO. Ở phần cuối, các cách khác nhau để tìm trợ giúp khi làm việc với Bioconductor đã được nêu. Nếu bạn muốn biết thêm về dự án, đừng ngần ngại xem Bioconductor_courses.
Nếu bạn muốn học thêm về R, hãy tham gia khóa Experimental Design in R của DataCamp.
Khóa học R
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
