कोर्स
R परिचय
4 घंटा
3.1M
इस ट्यूटोरियल में, आप Bioconductor स्पेस से परिचित होंगे। इसके माध्यम से आप अपने जैविक प्रयोगों के परिणामों पर संगणकीय और सांख्यिकीय विश्लेषण कर पाएंगे, क्योंकि किसी भी शोधकर्ता के लिए अपनी निष्कर्षों की महत्ता सिद्ध करना आवश्यक होता है। दूसरे शब्दों में, आप इस प्रोजेक्ट का उपयोग करके यह दर्शाने में सक्षम होंगे कि प्रयुक्त डेटा आपकी परिकल्पना के अनुरूप है या नहीं। इसके अलावा, आप अपने वैज्ञानिक प्रश्न का सांख्यिकीय रूप से सत्यापन कर सकते हैं, बिना अत्यधिक समय और धन व्यय किए।
संक्षेप में, यह ट्यूटोरियल निम्नलिखित बातों को स्पष्ट करेगा:
- Bioconductor क्या है?
- Bioconductor R पैकेज किसके लिए हैं?
- हम इसका उपयोग कैसे करें?
Bioconductor संगणकीय जीवविज्ञान और बायोइन्फॉरमैटिक्स के लिए एक ओपन सॉफ़्टवेयर विकास मंच है। यह संगणकीय जीवविज्ञान समुदाय के लिए एक ओपन-सोर्स, ओपन-डेवलपमेंट सॉफ़्टवेयर प्रोजेक्ट है। यह ओपन-सोर्स है क्योंकि कोई भी मूल कोड पढ़ और संशोधित कर सकता है, और ओपन-डेवलपमेंट है क्योंकि कोई भी कोड के विकास में योगदान और भागीदारी कर सकता है। यह R भाषा में कार्य करता है, जो डेटा विज्ञान में व्यापक रूप से प्रयुक्त भाषा है, विशेषकर डेटा विश्लेषण के लिए इसकी लचीलेपन के कारण। R में उच्च-गुणवत्ता की ग्राफ़िक्स भी हैं, और यह अन्य भाषाओं के साथ भली-भांति काम कर सकता है। Bioconductor जीनोमिक डेटा के विश्लेषण के लिए शक्तिशाली सांख्यिकीय और ग्राफ़िकल विधियों तक पहुँच प्रदान करता है। यह GenBank, GO, LocusLink और PubMed जैसी जैविक मेटाडेटा को प्रायोगिक डेटा के विश्लेषण में एकीकृत करने में भी सहायक है।
इसके अलावा, यह विस्तारणीय, इंटरऑपेरेबल और स्केलेबल सॉफ़्टवेयर का त्वरित विकास संभव बनाता है। साथ ही, Bioconductor का उपयोग करके उच्च-गुणवत्ता का प्रलेखन और पुनरुत्पाद्य (reproducible) शोध को बढ़ावा दिया जा सकता है। यह संगणकीय और सांख्यिकीय विधियों में प्रशिक्षण की तैयारी करता है। संक्षेप में, Bioconductor को नीचे दिए अनुसार तीन भागों में विभाजित किया जा सकता है:
| सांख्यिकीय विश्लेषण | समझ | उच्च-थ्रूपुट |
|---|---|---|
| बड़ा डेटा | जैविक परिप्रेक्ष्य | सीक्वेंसिंग |
| प्रौद्योगिक कलाकृतियाँ | विज़ुअलाइज़ेशन | माइक्रोएरे |
| डिज़ाइन किए गए प्रयोग | पुनरुत्पाद्यता | फ्लो साइटोमेट्री |
संगणकीय जीवविज्ञान में विश्लेषण प्रायः एक विशिष्ट प्रश्न का उत्तर देने के लिए अनेक भिन्न उपकरणों को साथ जोड़ने की आवश्यकता होती है। यह आमतौर पर ऐसे पैकेज का रूप लेता है जिसे अन्य शोधकर्ता भी उपयोग कर सकें। इसलिए, Bioconductor नियमों और मार्गदर्शक सिद्धांतों के साथ R पैकेजों का एक सॉफ़्टवेयर रिपॉजिटरी भी है। संस्करण 3.7 में 1500 से अधिक पैकेज हैं। इनका उपयोग दुनिया भर में हज़ारों शोधकर्ता करते हैं। इन पैकेजों का प्रलेखन सामान्यतः उत्कृष्ट होता है। चूँकि कोई भी योगदान दे सकता है, किसी विशेष समस्या को हल करने हेतु एक से अधिक विकल्प उपलब्ध हो सकते हैं, जिससे पैकेज डेवलपर्स के बीच एक प्रतिस्पर्धी माहौल बनता है।
वेबसाइट पर Bioconductor प्रोजेक्ट के इंस्टॉल, सीखने, उपयोग करने और योगदान देने से संबंधित सामग्री उपलब्ध है। यह प्रोजेक्ट 2001 की शरद ऋतु में शुरू हुआ था और इसमें अमेरिका, यूरोप और ऑस्ट्रेलिया के 20 से अधिक कोर डेवलपर्स शामिल हैं।
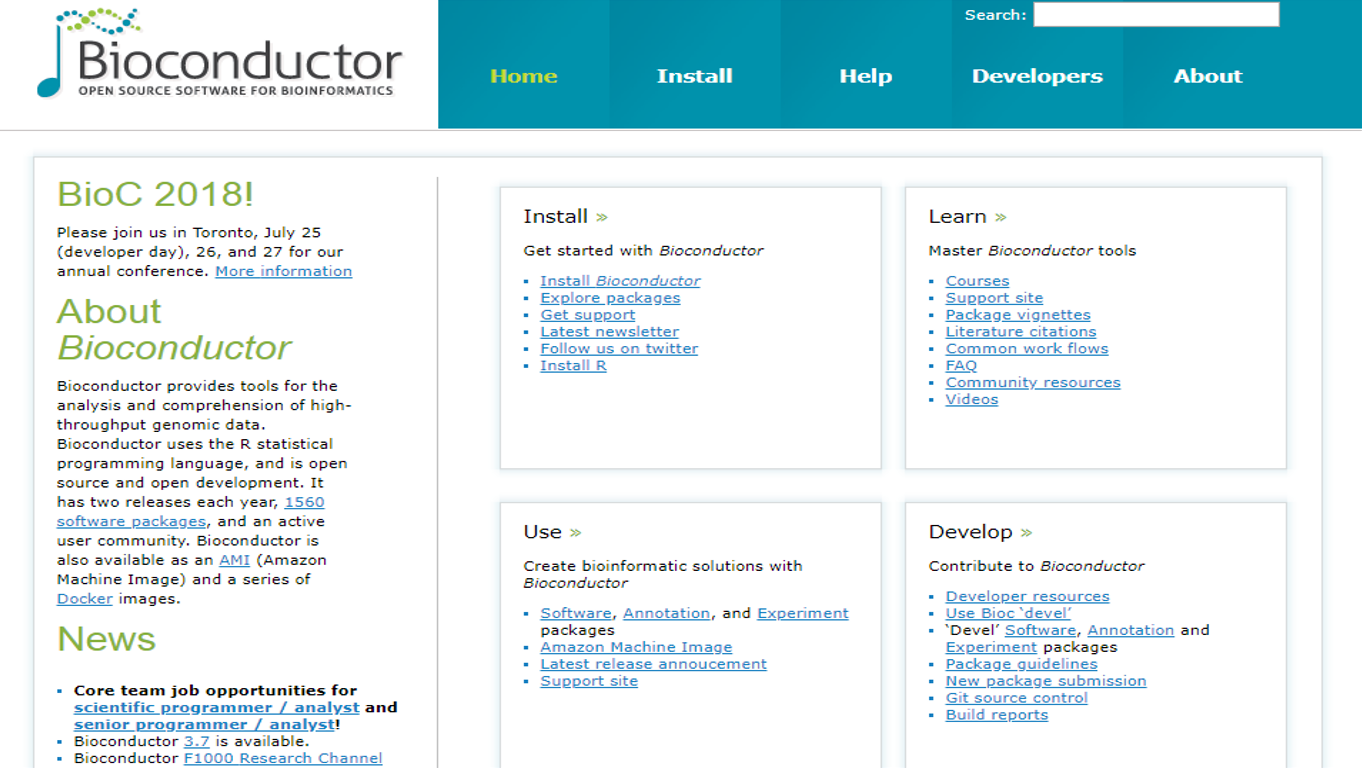
संक्षेप में, Bioconductor उच्च-थ्रूपुट जीनोमिक डेटा के सांख्यिकीय विश्लेषण और समझ पर केंद्रित है। सांख्यिकीय विश्लेषण पर ध्यान डेटा की प्रकृति से आता है। आधुनिक विधियाँ विशाल मात्रा में डेटा उत्पन्न करती हैं, जिनका सांख्यिकीय सारांश आवश्यक होता है। शोधकर्ताओं के रूप में, हमें सांख्यिकीय ढाँचे में केंद्रित और डिज़ाइन किए गए प्रयोगों का संचालन करना होता है। आधुनिक आनुवंशिक डेटा प्रकार उत्पन्न करने वाली तकनीकें और प्रयोगशाला प्रोटोकॉल तकनीकी कलाकृतियाँ उत्पन्न करते हैं, जिनका समाधान सांख्यिकीय तकनीकों से करना पड़ता है। अंततः, सघन डेटा एकीकरण की चुनौतियाँ हमें प्रत्येक चरण के सांख्यिकीय परिणामों पर सावधानी से विचार करने को बाध्य करती हैं।
Bioconductor सॉफ़्टवेयर R ऐड-ऑन पैकेजों से मिलकर बना है। एक R पैकेज कोड (R, C, या अन्य), प्रलेखन, और/या डेटा का संरचित संग्रह होता है जो विशिष्ट प्रकार के विश्लेषण करने हेतु होता है, जैसे affy, cluster, graph पैकेज। यह विशिष्ट सांख्यिकीय और ग्राफ़िकल विधियों के निष्पादन प्रदान करता है।
Bioconductor के नवीनतम रिलीज़ संस्करण में 1500 से अधिक पैकेज उपलब्ध हैं। इन्हें चार प्रकारों में बांटा जा सकता है:
• विश्लेषण सॉफ़्टवेयर पैकेज: उच्च-थ्रूपुट जीनोमिक डेटा के विश्लेषण के लिए उपकरण, जैसे IMMAN, limma
• एनोटेशन पैकेज: आईडेंटिफ़ायर मैप, जीन मॉडल, पाथवे आदि के स्थैतिक डेटाबेस; जैसे TxDb.Hsapiens.UCSC.hg19.knownGene
• उदाहरणात्मक प्रयोग डेटा पैकेज: सॉफ़्टवेयर की कार्यक्षमता दिखाने के लिए प्रयुक्त डेटा सेट, जैसे airway
• वर्कफ़्लो पैकेज: ऐसे दस्तावेज़ जो किसी बायोइन्फॉरमैटिक्स वर्कफ़्लो का वर्णन करते हैं जिसमें विशिष्ट जीवविज्ञान क्षेत्रों, जैसे प्रोटीओमिक्स, को समझाने हेतु अनेक Bioconductor पैकेज शामिल होते हैं; जैसे highthroughputassays
GenomicRanges: डेटा और एनोटेशन का वर्णन करने हेतु ‘Ranges’; GRanges(), GRangesList()
Biostrings: DNA और अन्य सीक्वेंस, DNAStringSet()
GenomicAlignments: संरेखित रीड्स; GAlignemts() और संबंधित
GenomicFeatures, AnnotationDbi: एनोटेशन संसाधन, TxDb, और org पैकेज।
SummarizedExperiment: प्रायोगिक डेटा का समन्वय
rtracklayer: जीनोम एनोटेशन आयात करें, जैसे BED, WIG, GTF, आदि।
Bioconductor का पहली बार उपयोग करने के लिए, हमें R का नवीनतम रिलीज़ प्राप्त करना होगा और फिर R शुरू करके नीचे दिए गए कमांड दर्ज कर Bioconductor का नवीनतम संस्करण इंस्टॉल करना होगा:
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
इन कमांड द्वारा, Bioconductor के नवीनतम संस्करण के सभी कोर पैकेज इंस्टॉल हो जाएंगे। Bioconductor रिपॉजिटरी पर उपलब्ध विशिष्ट पैकेज जैसे IMMAN और GenomicRanges इंस्टॉल करने के लिए, हम पैकेज लैंडिंग पेज पर दिए निर्देशों का उपयोग कर सकते हैं, जैसे निम्न कमांड:
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
R में सामान्य फ़ंक्शन install.packages() के बजाय पैकेज इंस्टॉलेशन के लिए BiocInstaller पैकेज का biocLite() फ़ंक्शन उपयोग किया जाता है। इसका कारण यह है कि Bioconductor का रिपॉजिटरी CRAN से अलग है, और इसका रिलीज़ शेड्यूल R से भिन्न है। इससे R और Bioconductor के रिलीज़ शेड्यूल के बीच असंगति हो सकती है। इसलिए install.packages() द्वारा पहचाना गया संस्करण अक्सर उपलब्ध नवीनतम ‘रिलीज़’ नहीं होता।
प्राथमिक इंस्टॉलेशन के बाद, यह भाग Bioconductor वर्कस्पेस के सरल उदाहरण देता है ताकि आप संदर्भ से अधिक परिचित हों। यहाँ, Bioconductor प्रोजेक्ट के विभिन्न घटकों जैसे उच्च-थ्रूपुट सीक्वेंसिंग, सांख्यिकीय विश्लेषण और समझ के दो अलग-अलग उदाहरण साथ लाए गए हैं।
शुरुआत के लिए, उच्च-थ्रूपुट डेटा से परिचित होने हेतु आप DNA सीक्वेंस पर काम करेंगे। इसके लिए आपको Biostring का उपयोग करना होगा, जो बड़े जैविक सीक्वेंस में परिवर्तन करने के लिए एक प्रमुख पैकेज है। इससे आप DNAStringSet() फ़ंक्शन का उपयोग कर सकते हैं, जो DNAString (IUPAC विस्तारित जेनेटिक अल्फ़ाबेट पर आधारित स्ट्रिंग) के सेट को स्टोर करता है। यह इनपुट को DNA बेस प्रकार के XStringSet ऑब्जेक्ट में बदल देता है। अक्षरों को इस प्रकार एन्कोड किया जाता है कि तेज़ सर्च एल्गोरिद्म का अनुकूलन हो सके।
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
इसके बाद, हम DNA सीक्वेंस का पूरक (complement) प्राप्त करने के लिए complement() फ़ंक्शन का उपयोग कर सकते हैं।
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
DNAStringSet और Biostrings जैसे पैकेजों के साथ काम करना अन्य पैकेजों में भी लाभ देता है।
एक अन्य उदाहरण में, हम Bioconductor प्रोजेक्ट के भीतर जीनोमिक लोकेशन इंगित करने के लिए निर्दिष्ट GenomicRanges पैकेज का उपयोग करना चाहते हैं। यह जीनोमिक विश्लेषण के लिए तीन क्लास (GRanges, GPos और GRangesList) प्रस्तुत कर आधार प्रदान करता है, जिनका उपयोग जीनोमिक रेंज, जीनोमिक पोजीशन और जीनोमिक रेंज के समूह दिखाने के लिए किया जाता है।
GRanges क्लास का उपयोग ऐसे जीनोमिक रेंज के सेट को दर्शाने के लिए किया जाता है जिनमें प्रत्येक के जीनोम पर एक प्रारंभ और एक अंत स्थान होता है। यह सन्निहित बाइंडिंग साइट, ट्रांस्क्रिप्ट्स और एक्सॉन्स जैसी जीनोमिक विशेषताओं के स्थान को स्टोर करता है। हम नीचे दिए अनुसार GRanges कंस्ट्रक्टर फ़ंक्शन का उपयोग करके इन ऑब्जेक्ट्स तक पहुँच सकते हैं:
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
परिणाम 10 जीनोमिक रेंज वाला एक GRanges ऑब्जेक्ट है। जैसा दिखाया गया है, यह फ़ंक्शन जानकारी को बाएँ और दाएँ भागों में बाँटता है जिन्हें | प्रतीकों द्वारा अलग किया जाता है। जीनोम के निर्देशांक (seqnames, ranges, और strand) बाएँ भाग में होते हैं, और मेटाडेटा कॉलम (एनोटेशन) दाएँ भाग में। इस उदाहरण में, मेटाडेटा में score और GC सूचना शामिल है। हालाँकि, GRanges ऑब्जेक्ट के मेटाडेटा भाग में लगभग कुछ भी संग्रहीत किया जा सकता है।
seqnames(), ranges(), और strand() सहायक फ़ंक्शन GRanges ऑब्जेक्ट के भीतर जीनोमिक निर्देशांकों के घटकों तक पहुँचने के लिए उपयोग किए जाते हैं। उदाहरण के लिए,
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
अंतिम उदाहरण में, प्रोजेक्ट के सांख्यिकीय विश्लेषण भाग का एक सरल उदाहरण दिया गया है। इसके लिए, जीन ऑंटोलॉजी (GO) वर्गीकरण पर चर्चा की जा सकती है। GO संकल्पनाओं (मॉलिक्यूलर फ़ंक्शन, सेल्यूलर कंपोनेंट और बायोलॉजिकल प्रोसेस) का एक संग्रह है, जिसका उपयोग जीन के कार्य और इन संकल्पनाओं के बीच के संबंधों को समझाने के लिए किया जाता है। अधिक विशिष्ट रूप से, GO जीन और जीन उत्पादों को पदानुक्रमित रूप से एक ग्राफ़ (ऑंटोलॉजी) में वर्गीकृत करता है। इसका प्रयोगात्मक उदाहरण हासिल करने के लिए तीन Bioconductor पैकेज clusterProfiler, DOSE और org.Hs.eg.db का उपयोग किया जा सकता है।
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
clusterProfiler पैकेज जीन और जीन क्लस्टर्स के GO जैसे फ़ंक्शनल प्रोफ़ाइल का विश्लेषण और विज़ुअलाइज़ेशन करने के लिए विधियों का एक सेट है। इसका उपयोग करके आप विभिन्न जीनों को उनकी समानताओं के अनुसार क्लस्टर कर सकेंगे। इस प्रक्रिया का उदाहरण देने के लिए, DOSE पैकेज में प्रयुक्त geneList डेटा सेट एक अच्छा विकल्प है। इसमें जीन आईडी का सूचना-विषयक कंटेंट शामिल है। दूसरी ओर, org.Hs.eg.db पैकेज में मानव के लिए जीनोमिक पोजीशन से संबंधित जानकारी से समृद्ध, जीनोम-व्यापी एनोटेशन और जेनेटिक सामग्री के सीक्वेंस निरूपण शामिल हैं।
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
enrichGO() फ़ंक्शन दी गई जीन वेक्टर पर GO एनरिचमेंट विश्लेषण करता है। एनरिचमेंट विश्लेषण एक ऐसी विधि है जिसमें जीनों के समूह को उनकी फ़ंक्शनल विशेषताओं के अनुसार पूर्वनिर्धारित बिन्स की किसी श्रेणी में नियत किया जाता है। एनरिच्ड परिणामों में बहुत सामान्य पद भी हो सकते हैं। इस फ़ंक्शन का उपयोग करने के लिए, आपको “OrgDb” नामक आर्ग्युमेंट भरना होगा। इसके लिए मानव जीनोम-व्यापी एनोटेशन वाला org.Hs.eg.db पैकेज आवश्यक है। इस पैकेज में जीनोमिक पोजीशन से संबंधित जानकारी से समृद्ध जेनेटिक सामग्री का सीक्वेंस निरूपण शामिल है।
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
एनरिचमेंट मैप को दर्शाने के लिए emapplot() फ़ंक्शन का उपयोग किया जा सकता है। यह फ़ंक्शन जीन सेट को एक नेटवर्क के रूप में प्रदर्शित करता है। सरल शब्दों में कहें, परस्पर ओवरलैप करने वाले जीन सेट एक साथ क्लस्टर बना लेते हैं।
emapplot(ego)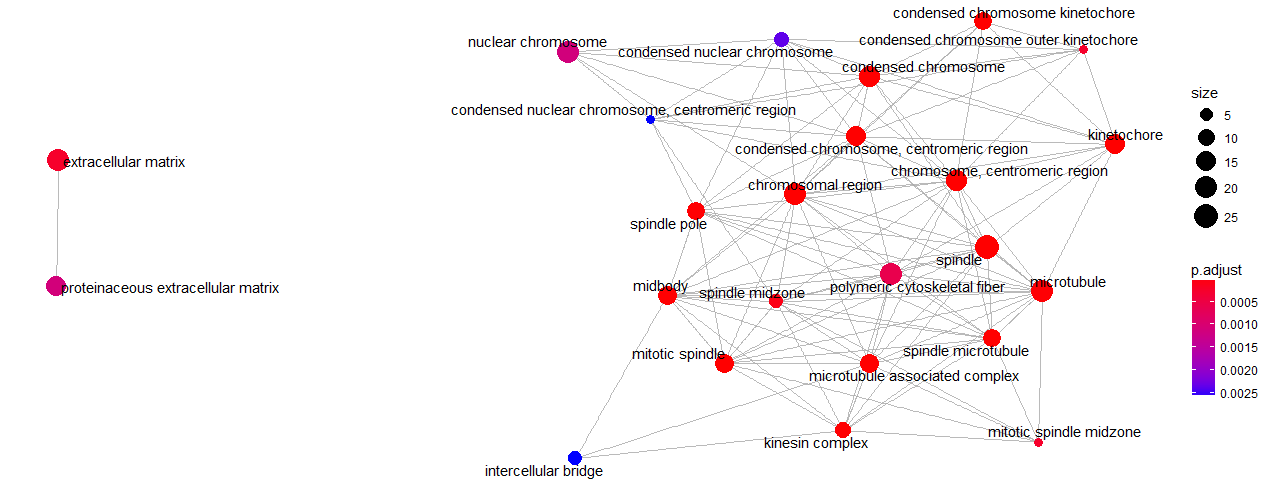
Bioconductor पैकेजों का उपयोग करते समय यदि किसी भी प्रकार की सहायता चाहिए, तो आप निम्न कमांड का उपयोग कर सकते हैं:
class(dnaSequence) # Indicate the class of the input object

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # List all available methods for a S3 and S4 generic function or class

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Show the help page of the function

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Refers to all available vignettes of the input package
इसके अलावा, Bioconductor साइट्स पर कई उपयोगी सहायता पेज और वर्कफ़्लो उपलब्ध हैं:
इस ट्यूटोरियल को पढ़कर आप Bioconductor प्रोजेक्ट और जैविक अनुसंधान कार्यों में इसकी बुनियादी भूमिका से परिचित हुए। साथ ही, Bioconductor पैकेजों के प्रकार और कुछ सबसे महत्वपूर्ण पैकेजों का उल्लेख किया गया। अगले चरण में, प्रोजेक्ट को कैसे इंस्टॉल और उपयोग करें, इसका एक छोटा वर्कफ़्लो समझाया गया। आपने Biostring और GenomicRanges पैकेजों के साथ काम करना सीखा, और परिणामस्वरूप आप DNA सीक्वेंस और जीनोम रेंज से परिचित हुए। एक अन्य उदाहरण में, आपने मानव जीनों के एक सेट पर एनरिचमेंट विश्लेषण लागू करने की कोशिश की। इस प्रकार, आपने एनरिचमेंट विश्लेषण और GO की अवधारणाएँ समझीं। अंतिम भाग में, Bioconductor पर काम करते समय सहायता प्राप्त करने के विभिन्न तरीकों का उल्लेख किया गया। यदि आप प्रोजेक्ट के बारे में और जानना चाहते हैं, तो निःसंकोच Bioconductor_courses देखें।
यदि आप R के बारे में और सीखना चाहते हैं, तो DataCamp का Experimental Design in R कोर्स करें।
R कोर्स
कोर्स
कोर्स
कोर्स