{count, plural, one {Corso} other {Corsi}}
Introduzione a R
{hours} ore
3.1M
In questo tutorial farai conoscenza con l’ecosistema di Bioconductor. In questo modo potrai eseguire analisi computazionali e statistiche sui risultati dei tuoi esperimenti biologici, come è necessario a qualsiasi ricercatore per dimostrare la significatività delle proprie conclusioni. In altre parole, con questo progetto potrai verificare se i dati utilizzati sono coerenti con la tua ipotesi. Inoltre, potrai validare la tua domanda scientifica dal punto di vista statistico senza sprecare troppo tempo e denaro.
In breve, questo tutorial chiarirà:
- Che cos’è Bioconductor?
- Cosa rappresentano i pacchetti R di Bioconductor?
- Come si usa?
Bioconductor è un ambiente software aperto per la biologia computazionale e la bioinformatica. È un progetto open-source e open-development per la comunità della biologia computazionale. È open-source perché chiunque può leggere e modificare il codice sottostante, e open-development perché chiunque può contribuire e partecipare allo sviluppo del codice. Utilizza il linguaggio R, ampiamente usato nella data science per la sua flessibilità, soprattutto nell’analisi dei dati. R offre anche grafica di alta qualità e può integrarsi facilmente con altri linguaggi. Bioconductor fornisce accesso a potenti metodi statistici e grafici per l’analisi di dati genomici. Facilita inoltre l’integrazione di metadati biologici come GenBank, GO, LocusLink e PubMed nell’analisi dei dati sperimentali.
Inoltre, consente lo sviluppo rapido di software estensibile, interoperabile e scalabile. Con Bioconductor si possono anche promuovere documentazione di alta qualità e ricerca riproducibile. Fornisce formazione in metodi computazionali e statistici. In sintesi, Bioconductor può essere suddiviso in tre parti principali come segue:
| Analisi statistica | Comprensione | Alta processività |
|---|---|---|
| Grandi dati | Contesto biologico | Sequenziamento |
| Artefatti tecnologici | Visualizzazione | Microarray |
| Esperimenti disegnati | Riproducibilità | Citometria a flusso |
L’analisi in biologia computazionale richiede quasi sempre molti strumenti diversi da integrare per rispondere a una domanda specifica. Questo di solito si traduce in un pacchetto utilizzabile anche da altri ricercatori. Quindi, Bioconductor è anche un repository di pacchetti R con regole e principi guida. La versione 3.7 include più di 1500 pacchetti, utilizzati da migliaia di ricercatori in tutto il mondo. Questi pacchetti hanno generalmente un’ottima documentazione. Poiché chiunque può contribuire, possono esistere più scelte di pacchetti per risolvere uno stesso problema, creando un ambiente competitivo tra gli sviluppatori.
Il sito web include materiali su come installare, imparare, usare e contribuire ai progetti di Bioconductor. Il progetto è iniziato nell’autunno del 2001 e conta più di 20 sviluppatori core tra Stati Uniti, Europa e Australia.
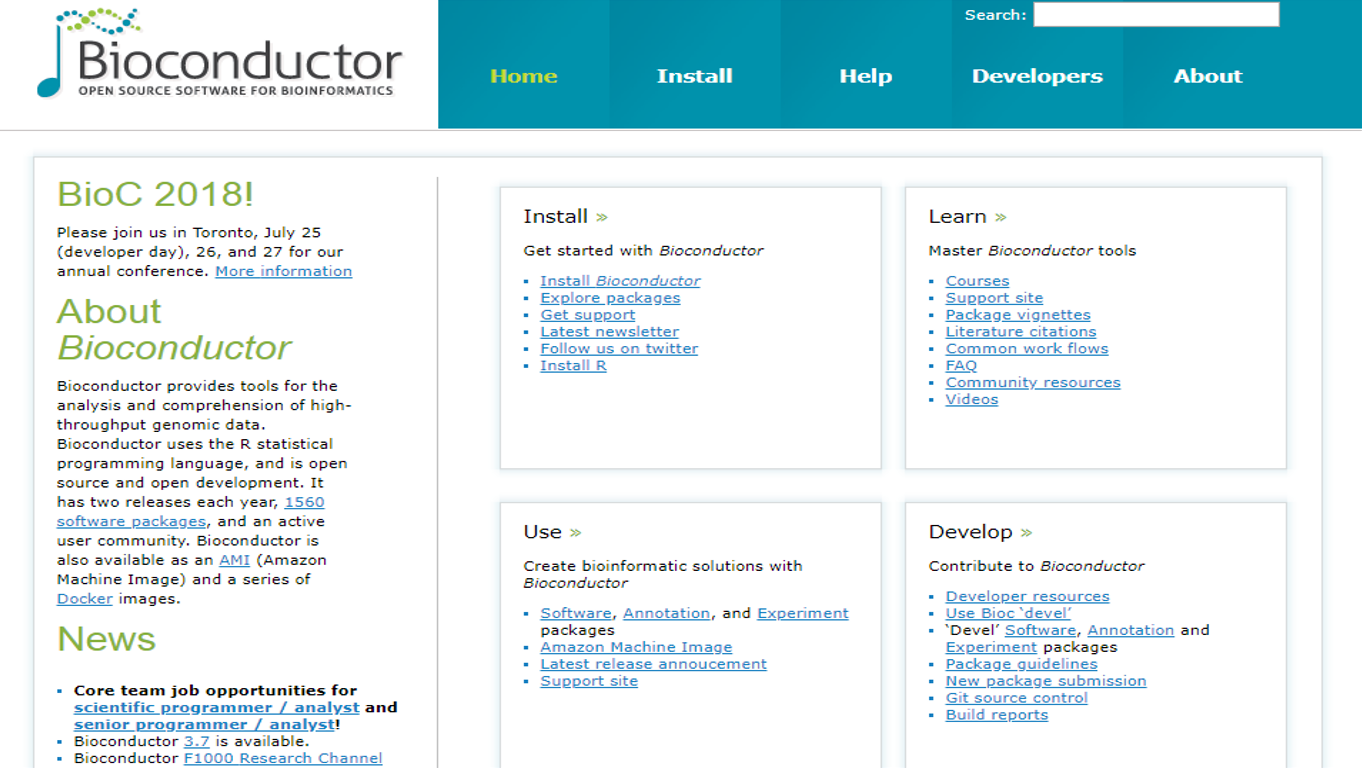
In sintesi, Bioconductor si occupa di analisi statistica e comprensione di dati genomici ad alta processività. L’attenzione all’analisi statistica deriva dalla natura dei dati: i metodi moderni generano volumi enormi di dati che richiedono necessariamente una sintesi statistica. Come ricercatori, dobbiamo condurre esperimenti mirati e progettati in un quadro statistico. La tecnologia che genera i moderni tipi di dati genetici e i protocolli di laboratorio introducono artefatti tecnologici che vanno affrontati con tecniche statistiche. Infine, le sfide di integrazione dei dati compatti ci impongono di riflettere attentamente sulle conseguenze statistiche dei passaggi coinvolti.
Il software di Bioconductor è costituito da pacchetti aggiuntivi per R. Un pacchetto R è una raccolta strutturata di codice (R, C, o altro), documentazione e/o dati per svolgere particolari tipi di analisi, ad esempio i pacchetti affy, cluster, graph. Fornisce implementazioni di specifici metodi statistici e grafici.
Nell’ultima versione di Bioconductor sono disponibili più di 1500 pacchetti. Possono essere classificati in quattro tipi:
• Pacchetti software per l’analisi: strumenti per l’analisi di dati genomici ad alta processività, ad esempio IMMAN, limma
• Pacchetti di annotazione: database statici di mappe di identificatori, modelli genici, pathway, ecc.; ad esempio TxDb.Hsapiens.UCSC.hg19.knownGene
• Pacchetti con dati sperimentali illustrativi: set di dati usati per illustrare le funzionalità del software, ad esempio airway
• Pacchetti di workflow: documenti che descrivono un flusso di lavoro bioinformatico che coinvolge più pacchetti di Bioconductor per spiegare campi specifici della biologia, come la proteomica, ad esempio highthroughputassays
GenomicRanges: ‘Ranges’ per descrivere dati e annotazioni; GRanges(), GRangesList()
Biostrings: sequenze di DNA e altre sequenze, DNAStringSet()
GenomicAlignments: read allineati; GAlignemts() e affini
GenomicFeatures, AnnotationDbi: risorse di annotazione, pacchetti TxDb e org.
SummarizedExperiment: coordinare i dati sperimentali
rtracklayer: importare annotazioni del genoma, ad es. BED, WIG, GTF, ecc.
Se è la prima volta che usi Bioconductor, devi procurarti l’ultima release di R e poi installare la versione più recente di Bioconductor avviando R e inserendo i seguenti comandi:
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
Con questi comandi verranno installati tutti i pacchetti core dell’ultima release di Bioconductor. Per installare pacchetti specifici come IMMAN e GenomicRanges disponibili nel repository di Bioconductor, si possono seguire le istruzioni nella pagina del pacchetto, ad esempio con il comando seguente:
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
La funzione biocLite() del pacchetto BiocInstaller viene usata per l’installazione dei pacchetti invece della funzione comune install.packages() di R. Il motivo è che Bioconductor ha un repository separato da CRAN e un ciclo di rilascio diverso da R. Questo può causare una mancata corrispondenza tra i cicli di rilascio di R e di Bioconductor. Di conseguenza, la versione identificata da install.packages() non è spesso la più recente ‘release’ disponibile.
Dopo l’installazione iniziale, questa sezione offre semplici esempi dell’ambiente di lavoro di Bioconductor per familiarizzare con il contesto. Qui sono riunite due diverse istanze di componenti eterogenei del progetto Bioconductor come il sequenziamento ad alta processività, l’analisi statistica e la comprensione.
Per iniziare, per prendere confidenza con i dati ad alta processività, lavorerai con sequenze di DNA. Per farlo devi usare Biostring, che è un pacchetto fondamentale per manipolare grandi sequenze biologiche. Da lì puoi usare DNAStringSet() come funzione per memorizzare un insieme di DNAString (una stringa basata sull’alfabeto del DNA secondo l’IUPAC Extended Genetic Alphabet). Questo può convertire l’input in un oggetto XStringSet di tipo base DNA. Le lettere sono codificate in modo da ottimizzare algoritmi di ricerca veloci.
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
Poi possiamo usare la funzione complement() per calcolare il complemento delle sequenze di DNA.
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
Imparare a usare pacchetti come DNAStringSet e Biostrings torna utile anche in altri pacchetti.
In un altro esempio, vogliamo usare il pacchetto GenomicRanges, pensato per indicare posizioni genomiche all’interno del progetto Bioconductor. Fornisce una base per l’analisi genomica presentando tre classi (GRanges, GPos e GRangesList), usate per rappresentare intervalli genomici, posizioni genomiche e gruppi di intervalli genomici.
La classe GRanges è usata per rappresentare un insieme di intervalli genomici, ciascuno con un’unica posizione di inizio e fine sul genoma. Memorizza la posizione di caratteristiche genomiche come siti di binding contigui, trascritti ed esoni. Possiamo creare questi oggetti usando il costruttore GRanges come segue:
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
Il risultato è un oggetto GRanges con 10 intervalli genomici. Come si vede, la stampa divide le informazioni in una parte sinistra e una destra separate da simboli |. Le coordinate genomiche (seqnames, ranges e strand) sono sulla sinistra, mentre le colonne di metadati (annotazioni) sono sulla destra. In questo esempio, i metadati includono score e informazione GC. Tuttavia, quasi qualsiasi cosa può essere memorizzata nella sezione dei metadati di un oggetto GRanges.
Le funzioni di accesso seqnames(), ranges() e strand() sono usate per estrarre i componenti delle coordinate genomiche all’interno di un oggetto GRanges. Per esempio,
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
Nell’ultimo esempio viene fornito un semplice caso della parte di analisi statistica del progetto. A tal fine si può trattare la classificazione Gene Ontology (GO). La GO è una raccolta di concetti (funzione molecolare, componente cellulare e processo biologico) usati per descrivere la funzione dei geni e le relazioni tra questi concetti. Più specificamente, GO classifica geni e prodotti genici gerarchicamente in un grafo chiamato ontologia. Per accedere a un esempio applicabile si possono usare tre pacchetti di Bioconductor chiamati clusterProfiler, DOSE e org.Hs.eg.db.
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
Il pacchetto clusterProfiler è un insieme di metodi specifici per analizzare e visualizzare profili funzionali, come la GO, di geni e cluster di geni. Usandolo, potrai raggruppare diversi geni in base alle loro somiglianze. Per esempio, il set di dati geneList utilizzato nel pacchetto DOSE è una buona scelta: contiene il contenuto informativo degli ID genici. Dall’altro lato, il pacchetto org.Hs.eg.db include annotazioni a livello di intero genoma, ossia la rappresentazione in sequenza del materiale genetico arricchita con informazioni relative alla posizione genomica, per l’uomo.
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
La funzione enrichGO() esegue la GO Enrichment Analysis su un dato vettore di geni. L’analisi di arricchimento è un approccio per individuare un gruppo di geni assegnati a una classe di insiemi predefiniti in base alle loro caratteristiche funzionali. Il risultato arricchito può contenere termini molto generali. Per usare questa funzione devi compilare l’argomento “OrgDb”. A tal fine è richiesto il pacchetto org.Hs.eg.db, che include l’annotazione umana a livello di genoma. Questo pacchetto consiste in una rappresentazione in sequenza del materiale genetico arricchita con informazioni relative alla posizione genomica.
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
Per illustrare la mappa di arricchimento si può usare la funzione emapplot(). Questa funzione rappresenta gli insiemi genici come una rete. Per una semplice dichiarazione, considera che insiemi genici che si sovrappongono reciprocamente formano un cluster.
emapplot(ego)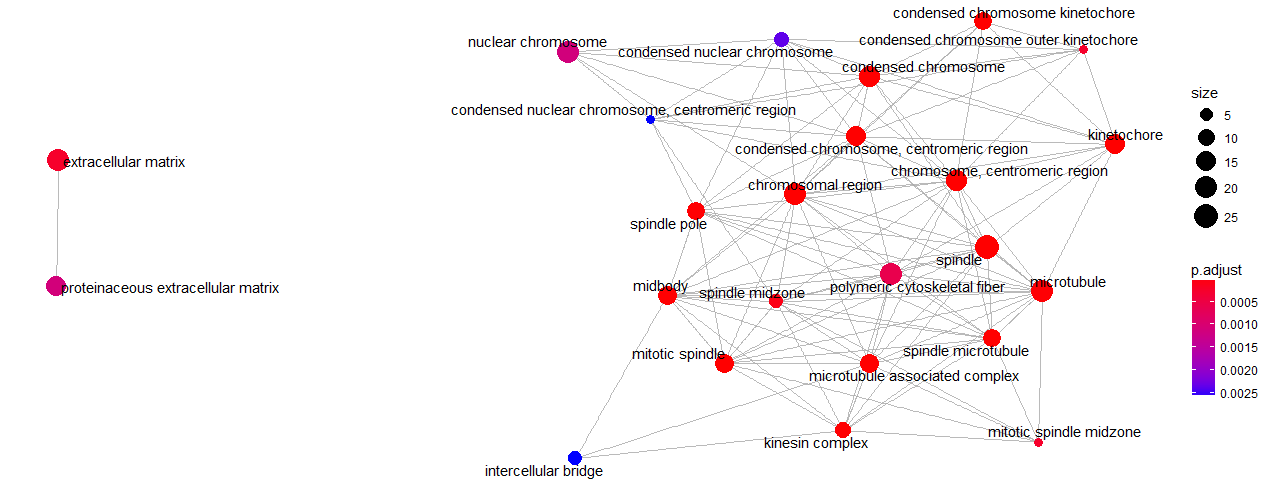
Durante l’uso dei pacchetti di Bioconductor, se hai bisogno di aiuto puoi usare i seguenti comandi:
class(dnaSequence) # Indicate the class of the input object

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # List all available methods for a S3 and S4 generic function or class

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Show the help page of the function

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Refers to all available vignettes of the input package
Inoltre, sul sito di Bioconductor sono disponibili molte utili pagine di aiuto e workflow:
Leggendo questo tutorial, hai conosciuto il progetto Bioconductor e il suo ruolo fondamentale nella ricerca biologica. Inoltre, sono stati presentati i tipi di pacchetti di Bioconductor e alcuni tra i più importanti. Successivamente, è stato illustrato un breve flusso di lavoro su come installare e usare il progetto. Hai imparato a lavorare con i pacchetti Biostring e GenomicRanges e, di conseguenza, ti sei familiarizzato con le sequenze di DNA e gli intervalli genomici. In un altro esempio, hai provato ad applicare l’analisi di arricchimento su un insieme di geni umani, imparando quindi i concetti di analisi di arricchimento e GO. Nell’ultima parte sono stati indicati vari modi per ottenere aiuto durante il lavoro con Bioconductor. Se vuoi saperne di più sul progetto, non esitare a consultare Bioconductor_courses.
Se vuoi imparare di più su R, segui il corso di DataCamp Experimental Design in R.
Corsi R
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



