Cursus
Introductie tot R
4 uur
3.1M
In deze tutorial maak je kennis met de Bioconductor-omgeving. Zo kun je computationele en statistische analyses uitvoeren op de resultaten van je biologische experiment, wat voor elke onderzoeker nodig is om de significantie van conclusies aan te tonen. Met andere woorden: met dit project kun je bepalen of de gebruikte data consistent zijn met je hypothese. Bovendien kun je je onderzoeksvraag statistisch valideren zonder onnodig veel tijd en geld te verspillen.
Kort samengevat behandelt deze tutorial:
- Wat is Bioconductor?
- Waar staan Bioconductor R-packages voor?
- Hoe gebruiken we het?
Bioconductor is een open software-ecosysteem voor computationele biologie en bio-informatica. Het is een open-source, open-development softwareproject voor de community van computationele biologie. Het is open-source omdat iedereen de onderliggende code kan lezen en wijzigen, en open-development omdat iedereen kan bijdragen en meewerken aan de ontwikkeling van de code. Het spreekt de R-taal, een veelgebruikte taal voor data science dankzij de flexibiliteit, vooral voor data-analyse. R heeft ook hoogwaardige grafische mogelijkheden, en het kan eenvoudig een slechte tool zijn voor andere talen. Bioconductor biedt toegang tot krachtige statistische en grafische methoden voor de analyse van genomische data. Het faciliteert ook de integratie van biologische metadata zoals GenBank, GO, LocusLink en PubMed in de analyse van experimentele data.
Bovendien maakt het de snelle ontwikkeling mogelijk van uitbreidbare, interoperabele en schaalbare software. Ook kunnen documentatie van hoge kwaliteit en reproduceerbaar onderzoek worden gestimuleerd met Bioconductor. Dit bereidt training voor in computationele en statistische methoden. Kort gezegd kan Bioconductor worden opgesplitst in drie verschillende onderdelen zoals hieronder:
| Statistische analyse | Begrip | High-throughput |
|---|---|---|
| Grote data | Biologische context | Sequencing |
| Technologische artefacten | Visualisatie | Microarrays |
| Ontworpen experimenten | Reproduceerbaarheid | Flowcytometrie |
Analyse in de computationele biologie vereist bijna altijd veel verschillende tools die je samenbrengt om een specifieke vraag te beantwoorden. Dat resulteert meestal in een package dat ook door andere onderzoekers gebruikt kan worden. Bioconductor is dus ook een software-repository van R-packages met enkele regels en leidende principes. Versie 3.7 heeft meer dan 1500 packages. Deze worden door duizenden onderzoekers wereldwijd gebruikt. Deze packages hebben over het algemeen uitstekende documentatie. Omdat iedereen kan bijdragen, kunnen er meerdere keuzes zijn om een specifiek probleem op te lossen. Dat creëert een competitieve omgeving onder package-ontwikkelaars.
De website bevat materiaal over hoe je Bioconductor-projecten installeert, leert, gebruikt en eraan bijdraagt. Het project startte in de herfst van 2001 en omvat meer dan 20 kernontwikkelaars in de VS, Europa en Australië.
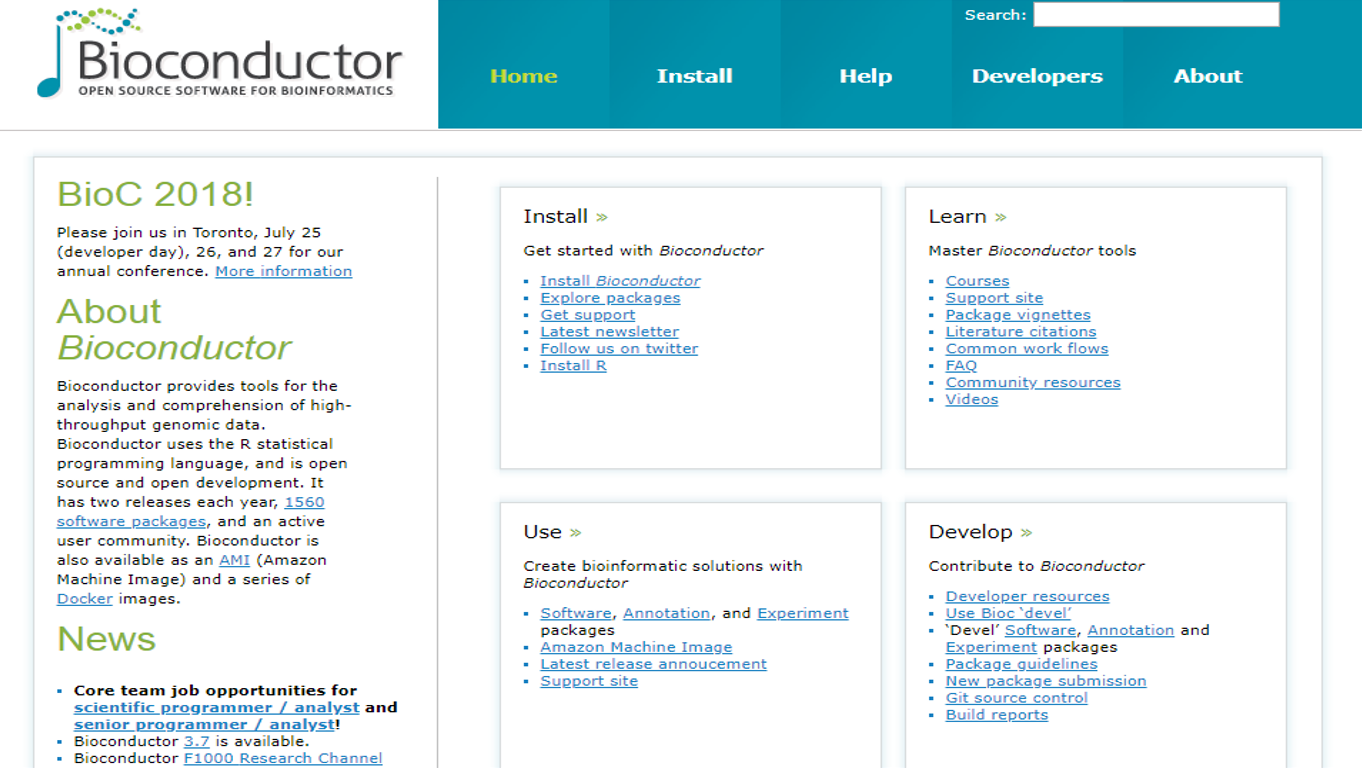
Samengevat werkt Bioconductor aan statistische analyse en begrip van high-throughput genomische data. De focus op statistische analyse komt door de aard van de data. Moderne methoden genereren enorme hoeveelheden data die noodzakelijkerwijs om een statistische samenvatting vragen. Als onderzoekers moeten we gerichte, ontworpen experimenten uitvoeren binnen een statistisch raamwerk. De technologie die moderne genetische datatypen genereert en de labprotocollen die daarna worden toegepast, brengen technologische artefacten met zich mee die met statistische technieken moeten worden aangepakt. Tot slot dwingen compacte uitdagingen rond dataintegratie ons zorgvuldig na te denken over de statistische consequenties van de betrokken stappen.
Bioconductor-software bestaat uit R-add-on-packages. Een R-package is een gestructureerde collectie code (R, C of anders), documentatie en/of data voor het uitvoeren van specifieke soorten analyses, bijvoorbeeld affy-, cluster-, graph-packages. Het biedt implementaties van specifieke statistische en grafische methoden.
In de nieuwste releaseversie van Bioconductor zijn meer dan 1500 packages beschikbaar. Ze kunnen worden ingedeeld in vier typen:
• Analysis software packages: Tools voor het analyseren van high-throughput genomische data, bijv. IMMAN, limma
• Annotation packages: Statische databases met identifier-maps, genmodellen, pathways, enz.; bijv. TxDb.Hsapiens.UCSC.hg19.knownGene
• Illustrative experiment data packages: Datasets die worden gebruikt om softwarefunctionaliteit te illustreren, bijv. airway
• Workflow packages: Documenten die een bio-informatica-workflow beschrijven waarbij meerdere Bioconductor-packages betrokken zijn, om specifieke velden van de biologie zoals proteomics uit te leggen, bijv. highthroughputassays
GenomicRanges: ‘Ranges’ om data en annotatie te beschrijven; GRanges(), GRangesList()
Biostrings: DNA- en andere sequenties, DNAStringSet()
GenomicAlignments: Uitgelijnde reads; GAlignemts() en aanverwanten
GenomicFeatures, AnnotationDbi: annotatiebronnen, TxDb- en org-packages.
SummarizedExperiment: coördineren van experimentele data
rtracklayer: importeren van genoomannotaties, bijv. BED, WIG, GTF, enz.
Als je Bioconductor voor het eerst gebruikt, moet je de nieuwste release van R installeren en vervolgens de nieuwste versie van Bioconductor installeren door R te starten en de volgende commando’s in te voeren:
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
Met deze commando’s worden alle kernpackages van de laatste Bioconductor-releas eversie geïnstalleerd. Voor het installeren van specifieke packages zoals IMMAN en GenomicRanges die beschikbaar zijn in de Bioconductor-repository, kun je de instructies op de packagepagina volgen, zoals met het volgende commando:
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
De functie biocLite() in het package BiocInstaller wordt gebruikt voor het installeren van packages in plaats van de gebruikelijke functie install.packages() in R. De reden hiervoor is dat Bioconductor een aparte repository heeft van CRAN, en de releaseschema’s verschillen van R. Dit kan een mismatch veroorzaken tussen de releasecycli van R en Bioconductor. Hierdoor is de versie die door install.packages() wordt geïdentificeerd vaak niet de meest recente ‘release’ die beschikbaar is.
Na de eerste installatie vind je in dit deel eenvoudige voorbeelden van de Bioconductor-werkruimte om vertrouwd te raken met de context. Hier zijn twee verschillende voorbeelden van diverse componenten van het Bioconductor-project, zoals high-throughput sequencing, statistische analyse en begrip, samengebracht.
Om te beginnen ga je, om kennis te maken met high-throughput data, werken met DNA-sequenties. Hiervoor gebruik je Biostring, een belangrijk package voor het manipuleren van grote biologische sequenties. Daarin kun je DNAStringSet() gebruiken als functie om een set DNAString op te slaan (een string gebaseerd op het DNA-alfabet volgens het IUPAC Extended Genetic Alphabet). Dit kan de invoer omzetten in een XStringSet-object van het DNA-basistype. De letters zijn gecodeerd op een manier die snelle zoekalgoritmen optimaliseert.
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
Vervolgens kunnen we de functie complement() gebruiken om DNA-sequenties te complementeren.
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
Leren werken met packages zoals DNAStringSet en Biostrings betaalt zich terug in andere packages.
In een ander voorbeeld willen we het package GenomicRanges gebruiken, dat is bedoeld om genomische locaties aan te geven binnen het Bioconductor-project. Het biedt een basis voor genomische analyse met drie klassen (GRanges, GPos en GRangesList), die worden gebruikt om genomische ranges, genomische posities en groepen van genomische ranges weer te geven.
De klasse GRanges wordt gebruikt om een set genomische ranges te illustreren die elk één start- en eindlocatie op het genoom hebben. Het slaat de locatie op van genomische features zoals aaneengesloten bindingsplaatsen, transcripten en exonen. We kunnen deze objecten benaderen met de constructorfunctie GRanges zoals hieronder:
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
Het resultaat is een GRanges-object met 10 genomische ranges. Zoals te zien is, verdeelt de functie de informatie in een linker- en rechtergedeelte die gescheiden zijn door | symbolen. De coördinaten van het genoom (seqnames, ranges en strand) staan aan de linkerkant, en de metadatakolommen (annotatie) staan aan de rechterkant. In dit voorbeeld bevatten de metadata de score- en GC-informatie. In principe kan echter bijna alles worden opgeslagen in het metadatagedeelte van een GRanges-object.
De hulp-functies seqnames(), ranges() en strand() worden gebruikt om de componenten van de genomische coördinaten binnen een GRanges-object te extraheren. Bijvoorbeeld,
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
In het laatste voorbeeld wordt een eenvoudig voorbeeld gegeven van het deel statistische analyse van het project. Hiervoor kan de Gene Ontology (GO)-classificatie worden besproken. GO is een verzameling concepten (moleculaire functie, cellulaire component en biologisch proces) die worden gebruikt om genfunctie en de relaties tussen deze concepten te beschrijven. Meer specifiek classificeert GO genen en genproducten hiërarchisch in een graaf die “ontologie” wordt genoemd. Om een toepasbaar voorbeeld te behandelen, kunnen drie Bioconductor-packages worden gebruikt: clusterProfiler, DOSE en org.Hs.eg.db.
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
Het package clusterProfiler is een set methoden die specifiek zijn om functionele profielen zoals GO van genen en genclusters te analyseren en te visualiseren. Hiermee kun je verschillende genen clusteren op basis van hun overeenkomsten. Als voorbeeld is de dataset geneList uit het package DOSE een goede keuze. Deze bevat informatie-inhoud van gen-ID’s. Anderzijds bevat het package org.Hs.eg.db genoom-brede annotatie voor de mens, een sequentierepresentatie van genetisch materiaal verrijkt met informatie over genomische positie.
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
De functie enrichGO() voert de GO-enrichmentanalyse uit op een gegeven vector van genen. Enrichmentanalyse is een benadering om een groep genen te onderscheiden die zijn toegewezen aan een klasse van vooraf gedefinieerde bins op basis van hun functionele specificaties. De verrijkte uitkomst kan zeer algemene termen bevatten. Om deze functie te gebruiken, moet je een argument “OrgDb” invullen. Daarvoor is het package org.Hs.eg.db met menselijke genoom-brede annotatie vereist. Dit package bestaat uit een sequentierepresentatie van genetisch materiaal die is verrijkt met informatie over genomische positie.
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
Om de enrichment map te visualiseren, kun je de functie emapplot() gebruiken. Deze functie toont genensets als een netwerk. Eenvoudig gesteld: onderling overlappende genensets vormen samen een cluster.
emapplot(ego)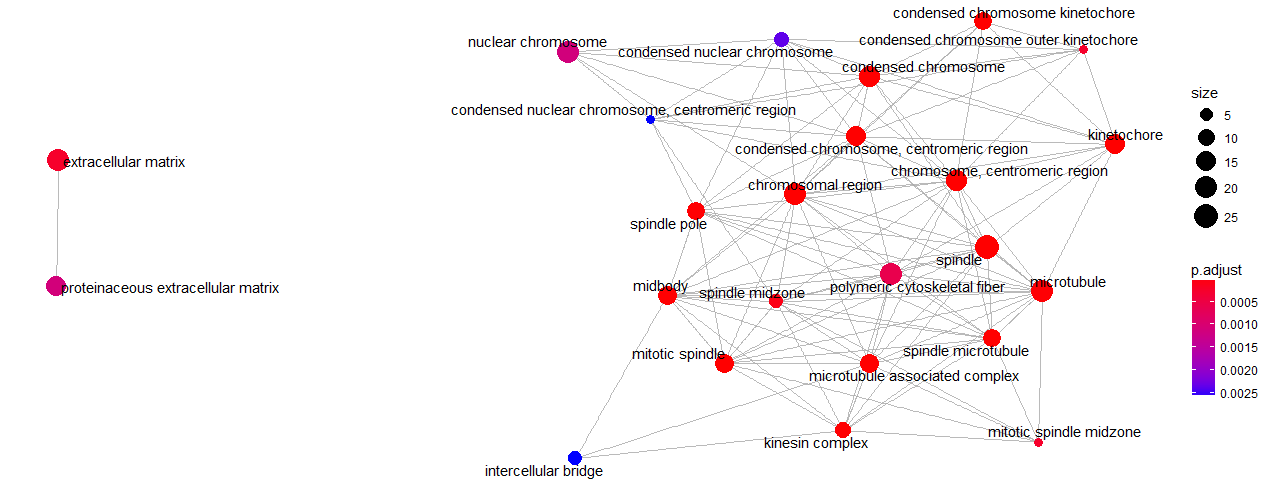
Tijdens het gebruik van Bioconductor-packages kun je bij behoefte aan hulp de volgende commando’s gebruiken:
class(dnaSequence) # Indicate the class of the input object

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # List all available methods for a S3 and S4 generic function or class

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Show the help page of the function

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Refers to all available vignettes of the input package
Daarnaast zijn er veel handige helppagina’s en workflows beschikbaar op de sites van Bioconductor:
Door deze tutorial te lezen, heb je kennisgemaakt met het Bioconductor-project en de fundamentele rol ervan in biologisch onderzoek. Daarnaast zijn de typen Bioconductor-packages en enkele van de belangrijkste genoemd. Vervolgens is kort uitgelegd hoe je het project installeert en gebruikt. Je leerde werken met de packages Biostring en GenomicRanges, en raakte daardoor vertrouwd met DNA-sequenties en genoomranges. In een ander voorbeeld paste je enrichmentanalyse toe op een set menselijke genen. Zo leerde je de concepten enrichmentanalyse en GO kennen. Tot slot zijn verschillende manieren aangegeven om hulp te krijgen tijdens het werken met Bioconductor. Wil je meer weten over het project? Bekijk dan gerust Bioconductor_courses.
Wil je meer leren over R? Volg dan DataCamp's cursus Experimental Design in R.
R-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

