


Kursus
Pengantar R
4 jam
3.1M
Seperti yang kini Anda ketahui, machine learning adalah subbidang dalam Ilmu Komputer (Computer Science/CS). Deep learning adalah subbidang machine learning berisi sekumpulan algoritme yang terinspirasi oleh struktur dan fungsi otak, yang biasanya disebut Jaringan Syaraf Tiruan (Artificial Neural Networks/ANN). Deep learning adalah salah satu tren terpanas dalam machine learning saat ini, dan ada banyak masalah di mana deep learning unggul, seperti robotika, pengenalan citra, dan Kecerdasan Buatan (Artificial Intelligence/AI).
Tutorial hari ini akan memberi Anda pengantar singkat deep learning di R dengan Keras melalui paket keras:
Ingin tahu lebih banyak tentang Keras asli atau konsep penting dalam deep learning seperti perceptron dan Multi-Layer Perceptron (MLP)? Pertimbangkan mengikuti kursus Deep Learning in Python di DataCamp atau mencoba Keras Tutorial: Deep Learning in Python.
Tip: lihat lembar contekan Keras kami di sini.
Seiring meningkatnya popularitas deep learning, CRAN telah diperkaya dengan lebih banyak paket deep learning untuk R; Di bawah ini Anda dapat melihat ringkasan paket-paket tersebut, diambil dari Machine Learning and Statistical Learning CRAN task view. Kolom “Percentile” menunjukkan persentil seperti yang terdapat di RDocumentation:
| Paket R | Persentil | Deskripsi |
|---|---|---|
| nnet | ke-96 | Perangkat lunak untuk jaringan syaraf feed-forward dengan satu hidden layer, dan untuk model log-linear multinomial. |
| neuralnet | ke-96 | Pelatihan jaringan syaraf menggunakan backpropagation |
| h2o | ke-95 | Fungsionalitas scripting R untuk H2O |
| RSNNS | ke-88 | Antarmuka ke Stuttgart Neural Network Simulator (SNNS) |
| tensorflow | ke-88 | Antarmuka ke TensorFlow |
| deepnet | ke-84 | Toolkit deep learning di R |
| darch | ke-79 | Paket untuk Arsitektur Dalam (Deep Architectures) dan Restricted Boltzmann Machines |
| rnn | ke-73 | Paket untuk mengimplementasikan Recurrent Neural Networks (RNN) |
| FCNN4R | ke-52 | Antarmuka ke pustaka FCNN yang memungkinkan ANN yang dapat diperluas oleh pengguna |
| rcppDL | ke-7 | Implementasi metode dasar machine learning dengan banyak layer (deep learning), termasuk dA (Denoising Autoencoder), SdA (Stacked Denoising Autoencoder), RBM (Restricted Boltzmann Machine) dan DBN (Deep Belief Nets) |
| deepr | ??* | Paket untuk merampingkan proses pelatihan, fine-tuning, dan prediksi untuk deep learning berbasis darch dan deepnet |
| MXNetR | ??* | Paket yang menghadirkan komputasi GPU yang fleksibel dan efisien serta deep learning mutakhir ke R |
Tip: untuk perbandingan paket deep learning di R, baca posting blog ini. Untuk informasi lebih lanjut tentang pemeringkatan dan skor di RDocumentation, lihat posting blog ini.
deepr dan MXNetR tidak ditemukan di RDocumentation.org, sehingga persentil untuk kedua paket ini tidak diketahui.
Baru-baru ini, dua paket baru hadir di komunitas R: paket kerasR, yang ditulis dan dibuat oleh Taylor Arnold, dan paket keras dari RStudio.
Kedua paket menyediakan antarmuka R ke paket deep learning Python Keras, yang mungkin sudah pernah Anda dengar, atau bahkan pernah Anda gunakan! Bagi Anda yang belum tahu apa yang ditawarkan paket Keras kepada pengguna Python, Keras adalah “API jaringan syaraf tingkat tinggi, ditulis dalam Python dan mampu berjalan di atas TensorFlow, Microsoft Cognitive Toolkit (CNTK), atau Theano”.
Memulai dengan Keras adalah salah satu cara termudah untuk mengenal deep learning di Python, dan inilah yang menjelaskan mengapa paket kerasR dan keras menyediakan antarmuka untuk paket fantastis ini bagi pengguna R.
Dalam hal ini, ada baiknya Anda memahami apa arti tepatnya ketika sebuah paket, seperti keras di R, adalah “antarmuka” ke paket lain, yaitu Keras di Python. Secara sederhana, ini berarti paket R keras dengan antarmukanya memungkinkan Anda menikmati manfaat pemrograman R sambil tetap memiliki akses ke kapabilitas paket Keras di Python.
Perlu dicatat bahwa praktik ini tidak jarang: misalnya, paket h2o juga menyediakan antarmuka, namun dalam hal ini—dan seperti yang sudah disiratkan namanya—ke H2O, sebuah mesin matematika open-source untuk big data yang dapat Anda gunakan untuk menghitung algoritme machine learning terdistribusi paralel. Paket lain yang mungkin Anda kenal dan menyediakan antarmuka adalah RWeka (antarmuka R ke Weka), tensorflow (antarmuka R ke TensorFlow), openml-r (antarmuka R ke OpenML), … Daftarnya bisa terus berlanjut!
Setelah Anda mengetahui semua ini, Anda mungkin terlebih dahulu bertanya pada diri sendiri: bagaimana membandingkan paket Python asli dengan paket R?
Pada dasarnya, Anda tidak akan menemukan terlalu banyak perbedaan antara paket R dan paket Python asli, terutama karena nama fungsinya hampir semuanya sama; Perbedaan yang Anda perhatikan terutama terletak pada bahasa pemrogramannya sendiri (penugasan variabel, pemuatan pustaka, …), namun hal terpenting yang perlu dicatat adalah sejauh mana fungsionalitas asli telah diadopsi dalam paket R.
Perlu diingat bahwa catatan ini tidak hanya berlaku untuk pustaka keras, tetapi juga untuk tensorflow, openml-r, … dan paket antarmuka lain yang disebutkan di atas!
Kedua, Anda mungkin juga bertanya-tanya apa perbedaan antara kedua paket R ini. Jika Anda ingin mempertimbangkan bagaimana keduanya berbeda, berikut beberapa poin yang bisa dipertimbangkan:
Paket keras menggunakan operator pipa (%>%) untuk menghubungkan fungsi atau operasi, sementara Anda tidak akan menemukannya di kerasR: misalnya, untuk membuat model dengan kerasR, Anda perlu menggunakan operator $. Penggunaan operator pipa umumnya meningkatkan keterbacaan kode, dan Anda pasti sudah pernah melihat operator ini jika Anda pernah bekerja dengan paket Tidyverse sebelumnya.
Anda akan melihat bahwa kerasR berisi fungsi-fungsi yang dinamai mirip, namun tidak persis sama dengan paket Keras asli. Misalnya, fungsi awal (Python) compile() disebut keras_compile(); Hal yang sama berlaku untuk fungsi lain, seperti fit() yang menjadi keras_fit(), atau predict() yang menjadi keras_predict saat Anda menggunakan paket kerasR. Ini semua adalah pembungkus kustom.
Dapat dikatakan bahwa instalasi paket keras dari RStudio lebih mudah daripada instalasi paket kerasR; Untuk memasang yang terakhir, Anda perlu memastikan lebih dulu mengonfigurasi versi Python yang akan digunakan dan ini bisa jadi rumit jika Anda bekerja di PC yang memiliki banyak environment atau versi Python terpasang. Namun saya serahkan penilaian ini kepada Anda :)

Sekarang setelah Anda mengumpulkan sedikit latar belakang, saatnya benar-benar mulai menggunakan Keras di R. Seperti yang telah Anda baca di pengantar tutorial ini, Anda akan terlebih dahulu membahas penyiapan workspace. Lalu, Anda akan memuat beberapa data dan setelah langkah singkat eksplorasi serta praproses data, Anda akan bisa mulai membangun MLP!
Yuk lanjut!
Seperti biasa, langkah pertama untuk mulai menggunakan paket apa pun adalah menyiapkan workspace: memasang dan memuat pustaka ke RStudio atau environment mana pun yang Anda gunakan.
Tenang, untuk tutorial ini, paketnya akan dimuat untuk Anda!
Pertama, pastikan Anda memasang keras: Anda dapat melakukannya dengan mudah dengan menjalankan devtools::install_github("rstudio/keras") di konsol. Selanjutnya, Anda dapat memuat paketnya dan memasang TensorFlow:
# Load in the keras package
library(keras)

# Install TensorFlow
install_tensorflow()
Setelah melakukan ini, Anda siap berangkat! Cepat, bukan?
Tip: untuk informasi lebih lanjut tentang proses instalasi, lihat situs web paket.
Sekarang proses instalasi sudah jelas dan workspace Anda siap, Anda bisa mulai memuat data! Pada titik ini, Anda memiliki tiga opsi besar terkait data Anda: Anda bisa memilih salah satu dataset bawaan yang disertakan dengan paket keras, Anda bisa memuat dataset Anda sendiri dari, misalnya, file CSV, atau Anda bisa membuat data dummy.
Dalam situasi mana pun, Anda akan melihat bahwa Anda dapat mulai menggunakan paket dengan cepat. Bagian ini akan membahas tiga opsi tersebut secara singkat dan menjelaskan bagaimana Anda dapat memuat (atau membuat) data yang Anda butuhkan untuk memulai!
Jika Anda sudah berpengalaman dengan paket Keras di Python, Anda mungkin sudah pernah mengakses dataset bawaan Keras dengan fungsi seperti mnist.load_data(), cifar10.load_data(), atau imdb.load_data().
Berikut contoh memuat data MNIST, CIFAR10, dan IMDB dengan paket keras:
# Read in MNIST data
mnist <- dataset_mnist()

# Read in CIFAR10 data
cifar10 <- dataset_cifar10()

# Read in IMDB data
imdb <- dataset_imdb()
Perhatikan bahwa semua fungsi untuk memuat dataset bawaan dengan keras mengikuti pola yang sama; Untuk data MNIST, Anda akan menggunakan fungsi dataset_mnist() untuk memuat data.
Sebagai alternatif, Anda juga dapat dengan cepat membuat data dummy untuk mulai mencoba. Anda dapat dengan mudah menggunakan fungsi matrix() untuk melakukannya:
Perhatikan bahwa ada baiknya memeriksa struktur data Anda; Penting untuk mengetahui sejak awal data apa yang Anda gunakan karena hal ini diperlukan untuk langkah-langkah selanjutnya. Anda akan mempelajari lebih lanjut soal ini nanti dalam tutorial!
Selain dataset bawaan, Anda juga dapat memuat data dari file. Untuk tutorial ini, Anda akan fokus pada pemuatan data dari file CSV, tetapi jika Anda ingin tahu lebih banyak tentang impor file di R, pertimbangkan R Data Import Tutorial dari DataCamp.
Mari gunakan fungsi read.csv() dari paket read.table untuk memuat dataset dari UCI Machine Learning Repository:
Selalu merupakan ide bagus untuk memeriksa apakah impor data Anda berhasil. Biasanya Anda menggunakan fungsi seperti head(), str(), dan dim() seperti pada cuplikan DataCamp Light di atas untuk melakukannya dengan cepat.
Hasil dari ketiga fungsi ini tidak langsung menunjukkan hal yang janggal; Dengan melihat keluaran fungsi str(), Anda melihat bahwa string pada kolom Species dibaca sebagai faktor. Ini bukan masalah, tapi tentu bagus untuk diketahui untuk langkah-langkah berikutnya, di mana Anda akan mengeksplorasi dan mempraproses data.
Untuk tutorial ini, Anda akan terus bekerja dengan dataset iris yang terkenal, yang Anda impor dengan fungsi read.csv().
Bagi Anda yang tidak memiliki pengetahuan biologi yang diperlukan untuk bekerja dengan data ini, berikut sedikit latar belakang: semua bunga memiliki sepal dan petal. Sepal menyelimuti petal dan biasanya berwarna hijau serta mirip daun, sementara petal umumnya berupa daun berwarna. Untuk bunga iris, ini sedikit berbeda, seperti yang dapat Anda lihat pada gambar berikut:

Anda mungkin sudah melihat pada bagian sebelumnya bahwa data frame iris tidak memiliki nama kolom setelah impor. Untuk sisa tutorial, itu tidak terlalu penting: meskipun fungsi read.csv() mengembalikan data dalam data.frame, data yang perlu Anda operkan ke fungsi fit() harus berupa matriks atau array.
Beberapa hal yang perlu diingat tentang dua struktur data yang baru saja disebutkan: - Matriks dan array tidak memiliki nama kolom; - Matriks adalah objek dua dimensi dengan satu tipe data; - Array adalah objek multi-dimensi dengan satu tipe data;
Tip: Tonton video ini jika Anda ingin mengulas kembali struktur data di R!
Perlu dicatat bahwa data frame, di sisi lain, adalah jenis daftar bernama khusus di mana semua elemen memiliki panjang yang sama. Ini adalah objek multi-dimensi yang dapat berisi beberapa tipe data. Anda sudah melihat ini benar ketika Anda memeriksa struktur data frame iris pada bagian sebelumnya. Dengan mengetahui hal ini dan mempertimbangkan bahwa Anda perlu bekerja menuju objek dua atau multi-dimensi dengan satu tipe data, Anda sebaiknya sudah bersiap melakukan sedikit prapemrosesan sebelum mulai membangun jaringan syaraf!
Untuk saat ini, nama kolom bisa berguna untuk keperluan eksplorasi, dan tentunya akan memudahkan pemahaman Anda atas data, jadi mari tambahkan beberapa nama kolom dengan bantuan fungsi names(). Selanjutnya, Anda bisa langsung menggunakan variabel iris dalam eksplorasi data! Plot, misalnya, bagaimana korelasi panjang petal dan lebar petal dengan fungsi plot().
Perhatikan bahwa Anda menggunakan fungsi unclass() untuk mengonversi nama spesies, yaitu “setosa, versicolor”, dan “virginica”, menjadi numerik 1, 2, dan 3.
Sekarang lihat lebih dekat hasil fungsi plot:

Grafik menunjukkan korelasi positif antara Petal.Length dan Petal.Width untuk berbagai spesies bunga iris. Namun, ini adalah sesuatu yang mungkin ingin Anda uji dengan fungsi cor(), yang akan memberikan korelasi keseluruhan antara semua atribut yang disertakan dalam dataset:
Selain itu, Anda dapat menggunakan paket corrplot bersama fungsi cor() untuk memplot korelasi antar atribut data Anda; Dalam kasus ini, Anda menghitung korelasi keseluruhan untuk semua atribut data frame iris. Anda menyimpan hasil perhitungan ini dalam variabel M dan mengopernya ke fungsi corrplot().
Juga, jangan lupa menentukan argumen method untuk menunjukkan bagaimana Anda ingin data diplot!
Anda dapat bereksperimen lebih lanjut dengan metode visualisasi pada cuplikan DataCamp Light di bawah ini:

Gunakan konsol R untuk mengeksplorasi data Anda lebih lanjut.
Jika Anda ingin membuat plot untuk data ini dengan paket ggvis, yaitu tata bahasa grafik interaktif, lihat tutorial Machine Learning in R For Beginners dari DataCamp atau ikuti kursus ggvis dari DataCamp.
Sebelum Anda dapat membangun model, Anda juga perlu memastikan bahwa data Anda dibersihkan, dinormalisasi (jika perlu) dan dibagi menjadi set pelatihan dan pengujian. Karena dataset berasal dari UCI Machine Learning Repository, Anda dapat mengharapkannya sudah cukup bersih, tetapi mari kita periksa ulang kualitas data Anda.
Sekilas, saat Anda memeriksa data dengan head(), Anda tidak benar-benar melihat hal yang janggal, bukan? Mari gunakan summary() dan str() untuk secara singkat mengulas apa yang Anda pelajari ketika memeriksa apakah impor data Anda berhasil:
Sekarang Anda yakin bahwa data cukup bersih, Anda dapat mulai memeriksa apakah normalisasi diperlukan untuk data apa pun yang Anda gunakan dalam tutorial ini.
Dari hasil fungsi summary() pada cuplikan DataCamp Light di atas, Anda melihat bahwa dataset Iris tidak perlu dinormalisasi: atribut Sepal.Length memiliki nilai dari 4.3 hingga 7.9 dan Sepal.Width berisi nilai dari 2 hingga 4.4, sementara nilai Petal.Length berkisar dari 1 hingga 6.9 dan Petal.Width dari 0.1 hingga 2.5. Dengan kata lain, semua nilai dari semua atribut dataset Iris berada dalam rentang 0.1 hingga 7.9, yang dapat dianggap dapat diterima.
Namun, masih merupakan ide bagus untuk mempelajari efek normalisasi pada data Anda; Anda bahkan bisa mencoba mengoper data yang telah dinormalisasi ke model Anda untuk melihat apakah ada efeknya. Ini berada di luar cakupan tutorial ini, tetapi silakan coba sendiri! Kodenya sudah ada semua di tutorial ini :)
Anda dapat membuat fungsi sendiri untuk menormalisasi data iris; Dalam kasus ini, itu adalah fungsi normalisasi min-maks, yang mentransformasikan data Anda secara linear ke fungsi (x-min)/(max-min). Dari sudut pandang tersebut, menerjemahkan rumus ini ke R cukup sederhana: Anda membuat fungsi yang menerima x atau beberapa data. Anda kemudian menghitung hasil pengurangan pertama x-min dan menyimpan hasilnya di num. Selanjutnya, Anda juga menghitung max-min dan menyimpan hasilnya di denom. Hasil fungsi normalize() Anda seharusnya mengembalikan pembagian num oleh max.
Untuk menerapkan fungsi buatan pengguna ini pada data iris Anda (nilai target dikecualikan), Anda tidak hanya perlu menggunakan normalize, tetapi juga fungsi lapply() untuk menormalisasi data, seperti di bawah ini:
Tip gunakan fungsi hist() di konsol R untuk mempelajari distribusi data Iris sebelum (iris) dan setelah normalisasi (iris_norm).
Untuk menggunakan fungsi normalize() dari paket keras, Anda pertama-tama perlu memastikan bahwa Anda bekerja dengan matriks. Seperti yang mungkin Anda ingat dari sebelumnya, ciri matriks adalah bahwa elemen data matriks memiliki tipe dasar yang sama; Dalam kasus ini, Anda memiliki nilai target bertipe faktor, sementara sisanya numerik.
Ini perlu diubah terlebih dahulu.
Anda dapat menggunakan fungsi as.numeric() untuk mengonversi data menjadi angka:
Data frame numerik sudah oke, tetapi Anda perlu mengonversi data menjadi array atau matriks jika ingin menggunakan paket keras. Anda dapat melakukannya dengan mudah dengan fungsi as.matrix(); Jangan lupa untuk mengatur dimnames ke NULL.
Seperti yang mungkin telah Anda baca pada bagian di atas, menormalisasi data Iris tidak diperlukan. Namun demikian, tetap merupakan ide bagus untuk mempelajari normalisasi dan efeknya, serta melihat bagaimana ini tidak hanya dapat dilakukan dengan UDF tetapi juga dengan fungsi normalize() bawaan keras.
Dengan data Anda dikonversi menjadi matriks, Anda memang juga dapat menggunakan paket keras untuk mempelajari efek kemungkinan normalisasi pada data Anda:
Perhatikan bahwa di sini, Anda menggunakan dimnames() untuk mengatur dimnames dari iris menjadi NULL. Ini memastikan tidak ada nama kolom dalam data Anda.
Sekarang setelah Anda memeriksa kualitas data dan mengetahui bahwa normalisasi tidak diperlukan, Anda dapat melanjutkan bekerja dengan data asli dan membaginya menjadi set pelatihan dan pengujian sehingga akhirnya Anda siap untuk mulai membangun model. Dengan melakukan ini, Anda memastikan bahwa Anda dapat membuat penilaian yang jujur terhadap kinerja model prediksi Anda nanti.
Sebelum membagi data menjadi set pelatihan dan pengujian, sebaiknya Anda menetapkan seed terlebih dahulu. Anda dapat dengan mudah melakukannya dengan set.seed(): gunakan fungsi ini dan operkan bilangan bulat acak. Seed adalah angka untuk generator bilangan acak R. Keuntungan utama menetapkan seed adalah Anda dapat memperoleh urutan bilangan acak yang sama setiap kali Anda memberikan seed yang sama pada generator bilangan acak.
Ini sangat baik untuk keberulangan (reproducibility) kode Anda!
Anda menggunakan fungsi sample() untuk mengambil sampel dengan ukuran yang ditetapkan sebagai jumlah baris pada dataset Iris, yaitu 150. Anda mengambil sampel dengan pengembalian (with replacement): Anda memilih dari vektor berisi 2 elemen dan menetapkan 1 atau 2 ke 150 baris dataset Iris. Penetapan elemen tunduk pada bobot probabilitas 0,67 dan 0,33.
Argumen replace pada fungsi sample() diatur ke TRUE, yang berarti Anda menetapkan 1 atau 2 pada baris tertentu lalu mengembalikan vektor berisi 2 elemen ke keadaan semula.
Dengan kata lain, untuk baris berikutnya dalam dataset Anda, Anda bisa menetapkan 1 atau 2, setiap kali lagi. Probabilitas memilih 1 atau 2 tidak boleh proporsional terhadap bobot di antara item yang tersisa, sehingga Anda menentukan bobot probabilitas.
Catatan samping: jika Anda menggunakan dataset bawaan dengan fungsi khusus dataset_imdb(), misalnya, data Anda dapat dengan mudah dibagi menggunakan operator $:
x_train <- imdb$train$x
y_train <- imdb$train$y
x_test <- imdb$test$x
y_test <- imdb$test$y
Anda telah berhasil membagi data Anda, tetapi masih ada satu langkah yang perlu Anda lakukan untuk mulai membangun model. Bisa tebak yang mana?
Saat Anda ingin memodelkan masalah klasifikasi multikelas dengan jaringan syaraf, secara umum praktik yang baik adalah memastikan Anda mentransformasikan atribut target dari vektor yang berisi nilai untuk setiap kelas ke matriks dengan nilai boolean untuk setiap kelas dan apakah suatu instance memiliki nilai kelas tersebut atau tidak.
Ini adalah penjelasan bebas dari One Hot Encoding (OHE). Terdengar cukup kompleks, bukan?
Untungnya, paket keras memiliki fungsi to_categorical() yang akan melakukan semua ini untuk Anda; Operkan iris.trainingtarget dan iris.testtarget ke fungsi ini dan simpan hasilnya di iris.trainLabels dan iris.testLabels:
Sekarang Anda resmi mencapai akhir langkah eksplorasi dan prapemrosesan dalam tutorial ini. Anda sekarang dapat lanjut membangun jaringan syaraf dengan keras!
Untuk mulai membangun model, Anda perlu terlebih dahulu menginisialisasi model sequential dengan bantuan fungsi keras_model_sequential(). Lalu, Anda siap mulai memodelkan.
Namun, sebelum mulai, ada baiknya meninjau kembali pertanyaan awal Anda tentang dataset ini: bisakah Anda memprediksi spesies bunga Iris tertentu? Lebih mudah bekerja dengan data numerik, dan Anda telah mempraproses data serta melakukan one-hot encoding pada nilai variabel target: sebuah bunga adalah salah satu dari jenis versicolor, setosa, atau virginica dan ini direfleksikan dengan nilai biner 1 dan 0.
Jenis jaringan yang berkinerja baik pada masalah seperti ini adalah multi-layer perceptron. Jenis jaringan syaraf ini sering kali fully connected. Itu berarti Anda ingin membangun tumpukan layer fully connected yang relatif sederhana untuk menyelesaikan masalah ini. Untuk fungsi aktivasi yang akan Anda gunakan, sebaiknya gunakan salah satu yang paling umum di sini demi tujuan berkenalan dengan Keras dan jaringan syaraf, yaitu fungsi aktivasi relu. Fungsi aktivasi rectifier ini digunakan pada hidden layer, yang secara umum merupakan praktik yang baik.
Selain itu, Anda juga melihat bahwa fungsi aktivasi softmax digunakan pada output layer. Anda melakukan ini karena ingin memastikan nilai keluaran berada pada rentang 0 hingga 1 dan dapat digunakan sebagai probabilitas prediksi:
Perhatikan bagaimana output layer menghasilkan 3 nilai keluaran, masing-masing untuk setiap kelas Iris (versicolor, virginica, atau setosa). Layer pertama, yang berisi 8 node tersembunyi, memiliki input_shape sebesar 4. Ini karena data pelatihan Anda iris.training memiliki 4 kolom.
Anda dapat memeriksa model lebih lanjut dengan fungsi berikut:
Sekarang setelah Anda menyiapkan arsitektur model, saatnya mengompilasi dan menyesuaikan model dengan data. Untuk mengompilasi model, Anda mengonfigurasinya dengan optimizer adam dan fungsi loss categorical_crossentropy. Selain itu, Anda juga memantau akurasi selama pelatihan dengan mengoper 'accuracy' ke argumen metrics.
Optimizer dan loss adalah dua argumen yang diperlukan jika Anda ingin mengompilasi model.
Beberapa algoritma optimisasi paling populer yang digunakan adalah Stochastic Gradient Descent (SGD), ADAM, dan RMSprop. Bergantung pada algoritma yang Anda pilih, Anda perlu menyetel parameter tertentu, seperti laju pembelajaran (learning rate) atau momentum. Pemilihan fungsi loss bergantung pada tugas yang Anda kerjakan: misalnya, untuk masalah regresi, Anda biasanya menggunakan Mean Squared Error (MSE).
Seperti yang Anda lihat pada contoh ini, Anda menggunakan fungsi loss categorical_crossentropy untuk masalah klasifikasi multi-kelas untuk menentukan apakah iris bertipe versicolor, virginica, atau setosa. Namun, perhatikan bahwa jika Anda memiliki masalah klasifikasi biner, Anda sebaiknya menggunakan fungsi loss binary_crossentropy.
Selanjutnya, Anda juga dapat melakukan fitting model ke data Anda; Dalam kasus ini, Anda melatih model selama 200 epoch atau iterasi atas semua sampel di iris.training dan iris.trainLabels, dengan batch berisi 5 sampel.
Tip jika Anda mau, Anda juga dapat menentukan argumen verbose di fungsi fit(). Dengan menyetel argumen ini ke 1, Anda menyatakan bahwa Anda ingin melihat log progress bar.
Yang Anda lakukan dengan kode di atas adalah melatih model untuk jumlah epoch tertentu atau paparan terhadap dataset pelatihan. Satu epoch adalah satu kali lintasan melalui seluruh set pelatihan, diikuti dengan pengujian set verifikasi. Ukuran batch yang Anda tentukan dalam kode di atas mendefinisikan jumlah sampel yang akan dipropagasikan melalui jaringan. Selain itu, dengan cara ini, Anda mengoptimalkan efisiensi karena Anda memastikan tidak memuat terlalu banyak pola masukan ke dalam memori secara bersamaan.
Selain itu, ada baiknya Anda tahu bahwa Anda juga dapat memvisualisasikan proses fitting jika Anda menyimpan baris kode pada potongan DataCamp Light di atas ke dalam sebuah variabel. Anda kemudian dapat meneruskan variabel tersebut ke fungsi plot(), seperti yang Anda lihat pada potongan kode ini!
Pastikan untuk mempelajari plot tersebut lebih detail.
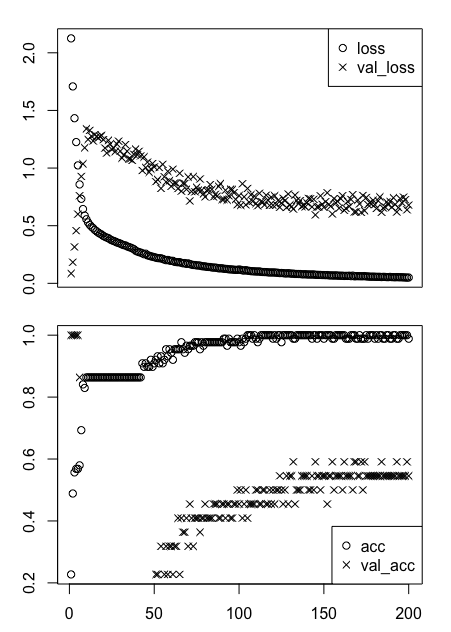
Sekilas, tidak mengherankan jika semuanya terlihat agak berantakan. Anda mungkin tidak sepenuhnya tahu apa yang sedang Anda lihat, bukan?
Satu hal yang baik untuk diketahui adalah bahwa loss dan acc menunjukkan loss dan akurasi model untuk data pelatihan, sementara val_loss dan val_acc adalah metrik yang sama, loss dan akurasi, untuk data uji atau validasi.
Tetapi, meskipun Anda sudah tahu ini, tidak mudah untuk menafsirkan kedua grafik tersebut. Mari kita coba membaginya menjadi bagian-bagian yang mungkin lebih mudah Anda pahami! Anda akan memisahkan dua plot ini dan membuat dua plot terpisah: satu untuk loss model dan satu lagi untuk akurasi model. Untungnya, Anda bisa dengan mudah menggunakan operator $ untuk mengakses data dan memplotnya selangkah demi selangkah.
Lihat kotak DataCamp Light di bawah untuk melihat bagaimana Anda dapat melakukannya:
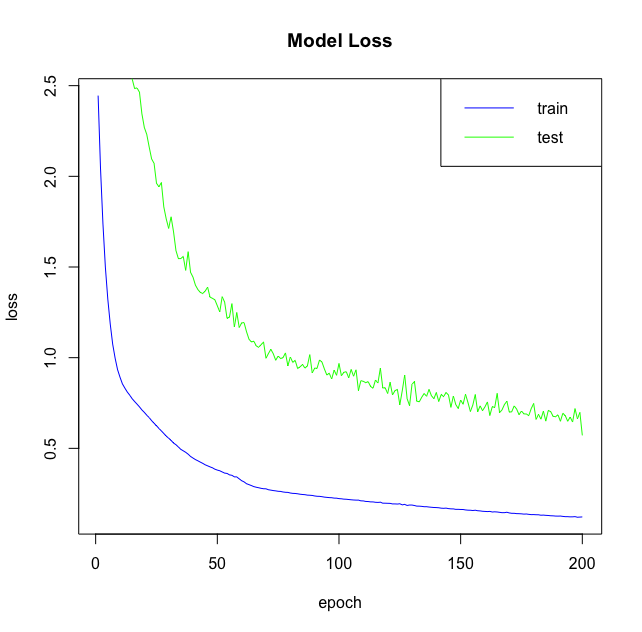
Dalam plot pertama ini, Anda memplot loss model pada data pelatihan dan data uji. Sekarang saatnya melakukan hal yang sama, tetapi untuk akurasi model:
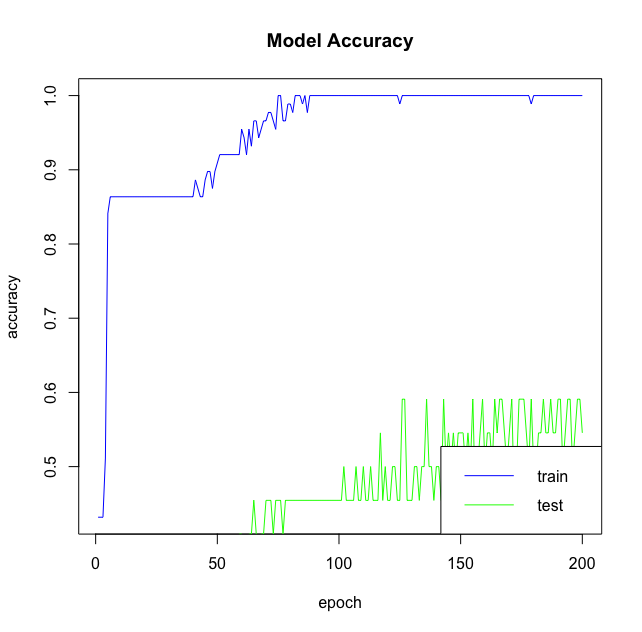
Beberapa hal yang perlu diingat di sini adalah sebagai berikut:
Sekarang model Anda sudah dibuat, dikompilasi, dan telah difit ke data, saatnya benar-benar menggunakan model Anda untuk memprediksi label untuk set uji iris.test Anda. Seperti yang mungkin Anda harapkan, Anda dapat menggunakan fungsi predict() untuk melakukannya. Setelah itu, Anda dapat mencetak confusion matrix untuk melihat prediksi dan label sebenarnya dari data iris.test dengan bantuan fungsi table().
Bagaimana menurut Anda hasilnya? Sekilas, apakah model yang Anda buat ini memberikan prediksi yang tepat?
Meski Anda sudah punya gambaran kecil tentang kinerja model dengan melihat label yang diprediksi untuk iris.test, tetap penting untuk meluangkan waktu mengevaluasi model Anda. Gunakan fungsi evaluate() untuk melakukannya: masukkan data uji iris.test, label uji iris.testLabels, dan tentukan ukuran batch. Simpan hasilnya dalam variabel score, seperti pada contoh kode di bawah ini:
Dengan mencetak score, Anda akan mendapatkan nilai loss dan nilai metrik (dalam kasus ini 'accuracy').
Fine-tuning model Anda kemungkinan akan sering Anda lakukan, terutama di awal, karena tidak semua masalah klasifikasi dan regresi sesederhana yang Anda lihat di bagian pertama tutorial ini. Seperti yang Anda baca di atas, sudah ada dua keputusan kunci yang mungkin ingin Anda sesuaikan: berapa banyak layer yang akan digunakan dan berapa banyak “hidden unit” yang akan Anda pilih untuk tiap layer.
Pada awalnya, ini benar-benar akan menjadi sebuah perjalanan.
Selain mencoba-coba jumlah epoch atau ukuran batch, ada cara lain untuk menyetel model Anda dengan harapan kinerjanya lebih baik: dengan menambahkan layer, menambah jumlah hidden unit, dan meneruskan parameter optimisasi Anda sendiri ke fungsi compile(). Bagian ini akan membahas ketiga opsi tersebut.
Apa yang akan terjadi jika Anda menambahkan satu layer lagi ke model Anda? Bagaimana jika tampilannya seperti ini?
Perhatikan bahwa Anda juga dapat memvisualisasikan metrik loss dan accuracy dari model baru ini! Cobalah pada potongan DataCamp Light di bawah ini:
|
|
|
Selain menambahkan layer dan mencoba-coba hidden unit, Anda juga dapat menyesuaikan (sebagian) parameter dari algoritma optimisasi yang Anda berikan ke fungsi compile(). Sampai sekarang, Anda selalu meneruskan sebuah vektor berisi string, adam, ke argumen optimizer.
Tetapi itu tidak selalu harus begitu!
Cobalah juga bereksperimen dengan algoritma optimisasi lain, seperti Stochastic Gradient Descent (SGD). Coba, misalnya, gunakan fungsi optimizer_sgd() untuk menyetel laju pembelajaran lr. Apakah Anda melihat efeknya?
Selain menggunakan optimizer lain, Anda juga bisa mencoba menggunakan laju pembelajaran yang lebih kecil untuk melatih jaringan Anda. Ini adalah salah satu teknik fine-tuning yang paling umum; Praktik umum adalah membuat learning rate awal 10 kali lebih kecil dari yang Anda gunakan untuk melatih model sebelumnya.
Mari kita visualisasikan lagi riwayat pelatihan untuk melihat efek dari penyesuaian kecil ini:
|
|
|
Ada satu hal terakhir dalam perjalanan Anda dengan paket keras, yaitu menyimpan atau mengekspor model Anda sehingga Anda dapat memuatnya kembali di waktu lain.
save_model_hdf5(model, "my_model.h5")
model <- load_model_hdf5("my_model.h5")
save_model_weights_hdf5("my_model_weights.h5")
model %>% load_model_weights_hdf5("my_model_weights.h5")
json_string <- model_to_json(model)
model <- model_from_json(json_string)

yaml_string <- model_to_yaml(model)
model <- model_from_yaml(yaml_string)
Selamat! Anda telah menyelesaikan tutorial deep learning di R dengan keras ini. Tutorial ini hanyalah satu langkah kecil dalam perjalanan deep learning Anda dengan R; Masih banyak yang perlu dipelajari! Jika Anda belum mengikuti kursus Deep Learning in Python dari DataCamp, Anda mungkin bisa mempertimbangkannya.
Sambil menunggu, pastikan juga untuk melihat dokumentasi Keras dan dokumentasi keras dari RStudio jika Anda belum melakukannya. Anda akan menemukan lebih banyak contoh dan informasi tentang semua fungsi, argumen, lebih banyak layer, dan sebagainya. Selain itu, lihat juga buku François Chollet “Deep Learning with Python”. Semua sumber ini tidak diragukan lagi akan sangat berguna untuk mempelajari cara bekerja dengan jaringan saraf di R!
Kursus terkait
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



