Vai al contenuto principale

keras: Deep Learning in R

In questo tutorial sul deep learning in R con il pacchetto keras di RStudio, imparerai a costruire un Multi-Layer Perceptron (MLP).
Aggiornato 29 set 2026  · 15 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Come ormai saprai, il machine learning è una sottoarea dell’Informatica (CS). Il deep learning, a sua volta, è una sottoarea del machine learning: un insieme di algoritmi ispirati alla struttura e al funzionamento del cervello, di solito chiamati Reti Neurali Artificiali (ANN). Il deep learning è una delle tendenze più calde del machine learning in questo momento e dà ottimi risultati in molti ambiti, come la robotica, il riconoscimento di immagini e l’Intelligenza Artificiale (AI).

Il tutorial di oggi ti darà una breve introduzione al deep learning in R con Keras tramite il pacchetto keras:

Vuoi saperne di più sul Keras originale o su concetti fondamentali del deep learning come i perceptron e i Perceptron Multistrato (MLP)? Prendi in considerazione il corso di DataCamp Deep Learning in Python o prova il Keras Tutorial: Deep Learning in Python.

Consiglio: trovi il nostro cheat sheet di Keras qui.

Deep Learning in R: breve panoramica dei pacchetti

Con l’aumentare della popolarità del deep learning, CRAN si è arricchito di più pacchetti R per il deep learning; qui sotto puoi vedere una panoramica di questi pacchetti, tratta dalla CRAN Task View Machine Learning and Statistical Learning. La colonna “Percentile” indica il percentile come riportato su RDocumentation:

Pacchetto R Percentile Descrizione
nnet 96th Software per reti neurali feed-forward con un singolo hidden layer e per modelli log-lineari multinomiali.
neuralnet 96th Addestramento di reti neurali tramite backpropagation
h2o 95th Funzionalità di scripting R per H2O
RSNNS 88th Interfaccia allo Stuttgart Neural Network Simulator (SNNS)
tensorflow 88th Interfaccia a TensorFlow
deepnet 84th Toolkit di deep learning in R
darch 79th Pacchetto per Deep Architectures e Restricted Boltzmann Machines
rnn 73rd Pacchetto per implementare Recurrent Neural Networks (RRN)
FCNN4R 52nd Interfaccia alla libreria FCNN che consente ANNs estendibili dall’utente
rcppDL 7th Implementazione di metodi base di machine learning con molti layer (deep learning), tra cui dA (Denoising Autoencoder), SdA (Stacked Denoising Autoencoder), RBM (Restricted Boltzmann Machine) e DBN (Deep Belief Nets)
deepr ??* Pacchetto per semplificare i processi di training, fine-tuning e predizione per il deep learning basato su darch e deepnet
MXNetR ??* Pacchetto che porta calcolo GPU flessibile ed efficiente e deep learning allo stato dell’arte in R

Consiglio: per un confronto tra pacchetti di deep learning in R, leggi questo post. Per maggiori informazioni su ranking e punteggio in RDocumentation, dai un’occhiata a questo post.

I pacchetti deepr e MXNetR non sono stati trovati su RDocumentation.org, quindi il percentile è sconosciuto per questi due pacchetti.

Keras, keras e kerasR

Di recente, due nuovi pacchetti sono approdati nella community R: il pacchetto kerasR, creato da Taylor Arnold, e il pacchetto keras di RStudio.

Entrambi forniscono un’interfaccia R al pacchetto Python di deep learning Keras, di cui potresti aver già sentito parlare o con cui magari hai già lavorato! Per chi non conosce cosa offre il pacchetto Keras agli utenti Python, è “un’API di reti neurali ad alto livello, scritta in Python e in grado di girare sopra TensorFlow, Microsoft Cognitive Toolkit (CNTK) o Theano”.

Interfacce?

Iniziare con Keras è uno dei modi più semplici per familiarizzare con il deep learning in Python, e questo spiega anche perché i pacchetti kerasR e keras forniscono un’interfaccia a questo pacchetto fantastico per gli utenti R.

In questo caso, è utile capire cosa significhi esattamente quando un pacchetto, come l’R keras, è “un’interfaccia” a un altro pacchetto, il Keras di Python. In termini semplici, questo significa che il pacchetto R keras, grazie all’interfaccia, ti permette di godere dei vantaggi della programmazione in R avendo accesso alle capacità del pacchetto Keras in Python.

Nota che non è una pratica insolita: ad esempio, anche il pacchetto h2o fornisce un’interfaccia, ma in questo caso –e come il nome già suggerisce– a H2O, un motore matematico open source per big data che puoi usare per calcolare algoritmi di machine learning distribuiti in parallelo. Altri pacchetti che potresti conoscere e che forniscono interfacce sono RWeka (interfaccia R a Weka), tensorflow (interfaccia R a TensorFlow), openml-r (interfaccia R a OpenML), … L’elenco potrebbe continuare all’infinito!

Qual è la differenza tra Keras, keras e kerasR?

Ora che sai tutto questo, potresti porti prima di tutto la seguente domanda: come compareresti il pacchetto originale in Python con i pacchetti in R?

In sostanza, non troverai troppe differenze tra i pacchetti R e il pacchetto originale in Python, soprattutto perché i nomi delle funzioni sono quasi tutti uguali; le uniche differenze che noti riguardano principalmente i linguaggi (assegnazione delle variabili, caricamento delle librerie, …), ma la cosa più importante da osservare è quanto della funzionalità originale sia stata incorporata nel pacchetto R.

Nota che questa osservazione non vale solo per la libreria keras, ma anche per tensorflow, openml-r, … e gli altri pacchetti di interfaccia citati sopra!

In secondo luogo, potresti anche chiederti quale sia allora la differenza tra questi due pacchetti R. Ebbene, se vuoi considerare in cosa differiscono, potresti tenere presenti i seguenti punti:

  • Il pacchetto keras usa il pipe operator (%>%) per collegare funzioni o operazioni, mentre non lo troverai in kerasR: ad esempio, per costruire il modello con kerasR, vedrai che devi usare l’operatore $. L’uso del pipe operator generalmente migliora la leggibilità del codice, e lo avrai sicuramente già visto se hai lavorato con i pacchetti Tidyverse.

  • Vedrai che kerasR contiene funzioni con nomi simili, ma non identici, a quelli del pacchetto Keras originale. Ad esempio, la funzione iniziale (Python) compile() si chiama keras_compile(); lo stesso vale per altre funzioni, come fit(), che diventa keras_fit(), o predict(), che diventa keras_predict quando usi il pacchetto kerasR. Sono tutti wrapper personalizzati.

  • Si può sostenere che l’installazione del pacchetto keras di RStudio sia più facile rispetto a quella del pacchetto kerasR; per installare quest’ultimo, infatti, devi prima assicurarti di configurare quale versione di Python usare e questo può diventare complicato se lavori su un PC con più ambienti o versioni di Python installate. Ma lascio a te la decisione :)

data science courses banner

Ora che hai raccolto un po’ di background, è il momento di iniziare davvero con Keras in R. Come avrai letto nell’introduzione del tutorial, prima passerai alla configurazione del tuo workspace. Poi caricherai alcuni dati e, dopo una breve fase di esplorazione e preprocessing, potrai iniziare a costruire il tuo MLP!

Andiamo avanti!

Installazione del pacchetto keras

Come sempre, il primo passo per iniziare con qualsiasi pacchetto è impostare il tuo workspace: installa e carica la libreria in RStudio o nell’ambiente in cui lavori.

Nessun problema, per questo tutorial il pacchetto verrà caricato per te!

Per prima cosa, assicurati di installare keras: puoi farlo facilmente eseguendo devtools::install_github("rstudio/keras") nella console. Poi puoi caricare il pacchetto e installare TensorFlow:

# Load in the keras package
library(keras)

# Install TensorFlow
install_tensorflow()

Una volta fatto questo, sei a posto! Veloce, vero?

Consiglio: per maggiori informazioni sul processo di installazione, consulta il sito del pacchetto.

Caricare i dati

Ora che il processo di installazione è chiaro e il tuo workspace è pronto, puoi iniziare a caricare i tuoi dati! A questo punto hai tre grandi opzioni: puoi usare uno dei dataset integrati che arrivano con il pacchetto keras, puoi caricare un tuo dataset da, per esempio, file CSV, oppure puoi creare dei dati fittizi.

Qualunque sia la situazione, vedrai che riuscirai a iniziare rapidamente con il pacchetto. Questa sezione passerà rapidamente in rassegna le tre opzioni e spiegherà come puoi caricare (o creare) i dati di cui hai bisogno per metterti all’opera!

Dataset integrati

Se hai già esperienza con il pacchetto Keras in Python, probabilmente avrai già usato i dataset integrati di Keras con funzioni come mnist.load_data(), cifar10.load_data() o imdb.load_data().

Ecco alcuni esempi in cui carichi i dati MNIST, CIFAR10 e IMDB con il pacchetto keras:

# Read in MNIST data
mnist <- dataset_mnist()

# Read in CIFAR10 data
cifar10 <- dataset_cifar10()

# Read in IMDB data
imdb <- dataset_imdb()

Nota che tutte le funzioni per caricare dataset integrati con keras seguono lo stesso schema; per i dati MNIST, userai la funzione dataset_mnist() per caricare i tuoi dati.

Dati fittizi

In alternativa, puoi anche creare rapidamente dei dati fittizi per iniziare. Puoi farlo facilmente con la funzione matrix():

eyJsYW5ndWFnZSI6InIiLCJzYW1wbGUiOiIjIE1ha2UgeW91ciBkdW1teSBkYXRhXG5kYXRhIDwtIG1hdHJpeChyZXhwKDEwMDAqNzg0KSwgbnJvdyA9IDEwMDAsIG5jb2wgPSA3ODQpXG5cbiMgTWFrZSBkdW1teSB0YXJnZXQgdmFsdWVzIGZvciB5b3VyIGR1bW15IGRhdGFcbmxhYmVscyA8LSBtYXRyaXgocm91bmQocnVuaWYoMTAwMCoxMCwgbWluID0gMCwgbWF4ID0gOSkpLCBucm93ID0gMTAwMCwgbmNvbCA9IDEwKSJ9

Ricorda che è una buona idea controllare la struttura dei tuoi dati; è fondamentale sapere già su quali dati stai lavorando, perché sarà necessario per i passaggi successivi. Ne parlerai più avanti nel tutorial!

Lettura dei dati da file

Oltre ai dataset integrati, puoi anche caricare dati da file. In questo tutorial, ti concentrerai sul caricamento di dati da file CSV, ma se vuoi saperne di più sull’import dei file in R, considera l’R Data Import Tutorial di DataCamp.

Usiamo la funzione read.csv() dal pacchetto read.table per caricare un dataset dall’UCI Machine Learning Repository:

eyJsYW5ndWFnZSI6InIiLCJzYW1wbGUiOiIjIFJlYWQgaW4gYGlyaXNgIGRhdGFcbmlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcblxuIyBSZXR1cm4gdGhlIGZpcnN0IHBhcnQgb2YgYGlyaXNgXG5oZWFkKC4uLi4pXG5cbiMgSW5zcGVjdCB0aGUgc3RydWN0dXJlXG5zdHIoLi4uLilcblxuIyBPYnRhaW4gdGhlIGRpbWVuc2lvbnNcbmRpbSguLi4uKSIsInNvbHV0aW9uIjoiIyBSZWFkIGluIGBpcmlzYCBkYXRhXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCBwYXJ0IG9mIGBpcmlzYFxuaGVhZChpcmlzKVxuXG4jIEluc3BlY3QgdGhlIHN0cnVjdHVyZVxuc3RyKGlyaXMpXG5cbiMgT2J0YWluIHRoZSBkaW1lbnNpb25zXG5kaW0oaXJpcykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiRGlkIHlvdSBsb2FkIGluIHRoZSBpcmlzIGRhdGEgY29ycmVjdGx5P1wiXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwiaGVhZFwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwic3RyXCIpICU+JSBjaGVja19yZXN1bHQoKSAlPiUgY2hlY2tfZXF1YWwoKVxuZXgoKSAlPiUgY2hlY2tfZnVuY3Rpb24oXCJkaW1cIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkdyZWF0IGpvYiEgTm93LCBkb2VzIHRoaXMgcmVzdWx0IGNvbmZpcm0geW91ciBpbml0aWFsIGh5cG90aGVzaXMgb2YgYSBwb3NpdGl2ZSBpbmRpY2F0aW9uIGJldHdlZW4gdGhlc2UgdHdvIGF0dHJpYnV0ZXM/XCIpIn0=

È sempre una buona idea verificare se l’import dei dati è andato a buon fine. Di solito usi funzioni come head(), str() e dim() come nel riquadro DataCamp Light qui sopra per farlo rapidamente.

I risultati di queste tre funzioni non evidenziano subito nulla di anomalo; guardando l’output della funzione str(), vedi che le stringhe della colonna Species sono lette come fattori. Non è un problema, ma è sicuramente utile saperlo per i prossimi passaggi, in cui esplorerai e preprocesserai i dati.

Esplorazione dei dati

Per questo tutorial, continuerai a lavorare con il famoso dataset iris che hai importato con la funzione read.csv().

Per chi non ha le conoscenze di biologia necessarie per lavorare con questi dati, ecco qualche informazione di base: tutti i fiori hanno un sepalo e un petalo. Il sepalo racchiude i petali ed è tipicamente verde e simile a una foglia, mentre i petali sono generalmente foglie colorate. Per i fiori di iris, è solo un po’ diverso, come puoi vedere nella figura seguente:

deep learning Python

Potresti aver già notato nella sezione precedente che il data frame iris non aveva nomi di colonna dopo l’import. Per il resto del tutorial, questo non è troppo importante: anche se la funzione read.csv() ti restituisce i dati in un data.frame, i dati che dovrai passare alla funzione fit() devono essere una matrice o un array.

Alcune cose da tenere a mente su queste due strutture dati appena menzionate: - Le matrici e gli array non hanno nomi di colonna; - Le matrici sono oggetti bidimensionali di un unico tipo di dato; - Gli array sono oggetti multidimensionali di un unico tipo di dato;

Consiglio: guarda questo video se vuoi un ripasso delle strutture dati in R!

Il data frame, invece, è un tipo speciale di lista nominata in cui tutti gli elementi hanno la stessa lunghezza. È un oggetto multidimensionale che può contenere più tipi di dato. Lo hai già visto quando hai controllato la struttura del data frame iris nella sezione precedente. Sapendo questo e considerando che dovrai arrivare a un oggetto bi- o multidimensionale di un unico tipo di dato, dovresti già prepararti a fare un po’ di preprocessing prima di iniziare a costruire la tua rete neurale!

Per ora, i nomi di colonna possono essere utili per l’esplorazione, e faciliteranno la comprensione dei dati, quindi aggiungiamo alcuni nomi di colonna con l’aiuto della funzione names(). Poi puoi usare subito la variabile iris nella tua esplorazione! Traccia, ad esempio, come la lunghezza e la larghezza del petalo correlano con la funzione plot().

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSAiLCJzYW1wbGUiOiJuYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcblxucGxvdChpcmlzJFBldGFsLkxlbmd0aCwgXG4gICAgIGlyaXMkUGV0YWwuV2lkdGgsIFxuICAgICBwY2g9MjEsIGJnPWMoXCJyZWRcIixcImdyZWVuM1wiLFwiYmx1ZVwiKVt1bmNsYXNzKGlyaXMkU3BlY2llcyldLCBcbiAgICAgeGxhYj1cIlBldGFsIExlbmd0aFwiLCBcbiAgICAgeWxhYj1cIlBldGFsIFdpZHRoXCIpIn0=

Nota che usi la funzione unclass() per convertire i nomi delle specie, cioè “setosa, versicolor” e “virginica”, nei numeri 1, 2 e 3.

Ora guarda più da vicino il risultato della funzione di plotting:

plot

Il grafico indica una correlazione positiva tra Petal.Length e Petal.Width per le diverse specie dei fiori di iris. Tuttavia, probabilmente vorrai verificarlo con la funzione cor(), che ti darà la correlazione complessiva tra tutti gli attributi inclusi nel dataset:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6IiMgT3ZlcmFsbCBjb3JyZWxhdGlvbiBiZXR3ZWVuIGBQZXRhbC5MZW5ndGhgIGFuZCBgUGV0YWwuV2lkdGhgIFxuY29yKC4uLi4uLi4uLi4uLi4uLi4uLCBpcmlzJFBldGFsLldpZHRoKSIsInNvbHV0aW9uIjoiIyBPdmVyYWxsIGNvcnJlbGF0aW9uIGJldHdlZW4gYFBldGFsLkxlbmd0aGAgYW5kIGBQZXRhbC5XaWR0aGAgXG5jb3IoaXJpcyRQZXRhbC5MZW5ndGgsIGlyaXMkUGV0YWwuV2lkdGgpIiwic2N0IjoiZXgoKSAlPiUgY2hlY2tfZnVuY3Rpb24oXCJjb3JcIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkdyZWF0IGpvYiEgTm93LCBkb2VzIHRoaXMgcmVzdWx0IGNvbmZpcm0geW91ciBpbml0aWFsIGh5cG90aGVzaXMgb2YgYSBwb3NpdGl2ZSBpbmRpY2F0aW9uIGJldHdlZW4gdGhlc2UgdHdvIGF0dHJpYnV0ZXM/XCIpIn0=

Inoltre, puoi usare il pacchetto corrplot insieme alla funzione cor() per tracciare le correlazioni tra gli attributi dei tuoi dati; in questo caso, calcoli la correlazione complessiva per tutti gli attributi del data frame iris. Memorizzi il risultato di questo calcolo in una variabile M e lo passi alla funzione corrplot().

Non dimenticare anche di specificare l’argomento method per indicare come vuoi che i dati vengano rappresentati!

Puoi fare altre prove con il metodo di visualizzazione nel riquadro DataCamp Light qui sotto:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoY29ycnBsb3QpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIikiLCJzYW1wbGUiOiIjIFN0b3JlIHRoZSBvdmVyYWxsIGNvcnJlbGF0aW9uIGluIGBNYFxuTSA8LSBjb3IoaXJpc1ssMTo0XSlcblxuIyBQbG90IHRoZSBjb3JyZWxhdGlvbiBwbG90IHdpdGggYE1gXG5jb3JycGxvdChNLCBtZXRob2Q9XCJjaXJjbGVcIikifQ==

chart

Usa la console di R per esplorare ulteriormente i tuoi dati.

Se vuoi creare grafici per questi dati con il pacchetto ggvis, che è la grammar of graphics interattiva, dai un’occhiata al tutorial di DataCamp Machine Learning in R For Beginners o segui il corso ggvis di DataCamp.

Preprocessing dei dati

Prima di poter costruire il tuo modello, devi anche assicurarti che i tuoi dati siano puliti, normalizzati (se applicabile) e divisi in training set e test set. Poiché il dataset proviene dall’UCI Machine Learning Repository, puoi aspettarti che sia già piuttosto pulito, ma verifichiamo comunque la qualità dei tuoi dati.

A prima vista, quando hai ispezionato i dati con head(), non hai visto nulla di strano, giusto? Usiamo summary() e str() per ricapitolare brevemente cosa hai imparato quando hai verificato se l’import dei tuoi dati era riuscito:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6IiMgUHVsbCB1cCBhIHN1bW1hcnkgb2YgYGlyaXNgXG5zdW1tYXJ5KC4uLi4pXG5cbiMgSW5zcGVjdCB0aGUgc3RydWN0dXJlIG9mIGBpcmlzYFxuc3RyKC4uLi4pIiwic29sdXRpb24iOiIjIFB1bGwgdXAgYSBzdW1tYXJ5IG9mIGBpcmlzYFxuc3VtbWFyeShpcmlzKVxuXG4jIEluc3BlY3QgdGhlIHN0cnVjdHVyZSBvZiBgaXJpc2BcbnN0cihpcmlzKSIsInNjdCI6ImV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwic3VtbWFyeVwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwic3RyXCIpICU+JSBjaGVja19yZXN1bHQoKSAlPiUgY2hlY2tfZXF1YWwoKVxuc3VjY2Vzc19tc2coXCJHb29kIGpvYiEgTm93LCB3aGF0IGRvIHlvdSBsZWFybiBmcm9tIHRoZSBvdXRwdXQgb2YgdGhlc2UgbGluZXMgb2YgY29kZT9cIikifQ==

Ora che sei sicuro che i dati siano sufficientemente puliti, puoi iniziare verificando se la normalizzazione è necessaria per qualcuno dei dati con cui stai lavorando in questo tutorial.

Normalizzare i dati con una User Defined Function (UDF)

Dai risultati della funzione summary() nel riquadro DataCamp Light qui sopra, vedi che il dataset Iris non ha bisogno di essere normalizzato: l’attributo Sepal.Length ha valori da 4.3 a 7.9 e Sepal.Width contiene valori da 2 a 4.4, mentre i valori di Petal.Length vanno da 1 a 6.9 e Petal.Width da 0.1 a 2.5. In altre parole, tutti i valori di tutti gli attributi del dataset Iris rientrano nell’intervallo tra 0.1 e 7.9, che puoi considerare accettabile.

Tuttavia, può comunque essere una buona idea studiare l’effetto della normalizzazione sui tuoi dati; puoi persino spingerti fino a passare i dati normalizzati al tuo modello per vedere se c’è qualche effetto. Questo è fuori dallo scopo del tutorial, ma sentiti libero di provarci per conto tuo! Il codice è tutto qui nel tutorial :)

Puoi creare una tua funzione per normalizzare i dati di iris; in questo caso, è una funzione di normalizzazione min-max, che trasforma linearmente i tuoi dati secondo la funzione (x-min)/(max-min). Da questo punto di vista, tradurre questa formula in R è piuttosto semplice: crei una funzione a cui passi x o dei dati. Calcoli poi il risultato della prima sottrazione x-min e lo memorizzi in num. Successivamente calcoli anche max-min e memorizzi il risultato in denom. Il risultato della tua funzione normalize() dovrebbe restituire la divisione di num per max.

Per applicare questa funzione definita dall’utente ai tuoi dati iris (valori target esclusi), devi usare non solo normalize, ma anche la funzione lapply() per normalizzare i dati, come qui sotto:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6IiMgQnVpbGQgeW91ciBvd24gYG5vcm1hbGl6ZSgpYCBmdW5jdGlvblxubm9ybWFsaXplIDwtIGZ1bmN0aW9uKHgpIHtcbiAgbnVtIDwtIHggLSBtaW4oeClcbiAgZGVub20gPC0gbWF4KHgpIC0gbWluKHgpXG4gIHJldHVybiAobnVtL2Rlbm9tKVxufVxuXG4jIE5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGFcbmlyaXNfbm9ybSA8LSBhcy5kYXRhLmZyYW1lKGxhcHBseShpcmlzWzE6NF0sIC4uLi4uLi4uLikpXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCBwYXJ0IG9mIGBpcmlzYCBcbmhlYWQoLi4uLikiLCJzb2x1dGlvbiI6IiMgQnVpbGQgeW91ciBvd24gYG5vcm1hbGl6ZSgpYCBmdW5jdGlvblxubm9ybWFsaXplIDwtIGZ1bmN0aW9uKHgpIHtcbiAgbnVtIDwtIHggLSBtaW4oeClcbiAgZGVub20gPC0gbWF4KHgpIC0gbWluKHgpXG4gIHJldHVybiAobnVtL2Rlbm9tKVxufVxuXG4jIE5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGFcbmlyaXNfbm9ybSA8LSBhcy5kYXRhLmZyYW1lKGxhcHBseShpcmlzWzE6NF0sIG5vcm1hbGl6ZSkpXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCBwYXJ0IG9mIGBpcmlzYCBcbmhlYWQoaXJpcykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiTWFrZSBzdXJlIHRvIGRlZmluZSBhIHZhcmlhYmxlIGBpcmlzX25vcm1gLlwiXG5tc2dfaW5jb3JyZWN0IDwtIFwiTWFrZSBzdXJlIHRoYXQgeW91IGFzc2lnbiB0aGUgY29ycmVjdCB2YWx1ZSB0byBgaXJpc19ub3JtYC5cIlxuXG5mdW5fZGVmIDwtIGV4KCkgJT4lIGNoZWNrX2Z1bl9kZWYoXCJub3JtYWxpemVcIilcbmZ1bl9kZWYgJT4lIGNoZWNrX2JvZHkoKVxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpcmlzX25vcm0nLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwiaGVhZFwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbnN1Y2Nlc3NfbXNnKFwiV2VsbCBkb25lISBOb3cgeW91IGNhbiBtb3ZlIG9uIHRvIHNlZSBob3cgeW91IGNhbiBub3JtYWxpemUgeW91ciBkYXRhIHdpdGgga2VyYXMhXCIpIn0=

Consiglio: usa la funzione hist() nella console R per studiare la distribuzione dei dati Iris prima (iris) e dopo la normalizzazione (iris_norm).

Normalizzare i dati con keras

Per usare la funzione normalize() dal pacchetto keras, devi prima assicurarti di lavorare con una matrice. Come ricorderai da prima, la caratteristica delle matrici è che gli elementi sono dello stesso tipo base; in questo caso, hai valori target di tipo factor, mentre il resto è tutto numerico.

Questo va modificato per prima cosa.

Puoi usare la funzione as.numeric() per convertire i dati in numeri:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6ImlyaXNbLDVdIDwtIC4uLi4uLi4uLi4uKGlyaXNbLDVdKSAtMVxuXG4jIFR1cm4gYGlyaXNgIGludG8gYSBtYXRyaXhcbmlyaXMgPC0gYXMubWF0cml4KGlyaXMpXG5cbiMgU2V0IGBpcmlzYCBgZGltbmFtZXNgIHRvIGBOVUxMYFxuZGltbmFtZXMoLi4uLikgPC0gTlVMTCIsInNvbHV0aW9uIjoiaXJpc1ssNV0gPC0gYXMubnVtZXJpYyhpcmlzWyw1XSkgLTFcblxuIyBUdXJuIGBpcmlzYCBpbnRvIGEgbWF0cml4XG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuXG4jIFNldCBpcmlzIGBkaW1uYW1lc2AgdG8gYE5VTExgXG5kaW1uYW1lcyhpcmlzKSA8LSBOVUxMIiwic2N0IjoibXNnX3VuZGVmaW5lZCA8LSBcIkRpZCB5b3UgdXNlIGBhcy5udW1lcmljKClgIHRvIGNvbnZlcnQgYGlyaXNbLDVdYCB0byBudW1lcmljP1wiXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbm1zZ191bmRlZmluZWQyIDwtIFwiRGlkIHlvdSB1c2UgYGFzLm1hdHJpeGAgdG8gY29udmVydCBgaXJpc2AgdG8gYSBtYXRyaXg/XCJcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnaXJpcycsIG1zZ191bmRlZmluZWQyKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZDIpXG5leCgpICU+JSBjaGVja19mdW5jdGlvbihcImRpbW5hbWVzXCIpICU+JSBjaGVja19yZXN1bHQoKSAlPiUgY2hlY2tfZXF1YWwoKVxuc3VjY2Vzc19tc2coXCJBd2Vzb21lIVwiKSJ9

Un data frame numerico va bene, ma dovrai convertire i dati in un array o in una matrice se vuoi usare il pacchetto keras. Puoi farlo facilmente con la funzione as.matrix(); non dimenticare qui di impostare le dimnames a NULL.

Come potresti aver letto nella sezione sopra, normalizzare i dati di Iris non è necessario. Tuttavia, è comunque una buona idea studiare la normalizzazione e il suo effetto, e vedere come questo si possa fare non solo con una UDF ma anche con la funzione normalize() integrata in keras.

Con i tuoi dati convertiti in una matrice, puoi infatti usare anche il pacchetto keras per studiare l’effetto di una possibile normalizzazione sui tuoi dati:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoa2VyYXMpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcbmlyaXNbLDVdIDwtIGFzLm51bWVyaWMoaXJpc1ssNV0pIC0xXG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuZGltbmFtZXMoaXJpcykgPC0gTlVMTCIsInNhbXBsZSI6IiMgTm9ybWFsaXplIHRoZSBgaXJpc2AgZGF0YVxuaXJpcyA8LSBub3JtYWxpemUoLi4uLlssMTo0XSlcblxuIyBSZXR1cm4gdGhlIHN1bW1hcnkgb2YgYGlyaXNgXG5zdW1tYXJ5KC4uLi4pIiwic29sdXRpb24iOiIjIE5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGFcbmlyaXMgPC0gbm9ybWFsaXplKGlyaXNbLDE6NF0pXG5cbiMgUmV0dXJuIHRoZSBzdW1tYXJ5IG9mIGBpcmlzYFxuc3VtbWFyeShpcmlzKSIsInNjdCI6Im1zZ191bmRlZmluZWQgPC0gXCJEaWQgeW91IG5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGE/XCJcbmV4KCkgJT4lIGNoZWNrX29iamVjdChcImlyaXNcIiwgbXNnX3VuZGVmaW5lZCkgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQpXG5leCgpICU+JSBjaGVja19mdW5jdGlvbihcInN1bW1hcnlcIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkF3ZXNvbWUhIE5vdywgaG93IGRvZXMgdGhpcyBzdW1tYXJ5IGNvbXBhcmUgdG8gdGhlIHByZXZpb3VzIHN1bW1hcnkgdGhhdCB5b3UgcmV0cmlldmVkIGluIHRoZSBEYXRhQ2FtcCBMaWdodCBjaHVuayBhYm92ZT9cIikifQ==

Nota che qui usi dimnames() per impostare le dimnames di iris a NULL. Questo assicura che non ci siano nomi di colonna nei tuoi dati.

Training e test set

Ora che hai controllato la qualità dei tuoi dati e sai che non è necessario normalizzarli, puoi continuare a lavorare con i dati originali e dividerli in training set e test set, così da essere finalmente pronto a iniziare a costruire il tuo modello. Facendo così, ti assicuri di poter valutare onestamente le prestazioni del modello predittivo in seguito.

Prima di dividere i dati in training e test set, è meglio impostare un seed. Puoi farlo facilmente con set.seed(): usa proprio questa funzione e passale un intero a caso. Un seed è un numero del generatore di numeri casuali di R. Il grande vantaggio di impostare un seed è che puoi ottenere la stessa sequenza di numeri casuali ogni volta che fornisci lo stesso seed al generatore.

Questo è ottimo per la riproducibilità del tuo codice!

Usi la funzione sample() per prendere un campione di dimensione pari al numero di righe del dataset Iris, cioè 150. Campioni con reinserimento: scegli da un vettore di 2 elementi e assegni 1 o 2 alle 150 righe del dataset Iris. L’assegnazione degli elementi è soggetta a pesi di probabilità di 0.67 e 0.33.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTEwiLCJzYW1wbGUiOiIjIERldGVybWluZSBzYW1wbGUgc2l6ZVxuaW5kIDwtIHNhbXBsZSgyLCBucm93KC4uLi4pLCByZXBsYWNlPVRSVUUsIHByb2I9YygwLjY3LCAwLjMzKSlcblxuIyBTcGxpdCB0aGUgYGlyaXNgIGRhdGFcbmlyaXMudHJhaW5pbmcgPC0gLi4uLltpbmQ9PTEsIDE6NF1cbmlyaXMudGVzdCA8LSBpcmlzW2luZD09MiwgMTo0XVxuXG4jIFNwbGl0IHRoZSBjbGFzcyBhdHRyaWJ1dGVcbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1suLi49PTEsIDVdXG5pcmlzLnRlc3R0YXJnZXQgPC0gaXJpc1tpbmQ9PTIsIDVdIiwic29sdXRpb24iOiIjIERldGVybWluZSBzYW1wbGUgc2l6ZVxuaW5kIDwtIHNhbXBsZSgyLCBucm93KGlyaXMpLCByZXBsYWNlPVRSVUUsIHByb2I9YygwLjY3LCAwLjMzKSlcblxuIyBTcGxpdCB0aGUgYGlyaXNgIGRhdGFcbmlyaXMudHJhaW5pbmcgPC0gaXJpc1tpbmQ9PTEsIDE6NF1cbmlyaXMudGVzdCA8LSBpcmlzW2luZD09MiwgMTo0XVxuXG4jIFNwbGl0IHRoZSBjbGFzcyBhdHRyaWJ1dGVcbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsIDVdXG5pcmlzLnRlc3R0YXJnZXQgPC0gaXJpc1tpbmQ9PTIsIDVdIiwic2N0IjoibXNnX3VuZGVmaW5lZCA8LSBcIkRpZCB5b3UgZGVmaW5lIGBpbmRgP1wiXG5tc2dfdW5kZWZpbmVkMSA8LSBcIkRpZCB5b3Ugc3BsaXQgdGhlIGBpcmlzYCBkYXRhIGludG8gYSB0cmFpbmluZyBzZXQ/XCJcbm1zZ191bmRlZmluZWQyIDwtIFwiRGlkIHlvdSBzcGxpdCB0aGUgYGlyaXNgIGRhdGEgaW50byBhIHRlc3Qgc2V0P1wiXG5tc2dfdW5kZWZpbmVkMyA8LSBcIkRpZCB5b3UgaXNvbGF0ZSB0aGUgYGlyaXNgIHRyYWluaW5nIGxhYmVscz9cIlxubXNnX3VuZGVmaW5lZDQgPC0gXCJEaWQgeW91IGlzb2xhdGUgdGhlIGBpcmlzYCB0ZXN0IGxhYmVscz9cIlxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpbmQnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnaXJpcy50cmFpbmluZycsIG1zZ191bmRlZmluZWQxKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZDEpXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMudGVzdCcsIG1zZ191bmRlZmluZWQyKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZDIpXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMudHJhaW5pbmd0YXJnZXQnLCBtc2dfdW5kZWZpbmVkMykgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQzKVxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpcmlzLnRlc3R0YXJnZXQnLCBtc2dfdW5kZWZpbmVkNCkgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQ0KVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhIElmIHlvdSB3YW50LCBtYWtlIHVzZSBvZiB0aGUgUiBjb25zb2xlIHRvIGNoZWNrIG91dCB5b3VyIG5ld2x5IGNyZWF0ZWQgdHJhaW5pbmcgYW5kIHRlc3Qgc2V0cyFcIikifQ==

L’argomento replace della funzione sample() è impostato su TRUE, il che significa che assegni un 1 o un 2 a una certa riga e poi resetti il vettore di 2 al suo stato originale.

In altre parole, per le righe successive del tuo dataset puoi assegnare di volta in volta un 1 o un 2. La probabilità di scegliere un 1 o un 2 non deve essere proporzionale ai pesi tra gli elementi rimanenti, quindi specifichi dei pesi di probabilità.

Nota a margine: se avessi usato un dataset integrato con la specifica funzione dataset_imdb(), ad esempio, i tuoi dati si possono dividere facilmente usando l’operatore $:

x_train <- imdb$train$x
y_train <- imdb$train$y
x_test <- imdb$test$x
y_test <- imdb$test$y

One-Hot Encoding

Hai diviso con successo i tuoi dati, ma c’è ancora un passaggio che devi fare prima di iniziare a costruire il tuo modello. Indovini quale?

Quando vuoi modellare problemi di classificazione multiclasse con reti neurali, è generalmente una buona pratica assicurarsi di trasformare l’attributo target da un vettore che contiene i valori per ogni classe a una matrice con un booleano per ogni valore di classe e se una data istanza ha o meno quel valore di classe.

Questa è una spiegazione informale della One Hot Encoding (OHE). Sembra piuttosto complesso, vero?

Per fortuna, il pacchetto keras ha una funzione to_categorical() che farà tutto questo per te; passa a questa funzione iris.trainingtarget e iris.testtarget e memorizza il risultato in iris.trainLabels e iris.testLabels:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV0iLCJzYW1wbGUiOiIjIE9uZSBob3QgZW5jb2RlIHRyYWluaW5nIHRhcmdldCB2YWx1ZXNcbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoLi4uLi4uLi4uLi4uLi4uLi4uKVxuXG4jIE9uZSBob3QgZW5jb2RlIHRlc3QgdGFyZ2V0IHZhbHVlc1xuaXJpcy50ZXN0TGFiZWxzIDwtIHRvX2NhdGVnb3JpY2FsKC4uLi4uLi4uLi4uLi4uLilcblxuIyBQcmludCBvdXQgdGhlIGlyaXMudGVzdExhYmVscyB0byBkb3VibGUgY2hlY2sgdGhlIHJlc3VsdFxucHJpbnQoLi4uLi4uLi4uLi4uLikiLCJzb2x1dGlvbiI6IiMgT25lIGhvdCBlbmNvZGUgdHJhaW5pbmcgdGFyZ2V0IHZhbHVlc1xuaXJpcy50cmFpbkxhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRyYWluaW5ndGFyZ2V0KVxuXG4jIE9uZSBob3QgZW5jb2RlIHRlc3QgdGFyZ2V0IHZhbHVlc1xuaXJpcy50ZXN0TGFiZWxzIDwtIHRvX2NhdGVnb3JpY2FsKGlyaXMudGVzdHRhcmdldClcblxuIyBQcmludCBvdXQgdGhlIGlyaXMudGVzdExhYmVscyB0byBkb3VibGUgY2hlY2sgdGhlIHJlc3VsdFxucHJpbnQoaXJpcy50ZXN0TGFiZWxzKSIsInNjdCI6Im1zZ191bmRlZmluZWQgPC0gXCJEaWQgeW91IHBhc3MgYGlyaXMudHJhaW5pbmd0YXJnZXRgIHRvIHRoZSBgdG9fY2F0ZWdvcmljYWwoKWAgZnVuY3Rpb24/XCJcbm1zZ191bmRlZmluZWQyIDwtIFwiRGlkIHlvdSBwYXNzIGBpcmlzLnRlc3R0YXJnZXRgIHRvIHRoZSBgdG9fY2F0ZWdvcmljYWwoKWAgZnVuY3Rpb24/XCJcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnaXJpcy50cmFpbkxhYmVscycsIG1zZ191bmRlZmluZWQpICU+JSBjaGVja19lcXVhbChtc2dfdW5kZWZpbmVkKVxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpcmlzLnRlc3RMYWJlbHMnLCBtc2dfdW5kZWZpbmVkMikgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQyKVxuZXgoKSAlPiUgY2hlY2tfZnVuY3Rpb24oXCJwcmludFwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbnN1Y2Nlc3NfbXNnKFwiR29vZCBqb2IhIERvdWJsZSBjaGVjayB0aGUgcHJpbnQtb3V0IG9mIGBpcmlzLnRlc3RMYWJlbHNgIHRvIHNlZSBob3cgb25lLWhvdCBlbmNvZGluZyB3b3JrcyFcIikifQ==

Ora hai ufficialmente concluso i passaggi di esplorazione e preprocessing in questo tutorial. Puoi passare a costruire la tua rete neurale con keras!

Costruire il modello

Per iniziare a costruire un modello, dovresti prima inizializzare un modello sequenziale con l’aiuto della funzione keras_model_sequential(). Poi sei pronto per cominciare a modellare.

Tuttavia, prima di iniziare, è una buona idea riprendere la tua domanda originale su questo dataset: puoi predire la specie di un determinato fiore di Iris? È più facile lavorare con dati numerici, e hai preprocessato i dati e fatto la one hot encoding dei valori della variabile target: un fiore è di tipo versicolor, setosa o virginica e questo è riflesso da valori binari 1 e 0.

Un tipo di rete che si comporta bene su un problema del genere è un perceptron multistrato. Questo tipo di rete neurale è spesso fully connected. Ciò significa che vuoi costruire uno stack relativamente semplice di layer completamente connessi per risolvere questo problema. Per quanto riguarda le funzioni di attivazione che userai, è meglio ricorrere a una delle più comuni per prendere confidenza con Keras e le reti neurali, ovvero la funzione di attivazione relu. Questa funzione di attivazione rettificatrice è usata in un layer nascosto, il che in generale è una buona pratica.

Inoltre, vedi anche che la funzione di attivazione softmax è usata nel layer di output. Lo fai perché vuoi assicurarti che i valori in uscita siano nell’intervallo tra 0 e 1 e possano essere usati come probabilità previste:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml6aWFsaXphIHVuIG1vZGVsbG8gc2VxdXVlbnppYWxlXG5tb2RlbCA8LSAuLi4uLi4uLi4uLi4uLi4uLi4uLi4uLlxuXG4jIEFnZ2l1bmdpIGxheWVyIGFsIG1vZGVsbG9cbm1vZGVsICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDgsIGFjdGl2YXRpb24gPSAncmVsdScsIGlucHV0X3NoYXBlID0gYyg0KSkgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMywgYWN0aXZhdGlvbiA9ICdzb2Z0bWF4JykiLCJzb2x1dGlvbiI6IiMgSW5penppYWxpemEgdW4gbW9kZWxsbyBzZXF1ZW56aWFsXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5cbiMgQWdn aXVuZ2kgbGF5ZXJpIGFsIG1vZGVsbG9cbm1vZGVsICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDgsIGFjdGl2YXRpb24gPSAncmVsdScsIGlucHV0X3NoYXBlID0gYyg0KSkgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMywgYWN0aXZhdGlvbiA9ICdzb2Z0bWF4JykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiSGFpIGluaXp6aWFsaXp6YXRvIHVuIG1vZGVsbG8gc2VxdWVuemlhbGUgY29uIGwnaXRvIGRpIGF1dGlzaW5vIGBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKClgP1wiXG5tc2dfaW5jb3JyZWN0IDwtIFwiSGFpIG1hbnRlbmV1dG8gbGUgbGF5ZXIgcHJlZGVmaW5pdGU/XCJcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnbW9kZWwnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX2luY29ycmVjdClcbnN1Y2Nlc3NfbXNnKFwiQmVuZSxhZmZhdHRvISBIYWkgY29zdHJ1aXRvIGNvbnN0cnVpdG8gdW4gbW9kZWxsbyBjb24gaWwgcGFjY2hldCBg a2VyYXNgIGluIFIhXCIpIn0=

Nota come il layer di output crea 3 valori di output, uno per ciascuna classe di Iris (versicolor, virginica o setosa). Il primo layer, che contiene 8 unità nascoste, invece, ha un input_shape pari a 4. Questo perché i tuoi dati di training iris.training hanno 4 colonne.

Puoi ispezionare ulteriormente il tuo modello con le seguenti funzioni:

  • puoi usare la funzione summary() per stampare una rappresentazione sintetica del modello;
  • get_config() restituirà un elenco che contiene la configurazione del modello;
  • get_layer() restituirà la configurazione del layer;
  • l'attributo layers può essere usato per recuperare un elenco piatto dei layer del modello;
  • per elencare i tensori di input, puoi usare l'attributo inputs; e
  • infine, per recuperare i tensori di output, puoi usare l'attributo outputs.
eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpIiwic2FtcGxlIjoiIyBTdGFtcGEgdW5hIHNudW1tYXJ5IGRpIHVuIG1vZGVsbG9cbnN1bW1hcnkobW9kZWwpXG5cbiMgT3R0aWVuaSBsYSBjb25maWd1cmF6aW9uZSBkZWwgbW9kZWxvXG5nZXRfY29uZmlnKG1vZGVsKVxuXG4jIE90dGllbmkgbGEgY29uZmlndXJhemlvbmUgZGVsIGxheWVyXG5nZXRfbGF5ZXIobW9kZWwsIGluZGV4ID0gMSlcblxuIyBJbGlzdGEgaSBsYXllciBkZWwgbW9kZWxvXG5tb2RlbCRsYXllcnNcblxuIyBJbGlzdGEgaSB0ZW5zb3JpIGRpIGlucHV0XG5tb2RlbCRpbnB1dHNcblxuIyBJbGlzdGEgaSB0ZW5zb3JpIGRpIG91dHB1dFxubW9kZWwk b3V0cHV0cyJ9

Compila e adatta il modello

Ora che hai impostato l'architettura del modello, è il momento di compilarlo e adattarlo ai dati. Per compilare il modello, configuralo con l'ottimizzatore adam e la funzione di perdita categorical_crossentropy. Inoltre, durante l'addestramento monitora anche l'accuratezza passando 'accuracy' all'argomento metrics.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpIiwic2FtcGxlIjoiIyBDb21waWxhIGlsIG1vZGVsbG9cbm1vZGVsICU+JSBjb21waWxlKFxuICAgICBsb3NzID0gJ2NhdGVnb3JpY2FsX2Nyb3NzZW50cm9weScsXG4gICAgIG9wdGltaXplciA9ICdhZGFtJyxcbiAgICAgbWV0cmljcyA9ICdhY2N1cmFjeSdcbiApIn0=

L'ottimizzatore e la perdita sono due argomenti obbligatori se vuoi compilare il modello.

Alcuni degli algoritmi di ottimizzazione più popolari sono lo Stochastic Gradient Descent (SGD), ADAM e RMSprop. A seconda dell'algoritmo che scegli, dovrai tarare alcuni parametri, come il learning rate o il momentum. La scelta della funzione di perdita dipende dal compito: per esempio, per un problema di regressione userai di solito la Mean Squared Error (MSE).

Come vedi in questo esempio, hai usato la funzione di perdita categorical_crossentropy per il problema di classificazione multiclasse che determina se un'iris è di tipo versicolor, virginica o setosa. Nota però che, se avessi avuto un problema di classificazione binaria, avresti dovuto usare la funzione di perdita binary_crossentropy.

Successivamente, puoi anche adattare il modello ai tuoi dati; in questo caso, addestri il modello per 200 epoche o iterazioni su tutti i campioni in iris.training e iris.trainLabels, in batch da 5 campioni.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKSIsInNhbXBsZSI6IiMgQWRhdHRhIGlsIG1vZGVsbG8gXG5tb2RlbCAlPiUgZml0KFxuICAgICBpcmlzLnRyYWluaW5nLCBcbiAgICAgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCwgXG4gICAgIGJhdGNoX3NpemUgPSA1LCBcbiAgICAgdmFsaWRhdGlvbl9zcGxpdCA9IDAuMlxuICkifQ==

Dritta: se vuoi, puoi anche specificare l'argomento verbose nella funzione fit(). Impostandolo a 1, indichi che vuoi vedere il log con la barra di avanzamento.

Con il codice qui sopra stai addestrando il modello per un numero specifico di epoche o passaggi sul dataset di training. Un'epoca è un singolo passaggio su tutto il training set, seguito dal test sul set di validazione. La dimensione del batch che specifichi nel codice definisce il numero di campioni che verranno propagati attraverso la rete. Inoltre, in questo modo ottimizzi l'efficienza perché ti assicuri di non caricare in memoria troppi pattern di input contemporaneamente.

Visualizza la cronologia dell'addestramento del modello

È anche utile sapere che puoi visualizzare il fitting se assegni le righe di codice nel riquadro DataCamp Light qui sopra a una variabile. Puoi poi passare la variabile alla funzione plot(), come vedi in questo blocco di codice!

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKSIsInNhbXBsZSI6IiMgU2FsdmEgbGEgY3Jvbm9sb2dpYSBkaSBmaXR0aW5nIGluIGBoaXN0b3J5YCBcbmhpc3RvcnkgPC0gbW9kZWwgJT4lIGZpdChcbiAgICAgcmlzLnRyYWluaW5nLCBcbiAgICAgcmlzLnRyYWluTGFiZWxzLCBcbiAgICAgZXBvY2hzID0gMjAwLFxuICAgICBiYXRjaF9zaXplID0gNSwgXG4gICAgIHZhbGlkYXRpb25fc3BsaXQgPSAwLjJcbiApXG5cbiMgU3RhbXBhIGlsIGdyYWZpY29cbnBsb3QoaGlzdG9yeSkifQ==

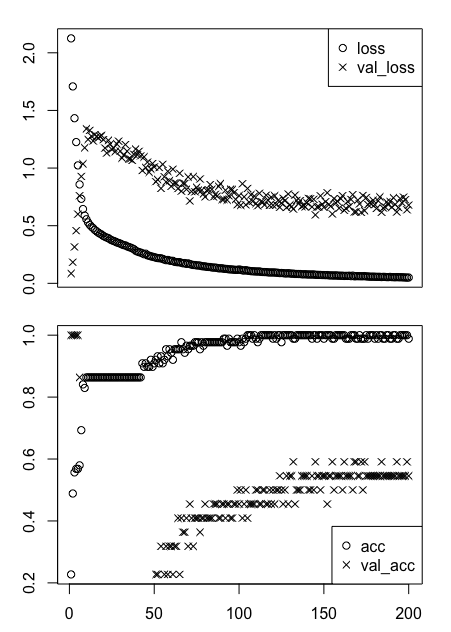
Assicurati di studiare il grafico più nel dettaglio.
plot

A prima vista, non stupisce che sembri un po' caotico. Potresti non sapere esattamente cosa stai guardando, giusto?

Una cosa utile da sapere è che loss e acc indicano rispettivamente la perdita e l'accuratezza del modello sui dati di training, mentre val_loss e val_acc sono le stesse metriche, perdita e accuratezza, sui dati di test o di validazione.

Ma, anche sapendolo, non è facile interpretare questi due grafici. Proviamo a spezzare il tutto in parti più semplici da capire! Dividerai questi due grafici e ne farai due separati: uno per la perdita del modello e un altro per l'accuratezza. Per fortuna, puoi usare facilmente l'operatore $ per accedere ai dati e tracciarli passo dopo passo.

Dai un'occhiata al riquadro DataCamp Light qui sotto per vedere come fare:
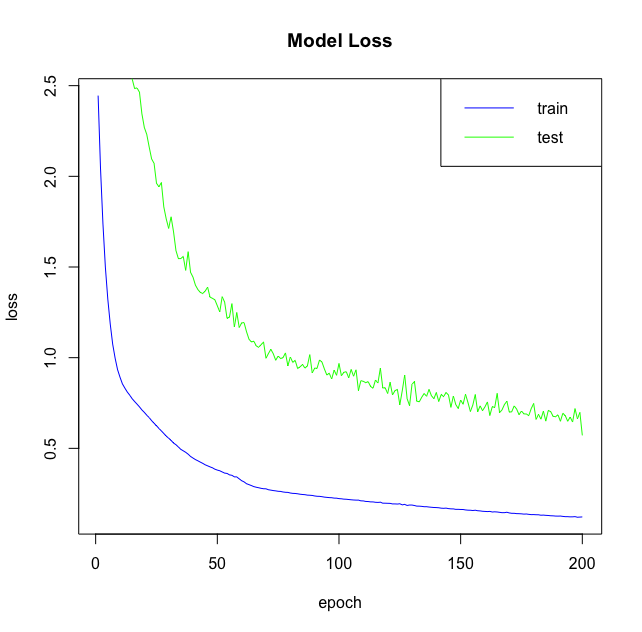
eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuaGlzdG9yeSA8LSBtb2RlbCAlPiUgZml0KFxuICAgICBpcmlzLnRyYWluaW5nLCBcbiAgICAgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCxcbiAgICAgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgVHJhY2NpYSBsYSBwZXJkaXRhIGRlbCBtb2RlbG8gc3VpIGRhdGkgZGkgdHJhaW5pbmdcbnBsb3QoaGlzdG9yeSRtZXRyaWNzJGxvc3MsIG1haW49XCJQcGVyZGl0YSBkZWwgbW9kZWxvXCIsIHhsYWIgPSBcImVwb2NoXCIsIHlsYWI9XCJsb3NzXCIsIGNvbD1cImJsdWVcIiwgdHlwZT1cImxcIilcblxuIyBUcmFjY2lhIGxhIHBlcmRpdGEgc3VpIGRhdGkgZGkgdGVzdFxubGluZXMoaGlzdG9yeSRtZXRyaWNzJHZhbF9sb3NzLCBjb2w9XCJncmVlblwiKVxuXG4jIEFnaXVuZ2kgdW5hIGxlZ2dlbmRhXG5sZWdlbmQoXCJ0b3ByaWdodFwiLCBjKFwidHJhaW5cIixcInRlc3RcIiksIGNvbD1jKFwiYmx1ZVwiLCBcImdyZWVuXCIpLCBsdHk9YygxLDEpKSJ9

chart

In questo primo grafico, hai tracciato la perdita del modello sui dati di training e di test. Ora è il momento di fare lo stesso anche per l'accuratezza del modello:
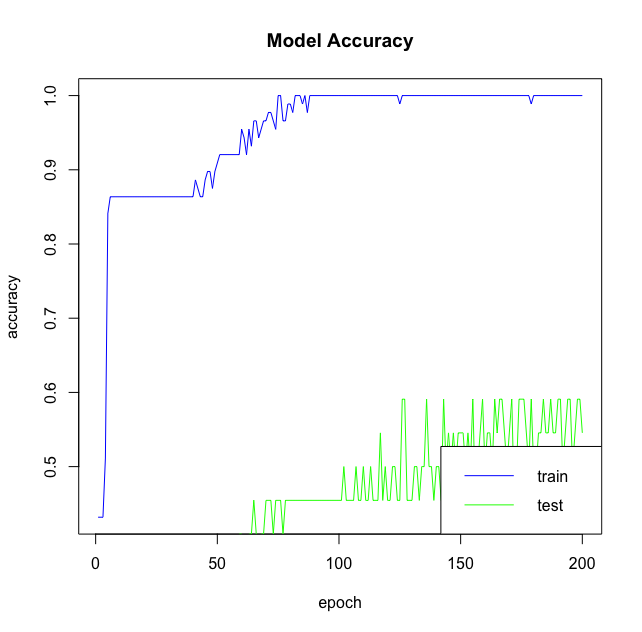
eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuaGlzdG9yeSA8LSBtb2RlbCAlPiUgZml0KFxuICAgICBpcmlzLnRyYWluaW5nLCBcbiAgICAgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCxcbiAgICAgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgVHJhY2NpYSBsJ2FjY3VyYWN6YSBkZWkgZGF0aSBkaSB0cmFpbmluZyBcbnBsb3QoaGlzdG9yeSRtZXRyaWNzJGFjYywgbWFpbj1cIkFjY3VyYXRlenphIGRlbCBNb2RlbG9cIiwgeGxhYiA9IFwiZXBvY2hcIiwgeWxhYj1cImFjY3VyYWN5XCIsIGNvbD1cImJsdWVcIiwgdHlwZT1cImxcIilcblxuIyBUcmFjY2lhIGxhIGFjY3VyYWN6YSBkZWkgZGF0aSBkaSB2YWxpZGF6aW9uXG5saW5lcyhoaXN0b3J5JG1ldHJpY3MkdmFsX2FjYywgY29sPVwiZ3JlZW5cIilcblxuIyBBZ2dpdW5naSBMZWdlbmRc bGVnZW5kKFwiYm90dG9tcmlnaHRcIiwgYyhcInRyYWluXCIsXCJ0ZXN0XCIpLCBjb2w9YyhcImJsdWVcIiwgXCJncmVlblwiKSwgbHR5PWMoMSwxKSkifQ==

model accuracy

Alcune cose da tenere a mente qui sono le seguenti:

  • se l'accuratezza sui dati di training continua a migliorare mentre quella sui dati di validazione peggiora, probabilmente stai overfittando: il modello inizia a memorizzare i dati invece di imparare da essi;
  • se la tendenza dell'accuratezza su entrambi i dataset è ancora in crescita nelle ultime epoche, è chiaro che il modello non ha ancora sovraimparato il dataset di training.

Predici le etichette di nuovi dati

Ora che il modello è stato creato, compilato e adattato ai dati, è il momento di usarlo per predire le etichette del set di test iris.test. Come ti aspettavi, puoi usare la funzione predict() per farlo. Dopo, puoi stampare la matrice di confusione per verificare le predizioni e le etichette reali dei dati iris.test con l'aiuto della funzione table().

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxubW9kZWwgJT4lIGZpdChcbiAgICAgaXJpcy50cmFpbmluZywgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCwgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgUHJlZGkgbGUgY2xhc3NpIHBlciBpIGRhdGkgZGkgdGVzdFxuY2xhc3NlcyA8LSBtb2RlbCAlPiUgcHJlZGljdF9jbGFzc2VzKGlyaXMudGVzdCwgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBNYXRyaWNlIGRpIGNvbmZ1c2lvbmVcbnRhYmxlKGlyaXMudGVzdHRhcmdldCwgY2xhc3NlcykifQ==

Cosa ne pensi dei risultati? A prima vista, questo modello che hai creato fa le previsioni giuste?

Valutare il tuo modello

Anche se hai già un'idea di come ha performato il modello guardando le etichette predette per iris.test, è comunque importante prenderti il tempo per valutarlo. Usa la funzione evaluate() per farlo: passa i dati di test iris.test, le etichette di test iris.testLabels e definisci la dimensione del batch. Salva il risultato in una variabile score, come nell'esempio di codice qui sotto:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxubW9kZWwgJT4lIGZpdChcbiAgICAgaXJpcy50cmFpbmluZywgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCwgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgVmFsdXRhIHN1aSBkYXRpIGRpIHRlc3QgZSBsYWJlbFxuc2NvcmUgPC0gbW9kZWwgJT4lIGV2YWx1YXRlKGlyaXMudGVzdCwgaXJpcy50ZXN0TGFiZWxzLCBiYXRjaF9zaXplID0gMTI4KVxuXG4jIFN0YW1wYSBsb3Jpc3VsdGF0b1xucHJpbnQoc2NvcmUpIn0=

Stampando score, otterrai il valore della perdita e quello della metrica (in questo caso 'accuracy').

Fine-tuning del tuo modello

Il fine-tuning del modello è probabilmente qualcosa che farai spesso, soprattutto all'inizio, perché non tutti i problemi di classificazione e regressione sono semplici come quello che hai visto nella prima parte di questo tutorial. Come hai letto sopra, ci sono già due decisioni chiave che probabilmente vorrai modificare: quante layer usare e quante "unità nascoste" scegliere per ciascun layer.

All'inizio sarà davvero un bel percorso.

Oltre a giocare con il numero di epoche o con la dimensione del batch, ci sono altri modi per ritoccare il modello nella speranza che renda meglio: aggiungendo layer, aumentando il numero di unità nascoste e passando parametri di ottimizzazione personalizzati alla funzione compile(). Questa sezione coprirà queste tre opzioni.

Aggiungere layer

Cosa succede se aggiungi un altro layer al tuo modello? E se fosse così?

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml6aWFsaXp6YSBpbCBtb2RlbG8gc2VxdWVuemlhbGVcbm1vZGVsIDwtIGtlcmFzX21vZGVsX3NlcXVlbnRpYWwoKSBcblxuIyBBZ2dpdW5naSBsYXllciBhbCBtb2RlbG9cbm1vZGVsICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDgsIGFjdGl2YXRpb24gPSAncmVsdScsIGlucHV0X3NoYXBlID0gYyg0KSkgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gNSwgYWN0aXZhdGlvbiA9ICdyZWx1JykgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMywgYWN0aXZhdGlvbiA9ICdzb2Z0bWF4JylcblxuIyBDb21waWxhIGlsIG1vZGVsbG9cbm1vZGVsICU+JSBjb21waWxlKFxuICAgICBsb3NzID0gJ2NhdGVnb3JpY2FsX2Nyb3NzZW50cm9weScsXG4gICAgIG9wdGltaXplciA9ICdhZGFtJyxcbiAgICAgbWV0cmljcyA9ICdhY2N1cmFjeSdcbiApXG5cbiMgQWRhdHRhIGlsIG1vZGVsbG8gYWkgZGF0aVxubW9kZWwgJT4lIGZpdChcbiAgICAgcmlzLnRyYWluaW5nLCBpcmlzLnRyYWluTGFiZWxzLCBcbiAgICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LCBcbiAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKVxuXG4jIFZhbHV0YSBpbCBtb2RlbG9cbnNjb3JlIDwtIG1vZGVsICU+JSBldmFsdWF0ZShpcmlzLnRlc3QsIGlyaXMudGVzdExhYmVscywgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBTdGFtcGEgbG8gc2NvcmVcbnByaW50KHNjb3JlKSJ9

Nota che puoi anche visualizzare le metriche di perdita e accuratezza di questo nuovo modello! Prova nel riquadro DataCamp Light qui sotto:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml6aWFsaXp6YSB1biBtb2RlbG8gc2VxdWVuemlhbGVcbm1vZGVsIDwtIGtlcmFzX21vZGVsX3NlcXVlbnRpYWwoKSBcblxuIyBBZ2dpdW5naSBsYXllciBhbCBtb2RlbG9cbm1vZGVsICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDgsIGFjdGl2YXRpb24gPSAncmVsdScsIGlucHV0X3NoYXBlID0gYyg0KSkgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gNSwgYWN0aXZhdGlvbiA9ICdyZWx1JykgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMywgYWN0aXZhdGlvbiA9ICdzb2Z0bWF4JylcblxuIyBDb21waWxlIGlsIG1vZGVsbG9cbm1vZGVsICU+JSBjb21waWxlKFxuICAgICBsb3NzID0gJ2NhdGVnb3JpY2FsX2Nyb3NzZW50cm9weScsXG4gICAgIG9wdGltaXplciA9ICdhZGFtJyxcbiAgICAgbWV0cmljcyA9ICdhY2N1cmFjeSdcbiApXG5cbiMgU2FsdmEgbGEgY3Jvbm9sb2dpYSBkaSB0cmFpbmluZyBpbiBoaXN0b3J5XG5oaXN0b3J5IDwtIG1vZGVsICU+JSBmaXQoXG4gIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LFxuICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKVxuXG4jIFRyYWNjaWEgbGEgcGVyZGl0YSBkZWwgbW9kZWxvXG5wbG90KGhpc3RvcnkkbWV0cmljcyRsb3NzLCBtYWluPVwiUGVyZGl0YSBkZWwgTW9kZWxvXCIsIHhsYWIgPSBcImVwb2NoXCIsIHlsYWI9XCJsb3NzXCIsIGNvbD1cImJsdWVcIiwgdHlwZT1cImxcIilcbmxpbmVzKGhpc3RvcnkkbWV0cmljcyR2YWxfbG9zcywgY29sPVwiZ3JlZW5cIilcbmxlZ2VuZChcInRvcHJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpXG5cbiMgVHJhY2NpYSBsJ2FjY3VyYWN6YSBkZWwgbW9kZWxvXG5wbG90KGhpc3RvcnkkbWV0cmljcyRhY2MsIG1haW49XCJBY2N1cmF0ZXp6YSBkZWwgTW9kZWxvXCIsIHhsYWIgPSBcImVwb2NoXCIsIHlsYWI9XCJhY2N1cmFjeVwiLCBjb2w9XCJibHVlXCIsIHR5cGU9XCJsXCIpXG5saW5lcyhoaXN0b3J5JG1ldHJpY3MkdmFsX2FjYywgY29sPVwiZ3JlZW5cIilcbmxlZ2VuZChcImJvdHRvbXJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpIn0=

deep learning model layers

Keras Layers model

Unità nascoste

Prova anche l’effetto di aggiungere più unità nascoste all’architettura del tuo modello e studiane l’impatto sulla valutazione, proprio così:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIGEgc2VxdWVudGlhbCBtb2RlbFxubW9kZWwgPC0ga2VyYXNfbW9kZWxfc2VxdWVudGlhbCgpIFxuXG4jIEFkZCBsYXllcnMgdG8gdGhlIG1vZGVsXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSAyOCwgYWN0aXZhdGlvbiA9ICdyZWx1JywgaW5wdXRfc2hhcGUgPSBjKDQpKSAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSAzLCBhY3RpdmF0aW9uID0gJ3NvZnRtYXgnKVxuXG4jIENvbXBpbGUgdGhlIG1vZGVsXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuXG4jIEZpdCB0aGUgbW9kZWwgdG8gdGhlIGRhdGFcbm1vZGVsICU+JSBmaXQoXG4gICAgIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICAgICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LCBcbiAgICAgdmFsaWRhdGlvbl9zcGxpdCA9IDAuMlxuIClcblxuIyBFdmFsdWF0ZSB0aGUgbW9kZWxcbnNjb3JlIDwtIG1vZGVsICU+JSBldmFsdWF0ZShpcmlzLnRlc3QsIGlyaXMudGVzdExhYmVscywgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBQcmludCB0aGUgc2NvcmVcbnByaW50KHNjb3JlKSJ9

Tieni presente che, in generale, questa non è sempre l’ottimizzazione migliore perché, se non hai una grande quantità di dati, l’overfitting può peggiorare. Ecco perché con dataset piccoli come questo è meglio usare una rete compatta.

Perché non provi a visualizzare l’effetto dell’aggiunta dei nodi nascosti nel tuo modello? Provalo qui sotto:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBzZXF1ZW50aWFsIG1vZGVsXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5cbiMgQWRkIGxheWVycyB0byB0aGUgbW9kZWxcbm9kZWwgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMjgsIGFjdGl2YXRpb24gPSAncmVsdScsIGlucHV0X3NoYXBlID0gYyg0KSkgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMywgYWN0aXZhdGlvbiA9ICdzb2Z0bWF4JylcblxuIyBDb21waWxlIHRoZSBtb2RlbFxubW9kZWwgJT4lIGNvbXBpbGUoXG4gICAgIGxvc3MgPSAnY2F0ZWdvcmljYWxfY3Jvc3NlbnRyb3B5JyxcbiAgICAgb3B0aW1pemVyID0gJ2FkYW0nLFxuICAgICBtZXRyaWNzID0gJ2FjY3VyYWN5J1xuIClcblxuIyBTYXZlIHRoZSB0cmFpbmluZyBoaXN0b3J5IGluIHRoZSBoaXN0b3J5IHZhcmlhYmxlXG5oaXN0b3J5IDwtIG1vZGVsICU+JSBmaXQoXG4gIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LCBcbiAgdmFsaWRhdGlvbl9zcGxpdCA9IDAuMlxuIClcblxuIyBQbG90IHRoZSBtb2RlbCBsb3NzXG5wbG90KGhpc3RvcnkkbWV0cmljcyRsb3NzLCBtYWluPVwiTW9kZWwgTG9zc1wiLCB4bGFiID0gXCJlcG9jaFwiLCB5bGFiPVwibG9zc1wiLCBjb2w9XCJibHVlXCIsIHR5cGU9XCJsXCIpXG5saW5lcyhoaXN0b3J5JG1ldHJpY3MkdGFsX2xvc3MsIGNvbD1cImdyZWVuXCIpXG5sZWdlbmQoXCJ0b3ByaWdodFwiLCBjKFwidHJhaW5cIixcInRlc3RcIiksIGNvbD1jKFwiYmx1ZVwiLCBcImdyZWVuXCIpLCBsdHk9YygxLDEpKVxuXG4jIFBsb3QgdGhlIG1vZGVsIGFjY3VyYWN5XG5wbG90KGhpc3RvcnkkbWV0cmljcyRhY2MsIG1haW49XCJNb2RlbCBBY2N1cmFjeVwiLCB4bGFiID0gXCJlcG9jaFwiLCB5bGFiPVwiYWNjdXJhY3lcIiwgY29sPVwiYmx1ZVwiLCB0eXBlPVwibFwiKVxubGluZXMoaGlzdG9yeSRtZXRyaWNzJHZhbF9hY2MsIGNvbD1cImdyZWVuXCIpXG5sZWdlbmQoXCJib3R0b21yaWdodFwiLCBjKFwidHJhaW5cIixcInRlc3RcIiksIGNvbD1jKFwiYmx1ZVwiLCBcImdyZWVuXCIpLCBsdHk9YygxLDEpKSJ9

modello di rete neurale

unità nascoste ann

Parametri di ottimizzazione

Oltre ad aggiungere layer e giocare con le unità nascoste, puoi anche provare a regolare (alcuni) parametri dell’algoritmo di ottimizzazione che passi alla funzione compile(). Finora hai sempre passato un vettore con una stringa, adam, all’argomento optimizer.

Ma non deve per forza essere sempre così!

Prova anche a sperimentare altri algoritmi di ottimizzazione, come lo Stochastic Gradient Descent (SGD). Prova, per esempio, a usare la funzione optimizer_sgd() per regolare il tasso di apprendimento lr. Noti qualche effetto?

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoa2VyYXMpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcbmlyaXNbLDVdIDwtIGFzLm51bWVyaWMoaXJpc1ssNV0pIC0xXG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuZGltbmFtZXMoaXJpcykgPC0gTlVMTFxuaW5kIDwtIHNhbXBsZSgyLCBucm93KGlyaXMpLCByZXBsYWNlPVRSVUUsIHByb2I9YygwLjY3LCAwLjMzKSlcbmlyaXMudHJhaW5pbmcgPC0gaXJpc1tpbmQ9PTEsIDE6NF1cbmlyaXMudGVzdCA8LSBpcmlzW2luZD09MiwgMTo0XVxuaXJpcy50cmFpbmluZ3RhcmdldCA8LSBpcmlzW2luZD09MSw1XVxuaXJpcy50ZXN0dGFyZ2V0IDwtIGlyaXNbaW5kPT0yLCA1XVxuaXJpcy50cmFpbkxhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRyYWluaW5ndGFyZ2V0KVxuaXJpcy50ZXN0TGFiZWxzIDwtIHRvX2NhdGVnb3JpY2FsKGlyaXMudGVzdHRhcmdldCkiLCJzYW1wbGUiOiIjIEluaXRpYWxpemUgYSBzZXF1ZW50aWFsIG1vZGVsXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5cbiMgQnVpbGQgdXAgeW91ciBtb2RlbCBieSBhZGRpbmcgbGF5ZXJzIHRvIGl0XG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5cbiMgRGVmaW5lIGFuIG9wdGltaXplclxuc2dkIDwtIG9wdGltaXplcl9zZ2QobHIgPSAwLjAxKVxuXG4jIFVzZSB0aGUgb3B0aW1pemVyIHRvIGNvbXBpbGUgdGhlIG1vZGVsXG5tb2RlbCAlPiUgY29tcGlsZShvcHRpbWl6ZXI9c2dkLCBcbiAgICAgICAgICAgICAgICAgIGxvc3M9J2NhdGVnb3JpY2FsX2Nyb3NzZW50cm9weScsIFxuICAgICAgICAgICAgICAgICAgbWV0cmljcz0nYWNjdXJhY3knKVxuXG4jIEZpdCB0aGUgbW9kZWwgdG8gdGhlIHRyYWluaW5nIGRhdGFcbm1vZGVsICU+JSBmaXQoXG4gICAgIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICAgICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LCBcbiAgICAgdmFsaWRhdGlvbl9zcGxpdCA9IDAuMlxuIClcblxuIyBFdmFsdWF0ZSB0aGUgbW9kZWxcbnNjb3JlIDwtIG1vZGVsICU+JSBldmFsdWF0ZShpcmlzLnRlc3QsIGlyaXMudGVzdExhYmVscywgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBQcmludCB0aGUgbG9zcyBhbmQgYWNjdXJhY3kgbWV0cmljc1xucHJpbnQoc2NvcmUpIn0=

Oltre a usare un altro ottimizzatore, puoi anche provare un learning rate più basso per addestrare la rete. Questa è una delle tecniche di fine-tuning più comuni; Una pratica diffusa è impostare il learning rate iniziale 10 volte più piccolo di quello usato in precedenza per addestrare il modello.

Visualizziamo di nuovo la storia di training per vedere l’effetto di questo piccolo aggiustamento:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoa2VyYXMpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcbmlyaXNbLDVdIDwtIGFzLm51bWVyaWMoaXJpc1ssNV0pIC0xXG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuZGltbmFtZXMoaXJpcykgPC0gTlVMTFxuaW5kIDwtIHNhbXBsZSgyLCBucm93KGlyaXMpLCByZXBsYWNlPVRSVUUsIHByb2I9YygwLjY3LCAwLjMzKSlcbmlyaXMudHJhaW5pbmcgPC0gaXJpc1tpbmQ9PTEsIDE6NF1cbmlyaXMudGVzdCA8LSBpcmlzW2luZD09MiwgMTo0XVxuaXJpcy50cmFpbmluZ3RhcmdldCA8LSBpcmlzW2luZD09MSw1XVxuaXJpcy50ZXN0dGFyZ2V0IDwtIGlyaXNbaW5kPT0yLCA1XVxuaXJpcy50cmFpbkxhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRyYWluaW5ndGFyZ2V0KVxuaXJpcy50ZXN0TGFiZWxzIDwtIHRvX2NhdGVnb3JpY2FsKGlyaXMudGVzdHRhcmdldClcbm1vZGVsIDwtIGtlcmFzX21vZGVsX3NlcXVlbnRpYWwoKSBcbm1vZGVsICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDgsIGFjdGl2YXRpb24gPSAncmVsdScsIGlucHV0X3NoYXBlID0gYyg0KSkgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMywgYWN0aXZhdGlvbiA9ICdzb2Z0bWF4JykiLCJzYW1wbGUiOiIjIERlZmluZSBhbiBvcHRpbWl6ZXJcbnNnZCA8LSBvcHRpbWl6ZXJfc2dkKGxyID0gMC4wMSlcblxuIyBDb21waWxlIHRoZSBtb2RlbFxubW9kZWwgJT4lIGNvbXBpbGUob3B0aW1pemVyPXNnZCwgXG4gICAgICAgICAgICAgICAgICBsb3NzPSdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLCBcbiAgICAgICAgICAgICAgICAgIG1ldHJpY3M9J2FjY3VyYWN5JylcblxuIyBGaXQgdGhlIG1vZGVsIHRvIHRoZSB0cmFpbmluZyBkYXRhXG5oaXN0b3J5IDwtIG1vZGVsICU+JSBmaXQoXG4gIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LCBcbiAgdmFsaWRhdGlvbl9zcGxpdCA9IDAuMlxuIClcblxuIyBQbG90IHRoZSBtb2RlbCBsb3NzXG5wbG90KGhpc3RvcnkkbWV0cmljcyRsb3NzLCBtYWluPVwiTW9kZWwgTG9zc1wiLCB4bGFiID0gXCJlcG9jaFwiLCB5bGFiPVwibG9zc1wiLCBjb2w9XCJibHVlXCIsIHR5cGU9XCJsXCIpXG5saW5lcyhoaXN0b3J5JG1ldHJpY3MkdGFsX2xvc3MsIGNvbD1cImdyZWVuXCIpXG5sZWdlbmQoXCJ0b3ByaWdodFwiLCBjKFwidHJhaW5cIixcInRlc3RcIiksIGNvbD1jKFwiYmx1ZVwiLCBcImdyZWVuXCIpLCBsdHk9YygxLDEpKVxuXG4jIFBsb3QgdGhlIG1vZGVsIGFjY3VyYWN5XG5wbG90KGhpc3RvcnkkbWV0cmljcyRhY2MsIG1haW49XCJNb2RlbCBBY2N1cmFjeVwiLCB4bGFiID0gXCJlcG9jaFwiLCB5bGFiPVwiYWNjdXJhY3lcIiwgY29sPVwiYmx1ZVwiLCB0eXBlPVwibFwiKVxubGluZXMoaGlzdG9yeSRtZXRyaWNzJHZhbF9hY2MsIGNvbD1cImdyZWVuXCIpXG5sZWdlbmQoXCJib3R0b21yaWdodFwiLCBjKFwidHJhaW5cIixcInRlc3RcIiksIGNvbD1jKFwiYmx1ZVwiLCBcImdyZWVuXCIpLCBsdHk9YygxLDEpKSJ9

modello di rete neurale

unità nascoste ann

Salvataggio, caricamento o esportazione del tuo modello

C’è un’ultima cosa che resta nel tuo percorso con il pacchetto keras: salvare o esportare il modello in modo da poterlo ricaricare in un altro momento.

  • Per prima cosa, puoi facilmente usare le funzioni save_model_hdf5() e load_model_hdf5() per salvare e caricare il modello nel tuo workspace:
save_model_hdf5(model, "my_model.h5")
model <- load_model_hdf5("my_model.h5")
  • Inoltre, puoi anche salvare e caricare i pesi del modello con le funzioni save_model_weights_hdf5() e load_model_weights_hdf5():
save_model_weights_hdf5("my_model_weights.h5")
model %>% load_model_weights_hdf5("my_model_weights.h5")
  • Infine, è utile sapere che puoi anche esportare la configurazione del modello in JSON o YAML. Qui ti vengono in aiuto le funzioni model_to_json() e model_to_yaml(). Per ricaricare le configurazioni nel tuo workspace, puoi semplicemente usare le funzioni model_from_json() e model_from yaml():
json_string <- model_to_json(model)
model <- model_from_json(json_string)

yaml_string <- model_to_yaml(model)
model <- model_from_yaml(yaml_string)
Impara Python per il Data Science con DataCamp

Deep Learning con Keras

Complimenti! Hai portato a termine questo tutorial di deep learning in R con keras. Questo tutorial è solo un piccolo passo nel tuo percorso di deep learning con R; c’è molto altro da esplorare! Se non hai ancora seguito il corso di DataCamp Deep Learning in Python, potresti prendere in considerazione l’idea di farlo.

Nel frattempo, assicurati anche di dare un’occhiata alla documentazione di Keras e alla documentazione di keras di RStudio, se non l’hai già fatto. Troverai altri esempi e informazioni su tutte le funzioni, gli argomenti, più layer, ecc… Dai anche un’occhiata al libro di François Chollet “Deep Learning with Python”. Tutte queste risorse saranno senza dubbio indispensabili per imparare a lavorare con le reti neurali in R!

Argomenti
R
Data Science
Intelligenza artificiale
Machine Learning
Deep Learning

Corsi correlati

Corso

Introduzione a R

4 ore
3.1M
Impara le basi dell'analisi dei dati in R, compresi vettori, liste e data frame, e fai pratica con R con set di dati reali.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

Mostra AltroMostra Altro

