Kurs
Einführung in R
4 Std.
3.1M
Wie du inzwischen weißt, ist Machine Learning ein Teilbereich der Informatik (CS). Deep Learning ist wiederum ein Teilbereich des Machine Learning: eine Menge von Algorithmen, die von Struktur und Funktion des Gehirns inspiriert sind und meist als Künstliche Neuronale Netze (ANN) bezeichnet werden. Deep Learning ist derzeit einer der heißesten Trends im Machine Learning und glänzt bei vielen Aufgaben – etwa in Robotik, Bilderkennung und Künstlicher Intelligenz (KI).
Dieses Tutorial gibt dir eine kurze Einführung in Deep Learning in R mit Keras über das keras-Paket:
Willst du mehr über das ursprüngliche Keras oder über zentrale Deep-Learning-Konzepte wie Perceptrons und Multi-Layer Perceptrons (MLPs) erfahren? Dann schau dir DataCamps Kurs Deep Learning in Python an oder arbeite das Keras Tutorial: Deep Learning in Python durch.
Tipp: Unser Keras-Cheatsheet findest du hier.
Mit dem Aufstieg von Deep Learning ist CRAN um mehrere R-Pakete für Deep Learning gewachsen. Unten siehst du einen Überblick – entnommen aus der CRAN Task View zu Machine Learning und Statistical Learning. Die Spalte „Percentile“ zeigt das Perzentil laut RDocumentation:
| R-Paket | Perzentil | Beschreibung |
|---|---|---|
| nnet | 96th | Software für Feedforward-Netze mit einer versteckten Schicht sowie für multinomiale log-lineare Modelle. |
| neuralnet | 96th | Training neuronaler Netze mit Backpropagation |
| h2o | 95th | R-Skripting-Funktionalität für H2O |
| RSNNS | 88th | Schnittstelle zum Stuttgart Neural Network Simulator (SNNS) |
| tensorflow | 88th | Schnittstelle zu TensorFlow |
| deepnet | 84th | Deep-Learning-Toolkit in R |
| darch | 79th | Paket für Deep Architectures und Restricted Boltzmann Machines |
| rnn | 73rd | Paket zur Implementierung von Recurrent Neural Networks (RRNs) |
| FCNN4R | 52nd | Schnittstelle zur FCNN-Bibliothek für erweiterbare ANNs |
| rcppDL | 7th | Implementierung grundlegender Machine-Learning-Methoden mit vielen Schichten (Deep Learning), inklusive dA (Denoising Autoencoder), SdA (Stacked Denoising Autoencoder), RBM (Restricted Boltzmann Machine) und DBN (Deep Belief Nets) |
| deepr | ??* | Paket zur Vereinfachung von Training, Feintuning und Vorhersage für Deep Learning auf Basis von darch und deepnet |
| MXNetR | ??* | Paket, das flexible, effiziente GPU-Berechnungen und State-of-the-Art-Deep-Learning nach R bringt |
Tipp: Einen Vergleich von Deep-Learning-Paketen in R findest du in diesem Blogpost. Mehr zu Ranking und Score in RDocumentation gibt’s in diesem Beitrag.
Die Pakete deepr und MXNetR wurden nicht auf RDocumentation.org gefunden, daher ist das Perzentil unbekannt.
Kürzlich haben zwei neue Pakete die R-Community erreicht: das Paket kerasR von Taylor Arnold und RStudios Paket keras.
Beide Pakete stellen eine R-Schnittstelle zum Python-Deep-Learning-Paket Keras bereit, von dem du vermutlich schon gehört hast – oder vielleicht arbeitest du bereits damit! Für alle, die Keras in Python noch nicht kennen: Es ist „eine High-Level-API für neuronale Netze, geschrieben in Python und lauffähig auf TensorFlow, Microsoft Cognitive Toolkit (CNTK) oder Theano“.
Der Einstieg in Keras ist eine der einfachsten Arten, sich mit Deep Learning in Python vertraut zu machen – deshalb bieten kerasR und keras eine Schnittstelle zu diesem großartigen Paket für R-Nutzende.
Wichtig ist zu verstehen, was es konkret bedeutet, wenn ein Paket – etwa das R-Paket keras – „eine Schnittstelle“ zu einem anderen Paket ist, hier zu Keras in Python. Kurz gesagt heißt das: Das R-Paket keras ermöglicht dir, in R zu programmieren und dabei die Funktionalität des Python-Pakets Keras zu nutzen.
Das ist keineswegs ungewöhnlich: Auch das Paket h2o stellt eine Schnittstelle bereit – wie der Name vermuten lässt – zu H2O, einer Open-Source-Rechen-Engine für Big Data, mit der du verteilte Machine-Learning-Algorithmen parallel berechnen kannst. Weitere Beispiele: RWeka (R-Schnittstelle zu Weka), tensorflow (R-Schnittstelle zu TensorFlow), openml-r (R-Schnittstelle zu OpenML), … die Liste ließe sich fortsetzen!
Wenn du das weißt, stellst du dir wahrscheinlich zuerst die Frage: Wie vergleicht man das ursprüngliche Python-Paket mit den R-Paketen?
Im Kern wirst du kaum Unterschiede zwischen den R-Paketen und dem Python-Original finden – die Funktionsnamen sind meist identisch. Unterschiede ergeben sich vor allem aus den Sprachen selbst (Zuweisung, Laden von Bibliotheken, …). Entscheidend ist, wie viel der Originalfunktionalität im jeweiligen R-Paket umgesetzt wurde.
Das gilt nicht nur für keras, sondern auch für tensorflow, openml-r und die anderen oben genannten Schnittstellenpakete!
Zweitens fragst du dich vielleicht, worin sich die beiden R-Pakete unterscheiden. Denk an folgende Punkte:
Das Paket keras nutzt den Pipe-Operator (%>%), um Funktionen bzw. Operationen zu verketten; in kerasR findest du das nicht. In kerasR arbeitest du z. B. mit dem $-Operator. Die Pipe erhöht in der Regel die Lesbarkeit und ist dir sicher aus den Tidyverse-Paketen bekannt.
In kerasR sind Funktionsnamen ähnlich, aber nicht identisch zum Original. Die Python-Funktion compile() heißt z. B. keras_compile(); fit() wird zu keras_fit(), predict() zu keras_predict usw. – es sind Wrapper.
Die Installation von RStudios keras ist oft einfacher als die von kerasR: Für kerasR musst du die zu nutzende Python-Version konfigurieren – knifflig auf Rechnern mit mehreren Umgebungen oder Python-Versionen. Entscheide selbst :)

Jetzt, da du etwas Hintergrund hast, wird’s Zeit, Keras in R praktisch anzuwenden. Wie in der Einleitung angekündigt, richtest du zuerst deine Arbeitsumgebung ein. Dann lädst du Daten und nach einer kurzen Erkundung und Vorverarbeitung baust du dein MLP!
Los geht’s!
Wie immer startest du mit dem Setup: Installiere das Paket und lade es in RStudio oder deine bevorzugte Umgebung.
Keine Sorge, für dieses Tutorial wird das Paket für dich geladen!
Installiere zunächst keras – am einfachsten mit devtools::install_github("rstudio/keras") in der Konsole. Danach lädst du das Paket und installierst TensorFlow:
# Load in the keras package
library(keras)

# Install TensorFlow
install_tensorflow()
Fertig? Dann kann’s losgehen – ging schnell, oder?
Tipp: Mehr zur Installation findest du auf der Paket-Website.
Jetzt, wo die Installation sitzt und dein Workspace bereit ist, kannst du Daten laden! Du hast grundsätzlich drei Optionen: Du nutzt eingebaute Datensätze aus dem keras-Paket, lädst eigene Daten z. B. aus CSV-Dateien, oder erstellst Dummy-Daten.
Ganz egal, welche Option du wählst – du kommst schnell ins Arbeiten. Dieser Abschnitt zeigt kurz alle drei Varianten und wie du die benötigten Daten lädst (oder erzeugst)!
Wenn du schon mit Keras in Python gearbeitet hast, kennst du die eingebauten Datensätze – etwa via mnist.load_data(), cifar10.load_data() oder imdb.load_data().
So lädst du MNIST, CIFAR10 und IMDB mit dem keras-Paket in R:
# Read in MNIST data
mnist <- dataset_mnist()

# Read in CIFAR10 data
cifar10 <- dataset_cifar10()

# Read in IMDB data
imdb <- dataset_imdb()
Beachte: Die Ladefunktionen für eingebaute Datensätze in keras folgen einem Muster; Für MNIST nutzt du z. B. dataset_mnist().
Alternativ kannst du schnell Dummy-Daten erzeugen. Das geht leicht mit matrix():
Es ist sinnvoll, die Struktur deiner Daten zu prüfen – du solltest wissen, womit du arbeitest, da das für die nächsten Schritte wichtig ist. Mehr dazu folgt weiter unten!
Neben eingebauten Datensätzen kannst du auch Daten aus Dateien laden. In diesem Tutorial konzentrieren wir uns auf CSV-Dateien. Wenn du mehr zum Import in R wissen willst, sieh dir DataCamps R Data Import Tutorial an.
Wir nutzen read.csv() (aus read.table), um einen Datensatz aus dem UCI Machine Learning Repository zu laden:
Prüfe immer, ob der Import erfolgreich war. Typische Funktionen dafür: head(), str() und dim() – wie im DataCamp-Light-Block oben.
Die Ausgaben dieser drei Funktionen zeigen nichts Ungewöhnliches. In der Struktur (str()) siehst du, dass die Strings der Spalte Species als Faktoren eingelesen wurden. Das ist kein Problem – aber gut zu wissen für die nächsten Schritte, in denen du die Daten erkundest und vorverarbeitest.
Für dieses Tutorial arbeitest du weiter mit dem berühmten iris-Datensatz, den du mit read.csv() importiert hast.
Für alle ohne botanischen Hintergrund hier etwas Kontext: Jede Blüte hat Kelchblatt (sepal) und Kronblatt (petal). Das Kelchblatt umschließt die Kronblätter, ist meist grün und blattähnlich; die Kronblätter sind meist farbig. Bei der Iris sieht das etwas anders aus – siehe Abbildung:

Dir ist vielleicht aufgefallen, dass der Data Frame iris nach dem Import keine Spaltennamen hatte. Für den Rest des Tutorials ist das nicht kritisch: Zwar liefert read.csv() einen data.frame zurück, aber die Daten, die du an fit() übergibst, müssen Matrix oder Array sein.
Ein paar Dinge zu den genannten Strukturen: – Matrizen und Arrays haben keine Spaltennamen; – Matrizen sind zweidimensionale Objekte eines einzigen Datentyps; – Arrays sind mehrdimensionale Objekte eines einzigen Datentyps.
Tipp: Schau dir dieses Video zur Auffrischung der Datenstrukturen in R an!
Ein Data Frame ist dagegen eine besondere Form einer benannten Liste, deren Elemente alle die gleiche Länge haben. Er ist mehrdimensional und kann mehrere Datentypen enthalten. Das hast du bereits in der Struktur des iris-Data-Frames gesehen. Da du auf ein zwei- oder mehrdimensionales Objekt mit einem Datentyp hinarbeiten musst, wirst du vor dem Netzbau etwas vorverarbeiten!
Für die Erkundung sind Spaltennamen jedoch hilfreich – sie erleichtern das Verständnis. Lass uns also mit names() Spaltennamen vergeben. Danach kannst du iris direkt nutzen. Plotte zum Beispiel mit plot(), wie Petal Length und Petal Width korrelieren.
Mit unclass() wandelst du die Artnamen „setosa, versicolor, virginica“ in die numerischen 1, 2 und 3 um.
Sieh dir das Plot-Ergebnis genauer an:

Die Grafik zeigt eine positive Korrelation zwischen Petal.Length und Petal.Width für die drei Iris-Arten. Das kannst du mit cor() auch quantitativ prüfen – diese Funktion liefert die Gesamt-Korrelation zwischen den Attributen des Datensatzes:
Mit dem Paket corrplot kannst du zusammen mit cor() die Korrelationen deiner Attribute visualisieren. Hier berechnest du die Korrelationen für alle Attribute des iris-Data-Frames, speicherst sie in M und übergibst M an corrplot().
Vergiss nicht, über den Parameter method festzulegen, wie geplottet werden soll!
Experimentiere mit der Darstellungsart im folgenden DataCamp-Light-Block:

Nutze die R-Konsole, um deine Daten weiter zu erkunden.
Wenn du mit ggvis (interaktive „Grammar of Graphics“) plotten willst, sieh dir DataCamps Tutorial Machine Learning in R für Einsteiger oder den ggvis-Kurs an.
Bevor du dein Modell baust, sollten die Daten bereinigt, ggf. normalisiert und in Trainings- und Testdaten geteilt sein. Da der Datensatz aus dem UCI-Repository kommt, ist er voraussichtlich recht sauber – dennoch: Prüfe die Qualität.
Auf den ersten Blick war bei head() nichts Auffälliges zu sehen. Nutze summary() und str(), um kurz zusammenzufassen, was du beim Import gelernt hast:
Jetzt kannst du prüfen, ob eine Normalisierung nötig ist.
Aus summary() oben siehst du: Der Iris-Datensatz braucht keine Normalisierung. Sepal.Length reicht von 4,3 bis 7,9, Sepal.Width von 2 bis 4,4, Petal.Length von 1 bis 6,9 und Petal.Width von 0,1 bis 2,5. Alle Werte liegen roughly zwischen 0,1 und 7,9 – akzeptabel.
Trotzdem lohnt es sich, den Effekt der Normalisierung zu untersuchen – und die normalisierten Daten ans Modell zu geben, um Unterschiede zu sehen. Das sprengt hier den Rahmen, aber probier es gern selbst aus. Der Code steht im Tutorial :)
Du kannst eine eigene Min-Max-Normalisierungsfunktion schreiben, die (x–min)/(max–min) berechnet: Du übergibst x, berechnest num = x–min(x), denom = max(x)–min(x) und gibst num/denom zurück.
Um die Funktion auf die iris-Daten (ohne Zielwerte) anzuwenden, nutzt du neben normalize auch lapply(), etwa so:
Tipp: Nutze hist() in der R-Konsole, um die Verteilung der Iris-Daten vor (iris) und nach der Normalisierung (iris_norm) zu vergleichen.
Für die normalize()-Funktion aus keras musst du zunächst mit einer Matrix arbeiten. Erinnerst du dich? Matrizen enthalten nur einen Datentyp. Deine Zielwerte sind aber Faktoren, der Rest numerisch.
Das musst du zuerst ändern.
Mit as.numeric() wandelst du die Daten in Zahlen:
Ein numerischer Data Frame ist okay, aber für keras brauchst du Matrix oder Array. Das geht mit as.matrix(); vergiss nicht, dimnames auf NULL zu setzen.
Auch wenn hier keine Normalisierung nötig ist, lohnt es sich, sie zu untersuchen – per eigener Funktion und per normalize() aus keras.
Mit den Daten als Matrix kannst du die eingebaute normalize()-Funktion verwenden, um den Effekt zu prüfen:
Hier setzt du mit dimnames() die Dim-Namen auf NULL, damit keine Spaltennamen mehr vorhanden sind.
Nachdem die Datenqualität passt und keine Normalisierung nötig ist, arbeitest du mit den Originaldaten weiter und teilst sie in Training und Test – so kannst du die Modellleistung fair beurteilen.
Setze vor dem Split einen Seed mit set.seed() und einer ganzen Zahl. Der Seed steuert den Zufallszahlengenerator in R und ermöglicht Reproduzierbarkeit.
Mit sample() ziehst du eine Stichprobe in der Größe der Zeilenanzahl (150). Du samplest mit Zurücklegen: Aus einem Vektor mit zwei Elementen weist du jeder der 150 Zeilen entweder 1 oder 2 zu – mit den Wahrscheinlichkeiten 0,67 und 0,33.
Das Argument replace=TRUE in sample() bedeutet, dass die Auswahl mit Zurücklegen erfolgt.
Anders gesagt: Für jede nächste Zeile weist du erneut 1 oder 2 zu – jeweils gemäß der festgelegten Wahrscheinlichkeiten.
Hinweis: Bei eingebauten Datensätzen wie dataset_imdb() könntest du per $-Operator direkt splitten:
x_train <- imdb$train$x
y_train <- imdb$train$y
x_test <- imdb$test$x
y_test <- imdb$test$y
Du hast die Daten erfolgreich gesplittet – ein Schritt fehlt noch, bevor du das Modell baust. Welche Vermutung hast du?
Bei Multiklassenproblemen ist es üblich, das Zielattribut von einem Vektor mit Klassenwerten in eine Matrix aus Booleans zu transformieren – je Klasse eine Spalte, je Instanz 1/0.
Das ist – grob – One-Hot-Encoding (OHE).
Zum Glück übernimmt das keras-Paket das für dich: Nutze to_categorical() für iris.trainingtarget und iris.testtarget und speichere in iris.trainLabels bzw. iris.testLabels:
Damit sind Erkundung und Vorverarbeitung abgeschlossen. Jetzt baust du mit keras dein neuronales Netz!
Starte mit einem sequenziellen Modell via keras_model_sequential(). Dann geht’s ans Modellieren.
Noch einmal zur Zielsetzung: Kannst du die Art einer Iris-Blüte vorhersagen? Numerische Daten sind einfacher zu verarbeiten, und du hast die Zielvariable bereits One-Hot-encodiert: Eine Blüte ist entweder versicolor, setosa oder virginica – und das spiegelt sich in binären 1/0-Werten wider.
Ein Netz, das für solche Probleme gut funktioniert, ist ein Multi-Layer Perceptron. Diese Netze sind oft „fully connected“, also voll verbunden. Du baust also einen einfachen Stapel aus Dense-Schichten. Als Aktivierungsfunktion eignet sich zum Einstieg die verbreitete relu für die versteckte Schicht – bewährte Praxis.
In der Ausgabeschicht nutzt du softmax, damit die Ausgaben im Bereich 0 bis 1 liegen und als vorhergesagte Wahrscheinlichkeiten interpretierbar sind:
Die Ausgabeschicht erzeugt 3 Werte – je eine Wahrscheinlichkeit für versicolor, virginica und setosa. Die erste Schicht mit 8 Neuronen hat input_shape=4, da iris.training 4 Spalten hat.
Folgende Funktionen helfen bei der Inspektion des Modells:
Jetzt kompilierst du das Modell und passt es an die Daten an. Zum Kompilieren konfigurierst du den adam-Optimizer und die Verlustfunktion categorical_crossentropy. Zusätzlich überwachst du die Genauigkeit, indem du 'accuracy' an metrics übergibst.
Optimizer und Loss sind Pflichtargumente beim Kompilieren.
Zu den populären Optimierern zählen Stochastic Gradient Descent (SGD), ADAM und RMSprop. Je nach Algorithmus musst du Parameter wie Lernrate oder Momentum tunen. Die Wahl der Verlustfunktion hängt von der Aufgabe ab: Für Regression etwa häufig Mean Squared Error (MSE).
Hier nutzt du categorical_crossentropy für das Multiklassenproblem (versicolor, virginica oder setosa). Bei binärer Klassifikation würdest du binary_crossentropy verwenden.
Anschließend passt du das Modell an: Hier trainierst du 200 Epochen über alle Samples in iris.training und iris.trainLabels, in Batches von 5 Samples.
Tipp: Mit verbose=1 in fit() bekommst du Fortschrittsbalken-Logging.
Du trainierst also für eine festgelegte Zahl an Epochen (jeder Durchlauf über den gesamten Trainingssatz, mit anschließender Validierung). batch_size legt fest, wie viele Samples pro Schritt durch das Netz laufen – effizienter, da nicht zu viele Muster gleichzeitig im Speicher liegen.
Du kannst die Anpassung auch visualisieren, wenn du das Ergebnis von fit() in einer Variablen speicherst und an plot() übergibst – so wie hier:
Sieh dir die Plots im Detail an.
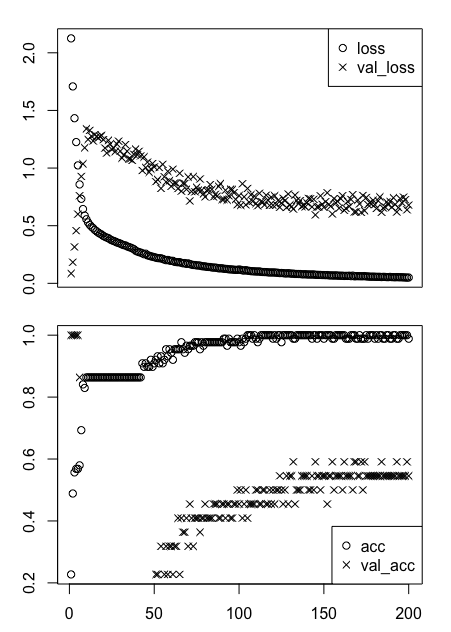
Auf den ersten Blick wirkt das unübersichtlich – verständlich.
Wichtig: loss und acc zeigen Verlust und Genauigkeit auf den Trainingsdaten; val_loss und val_acc dieselben Metriken für Validierungs-/Testdaten.
Trotzdem sind die Graphen nicht leicht zu interpretieren. Zerlegen wir sie: Erstelle zwei separate Plots – einen für den Modellverlust und einen für die Genauigkeit. Mit dem $-Operator greifst du auf die Daten zu und plottest Schritt für Schritt.
So geht’s im folgenden DataCamp-Light-Block:

Hier hast du den Verlust für Training und Test geplottet. Jetzt auch die Genauigkeit:
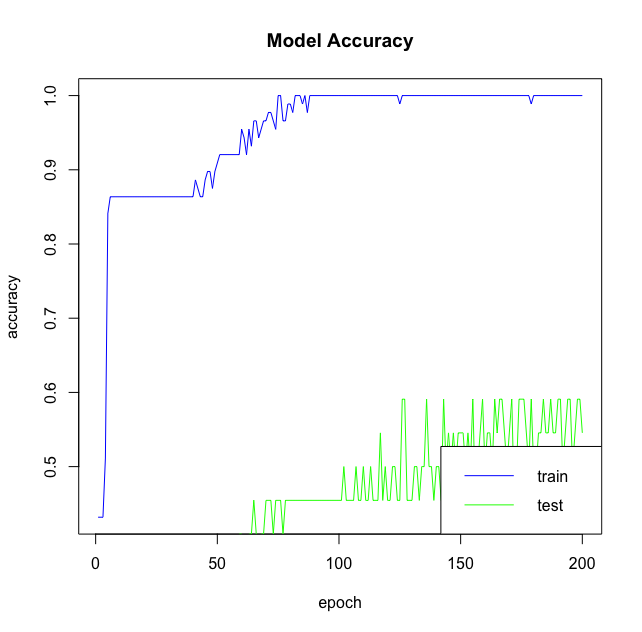
Denk an Folgendes:
Dein Modell ist erstellt, kompiliert und gefittet – Zeit für Vorhersagen auf dem Testset iris.test. Wie erwartet nutzt du predict(). Danach gibst du mit table() eine Konfusionsmatrix aus, um Vorhersagen und echte Labels zu vergleichen.
Wie wirken die Ergebnisse auf dich? Trifft das Modell auf Anhieb die richtigen Vorhersagen?
Auch wenn die Konfusionsmatrix schon einen Eindruck vermittelt, solltest du dein Modell systematisch evaluieren. Nutze evaluate(): Übergebe iris.test, iris.testLabels und eine Batchgröße. Speichere das Ergebnis in score – so wie hier:
Beim Print von score bekommst du Verlust und Metrik (hier „accuracy“) zurück.
Feintuning wirst du häufig brauchen – gerade am Anfang, da viele Klassifikations- und Regressionsprobleme komplexer sind als unser Beispiel. Zwei zentrale Stellschrauben sind: Anzahl der Schichten und Zahl der „hidden units“ pro Schicht.
Am Anfang ist das eine kleine Reise.
Neben Epochen- und Batchgröße kannst du dein Modell auch so tweaken: Schichten hinzufügen, die Zahl versteckter Neuronen erhöhen und Optimierungsparameter in compile() anpassen. Hier sind drei Optionen.
Was passiert, wenn du eine weitere Schicht hinzufügst? Zum Beispiel so:
Verwandte Kurse
Kurs
Kurs
Kurs
Blog
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Aditya Sharma
5 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
DataCamp Team
3 Min.


