
Last chance! 50% off DataCamp Premium
Sale ends in
Artık bildiğiniz gibi, makine öğrenimi Bilgisayar Bilimi (CS) içinde bir alt alandır. Derin öğrenme ise, beynin yapısından ve işlevinden esinlenen ve genellikle Yapay Sinir Ağları (ANN) olarak adlandırılan bir algoritmalar kümesi olan makine öğreniminin bir alt alanıdır. Derin öğrenme günümüzde makine öğreniminin en popüler trendlerinden biridir ve robotik, görüntü tanıma ve Yapay Zekâ (AI) gibi derin öğrenmenin parladığı pek çok problem vardır.
Bugünkü eğitim, R'de Keras ile derin öğrenmeye kısa bir giriş sunacak; bunun için keras paketini kullanacağız:
Orijinal Keras hakkında veya algılayıcılar ve Çok Katmanlı Algılayıcılar (MLP) gibi derin öğrenmenin temel kavramları hakkında daha fazla bilgi almak ister misiniz? DataCamp’in Python ile Derin Öğrenme kursunu veya Keras Eğitimi: Python ile Derin Öğrenme içeriğini incelemeyi düşünün.
İpucu: Keras hızlı başvuru kılavuzumuza buradan ulaşabilirsiniz.
Derin öğrenmenin popülerliğinin artmasıyla, CRAN R derin öğrenme paketleriyle zenginleşti; Aşağıda, Makine Öğrenimi ve İstatistiksel Öğrenme CRAN görev görünümünden alınmış bu paketlere bir genel bakış görebilirsiniz. “Yüzdelik” sütunu, RDocumentation’da bulunan yüzdeliği gösterir:
| R Paketi | Yüzdelik | Açıklama |
|---|---|---|
| nnet | 96. | Tek gizli katmanlı ileri beslemeli sinir ağları ve çok terimli log-doğrusal modeller için yazılım. |
| neuralnet | 96. | Geri yayılım kullanarak sinir ağlarının eğitimi |
| h2o | 95. | H2O için R betikleme işlevselliği |
| RSNNS | 88. | Stuttgart Neural Network Simulator’a (SNNS) arayüz |
| tensorflow | 88. | TensorFlow’a arayüz |
| deepnet | 84. | R’de derin öğrenme araç seti |
| darch | 79. | Derin Mimâriler ve Kısıtlı Boltzmann Makineleri için paket |
| rnn | 73. | Yinelemeli Sinir Ağlarını (RNN) uygulamak için paket |
| FCNN4R | 52. | Kullanıcı tarafından genişletilebilir ANN’lere izin veren FCNN kütüphanesine arayüz |
| rcppDL | 7. | Birçok katmanlı (derin öğrenme) temel makine öğrenimi yöntemlerinin uygulanması; dA (Gürültü Giderici Otokodlayıcı), SdA (Yığılmış Gürültü Giderici Otokodlayıcı), RBM (Kısıtlı Boltzmann Makinesi) ve DBN (Derin İnanç Ağları) dahil |
| deepr | ??* | darch ve deepnet’e dayalı derin öğrenmede eğitim, ince ayar ve tahmin süreçlerini kolaylaştıran paket |
| MXNetR | ??* | Esnek ve verimli GPU hesaplamayı ve son teknoloji derin öğrenmeyi R’ye getiren paket |
İpucu: R’de derin öğrenme paketlerinin karşılaştırması için bu blog yazısını okuyun. RDocumentation’daki sıralama ve puanlama hakkında daha fazla bilgi için bu blog yazısına göz atın.
deepr ve MXNetR, RDocumentation.org’da bulunamadığından bu iki paket için yüzdelik dilim bilinmiyor.
Yakın zamanda R topluluğuna iki yeni paket katıldı: Taylor Arnold tarafından yazılıp oluşturulan kerasR paketi ve RStudio’nun keras paketi.
Her iki paket de Python’daki derin öğrenme paketi Keras’a bir R arayüzü sağlar; muhtemelen Keras’ı zaten duydunuz, hatta belki de onunla çalıştınız! Keras paketinin Python kullanıcılarına neler sunduğunu bilmeyenler için, Keras “Python ile yazılmış, TensorFlow, Microsoft Cognitive Toolkit (CNTK) veya Theano üzerinde çalışabilen, yüksek seviyeli bir sinir ağları API’sidir”.
Keras ile başlamak, Python’da derin öğrenmeye aşina olmanın en kolay yollarından biridir; bu da kerasR ve keras paketlerinin R kullanıcıları için bu harika pakete bir arayüz sağlamasını açıklar.
Bu noktada, R keras gibi bir paketin, Python Keras’a “arayüz” olması ifadesinin tam olarak ne anlama geldiğini anlamanız faydalıdır. Basitçe söylemek gerekirse, arayüze sahip keras R paketi, R programlamanın avantajlarından yararlanırken Python Keras paketinin yeteneklerine erişmenizi sağlar.
Bu yaygın bir uygulamadır: örneğin h2o paketi de bir arayüz sağlar, ancak bu durumda —ve isminden de anlaşılacağı üzere— büyük veriler için açık kaynaklı bir matematik motoru olan H2O’ya; bununla paralel dağıtık makine öğrenimi algoritmalarını hesaplayabilirsiniz. Bildiğiniz diğer arayüz sağlayan paketlere örnek olarak RWeka (Weka’ya R arayüzü), tensorflow (TensorFlow’a R arayüzü), openml-r (OpenML’e R arayüzü) … verilebilir. Liste uzayıp gider!
Tüm bunları öğrendikten sonra aklınıza şu soru gelebilir: Orijinal Python paketini R paketleriyle nasıl karşılaştırırsınız?
Özünde, R paketleri ile orijinal Python paketi arasında çok fazla fark bulmazsınız; bunun başlıca nedeni, işlev adlarının neredeyse tamamen aynı olmasıdır. Gözlemlenecek farklar esas olarak programlama dillerinin kendilerinden (değişken ataması, kütüphane yükleme, …) kaynaklanır; ancak en önemli nokta, orijinal işlevselliğin ne kadarının R paketine dahil edildiğidir.
Bu yorum sadece keras kütüphanesi için değil, yukarıda bahsedilen tensorflow, openml-r, … ve diğer arayüz paketleri için de geçerlidir!
İkinci olarak, bu iki R paketi arasındaki farkın ne olduğu da aklınıza gelebilir. İkisini nasıl karşılaştıracağınızı düşünürken aşağıdaki noktaları dikkate alabilirsiniz:
keras paketi, işlevleri veya işlemleri birbirine bağlamak için pipe (|%) operatörünü kullanır; bunu kerasR’da görmezsiniz: örneğin, kerasR ile modelinizi oluşturmak için $ operatörünü kullanmanız gerekir. Pipe operatörünün kullanımı genellikle kodunuzun okunabilirliğini artırır ve daha önce Tidyverse paketleri ile çalıştıysanız bu operatöre kesinlikle rastlamışsınızdır.
kerasR, orijinal Keras paketine benzer fakat tamamen aynı olmayan isimlere sahip işlevler içerir. Örneğin, ilk (Python) compile() işlevi keras_compile() olarak adlandırılır; Aynısı diğer işlevler için de geçerlidir: fit() keras_fit(), predict() ise keras_predict olur. Bunların tümü özel sarmalayıcılardır.
RStudio’nun keras paketinin kurulumunun, kerasR paketinin kurulumundan daha kolay olduğunu söyleyebilirsiniz; İkincisini kurmak için önce hangi Python sürümünü kullanacağınızı yapılandırdığınızdan emin olmalısınız; birden fazla ortam veya Python sürümü kurulu olan bir bilgisayarda çalışıyorsanız bu zorlaşabilir. Ama karar sizin :)

Artık biraz arka plan bilgisi edindiğinize göre, R’de Keras ile işe gerçekten başlama zamanı. Bu eğitimin girişinde okuduğunuz gibi, önce çalışma alanınızın kurulumunu gözden geçireceksiniz. Ardından bazı verileri yükleyecek ve kısa bir veri keşfi ile ön işleme adımından sonra MLP’nizi kurmaya başlayabileceksiniz!
Hadi devam edelim!
Her zamanki gibi, herhangi bir pakete başlarken ilk adım çalışma alanınızı kurmaktır: kütüphaneyi RStudio’ya veya çalıştığınız ortama kurup yükleyin.
Endişelenmeyin, bu eğitim için paket sizin yerinize yüklenecek!
Önce, keras’ı kurduğunuzdan emin olun: bunu konsolunuzda devtools::install_github("rstudio/keras") komutunu çalıştırarak kolayca yapabilirsiniz. Sonra paketi yükleyebilir ve TensorFlow’u kurabilirsiniz:
# Load in the keras package
library(keras)

# Install TensorFlow
install_tensorflow()
Bunu yaptıktan sonra hazırsınız! Hızlı, değil mi?
İpucu: kurulum süreci hakkında daha fazla bilgi için paket web sitesine göz atın.
Kurulum süreci netleştiğine ve çalışma alanınız hazır olduğuna göre, verilerinizi yüklemeye başlayabilirsiniz! Bu noktada, verilerinizle ilgili üç büyük seçeneğiniz var: keras paketiyle gelen yerleşik veri kümelerinden birini kullanmayı seçebilir, örneğin CSV dosyalarından kendi veri kümenizi yükleyebilir veya bazı kukla veriler oluşturabilirsiniz.
Hangi durumda olursanız olun, paketle hızlıca işe koyulabileceğinizi göreceksiniz. Bu bölüm, bu üç seçeneği hızlıca ele alacak ve başlamanız için gereken verileri nasıl yükleyeceğinizi (veya oluşturacağınızı) açıklayacaktır!
Python’daki Keras paketiyle ilgili biraz deneyiminiz varsa, büyük olasılıkla mnist.load_data(), cifar10.load_data() veya imdb.load_data() gibi işlevlerle Keras yerleşik veri kümelerine zaten erişmişsinizdir.
İşte keras paketiyle MNIST, CIFAR10 ve IMDB verilerini yüklediğiniz bazı örnekler:
# Read in MNIST data
mnist <- dataset_mnist()

# Read in CIFAR10 data
cifar10 <- dataset_cifar10()

# Read in IMDB data
imdb <- dataset_imdb()
keras ile yerleşik veri kümelerini yüklemeye yönelik tüm işlevlerin aynı deseni izlediğine dikkat edin; MNIST verileri için, verilerinizi yüklemek üzere dataset_mnist() işlevini kullanırsınız.
Alternatif olarak, başlamak için hızlıca bazı kukla veriler de oluşturabilirsiniz. Bunu matrix() işlevini kullanarak kolayca yapabilirsiniz:
Veri yapınızı kontrol etmek iyi bir fikirdir; Hangi verilerle çalıştığınızın farkında olmak önemlidir, çünkü daha sonra atmanız gereken adımlar için gerekli olacaktır. Bunun hakkında daha fazlasını bu eğitimin ilerleyen kısımlarında öğreneceksiniz!
Yerleşik veri kümelerine ek olarak, dosyalardan da veri yükleyebilirsiniz. Bu eğitimde CSV dosyalarından veri yüklemeye odaklanacaksınız; ancak R’ye dosya aktarma hakkında daha fazla bilgi istiyorsanız DataCamp’in R Veri İçe Aktarma Eğitimini inceleyin.
UCI Machine Learning Repository’den bir veri kümesini yüklemek için read.table paketindeki read.csv() işlevini kullanalım:
Veri aktarımınızın başarılı olup olmadığını kontrol etmek her zaman iyi bir fikirdir. Bunu hızlıca yapmak için genellikle yukarıdaki DataCamp Light bloğunda olduğu gibi head(), str() ve dim() işlevlerini kullanırsınız.
Bu üç işlevin sonuçları hemen olağan dışı bir duruma işaret etmiyor; str() işlevinin çıktısına bakarak Species sütunundaki dizgelerin faktör olarak okunduğunu görürsünüz. Bu bir sorun değildir, ancak verileri keşfedeceğiniz ve ön işleyeceğiniz sonraki adımlar için bilmek kesinlikle iyidir.
Bu eğitimde, read.csv() işleviyle içe aktardığınız ünlü iris veri kümesiyle çalışmaya devam edeceksiniz.
Bu verilerle çalışmak için gerekli biyoloji bilgisine sahip olmayanlar için biraz arka plan: tüm çiçeklerde çanak yaprak (sepal) ve taç yaprak (petal) bulunur. Çanak yaprak, taç yaprakları çevreler ve tipik olarak yeşil ve yaprak gibidir; taç yapraklar ise genellikle renklidir. İris çiçeklerinde bu durum biraz farklıdır; bunu aşağıdaki resimde görebilirsiniz:

Önceki bölümde, iris veri çerçevesinin içe aktarma sonrasında herhangi bir sütun adına sahip olmadığını zaten görmüş olabilirsiniz. Kalan kısım için bu çok önemli değil: read.csv() işlevi verileri size bir data.frame olarak döndürse de, fit() işlevine geçirmeniz gereken verilerin bir matris veya dizi olması gerekir.
Yeni bahsedilen iki veri yapısı hakkında akılda tutulması gerekenler: - Matris ve dizilerin sütun adları yoktur; - Matrisler tek bir veri tipinden oluşan iki boyutlu nesnelerdir; - Diziler tek bir veri tipinden oluşan çok boyutlu nesnelerdir;
İpucu: R’deki veri yapılarıyla ilgili bir hatırlatma istiyorsanız bu videoya göz atın!
Öte yandan veri çerçevesi, tüm öğelerin aynı uzunlukta olduğu, adlandırılmış özel bir liste türüdür. Birden fazla veri tipi içerebilen çok boyutlu bir nesnedir. Önceki bölümde iris veri çerçevesinin yapısını kontrol ettiğinizde bunun doğru olduğunu zaten gördünüz. Bunu bilerek ve tek bir veri tipinden oluşan iki veya çok boyutlu bir nesneye doğru çalışmanız gerektiğini göz önünde bulundurarak, sinir ağınızı kurmaya başlamadan önce biraz ön işleme yapmaya hazırlanmalısınız!
Şimdilik sütun adları keşif amacıyla kullanışlı olabilir ve veriyi anlamanızı kesinlikle kolaylaştırır; bu yüzden names() işlevinin yardımıyla bazı sütun adları ekleyelim. Ardından veri keşfinde hemen iris değişkenini kullanabilirsiniz! Örneğin, plot() işleviyle taç yaprak uzunluğu ve taç yaprak genişliğinin nasıl korele olduğunu görselleştirin.
Tür adlarını, yani “setosa, versicolor” ve “virginica”yı sayısal 1, 2 ve 3’e dönüştürmek için unclass() işlevini kullandığınıza dikkat edin.
Şimdi çizim işlevinin sonucuna daha yakından bakın:

Grafik, iris çiçeklerinin farklı türleri için Petal.Length ile Petal.Width arasında pozitif bir korelasyon olduğunu göstermektedir. Ancak, bunu veri kümesine dahil edilen tüm öznitelikler arasındaki genel korelasyonu verecek cor() işleviyle test etmek isteyebilirsiniz:
Ek olarak, corrplot paketini cor() işleviyle birlikte kullanarak verinizin öznitelikleri arasındaki korelasyonları çizebilirsiniz; Bu durumda, iris veri çerçevesinin tüm öznitelikleri için genel korelasyonu hesaplıyorsunuz. Bu hesabın sonucunu M değişkeninde saklayıp corrplot() işlevine geçiriyorsunuz.
Ayrıca, verilerin nasıl çizileceğini belirtmek için bir method argümanı belirtmeyi unutmayın!
Aşağıdaki DataCamp Light bloğunda görselleştirme yöntemiyle daha fazla deney yapabilirsiniz:

Verilerinizi daha fazla keşfetmek için R konsolunu kullanın.
Bu veriler için grafikler oluşturmak üzere etkileşimli grafik dilbilgisi olan ggvis paketini kullanmak isterseniz DataCamp’in Yeni Başlayanlar için R ile Makine Öğrenimi eğitimine bakın veya DataCamp’in ggvis kursunu alın.
Modelinizi kurmadan önce, verilerinizin temizlendiğinden, normalize edildiğinden (uygulanabilirse) ve eğitim ile test kümelerine ayrıldığından da emin olmalısınız. Veri kümesi UCI Machine Learning Repository’den geldiği için zaten bir ölçüde temiz olmasını bekleyebilirsiniz; yine de verinizin kalitesini bir kez daha kontrol edelim.
İlk bakışta, verileri head() ile incelerken olağan dışı bir şey görmemiştiniz, değil mi? Veri aktarımınızın başarılı olup olmadığını kontrol ederken öğrendiklerinizi kısaca gözden geçirmek için summary() ve str() işlevlerini kullanalım:
Artık verilerin yeterince temiz olduğundan emin olduğunuza göre, bu eğitimde üzerinde çalıştığınız verilerin herhangi birinde normalleştirme gerekip gerekmediğini kontrol etmeye başlayabilirsiniz.
Yukarıdaki DataCamp Light bloğundaki summary() işlevinin sonucundan, Iris veri kümesinin normalleştirilmesine gerek olmadığını görüyorsunuz: Sepal.Length özniteliğinin değerleri 4.3 ile 7.9 arasında, Sepal.Width ise 2 ile 4.4 arasında; Petal.Length’in değerleri 1 ile 6.9 arasında, Petal.Width ise 0.1 ile 2.5 arasında değişiyor. Başka bir deyişle, Iris veri kümesindeki tüm özniteliklerin tüm değerleri 0.1 ile 7.9 aralığında; bunu kabul edilebilir sayabilirsiniz.
Yine de normalleştirmenin verileriniz üzerindeki etkisini incelemek iyi bir fikir olabilir; hatta normalleştirilmiş verileri modelinize geçirip bir etkisi olup olmadığını görmek için daha da ileri gidebilirsiniz. Bu, bu eğitimin kapsamı dışındadır; ancak bunu kendi başınıza denemekte özgürsünüz! Gerekli tüm kod bu eğitimde mevcut :)
iris verisini normalize etmek için kendi işlevinizi yazabilirsiniz; Bu durumda, verilerinizi (x-min)/(max-min) fonksiyonuna doğrusal olarak dönüştüren min-maks normalleştirme işlevidir. Bu açıdan bakıldığında, bu formülü R’ye çevirmek oldukça basittir: x veya bazı verileri ilettiğiniz bir işlev oluşturursunuz. İlk çıkarma işlemi olan x-min’i hesaplayıp sonucu num içinde saklayacaksınız. Sonra max-min’i hesaplayıp sonucu denom içinde saklayacaksınız. normalize() işlevinizin sonucu, num’un max’a bölünmesini döndürmelidir.
Bu kullanıcı tanımlı işlevi iris verilerinize (hedef değerler hariç) uygulamak için normalize’ın yanı sıra verileri normalleştirmek üzere lapply() işlevini de kullanmanız gerekir; aşağıdaki gibi:
İpucu: Iris verisinin normalleştirmeden önceki (iris) ve sonraki (iris_norm) dağılımını incelemek için R konsolunda hist() işlevini kullanın.
keras paketindeki normalize() işlevini kullanmak için önce bir matrisle çalıştığınızdan emin olmanız gerekir. Muhtemelen daha önce hatırladığınız gibi, matrislerin özelliği, matris veri öğelerinin aynı temel türde olmasıdır; Bu durumda, hedef değerler factor türündeyken geri kalanı sayısaldır.
Önce bunun değişmesi gerekir.
Verileri sayılara dönüştürmek için as.numeric() işlevini kullanabilirsiniz:
Sayısal bir veri çerçevesi iyidir, ancak keras paketini kullanmak istiyorsanız verileri bir diziye veya matrise dönüştürmeniz gerekir. Bunu as.matrix() işleviyle kolayca yapabilirsiniz; dimnames’i NULL olarak ayarlamayı unutmayın.
Yukarıdaki bölümde okumuş olabileceğiniz gibi, Iris verilerini normalleştirmek gerekli değildir. Yine de normalleştirmenin etkisini incelemek ve bunun yalnızca bir UDF ile değil, keras’ın yerleşik normalize() işleviyle de nasıl yapılabileceğini görmek iyi bir fikirdir.
Verilerinizi matrise dönüştürdüğünüze göre, olası bir normalleştirmenin veriniz üzerindeki etkisini incelemek için keras paketini de kullanabilirsiniz:
Burada, iris’in dimnames’ini NULL’a ayarlamak için dimnames() kullandığınıza dikkat edin. Bu, verilerinizde sütun adı olmadığından emin olmanızı sağlar.
Artık verilerinizin kalitesini kontrol ettiğinize ve verilerinizi normalleştirmenin gerekli olmadığını bildiğinize göre, orijinal verilerle devam edebilir ve modeli oluşturmaya nihayet başlayabilmek için verileri eğitim ve test kümelerine ayırabilirsiniz. Bunu yaparak, daha sonra tahmin edilen modelinizin performansını dürüstçe değerlendirebilmenizi sağlarsınız.
Verilerinizi eğitim ve test kümelerine ayırmadan önce, en iyisi önce bir tohum (seed) belirlemektir. Bunu set.seed() ile kolayca yapabilirsiniz: aynı işlevi kullanın ve ona rastgele bir tamsayı gönderin. Seed, R’nin rastgele sayı üretecinin bir sayısıdır. Seed belirlemenin en büyük avantajı, rastgele sayı üretecine aynı seed’i verdiğinizde her zaman aynı rastgele sayı dizisini elde etmenizdir.
Bu, kodunuzun yeniden üretilebilirliği için harikadır!
İris veri setindeki satır sayısı olan 150’ye eşit bir boyutta örnek almak için sample() işlevini kullanırsınız. Yerine koymalı örnekleme yaparsınız: 2 öğeden oluşan bir vektörden seçer ve İris veri setinin 150 satırına 1 veya 2 atarsınız. Öğelerin atanması 0.67 ve 0.33 olasılık ağırlıklarına tabidir.
sample() işlevinin replace argümanı TRUE olarak ayarlanmıştır; bu, belirli bir satıra 1 veya 2 atadığınız ve ardından 2 öğeli vektörü ilk hâline sıfırladığınız anlamına gelir.
Başka bir deyişle, veri kümenizdeki bir sonraki satırlar için her seferinde tekrar 1 veya 2 atayabilirsiniz. 1 veya 2 seçme olasılığı, geriye kalan öğeler arasındaki ağırlıklarla orantılı olmamalıdır; bu yüzden olasılık ağırlıklarını belirtirsiniz.
Not: Örneğin, dataset_imdb() adlı yerleşik bir veri kümesini kullansaydınız, verilerinizi $ operatörünü kullanarak kolayca bölebilirdiniz:
x_train <- imdb$train$x
y_train <- imdb$train$y
x_test <- imdb$test$x
y_test <- imdb$test$y
Verilerinizi başarıyla böldünüz, ancak modelinizi kurmaya başlamadan önce hâlâ geçmeniz gereken bir adım var. Hangisi olduğunu tahmin edebiliyor musunuz?
Sinir ağlarıyla çok sınıflı sınıflandırma problemlerini modellemek istediğinizde, hedef özniteliğinizi her sınıf değeri için değerler içeren bir vektörden, her sınıf değeri için bir boolean ve belirli bir örneğin o sınıf değerine sahip olup olmadığını belirten bir matrise dönüştürmek genellikle iyi bir uygulamadır.
Bu, One-Hot Encoding’in (OHE) serbest bir açıklamasıdır. Kulağa oldukça karmaşık geliyor, değil mi?
Neyse ki keras paketinde, bunların hepsini sizin için yapacak to_categorical() işlevi var; iris.trainingtarget ve iris.testtarget’ı bu işlevine gönderin ve sonucu iris.trainLabels ve iris.testLabels değişkenlerinde saklayın:
Artık bu eğitimdeki keşif ve ön işleme adımlarının sonuna resmen ulaştınız. Şimdi keras ile sinir ağınızı oluşturmaya geçebilirsiniz!
Bir model kurmaya başlamak için önce keras_model_sequential() işlevinin yardımıyla sıralı bir model başlatmalısınız. Sonra modellemeye hazırsınız.
Ancak başlamadan önce, bu veri kümesiyle ilgili orijinal sorunuzu yeniden gözden geçirmek iyi bir fikirdir: belirli bir İris çiçeğinin türünü tahmin edebilir misiniz? Sayısal verilerle çalışmak daha kolaydır ve siz verileri ön işlediniz ve hedef değişkenin değerlerini one-hot olarak kodladınız: bir çiçek ya versicolor, setosa ya da virginica türündedir ve bu durum ikili 1 ve 0 değerleriyle yansıtılır.
Bu tür bir problemde iyi performans gösteren ağ türü, çok katmanlı algılayıcıdır. Bu tür sinir ağı genellikle tamamen bağlıdır. Bu, bu problemi çözmek için nispeten basit, tamamen bağlı katmanlardan oluşan bir yığın inşa etmeyi amaçladığınız anlamına gelir. Kullanacağınız aktivasyon işlevlerine gelince, Keras ve sinir ağlarına aşina olmak amacıyla burada en yaygın olanlardan birini kullanmak en iyisidir: relu aktivasyon işlevi. Bu doğrultucu aktivasyon işlevi, genel olarak iyi bir uygulama olan bir gizli katmanda kullanılır.
Buna ek olarak, çıktı katmanında softmax aktivasyon işlevinin kullanıldığını da görürsünüz. Bunu, çıktı değerlerinin 0 ile 1 aralığında olmasını ve tahmini olasılıklar olarak kullanılabilmesini sağlamak için yaparsınız:
Çıktı katmanının, her bir Iris sınıfı (versicolor, virginica veya setosa) için birer tane olmak üzere 3 çıktı değeri oluşturduğuna dikkat edin. Buna karşılık, 8 gizli düğüm içeren ilk katmanın input_shape değeri 4’tür. Bunun nedeni, eğitim verileriniz olan iris.training’in 4 sütuna sahip olmasıdır.
Aşağıdaki işlevlerle modelinizi daha ayrıntılı inceleyebilirsiniz:
Artık modelinizin mimarisini oluşturduğunuza göre, modeli derleme ve veriye uydurma zamanı. Modelinizi derlemek için modeli adam eniyileyicisi ve categorical_crossentropy kayıp işleviyle yapılandırırsınız. Ek olarak, 'accuracy'yi metrics argümanına geçirerek eğitim sırasında doğruluğu da izlersiniz.
Modeli derlemek istiyorsanız, eniyileyici ve kayıp olmak üzere iki argüman gereklidir.
En popüler eniyileme algoritmalarından bazıları Stokastik Gradyan İnişi (SGD), ADAM ve RMSprop’tur. Hangi algoritmayı seçerseniz seçin, öğrenme oranı veya momentum gibi bazı parametreleri ayarlamanız gerekir. Kayıp işlevinin seçimi elinizdeki göreve bağlıdır: örneğin, bir regresyon probleminde genellikle Ortalama Kare Hatası (MSE) kullanılır.
Bu örnekte gördüğünüz gibi, bir irisin versicolor, virginica veya setosa türünde olup olmadığını belirlemeye yönelik çok sınıflı sınıflandırma problemi için categorical_crossentropy kayıp işlevini kullandınız. Ancak, ikili sınıflandırma problemi olsaydı, binary_crossentropy kayıp işlevinden yararlanmanız gerektiğini unutmayın.
Bir sonraki adımda, modeli verilerinize de uydurabilirsiniz; Bu durumda, iris.training ve iris.trainLabels içindeki tüm örnekler üzerinde 200 epoch veya yineleme boyunca, 5 örnekten oluşan yığınlar halinde modeli eğitirsiniz.
İpucu: isterseniz, fit() işlevinde verbose argümanını da belirtebilirsiniz. Bu argümanı 1 olarak ayarlayarak ilerleme çubuğu günlüğünü görmek istediğinizi belirtirsiniz.
Yukarıdaki kodla yaptığınız şey, belirli sayıda epoch için veya eğitim veri kümesine yapılan maruz kalmalar için modeli eğitmektir. Bir epoch, tüm eğitim kümesi üzerinden tek bir geçişin ardından doğrulama kümesinin test edilmesidir. Yukarıdaki kodda belirttiğiniz yığın boyutu, ağ üzerinden iletilecek örnek sayısını tanımlar. Bunu yaparak aynı anda çok fazla girdi örüntüsünü belleğe yüklemediğiniz için verimliliği de artırırsınız.
Ayrıca, yukarıdaki DataCamp Light bloğundaki kod satırlarını bir değişkene atarsanız uyumu da görselleştirebileceğinizi bilmekte fayda var. Ardından, bu değişkeni plot() işlevine, bu özel kod bloğunda gördüğünüz gibi, gönderebilirsiniz!
Grafiği daha ayrıntılı incelemeyi unutmayın.
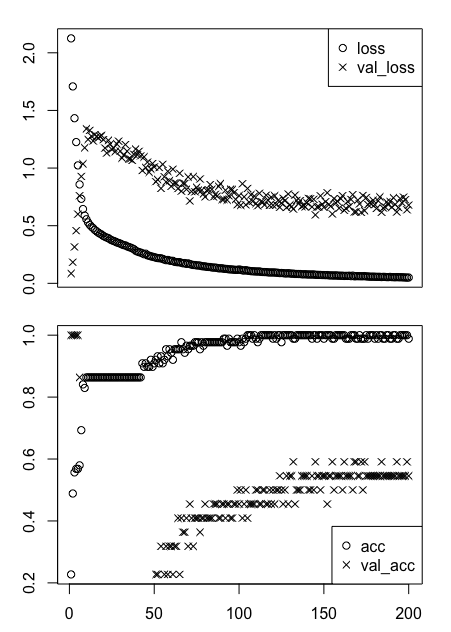
İlk bakışta, her şeyin biraz dağınık görünmesi şaşırtıcı değil. Tam olarak neye baktığınızı bilmiyor olabilirsiniz, değil mi?
Bilmeniz gereken iyi bir nokta, loss ve acc değerlerinin eğitim verileri için modelin kaybını ve doğruluğunu, val_loss ve val_acc değerlerinin ise test veya doğrulama verileri için aynı ölçütleri, yani kayıp ve doğruluğu ifade ettiğidir.
Ancak bunu bilseniz bile, bu iki grafiği yorumlamak kolay değildir. Bunu daha kolay anlayabileceğiniz parçalara ayıralım! Bu iki grafiği ayırıp ikisini de ayrı ayrı çizeceksiniz: biri model kaybı, diğeri model doğruluğu için olacak. Neyse ki, verilere erişmek ve adım adım çizdirmek için $ operatöründen kolayca yararlanabilirsiniz.
Bunu nasıl yapabileceğinizi görmek için aşağıdaki DataCamp Light kutusuna göz atın:
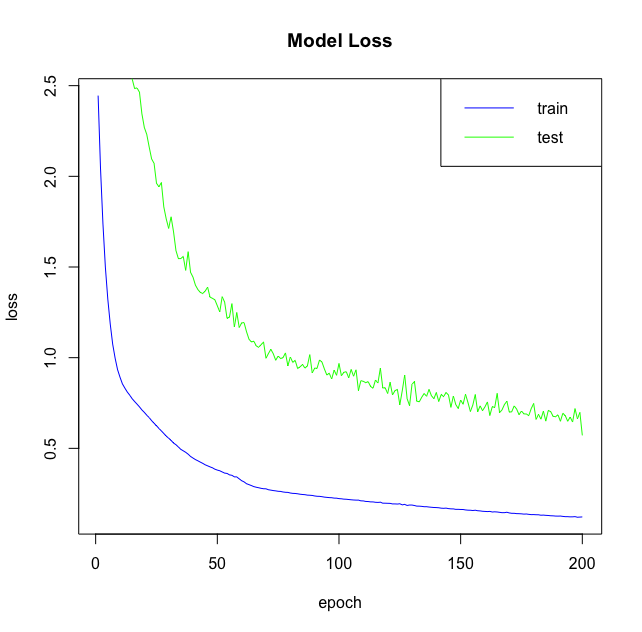
Bu ilk grafikte, modelin eğitim ve test verilerindeki kaybını çizdiniz. Şimdi aynı şeyi modelin doğruluğu için de yapma zamanı:
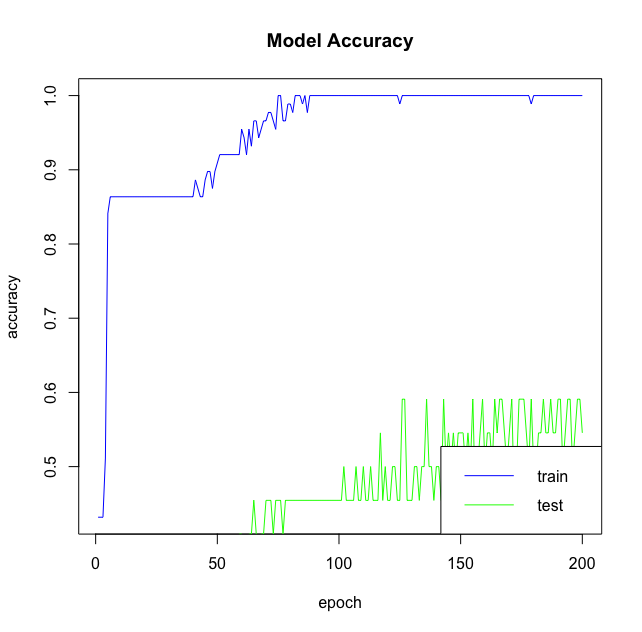
Burada aklınızda tutmanız gereken bazı noktalar şunlardır:
Artık modeliniz oluşturuldu, derlendi ve verilere uyduruldu; sırada modeli gerçekten kullanarak test kümeniz olan iris.test için etiketleri tahmin etmek var. Tahmin yapmak için beklediğiniz gibi predict() işlevini kullanabilirsiniz. Ardından, table() işlevinin yardımıyla iris.test verisinin tahminlerini ve gerçek etiketlerini görmek için karmaşıklık matrisini yazdırabilirsiniz.
Sonuçlar hakkında ne düşünüyorsunuz? İlk bakışta, oluşturduğunuz bu model doğru tahminler yapıyor mu?
iris.test için tahmin edilen etiketlere bakarak modelinizin nasıl performans gösterdiğine dair az çok bir fikriniz olsa da, modelinizi değerlendirmeniz için zaman ayırmanız hâlâ önemlidir. Bunu yapmak için evaluate() işlevini kullanın: test verisi iris.test’i, test etiketleri iris.testLabels’ı girin ve yığın boyutunu tanımlayın. Sonucu, aşağıdaki kod örneğinde olduğu gibi score adlı bir değişkende saklayın:
score’u yazdırdığınızda, geri dönen değerler kayıp değeri ve ölçüt değeri (bu durumda 'accuracy') olacaktır.
Modelinizi ince ayarlamak, özellikle başlangıçta, muhtemelen sıkça yapacağınız bir şeydir; çünkü tüm sınıflandırma ve regresyon problemleri bu eğitimin ilk bölümünde gördüğünüz kadar doğrudan olmayabilir. Yukarıda okuduğunuz gibi, muhtemelen ayarlamak isteyeceğiniz iki kilit karar vardır: kaç katman kullanacağınız ve her katman için kaç “gizli birim” seçeceğiniz.
Başlangıçta bu gerçekten epey bir yolculuk olacaktır.
Epoch sayısı veya yığın boyutuyla oynamanın yanı sıra, modelinizi daha iyi performans göstereceği umuduyla ayarlayabileceğiniz başka yollar da vardır: katmanlar ekleyerek, gizli birim sayısını artırarak ve kendi eniyileme parametrelerinizi compile() işlevine geçirerek. Bu bölüm bu üç seçeneği ele alacaktır.
Modelinize başka bir katman eklerseniz ne olur? Şöyle görünseydi ne olurdu?
Bu yeni modelin kayıp ve doğruluk ölçütlerini de görselleştirebileceğinizi unutmayın! Bunu aşağıdaki DataCamp Light bloğunda deneyin:
|
|
|
Katmanlar eklemenin ve gizli birimlerle oynamanın yanı sıra, compile() fonksiyonuna verdiğiniz optimizasyon algoritmasının (bazı) parametrelerini de ayarlamayı deneyebilirsiniz. Şu ana kadar, optimizer argümanına her zaman adam adlı bir dize içeren bir vektör geçirdiniz.
Ancak bu her zaman böyle olmak zorunda değil!
Ayrıca, Stokastik Gradyan İnişi (SGD) gibi diğer optimizasyon algoritmalarıyla da deney yapmayı deneyin. Örneğin, öğrenme oranı lr’yi ayarlamak için optimizer_sgd() fonksiyonunu kullanmayı deneyin. Bir etkisi olduğunu fark ediyor musunuz?
Başka bir eniyileyici kullanmanın yanı sıra, ağınızı eğitmek için daha küçük bir öğrenme oranı kullanmayı da deneyebilirsiniz. Bu, en yaygın ince ayar tekniklerinden biridir; Yaygın bir uygulama, başlangıç öğrenme oranını, modeli daha önce eğitmek için kullandığınızdan 10 kat daha küçük yapmaktır.
Bu küçük ayarın etkisini görmek için eğitim geçmişini bir kez daha görselleştirelim:
|
|
|
keras paketiyle yolculuğunuzda geriye kalan son bir şey var: modelinizi daha sonra başka bir zamanda geri yükleyebilmek için kaydetmek veya dışa aktarmak.
save_model_hdf5(model, "my_model.h5")
model <- load_model_hdf5("my_model.h5")
save_model_weights_hdf5("my_model_weights.h5")
model %>% load_model_weights_hdf5("my_model_weights.h5")
json_string <- model_to_json(model)
model <- model_from_json(json_string)

yaml_string <- model_to_yaml(model)
model <- model_from_yaml(yaml_string)
Tebrikler! R ile keras kullanarak bu derin öğrenme eğitimini tamamladınız. Bu eğitim, R ile derin öğrenme yolculuğunuzda sadece küçük bir adımdı; Kapsanacak çok daha fazla şey var! DataCamp’in Deep Learning in Python kursunu almadıysanız, göz atmayı düşünebilirsiniz.
Bu arada, henüz yapmadıysanız Keras dokümantasyonunu ve RStudio’nun keras dokümantasyonunu da mutlaka inceleyin. Tüm fonksiyonlar, argümanlar, daha fazla katman vb. için daha fazla örnek ve bilgi bulacaksınız… Ayrıca François Chollet’nin “Deep Learning with Python” kitabına da göz atın. Bu kaynakların tümü, R’de yapay sinir ağlarıyla nasıl çalışılacağını öğrenirken vazgeçilmez olacaktır!
İlgili kurslar
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.






