Accéder au contenu principal

keras : deep learning en R

In this tutorial to deep learning in R with RStudio's keras package, you'll learn how to build a Multi-Layer Perceptron (MLP).
Actualisé 19 sept. 2026  · 15 min lire

Explorer avec l’IA

ChatGPTClaudePerplexity

Vous le savez désormais, le machine learning est un sous‑domaine de l’informatique. Le deep learning est, lui, un sous‑domaine du machine learning : un ensemble d’algorithmes inspirés par la structure et le fonctionnement du cerveau, que l’on regroupe sous le terme de réseaux de neurones artificiels (ANN). Le deep learning est aujourd’hui l’une des tendances majeures en machine learning et excelle sur de nombreux problèmes comme la robotique, la reconnaissance d’images et l’intelligence artificielle (IA).

Le tutoriel du jour vous propose une brève introduction au deep learning en R avec Keras via le package keras :

Vous voulez en savoir plus sur Keras à l’origine, ou sur des notions clés du deep learning comme les perceptrons et les MLP ? Envisagez de suivre le cours Deep Learning in Python de DataCamp ou de parcourir le Keras Tutorial : Deep Learning in Python.

Astuce : retrouvez notre antisèche Keras ici.

Deep learning en R : bref panorama des packages

Avec l’essor du deep learning, CRAN s’est enrichi de nombreux packages R dédiés ; voici un aperçu, issu de la vue d’ensemble Machine Learning and Statistical Learning sur CRAN. La colonne « Percentile » indique le centile référencé sur RDocumentation :

Package R Percentile Description
nnet 96th Réseaux de neurones feed‑forward à une seule couche cachée et modèles log‑linéaires multinomiaux.
neuralnet 96th Entraînement de réseaux de neurones par rétropropagation
h2o 95th Fonctionnalités de scripting R pour H2O
RSNNS 88th Interface avec le Stuttgart Neural Network Simulator (SNNS)
tensorflow 88th Interface avec TensorFlow
deepnet 84th Boîte à outils de deep learning en R
darch 79th Package pour architectures profondes et machines de Boltzmann restreintes
rnn 73rd Implémentation des réseaux de neurones récurrents (RNN)
FCNN4R 52nd Interface avec la bibliothèque FCNN permettant des ANN extensibles par l’utilisateur
rcppDL 7th Implémentations de méthodes d’apprentissage automatique profondes (deep learning) : dA (autoencodeur débruitant), SdA (Stacked Denoising Autoencoder), RBM (Restricted Boltzmann Machine) et DBN (Deep Belief Nets)
deepr ??* Package pour fluidifier entraînement, réglage fin et prédiction en deep learning, basé sur darch et deepnet
MXNetR ??* Package offrant un calcul GPU flexible et efficace et un deep learning de pointe dans R

Astuce : pour une comparaison des packages de deep learning en R, lisez cet article de blog. Pour en savoir plus sur le ranking et le score sur RDocumentation, consultez cet article.

Les packages deepr et MXNetR n’ont pas été trouvés sur RDocumentation.org ; leur centile n’est donc pas indiqué.

Keras, keras et kerasR

Récemment, deux nouveaux packages ont fait leur apparition dans la communauté R : le package kerasR, créé par Taylor Arnold, et le package keras de RStudio.

Ces deux packages offrent une interface R au package Python de deep learning Keras, dont vous avez peut‑être déjà entendu parler, voire que vous avez utilisé ! Pour celles et ceux qui ne connaissent pas Keras côté Python, c’est « une API de haut niveau pour réseaux de neurones, écrite en Python, et fonctionnant au‑dessus de TensorFlow, Microsoft Cognitive Toolkit (CNTK) ou Theano ».

Des interfaces ?

Se lancer avec Keras est l’un des moyens les plus simples de découvrir le deep learning en Python ; c’est pourquoi kerasR et keras proposent une interface à ce superbe package pour les utilisateurs R.

Concrètement, qu’implique le fait que le package R keras soit « une interface » du Keras Python ? En bref, l’interface vous permet de profiter du confort de R tout en accédant aux capacités du package Keras en Python.

Ce n’est pas rare : par exemple, le package h2o fournit aussi une interface — ici vers H2O, un moteur mathématique open source pour le big data permettant l’exécution parallèle et distribuée d’algorithmes de machine learning. D’autres packages que vous connaissez peut‑être : RWeka (interface R vers Weka), tensorflow (interface R vers TensorFlow), openml-r (interface R vers OpenML), … et bien d’autres !

Quelle différence entre Keras, keras et kerasR ?

Maintenant que vous avez le contexte, vous vous demandez sans doute : comment comparer le package Python d’origine et les packages R ?

Dans l’ensemble, vous trouverez peu de différences entre les packages R et le package Python d’origine, car la plupart des noms de fonctions sont identiques. Les écarts tiennent surtout aux langages eux‑mêmes (affectation, chargement de bibliothèques, …). Le point clé, c’est l’étendue des fonctionnalités d’origine effectivement exposées dans le package R.

Remarque : cela vaut pour keras, mais aussi pour tensorflow, openml-r, … et les autres packages d’interface cités plus haut.

Ensuite, quelle est la différence entre les deux packages R ? Pour comparer, tenez compte des points suivants :

  • Le package keras utilise l’opérateur pipe (%>%) pour enchaîner des fonctions/opérations, ce que vous ne trouverez pas dans kerasR : par exemple, pour construire un modèle avec kerasR, vous utiliserez plutôt l’opérateur $. L’opérateur pipe améliore généralement la lisibilité du code ; vous l’avez certainement vu si vous utilisez les packages du Tidyverse.

  • kerasR propose des fonctions dont les noms sont proches, mais pas identiques à ceux de Keras. Par exemple, la fonction (Python) compile() devient keras_compile(), fit() devient keras_fit(), ou encore predict() devient keras_predict dans kerasR. Ce sont des wrappers dédiés.

  • On peut considérer que l’installation du package keras de RStudio est plus simple que celle de kerasR : pour ce dernier, il faut d’abord configurer la version de Python à utiliser, ce qui peut devenir délicat si votre machine comporte plusieurs environnements ou versions de Python. À vous de juger :)

data science courses banner

Maintenant que vous avez le contexte, passons à la pratique avec Keras en R. Comme indiqué en introduction, vous allez d’abord configurer votre environnement. Puis vous chargerez des données et, après une courte phase d’exploration et de prétraitement, vous construirez votre MLP !

Allons‑y !

Installer le package keras

Comme toujours, la première étape consiste à préparer votre environnement : installez et chargez la bibliothèque dans RStudio (ou l’environnement de votre choix).

Pas d’inquiétude, pour ce tutoriel, le package sera chargé pour vous !

Commencez par installer keras : lancez simplement devtools::install_github("rstudio/keras") dans votre console. Ensuite, chargez le package et installez TensorFlow :

# Charger le package keras
library(keras)

# Installer TensorFlow
install_tensorflow()

Une fois ceci fait, vous êtes prêt. Rapide, n’est‑ce pas ?

Astuce : pour plus de détails sur l’installation, consultez le site du package.

Charger les données

Maintenant que l’installation est claire et votre environnement prêt, vous pouvez charger vos données ! Trois grandes options s’offrent à vous : utiliser un jeu de données intégré au package keras, charger votre propre jeu (par exemple depuis des fichiers CSV) ou générer des données factices.

Quelle que soit votre situation, vous verrez que la prise en main est rapide. Cette section passe en revue ces trois options et explique comment charger (ou créer) les données nécessaires pour démarrer !

Jeux de données intégrés

Si vous avez déjà utilisé Keras en Python, vous avez sans doute exploité les jeux de données intégrés via des fonctions comme mnist.load_data(), cifar10.load_data() ou imdb.load_data().

Voici quelques exemples pour charger MNIST, CIFAR10 et IMDB avec le package keras :

# Lire les données MNIST
mnist <- dataset_mnist()

# Lire les données CIFAR10
cifar10 <- dataset_cifar10()

# Lire les données IMDB
imdb <- dataset_imdb()

Toutes les fonctions de chargement des jeux intégrés suivent le même schéma ; pour MNIST, utilisez dataset_mnist().

Données factices

Vous pouvez aussi générer rapidement des données factices pour démarrer, par exemple avec la fonction matrix() :

eyJsYW5ndWFnZSI6InIiLCJzYW1wbGUiOiIjIE1ha2UgeW91ciBkdW1teSBkYXRhXG5kYXRhIDwtIG1hdHJpeChyZXhwKDEwMDAqNzg0KSwgbnJvdyA9IDEwMDAsIG5jb2wgPSA3ODQpXG5cbiMgTWFrZSBkdW1teSB0YXJnZXQgdmFsdWVzIGZvciB5b3VyIGR1bW15IGRhdGFcbmxhYmVscyA8LSBtYXRyaXgocm91bmQocnVuaWYoMTAwMCoxMCwgbWluID0gMCwgbWF4ID0gOSkpLCBucm93ID0gMTAwMCwgbmNvbCA9IDEwKSJ9

Pensez à vérifier la structure de vos données : savoir ce que vous manipulez est crucial pour la suite. Vous en verrez l’importance un peu plus loin.

Lecture depuis des fichiers

Outre les jeux intégrés, vous pouvez charger des données depuis des fichiers. Ici, nous nous concentrons sur des CSV, mais si vous souhaitez en savoir plus sur l’import de données en R, voyez le tutoriel DataCamp sur l’import de données en R.

Utilisons read.csv() du package read.table pour charger un jeu depuis l’UCI Machine Learning Repository :

eyJsYW5ndWFnZSI6InIiLCJzYW1wbGUiOiIjIFJlYWQgaW4gYGlyaXNgIGRhdGFcbmlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcblxuIyBSZXR1cm4gdGhlIGZpcnN0IHBhcnQgb2YgYGlyaXNgXG5oZWFkKC4uLi4pXG5cbiMgSW5zcGVjdCB0aGUgc3RydWN0dXJlXG5zdHIoLi4uLilcblxuIyBPYnRhaW4gdGhlIGRpbWVuc2lvbnNcbmRpbSguLi4uKSIsInNvbHV0aW9uIjoiIyBSZWFkIGluIGBpcmlzYCBkYXRhXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCBwYXJ0IG9mIGBpcmlzYFxuaGVhZChpcmlzKVxuXG4jIEluc3BlY3QgdGhlIHN0cnVjdHVyZVxuc3RyKGlyaXMpXG5cbiMgT2J0YWluIHRoZSBkaW1lbnNpb25zXG5kaW0oaXJpcykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiRGlkIHlvdSBsb2FkIGluIHRoZSBpcmlzIGRhdGEgY29ycmVjdGx5P1wiXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwiaGVhZFwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwic3RyXCIpICU+JSBjaGVja19yZXN1bHQoKSAlPiUgY2hlY2tfZXF1YWwoKVxuZXgoKSAlPiUgY2hlY2tfZnVuY3Rpb24oXCJkaW1cIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkdyZWF0IGpvYiEgTm93LCBkb2VzIHRoaXMgcmVzdWx0IGNvbmZpcm0geW91ciBpbml0aWFsIGh5cG90aGVzaXMgb2YgYSBwb3NpdGl2ZSBpbmRpY2F0aW9uIGJldHdlZW4gdGhlc2UgdHdvIGF0dHJpYnV0ZXM/XCIpIn0=

Il est toujours judicieux de vérifier le succès de l’import : head(), str() et dim() sont vos alliés, comme dans l’extrait DataCamp Light ci‑dessus.

Rien d’anormal ne saute aux yeux ; la sortie de str() montre que la colonne Species est lue comme un facteur. Aucun problème, mais c’est utile pour la suite (exploration et prétraitement).

Exploration des données

Pour ce tutoriel, vous continuez avec le célèbre jeu iris importé via read.csv().

Un peu de contexte biologique si nécessaire : toutes les fleurs possèdent sépales et pétales. Le sépale entoure les pétales, est généralement vert et foliacé ; les pétales sont des « feuilles » colorées. Pour l’iris, c’est un peu différent, comme sur l’image suivante :

deep learning Python

Vous avez peut‑être remarqué que le data frame iris n’avait pas de noms de colonnes après l’import. Ce n’est pas crucial pour la suite : même si read.csv() renvoie un data.frame, la fonction fit() attend une matrice ou un tableau (array).

À retenir concernant ces structures : - Les matrices et les arrays n’ont pas de noms de colonnes ; - Les matrices sont des objets 2D d’un seul type ; - Les arrays sont des objets multi‑dimensionnels d’un seul type.

Astuce : besoin d’un rappel sur les structures de données en R ? Voyez cette vidéo.

Le data frame, lui, est une liste nommée particulière dont tous les éléments ont la même longueur. C’est un objet multi‑dimensionnel pouvant contenir plusieurs types. Vous l’avez constaté en inspectant iris. Sachant que vous devez tendre vers un objet 2D/multi‑dimensionnel d’un seul type, prévoyez un peu de prétraitement avant de construire votre réseau.

Pour l’exploration, des noms de colonnes restent pratiques et facilitent la compréhension : ajoutons‑en via names(). Vous pouvez alors l’explorer. Par exemple, visualisez la corrélation entre la longueur et la largeur des pétales avec plot().

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSAiLCJzYW1wbGUiOiJuYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcblxucGxvdChpcmlzJFBldGFsLkxlbmd0aCwgXG4gICAgIGlyaXMkUGV0YWwuV2lkdGgsIFxuICAgICBwY2g9MjEsIGJnPWMoXCJyZWRcIixcImdyZWVuM1wiLFwiYmx1ZVwiKVt1bmNsYXNzKGlyaXMkU3BlY2llcyldLCBcbiAgICAgeGxhYj1cIlBldGFsIExlbmd0aFwiLCBcbiAgICAgeWxhYj1cIlBldGFsIFdpZHRoXCIpIn0=

Notez l’usage de unclass() pour convertir les noms des espèces (« setosa, versicolor, virginica ») en 1, 2 et 3.

Examinez le résultat du graphique :

plot

Le graphique suggère une corrélation positive entre Petal.Length et Petal.Width selon les espèces. Testez‑le avec cor(), qui calcule la corrélation globale entre tous les attributs du jeu de données :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6IiMgT3ZlcmFsbCBjb3JyZWxhdGlvbiBiZXR3ZWVuIGBQZXRhbC5MZW5ndGhgIGFuZCBgUGV0YWwuV2lkdGhgIFxuY29yKC4uLi4uLi4uLi4uLi4uLi4uLCBpcmlzJFBldGFsLldpZHRoKSIsInNvbHV0aW9uIjoiIyBPdmVyYWxsIGNvcnJlbGF0aW9uIGJldHdlZW4gYFBldGFsLkxlbmd0aGAgYW5kIGBQZXRhbC5XaWR0aGAgXG5jb3IoaXJpcyRQZXRhbC5MZW5ndGgsIGlyaXMkUGV0YWwuV2lkdGgpIiwic2N0IjoiZXgoKSAlPiUgY2hlY2tfZnVuY3Rpb24oXCJjb3JcIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkdyZWF0IGpvYiEgTm93LCBkb2VzIHRoaXMgcmVzdWx0IGNvbmZpcm0geW91ciBpbml0aWFsIGh5cG90aGVzaXMgb2YgYSBwb3NpdGl2ZSBpbmRpY2F0aW9uIGJldHdlZW4gdGhlc2UgdHdvIGF0dHJpYnV0ZXM/XCIpIn0=

Vous pouvez aussi utiliser le package corrplot avec cor() pour visualiser les corrélations entre attributs : calculez la matrice de corrélation globale, stockez‑la dans M, puis passez‑la à corrplot().

N’oubliez pas de préciser l’argument method pour définir le rendu souhaité.

Expérimentez avec la méthode de visualisation dans l’extrait ci‑dessous :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoY29ycnBsb3QpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIikiLCJzYW1wbGUiOiIjIFN0b3JlIHRoZSBvdmVyYWxsIGNvcnJlbGF0aW9uIGluIGBNYFxuTSA8LSBjb3IoaXJpc1ssMTo0XSlcblxuIyBQbG90IHRoZSBjb3JyZWxhdGlvbiBwbG90IHdpdGggYE1gXG5jb3JycGxvdChNLCBtZXRob2Q9XCJjaXJjbGVcIikifQ==

chart

Servez‑vous de la console R pour approfondir l’exploration.

Pour des graphiques avec ggvis (grammaire graphique interactive), consultez le tutoriel Machine Learning in R For Beginners ou suivez le cours ggvis de DataCamp.

Prétraitement des données

Avant de construire votre modèle, assurez‑vous que vos données sont propres, normalisées (si nécessaire) et séparées en ensembles d’entraînement et de test. Comme le jeu provient de l’UCI Repository, il est déjà plutôt propre, mais vérifions tout de même sa qualité.

À première vue (head()), rien d’étrange, n’est‑ce pas ? Utilisons summary() et str() pour résumer ce que vous avez observé lors du contrôle d’import :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6IiMgUHVsbCB1cCBhIHN1bW1hcnkgb2YgYGlyaXNgXG5zdW1tYXJ5KC4uLi4pXG5cbiMgSW5zcGVjdCB0aGUgc3RydWN0dXJlIG9mIGBpcmlzYFxuc3RyKC4uLi4pIiwic29sdXRpb24iOiIjIFB1bGwgdXAgYSBzdW1tYXJ5IG9mIGBpcmlzYFxuc3VtbWFyeShpcmlzKVxuXG4jIEluc3BlY3QgdGhlIHN0cnVjdHVyZSBvZiBgaXJpc2BcbnN0cihpcmlzKSIsInNjdCI6ImV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwic3VtbWFyeVwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwic3RyXCIpICU+JSBjaGVja19yZXN1bHQoKSAlPiUgY2hlY2tfZXF1YWwoKVxuc3VjY2Vzc19tc2coXCJHb29kIGpvYiEgTm93LCB3aGF0IGRvIHlvdSBsZWFybiBmcm9tIHRoZSBvdXRwdXQgb2YgdGhlc2UgbGluZXMgb2YgY29kZT9cIikifQ==

La normalisation est‑elle nécessaire ?

Normaliser avec une fonction utilisateur

Le résultat de summary() montre que le jeu iris n’a pas besoin d’être normalisé : Sepal.Length va de 4.3 à 7.9, Sepal.Width de 2 à 4.4, Petal.Length de 1 à 6.9 et Petal.Width de 0.1 à 2.5. Autrement dit, toutes les valeurs sont comprises entre 0.1 et 7.9, ce qui est acceptable.

Cela dit, il est pertinent d’étudier l’effet d’une normalisation et pourquoi pas d’entraîner le modèle sur les données normalisées pour comparer. C’est hors du cadre de ce tutoriel, mais n’hésitez pas à essayer ! Tout le code est ici :)

Vous pouvez écrire votre propre fonction de normalisation min‑max (transformation (x‑min)/(max‑min)). En R, cela se traduit simplement : une fonction recevant x, calcule num = x‑min(x) puis denom = max(x)‑min(x) et renvoie num/denom.

Pour l’appliquer à iris (hors cible), combinez normalize et lapply(), comme suit :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6IiMgQnVpbGQgeW91ciBvd24gYG5vcm1hbGl6ZSgpYCBmdW5jdGlvblxubm9ybWFsaXplIDwtIGZ1bmN0aW9uKHgpIHtcbiAgbnVtIDwtIHggLSBtaW4oeClcbiAgZGVub20gPC0gbWF4KHgpIC0gbWluKHgpXG4gIHJldHVybiAobnVtL2Rlbm9tKVxufVxuXG4jIE5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGFcbmlyaXNfbm9ybSA8LSBhcy5kYXRhLmZyYW1lKGxhcHBseShpcmlzWzE6NF0sIC4uLi4uLi4uLikpXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCBwYXJ0IG9mIGBpcmlzYCBcbmhlYWQoLi4uLikiLCJzb2x1dGlvbiI6IiMgQnVpbGQgeW91ciBvd24gYG5vcm1hbGl6ZSgpYCBmdW5jdGlvblxubm9ybWFsaXplIDwtIGZ1bmN0aW9uKHgpIHtcbiAgbnVtIDwtIHggLSBtaW4oeClcbiAgZGVub20gPC0gbWF4KHgpIC0gbWluKHgpXG4gIHJldHVybiAobnVtL2Rlbm9tKVxufVxuXG4jIE5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGFcbmlyaXNfbm9ybSA8LSBhcy5kYXRhLmZyYW1lKGxhcHBseShpcmlzWzE6NF0sIG5vcm1hbGl6ZSkpXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCBwYXJ0IG9mIGBpcmlzYCBcbmhlYWQoaXJpcykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiTWFrZSBzdXJlIHRvIGRlZmluZSBhIHZhcmlhYmxlIGBpcmlzX25vcm1gLlwiXG5tc2dfaW5jb3JyZWN0IDwtIFwiTWFrZSBzdXJlIHRoYXQgeW91IGFzc2lnbiB0aGUgY29ycmVjdCB2YWx1ZSB0byBgaXJpc19ub3JtYC5cIlxuXG5mdW5fZGVmIDwtIGV4KCkgJT4lIGNoZWNrX2Z1bl9kZWYoXCJub3JtYWxpemVcIilcbmZ1bl9kZWYgJT4lIGNoZWNrX2JvZHkoKVxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpcmlzX25vcm0nLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwiaGVhZFwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbnN1Y2Nlc3NfbXNnKFwiV2VsbCBkb25lISBOb3cgeW91IGNhbiBtb3ZlIG9uIHRvIHNlZSBob3cgeW91IGNhbiBub3JtYWxpemUgeW91ciBkYXRhIHdpdGgga2VyYXMhXCIpIn0=

Astuce : utilisez hist() dans la console pour comparer la distribution des données avant (iris) et après normalisation (iris_norm).

Normaliser avec keras

Pour utiliser normalize() du package keras, il faut d’abord travailler sur une matrice. Or vos cibles sont des facteurs quand le reste est numérique.

Il faut donc convertir.

Utilisez as.numeric() pour transformer la colonne de cibles en nombres :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6ImlyaXNbLDVdIDwtIC4uLi4uLi4uLi4uKGlyaXNbLDVdKSAtMVxuXG4jIFR1cm4gYGlyaXNgIGludG8gYSBtYXRyaXhcbmlyaXMgPC0gYXMubWF0cml4KGlyaXMpXG5cbiMgU2V0IGBpcmlzYCBgZGltbmFtZXNgIHRvIGBOVUxMYFxuZGltbmFtZXMoLi4uLikgPC0gTlVMTCIsInNvbHV0aW9uIjoiaXJpc1ssNV0gPC0gYXMubnVtZXJpYyhpcmlzWyw1XSkgLTFcblxuIyBUdXJuIGBpcmlzYCBpbnRvIGEgbWF0cml4XG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuXG4jIFNldCBpcmlzIGBkaW1uYW1lc2AgdG8gYE5VTExgXG5kaW1uYW1lcyhpcmlzKSA8LSBOVUxMIiwic2N0IjoibXNnX3VuZGVmaW5lZCA8LSBcIkRpZCB5b3UgdXNlIGBhcy5udW1lcmljKClgIHRvIGNvbnZlcnQgYGlyaXNbLDVdYCB0byBudW1lcmljP1wiXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbm1zZ191bmRlZmluZWQyIDwtIFwiRGlkIHlvdSB1c2UgYGFzLm1hdHJpeGAgdG8gY29udmVydCBgaXJpc2AgdG8gYSBtYXRyaXg/XCJcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnaXJpcycsIG1zZ191bmRlZmluZWQyKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZDIpXG5leCgpICU+JSBjaGVja19mdW5jdGlvbihcImRpbW5hbWVzXCIpICU+JSBjaGVja19yZXN1bHQoKSAlPiUgY2hlY2tfZXF1YWwoKVxuc3VjY2Vzc19tc2coXCJBd2Vzb21lIVwiKSJ9

Un data frame numérique convient, mais pour utiliser keras il faut une matrice/array. Faites la conversion avec as.matrix() et pensez à fixer dimnames à NULL.

Comme vu plus haut, la normalisation d’iris n’est pas indispensable. Cela reste intéressant à étudier, à la fois via une UDF et via la fonction normalize() intégrée à keras.

Une fois vos données converties en matrice, vous pouvez aussi utiliser normalize() pour en observer l’effet :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoa2VyYXMpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcbmlyaXNbLDVdIDwtIGFzLm51bWVyaWMoaXJpc1ssNV0pIC0xXG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuZGltbmFtZXMoaXJpcykgPC0gTlVMTCIsInNhbXBsZSI6IiMgTm9ybWFsaXplIHRoZSBgaXJpc2AgZGF0YVxuaXJpcyA8LSBub3JtYWxpemUoLi4uLlssMTo0XSlcblxuIyBSZXR1cm4gdGhlIHN1bW1hcnkgb2YgYGlyaXNgXG5zdW1tYXJ5KC4uLi4pIiwic29sdXRpb24iOiIjIE5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGFcbmlyaXMgPC0gbm9ybWFsaXplKGlyaXNbLDE6NF0pXG5cbiMgUmV0dXJuIHRoZSBzdW1tYXJ5IG9mIGBpcmlzYFxuc3VtbWFyeShpcmlzKSIsInNjdCI6Im1zZ191bmRlZmluZWQgPC0gXCJEaWQgeW91IG5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGE/XCJcbmV4KCkgJT4lIGNoZWNrX29iamVjdChcImlyaXNcIiwgbXNnX3VuZGVmaW5lZCkgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQpXG5leCgpICU+JSBjaGVja19mdW5jdGlvbihcInN1bW1hcnlcIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkF3ZXNvbWUhIE5vdywgaG93IGRvZXMgdGhpcyBzdW1tYXJ5IGNvbXBhcmUgdG8gdGhlIHByZXZpb3VzIHN1bW1hcnkgdGhhdCB5b3UgcmV0cmlldmVkIGluIHRoZSBEYXRhQ2FtcCBMaWdodCBjaHVuayBhYm92ZT9cIikifQ==

Ici, vous utilisez dimnames() pour supprimer les noms de dimensions. Vous vous assurez ainsi qu’aucun nom de colonne n’est présent.

Ensembles d’entraînement et de test

Maintenant que vous avez contrôlé la qualité des données et confirmé qu’aucune normalisation n’est nécessaire, conservez les données d’origine et séparez‑les en ensembles d’entraînement et de test, afin d’évaluer honnêtement les performances du modèle.

Avant de séparer, fixez une graine aléatoire avec set.seed() pour garantir la reproductibilité (même séquence de nombres aléatoires pour une même graine).

Utilisez sample() pour échantillonner une étiquette par ligne (150) avec remise : vous tirez 1 ou 2 dans un vecteur de 2 éléments avec des probabilités 0,67 et 0,33, puis vous attribuez ces indices aux lignes pour former entraînement/test.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV0iLCJzYW1wbGUiOiIjIERldGVybWluZSBzYW1wbGUgc2l6ZVxuaW5kIDwtIHNhbXBsZSgyLCBucm93KGlyaXMpLCByZXBsYWNlPVRSVUUsIHByb2I9YygwLjY3LCAwLjMzKSlcblxuIyBTcGxpdCB0aGUgYGlyaXNgIGRhdGFcbmlyaXMudHJhaW5pbmcgPC0gaXJpc1tpbmQ9PTEsIDE6NF1cbmlyaXMudGVzdCA8LSBpcmlzW2luZD09MiwgMTo0XVxuXG4jIFNwbGl0IHRoZSBjbGFzcyBhdHRyaWJ1dGVcbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsIDVdXG5pcmlzLnRlc3R0YXJnZXQgPC0gaXJpc1tpbmQ9PTIsIDVdIiwic2N0IjoibXNnX3VuZGVmaW5lZCA8LSBcIkRpZCB5b3UgZGVmaW5lIGBpbmRgP1wiXG5tc2dfdW5kZWZpbmVkMSA8LSBcIkRpZCB5b3Ugc3BsaXQgdGhlIGBpcmlzYCBkYXRhIGludG8gYSB0cmFpbmluZyBzZXQ/XCJcbm1zZ191bmRlZmluZWQyIDwtIFwiRGlkIHlvdSBzcGxpdCB0aGUgYGlyaXNgIGRhdGEgaW50byBhIHRlc3Qgc2V0P1wiXG5tc2dfdW5kZWZpbmVkMyA8LSBcIkRpZCB5b3UgaXNvbGFbGF0ZSB0aGUgYGlyaXNgIHRyYWluaW5nIGxhYmVscz9cIlxubm1zZ191bmRlZmluZDQgPC0gXCJEaWQgeW91IGlzb2xhdGUgdGhlIGBpcmlzYCB0ZXN0IGxhYmVscz9cIlxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpbmQnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnaXJpcy50cmFpbmluZycsIG1zZ191bmRlZmluZWQxKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZDEpXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMudGVzdCcsIG1zZ191bmRlZmluZWQyKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZDIpXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMudHJhaW5pbmd0YXJnZXQnLCBtc2dfdW5kZWZpbmVkMykgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQzKVxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpcmlzLnRlc3R0YXJnZXQnLCBtc2dfdW5kZWZpbmVkNCkgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQ0KVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhIElmIHlvdSB3YW50LCBtYWtlIHVzZSBvZiB0aGUgUiBjb25zb2xlIHRvIGNoZWNrIG91dCB5b3VyIG5ld2x5IGNyZWF0ZWQgdHJhaW5pbmcgYW5kIHRlc3Qgc2V0cyFcIikifQ==

L’argument replace=TRUE de sample() signifie qu’après avoir attribué un 1 ou un 2 à une ligne, on remet le vecteur de tirage dans son état initial pour la ligne suivante, avec les mêmes probabilités.

Remarque : si vous aviez utilisé un jeu intégré via dataset_imdb(), vous pourriez séparer directement avec l’opérateur $ :

x_train <- imdb$train$x
y_train <- imdb$train$y
x_test <- imdb$test$x
y_test <- imdb$test$y

One‑hot encoding

Vous avez correctement séparé vos données, mais il reste une étape avant de construire le modèle. La devinez‑vous ?

Pour modéliser une classification multiclasse avec des réseaux de neurones, il est recommandé de transformer la variable cible d’un vecteur de classes en une matrice indiquant, pour chaque observation, la présence/absence de chaque classe (booléens).

C’est le principe du one‑hot encoding (OHE).

Heureusement, la fonction to_categorical() de keras s’en charge : passez‑lui iris.trainingtarget et iris.testtarget, et stockez le résultat dans iris.trainLabels et iris.testLabels :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBPbmUgaG90IGVuY29kZSB0cmFpbmluZyB0YXJnZXQgdmFsdWVzXG5pcmlzLnRyYWluTGFiZWxzIDwtIHRvX2NhdGVnb3JpY2FsKC4uLi4uLi4uLi4uLi4uLi4uLi4pXG5cbiMgT25lIGhvdCBlbmNvZGUgdGVzdCB0YXJnZXQgdmFsdWVzXG5pcmlzLnRlc3RMYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoLi4uLi4uLi4uLi4uLi4uLilcblxuIyBQcmludCBvdXQgdGhlIGlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5cbiMgUHJpbnQgb3V0IHRoZSBpcmlzLnRlc3RMYWJlbHMgdG8gZG91YmxlIGNoZWNrIHRoZSByZXN1bHRcbnByaW50KC4uLi4uLi4uLi4uLi4pIiwic29sdXRpb24iOiIjIE9uZSBob3QgZW5jb2RlIHRyYWluaW5nIHRhcmdldCB2YWx1ZXNcbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcblxuIyBPbmUgaG90IGVuY29kZSB0ZXN0IHRhcmdldCB2YWx1ZXNcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5cbiMgUHJpbnQgb3V0IHRoZSBpcmlzLnRlc3RMYWJlbHMgdG8gZG91YmxlIGNoZWNrIHRoZSByZXN1bHRcbnByaW50KGlyaXMudGVzdExhYmVscykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiRGlkIHlvdSBwYXNzIGBpcmlzLnRyYWluaW5ndGFyZ2V0YCB0byB0aGUgYHRvX2NhdGVnb3JpY2FsKClgIGZ1bmN0aW9uP1wiXG5tc2dfdW5kZWZpbmVkMiA8LSBcIkRpZCB5b3UgcGFzcyBgaXJpcy50ZXN0dGFyZ2V0YCB0byB0aGUgYHRvX2NhdGVnb3JpY2FsKClgIGZ1bmN0aW9uP1wiXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMudHJhaW5MYWJlbHMnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnaXJpcy50ZXN0TGFiZWxzJywgbXNnX3VuZGVmaW5lZDIpICU+JSBjaGVja19lcXVhbChtc2dfdW5kZWZpbmVkMilcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwicHJpbnRcIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkdvb2Qgam9iISBEb3VibGUgY2hlY2sgdGhlIHByaW50LW91dCBvZiBgaXJpcy50ZXN0TGFiZWxzYCB0byBzZWUgaG93IG9uZS1ob3QgZW5jb2Rpbmcgd29ya3MhXCIpIn0=

Vous voilà au bout des étapes d’exploration et de prétraitement. Place à la construction du réseau de neurones avec keras !

Construire le modèle

Commencez par initialiser un modèle séquentiel avec keras_model_sequential(). Vous pouvez ensuite empiler vos couches.

Au préalable, rappelez‑vous la question : peut‑on prédire l’espèce d’un iris ? Vous avez préparé des données numériques et one‑hot encodé la cible : la fleur est versicolor, setosa ou virginica, ce qui est représenté par des 0/1.

Un perceptron multicouche fonctionne bien sur ce type de problème. Il s’agit d’un réseau souvent entièrement connecté. Vous allez donc construire une pile de couches denses relativement simple. Côté fonctions d’activation, pour se familiariser avec Keras, utilisez relu dans la couche cachée, ce qui est une bonne pratique générale.

Dans la couche de sortie, utilisez softmax pour obtenir des probabilités normalisées entre 0 et 1 :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIGEgc2VxdWVudGlhbCBtb2RlbFxubW9kZWwgPC0gLi4uLi4uLi4uLi4uLi4uLi4uLi4uLlxuXG4jIEFkZCBsYXllcnMgdG8gdGhlIG1vZGVsXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpIiwic29sdXRpb24iOiIjIEluaXRpYWxpemUgYSBzZXF1ZW50aWFsIG1vZGVsXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5cbiMgQWRkIGxheWVycyB0byB0aGUgbW9kZWxcbm1vZGVsICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDgsIGFjdGl2YXRpb24gPSAncmVsdScsIGlucHV0X3NoYXBlID0gYyg0KSkgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMywgYWN0aXZhdGlvbiA9ICdzb2Z0bWF4JykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiRGlkIHlvdSBpbml0aWFsaXplIGEgc2VxdWVudGlhbCBtb2RlbCB3aXRoIHRoZSBoZWxwIG9mIGBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKClgP1wiXG5tc2dfaW5jb3JyZWN0IDwtIFwiRGlkIHlvdSBrZWVwIHRoZSBwcmVkZWZpbmVkIGxheWVycz9cIlxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdtb2RlbCcsIG1zZ191bmRlZmluZWQpICU+JSBjaGVja19lcXVhbChtc2dfaW5jb3JyZWN0KVxuc3VjY2Vzc19tc2coXCJHb29kIGpvYiEgWW91IGhhdmUgc3VjY2Vzc2Z1bGx5IGNvbnN0cnVjdGVkIGEgbW9kZWwgd2l0aCB0aGUgYGtlcmFzYCBwYWNrYWdlIGluIFIhXCIpIn0=

La couche de sortie crée 3 valeurs (une par classe : versicolor, virginica, setosa). La première couche a un input_shape de 4, car iris.training comporte 4 colonnes.

Vous pouvez inspecter le modèle avec :

  • summary() pour un récapitulatif ;
  • get_config() pour la configuration du modèle ;
  • get_layer() pour la configuration d’une couche ;
  • l’attribut layers pour la liste à plat des couches ;
  • l’attribut inputs pour les tenseurs d’entrée ;
  • et outputs pour les tenseurs de sortie.
eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpIiwic2FtcGxlIjoiIyBQcmludCBhIHN1bW1hcnkgb2YgYSBtb2RlbFxuc3VtbWFyeShtb2RlbClcblxuIyBHZXQgbW9kZWwgY29uZmlndXJhdGlvblxuZ2V0X2NvbmZpZyhtb2RlbClcblxuIyBHZXQgbGF5ZXIgY29uZmlndXJhdGlvblxuZ2V0X2xheWVyKG1vZGVsLCBpbmRleCA9IDEpXG5cbiMgTGlzdCB0aGUgbW9kZWwncyBsYXllcnNcbm1vZGVsJGxheWVyc1xuXG4jIExpc3QgdGhlIGlucHV0IHRlbnNvcnNcbm1vZGVsJGlucHV0c1xuXG4jIExpc3QgdGhlIG91dHB1dCB0ZW5zb3JzXG5tb2RlbCRvdXRwdXRzIn0=

Compiler et entraîner le modèle

Une fois l’architecture définie, compilez et entraînez le modèle. Pour la compilation, utilisez l’optimiseur adam et la fonction de perte categorical_crossentropy. Suivez aussi la métrique 'accuracy' pendant l’entraînement via l’argument metrics.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpIiwic2FtcGxlIjoiIyBDb21waWxlIHRoZSBtb2RlbFxubW9kZWwgJT4lIGNvbXBpbGUoXG4gICAgIGxvc3MgPSAnY2F0ZWdvcmljYWxfY3Jvc3NlbnRyb3B5JyxcbiAgICAgb3B0aW1pemVyID0gJ2FkYW0nLFxuICAgICBtZXRyaWNzID0gJ2FjY3VyYWN5J1xuICkifQ==

L’optimiseur et la perte sont requis pour compiler le modèle.

Parmi les algorithmes d’optimisation populaires : descente de gradient stochastique (SGD), Adam, RMSprop. Selon l’algorithme, vous ajusterez certains paramètres (taux d’apprentissage, momentum…). Le choix de la perte dépend de la tâche : pour une régression, on utilise souvent l’erreur quadratique moyenne (MSE).

Ici, vous utilisez categorical_crossentropy pour une classification multiclasse (versicolor/virginica/setosa). Pour une classification binaire, vous utiliseriez binary_crossentropy.

Ensuite, entraînez le modèle : 200 époques (parcours complets du jeu d’entraînement iris.training/iris.trainLabels) avec des lots (batches) de 5 échantillons.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKSIsInNhbXBsZSI6IiMgRml0IHRoZSBtb2RlbCBcbm1vZGVsICU+JSBmaXQoXG4gICAgIGlyaXMudHJhaW5pbmcsIFxuICAgICBpcmlzLnRyYWluTGFiZWxzLCBcbiAgICAgZXBvY2hzID0gMjAwLCBcbiAgICAgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSJ9

Astuce : vous pouvez aussi fixer verbose=1 dans fit() pour afficher une barre de progression.

Vous entraînez le modèle sur un nombre d’époques donné (un passage complet sur l’ensemble d’entraînement), avec un batch_size définissant le nombre d’échantillons propagés simultanément. Cela améliore l’efficacité en limitant la charge mémoire.

Visualiser l’historique d’entraînement

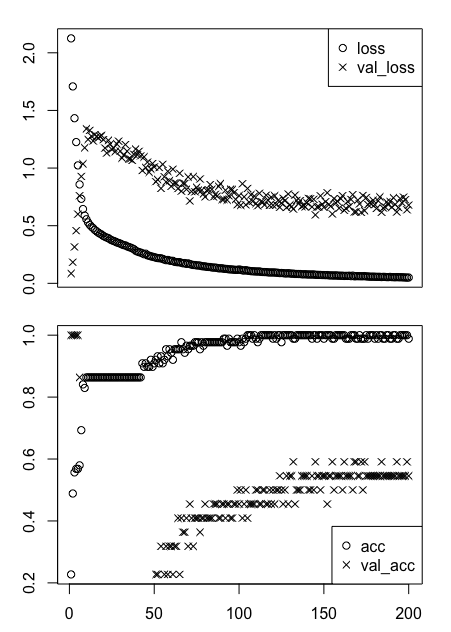
Vous pouvez visualiser l’entraînement en stockant le retour de fit() dans une variable, puis en la passant à plot(), comme ci‑dessous.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKSIsInNhbXBsZSI6IiMgU3RvcmUgdGhlIGZpdHRpbmcgaGlzdG9yeSBpbiBgaGlzdG9yeWAgXG5oaXN0b3J5IDwtIG1vZGVsICU+JSBmaXQoXG4gICAgIGlyaXMudHJhaW5pbmcsIFxuICAgICBpcmlzLnRyYWluTGFiZWxzLCBcbiAgICAgZXBvY2hzID0gMjAwLFxuICAgICBiYXRjaF9zaXplID0gNSwgXG4gICAgIHZhbGlkYXRpb25fc3BsaXQgPSAwLjJcbiApXG5cbiMgUGxvdCB0aGUgaGlzdG9yeVxucGxvdChoaXN0b3J5KSJ9

Étudiez le graphique en détail.

plot

À première vue, c’est un peu confus. De quoi s’agit‑il ?

loss et acc décrivent respectivement la perte et la précision sur l’entraînement ; val_loss et val_acc les mêmes métriques sur la validation.

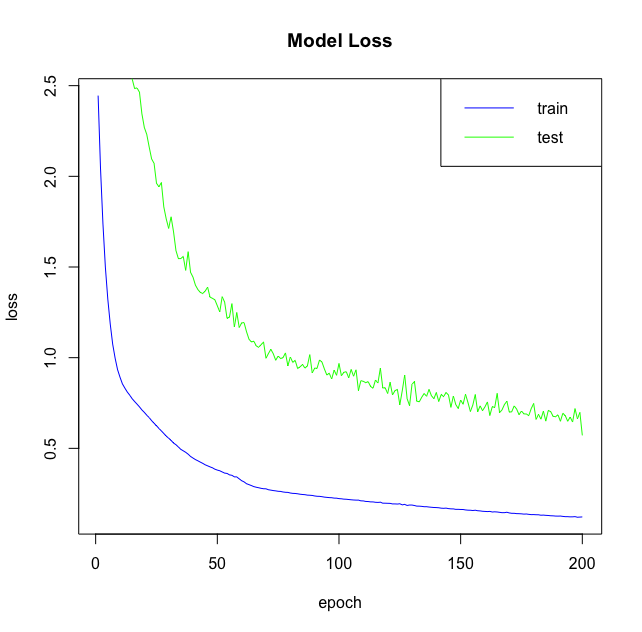
Pour faciliter l’interprétation, séparez ces deux tracés : un pour la perte, l’autre pour la précision. Utilisez l’opérateur $ pour accéder pas à pas aux séries à tracer.

Exemple dans la boîte DataCamp ci‑dessous :
eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuaGlzdG9yeSA8LSBtb2RlbCAlPiUgZml0KFxuICAgICBpcmlzLnRyYWluaW5nLCBcbiAgICAgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCxcbiAgICAgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgUGxvdCB0aGUgbW9kZWwgbG9zcyBvZiB0aGUgdHJhaW5pbmcgZGF0YVxucGxvdChoaXN0b3J5JG1ldHJpY3MkbG9zcywgbWFpbj1cIk1vZGVsIExvc3NcIiwgeGxhYiA9IFwiZXBvY2hcIiwgeWxhYj1cImxvc3NcIiwgY29sPVwiYmx1ZVwiLCB0eXBlPVwibFwiKVxuXG4jIFBsb3QgdGhlIG1vZGVsIGxvc3Mgb2YgdGhlIHRlc3QgZGF0YVxubGluZXMoaGlzdG9yeSRtZXRyaWNzJHZhbF9sb3NzLCBjb2w9XCJncmVlblwiKVxuXG4jIEFkZCBsZWdlbmRcbmxlZ2VuZChcInRvcHJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpIn0=

chart

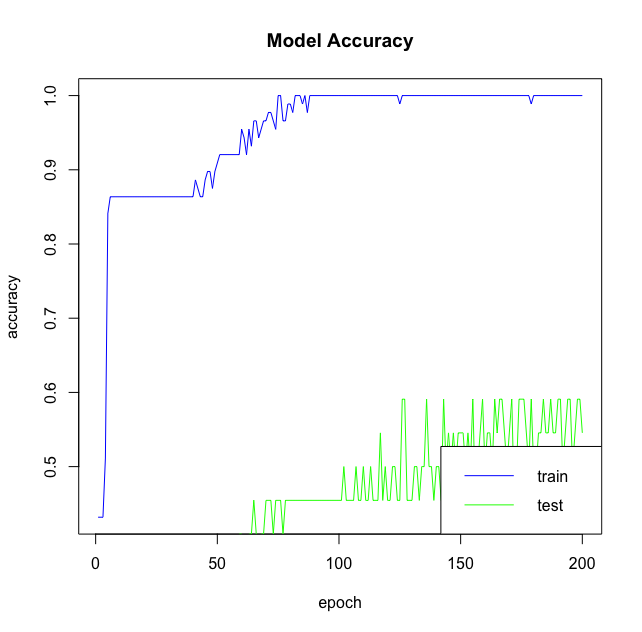
Ici, vous tracez la perte sur entraînement et test. Faites de même pour la précision :
eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuaGlzdG9yeSA8LSBtb2RlbCAlPiUgZml0KFxuICAgICBpcmlzLnRyYWluaW5nLCBcbiAgICAgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCxcbiAgICAgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgUGxvdCB0aGUgYWNjdXJhY3kgb2YgdGhlIHRyYWluaW5nIGRhdGEgXG5wbG90KGhpc3RvcnkkbWV0cmljcyRhY2MsIG1haW49XCJNb2RlbCBBY2N1cmFjeVwiLCB4bGFiID0gXCJlcG9jaFwiLCB5bGFiPVwiYWNjdXJhY3lcIiwgY29sPVwiYmx1ZVwiLCB0eXBlPVwibFwiKVxuXG4jIFBsb3QgdGhlIGFjY3VyYWN5IG9mIHRoZSB2YWxpZGF0aW9uIGRhdGFcbmxpbmVzKGhpc3RvcnkkbWV0cmljcyR2YWxfYWNjLCBjb2w9XCJncmVlblwiKVxuXG4jIEFkZCBMZWdlbmRcbmxlZ2VuZChcImJvdHRvbXJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpIn0=

model accuracy

À garder en tête :

  • Si la précision sur l’entraînement continue de monter mais que celle de validation baisse, vous sur‑adaptez (overfitting) : le modèle mémorise au lieu d’apprendre.
  • Si la précision sur les deux ensembles augmente encore sur les dernières époques, le modèle n’a pas encore sur‑appris.

Prédire les labels de nouvelles données

Votre modèle est créé, compilé et entraîné. Utilisez‑le pour prédire les classes du jeu de test iris.test avec predict(), puis affichez la matrice de confusion pour comparer prédictions et vrais labels via table().

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxubW9kZWwgJT4lIGZpdChcbiAgICAgaXJpcy50cmFpbmluZywgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCwgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgUHJlZGljdCB0aGUgY2xhc3NlcyBmb3IgdGhlIHRlc3QgZGF0YVxuY2xhc3NlcyA8LSBtb2RlbCAlPiUgcHJlZGljdF9jbGFzc2VzKGlyaXMudGVzdCwgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBDb25mdXNpb24gbWF0cml4XG50YWJsZShpcmlzLnRlc3R0YXJnZXQsIGNsYXNzZXMpIn0=

Que pensez‑vous des résultats ? À première vue, le modèle se trompe‑t‑il souvent ?

Évaluer votre modèle

Même si la matrice de confusion donne un aperçu des performances, évaluez formellement le modèle avec evaluate() : passez les données de test iris.test, les labels iris.testLabels et un batch_size. Stockez le résultat dans score, comme ci‑dessous :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxubW9kZWwgJT4lIGZpdChcbiAgICAgaXJpcy50cmFpbmluZywgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCwgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgRXZhbHVhdGUgb24gdGVzdCBkYXRhIGFuZCBsYWJlbHNcbnNjb3JlIDwtIG1vZGVsICU+JSBldmFsdWF0ZShpcmlzLnRlc3QsIGlyaXMudGVzdExhYmVscywgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBQcmludCB0aGUgc2NvcmVcbnByaW50KHNjb3JlKSJ9

En imprimant score, vous obtenez la valeur de perte et la valeur de la métrique (ici 'accuracy').

Ajuster finement votre modèle

Le réglage fin est une étape fréquente, surtout au début, car toutes les tâches de classification/régression ne sont pas aussi simples que notre exemple. Deux décisions clés reviennent souvent : le nombre de couches et le nombre d’unités cachées par couche.

Au début, c’est un vrai parcours d’exploration.

Outre le nombre d’époques et la taille de batch, vous pouvez : ajouter des couches, augmenter le nombre d’unités cachées et passer des paramètres d’optimisation personnalisés à compile().

Ajouter des couches

Que se passe‑t‑il si vous ajoutez une couche supplémentaire ? Par exemple :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBzZXF1ZW50aWFsIG1vZGVsXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5cbiMgQWRkIGxheWVycyB0byBtb2RlbFxubW9kZWwgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gOCwgYWN0aXZhdGlvbiA9ICdyZWx1JywgaW5wdXRfc2hhcGUgPSBjKDQpKSAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA1LCBhY3RpdmF0aW9uID0gJ3JlbHUnKSAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSAzLCBhY3RpdmF0aW9uID0gJ3NvZnRtYXgnKVxuXG4jIENvbXBpbGUgdGhlIG1vZGVsXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuXG4jIEZpdCB0aGUgbW9kZWwgdG8gdGhlIGRhdGFcbm1vZGVsICU+JSBmaXQoXG4gICAgIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICAgICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LCBcbiAgICAgdmFsaWRhdGlvbl9zcGxpdCA9IDAuMlxuIClcblxuIyBFdmFsdWF0ZSB0aGUgbW9kZWxcbnNjb3JlIDwtIG1vZGVsICU+JSBldmFsdWF0ZShpcmlzLnRlc3QsIGlyaXMudGVzdExhYmVscywgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBQcmludCB0aGUgc2NvcmVcbnByaW50KHNjb3JlKSJ9

Vous pouvez aussi visualiser les métriques de perte et de précision de ce nouveau modèle ! Essayez dans l’extrait ci‑dessous :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIGEgc2VxdWVudGlhbCBtb2RlbFxubW9kZWwgPC0ga2VyYXNfbW9kZWxfc2VxdWVudGlhbCgpIFxuXG4jIEFkZCBsYXllcnMgdG8gdGhlIG1vZGVsXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDUsIGFjdGl2YXRpb24gPSAncmVsdScpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5cbiMgQ29tcGlsZSB0aGUgbW9kZWxcbm1vZGVsICU+JSBjb21waWxlKFxuICAgICBsb3NzID0gJ2NhdGVnb3JpY2FsX2Nyb3NzZW50cm9weScsXG4gICAgIG9wdGltaXplciA9ICdhZGFtJyxcbiAgICAgbWV0cmljcyA9ICdhY2N1cmFjeSdcbiApXG5cbiMgU2F2ZSB0aGUgdHJhaW5pbmcgaGlzdG9yeSBpbiBoaXN0b3J5XG5oaXN0b3J5IDwtIG1vZGVsICU+JSBmaXQoXG4gIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LFxuICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKVxuXG4jIFBsb3QgdGhlIG1vZGVsIGxvc3NcbnBsb3QoaGlzdG9yeSRtZXRyaWNzJGxvc3MsIG1haW49XCJNb2RlbCBMb3NzXCIsIHhsYWIgPSBcImVwb2NoXCIsIHlsYWI9XCJsb3NzXCIsIGNvbD1cImJsdWVcIiwgdHlwZT1cImxcIilcbmxpbmVzKGhpc3RvcnkkbWV0cmljcyR2YWxfbG9zcywgY29sPVwiZ3JlZW5cIilcbmxlZ2VuZChcInRvcHJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpXG5cbiMgUGxvdCB0aGUgbW9kZWwgYWNjdXJhY3lcbnBsb3QoaGlzdG9yeSRtZXRyaWNzJGFjYywgbWFpbj1cIk1vZGVsIEFjY3VyYWN5XCIsIHhsYWIgPSBcImVwb2NoXCIsIHlsYWI9XCJhY2N1cmFjeVwiLCBjb2w9XCJibHVlXCIsIHR5cGU9XCJsXCIpXG5saW5lcyhoaXN0b3J5JG1ldHJpY3MkdmFsX2FjYywgY29sPVwiZ3JlZW5cIilcbmxlZ2VuZChcImJvdHRvbXJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpIn0=

deep learning model layers

Keras Layers model

Unités cachées

Testez aussi l’ajout d’unités cachées et observez l’impact sur l’évaluation, par exemple :

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIGEgc2VxdWVudGlhbCBtb2RlbFxubW9kZWwgPC0ga2VyYXNfbW9kZWxfc2VxdWVudGlhbCgpIFxuXG4
Sujets
R
Science des données
Intelligence artificielle
Apprentissage automatique
Apprentissage profond

Cours associés

Cours

Introduction à R

4 h
3.1M
Maîtrisez les bases de l’analyse de données en R et pratiquez les vecteurs, listes et data frames avec des données réelles.
Afficher les détailsRight Arrow
Commencer Le Cours
Voir plusRight Arrow