
Last chance! 50% off DataCamp Premium
Sale ends in
Jalankan dan edit kode dari Tutorial ini secara online
Jalankan kodeApakah Anda tertarik mempelajari lebih lanjut tentang manipulasi data di R dengan dplyr? Lihat kursus Data Manipulation in R with dplyr kami.
Untuk memahami apa itu operator pipe di R dan apa yang dapat Anda lakukan dengannya, perlu melihat gambar besarnya, mempelajari sejarah di baliknya. Pertanyaan seperti "dari mana asal kombinasi simbol yang aneh ini dan mengapa dibuat seperti itu?" mungkin terlintas di benak Anda. Anda akan menemukan jawabannya dan pertanyaan lainnya di bagian ini.
Sekarang, Anda dapat melihat sejarahnya dari tiga perspektif: dari sudut pandang matematika, dari pandangan holistik bahasa pemrograman, dan dari sudut pandang bahasa R itu sendiri. Anda akan membahas ketiganya di bawah ini!
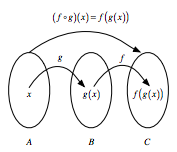
Jika Anda memiliki dua fungsi, misalnya $f : B → C$ dan $g : A → B$, Anda dapat merangkaikan kedua fungsi ini dengan mengambil keluaran dari satu fungsi dan memasukkannya ke fungsi berikutnya. Singkatnya, "chaining" berarti Anda meneruskan hasil antara ke fungsi berikutnya, tetapi Anda akan melihat lebih banyak tentang itu nanti.
Misalnya, Anda dapat mengatakan, $f(g(x))$: $g(x)$ berfungsi sebagai masukan untuk $f()$, sementara $x$ tentu saja menjadi masukan untuk $g()$.
Jika Anda ingin menuliskannya, Anda akan menggunakan notasi $f ◦ g$, yang dibaca sebagai "f mengikuti g". Atau, Anda dapat merepresentasikannya secara visual sebagai:
Seperti disebutkan dalam pengantar bagian ini, operator ini bukan hal baru dalam pemrograman: di Shell atau Terminal, Anda dapat meneruskan perintah dari satu ke berikutnya dengan karakter pipeline |. Demikian pula, F# memiliki operator forward pipe, yang nantinya terbukti penting! Terakhir, ada baiknya juga diketahui bahwa Haskell memiliki banyak operasi piping yang diturunkan dari Shell atau Terminal.
Setelah Anda melihat sedikit sejarah operator pipe di bahasa pemrograman lain, sekarang saatnya fokus pada R. Sejarah operator ini di R dimulai pada 17 Januari 2012, ketika seorang pengguna anonim mengajukan pertanyaan berikut dalam posting Stack Overflow ini:
Bagaimana Anda dapat mengimplementasikan operator forward pipe F# di R? Operator ini memungkinkan untuk dengan mudah merangkaikan serangkaian perhitungan. Misalnya, ketika Anda memiliki input data dan ingin memanggil fungsi
foodanbarsecara berurutan, Anda dapat menulisdata |> foo |> bar?
Jawabannya datang dari Ben Bolker, profesor di McMaster University, yang membalas:
Saya tidak tahu seberapa baik ini akan bertahan untuk penggunaan nyata, tetapi ini tampaknya (?) melakukan apa yang Anda inginkan, setidaknya untuk fungsi dengan satu argumen ...
"%>%" <- function(x,f) do.call(f,list(x))
pi %>% sin
[1] 1.224606e-16
pi %>% sin %>% cos
[1] 1
cos(sin(pi))
[1] 1
Sekitar sembilan bulan kemudian, Hadley Wickham memulai paket dplyr di GitHub. Anda mungkin kini mengenal Hadley, Chief Scientist di RStudio, sebagai penulis banyak paket R populer (termasuk paket terakhir ini!) dan sebagai instruktur untuk kursus Introduction to Writing Functions in R kami.
Namun, baru pada 2013 pipe pertama %.% muncul di paket ini. Seperti yang disebutkan dengan tepat oleh Adolfo Álvarez dalam posting blognya, fungsi tersebut dinamai chain(), yang bertujuan menyederhanakan notasi untuk penerapan beberapa fungsi pada sebuah data frame di R.
Pipe %.% tidak bertahan lama, karena Stefan Bache mengusulkan alternatif pada 29 Desember 2013 yang menyertakan operator seperti yang Anda kenal sekarang:
iris %>%
  subset(Sepal.Length > 5) %>%
  aggregate(. ~ Species, ., mean)
Bache terus mengembangkan operasi pipe ini, dan pada akhir 2013, paket magrittr lahir. Sementara itu, Hadley Wickham melanjutkan pengerjaan dplyr dan pada April 2014, operator %.% digantikan dengan yang sekarang Anda kenal, %>%.
Di tahun yang sama, Kun Ren merilis paket pipeR di GitHub, yang memasukkan operator pipe berbeda, %>>%, yang dirancang untuk menambah fleksibilitas proses piping. Namun, dapat dikatakan dengan aman bahwa %>% kini sudah mapan dalam bahasa R, terutama dengan popularitas Tidyverse belakangan ini.
Mengetahui sejarah adalah satu hal, tetapi itu belum memberi Anda gambaran tentang apa itu operator forward pipe F# ataupun apa yang sebenarnya dilakukannya di R.
Di F#, operator pipe-forward |> adalah pemanis sintaks untuk pemanggilan metode berantai. Atau, lebih sederhana, operator ini memungkinkan Anda meneruskan hasil antara ke fungsi berikutnya.
Ingat bahwa "chaining" berarti Anda memanggil beberapa metode. Karena setiap metode mengembalikan sebuah objek, Anda dapat memungkinkan pemanggilan tersebut dirangkaikan bersama dalam satu pernyataan, tanpa perlu variabel untuk menyimpan hasil antara.
Di R, operator pipe adalah, sebagaimana telah Anda lihat, %>%. Jika Anda tidak akrab dengan F#, Anda dapat menganggap operator ini mirip dengan + dalam pernyataan ggplot2. Fungsinya sangat mirip dengan operator F# yang telah Anda lihat: ia mengambil keluaran dari satu pernyataan dan menjadikannya masukan untuk pernyataan berikutnya. Saat menjelaskannya, Anda dapat menganggapnya sebagai "KEMUDIAN".
Ambil contoh potongan kode berikut dan bacalah dengan lantang:
iris %>%
  subset(Sepal.Length > 5) %>%
  aggregate(. ~ Species, ., mean)
Tepat, potongan kode di atas akan diterjemahkan menjadi sesuatu seperti "Anda mengambil data Iris, kemudian Anda melakukan subset data dan kemudian Anda melakukan agregasi data".
Ini adalah salah satu hal terkuat dari Tidyverse. Faktanya, memiliki rantai tindakan pemrosesan yang terstandar disebut "pipeline". Membuat pipeline untuk suatu format data sangat bagus, karena Anda dapat menerapkan pipeline itu pada data masuk yang memiliki format sama dan mengeluarkannya, misalnya, dalam format yang ramah ggplot2.
R adalah bahasa fungsional, yang berarti kode Anda sering berisi banyak tanda kurung, ( dan ). Ketika kode Anda kompleks, ini sering berarti Anda harus menumpuk tanda kurung tersebut. Ini membuat kode R Anda sulit dibaca dan dipahami. Di sinilah %>% datang untuk menyelamatkan!
Perhatikan contoh berikut, yang merupakan contoh khas kode bersarang:
# Initialize `x`
x <- c(0.109, 0.359, 0.63, 0.996, 0.515, 0.142, 0.017, 0.829, 0.907)

# Compute the logarithm of `x`, return suitably lagged and iterated differences,
# compute the exponential function and round the result
round(exp(diff(log(x))), 1)
Dengan bantuan %<%, Anda dapat menulis ulang kode di atas sebagai berikut:
# Import `magrittr`
library(magrittr)

# Perform the same computations on `x` as above
x %>% log() %>%
    diff() %>%
    exp() %>%
    round(1)
Terlihat sulit bagi Anda? Jangan khawatir! Anda akan mempelajari lebih lanjut cara melakukannya nanti dalam tutorial ini.
Catatan bahwa Anda perlu mengimpor library magrittr agar kode di atas berfungsi. Itu karena operator pipe adalah, seperti yang Anda baca di atas, bagian dari library magrittr dan, sejak 2014, juga bagian dari dplyr. Jika Anda lupa mengimpor library-nya, Anda akan mendapatkan error seperti Error in eval(expr, envir, enclos): could not find function "%>%".
Perhatikan juga bahwa menambahkan tanda kurung setelah log, diff dan exp bukanlah persyaratan formal, tetapi, di komunitas R, sebagian orang menggunakannya untuk meningkatkan keterbacaan kode.
Singkatnya, berikut empat alasan mengapa Anda sebaiknya menggunakan pipe di R:
Alasan-alasan ini diambil dari dokumentasi magrittr itu sendiri. Secara implisit, Anda melihat argumen keterbacaan dan fleksibilitas kembali muncul.
Walaupun %>% adalah operator pipe (utama) dari paket magrittr, ada beberapa operator lain yang sebaiknya Anda ketahui dan merupakan bagian dari paket yang sama:
%<>%;# Initialize `x`
x <- rnorm(100)
# Update value of `x` and assign it to `x`
x %<>% abs %>% sort
%T>%;rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
Catatan bahwa ada baiknya diketahui untuk saat ini bahwa potongan kode di atas sebenarnya adalah jalan pintas untuk:
rnorm(200) %>%
matrix(ncol = 2) %T>%
{ plot(.); . } %>%
colSums
Tetapi Anda akan melihat lebih banyak tentang itu nanti!
%$%.data.frame(z = rnorm(100)) %$%
ts.plot(z)
Tentu saja, ketiga operator ini bekerja sedikit berbeda dari operator utama %>%. Anda akan melihat lebih banyak tentang fungsionalitas dan penggunaannya nanti dalam tutorial ini.
Catatan bahwa meskipun Anda paling sering melihat pipe magrittr, Anda juga mungkin menjumpai pipe lain seiring berjalannya waktu! Beberapa contohnya adalah wrapr dengan dot arrow pipe %.>% atau to dot pipe %>.%, atau Bizarro pipe ->.;.
Sekarang Anda tahu bagaimana operator %>% muncul, apa sebenarnya itu, dan mengapa Anda harus menggunakannya, saatnya untuk mengetahui bagaimana Anda benar-benar dapat menggunakannya untuk keuntungan Anda. Anda akan melihat bahwa ada cukup banyak cara untuk menggunakannya!
Sebelum masuk ke penggunaan operator yang lebih lanjut, ada baiknya terlebih dahulu melihat contoh paling dasar yang menggunakan operator ini. Intinya, Anda akan melihat bahwa ada tiga aturan yang dapat diikuti ketika pertama kali mulai:
f(x) dapat ditulis ulang sebagai x %>% fSingkatnya, ini berarti fungsi yang mengambil satu argumen, function(argument), dapat ditulis ulang sebagai berikut: argument %>% function(). Lihat contoh yang lebih praktis berikut untuk memahami bagaimana keduanya ekuivalen:
# Compute the logarithm of `x`
log(x)
# Compute the logarithm of `x`
x %>% log()
f(x, y) dapat ditulis ulang sebagai x %>% f(y)Tentu, ada banyak fungsi yang tidak hanya mengambil satu argumen, tetapi beberapa. Ini terjadi di sini: Anda melihat bahwa fungsi mengambil dua argumen, x dan y. Mirip dengan yang Anda lihat di contoh pertama, Anda dapat menulis ulang fungsi dengan mengikuti struktur argument1 %>% function(argument2), di mana argument1 adalah placeholder magrittr dan argument2 adalah pemanggilan fungsi.
Semua ini tampak cukup teoretis. Mari lihat contoh yang lebih praktis:
# Round pi
round(pi, 6)
# Round pi
pi %>% round(6)
x %>% f %>% g %>% h dapat ditulis ulang sebagai h(g(f(x)))Ini mungkin terlihat kompleks, tetapi tidak seperti itu ketika Anda melihat contoh R yang nyata:
# Import `babynames` data
library(babynames)
# Import `dplyr` library
library(dplyr)
# Load the data
data(babynames)
# Count how many young boys with the name "Taylor" are born
sum(select(filter(babynames,sex=="M",name=="Taylor"),n))
# Do the same but now with `%>%`
babynames%>%filter(sex=="M",name=="Taylor")%>%
select(n)%>%
sum
Catatan bagaimana Anda bekerja dari dalam ke luar saat menulis ulang kode bersarang: Anda terlebih dahulu memasukkan babynames, lalu Anda menggunakan %>% untuk terlebih dahulu melakukan filter() data. Setelah itu, Anda akan memilih n dan terakhir, Anda akan melakukan sum() semuanya.
Ingat juga bahwa Anda sudah melihat contoh lain dari kode bersarang seperti itu yang diubah menjadi kode yang lebih mudah dibaca di awal tutorial ini, di mana Anda menggunakan fungsi log(), diff(), exp() dan round() untuk melakukan perhitungan pada x.
Sayangnya, ada beberapa pengecualian terhadap aturan umum yang diuraikan pada bagian sebelumnya. Mari kita lihat beberapa di antaranya di sini.
Pertimbangkan contoh ini, di mana Anda menggunakan fungsi assign() untuk menetapkan nilai 10 ke variabel x.
# Assign `10` to `x`
assign("x", 10)
# Assign `100` to `x`
"x" %>% assign(100)
# Return `x`
x
10
Anda melihat bahwa pemanggilan kedua dengan fungsi assign(), dikombinasikan dengan pipe, tidak bekerja dengan benar. Nilai x tidak diperbarui.
Mengapa demikian?
Itu karena fungsi tersebut menetapkan nilai baru 100 ke lingkungan sementara yang digunakan oleh %>%. Jadi, jika Anda ingin menggunakan assign() dengan pipe, Anda harus eksplisit tentang lingkungannya:
# Define your environment
env <- environment()
# Add the environment to `assign()`
"x" %>% assign(100, envir = env)
# Return `x`
x
100
Argumen dalam fungsi hanya dihitung ketika fungsi menggunakannya di R. Ini berarti tidak ada argumen yang dihitung sebelum Anda memanggil fungsi. Itu juga berarti pipe menghitung setiap elemen fungsi secara bergiliran.
Salah satu tempat di mana ini menjadi masalah adalah tryCatch(), yang memungkinkan Anda menangkap dan menangani error, seperti pada contoh ini:
tryCatch(stop("!"), error = function(e) "An error")
stop("!") %>%
tryCatch(error = function(e) "An error")
'An error'
Error in eval(expr, envir, enclos): !
Traceback:
1. stop("!") %>% tryCatch(error = function(e) "An error")
2. eval(lhs, parent, parent)
3. eval(expr, envir, enclos)
4. stop("!")
Anda akan melihat bahwa cara bersarang untuk menuliskan baris kode ini berfungsi dengan baik, sementara alternatif dengan pipe menghasilkan error. Fungsi lain dengan perilaku yang sama adalah try(), suppressMessages(), dan suppressWarnings() di base R.
Ada juga kasus di mana Anda dapat menggunakan operator pipe sebagai placeholder argumen. Perhatikan contoh berikut:
f(x, y) dapat ditulis ulang sebagai y %>% f(x, .)Dalam beberapa kasus, Anda tidak ingin nilai atau placeholder magrittr untuk pemanggilan fungsi berada di posisi pertama, seperti pada setiap contoh yang Anda lihat sejauh ini. Pertimbangkan kembali baris kode ini:
pi %>% round(6)
Jika Anda menulis ulang baris kode ini, pi akan menjadi argumen pertama dalam fungsi round() Anda. Namun bagaimana jika Anda ingin mengganti argumen kedua, ketiga, ... dan menggunakan argumen tersebut sebagai placeholder magrittr pada pemanggilan fungsi Anda?
Lihat contoh ini, di mana nilainya sebenarnya berada di posisi ketiga dalam pemanggilan fungsi:
"Ceci n'est pas une pipe" %>% gsub("une", "un", .)
'Ceci n\'est pas un pipe'
f(y, z = x) dapat ditulis ulang sebagai x %>% f(y, z = .)Demikian pula, Anda mungkin ingin menjadikan nilai suatu argumen tertentu dalam pemanggilan fungsi Anda sebagai placeholder magrittr. Pertimbangkan baris kode berikut:
6 %>% round(pi, digits=.)
Menggunakan placeholder beberapa kali dalam ekspresi sisi kanan adalah hal yang langsung. Namun, ketika placeholder hanya muncul dalam ekspresi bersarang, magrittr tetap akan menerapkan aturan argumen pertama. Alasannya adalah karena dalam banyak kasus ini menghasilkan kode yang lebih bersih.
Berikut beberapa "aturan" umum yang dapat Anda perhatikan saat bekerja dengan placeholder argumen dalam pemanggilan fungsi bersarang:
f(x, y = nrow(x), z = ncol(x)) dapat ditulis ulang sebagai x %>% f(y = nrow(.), z = ncol(.))# Initialize a matrix `ma`
ma <- matrix(1:12, 3, 4)
# Return the maximum of the values inputted
max(ma, nrow(ma), ncol(ma))
# Return the maximum of the values inputted
ma %>% max(nrow(ma), ncol(ma))
12
12
Perilaku ini dapat ditimpa dengan membungkus sisi kanan dalam kurung kurawal:
f(y = nrow(x), z = ncol(x)) dapat ditulis ulang sebagai x %>% {f(y = nrow(.), z = ncol(.))}# Only return the maximum of the `nrow(ma)` and `ncol(ma)` input values
ma %>% {max(nrow(ma), ncol(ma))}
4
Sebagai penutup, lihat juga contoh berikut, di mana Anda mungkin ingin menyesuaikan kerja placeholder argumen dalam pemanggilan fungsi bersarang:
# The function that you want to rewrite
paste(1:5, letters[1:5])
# The nested function call with dot placeholder
1:5 %>%
paste(., letters[.])
Anda melihat bahwa jika placeholder hanya digunakan dalam pemanggilan fungsi bersarang, placeholder magrittr juga akan ditempatkan sebagai argumen pertama! Jika Anda ingin menghindari hal ini, Anda dapat menggunakan kurung kurawal { dan }:
# The nested function call with dot placeholder and curly brackets
1:5 %>% {
paste(letters[.])
}
# Rewrite the above function call
paste(letters[1:5])
Fungsi unari adalah fungsi yang mengambil satu argumen. Pipeline apa pun yang Anda buat yang terdiri dari titik ., diikuti oleh fungsi-fungsi dan dirangkaikan dengan %>% dapat digunakan nanti jika Anda ingin menerapkannya pada nilai. Lihat contoh pipeline berikut:
. %>% cos %>% sin
Pipeline ini akan mengambil suatu masukan, setelah itu fungsi cos() dan sin() akan diterapkan padanya.
Tetapi belum selesai! Jika Anda ingin pipeline ini melakukan persis seperti yang baru saja Anda baca, Anda perlu menetapkannya terlebih dahulu ke sebuah variabel, misalnya f. Setelah itu, Anda dapat menggunakannya kembali nanti untuk melakukan operasi yang terdapat dalam pipeline pada nilai-nilai lain.
# Unary function
f <- . %>% cos %>% sin
f
structure(function (value)
freduce(value, `_function_list`), class = c("fseq", "function"
))Ingat juga bahwa Anda bisa menambahkan tanda kurung setelah fungsi cos() dan sin() pada baris kode jika ingin meningkatkan keterbacaan. Pertimbangkan contoh yang sama dengan tanda kurung: . %>% cos() %>% sin().
Anda lihat, membangun fungsi di magrittr sangat mirip dengan membangun fungsi dengan base R! Jika Anda tidak yakin seberapa mirip keduanya, periksa baris di atas dan bandingkan dengan baris kode berikut; Keduanya memiliki hasil yang sama!
# is equivalent to
f <- function(.) sin(cos(.))
f
function (.)
sin(cos(.))Ada situasi di mana Anda ingin menimpa nilai sisi kiri, seperti pada contoh tepat di bawah ini. Secara intuitif, Anda akan menggunakan operator penugasan <- untuk melakukannya.
# Load in the Iris data
iris <- read.csv(url("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data"), header = FALSE)
# Add column names to the Iris data
names(iris) <- c("Sepal.Length", "Sepal.Width", "Petal.Length", "Petal.Width", "Species")
# Compute the square root of `iris$Sepal.Length` and assign it to the variable
iris$Sepal.Length <-
iris$Sepal.Length %>%
sqrt()
Namun, ada operator pipe penugasan majemuk, yang memungkinkan Anda menggunakan notasi singkat untuk langsung menugaskan hasil pipeline ke sisi kiri:
# Compute the square root of `iris$Sepal.Length` and assign it to the variable
iris$Sepal.Length %<>% sqrt
# Return `Sepal.Length`
iris$Sepal.Length
Catatan bahwa operator penugasan majemuk %<>% harus menjadi operator pipe pertama dalam rantai agar ini berfungsi. Ini sepenuhnya sejalan dengan yang baru saja Anda baca tentang operator sebagai notasi singkat untuk notasi yang lebih panjang dengan pengulangan, di mana Anda menggunakan operator penugasan biasa <-.
Akibatnya, operator ini akan menugaskan hasil pipeline alih-alih mengembalikannya.
Operator tee bekerja persis seperti %>%, tetapi ia mengembalikan nilai sisi kiri alih-alih potensi hasil operasi di sisi kanan.
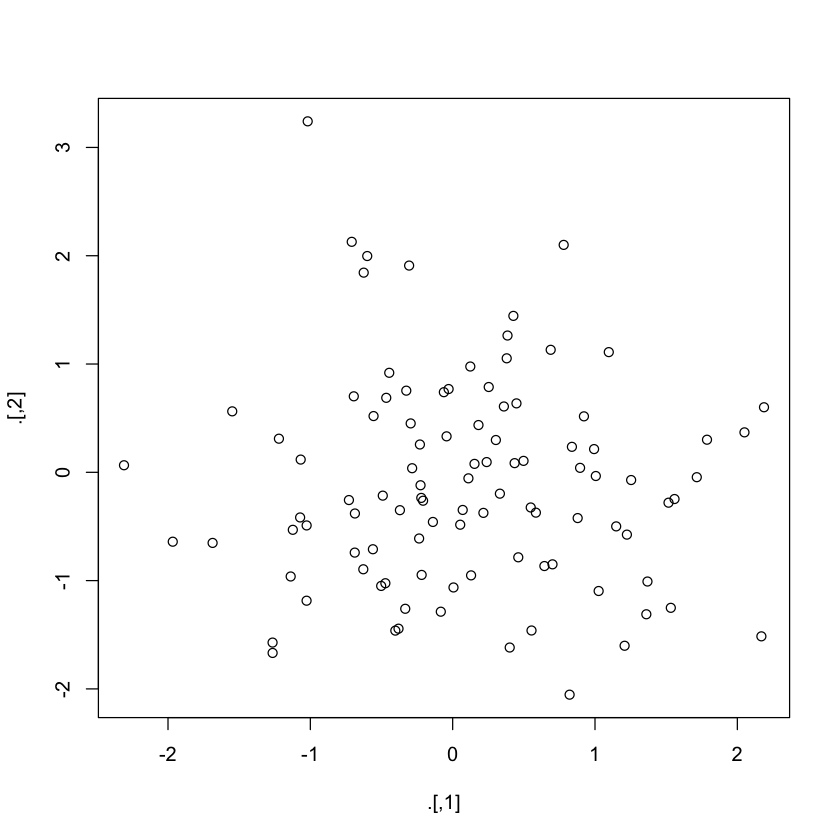
Ini berarti operator tee berguna dalam situasi di mana Anda menyertakan fungsi yang digunakan untuk efek sampingnya, seperti membuat plot dengan plot() atau mencetak ke berkas.
Dengan kata lain, fungsi seperti plot() biasanya tidak mengembalikan apa pun. Itu berarti, setelah memanggil plot(), misalnya, pipeline Anda akan berakhir. Namun, pada contoh berikut, operator tee %T>% memungkinkan Anda melanjutkan pipeline bahkan setelah Anda menggunakan plot():
set.seed(123)
rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
Saat bekerja dengan R, Anda akan mendapati bahwa banyak fungsi menerima argumen data. Pertimbangkan, misalnya, fungsi lm() atau fungsi with(). Fungsi-fungsi ini berguna dalam pipeline di mana data Anda terlebih dahulu diproses lalu diteruskan ke fungsi.
Untuk fungsi yang tidak memiliki argumen data, seperti fungsi cor(), tetap akan berguna jika Anda dapat mengekspos variabel dalam data. Di sinilah operator %$% berperan. Pertimbangkan contoh berikut:
iris %>%
subset(Sepal.Length > mean(Sepal.Length)) %$%
cor(Sepal.Length, Sepal.Width)
0.336696922252551
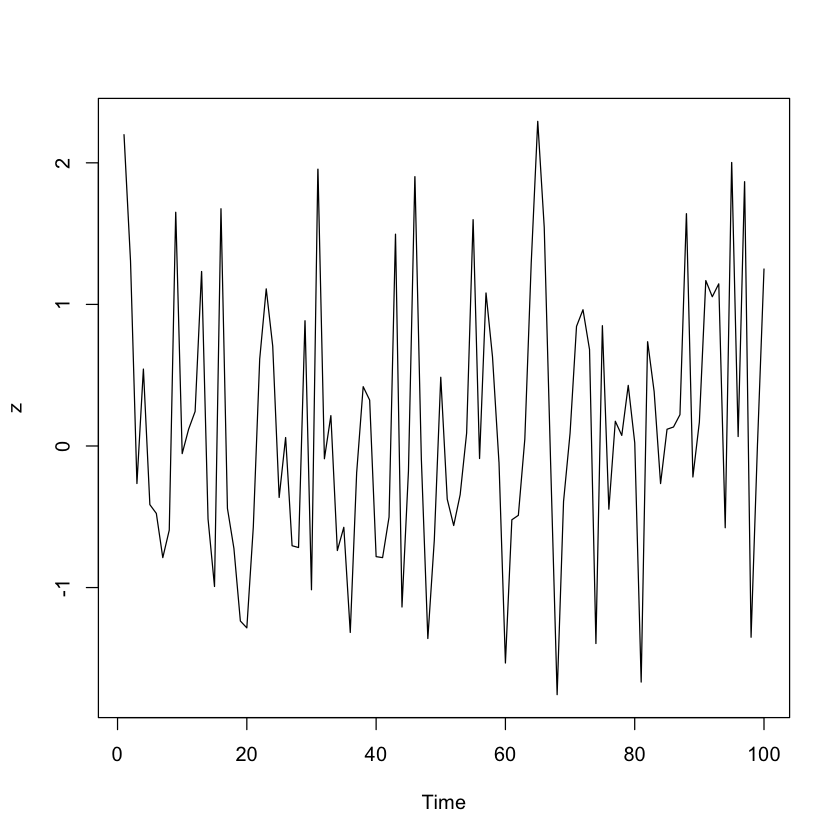
Dengan bantuan %$% Anda memastikan bahwa Sepal.Length dan Sepal.Width diekspos ke cor(). Demikian pula, Anda melihat bahwa data dalam fungsi data.frame() diteruskan ke ts.plot() untuk membuat beberapa deret waktu pada satu plot:
data.frame(z = rnorm(100)) %$%
  ts.plot(z)
dplyr dan magrittrDi pengantar tutorial ini, Anda sudah mengetahui bahwa pengembangan dplyr dan magrittr terjadi pada waktu yang hampir bersamaan, yakni sekitar 2013-2014. Dan, seperti yang Anda baca, paket magrittr juga merupakan bagian dari Tidyverse.
Di bagian ini, Anda akan menemukan betapa menariknya ketika Anda menggabungkan kedua paket tersebut dalam kode R Anda.
Bagi Anda yang baru mengenal paket dplyr, perlu diketahui bahwa paket R ini dibangun di sekitar lima verba, yaitu, "select", "filter", "arrange", "mutate" dan "summarize". Jika Anda sudah pernah memanipulasi data untuk suatu proyek data science, Anda akan tahu bahwa verba-verba ini merupakan mayoritas tugas manipulasi data yang umumnya perlu Anda lakukan pada data Anda.
Ambil contoh kode tradisional yang menggunakan fungsi-fungsi dplyr ini:
library(hflights)

grouped_flights <- group_by(hflights, Year, Month, DayofMonth)
flights_data <- select(grouped_flights, Year:DayofMonth, ArrDelay, DepDelay)
summarized_flights <- summarise(flights_data,
                arr = mean(ArrDelay, na.rm = TRUE),
                dep = mean(DepDelay, na.rm = TRUE))
final_result <- filter(summarized_flights, arr > 30 | dep > 30)

final_result
| Year | Month | DayofMonth | arr | dep |
|---|---|---|---|---|
| 2011 | 2 | 4 | 44.08088 | 47.17216 |
| 2011 | 3 | 3 | 35.12898 | 38.20064 |
| 2011 | 3 | 14 | 46.63830 | 36.13657 |
| 2011 | 4 | 4 | 38.71651 | 27.94915 |
| 2011 | 4 | 25 | 37.79845 | 22.25574 |
| 2011 | 5 | 12 | 69.52046 | 64.52039 |
| 2011 | 5 | 20 | 37.02857 | 26.55090 |
| 2011 | 6 | 22 | 65.51852 | 62.30979 |
| 2011 | 7 | 29 | 29.55755 | 31.86944 |
| 2011 | 9 | 29 | 39.19649 | 32.49528 |
| 2011 | 10 | 9 | 61.90172 | 59.52586 |
| 2011 | 11 | 15 | 43.68134 | 39.23333 |
| 2011 | 12 | 29 | 26.30096 | 30.78855 |
| 2011 | 12 | 31 | 46.48465 | 54.17137 |
Saat Anda melihat contoh ini, Anda langsung memahami mengapa dplyr dan magrittr dapat bekerja sangat baik bersama:
hflights %>%
    group_by(Year, Month, DayofMonth) %>%
    select(Year:DayofMonth, ArrDelay, DepDelay) %>%
    summarise(arr = mean(ArrDelay, na.rm = TRUE), dep = mean(DepDelay, na.rm = TRUE)) %>%
    filter(arr > 30 | dep > 30)
Kedua potongan kode cukup panjang, tetapi Anda bisa berargumen bahwa potongan kode kedua lebih jelas jika Anda ingin mengikuti semua operasinya. Dengan pembuatan variabel antara pada potongan kode pertama, Anda bisa kehilangan "alur" kode. Dengan menggunakan %>%, Anda mendapatkan gambaran yang lebih jelas tentang operasi yang dilakukan pada data!
Singkatnya, dplyr dan magrittr adalah tim impian Anda untuk memanipulasi data di R!
Menambahkan semua pipe ini ke kode R Anda bisa menjadi tugas yang menantang! Untuk mempermudah hidup Anda, John Mount, salah satu pendiri dan Principal Consultant di Win-Vector, LLC serta instruktur DataCamp, telah merilis paket dengan beberapa add-in RStudio yang memungkinkan Anda membuat pintasan keyboard untuk pipe di R. Addin sebenarnya adalah fungsi R dengan sedikit metadata pendaftaran khusus. Contoh addin sederhana, misalnya, bisa berupa fungsi yang menyisipkan potongan teks yang sering digunakan, tetapi juga bisa menjadi sangat kompleks!
Dengan addin ini, Anda akan dapat mengeksekusi fungsi R secara interaktif dari dalam RStudio IDE, baik dengan menggunakan pintasan keyboard maupun melalui menu Addins.
Catatan bahwa paket ini sebenarnya adalah fork dari paket add-in asli RStudio. Hati-hati; dukungan untuk addin hanya tersedia dalam rilis RStudio terbaru! Lihat artikel tentang RStudio addins untuk mempelajari lebih lanjut.
Anda dapat mengunduh add-in dan pintasan keyboardnya dari GitHub.
Di atas, Anda telah melihat bahwa pipe jelas sesuatu yang sebaiknya Anda gunakan saat memprogram dengan R. Lebih spesifik, Anda telah melihatnya dengan membahas beberapa kasus di mana pipe terbukti sangat berguna! Namun, ada beberapa situasi, yang diuraikan oleh Hadley Wickham dalam "R for Data Science", di mana sebaiknya dihindari:
Dalam kasus seperti ini, lebih baik membuat objek antara dengan nama yang bermakna. Ini tidak hanya akan memudahkan Anda men-debug kode, tetapi Anda juga akan lebih memahami kode Anda dan akan lebih mudah bagi orang lain untuk memahaminya.
Jika Anda tidak sedang mentransformasikan satu objek utama, melainkan dua atau lebih objek digabungkan, lebih baik tidak menggunakan pipe.
Pipe pada dasarnya bersifat linear dan mengekspresikan hubungan kompleks dengan pipe hanya akan menghasilkan kode kompleks yang sulit dibaca dan dipahami.
Menggunakan pipe dalam pengembangan paket internal tidak disarankan, karena membuat proses debugging menjadi lebih sulit!
Untuk refleksi lebih lanjut tentang topik ini, lihat diskusi Stack Overflow ini. Situasi lain yang muncul dalam diskusi tersebut adalah loop, dependensi paket, urutan argumen, dan keterbacaan.
Singkatnya, Anda dapat merangkum semuanya sebagai berikut: ingat dua hal yang membuat konstruksi ini begitu hebat, yaitu keterbacaan dan fleksibilitas. Begitu salah satu dari dua keunggulan besar ini terganggu, Anda mungkin mempertimbangkan beberapa alternatif alih-alih pipe.
Setelah semua yang Anda baca, Anda mungkin juga tertarik pada beberapa alternatif yang ada dalam bahasa pemrograman R. Beberapa solusi yang telah Anda lihat dalam tutorial ini adalah sebagai berikut:
Alih-alih merangkaikan semua operasi bersama dan menghasilkan satu hasil tunggal, pecah rantai tersebut dan pastikan Anda menyimpan hasil antara dalam variabel terpisah. Berhati-hatilah dengan penamaan variabel ini: tujuannya selalu untuk membuat kode Anda semudah mungkin untuk dipahami!
Salah satu keberatan yang mungkin Anda miliki terhadap pipe adalah kenyataan bahwa pipe bertentangan dengan "alur" yang Anda biasakan pada base R. Solusinya adalah tetap menggunakan penyusunan kode bersarang! Namun bagaimana jika Anda tidak menyukai pipe, tetapi Anda juga merasa penyusunan bersarang cukup membingungkan? Solusinya di sini adalah menggunakan indentasi untuk menyoroti hierarki.
Anda telah membahas banyak hal dalam tutorial pipe R ini: Anda telah melihat dari mana %>% berasal, apa sebenarnya itu, mengapa Anda harus menggunakannya dan bagaimana Anda harus menggunakannya. Anda telah melihat bahwa paket dplyr dan magrittr bekerja dengan sangat baik bersama-sama, dan bahwa ada lebih banyak operator di luar sana. Terakhir, Anda juga telah melihat beberapa kasus di mana Anda tidak boleh menggunakannya saat memprogram di R dan alternatif apa yang dapat Anda gunakan dalam kasus tersebut.
Jika Anda tertarik mempelajari lebih lanjut tentang Tidyverse, pertimbangkan kursus Introduction to the Tidyverse dari DataCamp.
Kursus R
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



