Ga naar hoofdinhoud

keras: Deep Learning in R

In deze tutorial over deep learning in R met RStudio's keras-pakket leer je een Multi-Layer Perceptron (MLP) bouwen.
Bijgewerkt 7 okt 2026  · 15 min lezen

Verken met AI

ChatGPTClaudePerplexity

Zoals je inmiddels weet, is machine learning een deelgebied binnen Computerwetenschappen (CS). Deep learning is vervolgens een deelgebied van machine learning: een verzameling algoritmes geïnspireerd op de structuur en werking van de hersenen, meestal aangeduid als Artificial Neural Networks (ANN). Deep learning is op dit moment een van de hotste trends binnen machine learning, en er zijn veel problemen waarin deep learning uitblinkt, zoals robotica, beeldherkenning en Artificial Intelligence (AI).

De tutorial van vandaag geeft je een korte introductie tot deep learning in R met Keras via het keras-pakket:

Wil je meer weten over de oorspronkelijke Keras of over kernconcepten in deep learning zoals perceptrons en Multi-Layer Perceptrons (MLP’s)? Overweeg DataCamp’s Deep Learning in Python-cursus of volg de Keras Tutorial: Deep Learning in Python.

Tip: bekijk onze Keras-cheat sheet hier.

Deep Learning in R: Kort overzicht van pakketten

Met de toenemende populariteit van deep learning is CRAN verrijkt met meer R deep learning-pakketten; Hieronder zie je een overzicht van deze pakketten, afkomstig uit de Machine Learning and Statistical Learning CRAN task view. De kolom “Percentile” geeft het percentiel aan zoals te vinden op RDocumentation:

R-pakket Percentiel Beschrijving
nnet 96e Software voor feedforward neurale netwerken met één verborgen laag, en voor multinomiale log-lineaire modellen.
neuralnet 96e Training van neurale netwerken met backpropagation
h2o 95e R-scriptingfunctionaliteit voor H2O
RSNNS 88e Interface naar de Stuttgart Neural Network Simulator (SNNS)
tensorflow 88e Interface naar TensorFlow
deepnet 84e Deep learning-toolkit in R
darch 79e Pakket voor Deep Architectures en Restricted Boltzmann Machines
rnn 73e Pakket om Recurrent Neural Networks (RRN’s) te implementeren
FCNN4R 52e Interface naar de FCNN-bibliotheek die uitbreidbare ANN’s mogelijk maakt
rcppDL 7e Implementatie van basis machine learning-methoden met meerdere lagen (deep learning), inclusief dA (Denoising Autoencoder), SdA (Stacked Denoising Autoencoder), RBM (Restricted Boltzmann Machine) en DBN (Deep Belief Nets)
deepr ??* Pakket om het trainen, fijnstemmen en voorspellen voor deep learning te stroomlijnen op basis van darch en deepnet
MXNetR ??* Pakket dat flexibele en efficiënte GPU-computing en state-of-the-art deep learning naar R brengt

Tip: voor een vergelijking van deep learning-pakketten in R, lees deze blogpost. Voor meer informatie over ranking en score op RDocumentation, bekijk deze blogpost.

Deepr en MXNetR zijn niet gevonden op RDocumentation.org, dus het percentiel voor deze twee pakketten is onbekend.

Keras, keras en kerasR

Onlangs vonden twee nieuwe pakketten hun weg naar de R-community: het kerasR-pakket, gemaakt door Taylor Arnold, en RStudio’s keras-pakket.

Beide pakketten bieden een R-interface naar het Python deep learning-pakket Keras, waar je misschien al van hebt gehoord of zelfs mee hebt gewerkt! Voor wie niet weet wat Keras in Python te bieden heeft: het is “een high-level neural networks API, geschreven in Python en in staat om te draaien bovenop TensorFlow, Microsoft Cognitive Toolkit (CNTK) of Theano”.

Interfaces?

Keras is een van de makkelijkste manieren om vertrouwd te raken met deep learning in Python, en dat verklaart ook waarom de pakketten kerasR en keras een interface bieden voor dit fantastische pakket aan R-gebruikers.

Het is in dit geval goed om te begrijpen wat het precies betekent als een pakket, zoals het R-pakket keras, “een interface” is naar een ander pakket, namelijk het Python-pakket Keras. Simpel gezegd betekent dit dat het R-pakket keras met de interface je laat profiteren van R-programmering, terwijl je toegang hebt tot de mogelijkheden van het Python-pakket Keras.

Let op: dit is niet ongebruikelijk. Zo biedt ook het h2o-pakket een interface, maar in dit geval -en zoals de naam al suggereert- naar H2O, een open-source rekenengine voor big data waarmee je parallel gedistribueerde machine learning-algoritmes kunt uitvoeren. Andere pakketten die je misschien kent en interfaces bieden zijn RWeka (R-interface naar Weka), tensorflow (R-interface naar TensorFlow), openml-r (R-interface naar OpenML), … Je kunt nog wel even doorgaan!

Wat is het verschil tussen Keras, keras en kerasR?

Nu je dit weet, stel je jezelf misschien eerst de volgende vraag: hoe vergelijk je het oorspronkelijke Python-pakket met de R-pakketten?

In essentie zul je niet veel verschillen vinden tussen de R-pakketten en het originele Python-pakket, vooral omdat de functienamen bijna allemaal hetzelfde zijn; De verschillen die je merkt, zitten vooral in de programmeertalen zelf (toekenning van variabelen, libraries laden, …), maar het belangrijkste aandachtspunt is in welke mate de oorspronkelijke functionaliteit is overgenomen in het R-pakket.

Let op: deze opmerking geldt niet alleen voor de keras-bibliotheek, maar ook voor tensorflow, openml-r, … en andere interfacepakketten die hierboven genoemd zijn!

Ten tweede vraag je je misschien af wat dan het verschil is tussen deze twee R-pakketten. Als je wilt vergelijken hoe ze verschillen, kun je de volgende punten overwegen:

  • Het keras-pakket gebruikt de pipe-operator (%>%) om functies of bewerkingen aan elkaar te koppelen, terwijl je dit niet terugziet in kerasR: om je model met kerasR te maken, gebruik je bijvoorbeeld de $-operator. Het gebruik van de pipe-operator verbetert over het algemeen de leesbaarheid van je code, en je hebt deze operator vast al gezien als je eerder met Tidyverse-pakketten hebt gewerkt.

  • Je ziet dat kerasR functies bevat die vergelijkbaar, maar niet exact hetzelfde heten als in het originele Keras-pakket. Zo heet de oorspronkelijke (Python) compile()-functie in kerasR keras_compile(); Hetzelfde geldt voor andere functies, zoals fit(), dat keras_fit() wordt, of predict(), dat keras_predict is wanneer je het kerasR-pakket gebruikt. Dit zijn allemaal custom wrappers.

  • Je zou kunnen stellen dat de installatie van RStudio’s keras-pakket eenvoudiger is dan die van het kerasR-pakket; Voor de installatie van dat laatste moet je eerst configureren welke Python-versie je gebruikt, en dat kan lastig worden als je op een pc werkt met meerdere omgevingen of Python-versies. Maar ik laat het aan jou over om te beslissen :)

data science courses banner

Nu je wat achtergrond hebt, is het tijd om echt te beginnen met Keras in R. Zoals je in de introductie van deze tutorial hebt gelezen, ga je eerst je werkruimte inrichten. Daarna laad je data in en na een korte verkennings- en voorbewerkingsstap kun je je MLP gaan bouwen!

Gaan we!

Het keras-pakket installeren

Zoals altijd is de eerste stap om met een pakket te werken het inrichten van je werkruimte: installeer en laad de library in RStudio of welke omgeving je ook gebruikt.

Geen zorgen, voor deze tutorial wordt het pakket voor je geladen!

Zorg er eerst voor dat je keras installeert: dat kan eenvoudig door devtools::install_github("rstudio/keras") in je console te draaien. Daarna kun je het pakket laden en TensorFlow installeren:

# Load in the keras package
library(keras)

# Install TensorFlow
install_tensorflow()

Als je dit gedaan hebt, ben je good to go! Snel hè?

Tip: voor meer informatie over het installatieproces, bekijk de pakketwebsite.

Data laden

Nu het installatieproces helder is en je werkruimte klaarstaat, kun je data gaan inladen! Op dit punt heb je drie grote opties voor je data: je kunt een van de ingebouwde datasets gebruiken die met het keras-pakket meekomen, je kunt je eigen dataset laden uit bijvoorbeeld CSV-bestanden, of je kunt wat dummydata maken.

In welke situatie je ook zit, je zult zien dat je snel met het pakket aan de slag kunt. In deze sectie lopen we kort de drie opties door en leggen we uit hoe je de data die je nodig hebt kunt laden (of maken) om te beginnen!

Ingebouwde datasets

Als je al wat ervaring hebt met Keras in Python, heb je waarschijnlijk al gebruikgemaakt van de ingebouwde Keras-datasets met functies als mnist.load_data(), cifar10.load_data() of imdb.load_data().

Hieronder enkele voorbeelden waarin je de MNIST-, CIFAR10- en IMDB-data met het keras-pakket inlaadt:

# Read in MNIST data
mnist <- dataset_mnist()

# Read in CIFAR10 data
cifar10 <- dataset_cifar10()

# Read in IMDB data
imdb <- dataset_imdb()

Let op dat alle functies om ingebouwde datasets met keras te laden hetzelfde patroon volgen; Voor MNIST-data gebruik je de dataset_mnist()-functie om je data te laden.

Dummydata

Je kunt ook snel wat dummydata maken om te starten. Dat kan eenvoudig met de matrix()-functie:

eyJsYW5ndWFnZSI6InIiLCJzYW1wbGUiOiIjIE1ha2UgeW91ciBkdW1teSBkYXRhXG5kYXRhIDwtIG1hdHJpeChyZXhwKDEwMDAqNzg0KSwgbnJvdyA9IDEwMDAsIG5jb2wgPSA3ODQpXG5cbiMgTWFrZSBkdW1teSB0YXJnZXQgdmFsdWVzIGZvciB5b3VyIGR1bW15IGRhdGFcbmxhYmVscyA8LSBtYXRyaXgocm91bmQocnVuaWYoMTAwMCoxMCwgbWluID0gMCwgbWF4ID0gOSkpLCBucm93ID0gMTAwMCwgbmNvbCA9IDEwKSJ9

Let op: het is een goed idee om de datastructuur van je data te bekijken; Het is cruciaal om te weten met welke data je werkt, omdat dat later nodig zal zijn. Daar leer je later in de tutorial meer over!

Data uit bestanden lezen

Naast de ingebouwde datasets kun je ook data uit bestanden inladen. In deze tutorial focussen we op data uit CSV-bestanden, maar als je meer wilt weten over importeren in R, bekijk dan DataCamp’s R Data Import Tutorial.

Laten we de read.csv()-functie uit het read.table-pakket gebruiken om een dataset uit de UCI Machine Learning Repository te laden:

eyJsYW5ndWFnZSI6InIiLCJzYW1wbGUiOiIjIFJlYWQgaW4gYGlyaXNgIGRhdGFcbmlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcblxuIyBSZXR1cm4gdGhlIGZpcnN0IHBhcnQgb2YgYGlyaXNgXG5oZWFkKC4uLi4pXG5cbiMgSW5zcGVjdCB0aGUgc3RydWN0dXJlXG5zdHIoLi4uLilcblxuIyBPYnRhaW4gdGhlIGRpbWVuc2lvbnNcbmRpbSguLi4uKSIsInNvbHV0aW9uIjoiIyBSZWFkIGluIGBpcmlzYCBkYXRhXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCBwYXJ0IG9mIGBpcmlzYFxuaGVhZChpcmlzKVxuXG4jIEluc3BlY3QgdGhlIHN0cnVjdHVyZVxuc3RyKGlyaXMpXG5cbiMgT2J0YWluIHRoZSBkaW1lbnNpb25zXG5kaW0oaXJpcykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiRGlkIHlvdSBsb2FkIGluIHRoZSBpcmlzIGRhdGEgY29ycmVjdGx5P1wiXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwiaGVhZFwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwic3RyXCIpICU+JSBjaGVja19yZXN1bHQoKSAlPiUgY2hlY2tfZXF1YWwoKVxuZXgoKSAlPiUgY2hlY2tfZnVuY3Rpb24oXCJkaW1cIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkdyZWF0IGpvYiEgTm93LCBkb2VzIHRoaXMgcmVzdWx0IGNvbmZpcm0geW91ciBpbml0aWFsIGh5cG90aGVzaXMgb2YgYSBwb3NpdGl2ZSBpbmRpY2F0aW9uIGJldHdlZW4gdGhlc2UgdHdvIGF0dHJpYnV0ZXM/XCIpIn0=

Het is altijd verstandig om te controleren of je data-import is geslaagd. Je gebruikt hiervoor meestal functies als head(), str() en dim(), zoals in de DataCamp Light-chunk hierboven.

De resultaten van deze drie functies lijken in eerste instantie niets geks te tonen; Uit de output van str() zie je dat de strings in de kolom Species als factors zijn ingelezen. Dat is geen probleem, maar het is goed om te weten voor de volgende stappen waarin je de data gaat verkennen en voorbewerken.

Data verkennen

Voor deze tutorial werk je verder met de bekende iris-dataset die je met de functie read.csv() hebt ingelezen.

Voor wie de benodigde biologiekennis mist om met deze data te werken, hier wat achtergrond: alle bloemen hebben een kelkblad (sepal) en kroonblad (petal). Het kelkblad omsluit de kroonbladeren en is typisch groen en bladachtig, terwijl de kroonbladeren meestal gekleurde bladeren zijn. Bij irissen is dit net wat anders, zoals je in de volgende afbeelding ziet:

deep learning Python

Je hebt in de vorige sectie misschien al gezien dat het iris-data frame na het importeren geen kolomnamen had. Voor de rest van de tutorial is dat niet heel belangrijk: ook al geeft read.csv() je data terug in een data.frame, de data die je aan de fit()-functie moet doorgeven, moet een matrix of array zijn.

Een paar dingen om te onthouden over de twee genoemde datastructuren: - Matrices en arrays hebben geen kolomnamen; - Matrices zijn tweedimensionale objecten met één datatype; - Arrays zijn meerdimensionale objecten met één datatype;

Tip: bekijk deze video als je de datastructuren in R wilt opfrissen!

Een data frame is daarentegen een speciaal soort benoemde lijst waarin alle elementen dezelfde lengte hebben. Het is een meerdimensionaal object dat meerdere datatypes kan bevatten. Dat zag je al toen je in de vorige sectie de structuur van het iris-data frame bekeek. Gezien dit, en omdat je straks naar een twee- of meerdimensionaal object met één datatype toe moet werken, kun je je alvast voorbereiden op wat voorbewerking voordat je je neurale netwerk gaat bouwen!

Voor nu kunnen kolomnamen handig zijn voor de verkenning, en ze maken het begrijpen van de data zeker makkelijker. Laten we dus wat kolomnamen toevoegen met de names()-functie. Vervolgens kun je de variabele iris meteen gebruiken in je data-exploratie! Plot bijvoorbeeld hoe de petal length en petal width met elkaar correleren met de plot()-functie.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSAiLCJzYW1wbGUiOiJuYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcblxucGxvdChpcmlzJFBldGFsLkxlbmd0aCwgXG4gICAgIGlyaXMkUGV0YWwuV2lkdGgsIFxuICAgICBwY2g9MjEsIGJnPWMoXCJyZWRcIixcImdyZWVuM1wiLFwiYmx1ZVwiKVt1bmNsYXNzKGlyaXMkU3BlY2llcyldLCBcbiAgICAgeGxhYj1cIlBldGFsIExlbmd0aFwiLCBcbiAgICAgeWxhYj1cIlBldGFsIFdpZHRoXCIpIn0=

Let op dat je de unclass()-functie gebruikt om de namen van de soorten, dus “setosa, versicolor” en “virginica”, om te zetten naar de numerieke waarden 1, 2 en 3.

Bekijk nu de output van de plotfunctie eens goed:

plot

De grafiek geeft voor de verschillende soorten irissen een positieve correlatie aan tussen Petal.Length en Petal.Width. Dit wil je waarschijnlijk ook testen met de cor()-functie, die je de totale correlatie geeft tussen alle attributen die in de dataset zijn opgenomen:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6IiMgT3ZlcmFsbCBjb3JyZWxhdGlvbiBiZXR3ZWVuIGBQZXRhbC5MZW5ndGhgIGFuZCBgUGV0YWwuV2lkdGhgIFxuY29yKC4uLi4uLi4uLi4uLi4uLi4uLCBpcmlzJFBldGFsLldpZHRoKSIsInNvbHV0aW9uIjoiIyBPdmVyYWxsIGNvcnJlbGF0aW9uIGJldHdlZW4gYFBldGFsLkxlbmd0aGAgYW5kIGBQZXRhbC5XaWR0aGAgXG5jb3IoaXJpcyRQZXRhbC5MZW5ndGgsIGlyaXMkUGV0YWwuV2lkdGgpIiwic2N0IjoiZXgoKSAlPiUgY2hlY2tfZnVuY3Rpb24oXCJjb3JcIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkdyZWF0IGpvYiEgTm93LCBkb2VzIHRoaXMgcmVzdWx0IGNvbmZpcm0geW91ciBpbml0aWFsIGh5cG90aGVzaXMgb2YgYSBwb3NpdGl2ZSBpbmRpY2F0aW9uIGJldHdlZW4gdGhlc2UgdHdvIGF0dHJpYnV0ZXM/XCIpIn0=

Daarnaast kun je het corrplot-pakket in combinatie met de cor()-functie gebruiken om de correlaties tussen de attributen van je data te plotten; In dit geval bereken je de totale correlatie voor alle attributen van het iris-data frame. Je slaat het resultaat op in variabele M en geeft die door aan de corrplot()-functie.

Vergeet niet een method-argument te specificeren om aan te geven hoe je de data wilt plotten!

Je kunt verder experimenteren met de visualisatiemethode in de DataCamp Light-chunk hieronder:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoY29ycnBsb3QpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIikiLCJzYW1wbGUiOiIjIFN0b3JlIHRoZSBvdmVyYWxsIGNvcnJlbGF0aW9uIGluIGBNYFxuTSA8LSBjb3IoaXJpc1ssMTo0XSlcblxuIyBQbG90IHRoZSBjb3JyZWxhdGlvbiBwbG90IHdpdGggYE1gXG5jb3JycGxvdChNLCBtZXRob2Q9XCJjaXJjbGVcIikifQ==

chart

Gebruik de R-console om je data verder te verkennen.

Als je grafieken voor deze data wilt maken met het ggvis-pakket, de interactieve grammar of graphics, bekijk dan DataCamp’s tutorial Machine Learning in R For Beginners of volg DataCamp’s ggvis-cursus.

Data voorbewerken

Voordat je je model kunt bouwen, moet je er ook voor zorgen dat je data opgeschoond is, genormaliseerd (indien van toepassing) en verdeeld in trainings- en testsets. Omdat de dataset uit de UCI Machine Learning Repository komt, kun je verwachten dat deze al enigszins schoon is, maar laten we de kwaliteit van je data toch even dubbelchecken.

Op het eerste gezicht zag je bij head() niet echt iets bijzonders, toch? Gebruik summary() en str() om kort te herhalen wat je leerde toen je controleerde of je import gelukt was:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6IiMgUHVsbCB1cCBhIHN1bW1hcnkgb2YgYGlyaXNgXG5zdW1tYXJ5KC4uLi4pXG5cbiMgSW5zcGVjdCB0aGUgc3RydWN0dXJlIG9mIGBpcmlzYFxuc3RyKC4uLi4pIiwic29sdXRpb24iOiIjIFB1bGwgdXAgYSBzdW1tYXJ5IG9mIGBpcmlzYFxuc3VtbWFyeShpcmlzKVxuXG4jIEluc3BlY3QgdGhlIHN0cnVjdHVyZSBvZiBgaXJpc2BcbnN0cihpcmlzKSIsInNjdCI6ImV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwic3VtbWFyeVwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwic3RyXCIpICU+JSBjaGVja19yZXN1bHQoKSAlPiUgY2hlY2tfZXF1YWwoKVxuc3VjY2Vzc19tc2coXCJHb29kIGpvYiEgTm93LCB3aGF0IGRvIHlvdSBsZWFybiBmcm9tIHRoZSBvdXRwdXQgb2YgdGhlc2UgbGluZXMgb2YgY29kZT9cIikifQ==

Nu je zeker weet dat de data schoon genoeg is, kun je controleren of normalisatie nodig is voor de data waarmee je in deze tutorial werkt.

Je data normaliseren met een User Defined Function (UDF)

Uit het resultaat van summary() in de DataCamp Light-chunk hierboven zie je dat de iris-dataset niet genormaliseerd hoeft te worden: het attribuut Sepal.Length heeft waarden van 4.3 tot 7.9 en Sepal.Width bevat waarden van 2 tot 4.4, terwijl Petal.Length loopt van 1 tot 6.9 en Petal.Width van 0.1 tot 2.5. Met andere woorden, alle waarden van alle attributen van de iris-dataset liggen tussen 0.1 en 7.9, wat je acceptabel kunt vinden.

Toch kan het zinvol zijn om het effect van normalisatie op je data te bestuderen; Je kunt zelfs zo ver gaan dat je de genormaliseerde data aan je model doorgeeft om te zien of er effect is. Dit valt buiten de scope van deze tutorial, maar probeer het vooral zelf! De code staat allemaal hier :)

Je kunt je eigen functie maken om de iris-data te normaliseren; In dit geval een min-max-normalisatie, die je data lineair transformeert naar de functie (x-min)/(max-min). Vanuit dat perspectief is het vertalen van deze formule naar R vrij eenvoudig: je maakt een functie waaraan je x of wat data doorgeeft. Je berekent dan x-min en slaat het resultaat op in num. Vervolgens bereken je max-min en sla je het resultaat op in denom. De uitkomst van je normalize()-functie moet de deling van num door max teruggeven.

Om deze user-defined functie op je iris-data toe te passen (doelwaarden uitgezonderd), gebruik je niet alleen normalize, maar ook de lapply()-functie om de data te normaliseren, zoals hieronder:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6IiMgQnVpbGQgeW91ciBvd24gYG5vcm1hbGl6ZSgpYCBmdW5jdGlvblxubm9ybWFsaXplIDwtIGZ1bmN0aW9uKHgpIHtcbiAgbnVtIDwtIHggLSBtaW4oeClcbiAgZGVub20gPC0gbWF4KHgpIC0gbWluKHgpXG4gIHJldHVybiAobnVtL2Rlbm9tKVxufVxuXG4jIE5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGFcbmlyaXNfbm9ybSA8LSBhcy5kYXRhLmZyYW1lKGxhcHBseShpcmlzWzE6NF0sIC4uLi4uLi4uLikpXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCBwYXJ0IG9mIGBpcmlzYCBcbmhlYWQoLi4uLikiLCJzb2x1dGlvbiI6IiMgQnVpbGQgeW91ciBvd24gYG5vcm1hbGl6ZSgpYCBmdW5jdGlvblxubm9ybWFsaXplIDwtIGZ1bmN0aW9uKHgpIHtcbiAgbnVtIDwtIHggLSBtaW4oeClcbiAgZGVub20gPC0gbWF4KHgpIC0gbWluKHgpXG4gIHJldHVybiAobnVtL2Rlbm9tKVxufVxuXG4jIE5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGFcbmlyaXNfbm9ybSA8LSBhcy5kYXRhLmZyYW1lKGxhcHBseShpcmlzWzE6NF0sIG5vcm1hbGl6ZSkpXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCBwYXJ0IG9mIGBpcmlzYCBcbmhlYWQoaXJpcykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiTWFrZSBzdXJlIHRvIGRlZmluZSBhIHZhcmlhYmxlIGBpcmlzX25vcm1gLlwiXG5tc2dfaW5jb3JyZWN0IDwtIFwiTWFrZSBzdXJlIHRoYXQgeW91IGFzc2lnbiB0aGUgY29ycmVjdCB2YWx1ZSB0byBgaXJpc19ub3JtYC5cIlxuXG5mdW5fZGVmIDwtIGV4KCkgJT4lIGNoZWNrX2Z1bl9kZWYoXCJub3JtYWxpemVcIilcbmZ1bl9kZWYgJT4lIGNoZWNrX2JvZHkoKVxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpcmlzX25vcm0nLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX2Z1bmN0aW9uKFwiaGVhZFwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbnN1Y2Nlc3NfbXNnKFwiV2VsbCBkb25lISBOb3cgeW91IGNhbiBtb3ZlIG9uIHRvIHNlZSBob3cgeW91IGNhbiBub3JtYWxpemUgeW91ciBkYXRhIHdpdGgga2VyYXMhXCIpIn0=

Tip gebruik de hist()-functie in de R-console om de verdeling van de iris-data vóór (iris) en na de normalisatie (iris_norm) te bestuderen.

Je data normaliseren met keras

Om de normalize()-functie uit het keras-pakket te gebruiken, moet je er eerst voor zorgen dat je met een matrix werkt. Zoals je je herinnert, is een kenmerk van matrices dat de elementen van hetzelfde basistype zijn; In dit geval heb je doelwaarden van het type factor, terwijl de rest numeriek is.

Dat moet eerst worden aangepast.

Je kunt de as.numeric()-functie gebruiken om de data naar getallen om te zetten:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImlyaXMgPC0gcmVhZC5jc3YodXJsKFwiaHR0cDovL2FyY2hpdmUuaWNzLnVjaS5lZHUvbWwvbWFjaGluZS1sZWFybmluZy1kYXRhYmFzZXMvaXJpcy9pcmlzLmRhdGFcIiksIGhlYWRlciA9IEZBTFNFKSBcbm5hbWVzKGlyaXMpIDwtIGMoXCJTZXBhbC5MZW5ndGhcIiwgXCJTZXBhbC5XaWR0aFwiLCBcIlBldGFsLkxlbmd0aFwiLCBcIlBldGFsLldpZHRoXCIsIFwiU3BlY2llc1wiKSIsInNhbXBsZSI6ImlyaXNbLDVdIDwtIC4uLi4uLi4uLi4uKGlyaXNbLDVdKSAtMVxuXG4jIFR1cm4gYGlyaXNgIGludG8gYSBtYXRyaXhcbmlyaXMgPC0gYXMubWF0cml4KGlyaXMpXG5cbiMgU2V0IGBpcmlzYCBgZGltbmFtZXNgIHRvIGBOVUxMYFxuZGltbmFtZXMoLi4uLikgPC0gTlVMTCIsInNvbHV0aW9uIjoiaXJpc1ssNV0gPC0gYXMubnVtZXJpYyhpcmlzWyw1XSkgLTFcblxuIyBUdXJuIGBpcmlzYCBpbnRvIGEgbWF0cml4XG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuXG4jIFNldCBpcmlzIGBkaW1uYW1lc2AgdG8gYE5VTExgXG5kaW1uYW1lcyhpcmlzKSA8LSBOVUxMIiwic2N0IjoibXNnX3VuZGVmaW5lZCA8LSBcIkRpZCB5b3UgdXNlIGBhcy5udW1lcmljKClgIHRvIGNvbnZlcnQgYGlyaXNbLDVdYCB0byBudW1lcmljP1wiXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbm1zZ191bmRlZmluZWQyIDwtIFwiRGlkIHlvdSB1c2UgYGFzLm1hdHJpeGAgdG8gY29udmVydCBgaXJpc2AgdG8gYSBtYXRyaXg/XCJcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnaXJpcycsIG1zZ191bmRlZmluZWQyKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZDIpXG5leCgpICU+JSBjaGVja19mdW5jdGlvbihcImRpbW5hbWVzXCIpICU+JSBjaGVja19yZXN1bHQoKSAlPiUgY2hlY2tfZXF1YWwoKVxuc3VjY2Vzc19tc2coXCJBd2Vzb21lIVwiKSJ9

Een numeriek data frame is prima, maar je moet de data omzetten naar een array of matrix als je het keras-pakket wilt gebruiken. Dat kan eenvoudig met de as.matrix()-functie; Vergeet niet de dimnames op NULL te zetten.

Zoals je hierboven kon lezen, is normaliseren van de iris-data niet nodig. Toch is het nog steeds een goed idee om normalisatie en het effect ervan te bestuderen, en te zien hoe je dit niet alleen met een UDF doet, maar ook met de ingebouwde normalize()-functie van keras.

Met je data omgezet naar een matrix kun je inderdaad ook het keras-pakket gebruiken om het effect van een mogelijke normalisatie op je data te bestuderen:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoa2VyYXMpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcbmlyaXNbLDVdIDwtIGFzLm51bWVyaWMoaXJpc1ssNV0pIC0xXG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuZGltbmFtZXMoaXJpcykgPC0gTlVMTCIsInNhbXBsZSI6IiMgTm9ybWFsaXplIHRoZSBgaXJpc2AgZGF0YVxuaXJpcyA8LSBub3JtYWxpemUoLi4uLlssMTo0XSlcblxuIyBSZXR1cm4gdGhlIHN1bW1hcnkgb2YgYGlyaXNgXG5zdW1tYXJ5KC4uLi4pIiwic29sdXRpb24iOiIjIE5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGFcbmlyaXMgPC0gbm9ybWFsaXplKGlyaXNbLDE6NF0pXG5cbiMgUmV0dXJuIHRoZSBzdW1tYXJ5IG9mIGBpcmlzYFxuc3VtbWFyeShpcmlzKSIsInNjdCI6Im1zZ191bmRlZmluZWQgPC0gXCJEaWQgeW91IG5vcm1hbGl6ZSB0aGUgYGlyaXNgIGRhdGE/XCJcbmV4KCkgJT4lIGNoZWNrX29iamVjdChcImlyaXNcIiwgbXNnX3VuZGVmaW5lZCkgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQpXG5leCgpICU+JSBjaGVja19mdW5jdGlvbihcInN1bW1hcnlcIikgJT4lIGNoZWNrX3Jlc3VsdCgpICU+JSBjaGVja19lcXVhbCgpXG5zdWNjZXNzX21zZyhcIkF3ZXNvbWUhIE5vdywgaG93IGRvZXMgdGhpcyBzdW1tYXJ5IGNvbXBhcmUgdG8gdGhlIHByZXZpb3VzIHN1bW1hcnkgdGhhdCB5b3UgcmV0cmlldmVkIGluIHRoZSBEYXRhQ2FtcCBMaWdodCBjaHVuayBhYm92ZT9cIikifQ==

Let op dat je hier dimnames() gebruikt om de dimnames van iris op NULL te zetten. Zo zorg je dat er geen kolomnamen in je data staan.

Training- en testsets

Nu je de kwaliteit van je data hebt gecontroleerd en weet dat normaliseren niet nodig is, kun je met de originele data verder en deze splitsen in trainings- en testsets, zodat je eindelijk je model kunt gaan bouwen. Zo zorg je ervoor dat je achteraf een eerlijke beoordeling van de prestaties van je voorspelde model kunt maken.

Voordat je je data splitst in trainings- en testsets, zet je het best eerst een seed. Dat kan eenvoudig met set.seed(): gebruik deze functie en geef er een willekeurig geheel getal aan door. Een seed is een getal voor R’s willekeurige getallengenerator. Het grote voordeel is dat je dezelfde reeks willekeurige getallen kunt krijgen wanneer je dezelfde seed gebruikt in de generator.

Goed voor de reproduceerbaarheid van je code!

Je gebruikt de sample()-functie om een steekproef te nemen met een grootte die gelijk is aan het aantal rijen van de iris-dataset, dus 150. Je samplet met terugleggen: je kiest uit een vector van 2 elementen en wijst 1 of 2 toe aan de 150 rijen van de iris-dataset. De toewijzing is onderhevig aan kansgewichten van 0.67 en 0.33.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV0iLCJzYW1wbGUiOiIjIERldGVybWluZSBzYW1wbGUgc2l6ZVxuaW5kIDwtIHNhbXBsZSgyLCBucm93KGlyaXMpLCByZXBsYWNlPVRSVUUsIHByb2I9YygwLjY3LCAwLjMzKSlcblxuIyBTcGxpdCB0aGUgYGlyaXNgIGRhdGFcbmlyaXMudHJhaW5pbmcgPC0gaXJpc1tpbmQ9PTEsIDE6NF1cbmlyaXMudGVzdCA8LSBpcmlzW2luZD09MiwgMTo0XVxuXG4jIFNwbGl0IHRoZSBjbGFzcyBhdHRyaWJ1dGVcbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsIDVdXG5pcmlzLnRlc3R0YXJnZXQgPC0gaXJpc1tpbmQ9PTIsIDVdIiwic2N0IjoibXNnX3VuZGVmaW5lZCA8LSBcIkRpZCB5b3UgZGVmaW5lIGBpbmRgP1wiXG5tc2dfdW5kZWZpbmVkMSA8LSBcIkRpZCB5b3Ugc3BsaXQgdGhlIGBpcmlzYCBkYXRhIGludG8gYSB0cmFpbmluZyBzZXQ/XCJcbm1zZ191bmRlZmluZWQyIDwtIFwiRGlkIHlvdSBzcGxpdCB0aGUgYGlyaXNgIGRhdGEgaW50byBhIHRlc3Qgc2V0P1wiXG5tc2dfdW5kZWZpbmVkMyA8LSBcIkRpZCB5b3UgaXNvbGF0ZSB0aGUgYGlyaXNgIHRyYWluaW5nIGxhYmVscz9cIlxubXNnX3VuZGVmaW5lZDQgPC0gXCJEaWQgeW91IGlzb2xhdGUgdGhlIGBpcmlzYCB0ZXN0IGxhYmVscz9cIlxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpbmQnLCBtc2dfdW5kZWZpbmVkKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZClcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnaXJpcy50cmFpbmluZycsIG1zZ191bmRlZmluZWQxKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZDEpXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMudGVzdCcsIG1zZ191bmRlZmluZWQyKSAlPiUgY2hlY2tfZXF1YWwobXNnX3VuZGVmaW5lZDIpXG5leCgpICU+JSBjaGVja19vYmplY3QoJ2lyaXMudHJhaW5pbmd0YXJnZXQnLCBtc2dfdW5kZWZpbmVkMykgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQzKVxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpcmlzLnRlc3R0YXJnZXQnLCBtc2dfdW5kZWZpbmVkNCkgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQ0KVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhIElmIHlvdSB3YW50LCBtYWtlIHVzZSBvZiB0aGUgUiBjb25zb2xlIHRvIGNoZWNrIG91dCB5b3VyIG5ld2x5IGNyZWF0ZWQgdHJhaW5pbmcgYW5kIHRlc3Qgc2V0cyFcIikifQ==

Het argument replace van de sample()-functie staat op TRUE, wat betekent dat je een 1 of 2 toewijst aan een bepaalde rij en daarna de vector van 2 terugzet naar de oorspronkelijke staat.

Met andere woorden: voor de volgende rijen in je dataset kun je telkens opnieuw een 1 of 2 toewijzen. De kans om 1 of 2 te kiezen moet niet evenredig zijn met de gewichten van de resterende items, dus je specificeert kansgewichten.

Terzijde: als je een ingebouwde dataset met bijvoorbeeld dataset_imdb() had gebruikt, kun je je data eenvoudig splitsen met de $-operator:

x_train <- imdb$train$x
y_train <- imdb$train$y
x_test <- imdb$test$x
y_test <- imdb$test$y

One-hot encoding

Je hebt je data succesvol gesplitst, maar er is nog één stap voordat je je model kunt gaan bouwen. Kun je raden welke?

Als je multiclass-classificatieproblemen met neurale netwerken wilt modelleren, is het doorgaans goed om je doelattribuut te transformeren van een vector met klasselabels naar een matrix met voor elke klasse een booleaanse waarde die aangeeft of een instantie die klasse heeft of niet.

Dit is een losse uitleg van One-Hot Encoding (OHE). Klinkt best complex, toch?

Gelukkig heeft het keras-pakket een to_categorical()-functie die dit voor je doet; Geef iris.trainingtarget en iris.testtarget door aan deze functie en sla het resultaat op in iris.trainLabels en iris.testLabels:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV0iLCJzYW1wbGUiOiIjIE9uZSBob3QgZW5jb2RlIHRyYWluaW5nIHRhcmdldCB2YWx1ZXNcbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoLi4uLi4uLi4uLi4uLi4uLi4uKVxuXG4jIE9uZSBob3QgZW5jb2RlIHRlc3QgdGFyZ2V0IHZhbHVlc1xuaXJpcy50ZXN0TGFiZWxzIDwtIHRvX2NhdGVnb3JpY2FsKC4uLi4uLi4uLi4uLi4uLilcblxuIyBQcmludCBvdXQgdGhlIGlyaXMudGVzdExhYmVscyB0byBkb3VibGUgY2hlY2sgdGhlIHJlc3VsdFxucHJpbnQoLi4uLi4uLi4uLi4uLikiLCJzb2x1dGlvbiI6IiMgT25lIGhvdCBlbmNvZGUgdHJhaW5pbmcgdGFyZ2V0IHZhbHVlc1xuaXJpcy50cmFpbkxhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRyYWluaW5ndGFyZ2V0KVxuXG4jIE9uZSBob3QgZW5jb2RlIHRlc3QgdGFyZ2V0IHZhbHVlc1xuaXJpcy50ZXN0TGFiZWxzIDwtIHRvX2NhdGVnb3JpY2FsKGlyaXMudGVzdHRhcmdldClcblxuIyBQcmludCBvdXQgdGhlIGlyaXMudGVzdExhYmVscyB0byBkb3VibGUgY2hlY2sgdGhlIHJlc3VsdFxucHJpbnQoaXJpcy50ZXN0TGFiZWxzKSIsInNjdCI6Im1zZ191bmRlZmluZWQgPC0gXCJEaWQgeW91IHBhc3MgYGlyaXMudHJhaW5pbmd0YXJnZXRgIHRvIHRoZSBgdG9fY2F0ZWdvcmljYWwoKWAgZnVuY3Rpb24/XCJcbm1zZ191bmRlZmluZWQyIDwtIFwiRGlkIHlvdSBwYXNzIGBpcmlzLnRlc3R0YXJnZXRgIHRvIHRoZSBgdG9fY2F0ZWdvcmljYWwoKWAgZnVuY3Rpb24/XCJcbmV4KCkgJT4lIGNoZWNrX29iamVjdCgnaXJpcy50cmFpbkxhYmVscycsIG1zZ191bmRlZmluZWQpICU+JSBjaGVja19lcXVhbChtc2dfdW5kZWZpbmVkKVxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdpcmlzLnRlc3RMYWJlbHMnLCBtc2dfdW5kZWZpbmVkMikgJT4lIGNoZWNrX2VxdWFsKG1zZ191bmRlZmluZWQyKVxuZXgoKSAlPiUgY2hlY2tfZnVuY3Rpb24oXCJwcmludFwiKSAlPiUgY2hlY2tfcmVzdWx0KCkgJT4lIGNoZWNrX2VxdWFsKClcbnN1Y2Nlc3NfbXNnKFwiR29vZCBqb2IhIERvdWJsZSBjaGVjayB0aGUgcHJpbnQtb3V0IG9mIGBpcmlzLnRlc3RMYWJlbHNgIHRvIHNlZSBob3cgb25lLWhvdCBlbmNvZGluZyB3b3JrcyFcIikifQ==

Nu ben je officieel aan het einde gekomen van de verkennings- en voorbewerkingsstappen in deze tutorial. Je kunt nu verder met het bouwen van je neurale netwerk met keras!

Het model construeren

Om een model te bouwen, initialiseer je eerst een sequentieel model met behulp van de functie keras_model_sequential(). Daarna kun je gaan modelleren.

Het is echter een goed idee om eerst nog even terug te gaan naar je oorspronkelijke vraag bij deze dataset: kun je de soort van een bepaalde irisbloem voorspellen? Werken met numerieke data is eenvoudiger, en je hebt de data voorbewerkt en de doelvariabele one-hot gecodeerd: een bloem is ofwel versicolor, setosa of virginica, en dat wordt weergegeven met binaire 1- en 0-waarden.

Een type netwerk dat goed presteert op zo’n probleem is een multi-layer perceptron. Dit type neuraal netwerk is vaak volledig verbonden. Dat betekent dat je een relatief eenvoudige stapel fully connected-lagen gaat bouwen om dit probleem op te lossen. Wat betreft de activatiefuncties, gebruik je hier het best een van de meest gangbare om vertrouwd te raken met Keras en neurale netwerken: de relu-activatie. Deze rectifier-activatie gebruik je in een verborgen laag, wat doorgaans een goede praktijk is.

Daarnaast zie je dat de softmax-activatie wordt gebruikt in de outputlaag. Dat doe je omdat je zeker wilt zijn dat de outputwaarden tussen 0 en 1 liggen en als voorspelde kansen gebruikt kunnen worden:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIGEgc2VxdWVudGlhbCBtb2RlbFxubW9kZWwgPC0gLi4uLi4uLi4uLi4uLi4uLi4uLi4uLlxuXG4jIEFkZCBsYXllcnMgdG8gdGhlIG1vZGVsXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpIiwic29sdXRpb24iOiIjIEluaXRpYWxpemUgYSBzZXF1ZW50aWFsIG1vZGVsXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5cbiMgQWRkIGxheWVycyB0byB0aGUgbW9kZWxcbm1vZGVsICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDgsIGFjdGl2YXRpb24gPSAncmVsdScsIGlucHV0X3NoYXBlID0gYyg0KSkgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMywgYWN0aXZhdGlvbiA9ICdzb2Z0bWF4JykiLCJzY3QiOiJtc2dfdW5kZWZpbmVkIDwtIFwiRGlkIHlvdSBpbml0aWFsaXplIGEgc2VxdWVudGlhbCBtb2RlbCB3aXRoIHRoZSBoZWxwIG9mIGBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKClgP1wiXG5tc2dfaW5jb3JyZWN0IDwtIFwiRGlkIHlvdSBrZWVwIHRoZSBwcmVkZWZpbmVkIGxheWVycz9cIlxuZXgoKSAlPiUgY2hlY2tfb2JqZWN0KCdtb2RlbCcsIG1zZ191bmRlZmluZWQpICU+JSBjaGVja19lcXVhbChtc2dfaW5jb3JyZWN0KVxuc3VjY2Vzc19tc2coXCJHb29kIGpvYiEgWW91IGhhdmUgc3VjY2Vzc2Z1bGx5IGNvbnN0cnVjdGVkIGEgbW9kZWwgd2l0aCB0aGUgYGtlcmFzYCBwYWNrYWdlIGluIFIhXCIpIn0=

Let op hoe de outputlaag 3 outputwaarden maakt, één voor elke iris-klasse (versicolor, virginica of setosa). De eerste laag, met 8 verborgen nodes, heeft daarentegen een input_shape van 4. Dat komt omdat je trainingsdata iris.training 4 kolommen heeft.

Je kunt je model verder inspecteren met de volgende functies:

  • Met de summary()-functie kun je een samenvattende weergave van je model printen;
  • get_config() geeft een lijst terug met de configuratie van het model;
  • get_layer() geeft de configuratie van de laag terug.
  • De eigenschap layers kun je gebruiken om een vlakke lijst van de lagen van het model op te halen;
  • Om de input-tensors te lijsten, gebruik je de eigenschap inputs; en
  • Tot slot kun je met de eigenschap outputs de output-tensors ophalen.
eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpIiwic2FtcGxlIjoiIyBQcmludCBhIHN1bW1hcnkgb2YgYSBtb2RlbFxuc3VtbWFyeShtb2RlbClcblxuIyBHZXQgbW9kZWwgY29uZmlndXJhdGlvblxuZ2V0X2NvbmZpZyhtb2RlbClcblxuIyBHZXQgbGF5ZXIgY29uZmlndXJhdGlvblxuZ2V0X2xheWVyKG1vZGVsLCBpbmRleCA9IDEpXG5cbiMgTGlzdCB0aGUgbW9kZWwncyBsYXllcnNcbm1vZGVsJGxheWVyc1xuXG4jIExpc3QgdGhlIGlucHV0IHRlbnNvcnNcbm1vZGVsJGlucHV0c1xuXG4jIExpc3QgdGhlIG91dHB1dCB0ZW5zb3JzXG5tb2RlbCRvdXRwdXRzIn0=

Het model compileren en fitten

Nu je de architectuur van je model hebt opgezet, is het tijd om het model te compileren en te fitten op de data. Om je model te compileren, configureer je het met de adam-optimizer en de loss-functie categorical_crossentropy. Daarnaast monitor je de nauwkeurigheid tijdens het trainen door 'accuracy' door te geven aan het metrics-argument.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpIiwic2FtcGxlIjoiIyBDb21waWxlIHRoZSBtb2RlbFxubW9kZWwgJT4lIGNvbXBpbGUoXG4gICAgIGxvc3MgPSAnY2F0ZWdvcmljYWxfY3Jvc3NlbnRyb3B5JyxcbiAgICAgb3B0aW1pemVyID0gJ2FkYW0nLFxuICAgICBtZXRyaWNzID0gJ2FjY3VyYWN5J1xuICkifQ==

De optimizer en de loss zijn twee vereiste argumenten als je het model wilt compileren.

Enkele van de meest populaire optimalisatie-algoritmes zijn Stochastic Gradient Descent (SGD), ADAM en RMSprop. Afhankelijk van welk algoritme je kiest, moet je bepaalde parameters afstemmen, zoals learning rate of momentum. De keuze voor een loss-functie hangt af van je taak: voor een regressieprobleem gebruik je bijvoorbeeld meestal de Mean Squared Error (MSE).

Zoals je in dit voorbeeld ziet, gebruik je de loss-functie categorical_crossentropy voor het multiclass-classificatieprobleem om te bepalen of een iris versicolor, virginica of setosa is. Als je echter een binaire classificatie had, dan had je binary_crossentropy moeten gebruiken.

Vervolgens kun je het model fitten op je data; In dit geval train je het model 200 epochs of iteraties over alle samples in iris.training en iris.trainLabels, in batches van 5 samples.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKSIsInNhbXBsZSI6IiMgRml0IHRoZSBtb2RlbCBcbm1vZGVsICU+JSBmaXQoXG4gICAgIGlyaXMudHJhaW5pbmcsIFxuICAgICBpcmlzLnRyYWluTGFiZWxzLCBcbiAgICAgZXBvY2hzID0gMjAwLCBcbiAgICAgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSJ9

Tip: als je wilt, kun je ook het verbose-argument in de fit()-functie opgeven. Door dit argument op 1 te zetten, geef je aan dat je de voortgangsbalk wilt zien.

Wat je hierboven doet, is het model trainen voor een bepaald aantal epochs of exposities aan de trainingsdataset. Een epoch is één keer door de volledige trainingsset, gevolgd door testen op de validatieset. De batchgrootte die je hierboven specificeert, bepaalt het aantal samples dat door het netwerk gaat. Ook optimaliseer je hiermee de efficiëntie, omdat je ervoor zorgt dat je niet te veel inputpatronen tegelijk in het geheugen laadt.

De trainingsgeschiedenis van het model visualiseren

Het is ook goed om te weten dat je de fitting kunt visualiseren als je de code uit de DataCamp Light-chunk hierboven aan een variabele toekent. Je kunt de variabele vervolgens doorgeven aan de plot()-functie, zoals je in deze code-chunk ziet!

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKSIsInNhbXBsZSI6IiMgU3RvcmUgdGhlIGZpdHRpbmcgaGlzdG9yeSBpbiBgaGlzdG9yeWAgXG5oaXN0b3J5IDwtIG1vZGVsICU+JSBmaXQoXG4gICAgIGlyaXMudHJhaW5pbmcsIFxuICAgICBpcmlzLnRyYWluTGFiZWxzLCBcbiAgICAgZXBvY2hzID0gMjAwLFxuICAgICBiYXRjaF9zaXplID0gNSwgXG4gICAgIHZhbGlkYXRpb25fc3BsaXQgPSAwLjJcbiApXG5cbiMgUGxvdCB0aGUgaGlzdG9yeVxucGxvdChoaXN0b3J5KSJ9

Bestudeer de plot in meer detail.

plot

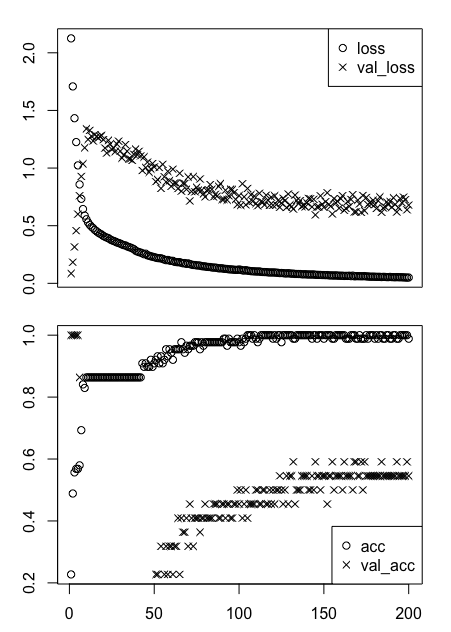
Op het eerste gezicht is het niet verrassend dat dit er wat rommelig uitziet. Je weet misschien niet precies waar je naar kijkt, toch?

Een goed ding om te weten: loss en acc geven respectievelijk het verlies en de nauwkeurigheid van het model voor de trainingsdata aan, terwijl val_loss en val_acc dezelfde metrics zijn voor de test- of validatiedata.

Maar zelfs als je dit weet, zijn deze twee grafieken niet eenvoudig te interpreteren. Laten we dit opsplitsen in delen die je makkelijker begrijpt! Je splitst de twee plots en maakt er twee losse van: één voor het modelverlies en één voor de modelnauwkeurigheid. Gelukkig kun je eenvoudig gebruikmaken van de $-operator om de data te benaderen en stap voor stap te plotten.

Bekijk de DataCamp Light-box hieronder om te zien hoe je dit doet:
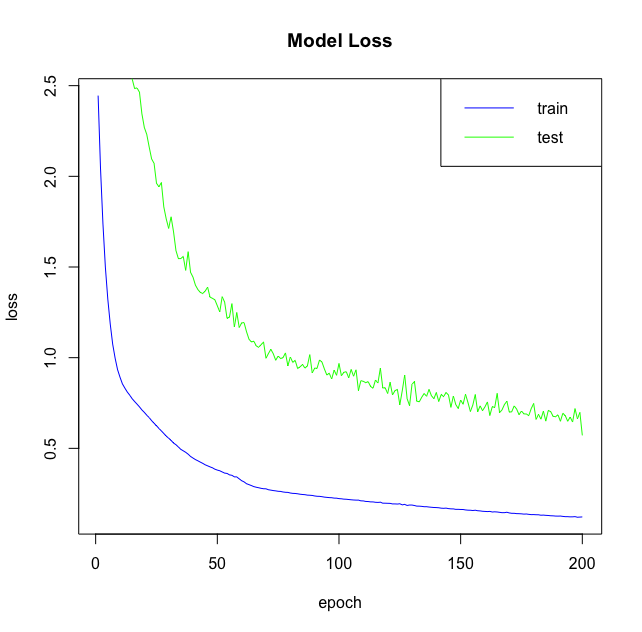
eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuaGlzdG9yeSA8LSBtb2RlbCAlPiUgZml0KFxuICAgICBpcmlzLnRyYWluaW5nLCBcbiAgICAgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCxcbiAgICAgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgUGxvdCB0aGUgbW9kZWwgbG9zcyBvZiB0aGUgdHJhaW5pbmcgZGF0YVxucGxvdChoaXN0b3J5JG1ldHJpY3MkbG9zcywgbWFpbj1cIk1vZGVsIExvc3NcIiwgeGxhYiA9IFwiZXBvY2hcIiwgeWxhYj1cImxvc3NcIiwgY29sPVwiYmx1ZVwiLCB0eXBlPVwibFwiKVxuXG4jIFBsb3QgdGhlIG1vZGVsIGxvc3Mgb2YgdGhlIHRlc3QgZGF0YVxubGluZXMoaGlzdG9yeSRtZXRyaWNzJHZhbF9sb3NzLCBjb2w9XCJncmVlblwiKVxuXG4jIEFkZCBsZWdlbmRcbmxlZ2VuZChcInRvcHJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpIn0=

chart

In deze eerste plot heb je het verlies van het model op de trainings- en testdata geplot. Tijd om hetzelfde te doen, maar dan voor de nauwkeurigheid van het model:
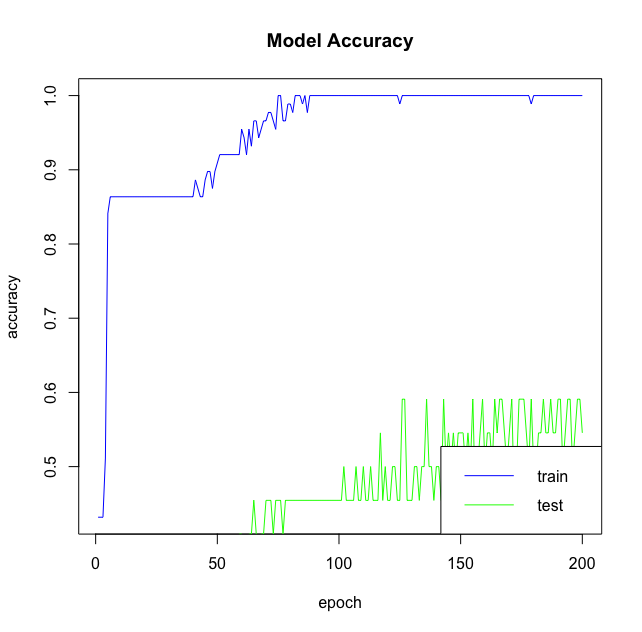
eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuaGlzdG9yeSA8LSBtb2RlbCAlPiUgZml0KFxuICAgICBpcmlzLnRyYWluaW5nLCBcbiAgICAgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCxcbiAgICAgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgUGxvdCB0aGUgYWNjdXJhY3kgb2YgdGhlIHRyYWluaW5nIGRhdGEgXG5wbG90KGhpc3RvcnkkbWV0cmljcyRhY2MsIG1haW49XCJNb2RlbCBBY2N1cmFjeVwiLCB4bGFiID0gXCJlcG9jaFwiLCB5bGFiPVwiYWNjdXJhY3lcIiwgY29sPVwiYmx1ZVwiLCB0eXBlPVwibFwiKVxuXG4jIFBsb3QgdGhlIGFjY3VyYWN5IG9mIHRoZSB2YWxpZGF0aW9uIGRhdGFcbmxpbmVzKGhpc3RvcnkkbWV0cmljcyR2YWxfYWNjLCBjb2w9XCJncmVlblwiKVxuXG4jIEFkZCBMZWdlbmRcbmxlZ2VuZChcImJvdHRvbXJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpIn0=

model accuracy

Een paar dingen om hier in gedachten te houden:

  • Als de nauwkeurigheid op je trainingsdata blijft verbeteren terwijl die op je validatiedata slechter wordt, overfit je waarschijnlijk: je model begint de data te onthouden in plaats van ervan te leren.
  • Als de trend voor nauwkeurigheid op beide datasets in de laatste paar epochs nog stijgt, kun je duidelijk zien dat het model de trainingsdata nog niet te veel heeft geleerd.

Labels van nieuwe data voorspellen

Nu je model is gemaakt, gecompileerd en gefit op de data, is het tijd om je model daadwerkelijk te gebruiken om de labels voor je testset iris.test te voorspellen. Zoals je verwachtte, kun je hiervoor de predict()-functie gebruiken. Daarna kun je de confusion matrix printen om de voorspellingen en de echte labels van de iris.test-data te bekijken met behulp van de table()-functie.

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxubW9kZWwgJT4lIGZpdChcbiAgICAgaXJpcy50cmFpbmluZywgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCwgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgUHJlZGljdCB0aGUgY2xhc3NlcyBmb3IgdGhlIHRlc3QgZGF0YVxuY2xhc3NlcyA8LSBtb2RlbCAlPiUgcHJlZGljdF9jbGFzc2VzKGlyaXMudGVzdCwgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBDb25mdXNpb24gbWF0cml4XG50YWJsZShpcmlzLnRlc3R0YXJnZXQsIGNsYXNzZXMpIn0=

Wat vind je van de resultaten? Maakt het model dat je hebt gemaakt op het eerste gezicht de juiste voorspellingen?

Je model evalueren

Hoewel je al een idee hebt van de prestaties door naar de voorspelde labels voor iris.test te kijken, is het toch belangrijk om de tijd te nemen om je model te evalueren. Gebruik hiervoor de evaluate()-functie: geef de testdata iris.test en de testlabels iris.testLabels door en definieer de batchgrootte. Sla het resultaat op in een variabele score, zoals in het codevoorbeeld hieronder:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxubW9kZWwgJT4lIGZpdChcbiAgICAgaXJpcy50cmFpbmluZywgaXJpcy50cmFpbkxhYmVscywgXG4gICAgIGVwb2NocyA9IDIwMCwgYmF0Y2hfc2l6ZSA9IDUsIFxuICAgICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKSIsInNhbXBsZSI6IiMgRXZhbHVhdGUgb24gdGVzdCBkYXRhIGFuZCBsYWJlbHNcbnNjb3JlIDwtIG1vZGVsICU+JSBldmFsdWF0ZShpcmlzLnRlc3QsIGlyaXMudGVzdExhYmVscywgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBQcmludCB0aGUgc2NvcmVcbnByaW50KHNjb3JlKSJ9

Door score te printen, krijg je de loss-waarde en de metric-waarde (in dit geval 'accuracy') terug.

Je model fijnstemmen

Je model fijnstemmen is waarschijnlijk iets wat je vaak zult doen, zeker in het begin, omdat niet alle classificatie- en regressieproblemen zo rechttoe rechtaan zijn als het probleem in het eerste deel van deze tutorial. Zoals je hierboven las, zijn er al twee belangrijke beslissingen die je waarschijnlijk wilt aanpassen: hoeveel lagen je gaat gebruiken en hoeveel “hidden units” je per laag kiest.

In het begin is dat best een zoektocht.

Naast spelen met het aantal epochs of de batchgrootte, zijn er andere manieren om je model te tweaken in de hoop dat het beter presteert: door lagen toe te voegen, door het aantal verborgen units te vergroten en door je eigen optimalisatieparameters aan de compile()-functie door te geven. In deze sectie bespreken we deze drie opties.

Lagen toevoegen

Wat gebeurt er als je nog een laag aan je model toevoegt? Wat als het er zo uitziet?

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBzZXF1ZW50aWFsIG1vZGVsXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5cbiMgQWRkIGxheWVycyB0byBtb2RlbFxubW9kZWwgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gOCwgYWN0aXZhdGlvbiA9ICdyZWx1JywgaW5wdXRfc2hhcGUgPSBjKDQpKSAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA1LCBhY3RpdmF0aW9uID0gJ3JlbHUnKSAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSAzLCBhY3RpdmF0aW9uID0gJ3NvZnRtYXgnKVxuXG4jIENvbXBpbGUgdGhlIG1vZGVsXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuXG4jIEZpdCB0aGUgbW9kZWwgdG8gdGhlIGRhdGFcbm9kZWwgJT4lIGZpdChcbiAgICAgcmlzLnRyYWluaW5nLCBpcmlzLnRyYWluTGFiZWxzLCBcbiAgICAgZXBvY2hzID0gMjAwLCBiYXRjaF9zaXplID0gNSwgXG4gICAgIHZhbGlkYXRpb25fc3BsaXQgPSAwLjJcbiApXG5cbiMgRXZhbHVhdGUgdGhlIG1vZGVsXG5zY29yZSA8LSBtb2RlbCAlPiUgZXZhbHVhdGUoaXJpcy50ZXN0LCBpcmlzLnRlc3RMYWJlbHMsIGJhdGNoX3NpemUgPSAxMjgpXG5cbiMgUHJpbnQgdGhlIHNjb3JlXG5wcmludChzY29yZSkifQ==

Let op dat je ook de verlies- en nauwkeurigheidsmetrics van dit nieuwe model kunt visualiseren! Probeer dit in de DataCamp Light-chunk hieronder:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIGEgc2VxdWVudGlhbCBtb2RlbFxubW9kZWwgPC0ga2VyYXNfbW9kZWxfc2VxdWVudGlhbCgpIFxuXG4jIEFkZCBsYXllcnMgdG8gdGhlIG1vZGVsXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDUsIGFjdGl2YXRpb24gPSAncmVsdScpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5cbiMgQ29tcGlsZSB0aGUgbW9kZWxcbm1vZGVsICU+JSBjb21waWxlKFxuICAgICBsb3NzID0gJ2NhdGVnb3JpY2FsX2Nyb3NzZW50cm9weScsXG4gICAgIG9wdGltaXplciA9ICdhZGFtJyxcbiAgICAgbWV0cmljcyA9ICdhY2N1cmFjeSdcbiApXG5cbiMgU2F2ZSB0aGUgdHJhaW5pbmcgaGlzdG9yeSBpbiBoaXN0b3J5XG5oaXN0b3J5IDwtIG1vZGVsICU+JSBmaXQoXG4gIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LFxuICB2YWxpZGF0aW9uX3NwbGl0ID0gMC4yXG4gKVxuXG4jIFBsb3QgdGhlIG1vZGVsIGxvc3NcbnBsb3QoaGlzdG9yeSRtZXRyaWNzJGxvc3MsIG1haW49XCJNb2RlbCBMb3NzXCIsIHhsYWIgPSBcImVwb2NoXCIsIHlsYWI9XCJsb3NzXCIsIGNvbD1cImJsdWVcIiwgdHlwZT1cImxcIilcbmxpbmVzKGhpc3RvcnkkbWV0cmljcyR2YWxfbG9zcywgY29sPVwiZ3JlZW5cIilcbmxlZ2VuZChcInRvcHJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpXG5cbiMgUGxvdCB0aGUgbW9kZWwgYWNjdXJhY3lcbnBsb3QoaGlzdG9yeSRtZXRyaWNzJGFjYywgbWFpbj1cIk1vZGVsIEFjY3VyYWN5XCIsIHhsYWIgPSBcImVwb2NoXCIsIHlsYWI9XCJhY2N1cmFjeVwiLCBjb2w9XCJibHVlXCIsIHR5cGU9XCJsXCIpXG5saW5lcyhoaXN0b3J5JG1ldHJpY3MkdmFsX2FjYywgY29sPVwiZ3JlZW5cIilcbmxlZ2VuZChcImJvdHRvbXJpZ2h0XCIsIGMoXCJ0cmFpblwiLFwidGVzdFwiKSwgY29sPWMoXCJibHVlXCIsIFwiZ3JlZW5cIiksIGx0eT1jKDEsMSkpIn0=

deep learning model layers

Keras Layers model

Verborgen units

Probeer ook het effect van meer verborgen units toevoegen aan de architectuur van je model en bestudeer de impact op de evaluatie, zoals hier:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIGEgc2VxdWVudGlhbCBtb2RlbFxubW9kZWwgPC0ga2VyYXNfbW9kZWxfc2VxdWVudGlhbCgpIFxuXG4jIEFkZCBsYXllcnMgdG8gdGhlIG1vZGVsXG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSAyOCwgYWN0aXZhdGlvbiA9ICdyZWx1JywgaW5wdXRfc2hhcGUgPSBjKDQpKSAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSAzLCBhY3RpdmF0aW9uID0gJ3NvZnRtYXgnKVxuXG4jIENvbXBpbGUgdGhlIG1vZGVsXG5tb2RlbCAlPiUgY29tcGlsZShcbiAgICAgbG9zcyA9ICdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLFxuICAgICBvcHRpbWl6ZXIgPSAnYWRhbScsXG4gICAgIG1ldHJpY3MgPSAnYWNjdXJhY3knXG4gKVxuXG4jIEZpdCB0aGUgbW9kZWwgdG8gdGhlIGRhdGFcbm1vZGVsICU+JSBmaXQoXG4gICAgIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICAgICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LCBcbiAgICAgdmFsaWRhdGlvbl9zcGxpdCA9IDAuMlxuIClcblxuIyBFdmFsdWF0ZSB0aGUgbW9kZWxcbnNjb3JlIDwtIG1vZGVsICU+JSBldmFsdWF0ZShpcmlzLnRlc3QsIGlyaXMudGVzdExhYmVscywgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBQcmludCB0aGUgc2NvcmVcbnByaW50KHNjb3JlKSJ9

Let op: in het algemeen is dit niet altijd de beste optimalisatie, want als je niet heel veel data hebt, kan en zal overfitting erger worden. Daarom kun je bij kleine datasets zoals deze beter een klein netwerk gebruiken.

Waarom visualiseer je niet het effect van de toevoeging van verborgen nodes in je model? Probeer het hieronder:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6InNldC5zZWVkKDEyMzQpXG5saWJyYXJ5KGtlcmFzKVxuaXJpcyA8LSByZWFkLmNzdih1cmwoXCJodHRwOi8vYXJjaGl2ZS5pY3MudWNpLmVkdS9tbC9tYWNoaW5lLWxlYXJuaW5nLWRhdGFiYXNlcy9pcmlzL2lyaXMuZGF0YVwiKSwgaGVhZGVyID0gRkFMU0UpIFxubmFtZXMoaXJpcykgPC0gYyhcIlNlcGFsLkxlbmd0aFwiLCBcIlNlcGFsLldpZHRoXCIsIFwiUGV0YWwuTGVuZ3RoXCIsIFwiUGV0YWwuV2lkdGhcIiwgXCJTcGVjaWVzXCIpXG5pcmlzWyw1XSA8LSBhcy5udW1lcmljKGlyaXNbLDVdKSAtMVxuaXJpcyA8LSBhcy5tYXRyaXgoaXJpcylcbmRpbW5hbWVzKGlyaXMpIDwtIE5VTExcbmluZCA8LSBzYW1wbGUoMiwgbnJvdyhpcmlzKSwgcmVwbGFjZT1UUlVFLCBwcm9iPWMoMC42NywgMC4zMykpXG5pcmlzLnRyYWluaW5nIDwtIGlyaXNbaW5kPT0xLCAxOjRdXG5pcmlzLnRlc3QgPC0gaXJpc1tpbmQ9PTIsIDE6NF1cbmlyaXMudHJhaW5pbmd0YXJnZXQgPC0gaXJpc1tpbmQ9PTEsNV1cbmlyaXMudGVzdHRhcmdldCA8LSBpcmlzW2luZD09MiwgNV1cbmlyaXMudHJhaW5MYWJlbHMgPC0gdG9fY2F0ZWdvcmljYWwoaXJpcy50cmFpbmluZ3RhcmdldClcbmlyaXMudGVzdExhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRlc3R0YXJnZXQpIiwic2FtcGxlIjoiIyBJbml0aWFsaXplIHRoZSBzZXF1ZW50aWFsIG1vZGVsXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5cbiMgQWRkIGxheWVycyB0byB0aGUgbW9kZWxcbm1vZGVsICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDI4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5cbiMgQ29tcGlsZSB0aGUgbW9kZWxcbm1vZGVsICU+JSBjb21waWxlKFxuICAgICBsb3NzID0gJ2NhdGVnb3JpY2FsX2Nyb3NzZW50cm9weScsXG4gICAgIG9wdGltaXplciA9ICdhZGFtJyxcbiAgICAgbWV0cmljcyA9ICdhY2N1cmFjeSdcbiApXG5cbiMgU2F2ZSB0aGUgdHJhaW5pbmcgaGlzdG9yeSBpbiB0aGUgaGlzdG9yeSB2YXJpYWJsZVxuaGlzdG9yeSA8LSBtb2RlbCAlPiUgZml0KFxuICBpcmlzLnRyYWluaW5nLCBpcmlzLnRyYWluTGFiZWxzLCBcbiAgZXBvY2hzID0gMjAwLCBiYXRjaF9zaXplID0gNSwgXG4gIHZhbGlkYXRpb25fc3BsaXQgPSAwLjJcbiApXG5cbiMgUGxvdCB0aGUgbW9kZWwgbG9zc1xucGxvdChoaXN0b3J5JG1ldHJpY3MkbG9zcywgbWFpbj1cIk1vZGVsIExvc3NcIiwgeGxhYiA9IFwiZXBvY2hcIiwgeWxhYj1cImxvc3NcIiwgY29sPVwiYmx1ZVwiLCB0eXBlPVwibFwiKVxubGluZXMoaGlzdG9yeSRtZXRyaWNzJHZhbF9sb3NzLCBjb2w9XCJncmVlblwiKVxubGVnZW5kKFwidG9wcmlnaHRcIiwgYyhcInRyYWluXCIsXCJ0ZXN0XCIpLCBjb2w9YyhcImJsdWVcIiwgXCJncmVlblwiKSwgbHR5PWMoMSwxKSlcblxuIyBQbG90IHRoZSBtb2RlbCBhY2N1cmFjeVxucGxvdChoaXN0b3J5JG1ldHJpY3MkYWNjLCBtYWluPVwiTW9kZWwgQWNjdXJhY3lcIiwgeGxhYiA9IFwiZXBvY2hcIiwgeWxhYj1cImFjY3VyYWN5XCIsIGNvbD1cImJsdWVcIiwgdHlwZT1cImxcIilcbmxpbmVzKGhpc3RvcnkkbWV0cmljcyR2YWxfYWNjLCBjb2w9XCJncmVlblwiKVxubGVnZW5kKFwiYm90dG9tcmlnaHRcIiwgYyhcInRyYWluXCIsXCJ0ZXN0XCIpLCBjb2w9YyhcImJsdWVcIiwgXCJncmVlblwiKSwgbHR5PWMoMSwxKSkifQ==

neural network model

hidden units ann

Optimalisatieparameters

Naast het toevoegen van lagen en spelen met verborgen units, kun je ook proberen (een deel van) de parameters van het optimalisatie-algoritme aan te passen dat je aan de compile()-functie geeft. Tot nu toe gaf je steeds een vector met de string adam door aan het optimizer-argument.

Maar dat hoeft niet altijd zo te zijn!

Experimenteer ook met andere optimalisatie-algoritmes, zoals Stochastic Gradient Descent (SGD). Probeer bijvoorbeeld de functie optimizer_sgd() te gebruiken om de learning rate lr aan te passen. Merk je effect?

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoa2VyYXMpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcbmlyaXNbLDVdIDwtIGFzLm51bWVyaWMoaXJpc1ssNV0pIC0xXG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuZGltbmFtZXMoaXJpcykgPC0gTlVMTFxuaW5kIDwtIHNhbXBsZSgyLCBucm93KGlyaXMpLCByZXBsYWNlPVRSVUUsIHByb2I9YygwLjY3LCAwLjMzKSlcbmlyaXMudHJhaW5pbmcgPC0gaXJpc1tpbmQ9PTEsIDE6NF1cbmlyaXMudGVzdCA8LSBpcmlzW2luZD09MiwgMTo0XVxuaXJpcy50cmFpbmluZ3RhcmdldCA8LSBpcmlzW2luZD09MSw1XVxuaXJpcy50ZXN0dGFyZ2V0IDwtIGlyaXNbaW5kPT0yLCA1XVxuaXJpcy50cmFpbkxhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRyYWluaW5ndGFyZ2V0KVxuaXJpcy50ZXN0TGFiZWxzIDwtIHRvX2NhdGVnb3JpY2FsKGlyaXMudGVzdHRhcmdldCkiLCJzYW1wbGUiOiIjIEluaXRpYWxpemUgYSBzZXF1ZW50aWFsIG1vZGVsXG5tb2RlbCA8LSBrZXJhc19tb2RlbF9zZXF1ZW50aWFsKCkgXG5cbiMgQnVpbGQgdXAgeW91ciBtb2RlbCBieSBhZGRpbmcgbGF5ZXJzIHRvIGl0XG5tb2RlbCAlPiUgXG4gICAgbGF5ZXJfZGVuc2UodW5pdHMgPSA4LCBhY3RpdmF0aW9uID0gJ3JlbHUnLCBpbnB1dF9zaGFwZSA9IGMoNCkpICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDMsIGFjdGl2YXRpb24gPSAnc29mdG1heCcpXG5cbiMgRGVmaW5lIGFuIG9wdGltaXplclxuc2dkIDwtIG9wdGltaXplcl9zZ2QobHIgPSAwLjAxKVxuXG4jIFVzZSB0aGUgb3B0aW1pemVyIHRvIGNvbXBpbGUgdGhlIG1vZGVsXG5tb2RlbCAlPiUgY29tcGlsZShvcHRpbWl6ZXI9c2dkLCBcbiAgICAgICAgICAgICAgICAgIGxvc3M9J2NhdGVnb3JpY2FsX2Nyb3NzZW50cm9weScsIFxuICAgICAgICAgICAgICAgICAgbWV0cmljcz0nYWNjdXJhY3knKVxuXG4jIEZpdCB0aGUgbW9kZWwgdG8gdGhlIHRyYWluaW5nIGRhdGFcbm1vZGVsICU+JSBmaXQoXG4gICAgIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICAgICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LCBcbiAgICAgdmFsaWRhdGlvbl9zcGxpdCA9IDAuMlxuIClcblxuIyBFdmFsdWF0ZSB0aGUgbW9kZWxcbnNjb3JlIDwtIG1vZGVsICU+JSBldmFsdWF0ZShpcmlzLnRlc3QsIGlyaXMudGVzdExhYmVscywgYmF0Y2hfc2l6ZSA9IDEyOClcblxuIyBQcmludCB0aGUgbG9zcyBhbmQgYWNjdXJhY3kgbWV0cmljc1xucHJpbnQoc2NvcmUpIn0=

Naast het gebruik van een andere optimizer, kun je ook proberen een lagere learning rate te gebruiken om je netwerk te trainen. Dit is een van de meest voorkomende fijnstemmings­technieken; Een gebruikelijke aanpak is om de initiële learning rate 10 keer kleiner te maken dan die waarmee je het model eerder trainde.

Laten we de trainingsgeschiedenis nog eens visualiseren om het effect van deze kleine aanpassing te zien:

eyJsYW5ndWFnZSI6InIiLCJwcmVfZXhlcmNpc2VfY29kZSI6ImxpYnJhcnkoa2VyYXMpXG5pcmlzIDwtIHJlYWQuY3N2KHVybChcImh0dHA6Ly9hcmNoaXZlLmljcy51Y2kuZWR1L21sL21hY2hpbmUtbGVhcm5pbmctZGF0YWJhc2VzL2lyaXMvaXJpcy5kYXRhXCIpLCBoZWFkZXIgPSBGQUxTRSkgXG5uYW1lcyhpcmlzKSA8LSBjKFwiU2VwYWwuTGVuZ3RoXCIsIFwiU2VwYWwuV2lkdGhcIiwgXCJQZXRhbC5MZW5ndGhcIiwgXCJQZXRhbC5XaWR0aFwiLCBcIlNwZWNpZXNcIilcbmlyaXNbLDVdIDwtIGFzLm51bWVyaWMoaXJpc1ssNV0pIC0xXG5pcmlzIDwtIGFzLm1hdHJpeChpcmlzKVxuZGltbmFtZXMoaXJpcykgPC0gTlVMTFxuaW5kIDwtIHNhbXBsZSgyLCBucm93KGlyaXMpLCByZXBsYWNlPVRSVUUsIHByb2I9YygwLjY3LCAwLjMzKSlcbmlyaXMudHJhaW5pbmcgPC0gaXJpc1tpbmQ9PTEsIDE6NF1cbmlyaXMudGVzdCA8LSBpcmlzW2luZD09MiwgMTo0XVxuaXJpcy50cmFpbmluZ3RhcmdldCA8LSBpcmlzW2luZD09MSw1XVxuaXJpcy50ZXN0dGFyZ2V0IDwtIGlyaXNbaW5kPT0yLCA1XVxuaXJpcy50cmFpbkxhYmVscyA8LSB0b19jYXRlZ29yaWNhbChpcmlzLnRyYWluaW5ndGFyZ2V0KVxuaXJpcy50ZXN0TGFiZWxzIDwtIHRvX2NhdGVnb3JpY2FsKGlyaXMudGVzdHRhcmdldClcbm1vZGVsIDwtIGtlcmFzX21vZGVsX3NlcXVlbnRpYWwoKSBcbm1vZGVsICU+JSBcbiAgICBsYXllcl9kZW5zZSh1bml0cyA9IDgsIGFjdGl2YXRpb24gPSAncmVsdScsIGlucHV0X3NoYXBlID0gYyg0KSkgJT4lIFxuICAgIGxheWVyX2RlbnNlKHVuaXRzID0gMywgYWN0aXZhdGlvbiA9ICdzb2Z0bWF4JykiLCJzYW1wbGUiOiIjIERlZmluZSBhbiBvcHRpbWl6ZXJcbnNnZCA8LSBvcHRpbWl6ZXJfc2dkKGxyID0gMC4wMSlcblxuIyBDb21waWxlIHRoZSBtb2RlbFxubW9kZWwgJT4lIGNvbXBpbGUob3B0aW1pemVyPXNnZCwgXG4gICAgICAgICAgICAgICAgICBsb3NzPSdjYXRlZ29yaWNhbF9jcm9zc2VudHJvcHknLCBcbiAgICAgICAgICAgICAgICAgIG1ldHJpY3M9J2FjY3VyYWN5JylcblxuIyBGaXQgdGhlIG1vZGVsIHRvIHRoZSB0cmFpbmluZyBkYXRhXG5oaXN0b3J5IDwtIG1vZGVsICU+JSBmaXQoXG4gIGlyaXMudHJhaW5pbmcsIGlyaXMudHJhaW5MYWJlbHMsIFxuICBlcG9jaHMgPSAyMDAsIGJhdGNoX3NpemUgPSA1LCBcbiAgdmFsaWRhdGlvbl9zcGxpdCA9IDAuMlxuIClcblxuIyBQbG90IHRoZSBtb2RlbCBsb3NzXG5wbG90KGhpc3RvcnkkbWV0cmljcyRsb3NzLCBtYWluPVwiTW9kZWwgTG9zc1wiLCB4bGFiID0gXCJlcG9jaFwiLCB5bGFiPVwibG9zc1wiLCBjb2w9XCJibHVlXCIsIHR5cGU9XCJsXCIpXG5saW5lcyhoaXN0b3J5JG1ldHJpY3MkdmFsX2xvc3MsIGNvbD1cImdyZWVuXCIpXG5sZWdlbmQoXCJ0b3ByaWdodFwiLCBjKFwidHJhaW5cIixcInRlc3RcIiksIGNvbD1jKFwiYmx1ZVwiLCBcImdyZWVuXCIpLCBsdHk9YygxLDEpKVxuXG4jIFBsb3QgdGhlIG1vZGVsIGFjY3VyYWN5XG5wbG90KGhpc3RvcnkkbWV0cmljcyRhY2MsIG1haW49XCJNb2RlbCBBY2N1cmFjeVwiLCB4bGFiID0gXCJlcG9jaFwiLCB5bGFiPVwiYWNjdXJhY3lcIiwgY29sPVwiYmx1ZVwiLCB0eXBlPVwibFwiKVxubGluZXMoaGlzdG9yeSRtZXRyaWNzJHZhbF9hY2MsIGNvbD1cImdyZWVuXCIpXG5sZWdlbmQoXCJib3R0b21yaWdodFwiLCBjKFwidHJhaW5cIixcInRlc3RcIiksIGNvbD1jKFwiYmx1ZVwiLCBcImdyZWVuXCIpLCBsdHk9YygxLDEpKSJ9

neural network model

hidden units ann

Je model opslaan, laden of exporteren

Er is nog één ding dat overblijft in je reis met het keras-pakket: je model opslaan of exporteren zodat je het op een later moment weer kunt laden.

  • Allereerst kun je eenvoudig gebruikmaken van de functies save_model_hdf5() en load_model_hdf5() om je model in je werkruimte op te slaan en te laden:
save_model_hdf5(model, "my_model.h5")
model <- load_model_hdf5("my_model.h5")
  • Daarnaast kun je ook de modelgewichten opslaan en laden met de functies save_model_weights_hdf5() en load_model_weights_hdf5() :
save_model_weights_hdf5("my_model_weights.h5")
model %>% load_model_weights_hdf5("my_model_weights.h5")
  • Tot slot is het goed om te weten dat je de modelconfiguratie ook kunt exporteren naar JSON of YAML. De functies model_to_json() en model_to_yaml() helpen je hierbij. Om de configuraties terug in je werkruimte te laden, gebruik je gewoon de functies model_from_json() en model_from yaml():
json_string <- model_to_json(model)
model <- model_from_json(json_string)

yaml_string <- model_to_yaml(model)
model <- model_from_yaml(yaml_string)
Learn Python for Data Science With DataCamp

Deep Learning met Keras

Gefeliciteerd! Je bent door deze deep learning-tutorial in R met keras heen. Deze tutorial was slechts een kleine stap in je deep learning-reis met R; Er is nog veel meer te ontdekken! Als je DataCamp’s Deep Learning in Python-cursus nog niet hebt gevolgd, overweeg dat dan.

Bekijk intussen ook zeker de Keras-documentatie en de RStudio-keras-documentatie als je dat nog niet hebt gedaan. Je vindt er meer voorbeelden en informatie over alle functies, argumenten, extra lagen, enzovoort. Bekijk ook het boek van François Chollet “Deep Learning with Python”. Al deze bronnen zijn onmisbaar om te leren werken met neurale netwerken in R!

Onderwerpen
R
Data Science
Kunstmatige intelligentie
Machine Learning
Deep Learning

Gerelateerde cursussen

Cursus

Introductie tot R

4 uur
3.1M
Beheers de basis van data-analyse in R, inclusief vectors, lists en data frames, en oefen met echte datasets.
Bekijk detailsRight Arrow
Start Cursus
Meer bekijkenRight Arrow