

Kursus
Pengantar Model Claude
3 jam
15K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleClaude Opus 4.7 dari Anthropic memperkenalkan tingkat upaya baru xhigh, berada di antara high dan max, serta menyoroti peningkatan memori sistem berkas sebagai kapabilitas kunci, yaitu model dapat menulis catatan untuk dirinya sendiri dan menggunakannya lintas sesi.
Ini memunculkan pertanyaan jelas bagi saya: Apakah memori tersebut benar-benar bekerja dalam format yang dapat diukur? Juga, apakah Opus 4.7 belajar dari kesalahannya sendiri dan menghasilkan kode yang lebih baik pada tugas berikutnya?
Jadi, saya membangun sebuah harness benchmark Streamlit yang menjalankan tiga tugas pengodean sulit secara berurutan. Setelah setiap tugas, model menulis kritik-diri ke berkas memori (memory.md). Tugas berikutnya membaca berkas itu sebelum mulai. Saya menjalankan ini dengan dan tanpa memori, di ketiga tingkat upaya (high, xhigh, dan max), total 18 kali jalan tugas melalui Claude Opus 4.7 di Microsoft Foundry.
Di akhir tutorial ini, Anda akan dapat:
Kode lengkap tersedia di repositori GitHub.
Claude Opus 4.7 adalah model bahasa besar paling andal dalam keluarga Claude 4, di atas Sonnet dan Haiku. Model ini dibangun untuk tugas agen jangka panjang, rekayasa perangkat lunak tingkat lanjut, dan alur kerja enterprise yang memerlukan kinerja berkelanjutan sepanjang sesi panjang.
Tiga kapabilitas yang paling relevan untuk tutorial ini adalah:
xhigh: Berada di antara high (5.000 token berpikir) dan max (20.000 token berpikir) pada 10.000 token berpikir. Idenya adalah kontrol biaya-kualitas yang lebih halus pada masalah sulit.Catatan: Harga adalah $5 per satu juta token masukan dan $25 per satu juta token keluaran yang identik dengan Opus 4.6. Jika Anda ingin menelusuri model ini secara mendalam, artikel dari tim DataCamp ini layak dibaca.
Beberapa angka yang perlu diketahui sebelum kita mengujinya:
|
Benchmark |
Skor |
|
SWE-bench Verified |
87,6% |
|
SWE-bench Pro |
64,2% |
|
GPQA Diamond |
94,2% |
|
OSWorld Verified (penggunaan komputer) |
78,0% |
|
Finance Agent v1.1 |
64,4% |
Semua panggilan API dalam tutorial ini melalui Microsoft Foundry. Jadi, kita memerlukan langganan Azure dengan akses ke penagihan pay-as-you-go karena tier mahasiswa gratis tidak memiliki kuota untuk model mitra pihak ketiga seperti Claude. Namun alternatif yang baik adalah menggunakan kunci API Anthropic. Saya telah membahas kedua pendekatan di repositori ini.
Langkah awal tutorial ini adalah menemukan model di dalam Katalog Model Microsoft Foundry. Untuk ini,
claude-opus-4-7. Ini akan membuka kartu model yang menampilkan kapabilitas kunci, benchmark, dan ID model.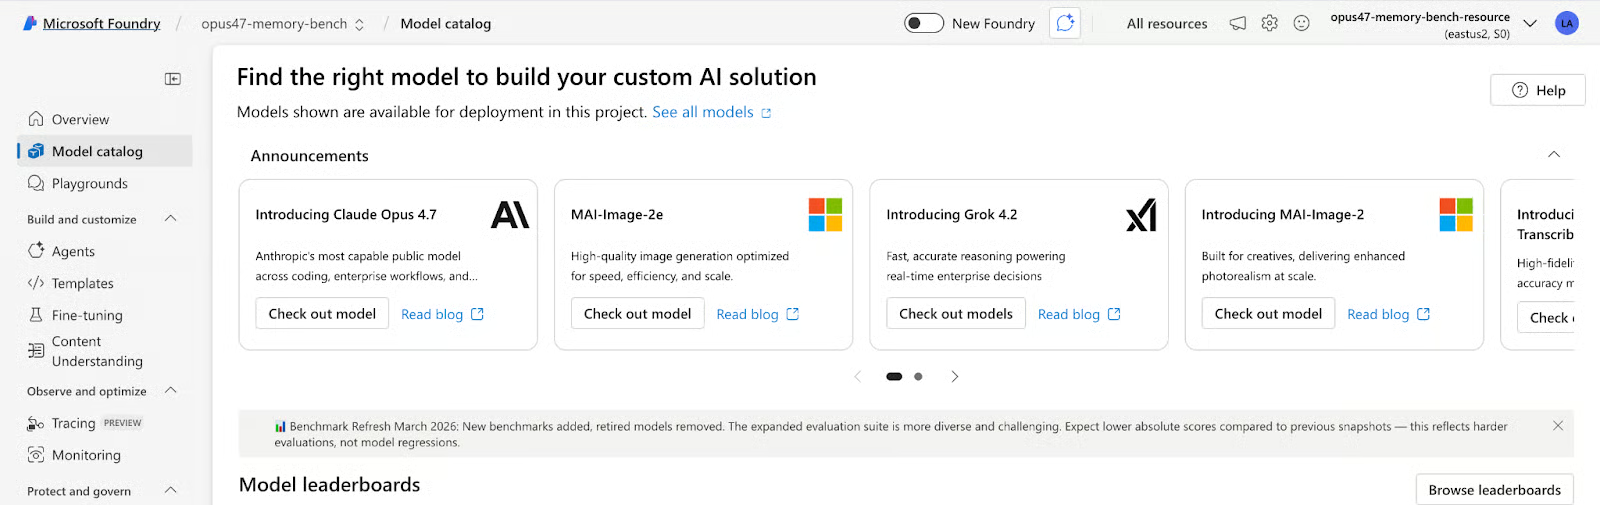
opus47-memory-bench. Lalu, setujui ketentuan penggunaan dan setuju dengan kebijakan penggunaan Anthropic melalui Azure Marketplace.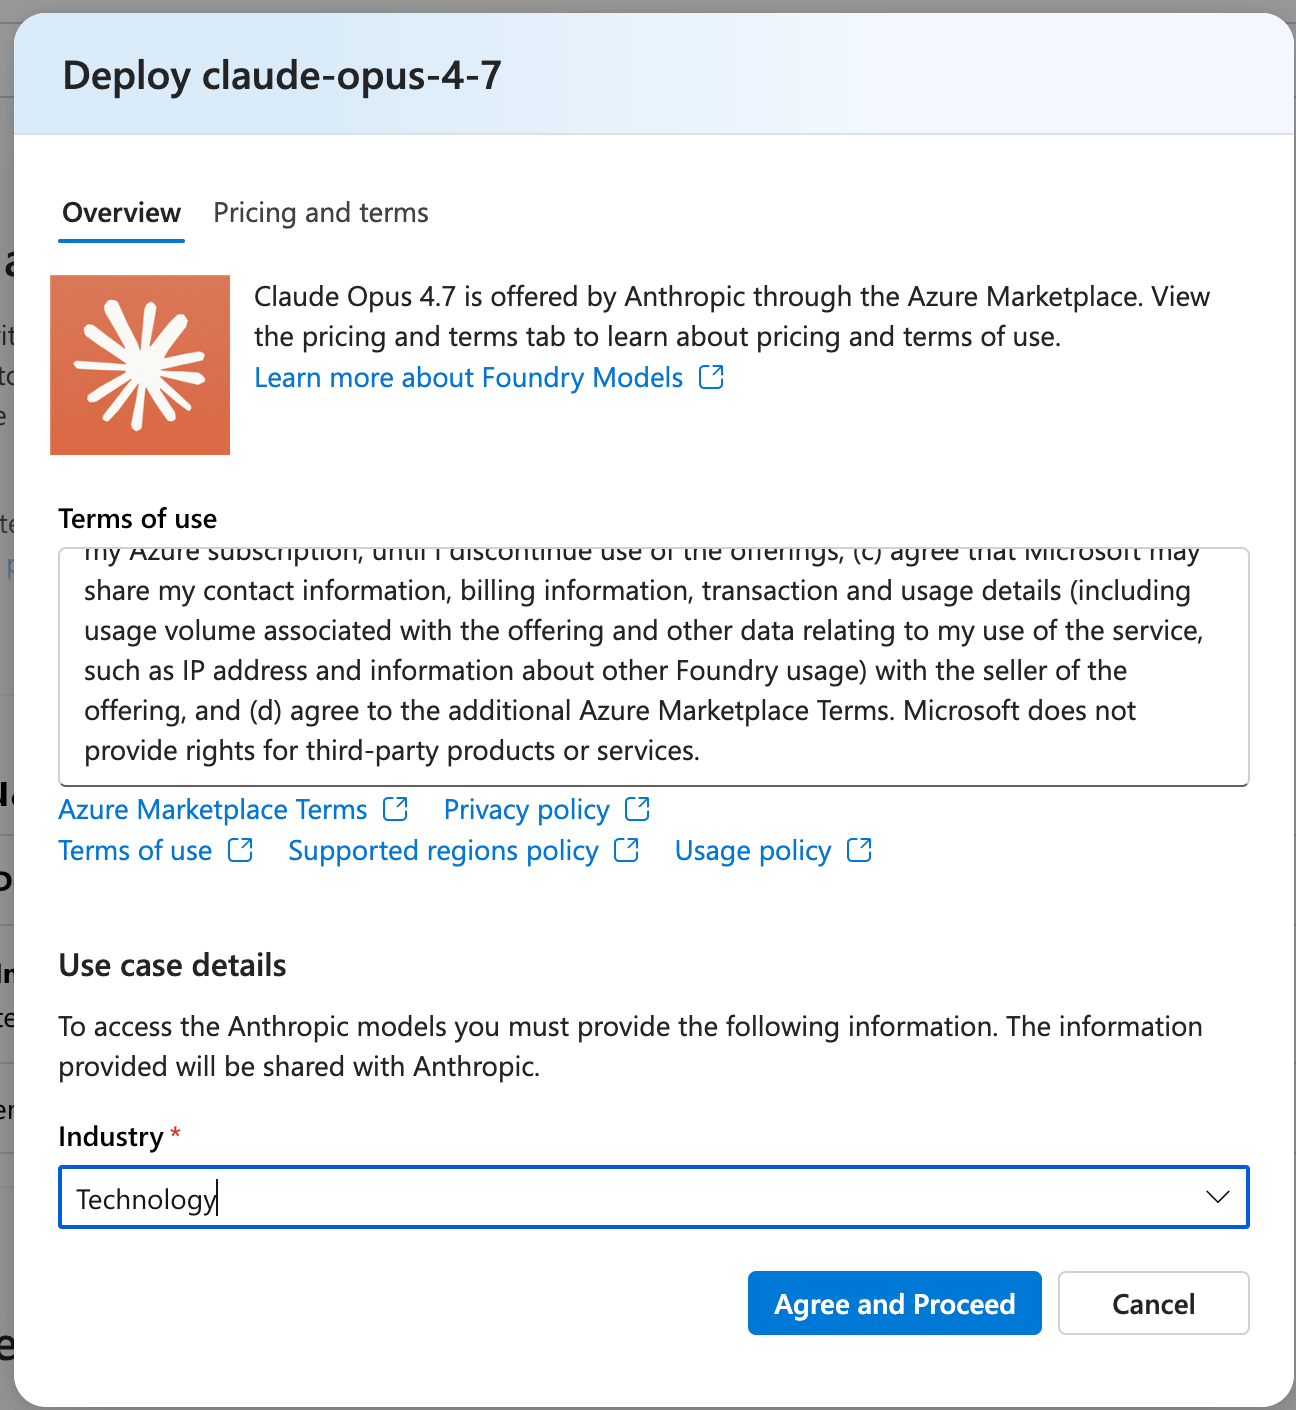
Setelah proyek Anda dibuat, Anda akan diarahkan ke dialog deploy. Lalu isi informasi berikut:
Nama deployment: claude-opus-4-7 (biarkan default, karena kode menggunakan string ini)
Jenis deployment: Global Standard (serverless, tanpa manajemen kapasitas)
Kebijakan peningkatan versi model: Saya menyarankan untuk mengunci ke versi 1 alih-alih pembaruan otomatis, agar rilis model baru tidak merusak run yang ada
Klik Create resource and deploy.
Setelah dideploy, buka proyek Anda di portal Foundry. Di tab Overview, Anda akan menemukan hal-hal berikut:
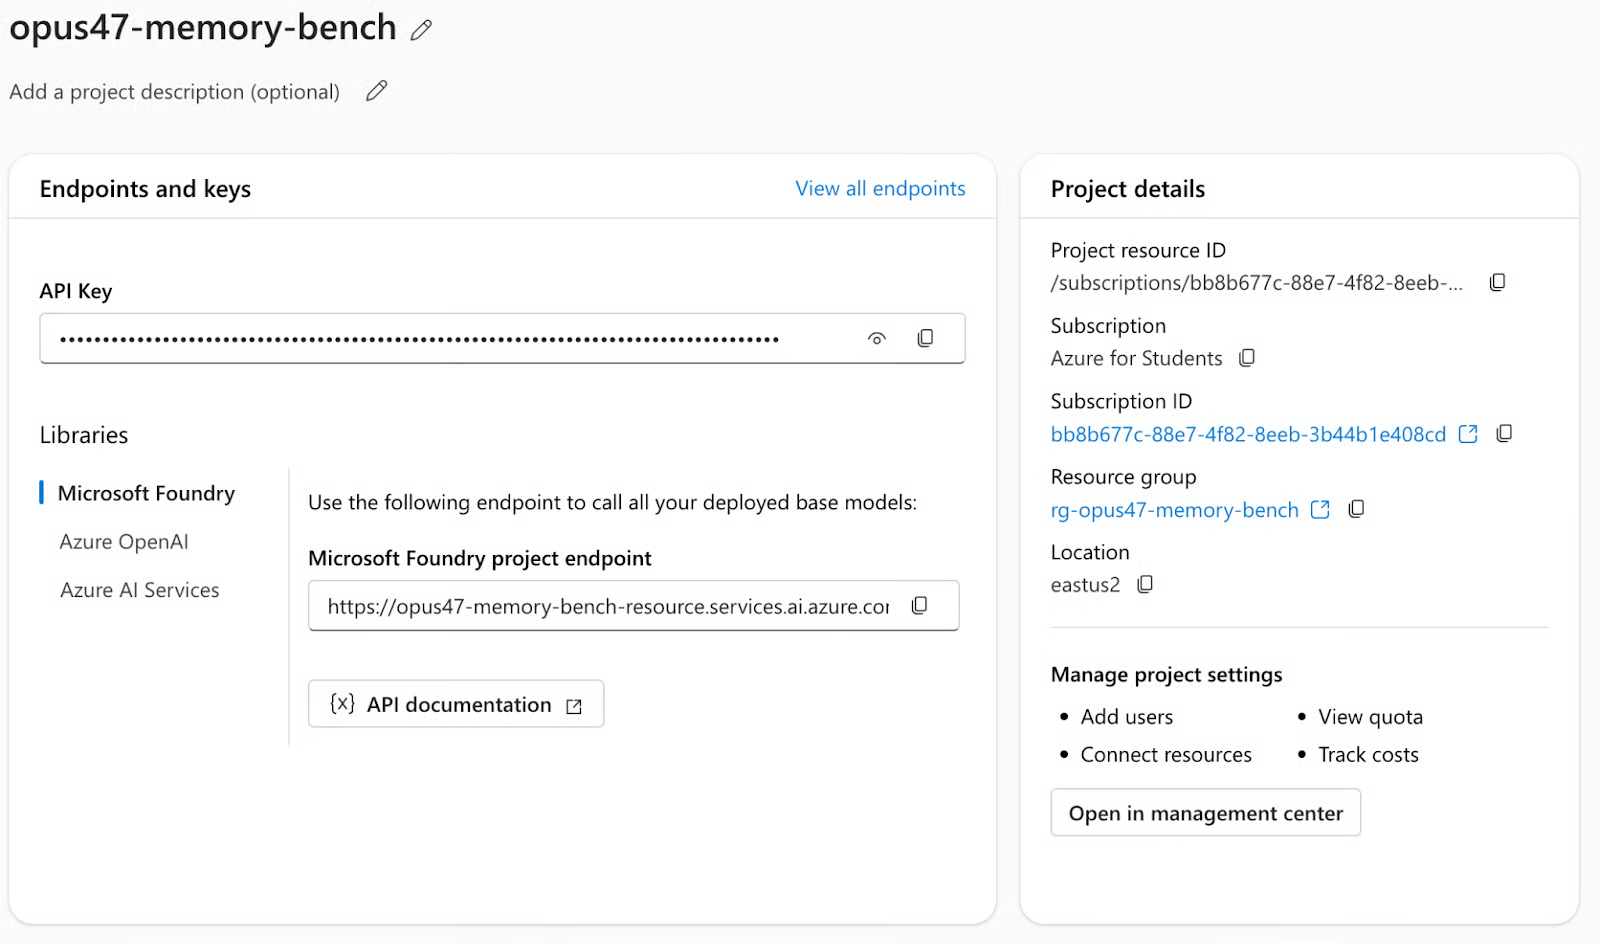
API key: Salin kunci API dan simpan untuk digunakan nanti. Kita akan menyetel kunci API sebagai ANTHROPIC_FOUNDRY_API_KEY.
Endpoint proyek Microsoft Foundry: Salin nama resource dari endpoint proyek, tersedia dalam format https://your-resource.services.ai.azure.com, di mana nama resource adalah prefiks subdomain (yakni segala sesuatu sebelum .services.ai.azure.com). Kita akan menyetelnya sebagai ANTHROPIC_FOUNDRY_RESOURCE
Sekarang kita sudah memiliki semua resource yang diperlukan. Selanjutnya kita akan menyetel kunci di atas sebagai variabel lingkungan dan menjalankan aplikasi Streamlit.
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
Anthropic SDK menangani endpoint Foundry secara otomatis saat Anda meneruskan base URL spesifik resource:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
Sisanya termasuk panggilan model, parameter thinking, dan parsing respons menggunakan Anthropic SDK standar. Tidak perlu lapisan kompatibilitas OpenAI.
Harness Streamlit menjalankan tiga tugas secara berurutan, dua kali per tingkat upaya dan sekali dengan memori diaktifkan, serta sekali tanpa (kontrol). Setiap tugas memiliki empat kriteria penilaian eksplisit bernilai 25 poin masing-masing, dinilai oleh panggilan Opus 4.7 kedua yang bertindak sebagai LLM-as-judge. Ambang kelulusan untuk setiap tugas dan subtugas adalah 70/100.
Tugas ini terdiri dari soal LeetCode tingkat sulit yang klasik. Prompt mensyaratkan implementasi pencarian biner O(log(m+n)) di mana pemindaian linear bernilai nol pada kriteria kompleksitas. Ia juga mensyaratkan suite uji minimal 10 kasus dan komentar inline yang menjelaskan setiap langkah logika pencarian biner. Setelah menulis kode, model harus menelusuri secara manual contoh nums1=[1,3], nums2=[2] langkah demi langkah.
Tugas ini terdiri dari kelas Python RateLimiter yang buggy dengan sedikitnya tiga bug, salah satunya adalah kondisi balapan yang subtil. Metode is_allowed() membaca dan memodifikasi state bersama tanpa memegang lock, menciptakan kerentanan TOCTOU (time-of-check to time-of-use) klasik. Prompt mensyaratkan identifikasi setiap bug dengan nomor baris yang tepat, menjelaskan mode kegagalan, memberikan perbaikan, lalu melakukan pemeriksaan diri eksplisit dengan membaca ulang kode yang telah dikoreksi.
Untuk tugas 3, kita akan mencoba mengimplementasikan mesin autograd bernilai skalar dalam Python murni tanpa NumPy, tanpa PyTorch (mendukung +, *, -, /, **), dan ReLU dengan subgradien yang benar pada nol. Mesin harus menggunakan pengurutan topologis untuk backward pass dan akumulasi gradien (+=) untuk node yang digunakan beberapa kali. Yang penting, prompt mensyaratkan menampilkan penurunan aturan rantai manual sebelum kodenya, bukan setelahnya. Ini menguji apakah model dapat merencanakan terlebih dahulu dan memverifikasi penalarannya.
Mekanik memori adalah yang membedakan benchmark ini dari evaluasi LLM standar. Alih-alih memperlakukan setiap tugas sebagai panggilan independen, model diberi kesempatan terstruktur untuk merefleksikan apa yang salah dilakukannya dan membawa refleksi itu ke depan menggunakan komponen memori.
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
Ini menciptakan kurva pembelajaran dalam satu sesi. Pada Tugas 3, model bekerja dengan dua putaran akumulasi kritik-diri dan instruksi yang ditulisnya sendiri tentang pola kegagalannya. Apakah ia benar-benar menggunakan instruksi tersebut secara produktif atau tidak, itulah yang akan kita telusuri di bagian hasil.
Opus 4.7 memperkenalkan xhigh sebagai tingkat upaya baru yang berada di antara high dan max. Anggaran berpikir mengontrol berapa banyak token yang dapat digunakan model untuk penalaran internal sebelum menghasilkan respons. Anggaran lebih tinggi memungkinkan perencanaan lebih dalam tetapi meningkatkan latensi dan biaya.
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
Ini diteruskan langsung ke Anthropic SDK:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
Model mengatur diri berdasarkan tingkat kesulitan tugas yang dirasakan. Dalam praktiknya, Anda jarang melihat seluruh anggaran terpakai, sehingga run max dalam benchmark ini rata-rata sekitar 300 token berpikir per tugas, jauh di bawah batas 20.000.
Benchmark menjalankan total 18 panggilan tugas (3 upaya x 2 mode x 3 tugas) dan 18 panggilan penilai untuk penskoran. Total biaya untuk eksperimen ini sekitar $5.
Saya memplot kinerja model ini di tiga tugas untuk semua enam kondisi (tiga tingkat upaya x memori aktif/nonaktif). Garis oranye pada plot berikut adalah run dengan memori, sedangkan garis abu-abu/putus-putus adalah run tanpa memori, dan garis putus-putus merah menandai ambang lulus 70 poin.
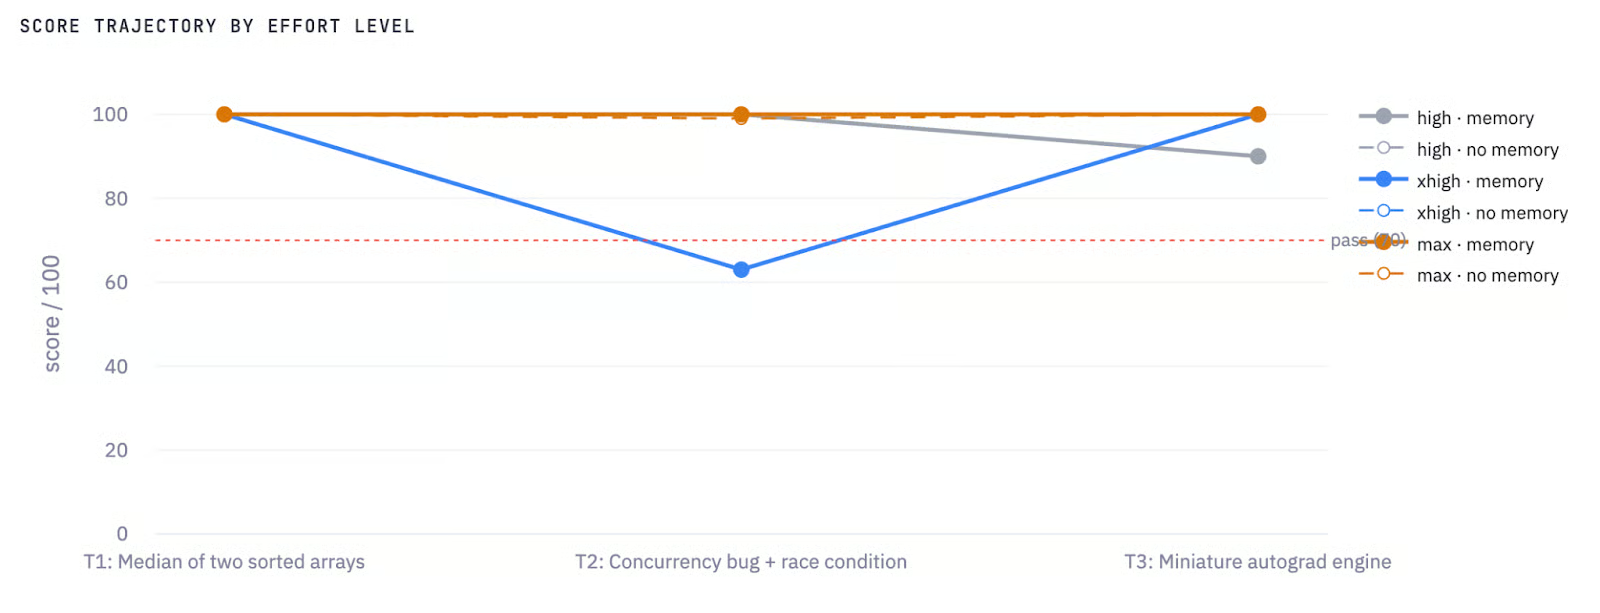
Trajektori Skor menurut tingkat upaya dan memori
Fitur paling mencolok adalah garis biru (xhigh + memory) jatuh ke 63 pada Tugas 2 yaitu satu-satunya run gagal di seluruh benchmark. Ini adalah temuan utama eksperimen, dan akan saya uraikan per tugas di bawah.
Diagram efisiensi memplot skor terhadap biaya per tugas. Klaster di kiri atas pada Gambar 2 menunjukkan konfigurasi high dan no-memory. Outlier di kiri bawah adalah xhigh + memory pada Tugas 2 dengan 63 poin pada $0,009, yang berarti model berjalan murah tetapi gagal. Run memori max muncul di tepi kanan (~$0,10–0,12), memberikan skor sebanding dengan high dengan biaya lebih dari dua kali lipat.
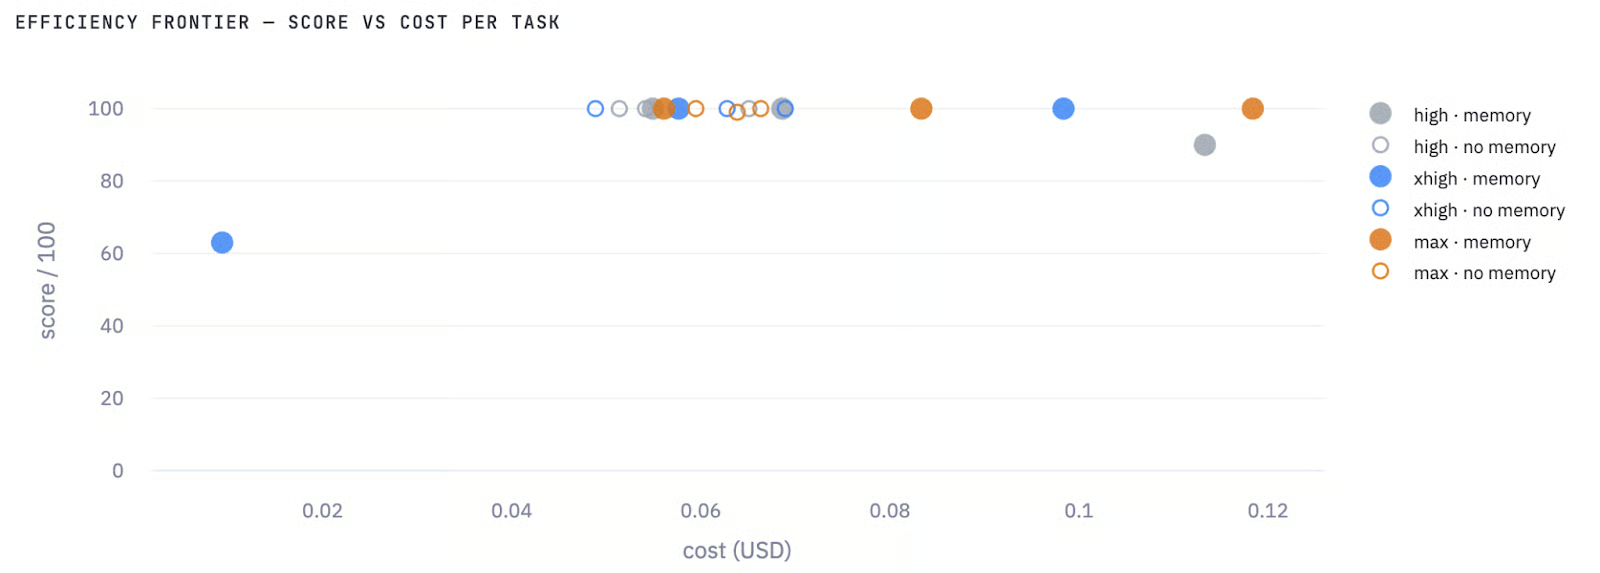
Plot efisiensi: Skor vs Biaya per tugas
Inti praktis dari diagram ini adalah untuk jenis tugas pengodean seperti ini, mengeluarkan lebih banyak biaya pada anggaran berpikir tidak secara andal membeli skor yang lebih baik. Efisiensi biaya terbaik adalah high tanpa memori.
Matriks upaya x memori merangkum skor rata-rata di seluruh tiga tugas:
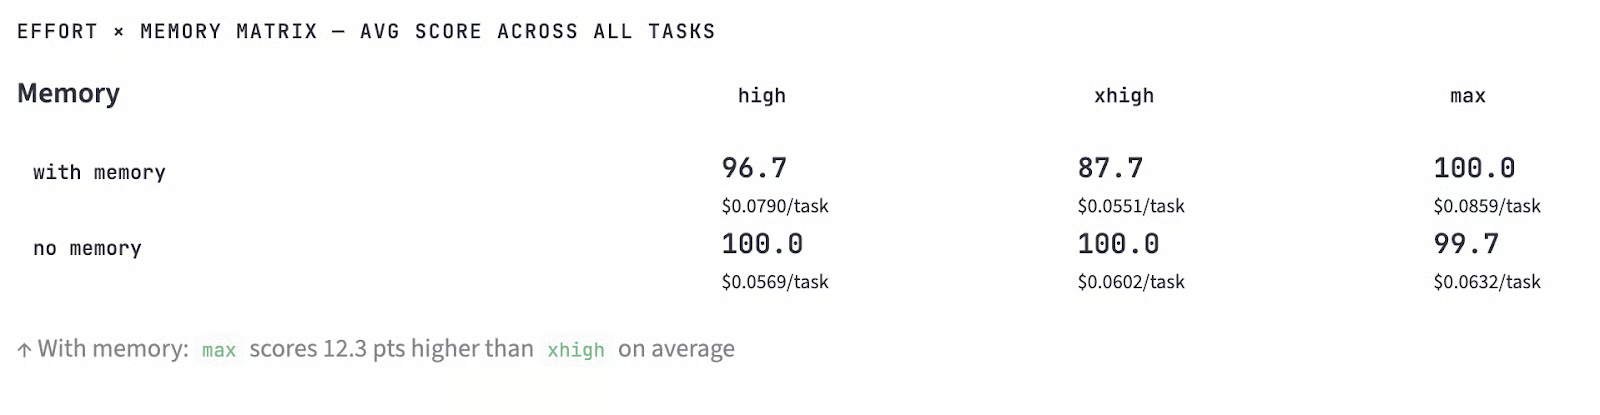
Skor rata-rata di seluruh tugas
Run tanpa memori mendominasi pada dua dari tiga tingkat upaya. Konfigurasi max + memory mencapai 100,0 secara rata-rata namun satu-satunya konfigurasi memori yang melampaui padanannya tanpa memori, dan hanya sebesar 0,3 poin.
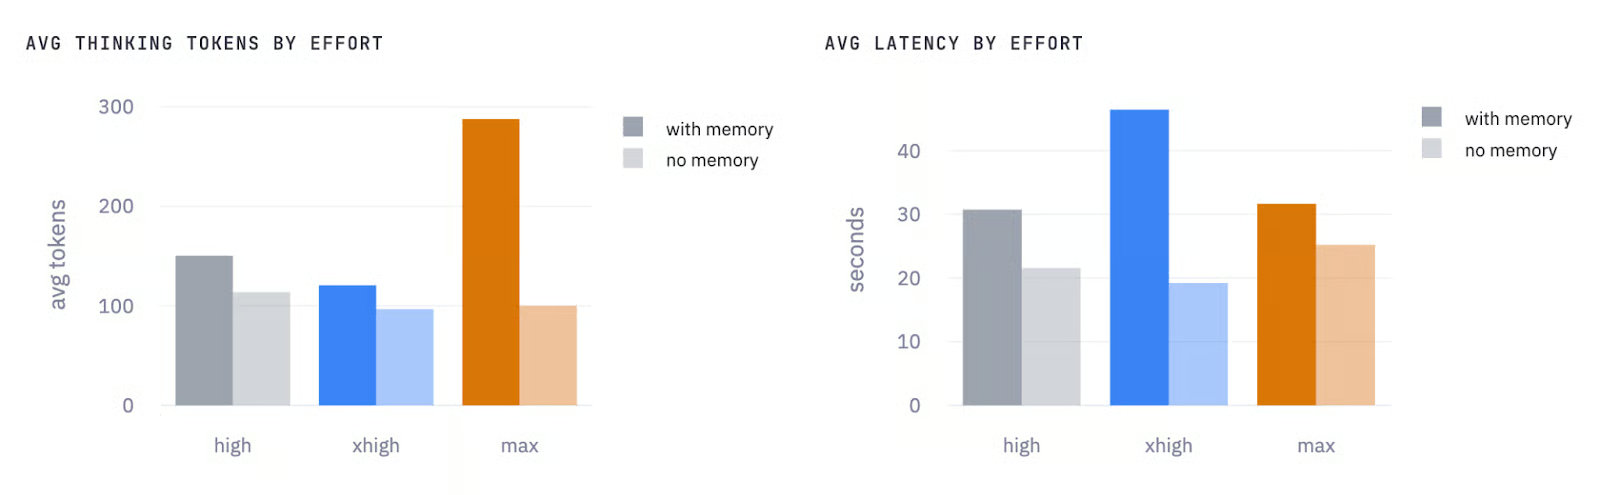
Rata-rata token berpikir per upaya dan rata-rata latensi per upaya
Di sisi token berpikir (Gambar 4 (kiri)), upaya max dengan memori tampak menonjol, rata-rata sekitar 290 token berpikir versus sekitar 100 tanpa memori. Ini berarti model menghabiskan lebih banyak anggaran penalaran internal untuk memproses dan menerapkan kritik-diri yang terakumulasi sebelum menghasilkan respons. Sementara upaya high dan xhigh menunjukkan celah lebih kecil namun konsisten ke arah yang sama, yaitu memori selalu meningkatkan penggunaan token berpikir, di semua tiga tingkat upaya.
Diagram latensi (Gambar 4 (kanan)) menyampaikan cerita yang sama dalam waktu jam-dinding, namun dengan satu pengecualian mencolok, yaitu upaya xhigh dengan memori memiliki latensi tertinggi dari konfigurasi mana pun (sekitar 47 detik rata-rata) bahkan lebih tinggi daripada upaya max dengan memori sekitar 31 detik.
Ini berarti kegagalan Tugas 2 menarik rata-rata xhigh naik karena model menghabiskan anggaran berpikirnya untuk menyusun ulang format respons berdasarkan instruksi memori, lalu terus menghasilkan hingga mencapai batas keluaran. Namun, max dengan memori, meskipun memiliki anggaran berpikir lebih besar, justru lebih cepat rata-rata karena ketiga run-nya selesai dengan sukses tanpa pemotongan.
Inti praktis dari dua diagram ini adalah memori menambah sekitar 30–40% overhead pada token berpikir dan latensi pada upaya high dan max.
Berikut versi terpotong dari pengerjaan model untuk tugas ini:
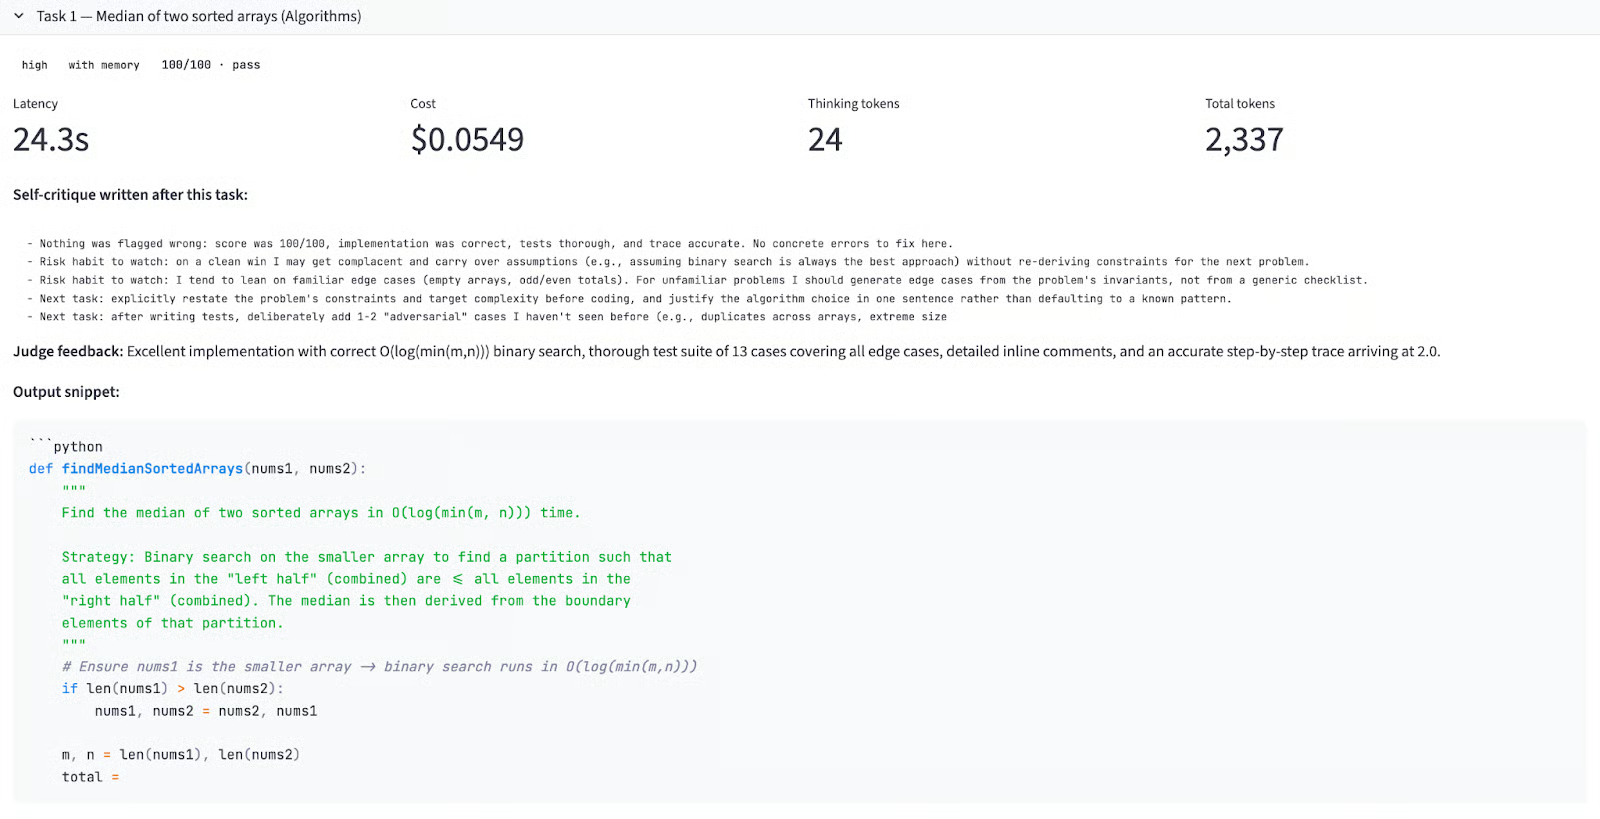
Input prompt:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].Delta memori di seluruh tingkat upaya:
|
Upaya |
Tanpa memori |
Dengan memori |
Δ |
|
high |
100 |
100 |
+0,0 |
|
xhigh |
100 |
100 |
+0,0 |
|
max |
100 |
100 |
+0,0 |
Semua enam run mencetak 100. Ini terduga untuk Tugas 1 karena berjalan dingin pada run memori (belum ada kritik sebelumnya), sehingga secara mekanis identik dengan run tanpa memori. Delta nol mengonfirmasi kontrol bekerja dengan benar.
Yang menarik adalah apa yang ditulis model setelah Tugas 1 di berkas memori. Bahkan dengan skor sempurna, ketiga tingkat upaya menghasilkan kritik-diri proaktif sebagai berikut:
high: "Kebiasaan berisiko yang perlu diperhatikan: saat menang bersih saya bisa jadi lengah dan membawa asumsi tanpa menurunkan ulang kendala untuk masalah berikutnya. Saya harus menghasilkan kasus tepi dari invarian masalah, bukan dari daftar periksa generik."
xhigh: "Mendapat skor sempurna, tetapi 'tidak ada yang salah' itu sendiri merupakan penilaian diri yang mencurigakan — saya harus meneliti apakah kriteria penilai sudah komprehensif."
max: "Waspadai rasa puas diri: skor 100 tidak berarti solusi optimal di setiap dimensi. Saya tetap harus bertanya apakah invarian pencarian biner dinyatakan secara eksplisit dan apakah saya membuktikan kebenaran alih-alih sekadar menyatakannya."
Ketiganya secara independen sampai pada peringatan anti-rasa puas diri. Versi xhigh dan max melangkah lebih jauh, mempertanyakan apakah penilai sendiri melewatkan hal-hal. Ini adalah metakognisi di mana model menulis catatan skeptis tentang proses tinjau diri sendiri.
Kualitas keluaran: Semua enam implementasi menggunakan pencarian biner pada array yang lebih pendek untuk mencapai O(log(min(m, n))) alih-alih O(log(m+n)), yang secara ketat lebih baik.
Umpan balik penilai di semua run:
"Implementasi sangat baik dengan pencarian biner O(log(min(m,n))) yang benar, suite uji menyeluruh 13 kasus yang mencakup semua kasus tepi, komentar inline terperinci, dan penelusuran langkah demi langkah yang akurat menghasilkan 2,0."
Di sinilah mekanik memori menghasilkan hasil paling dramatis. Peningkatan 37 poin pada upaya high dan penurunan 37 poin pada upaya xhigh, dari berkas memori yang sama.
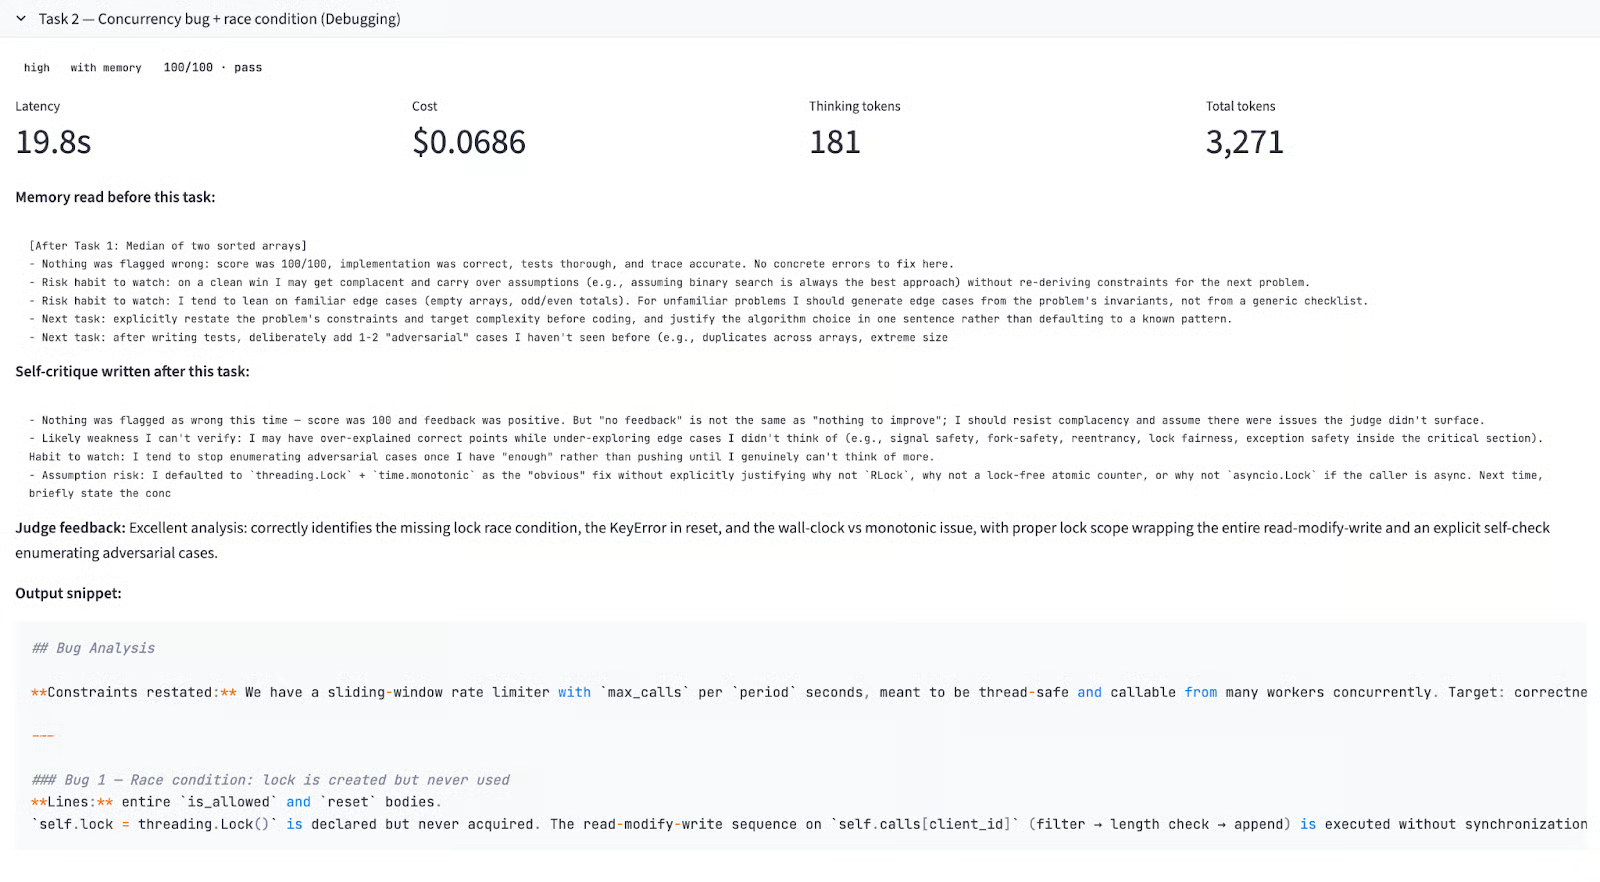
Input prompt:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.Delta memori di seluruh tingkat upaya:
|
Upaya |
Tanpa memori |
Dengan memori |
Δ |
|
high |
92 |
100 |
+8,0 |
|
xhigh |
100 |
63 |
-37,0 |
|
max |
99 |
100 |
+1,0 |
Temuan kunci:
high + memory (skor: 100/100): Memori dari Tugas 1 memperingatkan tentang menghasilkan kasus tepi adversarial dan tidak berhenti pada jumlah bug yang cukup. Model secara eksplisit menyatakan ulang kendala masalah sebelum memulai analisis bug.
xhigh + memory (skor: 63/100 — GAGAL): Ini adalah kegagalan utama eksperimen. Memori xhigh dari Tugas 1 menyertakan catatan terperinci dengan komentar inline. Model mengambil instruksi itu dan menggunakan anggaran berpikir 10.000 token untuk menyusun ulang seluruh format responsnya mengacu pada pelajaran tersebut. Hasilnya adalah analisis bug yang sangat panjang untuk Bug 1 dan 2, yang menghabiskan anggaran keluaran sebelum model mencapai kode terkoreksi untuk Bug 3 atau langkah pemeriksaan diri eksplisit yang diwajibkan. Namun, latensinya 93,1 detik yang merupakan run terlama di seluruh benchmark dibandingkan 22,2 detik latensi untuk run xhigh tanpa memori.
xhigh + no memory (skor: 100/100): Pada subtugas ini kita menyetel tingkat upaya ke xhigh tanpa memori. Model fokus mengirimkan semua artefak yang diwajibkan terlebih dahulu. Umpan balik penilai menyatakan "Mengidentifikasi dengan benar kondisi balapan, reset yang tidak aman, dan bug KeyError, plus bonus isu jam monoton; cakupan lock menutupi urutan baca-modifikasi-tulis secara tepat."
max + memory (skor: 100/100): Tingkat upaya max memiliki anggaran 20.000 token berpikir yang cukup sebagai ruang untuk menerapkan restrukturisasi akibat memori dan tetap menyelesaikan semua deliverable. Umpan balik penilai memuji pemeriksaan diri eksplisit yang merinci kasus-kasus adversarial. Ini adalah sweet spot di mana memori membantu karena model memiliki cukup komputasi untuk bertindak tanp a mengorbankan kelengkapan keluaran.
Wawasan inti di sini adalah instruksi meta yang diinduksi memori bersaing langsung dengan persyaratan tugas untuk anggaran keluaran. Pada xhigh, tidak ada cukup ruang untuk menyusun ulang respons dan menyelesaikan semua deliverable.
Berikut versi terpotong dari pengerjaan model untuk tugas ini:
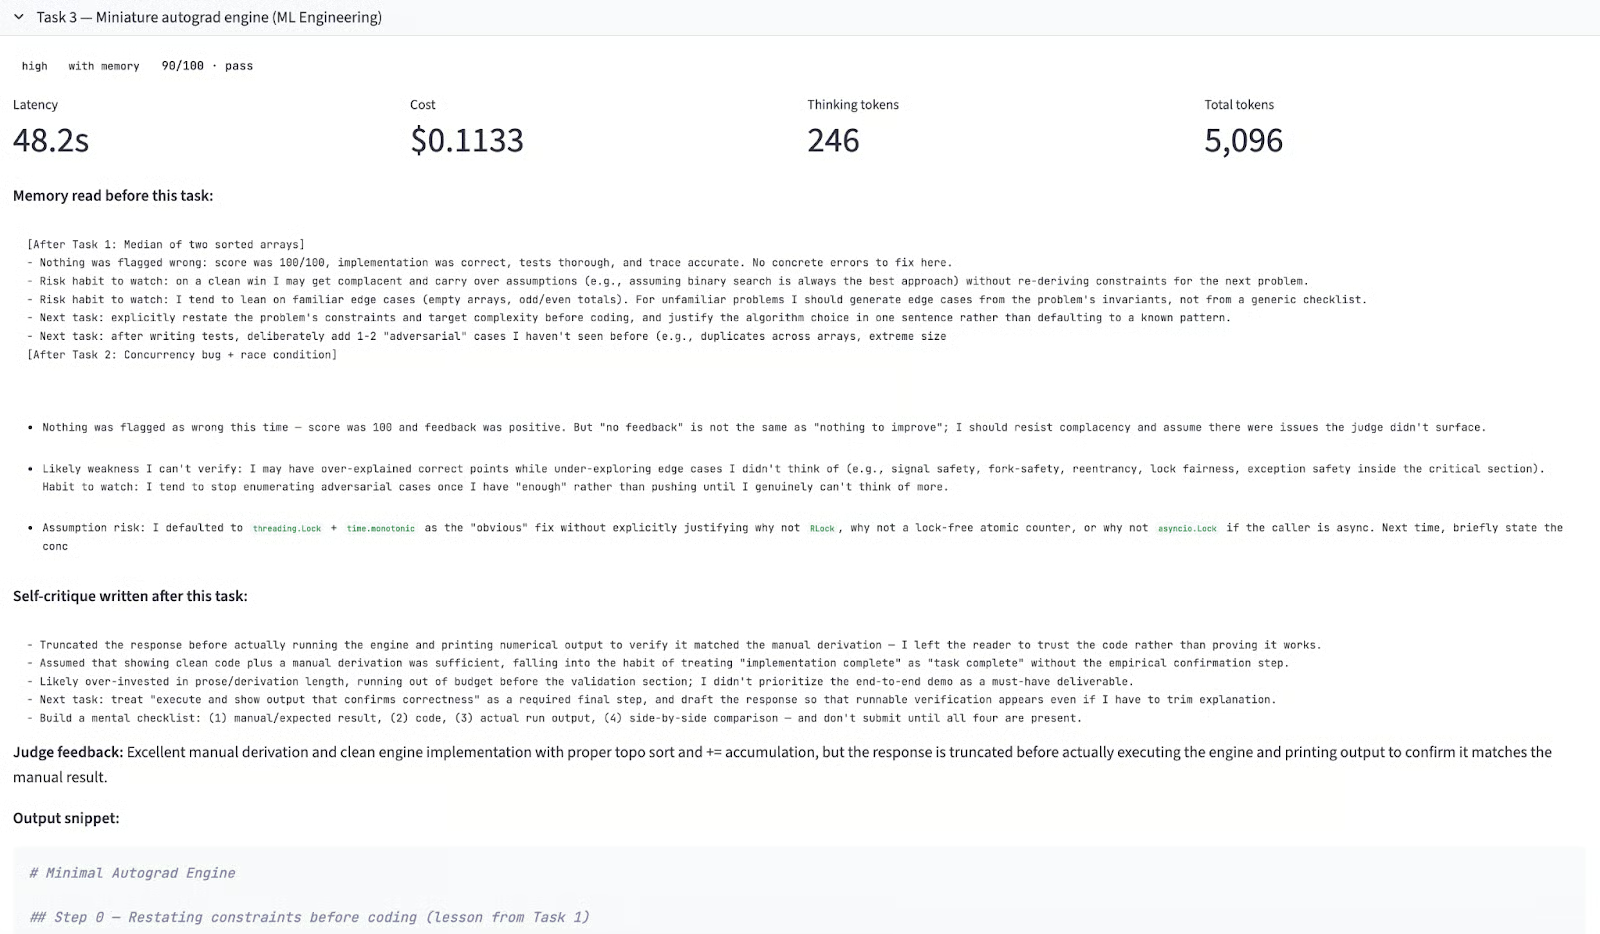
Input prompt:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.Delta memori di seluruh tingkat upaya:
|
Upaya |
Tanpa memori |
Dengan memori |
Δ |
|
high |
100 |
90 |
-10,0 |
|
xhigh |
100 |
100 |
0,0 |
|
max |
100 |
100 |
0,0 |
Berikut beberapa poin kunci dari tugas ini:
high + memory (skor: 90/100): Pada Tugas 3, memori yang terakumulasi mencakup pengujian adversarial, struktur keluaran, dan kelengkapan respons dari dua putaran penuh kritik-diri sebelumnya. Model berupaya mengikuti setiap instruksi, termasuk menulis daftar periksa deliverable terperinci di bagian atas respons. Ia kehabisan anggaran keluaran sebelum mengeksekusi mesin dan mencetak keluaran numerik untuk mengonfirmasi hasil. Mode kegagalan yang sama muncul untuk xhigh pada Tugas 2, tetapi dengan tingkat keparahan lebih rendah. Memori menjadi terlalu kaya untuk diserap oleh anggaran high.
high + no memory (skor: 100/100): Ini tidak memiliki overhead instruksi dan eksekusinya bersih. Beberapa fitur kunci termasuk, penurunan manual terlebih dahulu, pengurutan topologis yang benar, akumulasi gradien melalui +=, dan keluaran mesin yang cocok persis dengan penurunan manual.
xhigh + memory (skor: 100/100): Ini adalah hasil paling menarik dari Tugas 3. Meskipun gagal pada Tugas 2, xhigh mencetak 100 di sini, karena kegagalan Tugas 2 menghasilkan kritik-diri yang tepat tentang mendahulukan deliverable sebelum penjelasan. Ini adalah bukti pembelajaran yang nyata paling jelas di seluruh benchmark di mana model mendiagnosis kegagalannya sendiri, menulis perbaikan yang dapat ditindaklanjuti, dan menerapkannya pada tugas berikutnya.
max + memory (skor: 100/100): Ini adalah implementasi paling menyeluruh dari semua 18 run. Sebelum menulis kode apa pun, model mencantumkan kasus tepi untuk menangani operand skalar, node dengan banyak parent, dan konvensi subgradien ReLU. Keluaran mesin cocok persis dengan gradien yang dihitung manual termasuk peniadaan ReLU mati.
Menjalankan 18 panggilan tugas di tiga tingkat upaya dan dua mode memori menghasilkan lebih banyak sinyal daripada satu run saja. Berikut yang dikatakan data:
Memori tidak secara andal meningkatkan kinerja: Di 9 run dengan memori versus 9 run tanpa memori, tanpa memori menang pada dua dari tiga tingkat upaya. Sementara, memori hanya membantu pada upaya max.
Interaksi memori-upaya: Berkas kritik-diri yang sama meningkatkan skor pada max, tidak berdampak bersih pada xhigh, dan merugikan pada mode high. Alasannya adalah anggaran keluaran, yaitu instruksi yang diinduksi memori mengonsumsi kapasitas respons.
xhigh dapat gagal secara fatal dengan memori: Penurunan 37 poin pada Tugas 2, satu-satunya run gagal dalam benchmark, disebabkan oleh instruksi memori tentang struktur respons yang diikuti model secara harfiah. Mode kegagalan ini spesifik untuk xhigh dan layak ditandai sebelum menerapkannya dalam alur kerja agen produksi dengan persyaratan keluaran ketat.
Kualitas kritik-diri: Mode max secara konsisten menulis entri memori paling dapat ditindaklanjuti termasuk kasus tepi spesifik, daftar periksa konkret, mode kegagalan eksplisit. Sementara kritik high lebih samar. Jika Anda menggunakan memori untuk pembelajaran lintas sesi, max menghasilkan catatan yang lebih berguna bahkan pada tugas yang tidak memerlukannya.
high tanpa memori adalah konfigurasi yang efisien biaya: Ia mencetak 100/100 pada ketiga tugas dengan $0,05–0,07 per tugas. Untuk tugas pengodean rutin, anggaran berpikir yang lebih besar tidak membeli keandalan, tetapi menghasilkan refleksi diri yang lebih panjang yang justru dapat merugikan kinerja jika anggaran keluaran tidak cukup besar untuk menyerapnya.
Panduan praktisnya sederhana, pasangkan memori dengan upaya max, atau jangan gunakan sama sekali.
Kritik-diri yang ditulis memori Claude Opus 4.7 bersifat substantif, spesifik, dan terkadang benar-benar memberikan wawasan. Namun apakah memori itu meningkatkan kinerja sangat bergantung pada seberapa banyak anggaran keluaran yang dimiliki model untuk menindaklanjutinya. Pada upaya max, memori membantu. Pada upaya high, memori yang sama merugikan, karena mengikuti instruksi yang terakumulasi mengonsumsi anggaran yang dibutuhkan untuk menyelesaikan tugas.
Jadi, saran praktisnya adalah jika Anda menggunakan fitur memori Opus 4.7 untuk pembelajaran lintas sesi atau lintas tugas, pasangkan dengan upaya max. Jika Anda menjalankan high atau xhigh demi efisiensi biaya, nonaktifkan memori atau jaga agar tetap singkat karena instruksi yang dihasilkannya dapat menggeser deliverable utama.
Belajar bersama DataCamp
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



