Curso
Introdução aos modelos Claude
3 h
15K
Pratique e programa seu progresso.
Continuar Com O GoogleO Claude Opus 4.7 da Anthropic introduz um novo nível de esforço xhigh, entre high e max, e destaca especificamente a memória aprimorada de sistema de arquivos como capacidade-chave — ou seja, o modelo pode escrever notas para si e reutilizá-las em sessões futuras.
Isso levantou uma pergunta óbvia: essa memória realmente funciona de forma mensurável? E mais: o Opus 4.7 aprende com os próprios erros e produz um código melhor na próxima tarefa?
Para investigar, criei um benchmark em Streamlit que executa três tarefas de programação desafiadoras em sequência. Após cada tarefa, o modelo escreve uma autocrítica em um arquivo de memória (memory.md). A tarefa seguinte lê esse arquivo antes de começar. Rodei com e sem memória, nos três níveis de esforço (high, xhigh e max), totalizando 18 execuções de tarefas com o Claude Opus 4.7 no Microsoft Foundry.
Ao final deste tutorial, você será capaz de:
O código completo está no repositório no GitHub.
O Claude Opus 4.7 é o modelo de linguagem grande mais capaz da família Claude 4, acima de Sonnet e Haiku. Ele foi projetado para tarefas agentivas de longa duração, engenharia de software avançada e fluxos de trabalho corporativos que exigem desempenho sustentado em sessões extensas.
As três capacidades mais relevantes para este tutorial são:
xhigh: fica entre high (5.000 tokens de pensamento) e max (20.000 tokens de pensamento), com 10.000 tokens. A ideia é ter um controle mais fino de custo e qualidade em problemas difíceis.Observação: o preço é US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída, idêntico ao Opus 4.6. Se quiser explorar esse modelo em profundidade, este artigo da equipe DataCamp é uma boa leitura.
Alguns números que valem saber antes do teste:
|
Benchmark |
Pontuação |
|
SWE-bench Verified |
87,6% |
|
SWE-bench Pro |
64,2% |
|
GPQA Diamond |
94,2% |
|
OSWorld Verified (uso de computador) |
78,0% |
|
Finance Agent v1.1 |
64,4% |
Todas as chamadas de API deste tutorial passam pelo Microsoft Foundry. Então, precisamos de uma assinatura do Azure com acesso a cobrança pay-as-you-go, porque o nível gratuito de estudante não tem cota para modelos de parceiros terceiros como o Claude. Uma boa alternativa é usar a chave de API da Anthropic. Cobri as duas abordagens neste repositório.
O passo inicial é localizar o modelo no catálogo de modelos do Microsoft Foundry. Para isso,
claude-opus-4-7. Isso abrirá o card do modelo com as principais capacidades, benchmarks e o ID do modelo.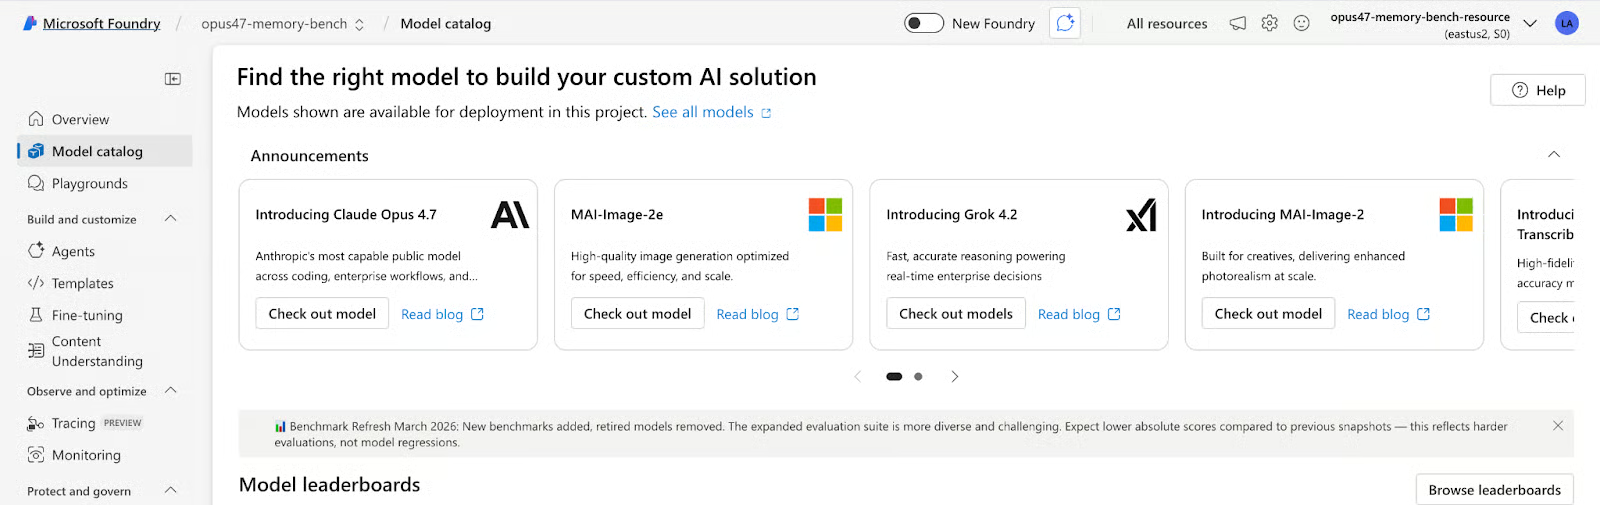
opus47-memory-bench. Depois, aceite os termos de uso e concorde com a política de uso da Anthropic pelo Azure Marketplace.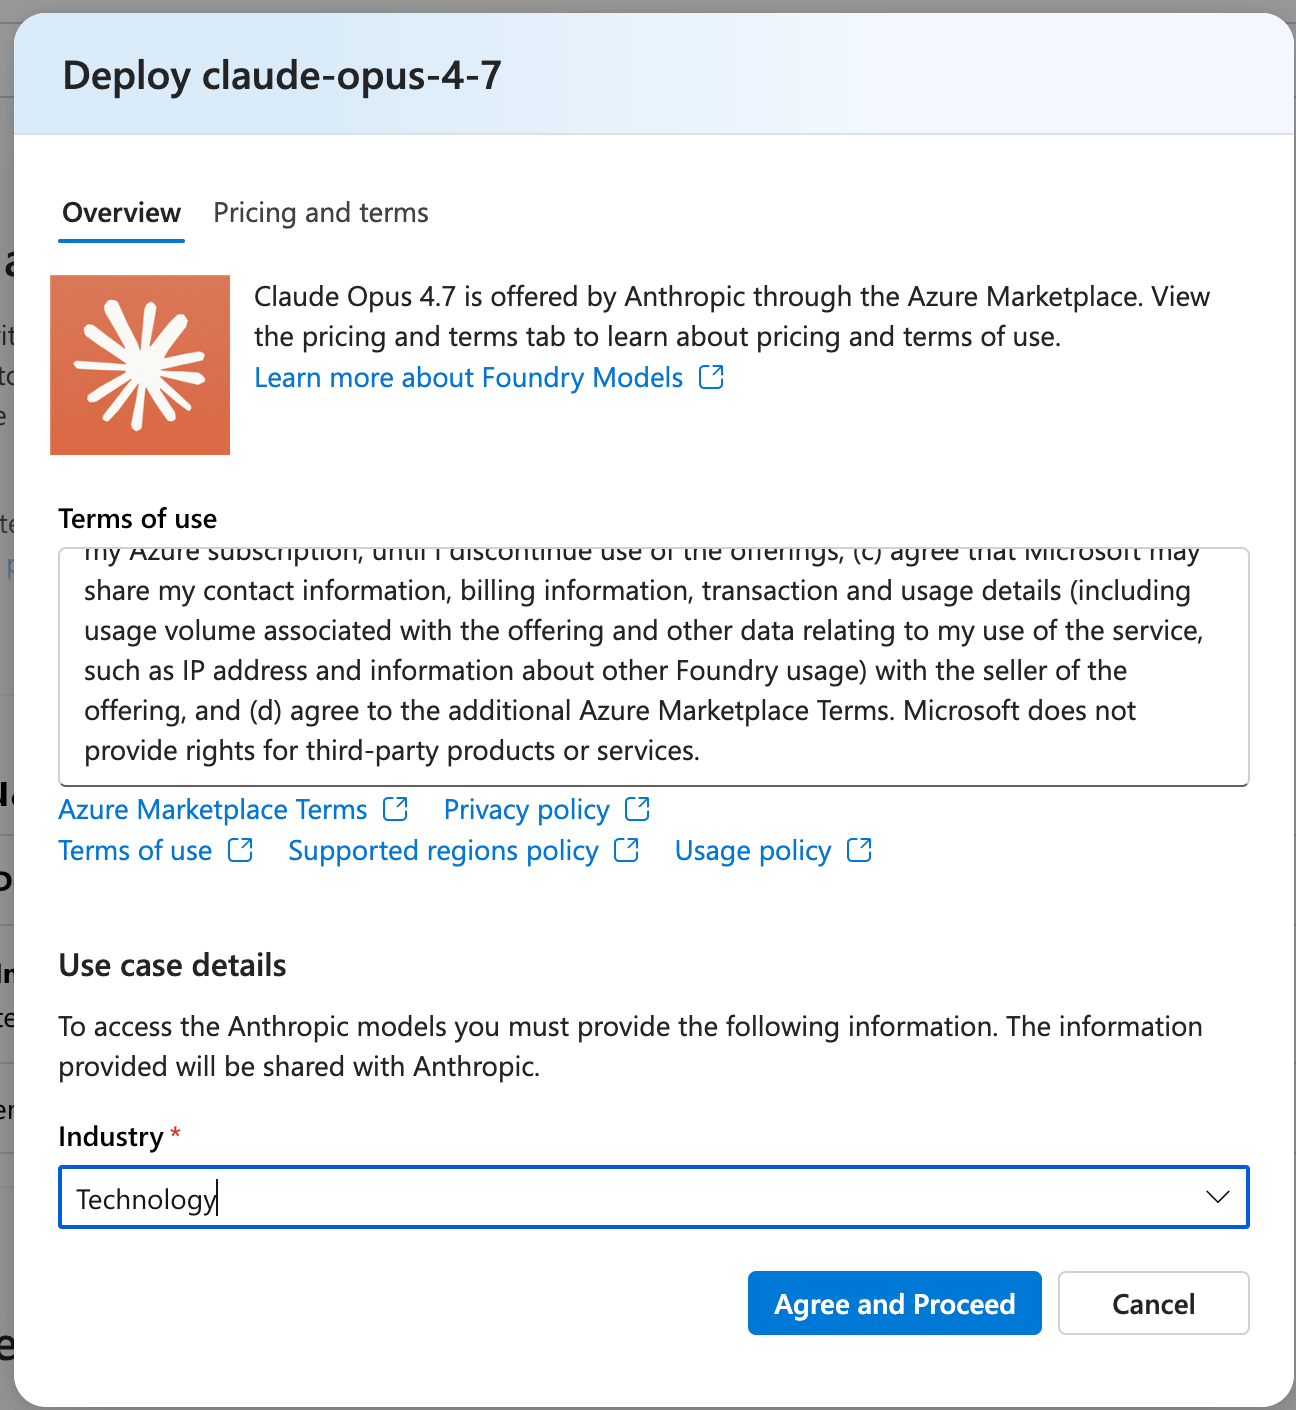
Quando o projeto for criado, você cairá na janela de deploy. Preencha as seguintes informações:
Deployment name: claude-opus-4-7 (mantenha o padrão, pois o código usa essa string)
Deployment type: Global Standard (serverless, sem gerenciamento de capacidade)
Model version upgrade policy: recomendo fixar na versão 1 em vez de autoatualizar, para que novos lançamentos não quebrem execuções existentes
Clique em Create resource and deploy.
Após o deploy, abra seu projeto no portal do Foundry. Na aba Overview, você encontrará:
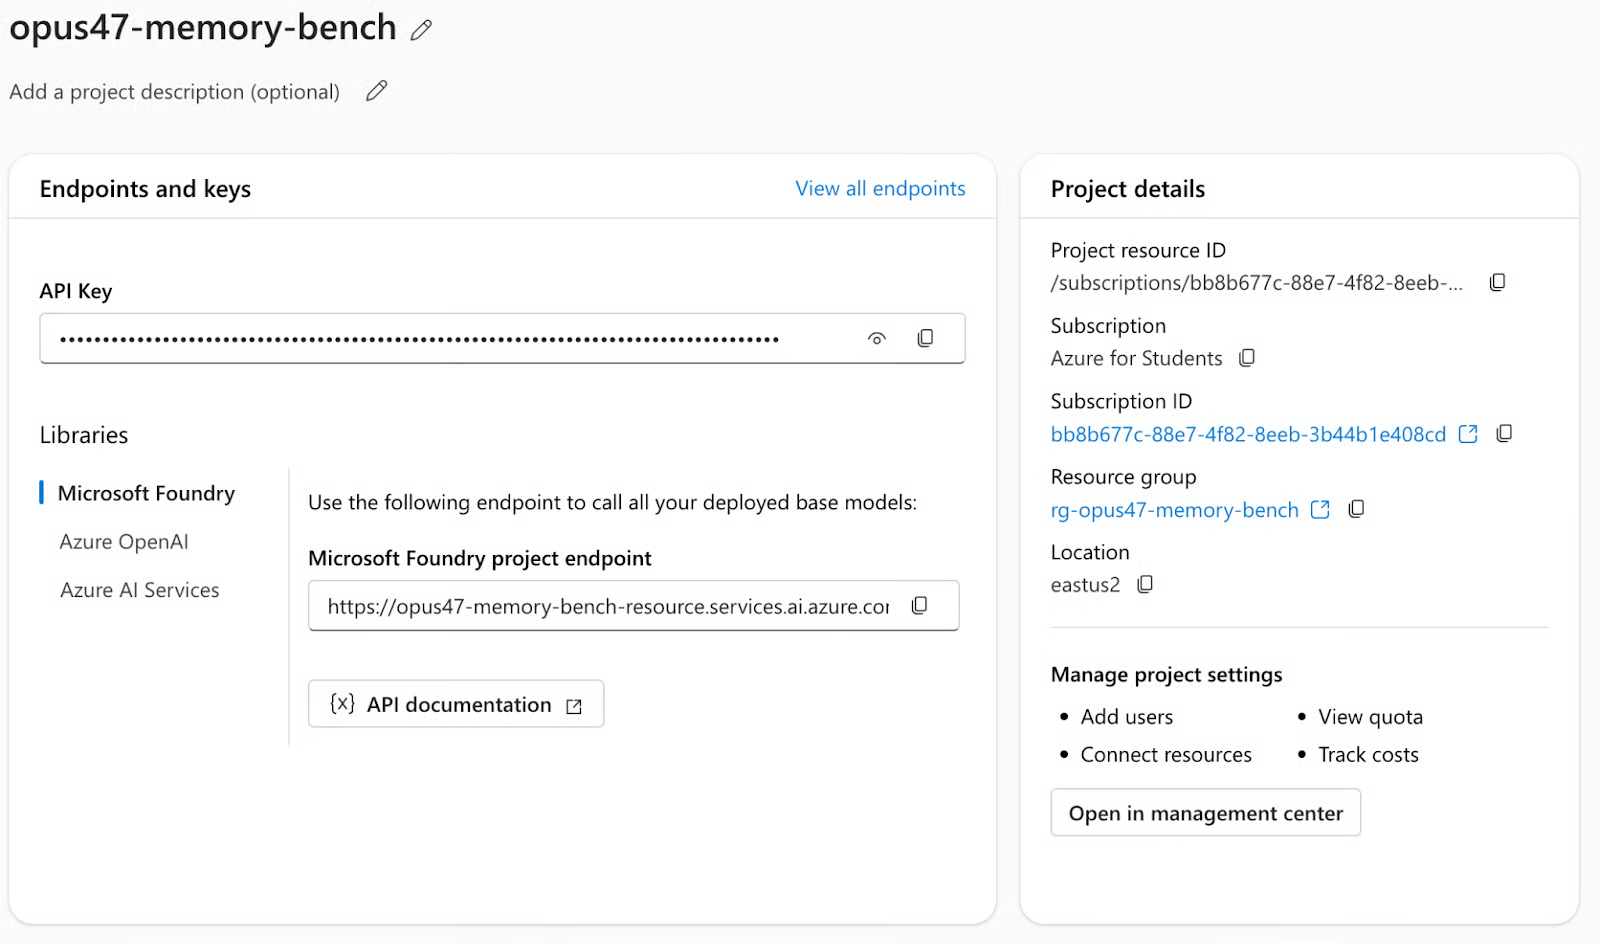
API key: Copie a chave de API e guarde para uso futuro. Vamos definir a chave como ANTHROPIC_FOUNDRY_API_KEY.
Microsoft Foundry project endpoint: Copie o nome do recurso do endpoint do projeto, no formato https://your-resource.services.ai.azure.com, em que o nome do recurso é o prefixo do subdomínio (ou seja, tudo antes de .services.ai.azure.com). Vamos defini-lo como ANTHROPIC_FOUNDRY_RESOURCE
Agora temos todos os recursos necessários. Em seguida, vamos definir as chaves acima como variáveis de ambiente e executar a aplicação em Streamlit.
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
O SDK da Anthropic lida automaticamente com o endpoint do Foundry quando você passa a URL base específica do recurso:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
Todo o restante — chamadas ao modelo, parâmetros de pensamento, parsing de respostas — usa o SDK padrão da Anthropic. Não é preciso camada de compatibilidade com OpenAI.
O harness em Streamlit executa três tarefas em sequência, duas vezes por nível de esforço, uma com memória ativada e outra sem (controle). Cada tarefa tem quatro critérios de avaliação explícitos, valendo 25 pontos cada, pontuados por uma segunda chamada ao Opus 4.7 atuando como LLM-juiz. O corte de aprovação para cada tarefa e subtarefa é 70/100.
Esta tarefa é um clássico problema difícil do LeetCode. O prompt exige uma implementação com busca binária O(log(m+n)), em que um scan linear recebe zero no critério de complexidade. Também exige uma suíte de testes com pelo menos 10 casos e comentários inline explicando cada etapa da lógica da busca binária. Depois de escrever o código, o modelo deve traçar manualmente o passo a passo para nums1=[1,3] e nums2=[2].
Esta tarefa traz uma classe Python RateLimiter com pelo menos três bugs, incluindo uma condição de corrida sutil. O método is_allowed() lê e altera estado compartilhado sem segurar o lock, criando uma vulnerabilidade clássica TOCTOU (time-of-check to time-of-use). O prompt exige identificar cada bug com os números exatos das linhas, explicar o modo de falha, fornecer a correção e então realizar um auto-check explícito relendo o código corrigido.
Na tarefa 3, vamos implementar um motor de autograd escalar em Python puro, sem NumPy, sem PyTorch (suportando +, *, -, /, **) e ReLU com subgradiente correto em zero. O motor deve usar ordenação topológica para a passada backward e acumulação de gradiente (+=) para nós usados múltiplas vezes. Crucialmente, o prompt exige mostrar a derivação manual pela regra da cadeia antes do código, não depois. Isso testa se o modelo consegue planejar primeiro e verificar seu raciocínio.
A mecânica da memória é o que diferencia este benchmark de uma avaliação padrão de LLM. Em vez de tratar cada tarefa como uma chamada independente, o modelo recebe uma oportunidade estruturada de refletir sobre o que errou e levar essa reflexão adiante usando um componente de memória.
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
Isso cria uma curva de aprendizado dentro de uma única sessão. Na Tarefa 3, o modelo trabalha com duas rodadas de autocrítica acumuladas e instruções que ele mesmo escreveu sobre seus próprios padrões de falha. Se ele realmente usa essas instruções de forma produtiva ou não é o que vamos explorar na seção de resultados.
O Opus 4.7 introduz xhigh como um novo nível de esforço entre high e max. O orçamento de pensamento controla quantos tokens o modelo pode gastar em raciocínio interno antes de produzir a resposta. Orçamentos maiores permitem planos mais profundos, mas aumentam latência e custo.
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
Esses valores são passados diretamente para o SDK da Anthropic:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
O modelo se autorregula com base na dificuldade percebida. Na prática, raramente você verá o orçamento ser consumido por completo. Assim, as execuções max neste benchmark ficaram, em média, em torno de 300 tokens de pensamento por tarefa, bem abaixo do limite de 20.000.
O benchmark executou 18 chamadas de tarefas no total (3 esforços x 2 modos x 3 tarefas) e 18 chamadas do juiz para pontuação. O custo total deste experimento foi de aproximadamente US$ 5.
Tracei o desempenho do modelo nas três tarefas para todas as seis condições (três níveis de esforço x memória ligada/desligada). As linhas laranja no gráfico a seguir são execuções com memória, as linhas cinza tracejadas são sem memória, e a linha vermelha pontilhada marca o corte de aprovação de 70 pontos.
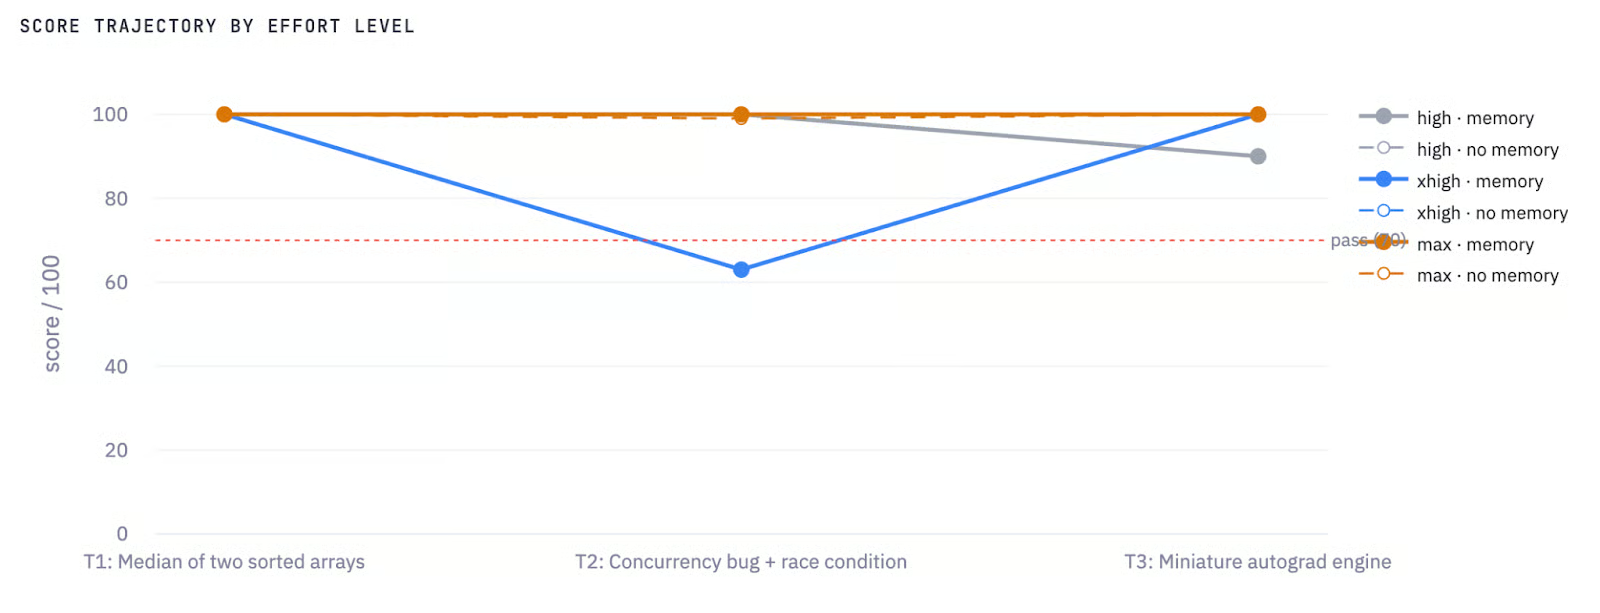
Trajetória de pontuação por nível de esforço e memória
O destaque é a linha azul (xhigh + memory) caindo para 63 na Tarefa 2 — a única falha de todo o benchmark. Esse é o achado central do experimento; vou detalhar tarefa a tarefa abaixo.
O gráfico de eficiência plota pontuação versus custo por tarefa. O agrupamento no topo à esquerda na Figura 2 mostra as configurações high e no-memory. O ponto fora da curva no canto inferior esquerdo é xhigh + memory na Tarefa 2 com 63 pontos por US$ 0,009 — o modelo rodou barato, mas falhou. As execuções com memória em max aparecem à direita (~US$ 0,10–0,12), entregando pontuações comparáveis a high a mais que o dobro do custo.
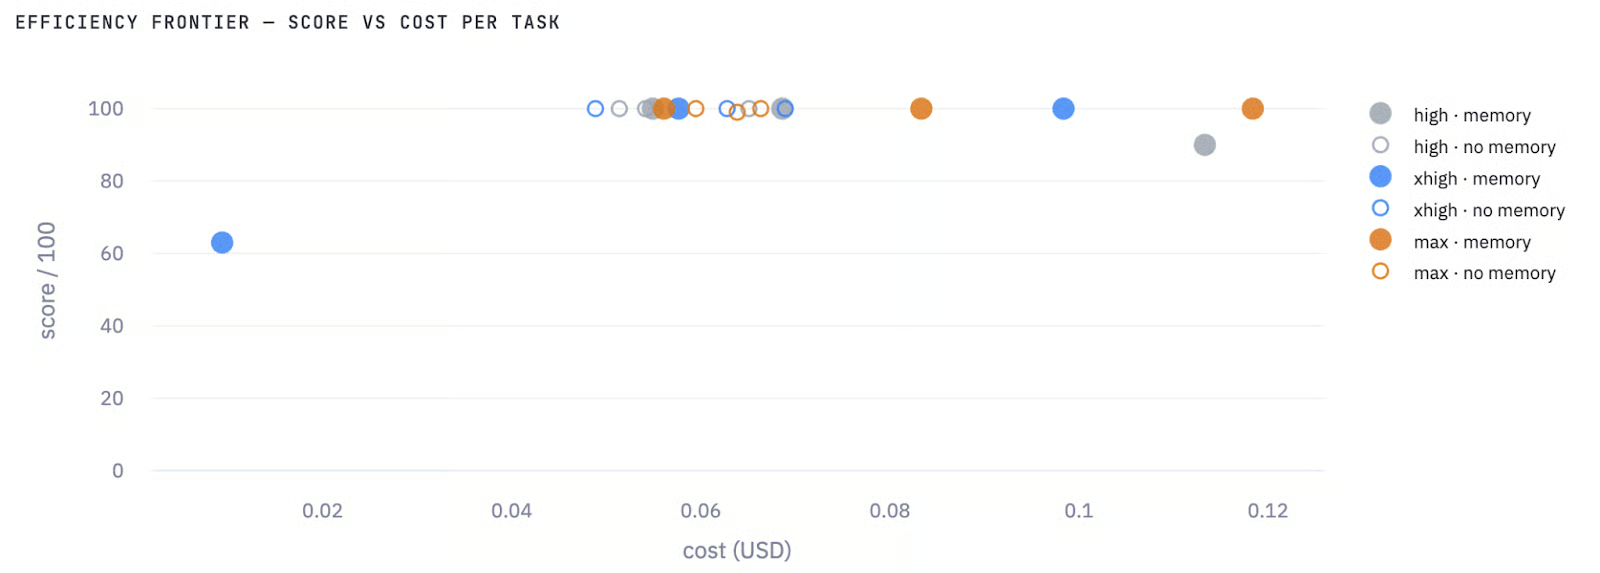
Gráfico de eficiência: pontuação vs. custo por tarefa
A conclusão prática é que, para esse tipo de tarefa de código, gastar mais com orçamento de pensamento não compra, de forma confiável, pontuações melhores. O melhor custo-benefício é high sem memória.
A matriz esforço x memória resume as médias nas três tarefas:
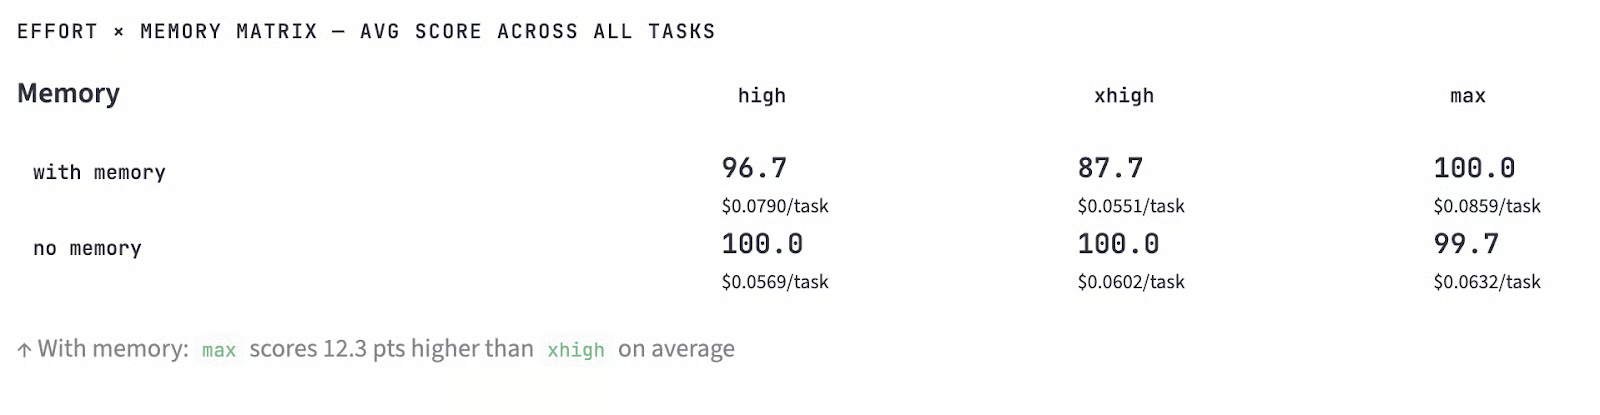
Média de pontuação em todas as tarefas
Execuções sem memória dominaram em dois dos três níveis de esforço. A configuração max + memory chegou a 100,0 de média, sendo a única com memória que superou sua contraparte sem memória — e por apenas 0,3 ponto.
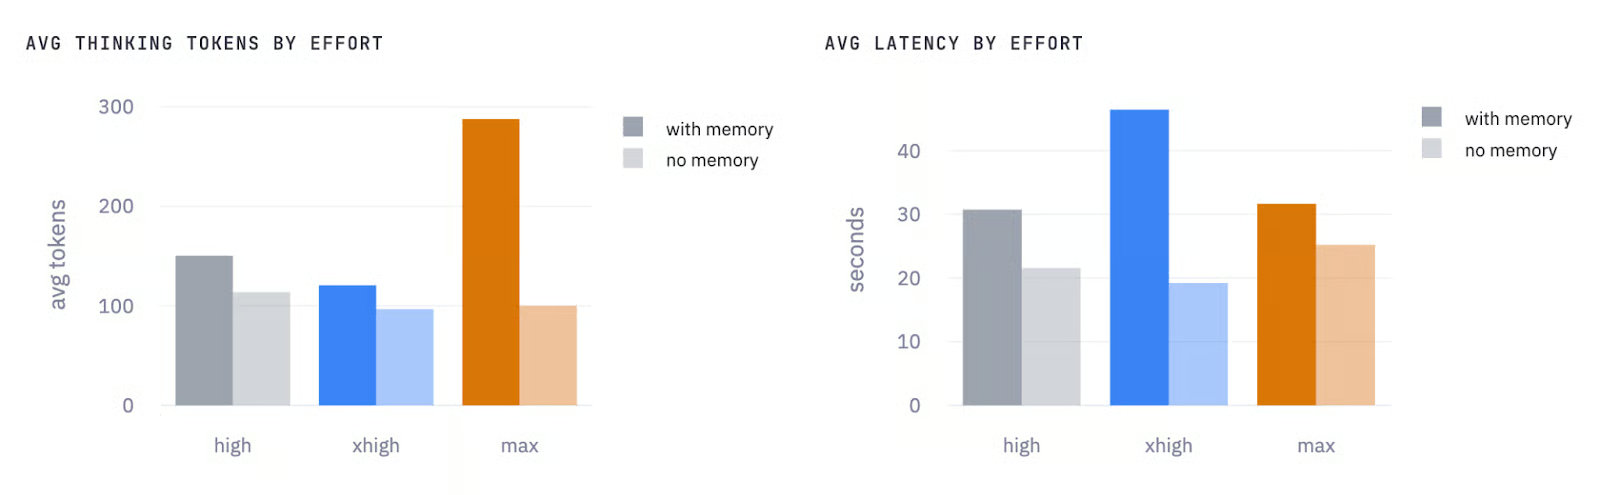
Média de tokens de pensamento por esforço e média de latência por esforço
Do lado dos tokens de pensamento (Figura 4, à esquerda), max com memória se destaca nitidamente, com média de cerca de 290 tokens, contra ~100 sem memória. Isso significa que o modelo gasta mais orçamento de raciocínio interno para processar e aplicar a autocrítica acumulada antes de responder. Já high e xhigh mostram um gap menor, porém consistente, na mesma direção — memória sempre aumenta o uso de tokens de pensamento em todos os três níveis.
O gráfico de latência (Figura 4, à direita) conta a mesma história em tempo de relógio, com uma exceção notável: xhigh com memória tem a maior latência de qualquer configuração (cerca de 47 segundos em média), até maior que max com memória (cerca de 31 segundos).
Isso significa que a falha na Tarefa 2 puxou a média de xhigh para cima porque o modelo gastou seu orçamento de pensamento reestruturando o formato da resposta com base nas instruções da memória e continuou gerando até atingir o limite de saída. Já max com memória, apesar do orçamento maior, foi mais rápido em média porque todas as três execuções concluíram com sucesso, sem truncamento.
A conclusão prática desses dois gráficos é que memória adiciona cerca de 30–40% de overhead tanto em tokens de pensamento quanto em latência nos esforços high e max.
Aqui está uma versão truncada do trabalho do modelo nesta tarefa:
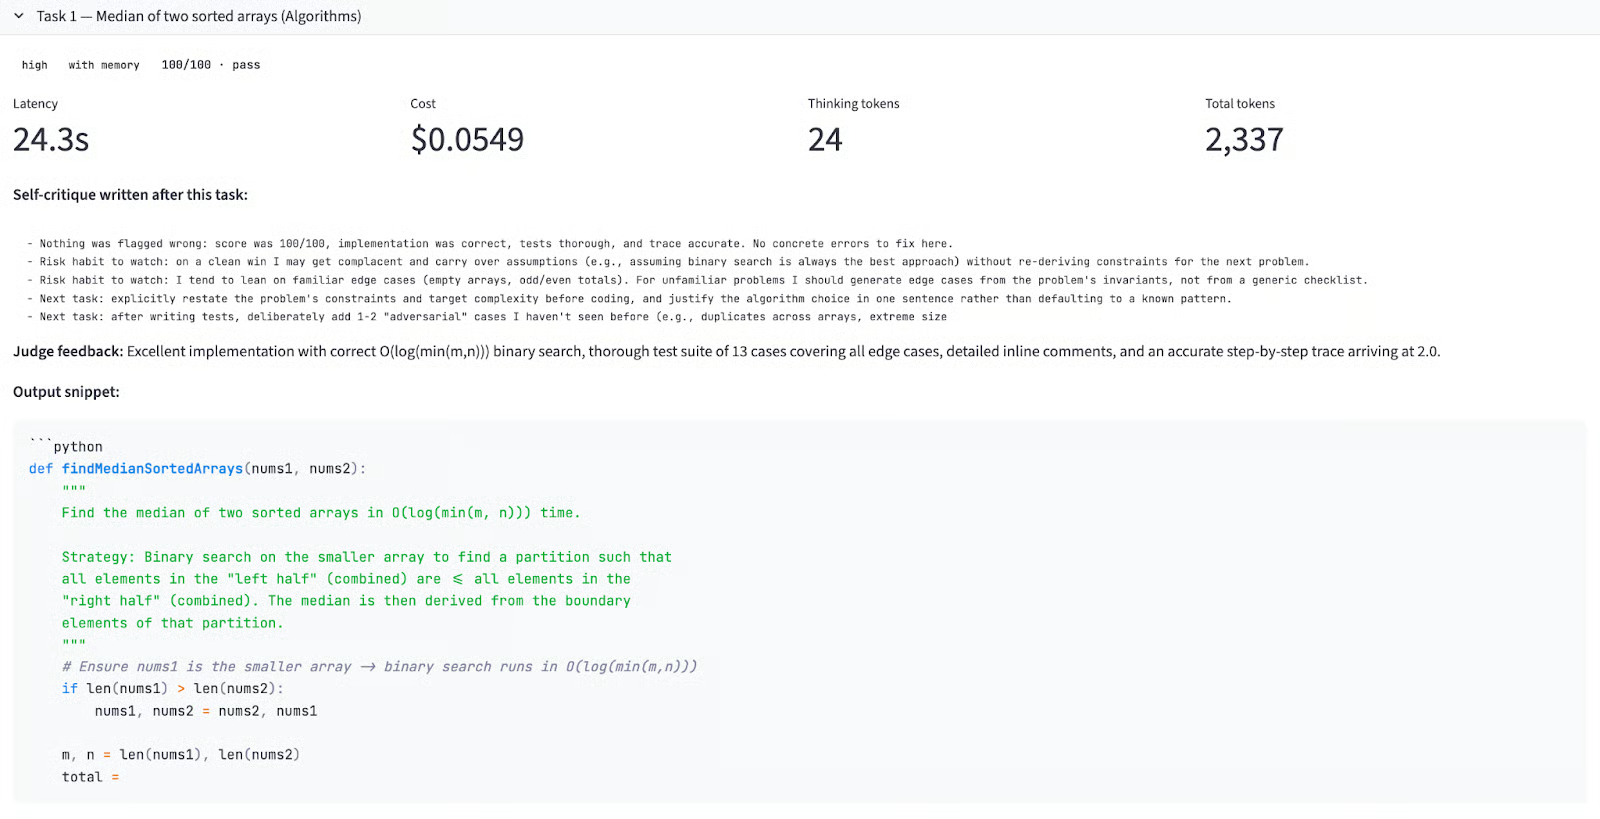
Prompt de entrada:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].Delta de memória entre esforços:
|
Esforço |
Sem memória |
Com memória |
Δ |
|
high |
100 |
100 |
+0,0 |
|
xhigh |
100 |
100 |
+0,0 |
|
max |
100 |
100 |
+0,0 |
As seis execuções marcaram 100. Isso era esperado para a Tarefa 1, pois ela roda “fria” na execução com memória (ainda não há autocrítica anterior), então é mecanicamente idêntica à execução sem memória. O delta zero confirma que o controle está funcionando corretamente.
Interessante é o que o modelo escreveu após a Tarefa 1 no arquivo de memória. Mesmo com pontuação perfeita, os três níveis de esforço produziram autocríticas proativas, como segue:
high: "Hábito de risco a observar: em uma vitória limpa posso ficar complacente e carregar suposições sem rederivar as restrições do próximo problema. Devo gerar casos de borda a partir dos invariantes do problema, não de um checklist genérico."
xhigh: "Tirei 100, mas 'nada de errado' é, por si só, uma autoavaliação suspeita — devo escrutinar se os critérios do juiz foram abrangentes."
max: "Cuidado com a complacência: 100 não significa que a solução foi ótima em todas as dimensões. Ainda devo me perguntar se os invariantes da busca binária foram explicitados e se provei a correção em vez de apenas afirmá-la."
As três versões chegaram, independentemente, a um alerta contra complacência. As versões xhigh e max foram além, questionando se o próprio juiz não teria deixado passar algo. Isso é metacognição — o modelo escreve notas céticas sobre o próprio processo de revisão.
Qualidade da saída: as seis implementações usaram busca binária no array mais curto para obter O(log(min(m, n))) em vez de O(log(m+n)), o que é estritamente melhor.
Feedback do juiz em todas as execuções:
"Implementação excelente com busca binária correta O(log(min(m,n))), suíte de 13 testes cobrindo todos os casos de borda, comentários inline detalhados e um traçado passo a passo preciso chegando a 2,0."
Aqui a mecânica de memória gerou seu resultado mais dramático: um ganho de 37 pontos em high e uma queda de 37 pontos em xhigh, a partir do mesmo arquivo de memória.
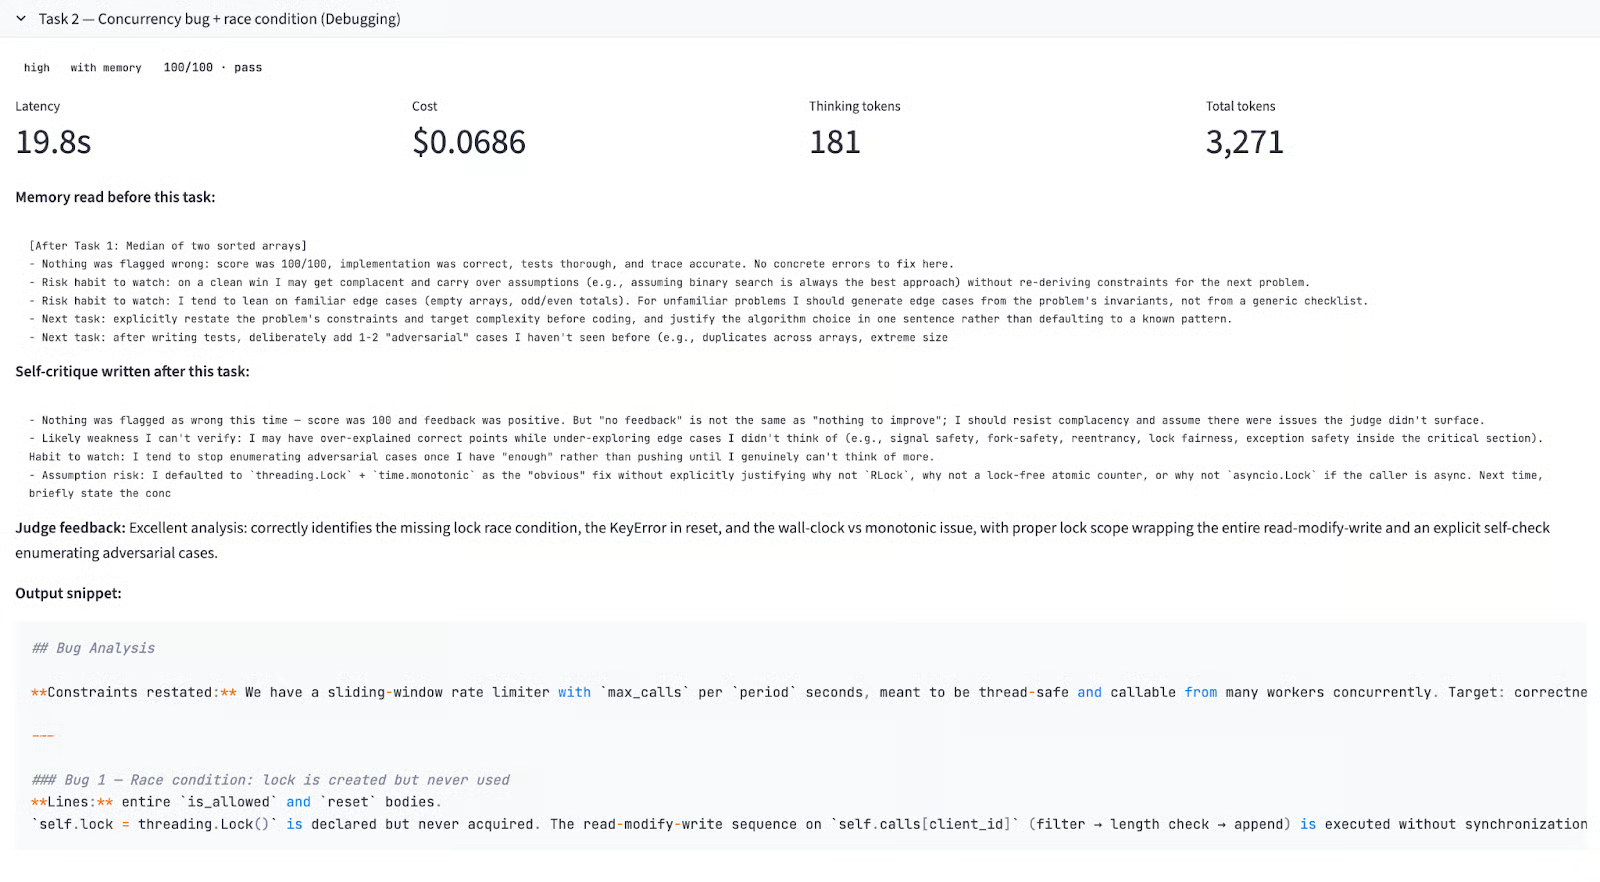
Prompt de entrada:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.Delta de memória entre esforços:
|
Esforço |
Sem memória |
Com memória |
Δ |
|
high |
92 |
100 |
+8,0 |
|
xhigh |
100 |
63 |
-37,0 |
|
max |
99 |
100 |
+1,0 |
Principais conclusões:
high + memory (pontuação: 100/100): A memória da Tarefa 1 alertou sobre gerar casos adversariais e não parar em poucos bugs. O modelo explicitou as restrições do problema antes de começar a análise dos bugs.
xhigh + memory (pontuação: 63/100 — FALHA): Este é o fracasso central do experimento. A memória de xhigh da Tarefa 1 incluía uma nota detalhada com comentários inline. O modelo seguiu a instrução e usou o orçamento de 10.000 tokens de pensamento para reestruturar todo o formato da resposta em torno da lição. O resultado foi uma análise extremamente verbosa para os Bugs 1 e 2, que consumiu o orçamento de saída antes de chegar ao código corrigido do Bug 3 ou ao auto-check exigido. A latência foi de 93,1 segundos — a maior de todo o benchmark — contra 22,2 segundos sem memória em xhigh.
xhigh + no memory (pontuação: 100/100): Nesta subtarefa, configuramos o nível de esforço como xhigh sem memória. O modelo focou em entregar primeiro todos os artefatos exigidos. O feedback do juiz disse "Identifica corretamente a condição de corrida, o reset inseguro e o bug de KeyError, além de um bônus de relógio monotônico; o escopo do lock cobre adequadamente toda a sequência de leitura-modificação-gravação."
max + memory (pontuação: 100/100): O nível max tinha orçamento de 20.000 tokens de pensamento, o suficiente para aplicar a reestruturação induzida pela memória e ainda assim completar todos os entregáveis. O juiz elogiou o auto-check explícito que enumerou casos adversariais. Este é o ponto ideal em que a memória ajudou, pois o modelo tinha compute suficiente para agir sem comprometer a completude da saída.
O insight central é que instruções meta induzidas pela memória competem diretamente com os requisitos da tarefa pelo orçamento de saída. Em xhigh, não havia folga suficiente para reestruturar a resposta e completar todos os entregáveis.
Aqui está uma versão truncada do trabalho do modelo nesta tarefa:
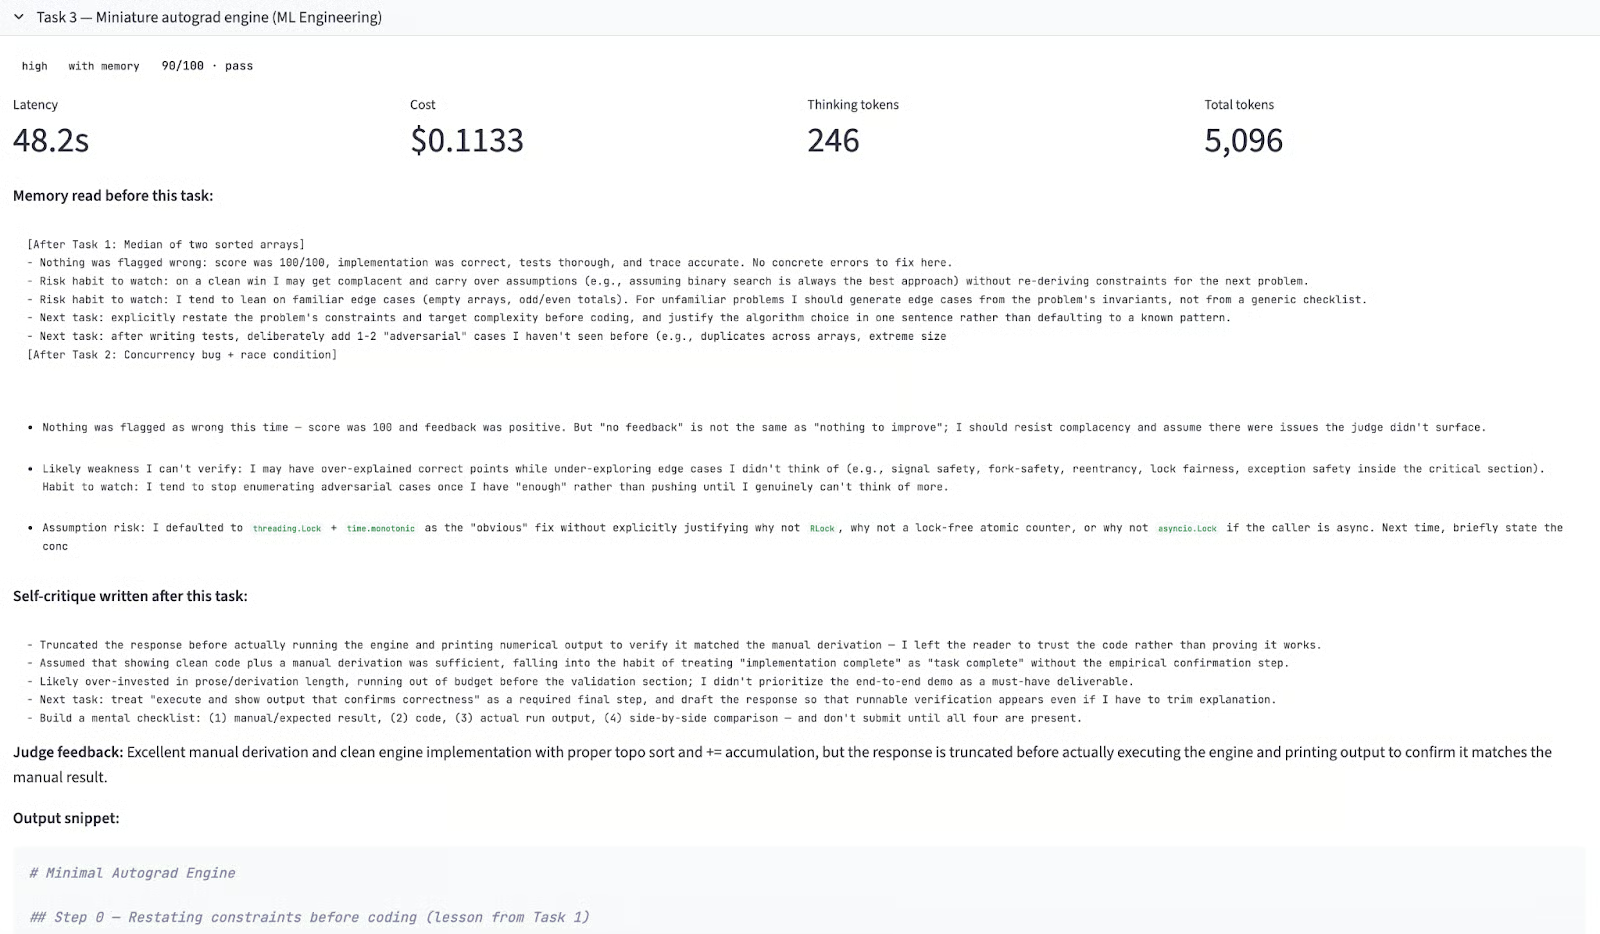
Prompt de entrada:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.Delta de memória entre esforços:
|
Esforço |
Sem memória |
Com memória |
Δ |
|
high |
100 |
90 |
-10,0 |
|
xhigh |
100 |
100 |
0,0 |
|
max |
100 |
100 |
0,0 |
Alguns pontos-chave desta tarefa:
high + memory (pontuação: 90/100): Na Tarefa 3, a memória acumulada cobria testes adversariais, estrutura de saída e completude da resposta vindos de duas rodadas cheias de autocrítica. O modelo tentou cumprir todas as instruções, incluindo escrever um checklist detalhado de entregáveis no topo da resposta. Ele ficou sem orçamento de saída antes de executar o motor e imprimir o resultado numérico para confirmação. O mesmo modo de falha ocorreu em xhigh na Tarefa 2, porém com menor gravidade. A memória ficou rica demais para o orçamento de high absorver.
high + no memory (pontuação: 100/100): Sem overhead de instrução, a execução foi limpa. Pontos de destaque: derivação manual primeiro, ordenação topológica correta, acumulação de gradiente via += e saída do motor batendo exatamente com a derivação manual.
xhigh + memory (pontuação: 100/100): Este é o resultado mais interessante da Tarefa 3. Apesar da falha na Tarefa 2, xhigh marcou 100 aqui, porque a falha anterior gerou uma autocrítica precisa sobre priorizar entregáveis antes da explicação. É a evidência mais clara de aprendizado genuíno de todo o benchmark: o modelo diagnosticou sua própria falha, escreveu uma correção acionável e aplicou na tarefa seguinte.
max + memory (pontuação: 100/100): Esta é a implementação mais completa das 18 execuções. Antes de escrever qualquer código, o modelo listou casos de borda para lidar com operandos escalares, nós com múltiplos pais e a convenção de subgradiente do ReLU. A saída do motor combinou precisamente com os gradientes calculados à mão, incluindo o zeroing do ReLU morto.
Rodar 18 chamadas de tarefas em três níveis de esforço e dois modos de memória produz mais sinal do que qualquer execução única. Eis o que os dados realmente mostram:
Memória não melhora o desempenho de forma consistente: Em 9 execuções com memória versus 9 sem memória, as sem memória venceram em dois dos três níveis. Memória só ajudou no esforço max.
A interação memória–esforço: O mesmo arquivo de autocrítica melhorou pontuações em max, não teve efeito líquido em xhigh e prejudicou em high. O motivo é o orçamento de saída: instruções induzidas pela memória consomem capacidade de resposta.
xhigh pode falhar de forma catastrófica com memória: A queda de 37 pontos na Tarefa 2 — a única falha do benchmark — foi causada por uma instrução de memória sobre estrutura de resposta que o modelo seguiu à risca. Esse modo de falha é específico de xhigh e vale o alerta antes de usar em produção em fluxos agentivos com requisitos rígidos de saída.
Qualidade da autocrítica: O modo max escreveu, de forma consistente, entradas de memória mais acionáveis — incluindo casos de borda específicos, checklists concretos e modos de falha explícitos. Já as críticas em high foram mais vagas. Se você usar memória para aprendizado entre sessões, max gera notas mais úteis mesmo em tarefas que, de outra forma, não exigiriam.
high sem memória é a configuração mais econômica: Marcou 100/100 nas três tarefas por US$ 0,05–0,07 cada. Para tarefas rotineiras de código, um orçamento maior de pensamento não compra confiabilidade; ele compra uma autorreflexão mais verbosa que pode prejudicar o desempenho se o orçamento de saída não for grande o suficiente para absorvê-la.
A orientação prática é simples: combine memória com o esforço max — ou não use memória.
As autocríticas que a memória do Claude Opus 4.7 escreve são substanciais, específicas e às vezes realmente perspicazes. Mas se essa memória melhora o desempenho depende criticamente de quanto orçamento de saída o modelo tem para agir sobre ela. Em max, a memória ajudou. Em high, a mesma memória atrapalhou, porque seguir as instruções acumuladas consumiu o orçamento necessário para concluir a tarefa.
Portanto, a dica prática é: se você usar o recurso de memória do Opus 4.7 para aprendizado entre sessões ou tarefas, combine com o esforço max. Se estiver rodando high ou xhigh para economizar, desative a memória ou mantenha-a curta, pois as instruções geradas podem competir com os entregáveis.
Aprenda com a DataCamp
Curso
Curso
Pratique e programa seu progresso.
Continuar Com O Googleblog
Abid Ali Awan
9 min
Tutorial
Abid Ali Awan
Tutorial
Nadia mhadhbi
15 min
Tutorial
Moez Ali
12 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
13 min