

Kurs
Claude Modellerine Giriş
3 sa
15K
Alıştırma and program your progress.
Google Ile Devam EdinAnthropic’in Claude Opus 4.7 sürümü, high ile max arasına konumlanan yeni bir xhigh çaba düzeyi sunuyor ve özellikle geliştirilmiş dosya sistemi belleğini temel bir yetenek olarak vurguluyor; yani model kendi kendine notlar yazıp bunları oturumlar arasında kullanabiliyor.
Bu bende bariz bir soruyu gündeme getirdi: Bellek gerçekten ölçülebilir bir biçimde çalışıyor mu? Ayrıca, Opus 4.7 kendi hatalarından öğrenip bir sonraki görevde daha iyi kod üretiyor mu?
Bu nedenle, art arda üç zorlu kodlama görevini çalıştıran bir Streamlit kıyaslama düzeneği oluşturdum. Her görevden sonra, model bir öz-eleştiriyi bir bellek dosyasına (memory.md) yazıyor. Bir sonraki görev başlamadan önce bu dosyayı okuyor. Bunu bellek açık/kapalı olacak şekilde, üç çaba düzeyinin tümünde (high, xhigh ve max) çalıştırdım; toplamda Microsoft Foundry üzerinde Claude Opus 4.7 ile 18 görev koşusu oldu.
Bu eğitim sonunda şunları yapabileceksiniz:
Tüm kod GitHub deposunda mevcuttur.
Claude Opus 4.7, Sonnet ve Haiku’nun üzerinde, Claude 4 ailesindeki en yetenekli büyük dil modelidir. Uzun süreli görev temelli süreçler, ileri seviye yazılım mühendisliği ve uzun oturumlar boyunca kalıcı performans gerektiren kurumsal iş akışları için tasarlanmıştır.
Bu eğitim açısından en ilgili üç yetenek şunlardır:
xhigh çaba düzeyi: high (5.000 düşünme token’ı) ile max (20.000 düşünme token’ı) arasında, 10.000 düşünme token’ında konumlanır. Amaç, zor problemler için maliyet-kalite kontrolünü daha ince ayarlamaktır.Not: Fiyatlandırma milyon başına giriş token’ı için 5 ABD doları ve çıkış token’ı için 25 ABD doları olup Opus 4.6 ile aynıdır. Bu modeli derinlemesine keşfetmek isterseniz, DataCamp ekibinin bu yazısı okunmaya değerdir.
Testten önce bilinmeye değer birkaç sayı:
|
Kıyaslama |
Puan |
|
SWE-bench Verified |
%87,6 |
|
SWE-bench Pro |
%64,2 |
|
GPQA Diamond |
%94,2 |
|
OSWorld Verified (bilgisayar kullanımı) |
%78,0 |
|
Finance Agent v1.1 |
%64,4 |
Bu eğitimdeki tüm API çağrıları Microsoft Foundry üzerinden geçer. Bu nedenle, kullanım başına ödeme faturalandırmasına erişimi olan bir Azure aboneliğine ihtiyacımız var; çünkü ücretsiz öğrenci katmanında Claude gibi üçüncü taraf ortak modellere kota bulunmuyor. Ancak iyi bir alternatif Anthropic’in API anahtarını kullanmaktır. Her iki yaklaşımı da bu depoda ele aldım.
Bu eğitimin ilk adımı, Microsoft Foundry Model kataloğu içinde modeli bulmaktır. Bunun için,
claude-opus-4-7 ifadesini arayın. Bu, temel yetenekleri, kıyaslamaları ve model kimliğini gösteren bir model kartı açacaktır.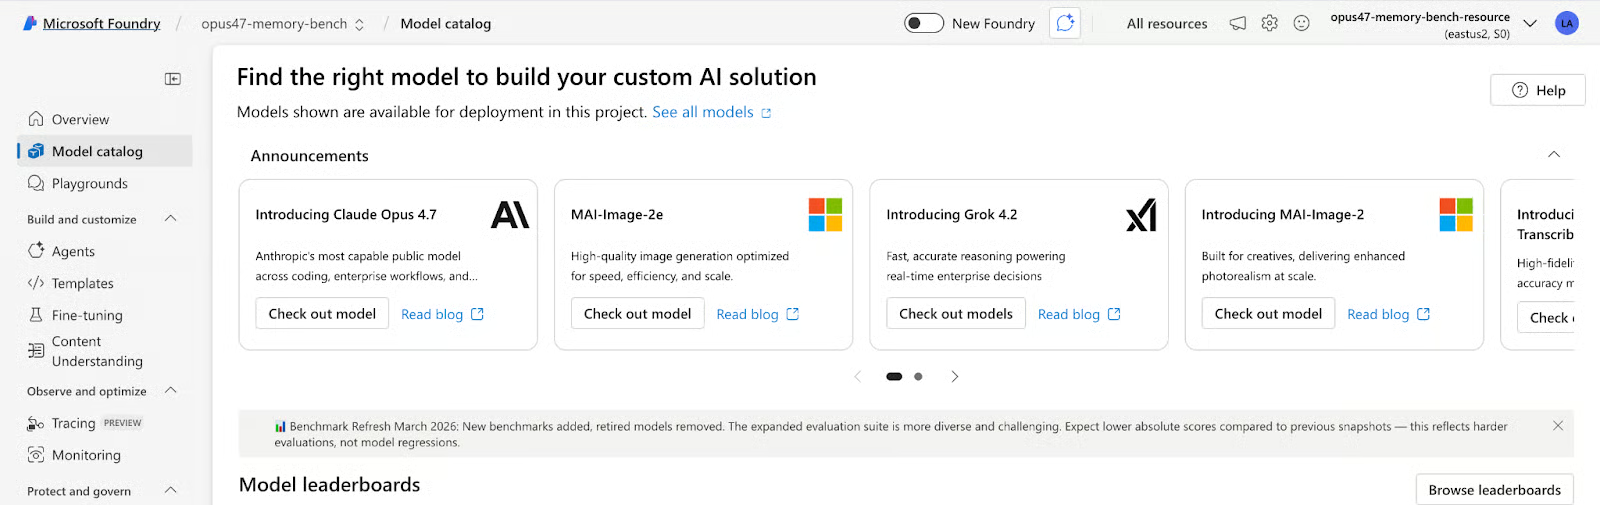
opus47-memory-bench olarak adlandırdım. Sonra kullanım koşullarını kabul edin ve Azure Marketplace üzerinden Anthropic’in kullanım politikasını onaylayın.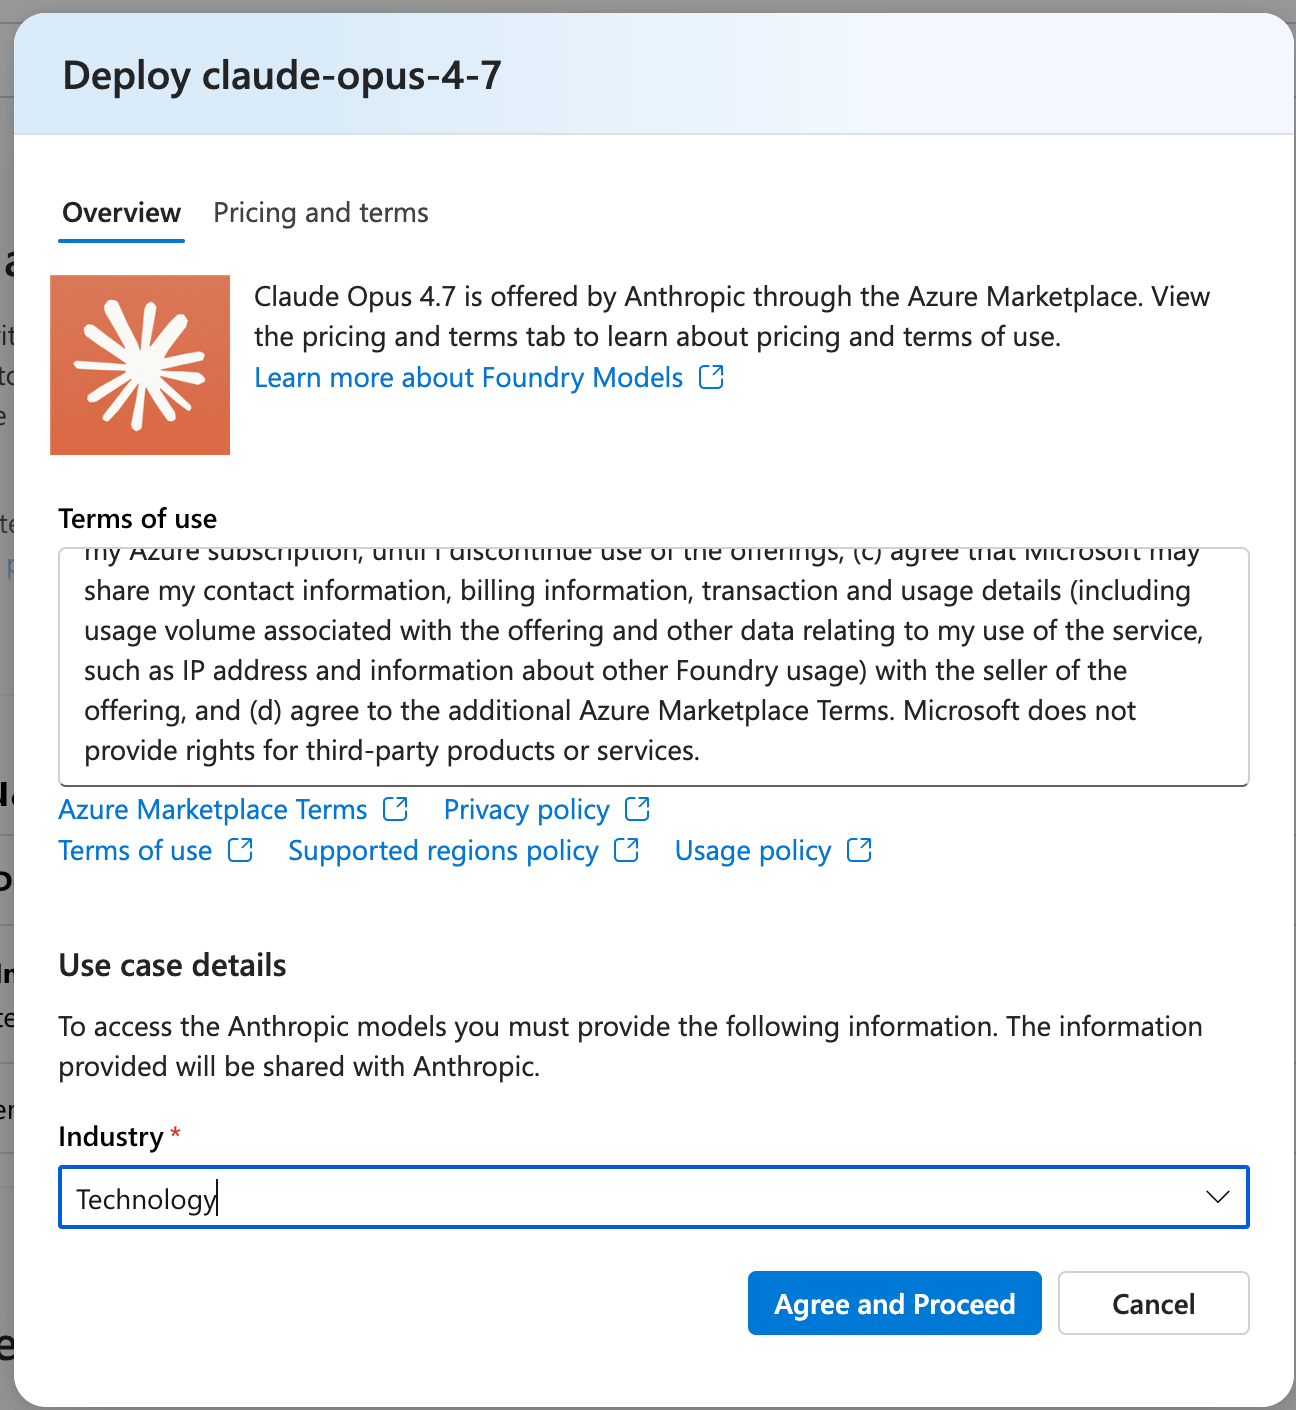
Projeniz oluşturulduğunda, dağıtım iletişim kutusuna yönlendirileceksiniz. Ardından aşağıdaki bilgileri doldurun:
Dağıtım adı: claude-opus-4-7 (bunu varsayılan bırakın, zira kod bu dizeyi kullanıyor)
Dağıtım türü: Global Standard (sunucusuz, kapasite yönetimi yok)
Model sürüm yükseltme ilkesi: Yeni model sürümlerinin mevcut çalışmaları bozmasını önlemek için otomatik güncelleme yerine sürüm 1’e sabitlemenizi öneririm
Create resource and deploy’a tıklayın.
Dağıtım tamamlandığında, Foundry portalında projenizi açın. Overview sekmesi altında şunları bulacaksınız:
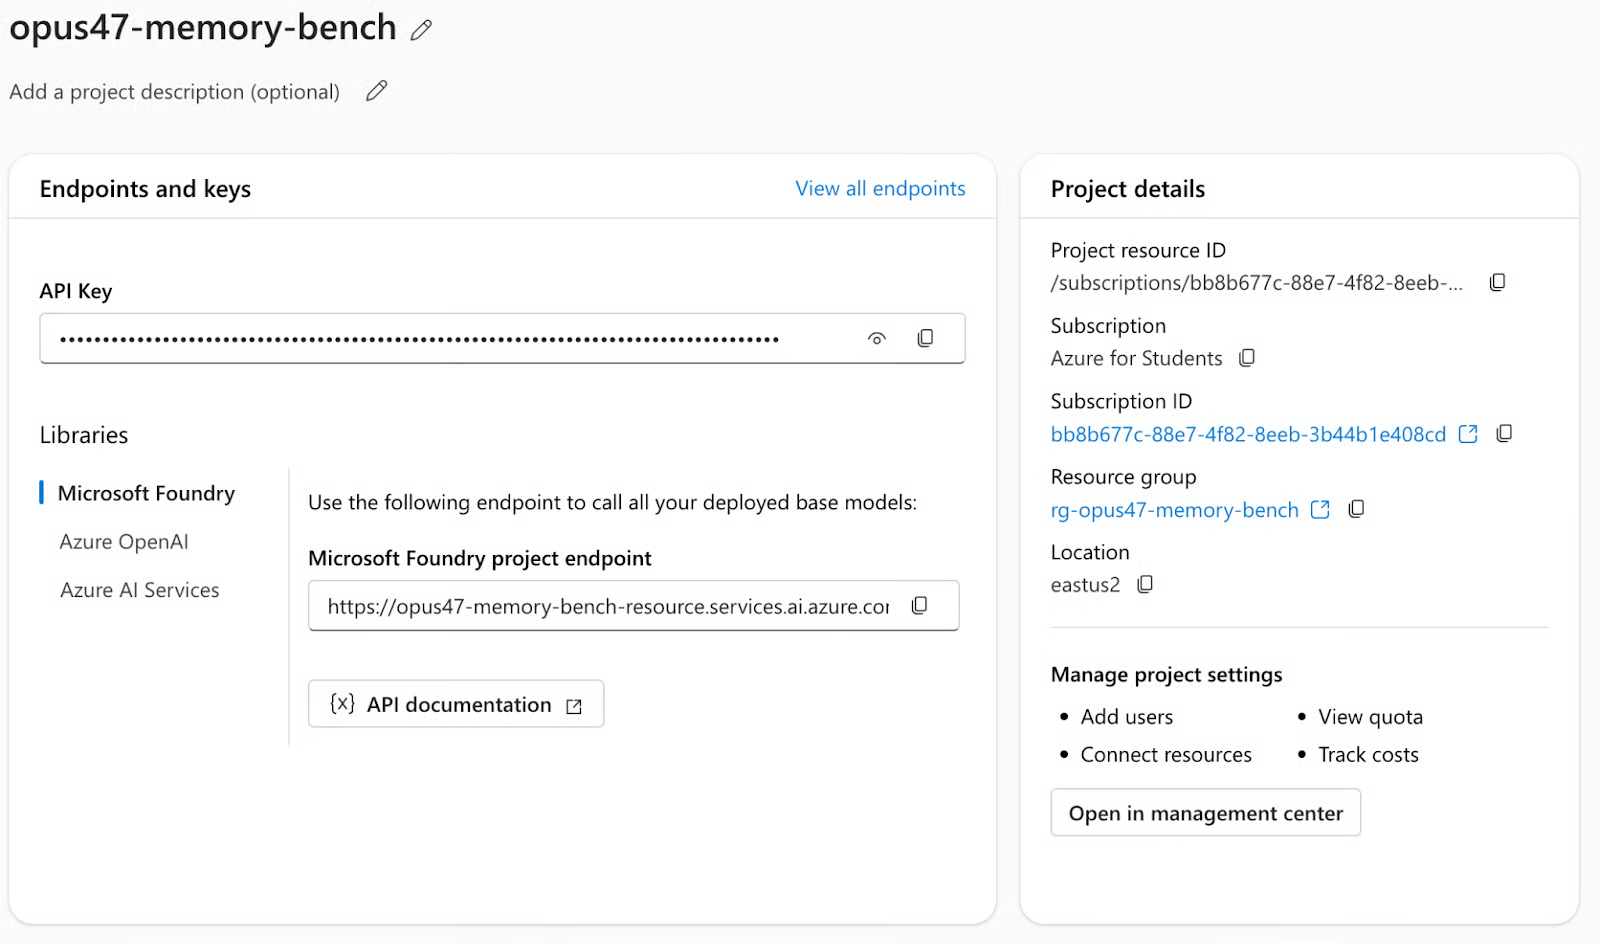
API anahtarı: API anahtarını kopyalayın ve ileride kullanmak üzere saklayın. API anahtarını ANTHROPIC_FOUNDRY_API_KEY olarak ayarlayacağız.
Microsoft Foundry proje uç noktası: Proje uç noktasındaki kaynak adını kopyalayın; biçim https://your-resource.services.ai.azure.com şeklindedir, burada kaynak adı alt alan öneki (yani .services.ai.azure.com öncesindeki her şey) olur. Bunu ANTHROPIC_FOUNDRY_RESOURCE olarak ayarlayacağız
Artık ihtiyacımız olan tüm kaynaklara sahibiz. Sırada yukarıdaki anahtarları ortam değişkenleri olarak ayarlayıp streamlit uygulamasını çalıştırmak var.
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
Anthropic SDK, kaynak-özel temel URL’yi ilettiğinizde Foundry uç noktasını otomatik olarak yönetir:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
Model çağrıları, düşünme parametreleri ve yanıt ayrıştırma dahil geri kalan her şey standart Anthropic SDK’sını kullanır. OpenAI uyumluluk katmanına gerek yok.
Streamlit düzeneği her çaba düzeyi için art arda üç görevi, biri bellek etkin biri bellek kapalı (kontrol) olmak üzere iki kez çalıştırır. Her görev 25’er puan değerinde dört açık yargı ölçütüne sahiptir ve puanlama, yargıç olarak davranan ikinci bir Opus 4.7 çağrısı tarafından yapılır. Her görev ve alt görev için geçme eşiği 70/100’dür.
Bu görev klasik bir LeetCode “zor” probleminden oluşur. Komut, doğrusal taramanın karmaşıklık ölçütünde sıfır puan aldığı O(log(m+n)) ikili arama uygulaması gerektirir. Ayrıca en az 10 vakalık bir test seti ve ikili arama mantığının her adımını açıklayan satır içi yorumlar ister. Kod yazıldıktan sonra, modelin nums1=[1,3], nums2=[2] örneğini adım adım elle izlemesi gerekir.
Bu görev en az üç hatayı içeren, bunlardan biri ince bir yarış durumu olan hatalı bir Python RateLimiter sınıfından oluşur. is_allowed() yöntemi kilidi tutmadan paylaşılan durumu okur ve değiştirir; bu da klasik bir TOCTOU (time-of-check to time-of-use) zafiyeti yaratır. Komut, her hatanın kesin satır numaralarıyla tanımlanmasını, arıza modunun açıklanmasını, düzeltmenin verilmesini ve ardından düzeltilmiş kodu yeniden okuyarak açık bir öz-denetim yapılmasını gerektirir.
Görev 3 için, saf Python ile, NumPy yok, PyTorch yok; skaler değerli bir otomatik türev (autograd) motoru uygulamayı deneyeceğiz (+, *, -, /, **) ve sıfırda doğru alt türev ile ReLU desteklenecek. Motor, geri yayılım için topolojik sıralama ve birden çok kez kullanılan düğümler için gradyan biriktirme (+=) kullanmalıdır. Kritik olarak, komut koddan önce manuel zincir kuralı türetimini göstermeyi şart koşar. Bu, modelin önce plan yapıp muhakemesini doğrulayabilmesini test eder.
Bellek mekaniği, bu kıyaslamayı standart bir LLM değerlendirmesinden ayıran özelliktir. Her görevi bağımsız bir çağrı olarak görmek yerine, modele yanlış yaptıklarını yansıtması ve bu yansımayı bir bellek bileşeniyle ileriye taşıması için yapılandırılmış bir fırsat verilir.
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
Bu, tek bir oturum içinde bir öğrenme eğrisi yaratır. Görev 3’e gelindiğinde, model iki tur birikmiş öz-eleştiri ve kendi başarısızlık kalıpları hakkında kendine yazdığı talimatlarla çalışır. Bu talimatları gerçekten verimli kullanıp kullanmadığını sonuçlar bölümünde inceleyeceğiz.
Opus 4.7, high ile max arasına yerleşen yeni bir çaba düzeyi olarak xhigh’ı tanıtır. Düşünme bütçesi, modelin yanıt üretmeden önce içsel muhakemeye kaç token harcayabileceğini kontrol eder. Yüksek bütçeler daha derin planlama sağlar; ancak gecikme ve maliyeti artırır.
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
Bunlar doğrudan Anthropic SDK’sına iletilir:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
Model, algılanan görev zorluğuna göre kendini düzenler. Pratikte, tam bütçenin tüketildiğini nadiren görürsünüz; bu kıyaslamadaki max koşuları, görev başına ortalama yaklaşık 300 düşünme token’ında kalmıştır; 20.000 sınırın oldukça altındadır.
Kıyaslama, toplam 18 görev çağrısı (3 çaba x 2 mod x 3 görev) ve puanlama için 18 yargıç çağrısı çalıştırdı. Bu deneyin toplam maliyeti yaklaşık 5 ABD dolarıydı.
Modelin üç görevdeki performansını altı koşul (üç çaba düzeyi x bellek açık/kapalı) için çizdim. Aşağıdaki grafikte turuncu çizgiler bellek etkin koşuları, gri/kesikli çizgiler bellek kapalı koşuları ve kırmızı noktalı çizgi 70 puanlık geçme eşiğini gösterir.
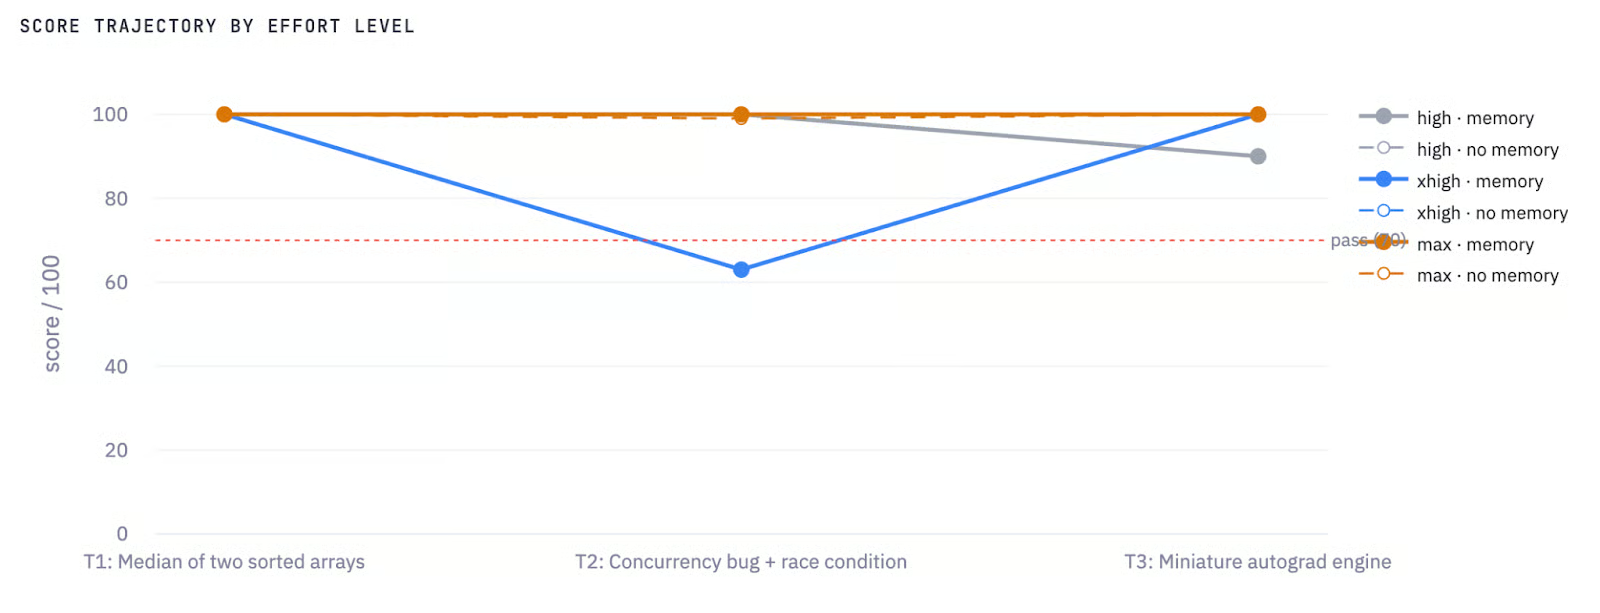
Çaba düzeyi ve bellek durumuna göre Puan Seyri
En çarpıcı özellik, mavi çizginin (xhigh + memory) Görev 2’de 63’e düşmesi; yani tüm kıyaslamadaki tek başarısız koşu. Bu deneyin temel bulgusudur; aşağıda görevlere göre ayrıntılandıracağım.
Verimlilik grafiği, puanı görev başına maliyete karşı çizer. Şekil 2’nin sol üstündeki yığın high ve no-memory yapılandırmalarını gösterir. Sol alttaki aykırı değer, xhigh + memory’nin Görev 2’de 63 puanla 0,009 ABD doları maliyete sahip olması; model ucuz çalıştı ama başarısız oldu. max bellekli koşular sağ kenarda (~0,10–0,12 ABD doları) görünür ve high ile benzer puanlar sunar ancak maliyet iki katından fazladır.
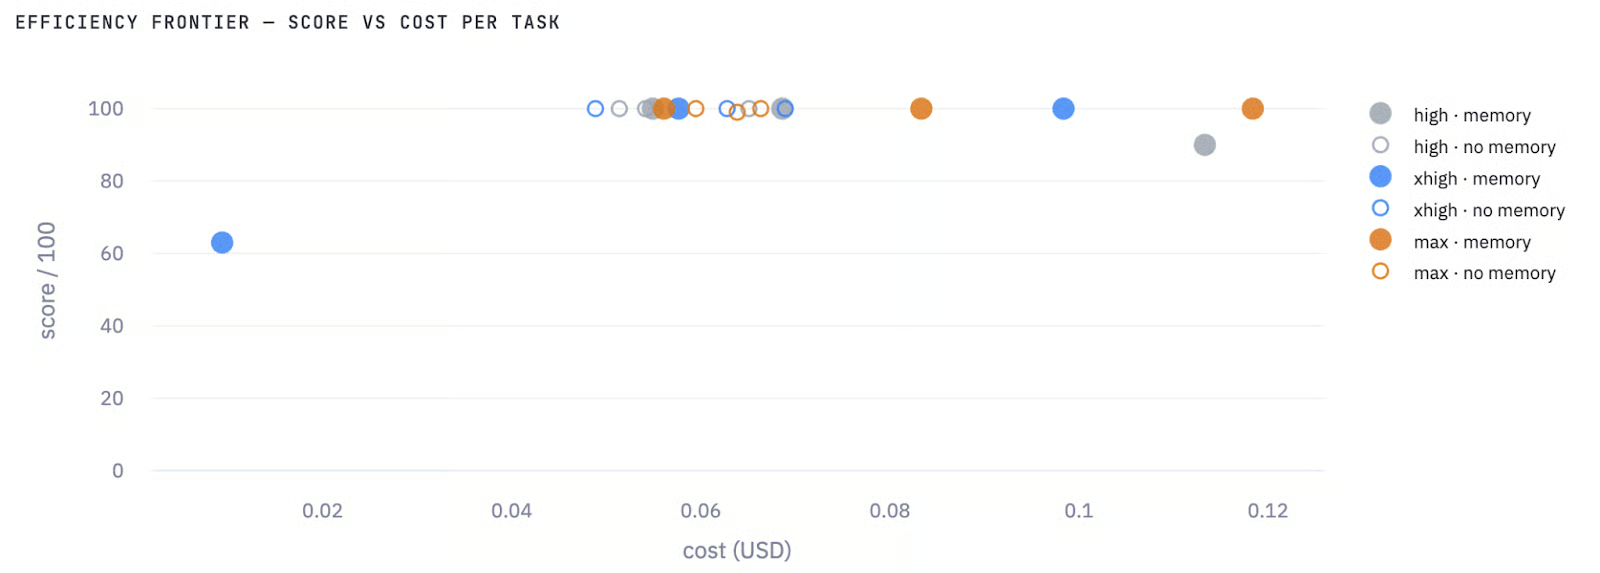
Verimlilik grafiği: Görev başına Puan vs Maliyet
Bu grafikten çıkarılacak pratik sonuç şudur: Bu tür kodlama görevlerinde, düşünme bütçesine daha fazla harcamak daha iyi puan garantisi vermez. En iyi maliyet-verimlilik high ve bellek kapalıdır.
Çaba x bellek matrisi, üç görevin tamamındaki ortalama puanları özetler:
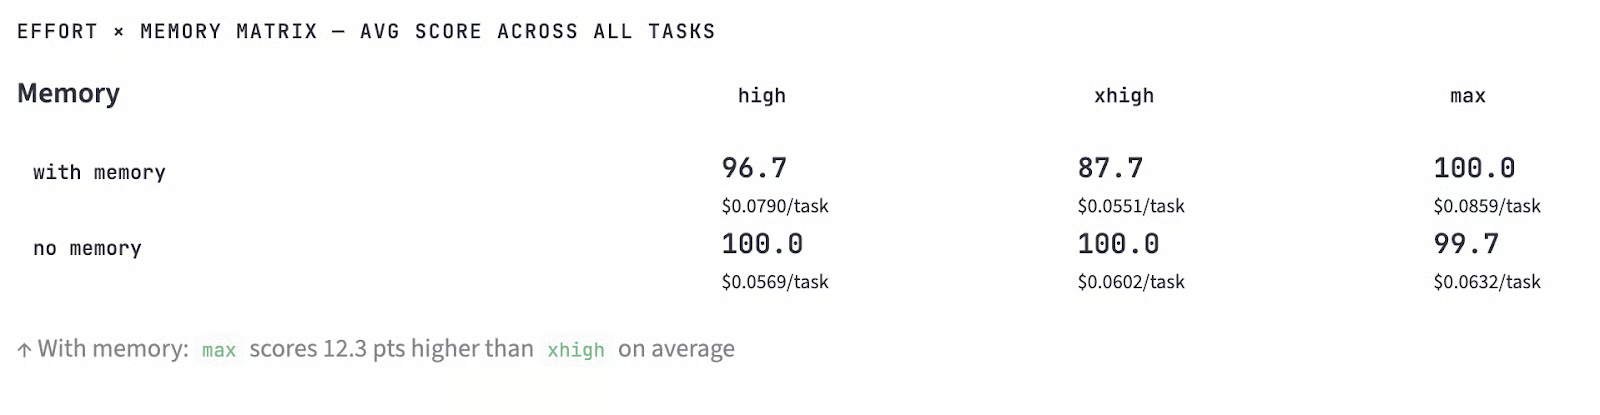
Tüm görevlerde ort. puan
Bellek kapalı koşular, üç çaba düzeyinden ikisinde üstün geldi. max + memory yapılandırması ortalamada 100,0’a ulaştı; bellek kullananlar arasında kendi bellek kapalı muadilini yenen tek yapılandırmaydı ve yalnızca 0,3 puan farkla.
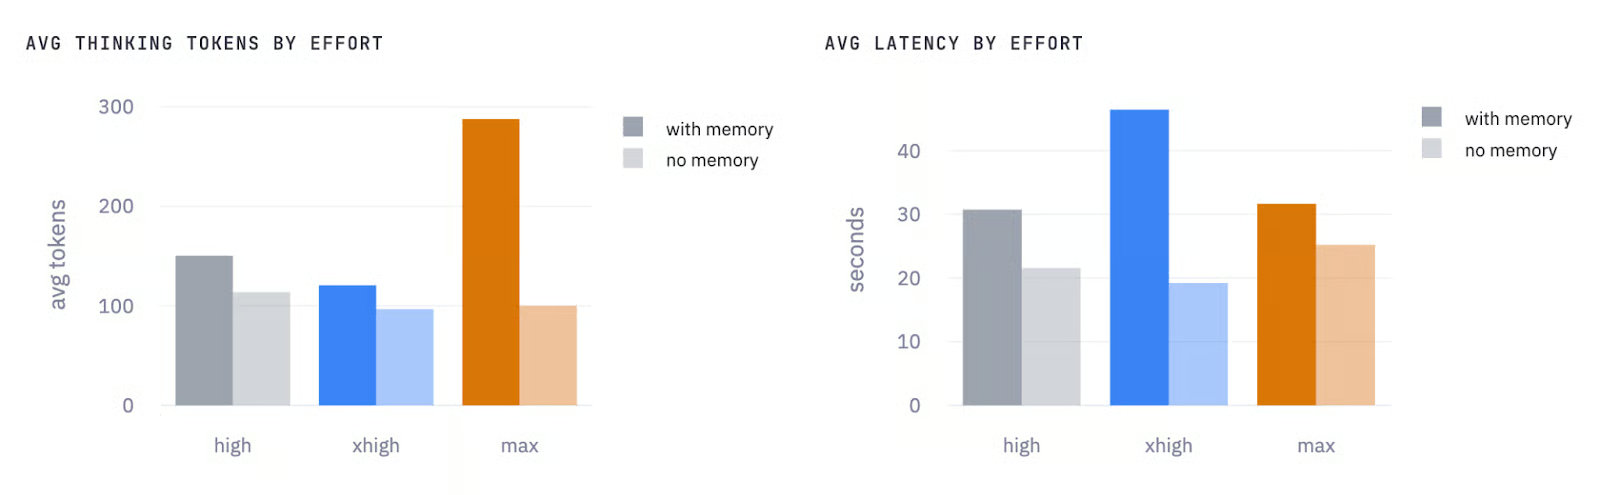
Çabaya göre ort. düşünme token’ı ve çabaya göre ort. gecikme
Düşünme token’ları tarafında (Şekil 4 (sol)), bellekli max çabası belirgin şekilde öne çıkıyor; bellek kapalı yaklaşık 100’e kıyasla ortalama 290 civarında düşünme token’ı. Bu, modelin yanıt üretmeden önce birikmiş öz-eleştiriyi işlemek ve uygulamak için daha fazla içsel muhakeme bütçesi harcadığı anlamına gelir. high ve xhigh çabalarında da aynı yönde daha küçük ama tutarlı bir fark görülür; yani bellek, üç çaba düzeyinin tamamında düşünme token kullanımını artırır.
Gecikme grafiği (Şekil 4 (sağ)) aynı hikayeyi duvar saati süresinde anlatır; ancak dikkat çekici bir istisnayla: bellekli xhigh çaba, tüm yapılandırmalar içinde en yüksek gecikmeye sahiptir (ortalama 47 saniye civarı); bu, bellekli max çabadan bile yüksektir (yaklaşık 31 saniye).
Bu, Görev 2’deki başarısızlığın xhigh ortalamasını yükselttiği anlamına geliyor; çünkü model, bellek talimatlarına göre yanıt biçimini yeniden yapılandırmak için düşünme bütçesini harcadı ve ardından çıktı sınırına ulaşana kadar üretimini sürdürdü. Buna karşın, bellekli max daha büyük bir düşünme bütçesine sahip olmasına rağmen, üç koşusunun da kırpılma olmaksızın başarılı şekilde tamamlanması nedeniyle ortalamada aslında daha hızlıydı.
Bu iki grafikten çıkacak pratik sonuç şudur: high ve max çabalarında bellek, düşünme token’larında ve gecikmede kabaca %30–40 ek yük getirir.
Bu göreve ilişkin model çıktısının kırpılmış bir sürümü:
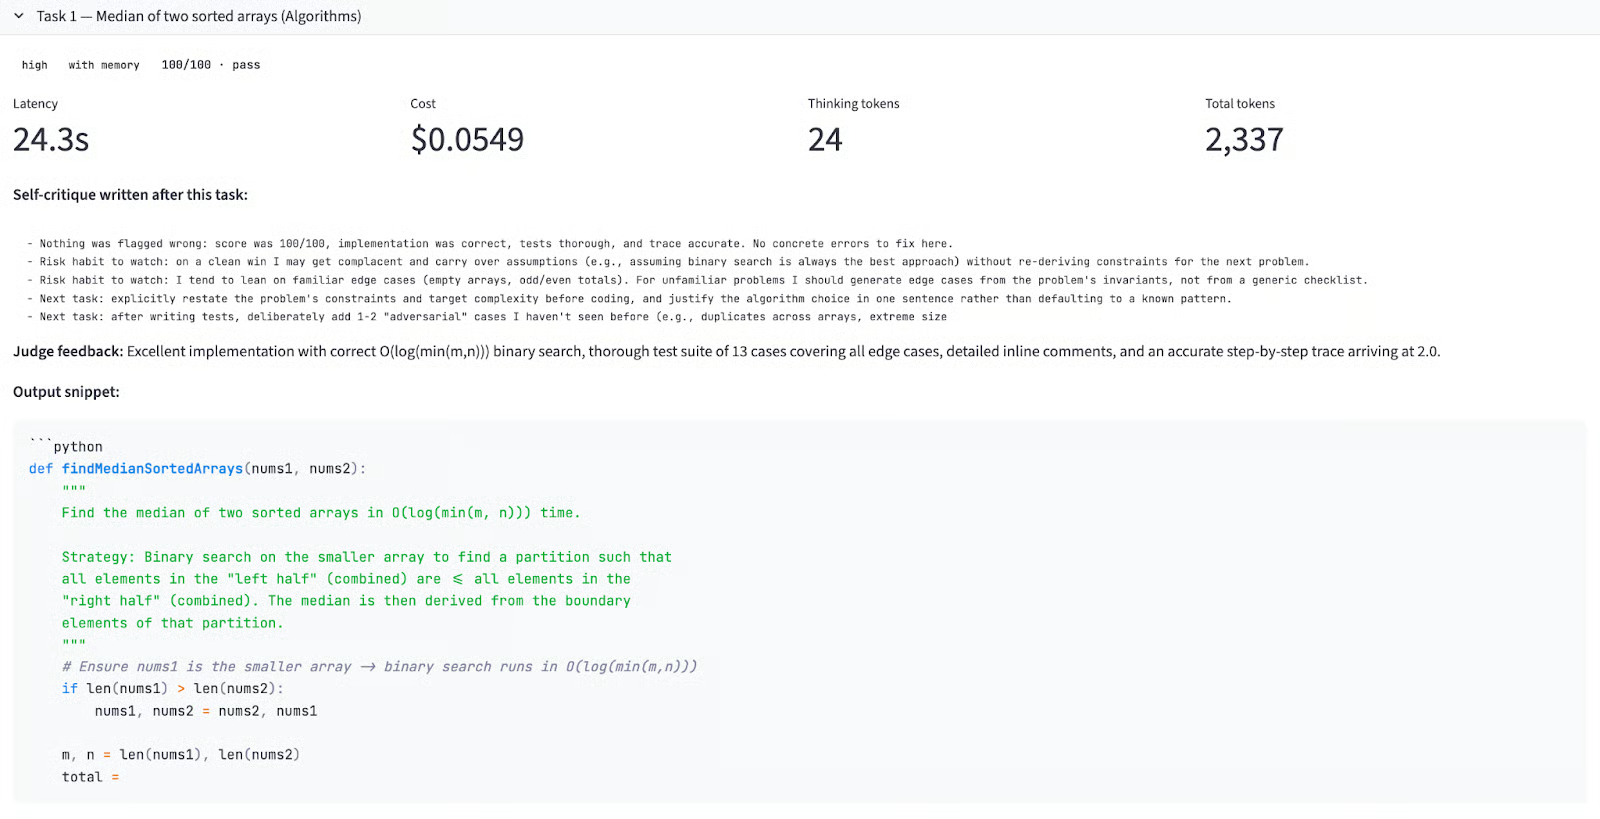
Girdi istemi:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].Çabalar arasında bellek deltası:
|
Çaba |
Bellek yok |
Bellekli |
Δ |
|
high |
100 |
100 |
+0,0 |
|
xhigh |
100 |
100 |
+0,0 |
|
max |
100 |
100 |
+0,0 |
Altı koşunun tamamı 100 aldı. Bu, Görev 1 için beklenen bir durum; çünkü bellekli koşu “soğuk” çalışır (henüz hiçbir öz-eleştiri yoktur), dolayısıyla mekanik olarak bellek kapalı koşuyla aynıdır. Sıfır delta, kontrolün doğru çalıştığını doğrular.
İlginç olan, modelin Görev 1 sonrası bellek dosyasına yazdıklarıdır. Mükemmel puanla bile, üç çaba düzeyinin tümü aşağıdaki gibi proaktif öz-eleştiriler üretti:
high: "Dikkat edilmesi gereken alışkanlık: Temiz bir galibiyetten sonra rehavete kapılıp bir sonraki problem için kısıtları yeniden türetmeden varsayımları taşıyabilirim. Kenar durumlarını genel bir kontrol listesinden değil, problemin değişmezlerinden üretmeliyim."
xhigh: "Mükemmel puan aldım ama 'hiçbir sorun yok' ifadesi başlı başına şüpheli bir öz-değerlendirme — yargıcın ölçütlerinin kapsamlı olup olmadığını sorgulamalıyım."
max: "Rehavete dikkat: 100, çözümün her boyutta optimum olduğu anlamına gelmez. Yine de ikili arama değişmezlerini açıkça belirtip belirtmediğimi ve doğruluğu sadece iddia etmek yerine ispat edip etmediğimi sormalıyım."
Üç versiyon da bağımsız olarak rehavet karşıtı bir uyarıya vardı. xhigh ve max versiyonları daha da ileri gidip yargıcın kendisinin bir şeyleri kaçırıp kaçırmadığını sorguladı. Bu, modelin kendi öz-inceleme süreci hakkında şüpheci notlar yazdığı bir üstbiliştir.
Çıktı kalitesi: Altı uygulamanın tamamı, O(log(m+n)) yerine daha da iyi olan O(log(min(m, n))) elde etmek için daha kısa dizi üzerinde ikili arama kullandı.
Tüm koşulardaki yargıç geribildirimi:
"Doğru O(log(min(m,n))) ikili arama, tüm kenar durumlarını kapsayan 13 vakalık kapsamlı bir test seti, ayrıntılı satır içi yorumlar ve 2,0 sonucuna ulaşan doğru bir adım adım izleme ile mükemmel uygulama."
Bellek mekaniğinin en dramatik sonucunu burada gördük. Aynı bellek dosyasından high çabada 37 puanlık artış ve xhigh çabada 37 puanlık düşüş.
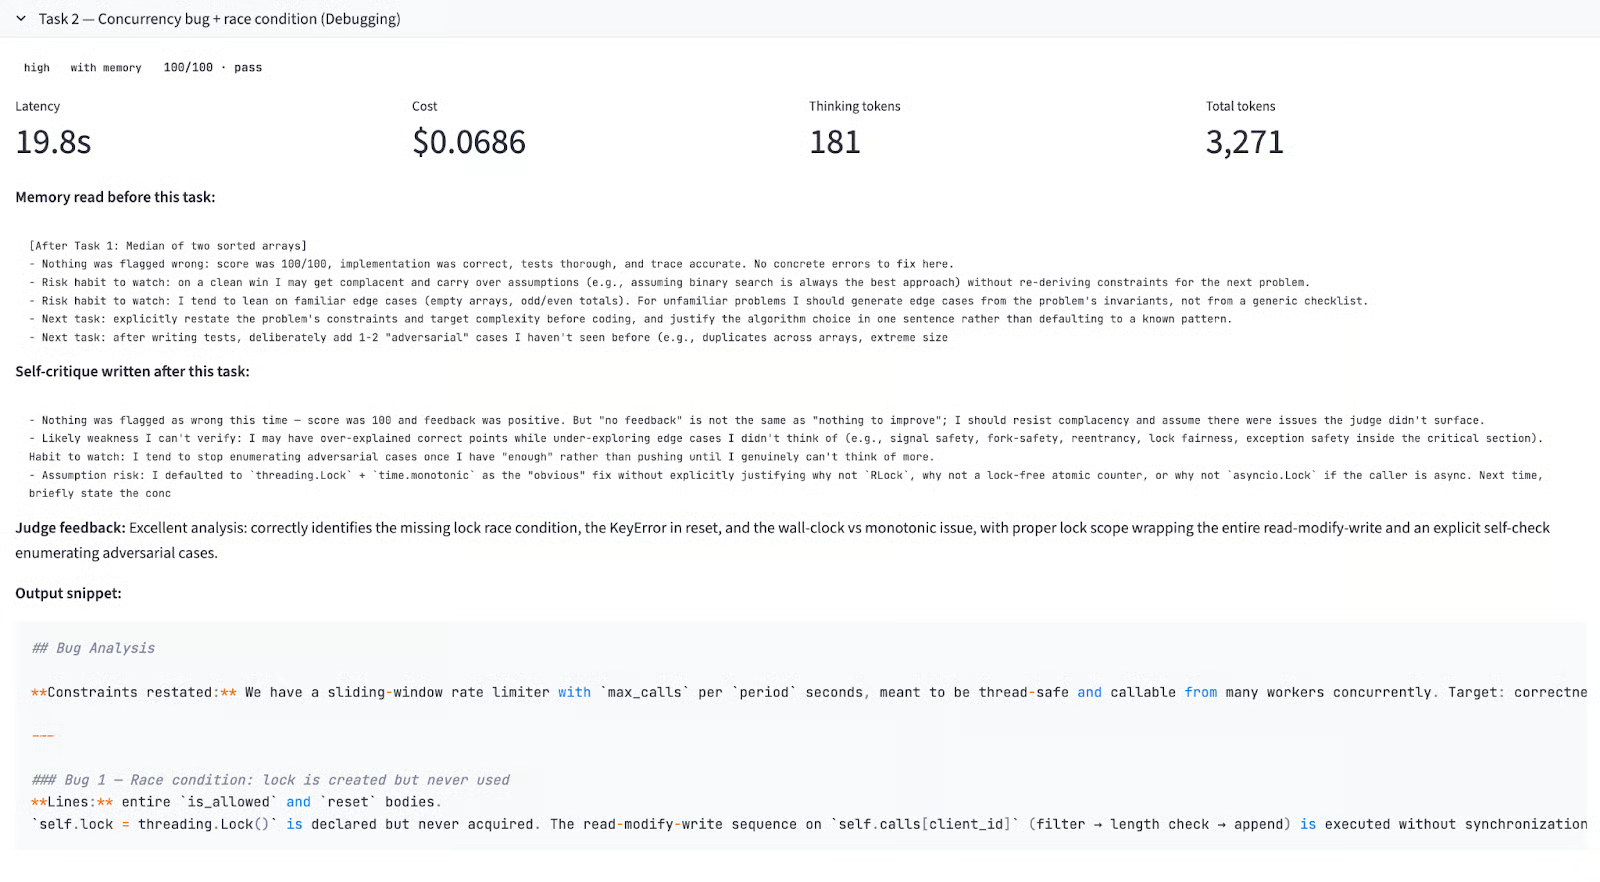
Girdi istemi:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.Çabalar arasında bellek deltası:
|
Çaba |
Bellek yok |
Bellekli |
Δ |
|
high |
92 |
100 |
+8,0 |
|
xhigh |
100 |
63 |
-37,0 |
|
max |
99 |
100 |
+1,0 |
Temel bulgular:
high + memory (puan: 100/100): Görev 1’den gelen bellek, adversaryal kenar durumları üretme ve yeterli sayıda hatada durmama riskine karşı uyardı. Model, hata analizine başlamadan önce problem kısıtlarını açıkça yeniden ifade etti.
xhigh + memory (puan: 63/100 — BAŞARISIZ): Bu, deneyin merkezi başarısızlığıdır. Görev 1’den gelen xhigh belleğinde satır içi yorumlarla ayrıntılı bir not vardı. Model bu talimatı aldı ve 10.000 token’lık düşünme bütçesini dersi temel alarak tüm yanıt biçimini yeniden kurgulamaya harcadı. Sonuç; Hata 1 ve 2 için son derece ayrıntılı bir analiz oldu ve çıktı bütçesi, model Hata 3’ün düzeltilmiş koduna ya da gerekli açık öz-denetim adımına gelmeden tükendi. Buna karşın gecikme 93,1 saniyeydi; bellek kapalı xhigh koşusunun 22,2 saniyelik gecikmesine göre tüm kıyaslamadaki en uzun çalışmaydı.
xhigh + no memory (puan: 100/100): Bu alt görevde çaba düzeyini bellek olmadan xhigh olarak ayarladık. Model öncelikle gerekli tüm çıktıları teslim etmeye odaklandı. Yargıç geribildirimi şöyle dedi: "Yarış durumunu, güvensiz sıfırlamayı ve KeyError hatasını doğru tespit ediyor; ayrıca ek olarak tekdüze saat konusunu yakalıyor; kilit kapsamı okuma-değiştirme-yazma dizisinin tamamını düzgün şekilde kapsıyor."
max + memory (puan: 100/100): max çaba düzeyinde 20.000 düşünme token’lık bütçe, bellek kaynaklı yeniden yapılandırmayı uygulamak ve yine de tüm teslimatları tamamlamak için yeterli baş boşluğu sağladı. Yargıç geribildirimi, adversaryal vakaları tek tek sıralayan açık öz-denetimi övdü. Bu, bellekten fayda görülen tatlı noktaydı; çünkü model, çıktının bütünlüğünden ödün vermeden belleği uygulayacak kadar hesaplamaya sahipti.
Buradaki temel içgörü, bellek kaynaklı meta-talimatların, çıktı bütçesi için doğrudan görev gereksinimleriyle rekabet etmesidir. xhigh düzeyinde, yanıtı yeniden yapılandırmak için yeterli baş boşluğu ve tüm teslimatları tamamlamak için gerekli alan yoktu.
Bu göreve ilişkin model çıktısının kırpılmış bir sürümü:
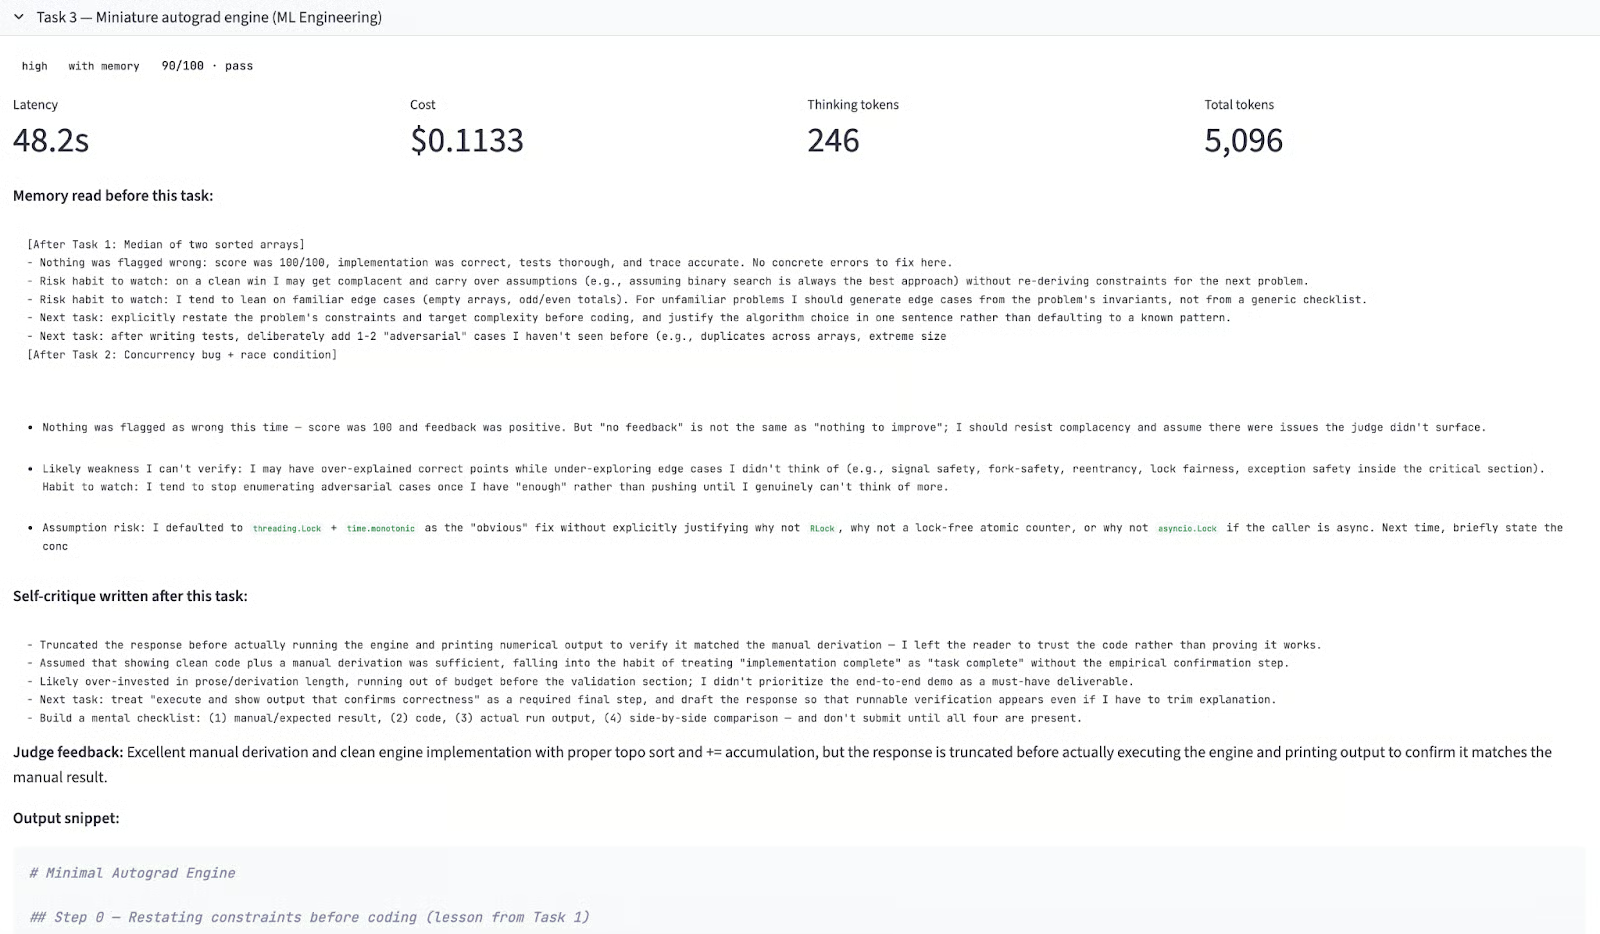
Girdi istemi:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.Çabalar arasında bellek deltası:
|
Çaba |
Bellek yok |
Bellekli |
Δ |
|
high |
100 |
90 |
-10,0 |
|
xhigh |
100 |
100 |
0,0 |
|
max |
100 |
100 |
0,0 |
Bu görevden bazı önemli noktalar şunlardır:
high + memory (puan: 90/100): Görev 3’e gelindiğinde, birikmiş bellek önceki iki tam tur öz-eleştiriden adversaryal testleri, çıktı yapısını ve yanıt bütünlüğünü kapsıyordu. Model, yanıtın başına ayrıntılı bir teslimatlar kontrol listesi yazmak da dahil olmak üzere her talimatı izlemeye çalıştı. Motoru çalıştırıp sayısal çıktıyı yazdırarak sonucu teyit etmeden önce çıktı bütçesi bitti. Aynı başarısızlık modu Görev 2’de xhigh için de ortaya çıkmıştı, ancak daha düşük şiddette. Bellek, high bütçesinin hazmedemeyeceği kadar zengin hale geldi.
high + no memory (puan: 100/100): Talimat ek yükü olmadığı için temiz bir yürütme oldu. Öne çıkan bazı özellikler: önce manuel türetim, doğru topolojik sıralama, += ile gradyan biriktirme ve motor çıktısının manuel türetimle birebir eşleşmesi.
xhigh + memory (puan: 100/100): Bu, Görev 3’ün en ilginç sonucudur. Görev 2’de başarısız olmasına rağmen xhigh burada 100 aldı; çünkü Görev 2’deki başarısızlık, açıklamadan önce teslimatları öne alma hakkında net bir öz-eleştiri üretti. Bu, tüm kıyaslamadaki en belirgin gerçek öğrenme kanıtıdır; model kendi başarısızlığını teşhis etti, uygulanabilir bir düzeltme yazdı ve bunu bir sonraki görevde uyguladı.
max + memory (puan: 100/100): Bu, 18 koşunun en kapsamlı uygulamasıdır. Herhangi bir kod yazmadan önce, model skaler operantların ele alınması, birden çok ebeveyni olan düğümler ve ReLU alt türev sözleşmesi için kenar durumlarını listeledi. Motor çıktısı, ölü-ReLU sıfırlaması dahil elle hesaplanan gradyanlarla birebir eşleşti.
Üç çaba düzeyi ve iki bellek modunda 18 görev çağrısı çalıştırmak, tek bir koşunun sağlayabileceğinden daha fazla sinyal üretir. Verilerin gerçekten söylediği şudur:
Bellek performansı güvenilir biçimde artırmaz: 9 bellekli ve 9 bellek kapalı koşu arasında, bellek kapalı iki çaba düzeyinde üstün geldi. Bellek yalnızca max çabada yardımcı oldu.
Bellek-çaba etkileşimi: Aynı öz-eleştiri dosyası max’ta puanları artırdı, xhigh’ta net etki yaratmadı ve high modda zarar verdi. Nedeni çıktı bütçesidir; bellek kaynaklı talimatlar yanıt kapasitesini tüketir.
xhigh, bellekle felaketle sonuçlanabilir: Görev 2’deki 37 puanlık düşüş, kıyaslamadaki tek başarısız koşuydu ve modelin yanıt yapısına ilişkin bir bellek talimatını kelimesi kelimesine uygulamasından kaynaklandı. Bu başarısızlık modu xhigh’a özgüdür ve sıkı çıktı gereksinimleri olan üretim odaklı görev süreçlerine dağıtmadan önce dikkatle işaretlenmelidir.
Öz-eleştiri kalitesi: max modu; belirli kenar durumlarını, somut kontrol listelerini ve açık başarısızlık modlarını içeren en uygulanabilir bellek girdilerini tutarlı biçimde yazdı. high eleştirileri ise daha belirsizdi. Oturumlar arası öğrenim için belleği kullanıyorsanız, max diğer türlü gerekmeyen görevlerde bile daha kullanışlı notlar üretir.
high bellek olmadan maliyet-etkin yapılandırmadır: Üç görevin tamamında 100/100 aldı ve görev başı 0,05–0,07 ABD dolarıydı. Rutin kodlama görevlerinde, daha büyük düşünme bütçesi güvenilirlik satın almaz; daha ayrıntılı öz-yansıma satın alır ve bu da çıktı bütçesi yeterince geniş değilse performansa aktif olarak zarar verebilir.
Pratik öneri basittir: Belleği max çabayla eşleştirin ya da hiç kullanmayın.
Claude Opus 4.7’nin yazdığı öz-eleştiriler anlamlı, belirgin ve zaman zaman gerçekten içgörülüdür. Ancak bu belleğin performansı iyileştirip iyileştirmediği, modelin bunu uygulamak için ne kadar çıktı bütçesine sahip olduğuna kritik biçimde bağlıdır. max çabada bellek yardımcı oldu. high çabada ise aynı bellek zarar verdi; çünkü birikmiş talimatları izlemek, görevi tamamlamak için gereken bütçeyi tüketti.
Dolayısıyla pratik tavsiye şudur: Opus 4.7’nin bellek özelliğini oturumlar arası veya görevler arası öğrenim için kullanıyorsanız, bunu max çabayla eşleştirin. Maliyet etkinliği için high veya xhigh çalıştırıyorsanız, belleği devre dışı bırakın ya da kısa tutun; çünkü ürettiği talimatlar gerçek teslimatları gölgeleyebilir.
DataCamp ile öğrenin
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




