

कोर्स
Claude मॉडलों का परिचय
3 घंटा
15K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंAnthropic का Claude Opus 4.7 एक नया xhigh effort स्तर पेश करता है, जो high और max के बीच स्थित है, और खास तौर पर बेहतर फाइल-सिस्टम मेमोरी को एक प्रमुख क्षमता के रूप में रेखांकित करता है, यानी मॉडल खुद के लिए नोट्स लिख सकता है और उन्हें सत्रों में उपयोग कर सकता है।
इससे मेरे मन में एक सीधा सवाल उठा: क्या मेमोरी वास्तव में किसी मापने योग्य रूप में काम करती है? साथ ही, क्या Opus 4.7 अपनी गलतियों से सीखता है और अगले कार्य में बेहतर कोड उत्पन्न करता है?
इसलिए, मैंने एक Streamlit बेंचमार्क हार्नेस बनाया जो तीन कठिन-कोडिंग कार्यों को क्रमिक रूप से चलाता है। हर कार्य के बाद, मॉडल एक self-critique को मेमोरी फाइल (memory.md) में लिखता है। अगला कार्य शुरू होने से पहले उस फाइल को पढ़ता है। मैंने इसे मेमोरी के साथ और बिना, तीनों effort स्तरों (high, xhigh, और max) पर चलाया—कुल 18 कार्य-रन—Microsoft Foundry पर Claude Opus 4.7 के जरिए।
इस ट्यूटोरियल के अंत तक, आप सक्षम होंगे:
पूरा कोड GitHub रेपो में उपलब्ध है।
Claude Opus 4.7, Claude 4 परिवार का सबसे सक्षम large language मॉडल है, जो Sonnet और Haiku से ऊपर स्थित है। यह लंबे समय तक चलने वाले एजेंटिक कार्यों, उन्नत सॉफ्टवेयर इंजीनियरिंग, और एंटरप्राइज वर्कफ्लोज़ के लिए बनाया गया है, जिन्हें लंबे सत्रों में सतत प्रदर्शन की आवश्यकता होती है।
इस ट्यूटोरियल के लिए सबसे प्रासंगिक तीन क्षमताएँ हैं:
xhigh effort स्तर: यह high (5,000 thinking tokens) और max (20,000 thinking tokens) के बीच 10,000 thinking tokens पर स्थित है। विचार यह है कि कठिन समस्याओं पर लागत-गुणवत्ता नियंत्रण और बारीकी से हो।नोट: कीमत $5 प्रति मिलियन इनपुट टोकन और $25 प्रति मिलियन आउटपुट टोकन है, जो Opus 4.6 के समान है। अगर आप इस मॉडल को गहराई से खंगालना चाहते हैं, तो DataCamp टीम का यह लेख एक अच्छा संसाधन है।
परीक्षण से पहले कुछ अहम संख्याएँ:
|
बेंचमार्क |
स्कोर |
|
SWE-bench Verified |
87.6% |
|
SWE-bench Pro |
64.2% |
|
GPQA Diamond |
94.2% |
|
OSWorld Verified (computer use) |
78.0% |
|
Finance Agent v1.1 |
64.4% |
इस ट्यूटोरियल की सभी API कॉल्स Microsoft Foundry के माध्यम से जाती हैं। इसलिए, हमें pay-as-you-go बिलिंग एक्सेस वाली Azure सदस्यता चाहिए, क्योंकि मुफ्त छात्र स्तर में Claude जैसे थर्ड-पार्टी पार्टनर मॉडलों के लिए कोटा नहीं है। लेकिन एक अच्छा विकल्प Anthropic की API key का उपयोग करना है। मैंने दोनों तरीकों को इस रेपो में कवर किया है।
ट्यूटोरियल का आरंभिक कदम Microsoft Foundry Model कैटलॉग में मॉडल ढूँढना है। इसके लिए,
claude-opus-4-7 खोजें। इससे मॉडल कार्ड खुलेगा जिसमें प्रमुख क्षमताएँ, बेंचमार्क, और मॉडल ID दिखेगी।
opus47-memory-bench रखा। फिर, terms of use स्वीकार करें और Azure Marketplace के जरिए Anthropic की usage policy से सहमति दें।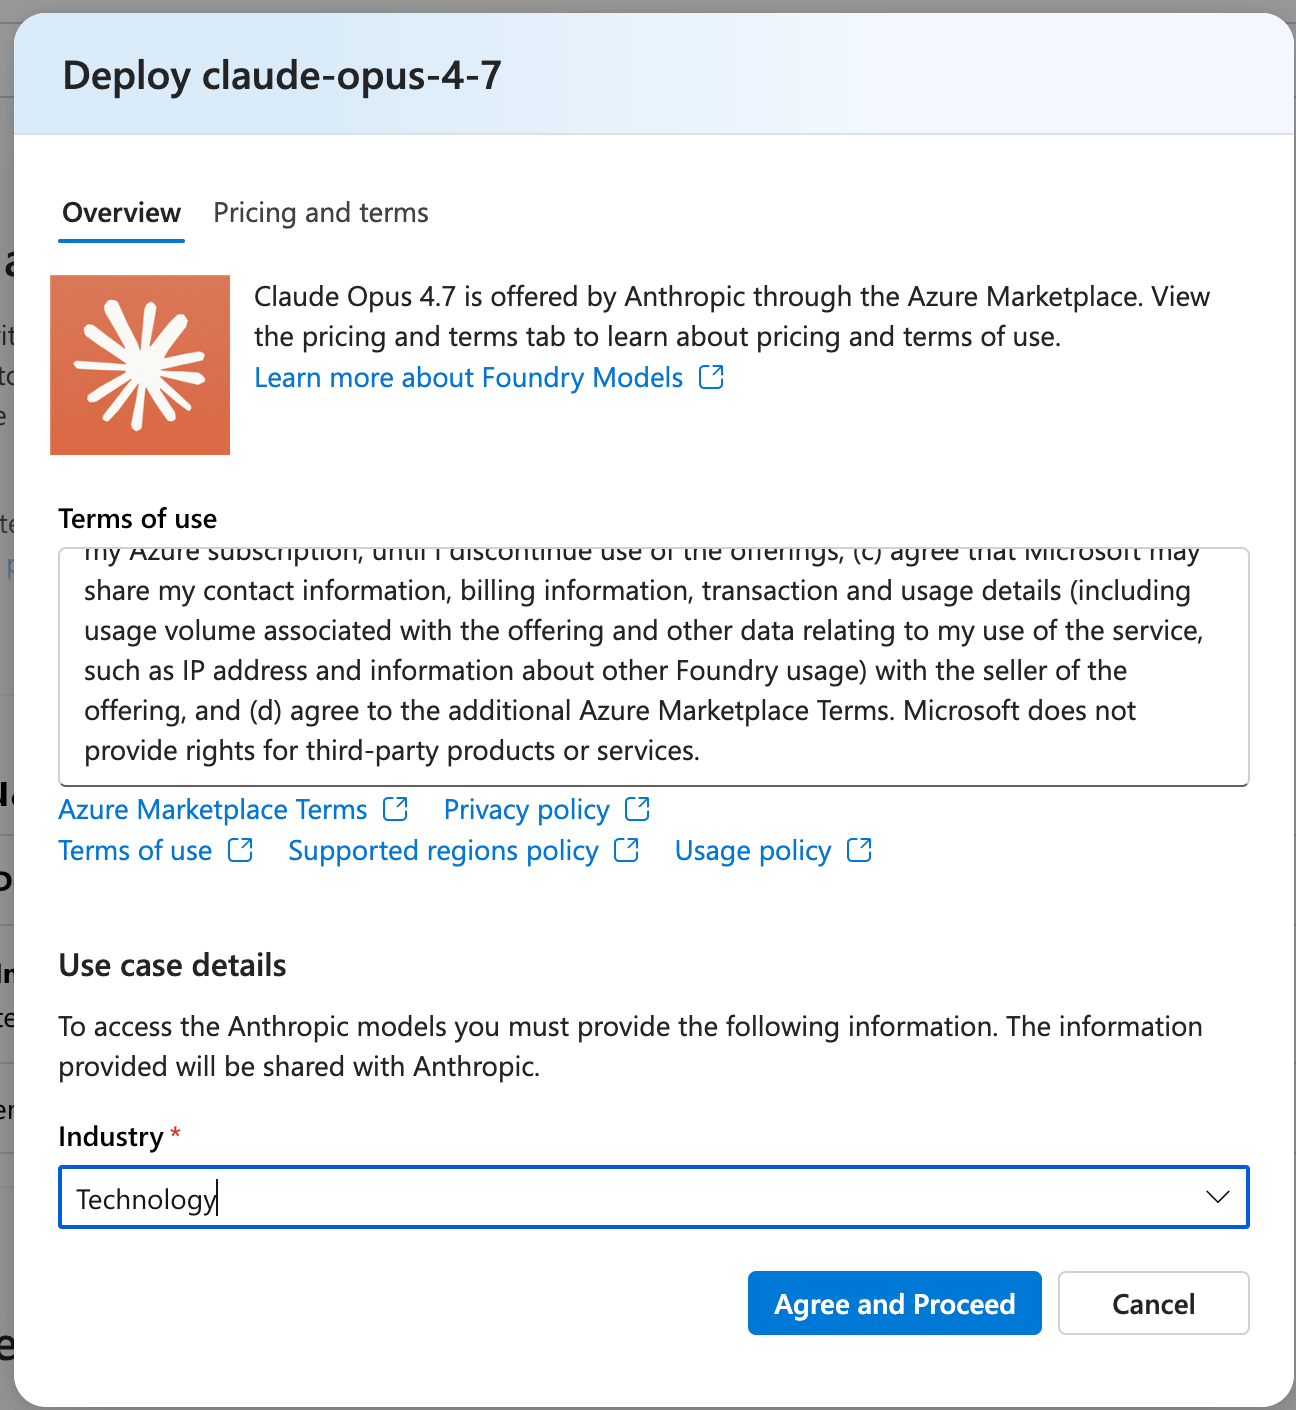
प्रोजेक्ट बन जाने के बाद, आप डिप्लॉय डायलॉग पर आएँगे। फिर निम्न जानकारी भरें:
Deployment name: claude-opus-4-7 (इसे डिफ़ॉल्ट रहने दें, क्योंकि कोड यही स्ट्रिंग उपयोग करता है)
Deployment type: Global Standard (serverless, कोई capacity प्रबंधन नहीं)
Model version upgrade policy: मैं auto-update के बजाय संस्करण 1 पर पिन करने की सिफारिश करता/करती हूँ ताकि नए मॉडल रिलीज मौजूदा रन न बिगाड़ें
Create resource and deploy पर क्लिक करें।
डिप्लॉय हो जाने पर, Foundry पोर्टल में अपना प्रोजेक्ट खोलें। Overview टैब के तहत आपको निम्नलिखित मिलेंगे:
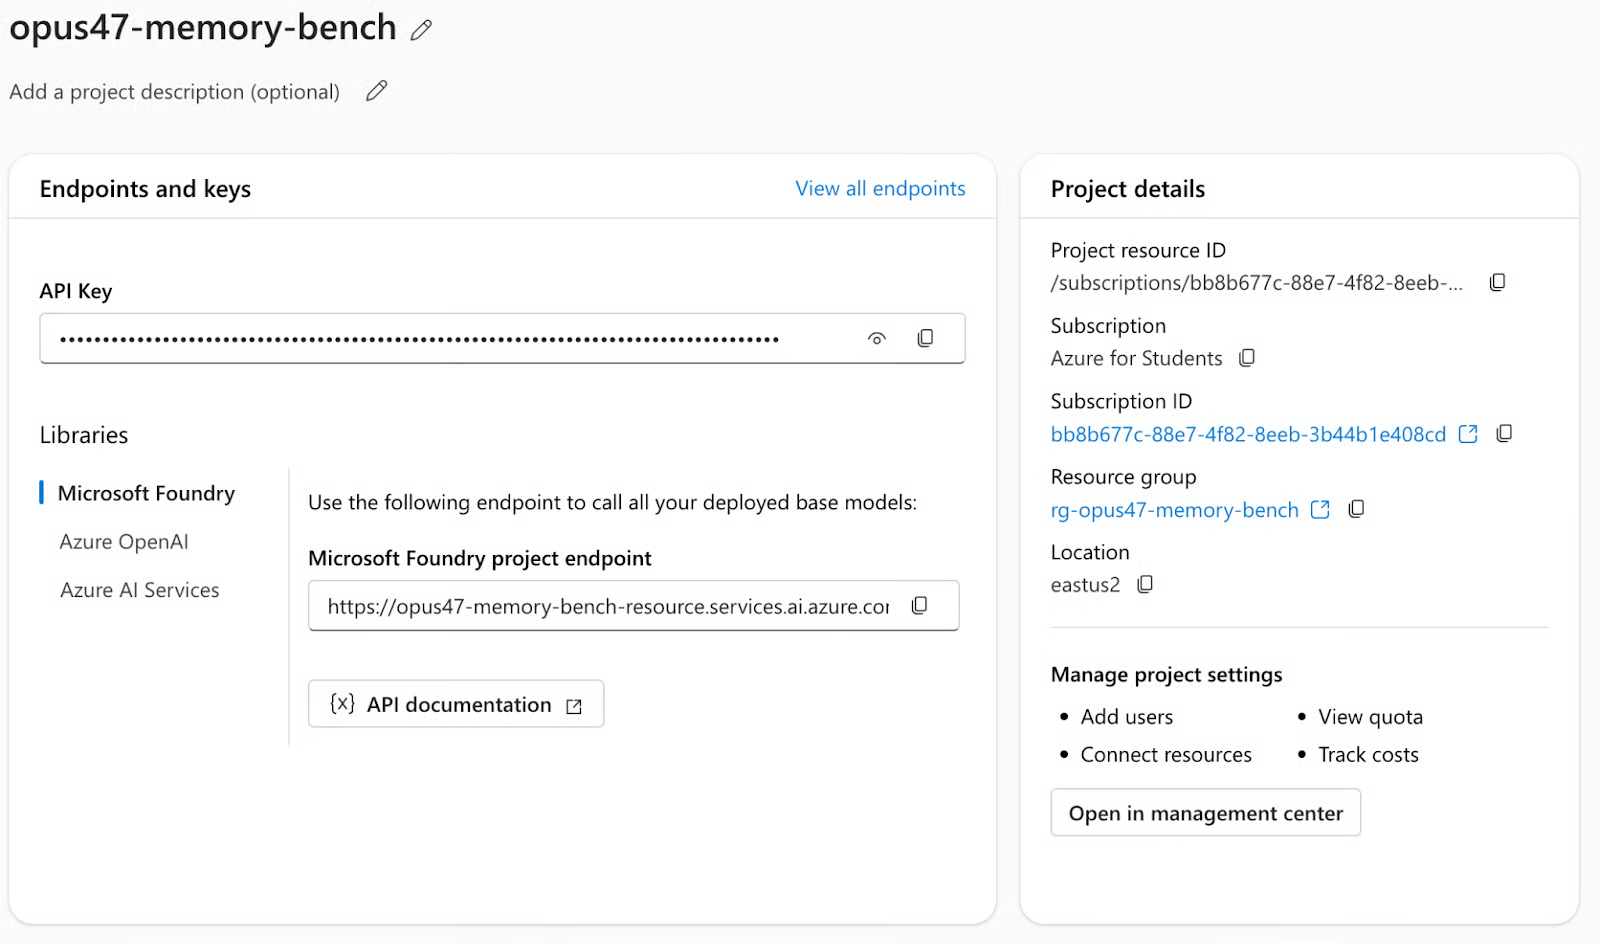
API key: API key कॉपी करें और भविष्य के उपयोग के लिए सहेजें। हम API key को ANTHROPIC_FOUNDRY_API_KEY के रूप में सेट करेंगे।
Microsoft Foundry project endpoint: प्रोजेक्ट endpoint से resource name कॉपी करें, जो https://your-resource.services.ai.azure.com फॉर्मेट में उपलब्ध है, जहाँ resource name उपडोमेन प्रीफिक्स है (यानी .services.ai.azure.com से पहले का भाग)। हम इसे ANTHROPIC_FOUNDRY_RESOURCE के रूप में सेट करेंगे।
अब हमारे पास सभी आवश्यक संसाधन हैं। अगला कदम ऊपर दी गई keys को environment variables के रूप में सेट करना और streamlit एप्लिकेशन चलाना है।
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
Anthropic SDK, जब आप resource-विशिष्ट base URL पास करते हैं, तो Foundry endpoint को स्वतः हैंडल करता है:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
बाकी सब—मॉडल कॉल्स, थिंकिंग पैरामीटर्स, रेस्पॉन्स पार्सिंग—मानक Anthropic SDK का उपयोग करते हैं। OpenAI compatibility layer की आवश्यकता नहीं है।
Streamlit हार्नेस तीन कार्य क्रम में चलाता है, प्रत्येक effort स्तर पर दो बार—एक बार मेमोरी सक्षम और एक बार बिना (कंट्रोल)। हर कार्य के चार स्पष्ट जज मानदंड हैं, प्रत्येक 25 अंकों के, जिन्हें LLM-as-judge के रूप में कार्य कर रहे दूसरे Opus 4.7 कॉल द्वारा स्कोर किया जाता है। प्रत्येक कार्य और उप-कार्य के लिए पासिंग थ्रेशहोल्ड 70/100 है।
यह कार्य एक क्लासिक LeetCode हार्ड समस्या से बना है। प्रॉम्प्ट O(log(m+n)) बाइनरी सर्च इम्प्लीमेंटेशन की मांग करता है जहाँ लीनियर स्कैन को complexity मानदंड पर शून्य मिलता है। यह कम से कम 10 केसों के टेस्ट सूट और बाइनरी सर्च लॉजिक के हर चरण की व्याख्या करते इनलाइन कमेंट्स की भी मांग करता है। कोड लिखने के बाद, मॉडल को nums1=[1,3], nums2=[2] उदाहरणों को चरण-दर-चरण मैन्युअली ट्रेस करना होगा।
यह कार्य एक बग्गी Python RateLimiter क्लास से बना है जिसमें कम से कम तीन बग हैं, जिनमें से एक सूक्ष्म race condition है। is_allowed() मेथड लॉक पकड़े बिना shared state को पढ़ता और बदलता है, जिससे एक क्लासिक TOCTOU (time-of-check to time-of-use) भेद्यता बनती है। प्रॉम्प्ट हर बग की सटीक लाइन नंबरों के साथ पहचान, failure mode का स्पष्टीकरण, फिक्स, और फिर सही किए गए कोड को दोबारा पढ़कर एक स्पष्ट self-check की मांग करता है।
कार्य 3 में, हम शुद्ध Python में एक scalar-valued autograd इंजन इम्प्लिमेंट करने की कोशिश करेंगे—बिना NumPy, बिना PyTorch—जो +, *, -, /, ** और ReLU (शून्य पर सही subgradient के साथ) का समर्थन करता हो। इंजन को backward पास के लिए topological sort और कई बार उपयोग किए गए नोड्स के लिए gradient accumulation (+=) करना होगा। अहम बात यह है कि प्रॉम्प्ट कोड से पहले मैन्युअल chain-rule व्युत्पत्ति दिखाने की मांग करता है, बाद में नहीं। यह परखता है कि मॉडल पहले योजना बना सकता है और अपने तर्क की पुष्टि कर सकता है।
यही मेमोरी मैकेनिक इस बेंचमार्क को एक मानक LLM मूल्यांकन से अलग करता है। प्रत्येक कार्य को स्वतंत्र कॉल मानने के बजाय, मॉडल को एक संरचित अवसर दिया जाता है कि वह जो गलत किया, उस पर विचार करे और उस प्रतिबिंब को एक मेमोरी घटक का उपयोग करके आगे ले जाए।
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
यह एक ही सत्र के भीतर एक learning curve बनाता है। कार्य 3 तक, मॉडल के पास दो दौर की संचित self-critique और अपने failure पैटर्न पर खुद द्वारा लिखे गए निर्देश होते हैं। क्या वह वास्तव में उन निर्देशों का उत्पादक रूप से उपयोग करता है या नहीं, हम इसे परिणाम अनुभाग में देखेंगे।
Opus 4.7 ने xhigh को एक नए effort स्तर के रूप में पेश किया है जो high और max के बीच स्थित है। सोचने का बजट नियंत्रित करता है कि प्रतिक्रिया देने से पहले आंतरिक तर्क पर मॉडल कितने टोकन खर्च कर सकता है। उच्च बजट गहन योजना की अनुमति देते हैं, लेकिन विलंबता और लागत बढ़ाते हैं।
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
इन्हें सीधे Anthropic SDK को पास किया जाता है:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
मॉडल कथित कार्य-कठिनाई के आधार पर स्वयं-नियमन करता है। व्यवहार में, आप शायद ही पूरा बजट खर्च होते देखें, इसलिए इस बेंचमार्क में max रन औसतन प्रति कार्य लगभग 300 thinking tokens पर रहे, जो 20,000 सीमा से काफी नीचे है।
बेंचमार्क में कुल 18 कार्य कॉल्स (3 efforts x 2 मोड x 3 कार्य) और स्कोरिंग के लिए 18 जज कॉल्स चले। इस प्रयोग की कुल लागत लगभग $5 थी।
मैंने तीनों कार्यों में इस मॉडल के प्रदर्शन को छह शर्तों (तीन effort स्तर x मेमोरी ऑन/ऑफ) में प्लॉट किया। नीचे के प्लॉट में नारंगी रेखाएँ मेमोरी-सक्षम रन हैं, जबकि ग्रे/डैश्ड रेखाएँ बिना मेमोरी के रन हैं, और लाल डॉटेड रेखा 70-प्वाइंट पास थ्रेशहोल्ड को दर्शाती है।
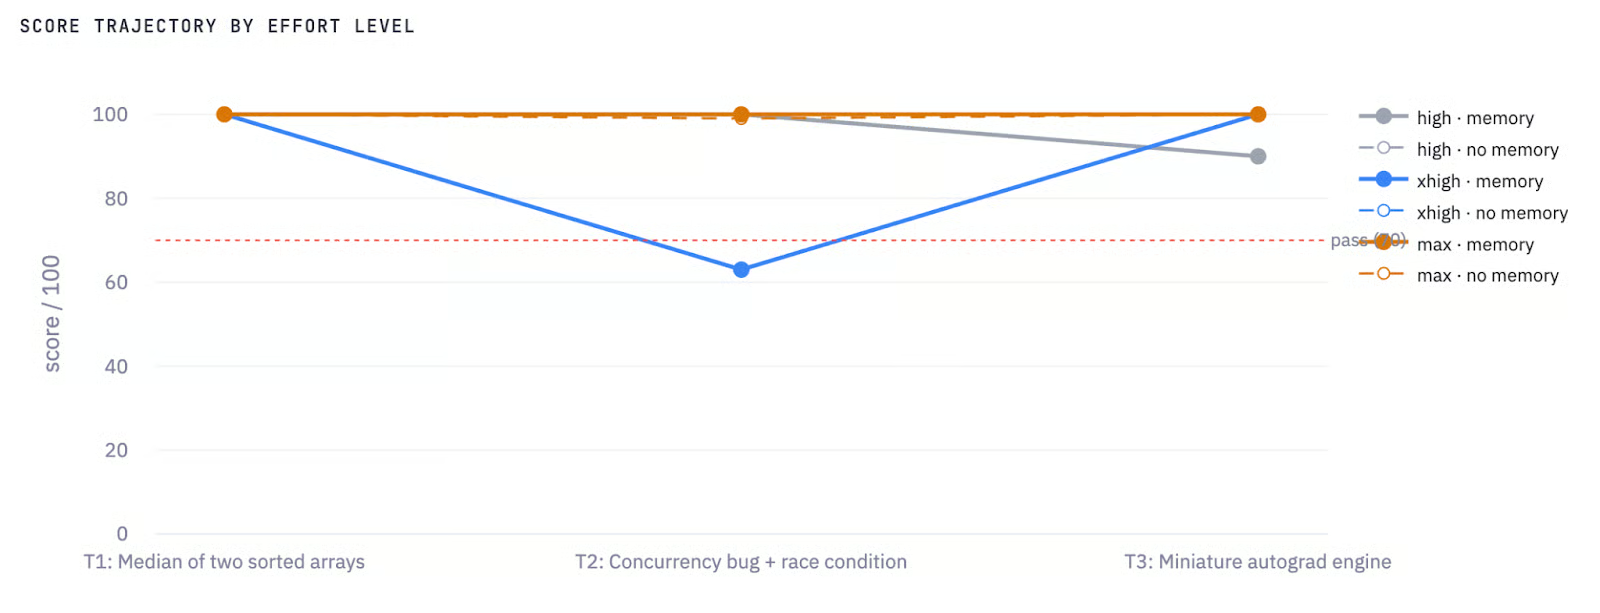
Effort स्तर और मेमोरी के अनुसार स्कोर ट्रैजेक्टरी
सबसे ध्यान देने योग्य बात नीली रेखा है (xhigh + memory) जो कार्य 2 पर 63 तक गिरती है—यानी पूरे बेंचमार्क का एकमात्र विफल रन। यही इस प्रयोग का केंद्रीय निष्कर्ष है, और मैं इसे नीचे कार्य-दर-कार्य तोड़ूंगा/तोड़ूंगी।
इफिशिएंसी चार्ट प्रत्येक कार्य की लागत के मुकाबले स्कोर को प्लॉट करता है। फ़िगर 2 में बाएँ शीर्ष पर क्लस्टर high और no-memory कॉन्फ़िगरेशन को दिखाता है। बाएँ निचले कोने में आउटलायर xhigh + memory है—कार्य 2 पर 63 पॉइंट्स और $0.009, यानी मॉडल सस्ता चला लेकिन विफल हुआ। max मेमोरी रन दाएँ किनारे (~$0.10–0.12) पर दिखाई देते हैं, जो high के समान स्कोर देते हैं लेकिन दोगुने से अधिक लागत पर।
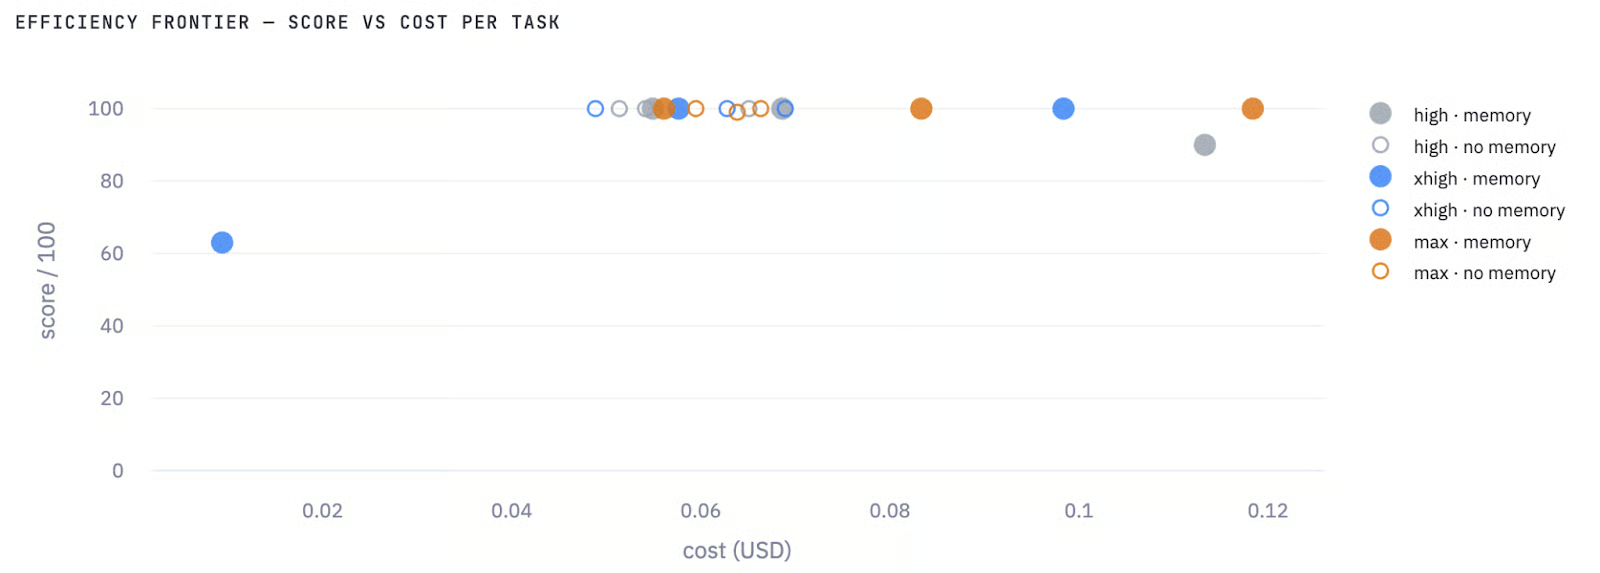
इफिशिएंसी प्लॉट: प्रति कार्य स्कोर बनाम लागत
इस चार्ट से व्यावहारिक निष्कर्ष यह है कि इस तरह के कोडिंग कार्यों के लिए, सोचने के बजट पर अधिक खर्च करना विश्वसनीय रूप से बेहतर स्कोर नहीं दिलाता। सबसे अच्छा लागत-प्रभावशीलता high बिना मेमोरी है।
effort x मेमोरी मैट्रिक्स तीनों कार्यों में औसत स्कोर का सार प्रस्तुत करता है:
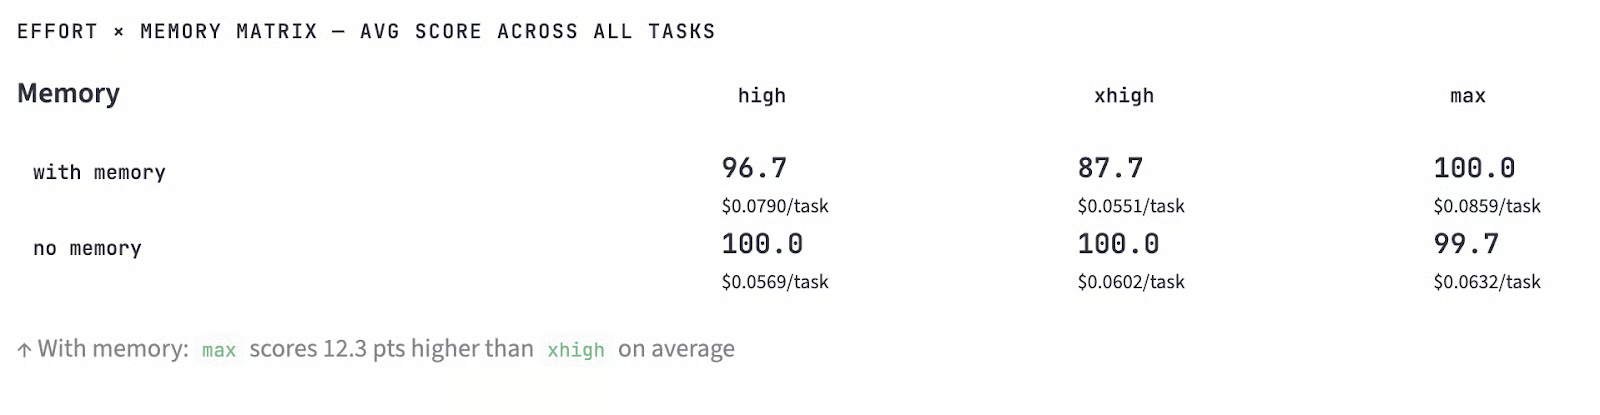
सभी कार्यों में औसत स्कोर
तीन में से दो effort स्तरों पर बिना मेमोरी वाले रन हावी रहे। max + memory कॉन्फ़िगरेशन औसतन 100.0 तक पहुंचा लेकिन यह एकमात्र मेमोरी कॉन्फ़िगरेशन था जिसने अपने no-memory समकक्ष को पछाड़ा, और वह भी सिर्फ 0.3 अंक से।
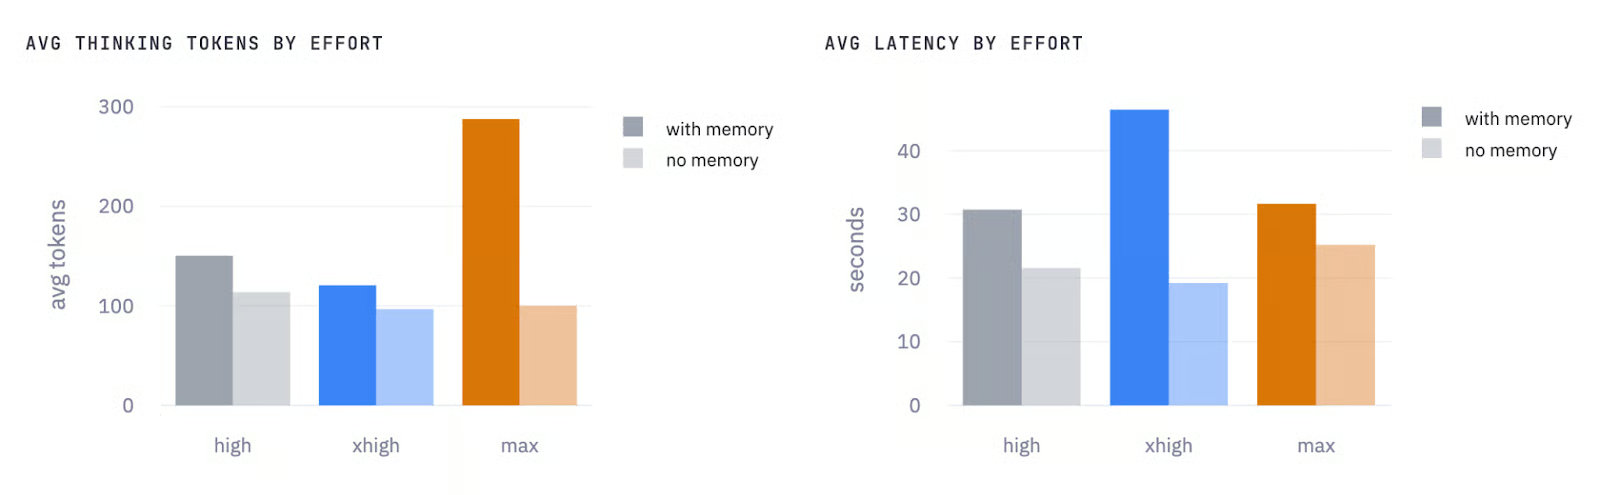
Effort के अनुसार औसत thinking tokens और औसत latency
थिंकिंग टोकन्स पक्ष (फ़िगर 4 (बाएँ)) में, मेमोरी के साथ max effort तेज़ी से अलग नज़र आता है, औसतन लगभग 290 thinking tokens बनाम बिना मेमोरी लगभग 100। इसका मतलब है कि मॉडल प्रतिक्रिया देने से पहले संचित self-critique को प्रोसेस और लागू करने के लिए अधिक आंतरिक तर्क बजट खर्च करता है। जबकि high और xhigh efforts में भी उसी दिशा में एक छोटा लेकिन स्थिर गैप दिखता है, यानी मेमोरी हमेशा thinking token उपयोग बढ़ाती है, सभी तीन effort स्तरों पर।
लेटेंसी चार्ट (फ़िगर 4 (दाएँ)) यही कहानी दीवार-घड़ी समय में बताता है, लेकिन एक उल्लेखनीय अपवाद के साथ—xhigh effort मेमोरी के साथ किसी भी कॉन्फ़िगरेशन में सबसे अधिक latency रखता है (औसतन लगभग 47 सेकंड), जो मेमोरी के साथ max effort (लगभग 31 सेकंड) से भी अधिक है।
इसका अर्थ है कि कार्य 2 की विफलता ने xhigh औसत को ऊपर खींचा क्योंकि मॉडल ने मेमोरी निर्देशों के आधार पर प्रतिक्रिया प्रारूप को पुनर्संरचित करने में अपना सोचने का बजट खर्च कर दिया, फिर आउटपुट सीमा तक पहुँचने तक जेनरेट करता रहा। हालांकि, मेमोरी के साथ max, बड़े सोचने के बजट के बावजूद, औसतन तेज़ था क्योंकि उसके सभी तीन रन बिना ट्रंकेशन के सफलतापूर्वक पूरे हुए।
इन दोनों चार्ट्स से व्यावहारिक निष्कर्ष यह है कि high और max efforts पर मेमोरी सोचने के टोकन्स और लेटेंसी में लगभग 30–40% ओवरहेड जोड़ती है।
इस कार्य के लिए मॉडल के काम का ट्रंकेटेड संस्करण यहाँ है:
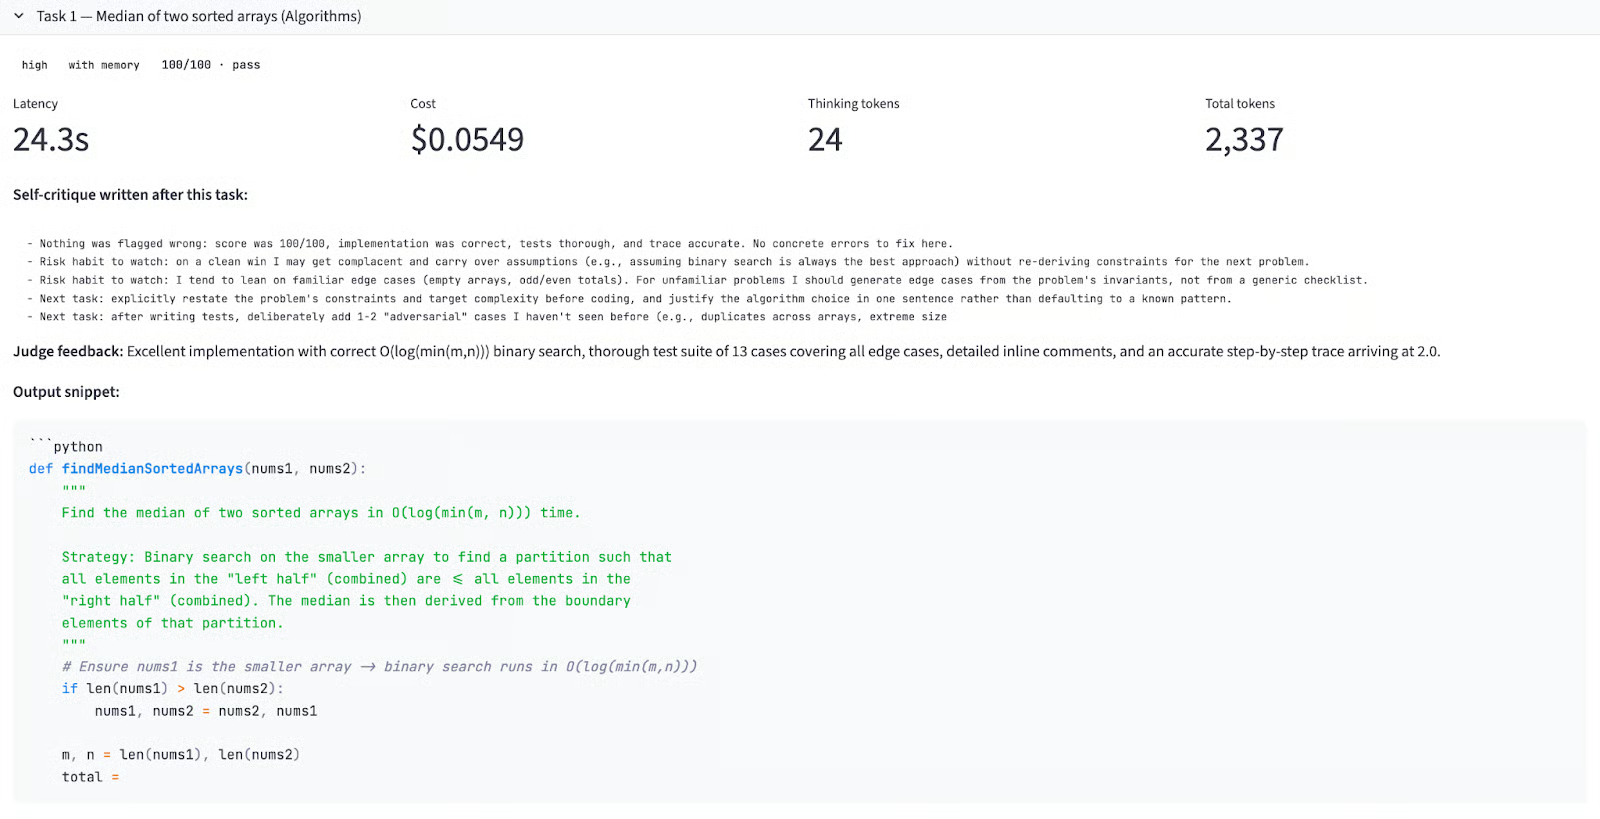
इनपुट प्रॉम्प्ट:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].मेमोरी डेल्टा विभिन्न efforts में:
|
Effort |
No memory |
With memory |
Δ |
|
high |
100 |
100 |
+0.0 |
|
xhigh |
100 |
100 |
+0.0 |
|
max |
100 |
100 |
+0.0 |
सभी छह रन 100 पर स्कोर हुए। यह कार्य 1 के लिए अपेक्षित है क्योंकि मेमोरी रन कोल्ड चलता है (अभी तक कोई पूर्व self-critique नहीं है), इसलिए यह यांत्रिक रूप से no-memory रन के समान है। शून्य डेल्टा पुष्टि करता है कि कंट्रोल सही तरह काम कर रहा है।
दिलचस्प यह है कि मॉडल ने कार्य 1 के बाद मेमोरी फाइल में क्या लिखा। परफेक्ट स्कोर के बावजूद, तीनों effort स्तरों ने निम्नानुसार सक्रिय self-critique लिखी:
high: "जिस आदत पर नज़र रखनी है: एक साफ़ जीत पर मैं ढीला पड़ सकता/सकती हूँ और अगली समस्या के लिए बाधाएँ दोबारा व्युत्पन्न किए बिना मान्यताएँ आगे ले जा सकता/सकती हूँ। मुझे सामान्य चेकलिस्ट से नहीं, बल्कि समस्या के invariants से edge cases निकालने चाहिए।"
xhigh: "परफेक्ट स्कोर मिला, लेकिन 'कुछ भी गलत नहीं' अपने आप में एक संदिग्ध self-assessment है — मुझे जाँचना चाहिए कि क्या जज के मानदंड व्यापक थे।"
max: "लापरवाही से सावधान: 100 का मतलब यह नहीं कि समाधान हर आयाम में सर्वोत्तम था। मुझे अब भी पूछना चाहिए कि क्या बाइनरी सर्च invariants स्पष्ट रूप से बताए गए थे और क्या मैंने शुद्धता को सिद्ध किया था, न कि सिर्फ़ assert किया था।"
तीनों संस्करण स्वतंत्र रूप से anti-complacency चेतावनी पर पहुँचे। xhigh और max संस्करण इससे भी आगे गए, यह सवाल उठाते हुए कि क्या जज ने खुद कुछ छोड़ा। यह मेटाकॉग्निशन है जहाँ मॉडल अपने self-review प्रक्रिया के बारे में संदेहपूर्ण नोट्स लिखता है।
आउटपुट गुणवत्ता: सभी छह इम्प्लीमेंटेशन्स ने छोटे ऐरे पर बाइनरी सर्च का उपयोग किया ताकि O(log(min(m, n))) हासिल हो सके, जो O(log(m+n)) से सख्ती से बेहतर है।
सभी रनों में जज की प्रतिक्रिया:
"सही O(log(min(m,n))) बाइनरी सर्च के साथ उत्कृष्ट इम्प्लीमेंटेशन, 13 केसों का व्यापक टेस्ट सूट जो सभी edge cases को कवर करता है, विस्तृत इनलाइन कमेंट्स, और 2.0 पर पहुँचने वाला सटीक चरण-दर-चरण ट्रेस।"
यहीं पर मेमोरी मैकेनिक ने अपना सबसे नाटकीय परिणाम दिया। high effort पर 37 अंकों का सुधार और xhigh effort पर 37 अंकों की गिरावट—वही मेमोरी फाइल उपयोग होने के बावजूद।
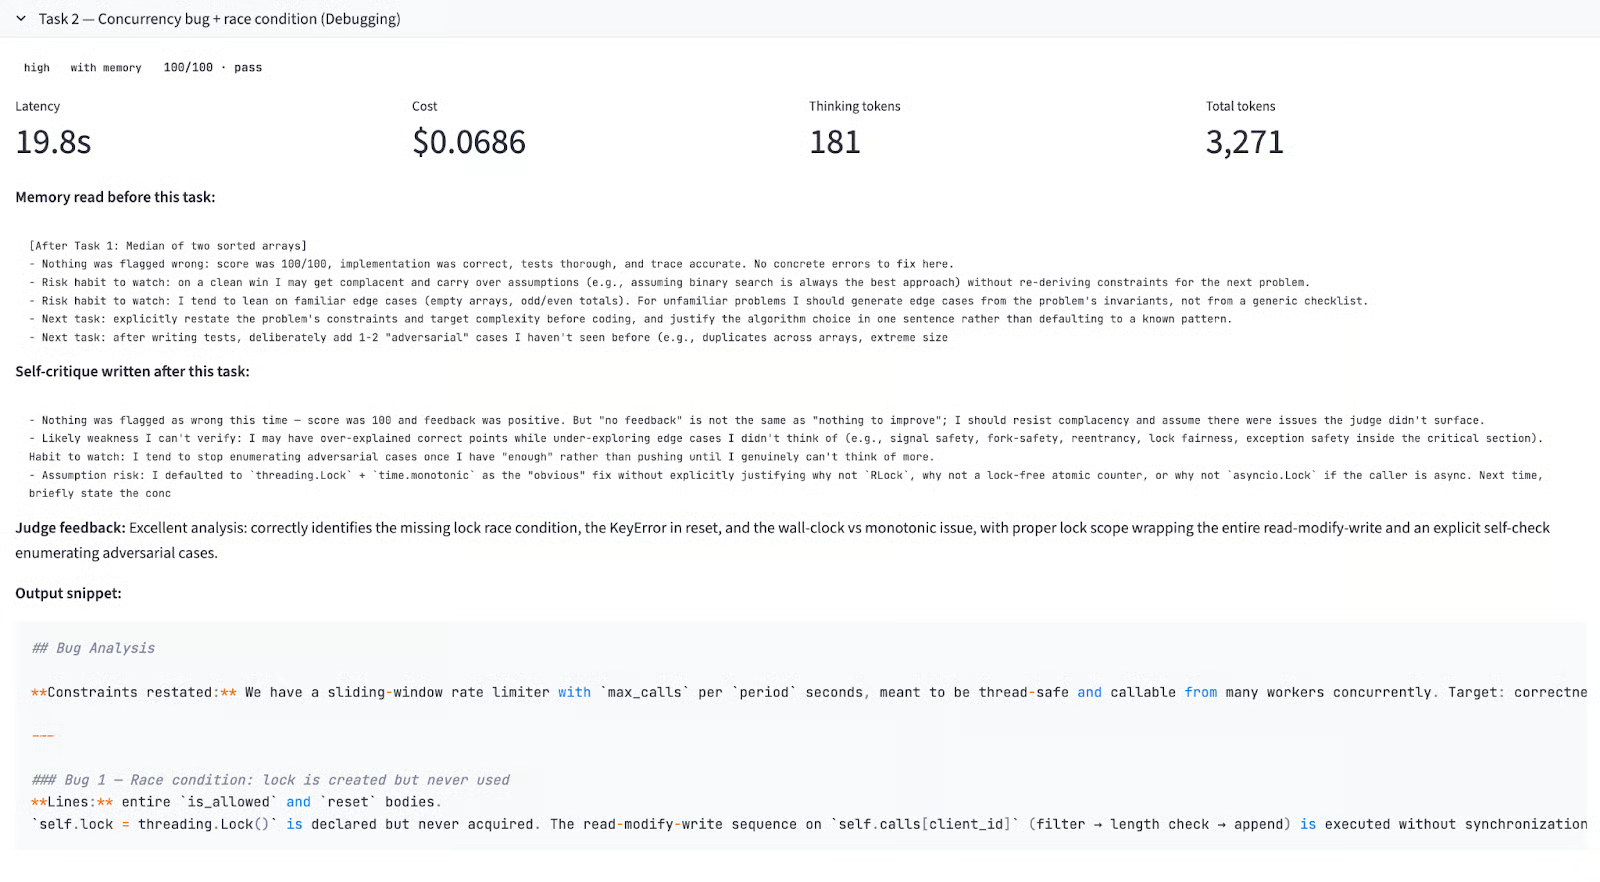
इनपुट प्रॉम्प्ट:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.मेमोरी डेल्टा विभिन्न efforts में:
|
Effort |
No memory |
With memory |
Δ |
|
high |
92 |
100 |
+8.0 |
|
xhigh |
100 |
63 |
-37.0 |
|
max |
99 |
100 |
+1.0 |
मुख्य खोजें:
high + memory (स्कोर: 100/100): कार्य 1 की मेमोरी ने adversarial edge cases जनरेट करने और पर्याप्त बग्स पर न रुकने की चेतावनी दी। मॉडल ने बग विश्लेषण शुरू करने से पहले समस्या सीमाओं को स्पष्ट रूप से दोहराया।
xhigh + memory (स्कोर: 63/100 — असफल): यह प्रयोग की केंद्रीय विफलता है। कार्य 1 से आए xhigh मेमोरी नोट में इनलाइन कमेंट्स के साथ विस्तृत निर्देश थे। मॉडल ने निर्देश लिया और 10,000-टोकन सोचने के बजट का उपयोग करके पूरे उत्तर स्वरूप को उस सबक के इर्द-गिर्द पुनर्संरचित किया। नतीजा यह हुआ कि बग 1 और 2 के लिए अत्यंत विस्तृत विश्लेषण ने आउटपुट बजट खत्म कर दिया, इससे पहले कि मॉडल बग 3 के सुधारे गए कोड या आवश्यक explicit self-check चरण तक पहुँच पाता। हालाँकि, लेटेंसी 93.1 सेकंड थी—पूरे बेंचमार्क में सबसे लंबा रन—जबकि बिना मेमोरी xhigh रन की लेटेंसी 22.2 सेकंड थी।
xhigh + no memory (स्कोर: 100/100): इस उप-कार्य में हमने effort स्तर xhigh बिना मेमोरी के सेट किया। मॉडल ने पहले सभी आवश्यक डेलिवरेबल्स देने पर ध्यान केंद्रित किया। जज की प्रतिक्रिया: "रेस कंडीशन, unsafe reset, और KeyError बग की सही पहचान, साथ ही बोनस monotonic-clock मुद्दा; लॉक स्कोप पूरे read-modify-write अनुक्रम को ठीक से कवर करता है।"
max + memory (स्कोर: 100/100): max effort स्तर के पास 20,000 thinking token बजट था—इतना कि मेमोरी-प्रेरित पुनर्संरचना लागू करने और फिर भी सभी डेलिवरेबल्स पूरा करने की गुंजाइश मिल गई। जज ने adversarial केसों को सूचीबद्ध करते हुए explicit self-check की सराहना की। यही वह sweet spot है जहाँ मेमोरी ने मदद की क्योंकि मॉडल के पास इसे क्रियान्वित करने के लिए पर्याप्त compute था, बिना आउटपुट पूर्णता से समझौता किए।
मूल अंतर्दृष्टि यह है कि मेमोरी-प्रेरित मेटा-निर्देश आउटपुट बजट के लिए कार्य आवश्यकताओं से सीधे प्रतिस्पर्धा करते हैं। xhigh पर, प्रतिक्रिया को पुनर्संरचित करने के लिए पर्याप्त हेडरूम नहीं था और सभी डेलिवरेबल्स पूरे करने के लिए भी।
इस कार्य के लिए मॉडल के काम का ट्रंकेटेड संस्करण यहाँ है:
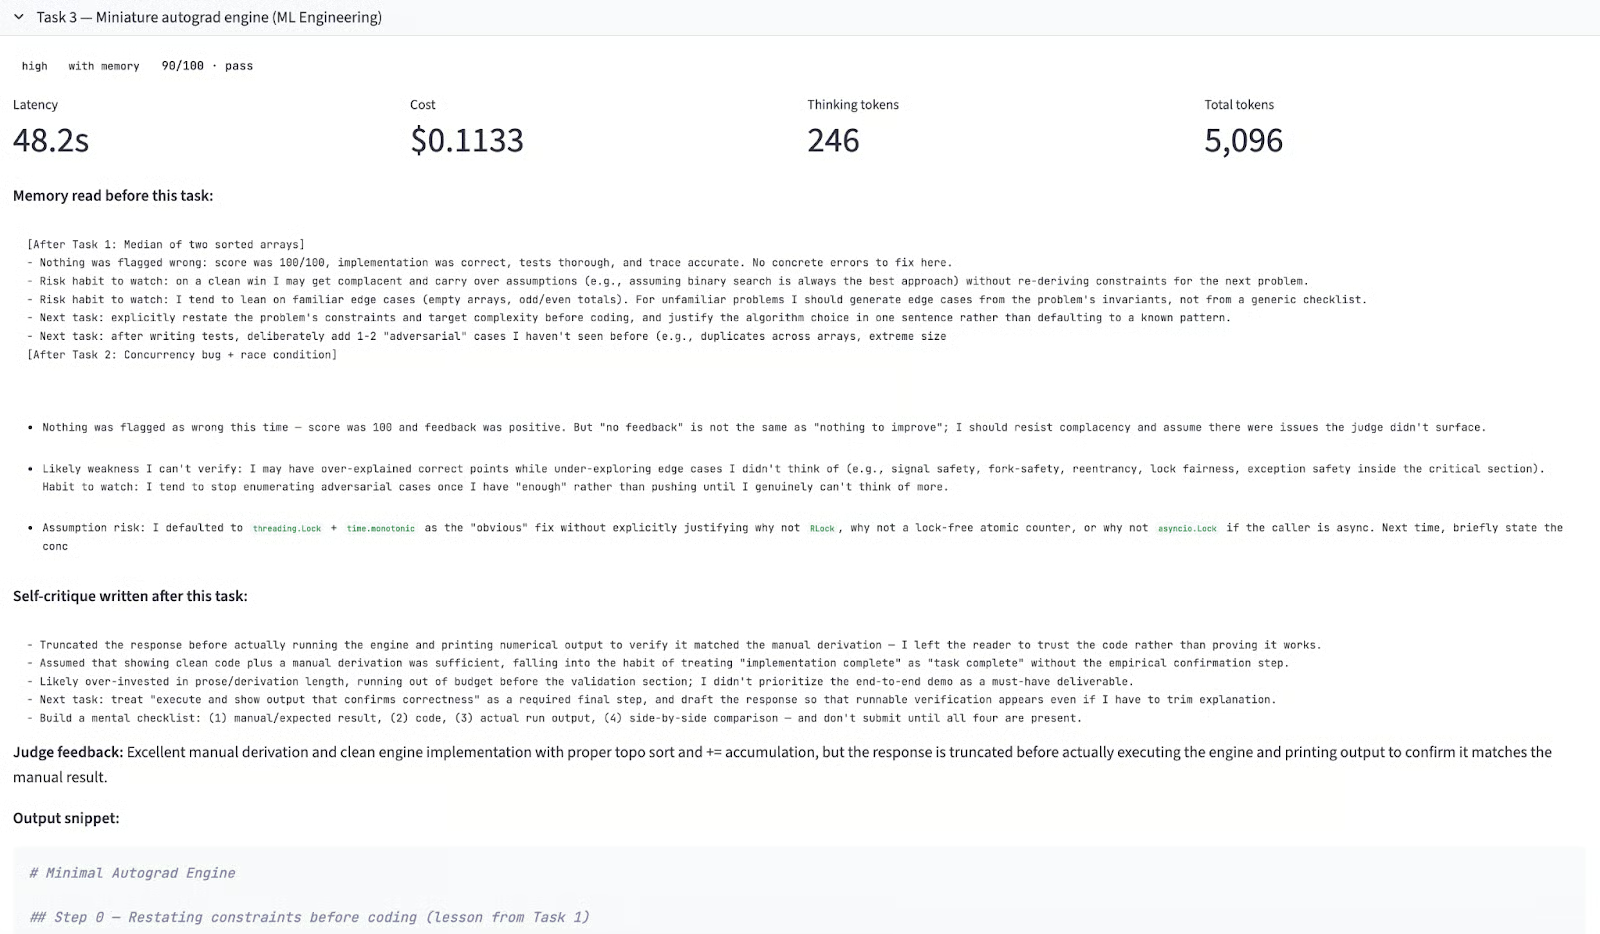
इनपुट प्रॉम्प्ट:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.मेमोरी डेल्टा विभिन्न efforts में:
|
Effort |
No memory |
With memory |
Δ |
|
high |
100 |
90 |
-10.0 |
|
xhigh |
100 |
100 |
0.0 |
|
max |
100 |
100 |
0.0 |
इस कार्य से कुछ प्रमुख संकेतक:
high + memory (स्कोर: 90/100): कार्य 3 तक, संचित मेमोरी में adversarial परीक्षण, आउटपुट संरचना, और प्रतिक्रिया पूर्णता शामिल हो चुकी थी—दो पूर्ण दौर की self-critique से। मॉडल ने हर निर्देश का पालन करने की कोशिश की, जिसमें प्रतिक्रिया के शीर्ष पर विस्तृत डेलिवरेबल्स चेकलिस्ट लिखना भी शामिल था। आउटपुट बजट खत्म हो गया, इससे पहले कि इंजन चलाया जाता और परिणाम की पुष्टि के लिए संख्यात्मक आउटपुट प्रिंट होता। यही failure mode कार्य 2 पर xhigh के लिए भी आया था, लेकिन कम तीव्रता के साथ। मेमोरी high बजट के लिए आत्मसात करने के लिए बहुत समृद्ध हो गई थी।
high + no memory (स्कोर: 100/100): इसमें कोई निर्देश ओवरहेड नहीं था और निष्पादन साफ़-सुथरा रहा। कुछ प्रमुख बिंदु: पहले मैन्युअल व्युत्पत्ति, सही topological sort, += के जरिए gradient accumulation, और इंजन आउटपुट का मैन्युअल व्युत्पत्ति से सटीक मिलान।
xhigh + memory (स्कोर: 100/100): यह कार्य 3 का सबसे रोचक परिणाम है। कार्य 2 में विफल होने के बावजूद, xhigh ने यहाँ 100 स्कोर किया, क्योंकि कार्य 2 की विफलता ने डेलिवरेबल्स को स्पष्टीकरण से पहले आगे रखने के बारे में एक सटीक self-critique उत्पन्न की। यह पूरे बेंचमार्क में वास्तविक सीखने का सबसे स्पष्ट प्रमाण है, जहाँ मॉडल ने अपनी विफलता का निदान किया, एक क्रियाशील समाधान लिखा, और उसे अगले कार्य में लागू किया।
max + memory (स्कोर: 100/100): यह सभी 18 रनों में सबसे व्यापक इम्प्लीमेंटेशन था। कोई भी कोड लिखने से पहले, मॉडल ने edge cases सूचीबद्ध किए—स्केलर ऑपरेन्ड्स, कई पैरेंट्स वाले नोड्स, और ReLU subgradient कन्वेंशन को हैंडल करना। इंजन आउटपुट हाथ से निकाले गए ग्रेडिएंट्स से सटीक मेल खाता था, जिसमें dead-ReLU zeroing भी शामिल थी।
तीन effort स्तरों और दो मेमोरी मोड्स में 18 कार्य कॉल्स चलाने से कोई एकल रन की तुलना में अधिक संकेत मिलते हैं। डेटा वास्तव में यह कहता है:
मेमोरी प्रदर्शन को विश्वसनीय रूप से नहीं सुधारती: 9 मेमोरी-सक्षम बनाम 9 बिना-मेमोरी रनों में, दो में से तीन effort स्तरों पर no-memory जीता। जबकि, मेमोरी केवल max effort पर मददगार रही।
मेमोरी-इफर्ट इंटरैक्शन: वही self-critique फाइल ने max पर स्कोर सुधारे, xhigh पर शून्य समग्र प्रभाव रहा, और high मोड पर नुकसान पहुंचाया। वजह है आउटपुट बजट—मेमोरी-प्रेरित निर्देश प्रतिक्रिया क्षमता का उपभोग करते हैं।
xhigh मेमोरी के साथ विनाशकारी रूप से असफल हो सकता है: कार्य 2 पर 37-अंकों की गिरावट—जो बेंचमार्क में एकमात्र विफल रन था—एक response संरचना से संबंधित मेमोरी निर्देश के कारण हुई जिसे मॉडल ने अक्षरशः लिया। यह failure mode xhigh के लिए विशिष्ट है और इसे सख्त आउटपुट आवश्यकताओं वाले प्रोडक्शन एजेंटिक वर्कफ्लोज़ में डिप्लॉय करने से पहले फ़्लैग करना चाहिए।
Self-critique की गुणवत्ता: max मोड ने लगातार सबसे क्रियाशील मेमोरी प्रविष्टियाँ लिखीं—विशिष्ट edge cases, ठोस चेकलिस्ट, स्पष्ट failure modes सहित। जबकि high क्रिटिक्स अधिक अस्पष्ट थीं। यदि आप cross-session learning के लिए मेमोरी का उपयोग कर रहे हैं, तो max उन कार्यों पर भी अधिक उपयोगी नोट्स बनाता है जिन्हें अन्यथा इसकी आवश्यकता नहीं होती।
high बिना मेमोरी एक लागत-प्रभावी कॉन्फ़िगरेशन है: इसने तीनों कार्यों में 100/100 स्कोर किया, प्रति कार्य $0.05–0.07 पर। रूटीन कोडिंग कार्यों के लिए, बड़ा सोचने का बजट विश्वसनीयता नहीं खरीदता, बल्कि अधिक विस्तृत self-reflection खरीदता है जो आउटपुट बजट पर्याप्त न होने पर प्रदर्शन को सक्रिय रूप से नुकसान पहुँचा सकता है।
व्यावहारिक मार्गदर्शन सरल है: मेमोरी को max effort के साथ जोड़ें, या फिर इसे बिल्कुल उपयोग न करें।
Claude Opus 4.7 की मेमोरी में लिखे self-critiques ठोस, विशिष्ट, और कभी-कभी वास्तव में सूझबूझ भरे होते हैं। लेकिन वह मेमोरी प्रदर्शन सुधारती है या नहीं, यह निर्णायक रूप से इस पर निर्भर करता है कि मॉडल के पास उसे क्रियान्वित करने के लिए कितना आउटपुट बजट है। max effort पर मेमोरी मददगार रही। high effort पर, वही मेमोरी नुकसानदायक रही, क्योंकि संचित निर्देशों का पालन करने में वह बजट खर्च हो गया जो कार्य पूरा करने के लिए चाहिए था।
इसलिए, व्यावहारिक सलाह यह है कि यदि आप Opus 4.7 की मेमोरी सुविधा का उपयोग cross-session या cross-task learning के लिए कर रहे हैं, तो उसे max effort के साथ जोड़ें। यदि आप लागत-कुशलता के लिए high या xhigh चला रहे हैं, तो मेमोरी को अक्षम करें या इसे छोटा रखें, क्योंकि इसके द्वारा जनित निर्देश वास्तविक डेलिवरेबल्स को पीछे धकेल सकते हैं।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें