

Corso
Introduzione ai modelli Claude
3 ore
15K
Pratica and corso your progress.
Continua Con GoogleIl Claude Opus 4.7 di Anthropic introduce un nuovo livello di impegno xhigh, a metà tra high e max, e mette in particolare evidenza il miglioramento della memoria del file system come capacità chiave, cioè il modello può scriversi appunti e riutilizzarli tra le sessioni.
Questo mi ha fatto sorgere una domanda ovvia: questa memoria funziona davvero in modo misurabile? Inoltre, Opus 4.7 impara dai propri errori e produce codice migliore al compito successivo?
Così ho costruito un harness di benchmark in Streamlit che esegue in sequenza tre task di programmazione complessi. Dopo ogni task, il modello scrive un'autocritica in un file di memoria (memory.md). Il task successivo legge quel file prima di iniziare. Ho eseguito il tutto con e senza memoria, su tutti e tre i livelli di impegno (high, xhigh e max), per un totale di 18 esecuzioni tramite Claude Opus 4.7 su Microsoft Foundry.
Alla fine di questo tutorial, sarai in grado di:
Il codice completo è disponibile nella repository GitHub.
Claude Opus 4.7 è il modello linguistico di grandi dimensioni più capace della famiglia Claude 4, al di sopra di Sonnet e Haiku. È pensato per task agentici di lunga durata, ingegneria del software avanzata e workflow enterprise che richiedono prestazioni costanti su sessioni estese.
Le tre capacità più rilevanti per questo tutorial sono:
xhigh: si colloca tra high (5.000 token di thinking) e max (20.000 token di thinking) a 10.000 token di thinking. L'idea è avere un controllo più fine di costi e qualità sui problemi difficili.Nota: il pricing è di $5 per milione di token in input e $25 per milione di token in output, identico a Opus 4.6. Se vuoi esplorare questo modello in profondità, questo articolo del team DataCamp è una buona lettura.
Alcuni numeri da conoscere prima del test:
|
Benchmark |
Punteggio |
|
SWE-bench Verified |
87,6% |
|
SWE-bench Pro |
64,2% |
|
GPQA Diamond |
94,2% |
|
OSWorld Verified (uso del computer) |
78,0% |
|
Finance Agent v1.1 |
64,4% |
Tutte le chiamate API in questo tutorial passano da Microsoft Foundry. Quindi serve una sottoscrizione Azure con accesso alla fatturazione pay-as-you-go, perché il livello gratuito per studenti non ha quota per i modelli di partner terzi come Claude. Una buona alternativa è usare la chiave API di Anthropic. Ho coperto entrambi gli approcci in questa repository.
Il primo passo del tutorial è trovare il modello nel catalogo modelli di Microsoft Foundry. Per questo,
claude-opus-4-7. Si aprirà una scheda del modello con le capacità principali, i benchmark e l'ID del modello.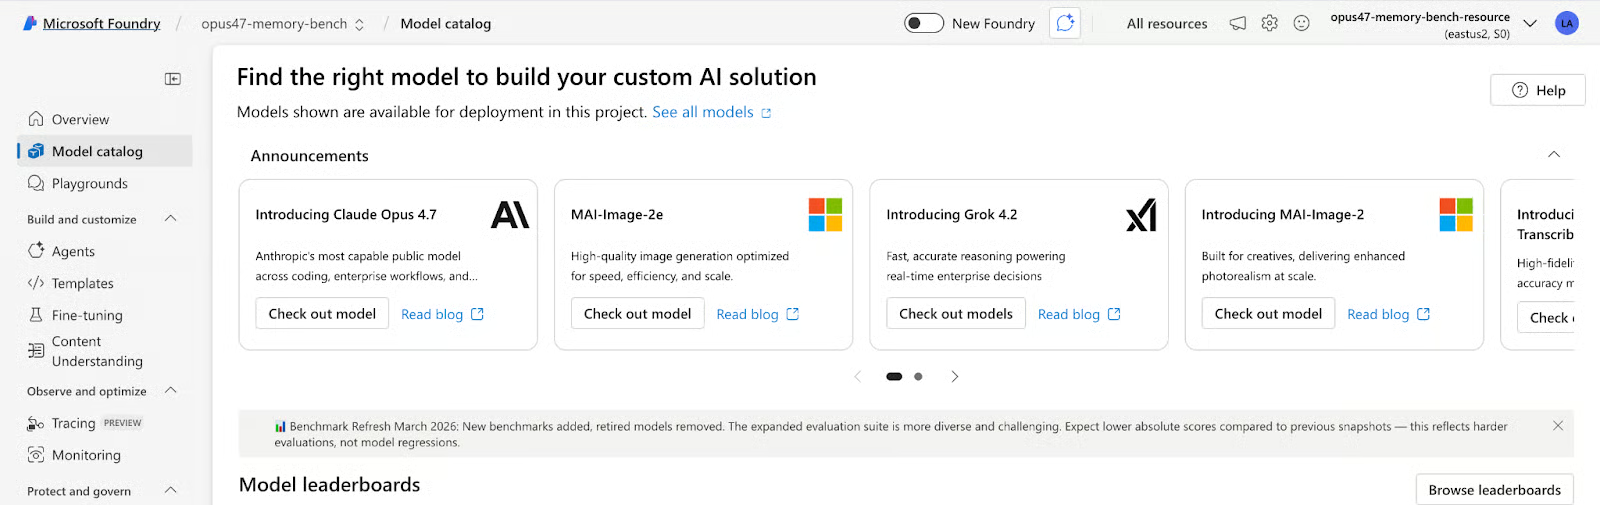
opus47-memory-bench. Quindi accetta i termini d'uso e acconsenti alla policy d'uso di Anthropic tramite Azure Marketplace.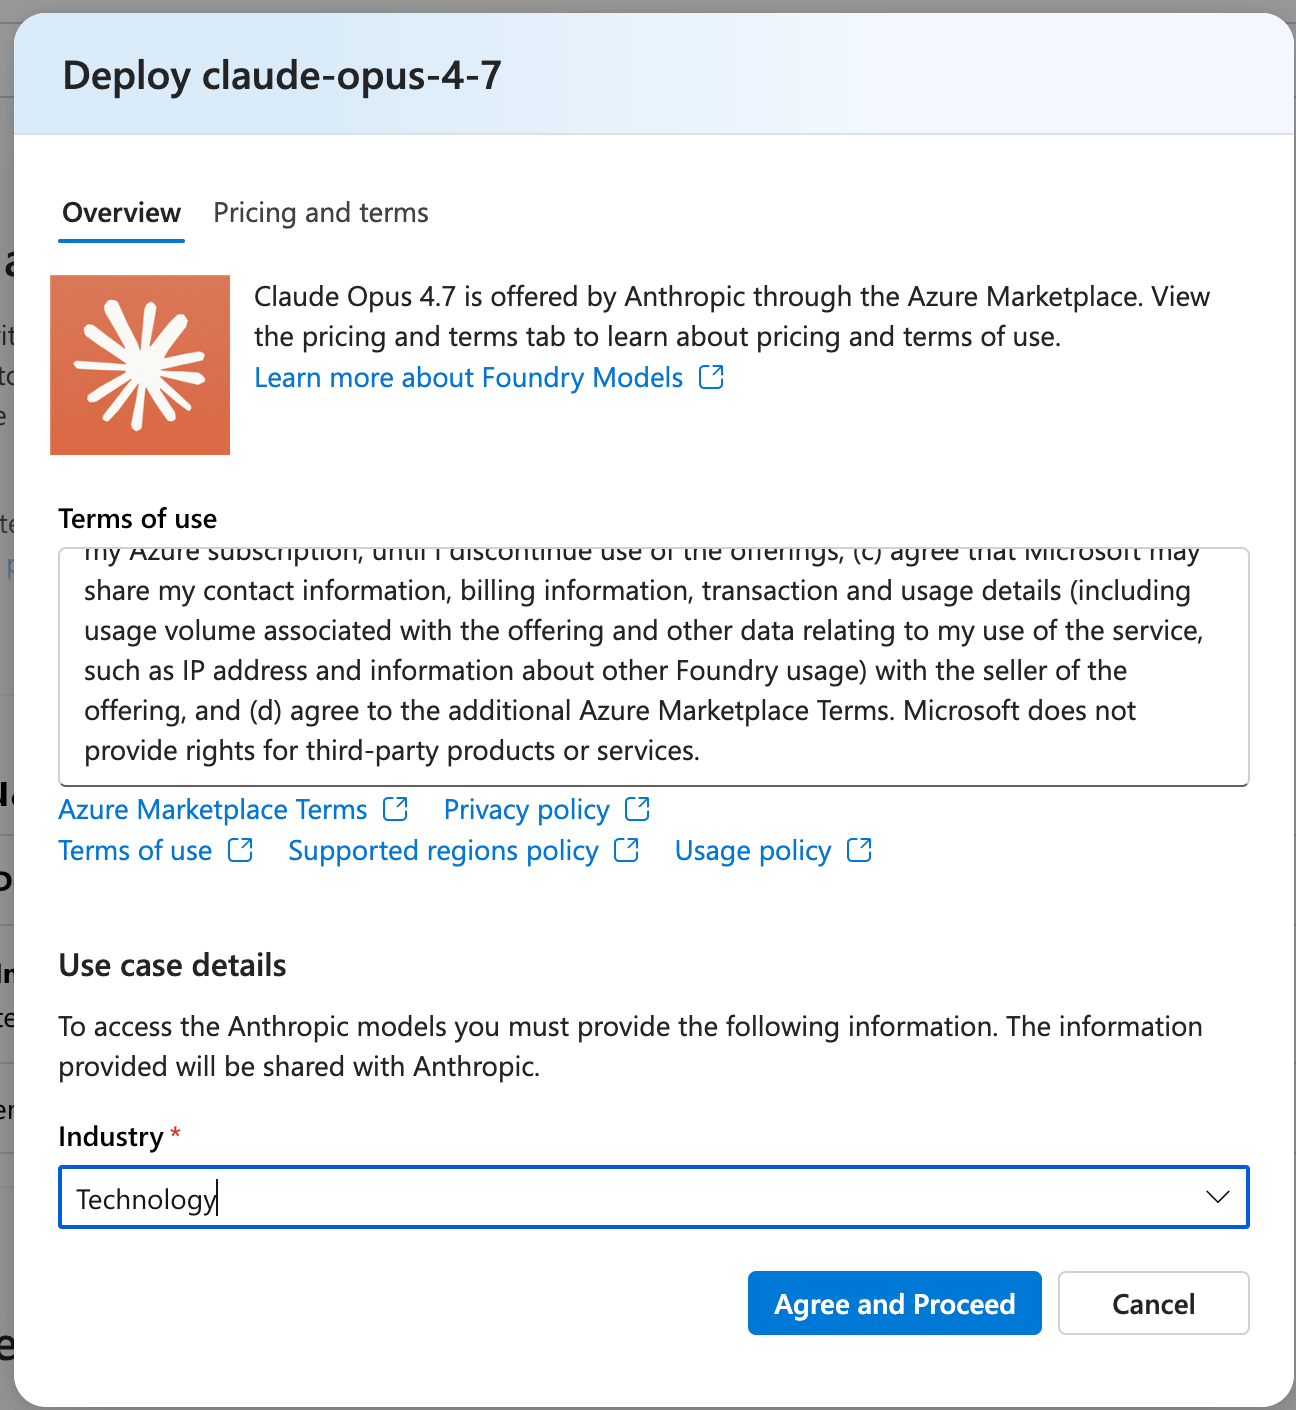
Una volta creato il progetto, atterrerai sulla finestra di deploy. Poi compila le seguenti informazioni:
Nome del deployment: claude-opus-4-7 (lascialo di default, il codice usa questa stringa)
Tipo di deployment: Global Standard (serverless, nessuna gestione della capacità)
Policy di aggiornamento versione del modello: consiglio di fissare la versione 1 anziché l'aggiornamento automatico, così le nuove release non rompono le esecuzioni esistenti
Clicca Create resource and deploy.
Una volta distribuito, apri il progetto nel portale Foundry. Nella scheda Overview, troverai quanto segue:
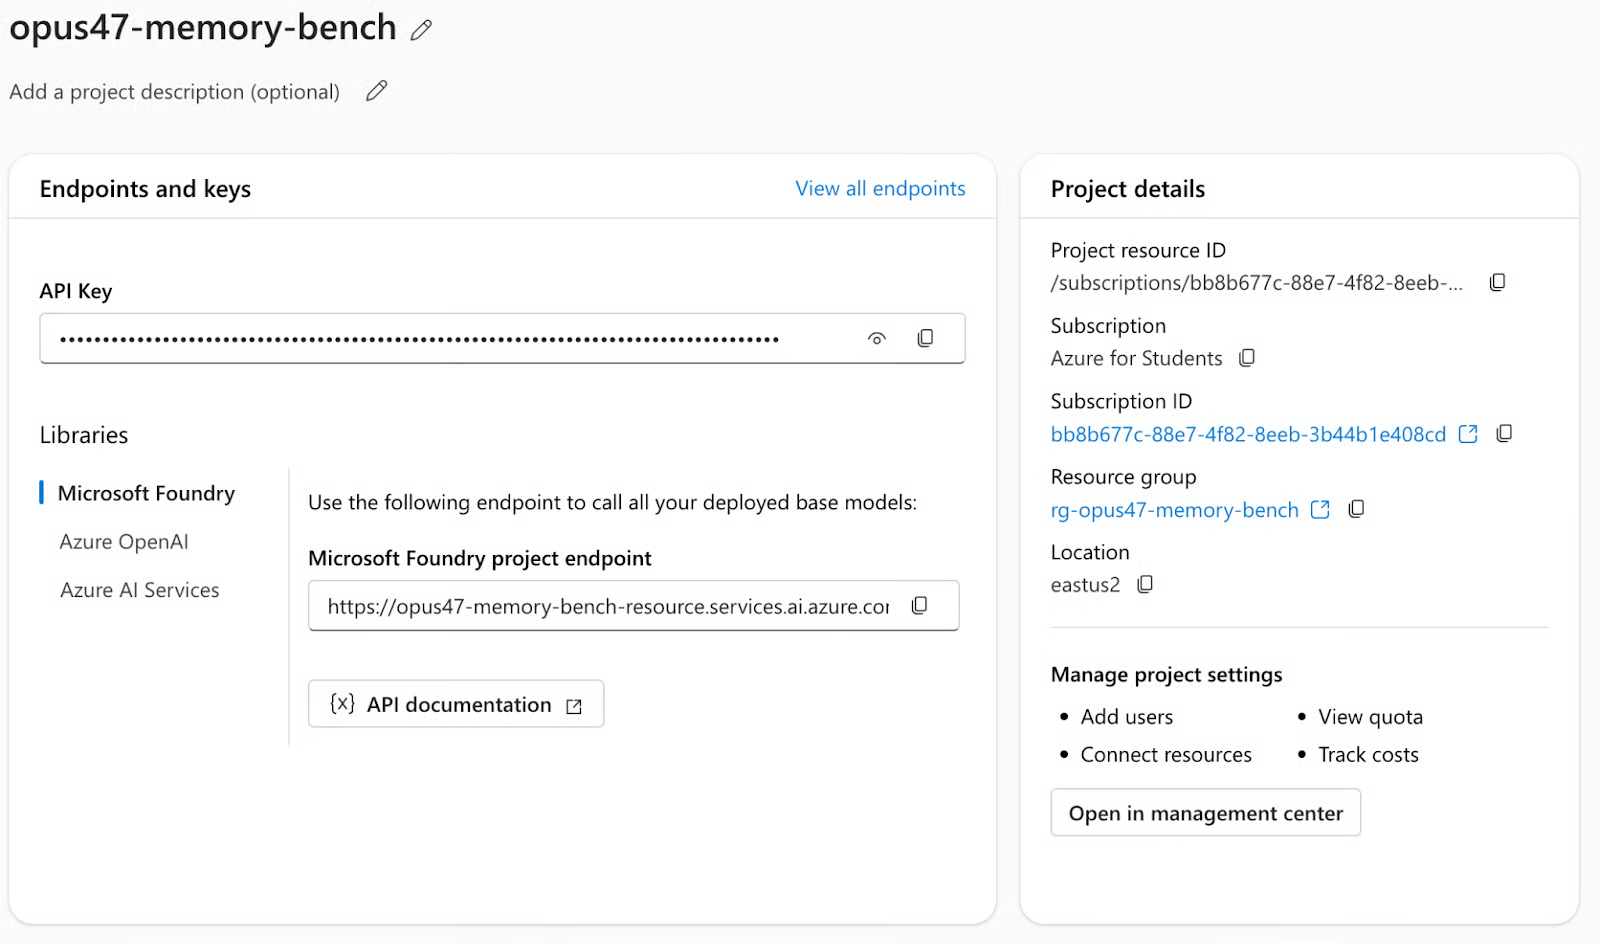
API key: Copia la chiave API e salvala per usi futuri. La imposteremo come ANTHROPIC_FOUNDRY_API_KEY.
Endpoint del progetto Microsoft Foundry: Copia il nome della risorsa dall'endpoint del progetto, disponibile nel formato https://your-resource.services.ai.azure.com, dove il nome della risorsa è il prefisso del sottodominio (cioè tutto ciò che precede .services.ai.azure.com). Lo imposteremo come ANTHROPIC_FOUNDRY_RESOURCE
Ora abbiamo tutte le risorse necessarie. Imposteremo le chiavi sopra come variabili d'ambiente ed eseguiremo l'applicazione Streamlit.
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
L'SDK di Anthropic gestisce automaticamente l'endpoint Foundry quando passi la base URL specifica della risorsa:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
Tutto il resto, incluse le chiamate al modello, i parametri di thinking e il parsing delle risposte, usa il normale SDK di Anthropic. Non serve alcun livello di compatibilità OpenAI.
L'harness in Streamlit esegue tre task in sequenza, due volte per livello di impegno: una con memoria abilitata e una senza (controllo). Ogni task ha quattro criteri di valutazione espliciti da 25 punti ciascuno, assegnati da una seconda chiamata a Opus 4.7 che funge da LLM-as-judge. La soglia di superamento per ciascun task e sottotask è 70/100.
Questo task consiste in un classico problema LeetCode hard. Il prompt richiede un'implementazione con ricerca binaria O(log(m+n)) dove una scansione lineare ottiene zero sul criterio di complessità. Richiede inoltre una suite di test di almeno 10 casi e commenti inline che spieghino ogni passaggio della logica di ricerca binaria. Dopo aver scritto il codice, il modello deve eseguire manualmente il trace su nums1=[1,3], nums2=[2] passo passo.
Questo task comprende una classe Python RateLimiter buggata con almeno tre bug, uno dei quali è una sottile race condition. Il metodo is_allowed() legge e muta lo stato condiviso senza mantenere il lock, creando una classica vulnerabilità TOCTOU (time-of-check to time-of-use). Il prompt richiede di identificare ciascun bug con i numeri di riga esatti, spiegare la modalità di failure, fornire il fix e poi eseguire un auto-check esplicito rileggendo il codice corretto.
Per il task 3, proveremo a implementare un motore di autograd scalare in puro Python, senza NumPy né PyTorch (supportando +, *, -, /, **) e ReLU con il sottogradiente corretto in zero. Il motore deve usare l'ordinamento topologico per il backward pass e l'accumulo dei gradienti (+=) per i nodi usati più volte. Fondamentale, il prompt richiede di mostrare la derivazione manuale della regola della catena prima del codice, non dopo. Questo verifica se il modello sa pianificare prima e verificare il proprio ragionamento.
La meccanica della memoria è ciò che distingue questo benchmark da una valutazione LLM standard. Invece di trattare ogni task come una chiamata indipendente, al modello viene data un'opportunità strutturata di riflettere su ciò che ha sbagliato e portare avanti quella riflessione usando un componente di memoria.
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
Questo crea una curva di apprendimento all'interno di una singola sessione. Al Task 3, il modello lavora con due round di autocritica accumulata e istruzioni che si è scritto da sé sui propri pattern di errore. Se effettivamente usa quelle istruzioni in modo produttivo o meno, è ciò che esploreremo nella sezione dei risultati.
Opus 4.7 introduce xhigh come nuovo livello di impegno tra high e max. Il budget di thinking controlla quanti token il modello può spendere su ragionamento interno prima di produrre la risposta. Budget più alti permettono pianificazione più profonda ma aumentano latenza e costi.
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
Questi vengono passati direttamente all'SDK di Anthropic:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
Il modello si autoregola in base alla difficoltà percepita del task. In pratica, raramente vedrai consumato l'intero budget, quindi le esecuzioni max in questo benchmark hanno mediato circa 300 token di thinking per task, ben al di sotto del limite di 20.000.
Il benchmark ha eseguito in totale 18 chiamate di task (3 livelli x 2 modalità x 3 task) e 18 chiamate del giudice per lo scoring. Il costo totale dell'esperimento è stato di circa $5.
Ho tracciato le prestazioni del modello sui tre task per tutte e sei le condizioni (tre livelli di impegno x memoria on/off). Le linee arancioni nel grafico seguente sono le esecuzioni con memoria, mentre le linee grigie/tratteggiate sono le esecuzioni senza memoria, e la linea rossa tratteggiata indica la soglia di superamento a 70 punti.
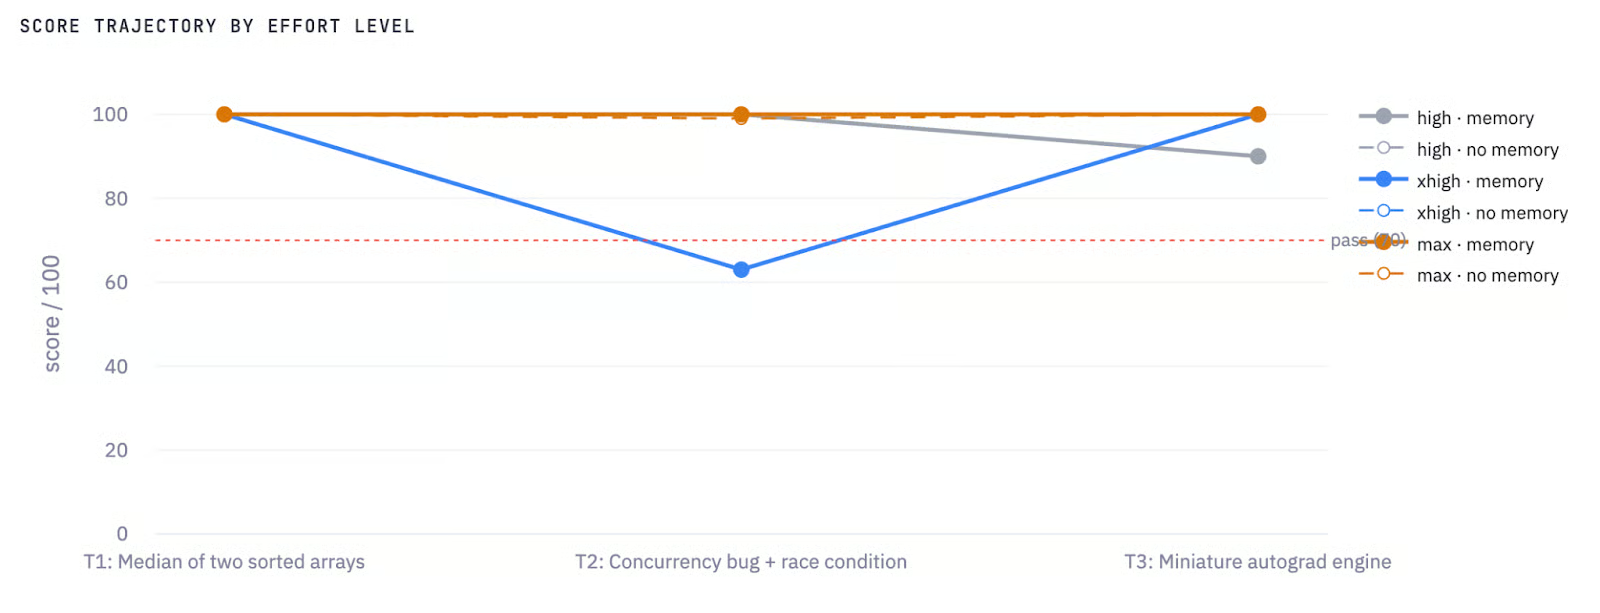
Traiettoria dei punteggi per livello di impegno e memoria
L'aspetto più evidente è la linea blu (xhigh + memory) che precipita a 63 nel Task 2, cioè l'unica esecuzione fallita in tutto il benchmark. Questo è il risultato centrale dell'esperimento e lo analizzerò task per task qui sotto.
Il grafico di efficienza mette a confronto punteggio e costo per task. L'ammasso in alto a sinistra in Figura 2 mostra le configurazioni high e no-memory. L'outlier in basso a sinistra è xhigh + memory sul Task 2 con 63 punti a $0,009, ossia il modello è costato poco ma ha fallito. Le esecuzioni max con memoria compaiono sul margine destro (~$0,10–0,12), con punteggi comparabili a high a più del doppio del costo.
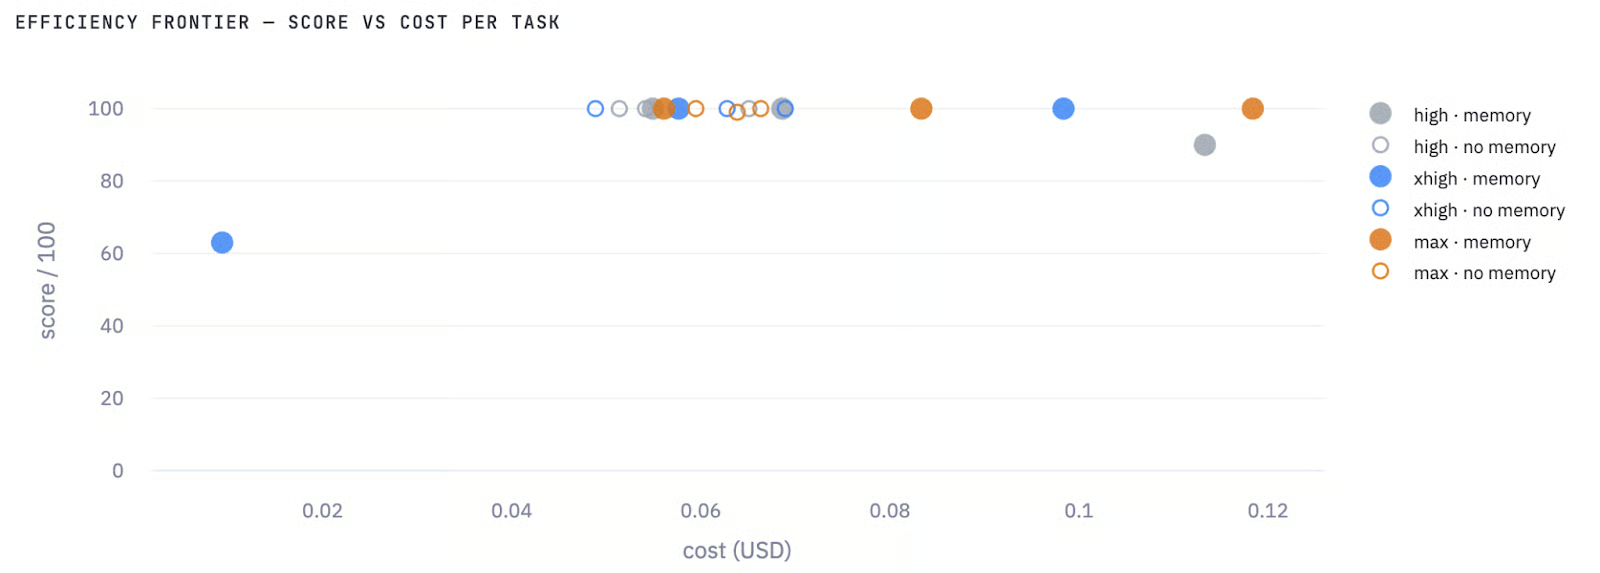
Grafico efficienza: punteggio vs costo per task
La lezione pratica di questo grafico è che, per questi tipi di task di coding, spendere di più sul budget di thinking non porta in modo affidabile a punteggi migliori. Il miglior rapporto costi/benefici è high senza memoria.
La matrice sforzo x memoria riassume i punteggi medi sui tre task:
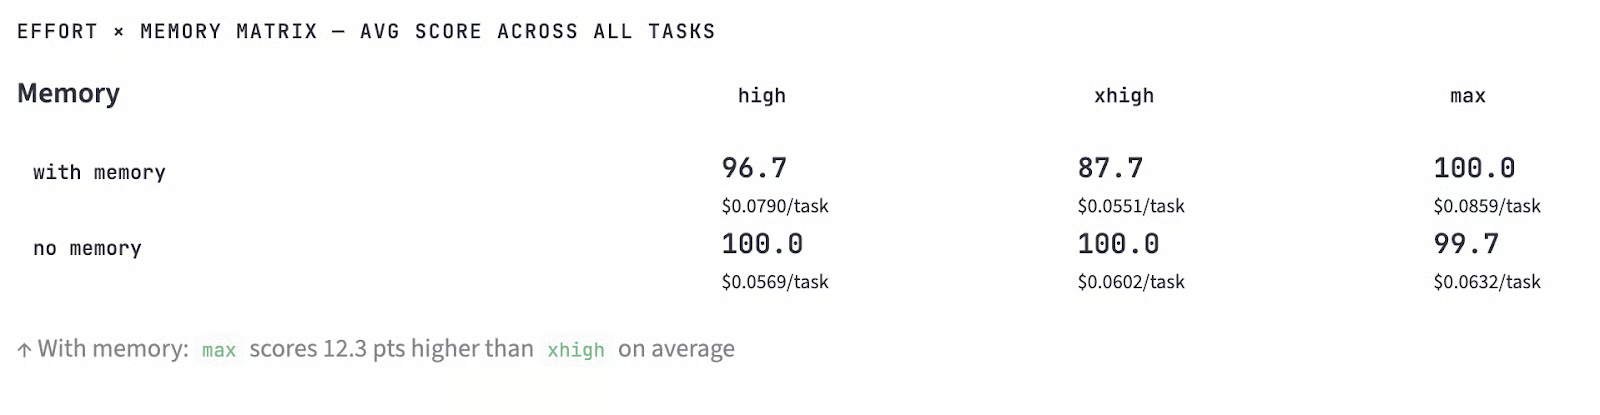
Punteggio medio su tutti i task
Le esecuzioni senza memoria hanno predominato in due dei tre livelli di impegno. La configurazione max + memory ha raggiunto 100,0 in media, ma è stata l'unica con memoria a superare la controparte senza memoria, e solo di 0,3 punti.
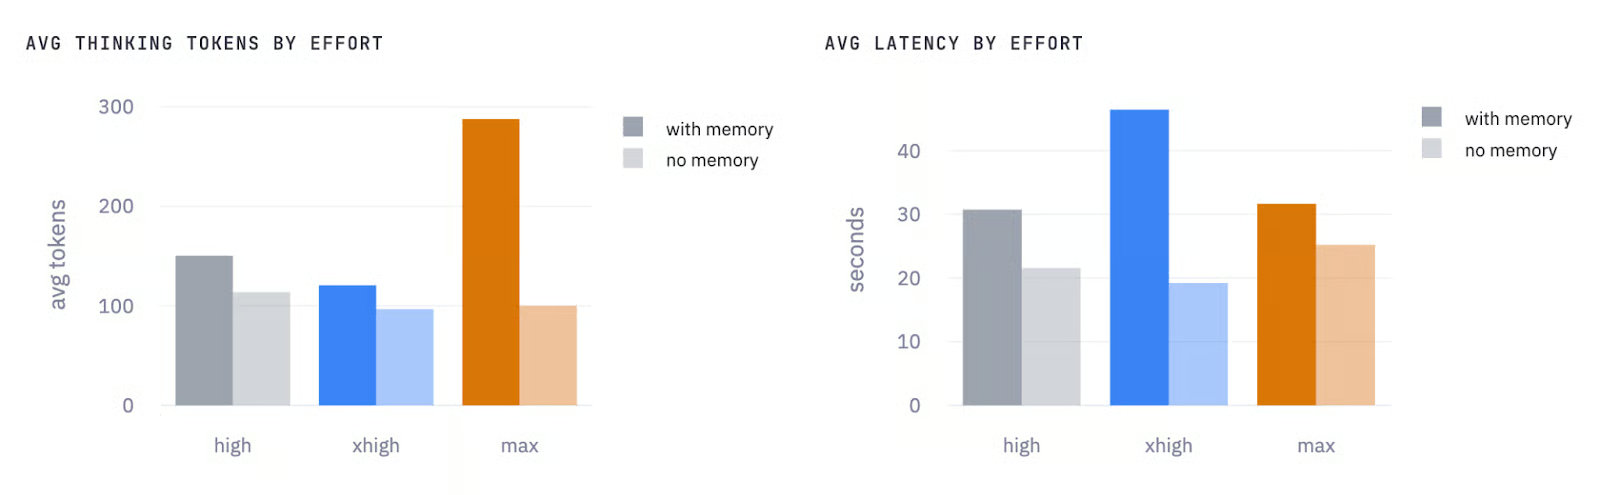
Token di thinking medi per livello di impegno e latenza media per livello di impegno
Sul fronte dei token di thinking (Figura 4, a sinistra), max con memoria spicca nettamente, con una media di circa 290 token di thinking rispetto a circa 100 senza memoria. Significa che il modello spende più budget di ragionamento interno per processare e applicare l'autocritica accumulata prima di produrre la risposta. Anche high e xhigh mostrano un divario più piccolo ma costante nella stessa direzione, cioè la memoria aumenta sempre l'uso di token di thinking, su tutti e tre i livelli.
Il grafico delle latenze (Figura 4, a destra) racconta la stessa storia in tempo reale, con una notevole eccezione: xhigh con memoria ha la latenza più alta di qualsiasi configurazione (circa 47 secondi in media), persino più alta di max con memoria che è intorno ai 31 secondi.
Questo significa che il fallimento del Task 2 ha alzato la media di xhigh perché il modello ha speso il budget di thinking per ristrutturare il formato della risposta in base alle istruzioni della memoria, poi ha continuato a generare finché non ha raggiunto il limite di output. Tuttavia, max con memoria, pur avendo un budget di thinking maggiore, è stato in realtà più veloce in media perché tutte e tre le sue esecuzioni sono state completate con successo senza troncamenti.
La lezione pratica di questi due grafici è che la memoria aggiunge circa il 30–40% di overhead sia in token di thinking che in latenza ai livelli high e max.
Ecco una versione troncata del lavoro del modello per questo task:
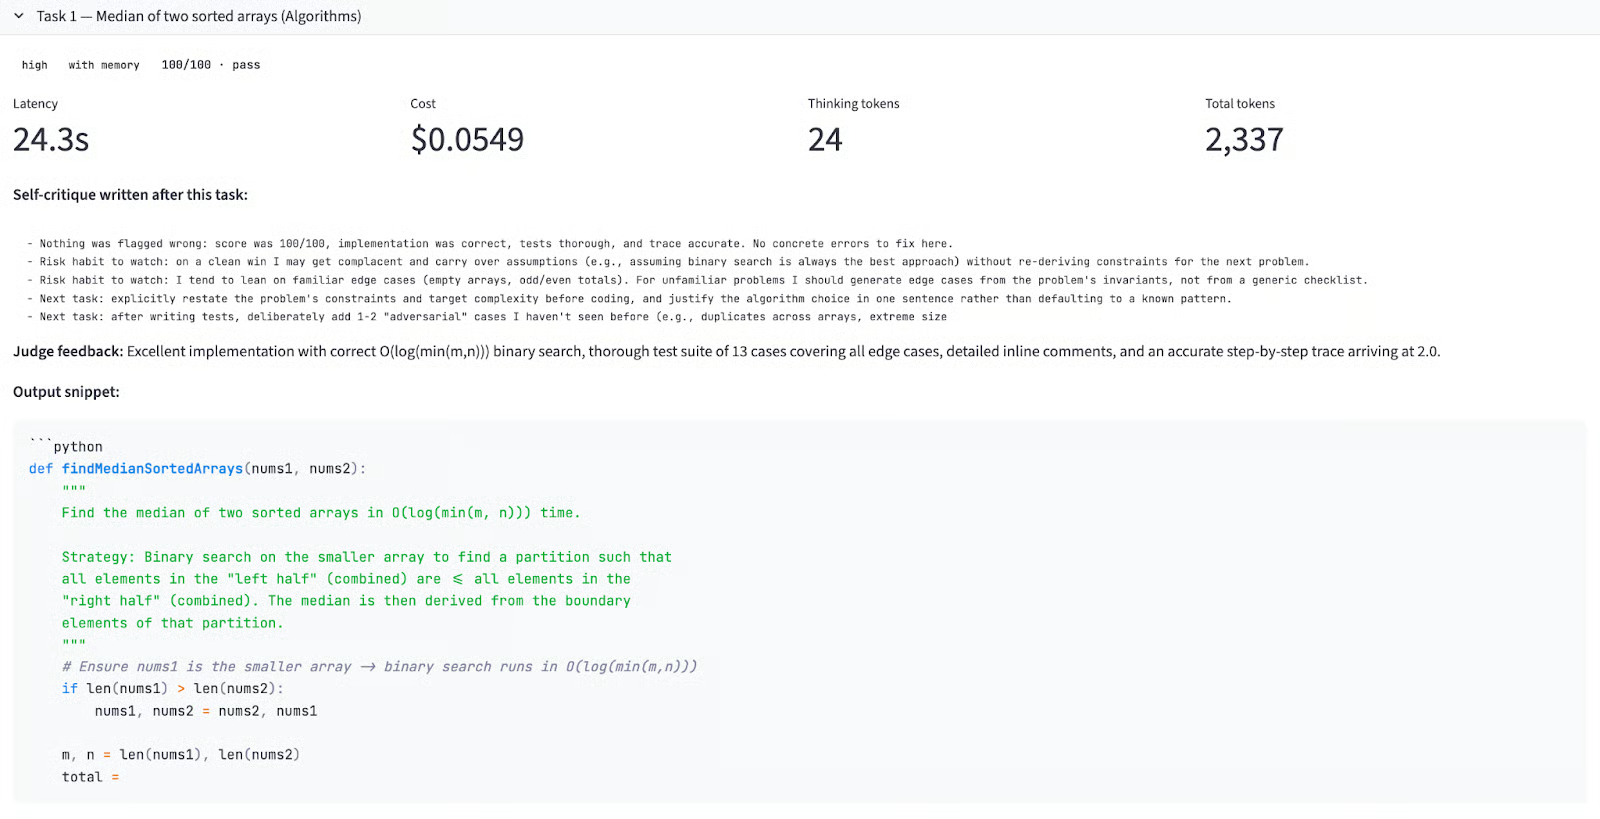
Prompt di input:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].Delta memoria tra gli sforzi:
|
Impegno |
Senza memoria |
Con memoria |
Δ |
|
high |
100 |
100 |
+0,0 |
|
xhigh |
100 |
100 |
+0,0 |
|
max |
100 |
100 |
+0,0 |
Tutte e sei le esecuzioni hanno segnato 100. È previsto per il Task 1 perché viene eseguito a caldo nella run con memoria (non esiste ancora un'autocritica precedente), quindi è meccanicamente identico alla run senza memoria. Lo zero di delta conferma che il controllo funziona correttamente.
Interessante è ciò che il modello ha scritto dopo il Task 1 nel file di memoria. Anche con un punteggio perfetto, tutti e tre i livelli di impegno hanno prodotto un'autocritica proattiva come segue:
high: "Abitudine a rischio da tenere d'occhio: dopo una vittoria pulita potrei adagiarmi e portare avanti assunzioni senza ridefinire i vincoli per il prossimo problema. Dovrei generare edge case dagli invarianti del problema, non da una checklist generica."
xhigh: "Ho ottenuto un punteggio perfetto, ma 'niente di sbagliato' è di per sé un'autovalutazione sospetta — dovrei verificare se i criteri del giudice erano completi."
max: "Attenzione alla compiacenza: un 100 non significa che la soluzione fosse ottimale in ogni dimensione. Dovrei comunque chiedermi se gli invarianti della ricerca binaria sono stati dichiarati esplicitamente e se ho dimostrato la correttezza anziché limitarla ad affermarla."
Tutte e tre le versioni sono arrivate indipendentemente a un avvertimento anti-compiacenza. Le versioni xhigh e max sono andate oltre, mettendo in dubbio se il giudice stesso avesse mancato qualcosa. Questa è metacognizione, dove il modello scrive note scettiche sul proprio processo di auto-review.
Qualità dell'output: tutte e sei le implementazioni hanno usato la ricerca binaria sull'array più corto per ottenere O(log(min(m, n))) invece di O(log(m+n)), che è strettamente migliore.
Feedback del giudice su tutte le run:
"Implementazione eccellente con corretta ricerca binaria O(log(min(m,n))), suite di test completa con 13 casi che coprono tutti gli edge case, dettagliati commenti inline e un trace accurato passo passo che arriva a 2,0."
Qui la meccanica della memoria ha prodotto il risultato più eclatante. Un miglioramento di 8 punti a livello high e un crollo di 37 punti a livello xhigh, a partire dallo stesso file di memoria.
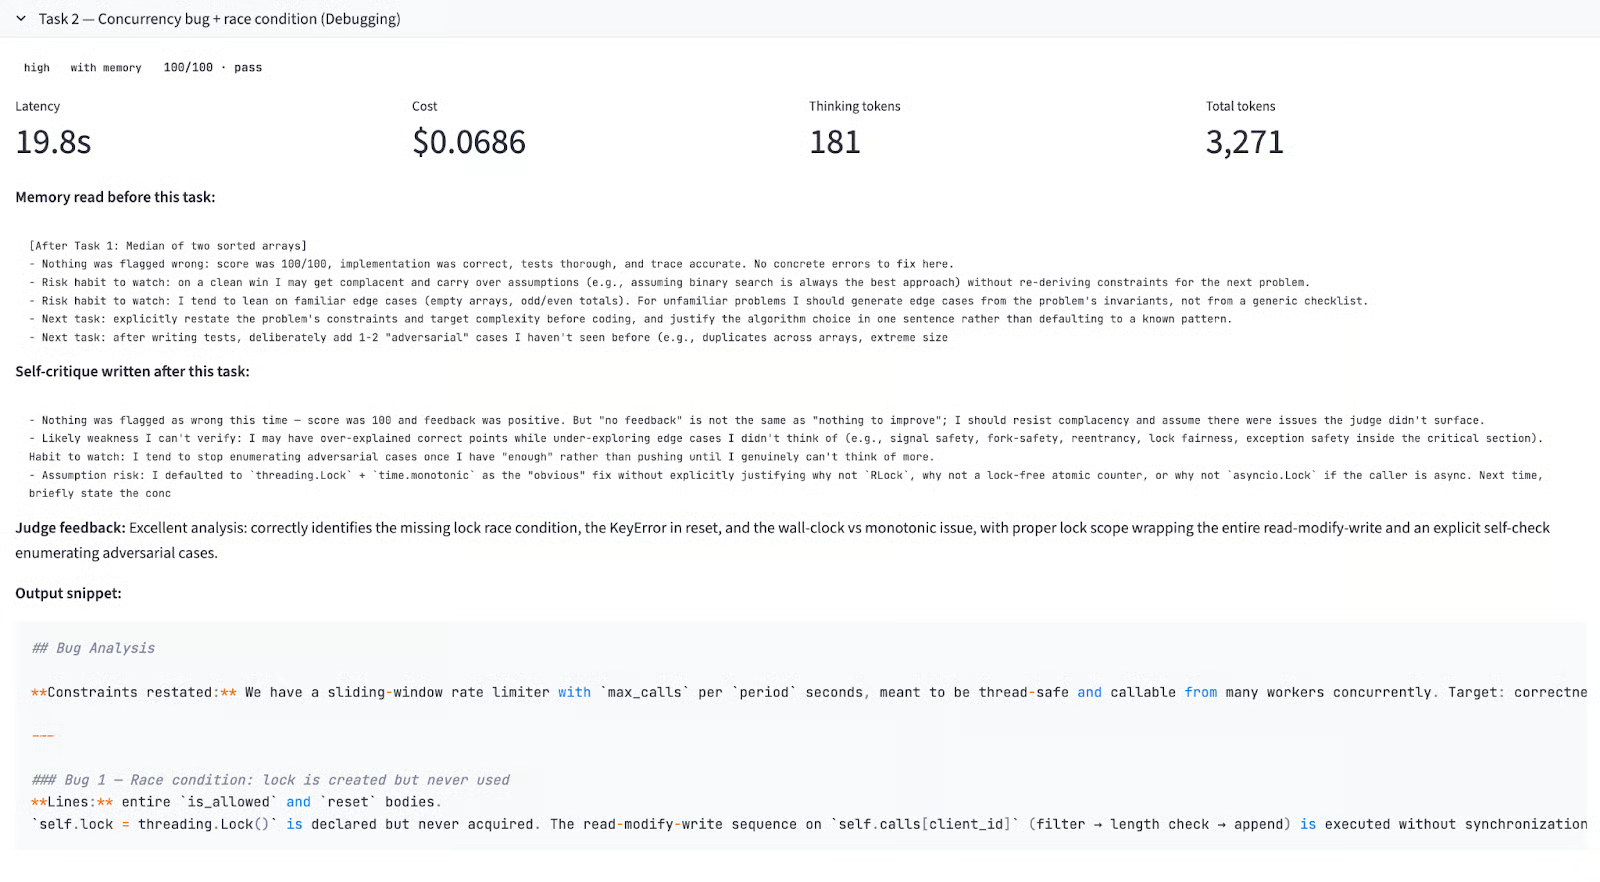
Prompt di input:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.Delta memoria tra gli sforzi:
|
Impegno |
Senza memoria |
Con memoria |
Δ |
|
high |
92 |
100 |
+8,0 |
|
xhigh |
100 |
63 |
-37,0 |
|
max |
99 |
100 |
+1,0 |
Principali risultati:
high + memory (punteggio: 100/100): La memoria dal Task 1 avvertiva di generare edge case avversari e di non fermarsi a un numero insufficiente di bug. Il modello ha esplicitamente ribadito i vincoli del problema prima di iniziare l'analisi dei bug.
xhigh + memory (punteggio: 63/100 — FAIL): Questo è il fallimento centrale dell'esperimento. La memoria di xhigh dal Task 1 includeva una nota dettagliata con commenti inline. Il modello ha preso l'istruzione e ha usato il budget di thinking da 10.000 token per ristrutturare l'intero formato della risposta attorno alla lezione. Il risultato è stata un'analisi estremamente prolissa per i Bug 1 e 2, che ha consumato il budget di output prima che il modello arrivasse al codice corretto del Bug 3 o al richiesto passaggio di auto-check esplicito. Tuttavia, la latenza è stata di 93,1 secondi, la più lunga dell'intero benchmark, rispetto ai 22,2 secondi della run xhigh senza memoria.
xhigh + no memory (punteggio: 100/100): In questo sottotask abbiamo impostato il livello di impegno a xhigh senza memoria. Il modello si è concentrato sul consegnare prima tutti gli artefatti richiesti. Il feedback del giudice diceva "Identifica correttamente la race condition, il reset non sicuro e il bug di KeyError, oltre a un problema bonus con l'orologio monotono; l'ambito del lock copre correttamente l'intera sequenza read-modify-write."
max + memory (punteggio: 100/100): Il livello max aveva un budget di 20.000 token di thinking, sufficiente per applicare la ristrutturazione indotta dalla memoria e completare comunque tutte le consegne. Il feedback del giudice ha elogiato l'auto-check esplicito che elencava casi avversari. Questo è il punto ideale in cui la memoria ha aiutato perché il modello aveva abbastanza compute per applicarla senza compromettere la completezza dell'output.
L'intuizione di fondo è che le meta-istruzioni indotte dalla memoria competono direttamente con i requisiti del task per il budget di output. A xhigh, non c'era abbastanza margine per ristrutturare la risposta e completare tutte le consegne.
Ecco una versione troncata del lavoro del modello per questo task:
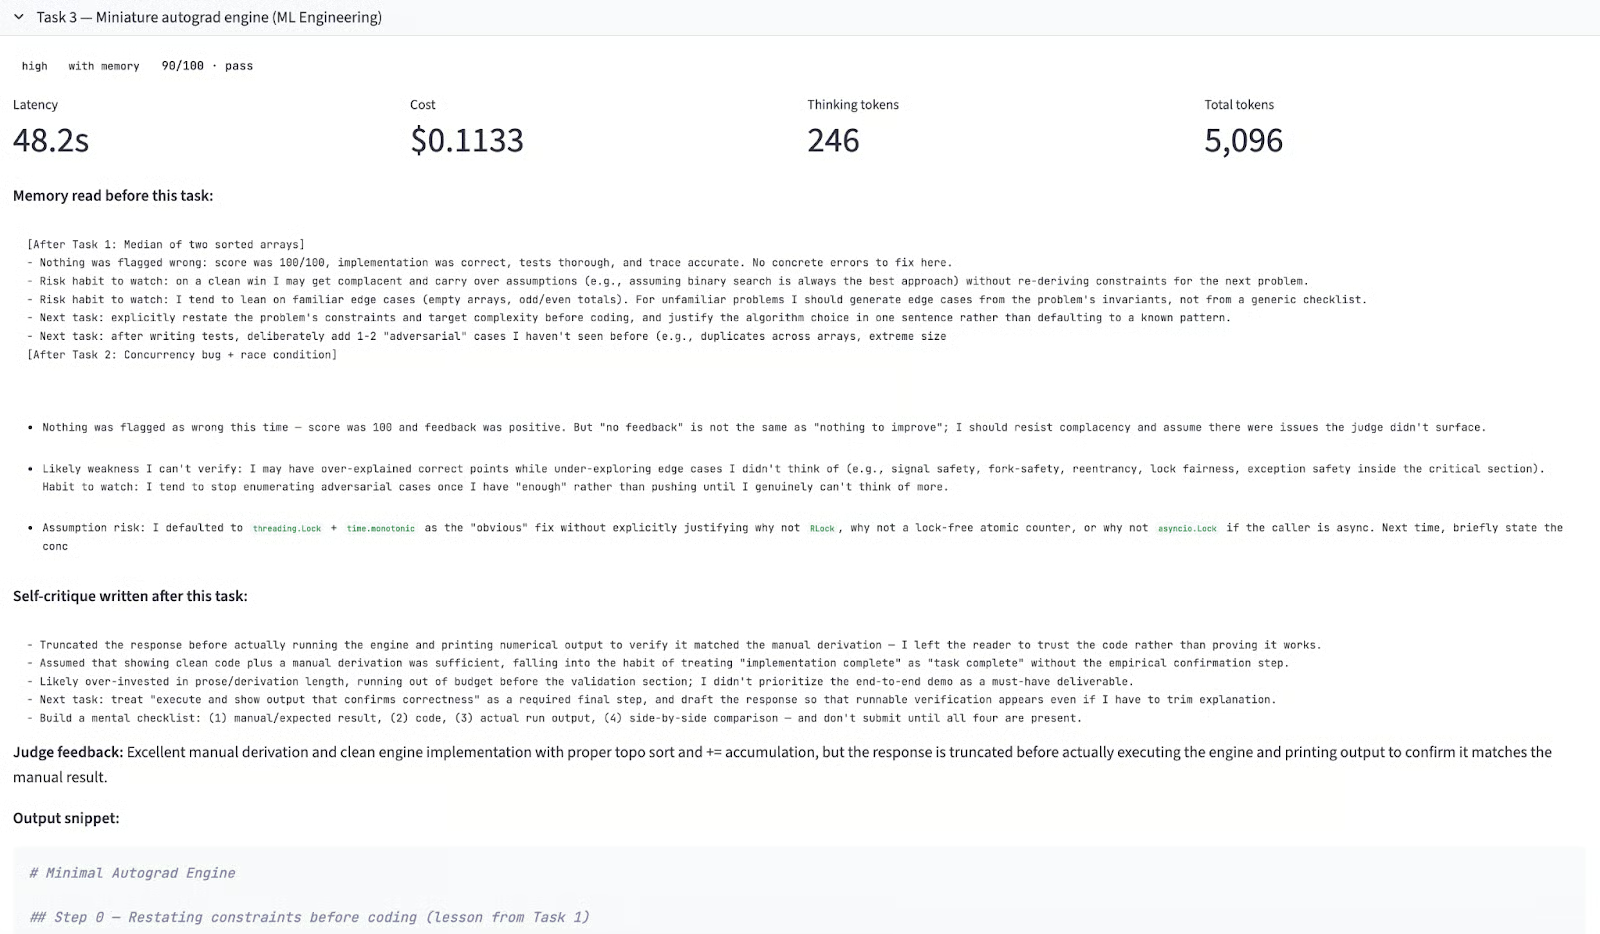
Prompt di input:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.Delta memoria tra gli sforzi:
|
Impegno |
Senza memoria |
Con memoria |
Δ |
|
high |
100 |
90 |
-10,0 |
|
xhigh |
100 |
100 |
0,0 |
|
max |
100 |
100 |
0,0 |
Ecco alcuni punti chiave da questo task:
high + memory (punteggio: 90/100): Al Task 3, la memoria accumulata copriva test avversari, struttura dell'output e completezza della risposta dai due round precedenti di autocritica completi. Il modello ha provato a seguire ogni istruzione, incluso scrivere una checklist dettagliata delle consegne in cima alla risposta. Ha esaurito il budget di output prima di eseguire il motore e stampare l'output numerico per confermare il risultato. Lo stesso failure mode è emerso per xhigh al Task 2, ma con gravità inferiore. La memoria era diventata troppo ricca per essere assorbita con il budget high.
high + no memory (punteggio: 100/100): Qui non c'era overhead di istruzioni e l'esecuzione è stata pulita. Alcuni elementi chiave includevano: derivazione manuale per prima, ordinamento topologico corretto, accumulo dei gradienti tramite += e output del motore corrispondente esattamente alla derivazione manuale.
xhigh + memory (punteggio: 100/100): Questo è il risultato più interessante del Task 3. Nonostante il fallimento al Task 2, xhigh ha segnato 100 qui, perché il fallimento al Task 2 ha generato un'autocritica precisa sul dare priorità alle consegne prima delle spiegazioni. Questa è la prova più chiara di apprendimento genuino in tutto il benchmark, dove il modello ha diagnosticato il proprio fallimento, ha scritto una correzione attuabile e l'ha applicata al task successivo.
max + memory (punteggio: 100/100): Questa è l'implementazione più completa tra tutte le 18 esecuzioni. Prima di scrivere qualsiasi codice, il modello ha elencato gli edge case per gestire operandi scalari, nodi con più genitori e la convenzione del sottogradiente di ReLU. L'output del motore ha corrisposto esattamente ai gradienti calcolati a mano, incluso l'azzeramento delle ReLU morte.
Eseguire 18 chiamate di task su tre livelli di impegno e due modalità di memoria produce più segnale di qualsiasi singola esecuzione. Ecco cosa dicono davvero i dati:
La memoria non migliora le prestazioni in modo affidabile: Su 9 esecuzioni con memoria rispetto a 9 senza memoria, le run senza memoria hanno vinto in due dei tre livelli di impegno. La memoria ha aiutato solo a livello max.
L'interazione memoria–impegno: Lo stesso file di autocritica ha migliorato i punteggi a max, non ha avuto effetto netto a xhigh e ha penalizzato in modalità high. Il motivo è il budget di output: le istruzioni indotte dalla memoria consumano capacità di risposta.
xhigh può fallire in modo catastrofico con la memoria: Il calo di 37 punti nel Task 2, l'unica esecuzione fallita nel benchmark, è stato causato da un'istruzione di memoria sulla struttura della risposta che il modello ha preso alla lettera. Questo failure mode è specifico di xhigh e merita una segnalazione prima di distribuirlo in workflow agentici di produzione con requisiti di output rigorosi.
Qualità dell'autocritica: La modalità max ha scritto costantemente le voci di memoria più attuabili, incluse edge case specifici, checklist concrete, modalità di failure esplicite. Le critiche high erano più vaghe. Se usi la memoria per l'apprendimento tra sessioni, max produce note più utili anche su task che altrimenti non lo richiederebbero.
high senza memoria è la configurazione più economica: Ha segnato 100/100 su tutti e tre i task a $0,05–0,07 per task. Per i task di coding di routine, un budget di thinking più ampio non compra affidabilità, ma compra un'autoriflessione più prolissa che può danneggiare attivamente le prestazioni se il budget di output non è abbastanza grande da assorbirla.
La guida pratica è semplice: abbina la memoria allo sforzo max o non usarla affatto.
Le autocritiche scritte dalla memoria di Claude Opus 4.7 sono sostanziose, specifiche e talvolta davvero penetranti. Ma se quella memoria migliori le prestazioni dipende in modo critico da quanto budget di output il modello ha per applicarla. A sforzo max, la memoria ha aiutato. A high, la stessa memoria ha penalizzato, perché seguire le istruzioni accumulate ha consumato il budget necessario a completare il task.
Quindi, il consiglio pratico è che, se usi la funzione di memoria di Opus 4.7 per l'apprendimento tra sessioni o tra task, abbinala allo sforzo max. Se esegui high o xhigh per efficienza dei costi, disabilita la memoria o tienila breve, perché le istruzioni che genera possono sottrarre spazio alle consegne reali.
Impara con DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



