

课程
Claude 模型入门
3 小时
15K
实践并学习路径你的进步。
使用 Google 继续Anthropic 的Claude Opus 4.7 引入了新的 xhigh 努力等级,位于 high 与 max 之间,并特别强调改进的文件系统记忆作为一项关键能力,即模型可以为自己做笔记并在不同会话间使用它们。
这让我产生了一个显而易见的问题:这种记忆在可量化的层面上是否真的有效?此外,Opus 4.7 会否从自身错误中学习,并在下一次任务中产出更好的代码?
因此,我构建了一个 Streamlit 基准测试工具,顺序运行三个高难度编码任务。每个任务结束后,模型会将自我反思写入一个记忆文件(memory.md)。下一个任务在开始前会读取该文件。我在三种努力等级(high、xhigh 和 max)下,分别启用与禁用记忆进行运行,共计 18 次任务运行,模型为 Claude Opus 4.7,托管于 Microsoft Foundry。
在本教程结束时,您将能够:
完整代码已发布于 GitHub 仓库。
Claude Opus 4.7 是 Claude 4 系列中能力最强的大语言模型,高于 Sonnet 与 Haiku。它面向长时运行的代理式任务、高级软件工程和企业工作流,需要在长会话中保持稳定表现。
与本教程最相关的三项能力是:
xhigh 努力等级:介于 high(5,000 思考 token)与 max(20,000 思考 token)之间,为 10,000 思考 token。用于在难题上更精细地平衡成本与质量。注意:定价为每百万输入 token 5 美元、每百万输出 token 25 美元,与 Opus 4.6 相同。若想深入探索该模型,DataCamp 团队这篇文章值得一读。
在测试前,有几个值得了解的数字:
|
基准 |
分数 |
|
SWE-bench Verified |
87.6% |
|
SWE-bench Pro |
64.2% |
|
GPQA Diamond |
94.2% |
|
OSWorld Verified(计算机使用) |
78.0% |
|
Finance Agent v1.1 |
64.4% |
本教程中的所有 API 调用均通过 Microsoft Foundry 进行。因此,我们需要一个 Azure 订阅并开通按量付费结算,因为免费学生层没有第三方合作模型(如 Claude)的配额。一个不错的替代方案是使用 Anthropic 的 API 密钥。两种方式我都已在该仓库中覆盖。
首先需要在 Microsoft Foundry 的模型目录中找到该模型。为此,
claude-opus-4-7。这将打开一个模型卡片,展示关键能力、基准测试和模型 ID。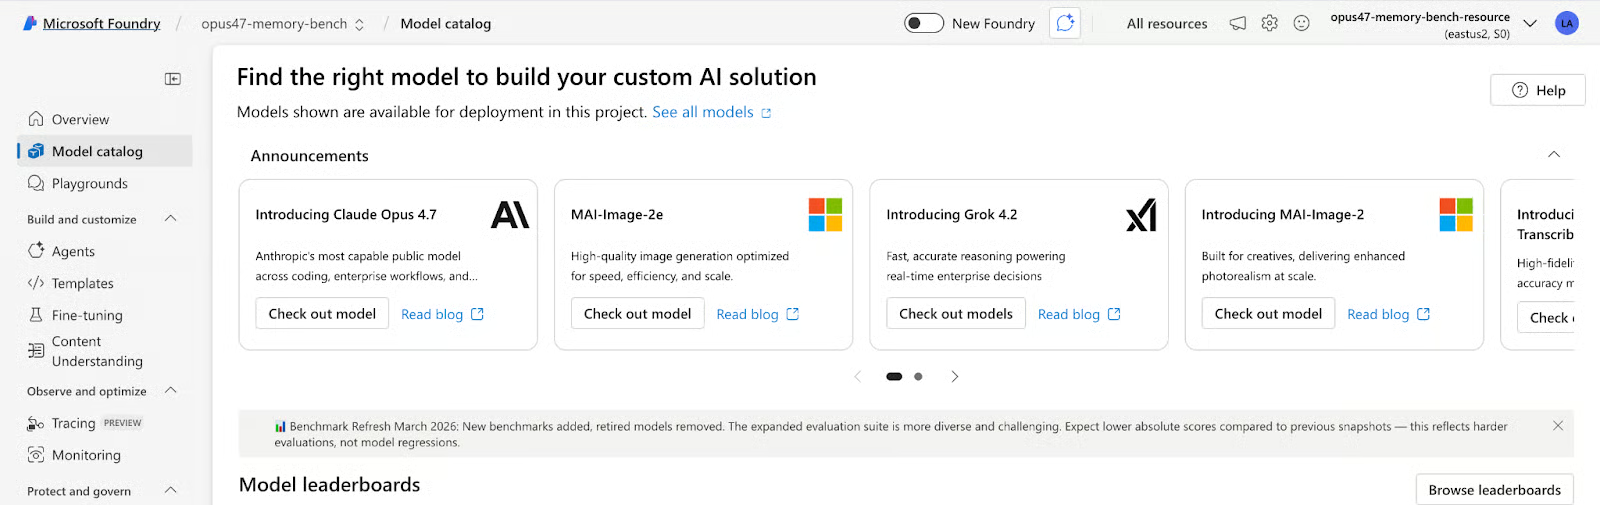
opus47-memory-bench。然后通过 Azure 市场接受使用条款并同意 Anthropic 的使用政策。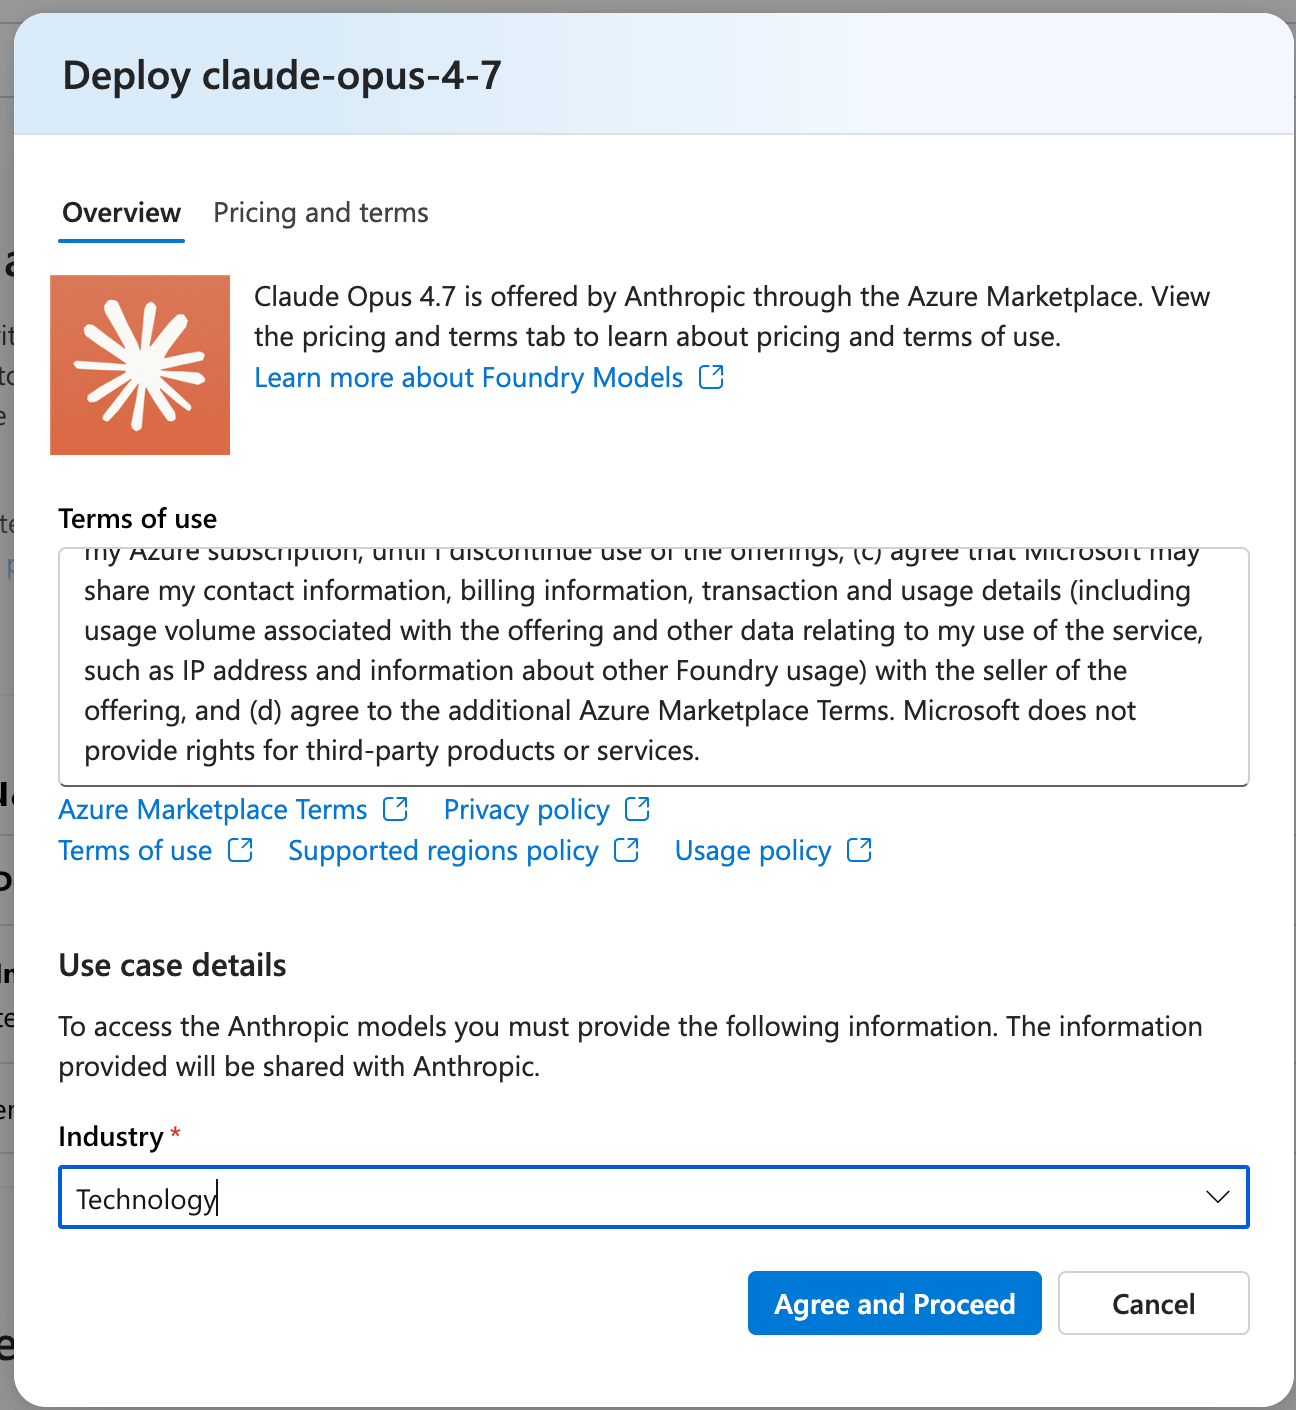
创建项目后,您会进入部署对话框。然后填写以下信息:
部署名称:claude-opus-4-7(保持默认,因为代码使用该字符串)
部署类型:Global Standard(无服务器,无需容量管理)
模型版本升级策略:建议固定到版本 1 而非自动更新,以免新模型版本导致现有运行出错
点击 Create resource and deploy。
部署完成后,在 Foundry 门户中打开您的项目。在 Overview 选项卡下,您会看到以下信息:
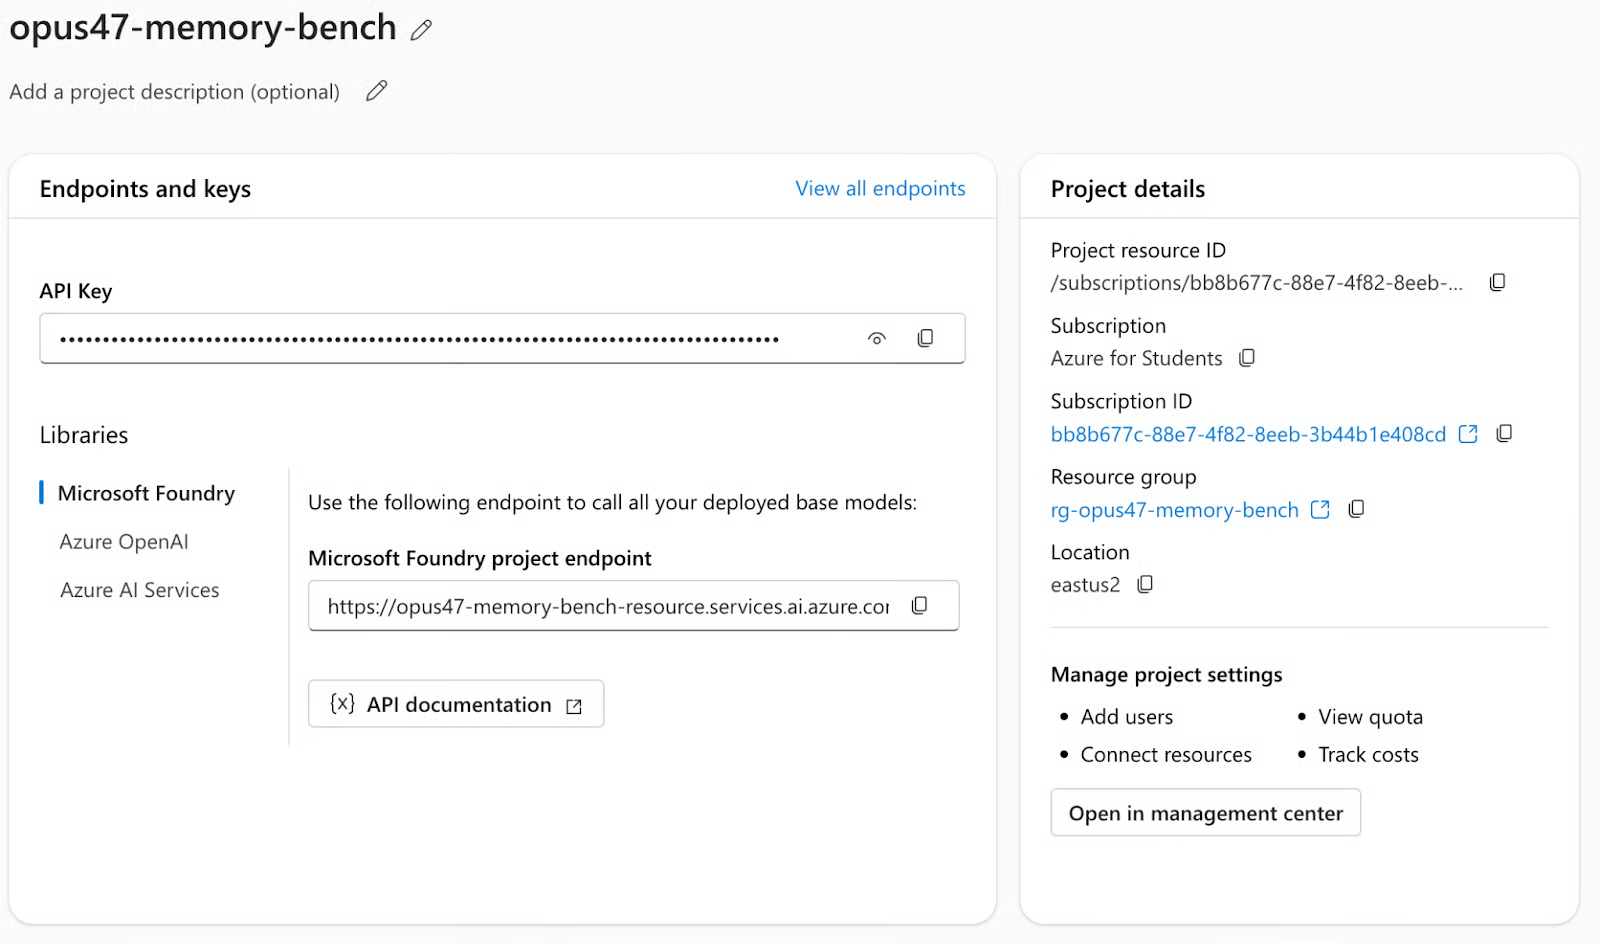
API key:复制该 API 密钥以备后用。我们将把该 API 密钥设置为 ANTHROPIC_FOUNDRY_API_KEY。
Microsoft Foundry 项目端点:从项目端点中复制资源名称,格式为 https://your-resource.services.ai.azure.com,其中资源名称是子域前缀(即 .services.ai.azure.com 之前的全部内容)。我们将其设置为 ANTHROPIC_FOUNDRY_RESOURCE
现在我们已具备所需的一切资源。接下来将上述键设置为环境变量,并运行 streamlit 应用。
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
当您传入基于资源的基础 URL 时,Anthropic SDK 会自动处理 Foundry 端点:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
其余部分(包括模型调用、思考参数与响应解析)均使用标准的 Anthropic SDK。无需 OpenAI 兼容层。
该 streamlit 测试工具按顺序运行三个任务,每个努力等级执行两次:一次启用记忆,一次不启用(对照)。 每个任务有四项明确的评判标准,每项 25 分,由第二次 Opus 4.7 调用充当 LLM 评审进行打分。每个任务及其子任务的通过阈值为 70/100。
该任务为经典的 LeetCode 困难题。提示要求 O(log(m+n)) 的二分查找实现,若采用线性扫描,则在复杂度标准上得分为零。同时要求至少 10 个用例的测试套件,并在代码中内联注释解释二分逻辑的每一步。写完代码后,模型必须手动逐步推演 nums1=[1,3]、nums2=[2] 示例。
该任务包含一个存在至少三个缺陷的 Python RateLimiter 类,其中一个是隐蔽的竞态条件。is_allowed() 方法在未持有锁的情况下读取并修改共享状态,造成典型的 TOCTOU(检查-使用时序)漏洞。提示要求指出每个缺陷的确切行号,解释失败模式,提供修复,并在重读修正后的代码后进行明确的自检。
在任务 3 中,我们将尝试用纯 Python 实现一个标量自动求导引擎,不使用 NumPy 与 PyTorch,支持 +、*、-、/、** 运算,以及在零点具有正确次梯度的 ReLU。该引擎必须在反向传播中使用拓扑排序,并对被多次使用的节点进行梯度累加(+=)。关键之处在于,提示要求先展示手动的链式法则推导,再给出代码。这测试模型能否先规划再校验其推理。
记忆机制是本基准测试区别于标准 LLM 评测的关键。不将每个任务视为独立调用,而是为模型提供结构化的机会,反思其失误并通过记忆组件将反思带入后续任务。
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
这会在单个会话内形成一条学习曲线。到任务 3 时,模型已积累两轮自我反思及其为自身失败模式撰写的改进指令。它是否能有效利用这些指令,将在结果部分展开。
Opus 4.7 引入了位于 high 与 max 之间的新努力等级 xhigh。思考预算用于控制模型在生成响应前可用于内部推理的 token 数。更高预算允许更深层规划,但会增加时延与成本。
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
这些参数会直接传给 Anthropic SDK:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
模型会基于感知到的任务难度进行自我调节。实际中很少会消耗满预算,因此本基准测试中的 max 运行平均每个任务约 300 个思考 token,远低于 20,000 的上限。
本基准共进行了 18 次任务调用(3 个努力等级 x 2 种模式 x 3 个任务)以及 18 次评审调用进行打分。本实验的总成本约为 5 美元。
我绘制了六种条件(3 个努力等级 x 记忆开/关)下,模型在三个任务上的表现曲线。下图中的橙色线为启用记忆的运行,灰色/虚线为未启用记忆的运行,红色虚线为 70 分的通过阈值。
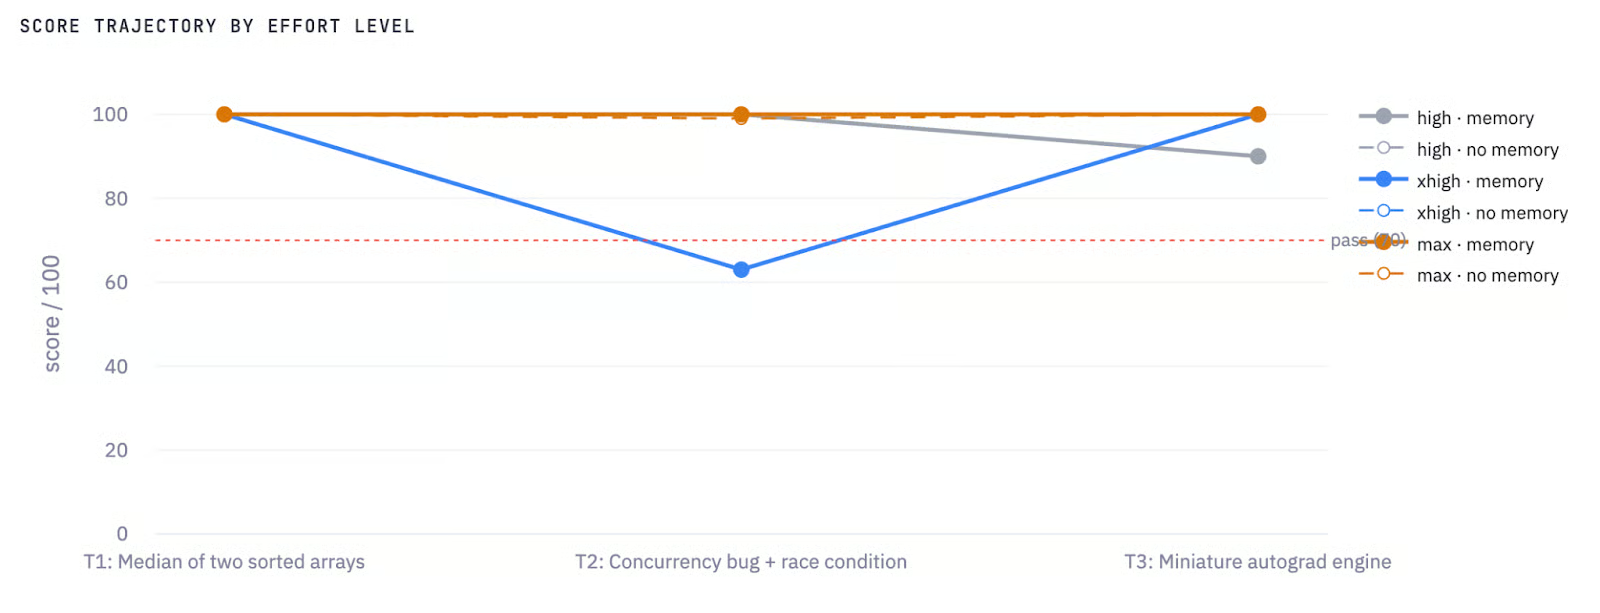
按努力等级与记忆的得分轨迹
最引人注目的是蓝色线(xhigh + memory)在任务 2 中跌至 63 分,即整个基准中唯一的失败运行。这是实验的核心发现,我会在下文按任务逐一拆解。
效率图将得分与每个任务的成本对照绘制。图 2 左上方的簇展示了 high 与 no-memory 配置。左下角的离群点是任务 2 上的 xhigh + memory:63 分、成本 0.009 美元,意味着模型运行很省钱但失败了。max 的记忆运行出现在右侧边缘(约 0.10–0.12 美元),以超过两倍的成本提供与 high 相当的得分。
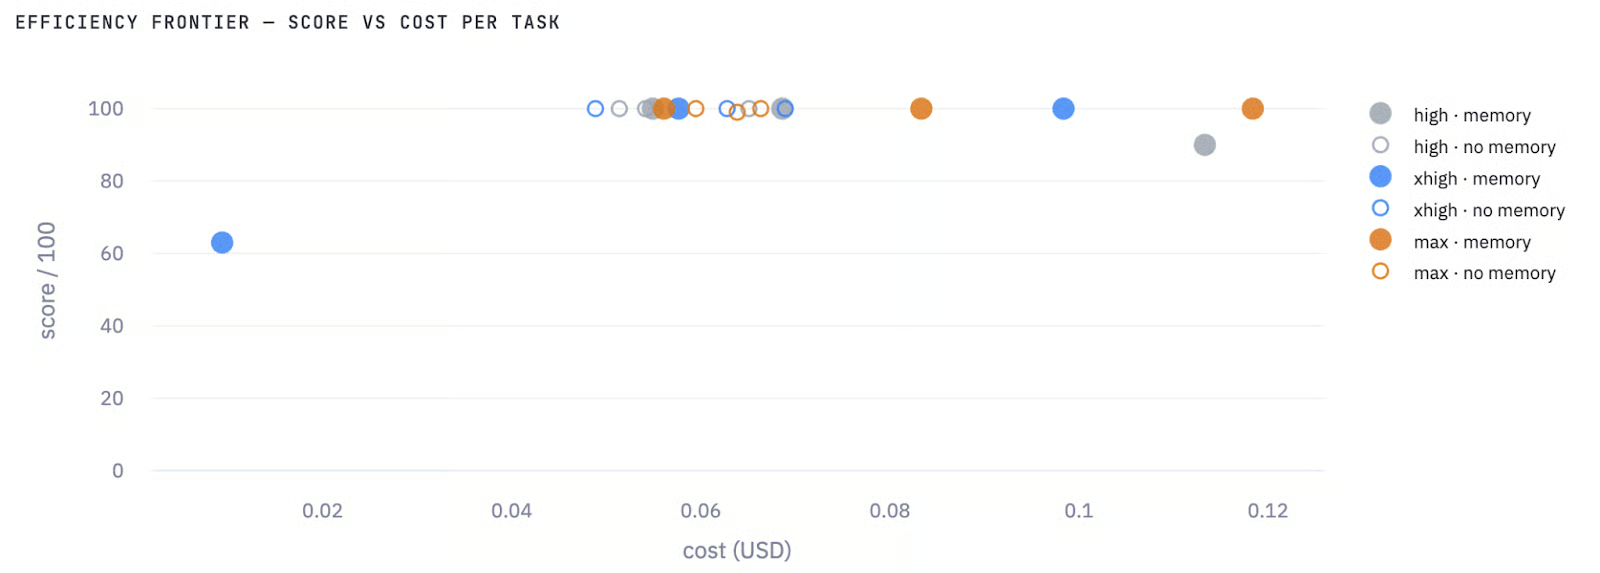
效率图:每个任务的得分与成本
该图的实际结论是,对于这类编码任务,增加思考预算的投入并不能可靠地带来更高分。性价比最佳的是不启用记忆的 high。
努力 x 记忆矩阵汇总了三个任务的平均分:
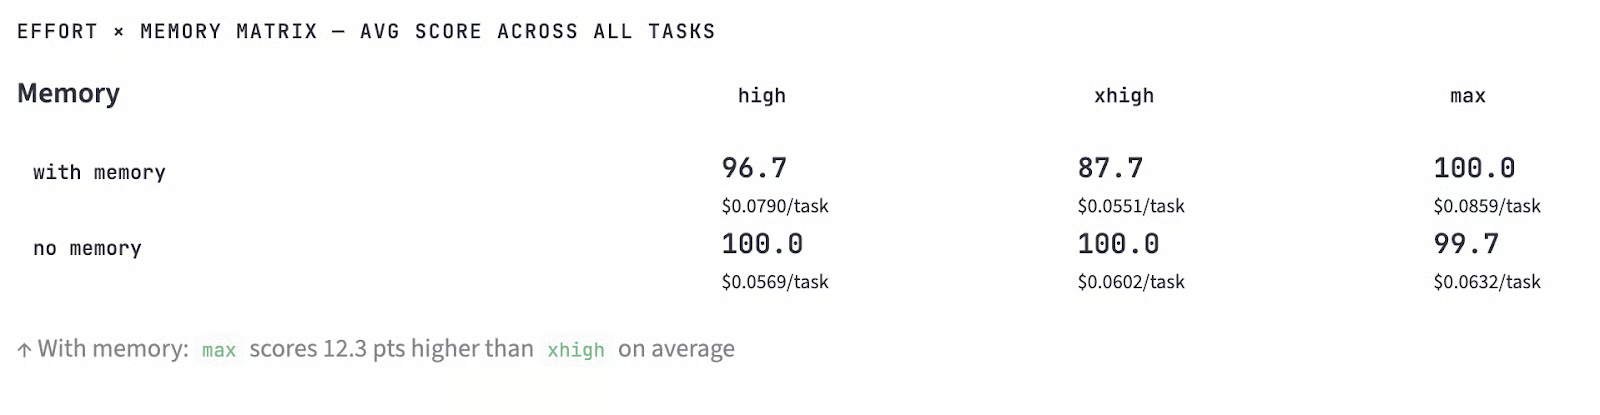
所有任务的平均分
在三种努力等级中的两种上,不启用记忆的运行占优。max + memory 配置达到了 100.0 的平均分,但它是唯一一个超越无记忆对应项的记忆配置,而且仅高出 0.3 分。
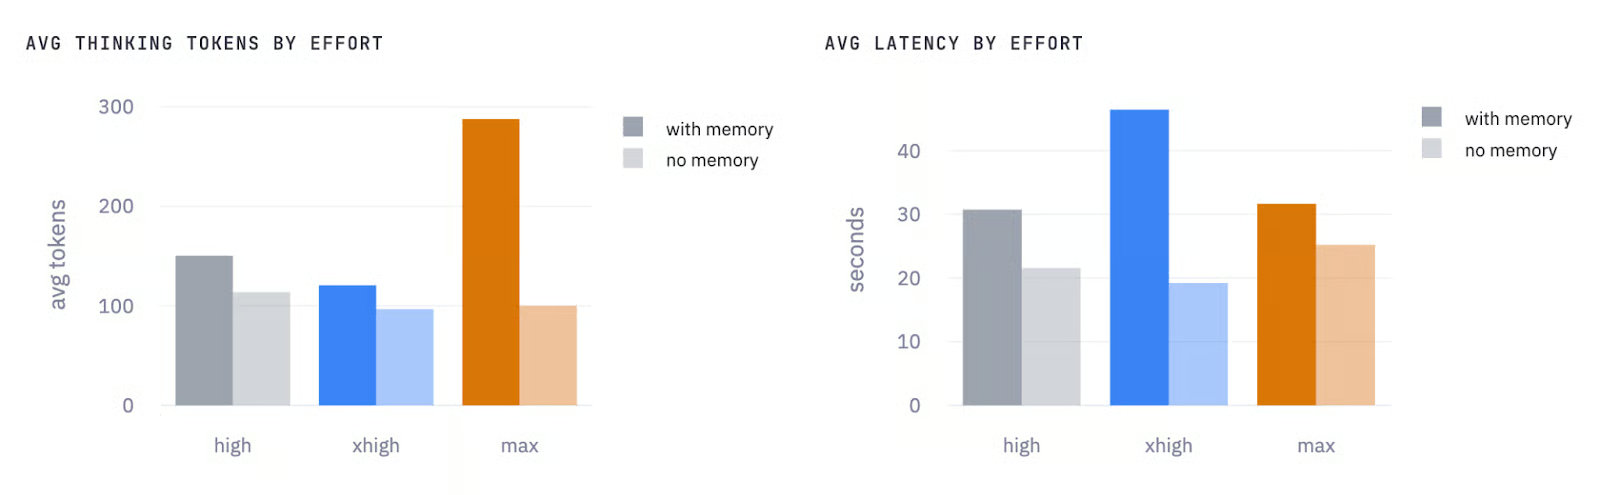
按努力的平均思考 token 与平均时延
在思考 token 方面(图 4 左),max 努力配合记忆表现突出,平均约 290 个思考 token,而未启用记忆约为 100 左右。这意味着模型在生成响应前会花更多内部推理预算来处理并应用累积的自我反思。与此同时,high 与 xhigh 也呈现较小但一致的差距,即在三个努力等级中,记忆都会提高思考 token 的使用量。
时延图(图 4 右)在墙钟时间上讲述了同样的故事,但有一个显著例外:xhigh 努力配合记忆的时延在所有配置中最高(平均约 47 秒),甚至高于配合记忆的 max 努力(约 31 秒)。
这意味着任务 2 的失败拉高了 xhigh 的平均值,因为模型将思考预算用于基于记忆指令重构其响应格式,随后持续生成直至触及输出上限。然而,尽管 max 配合记忆拥有更大的思考预算,其平均速度实际上更快,因为其三次运行均顺利完成且未被截断。
这两张图的实际结论是,在 high 与 max 努力下,记忆会在思考 token 与时延上带来约 30–40% 的开销。
以下是模型在该任务中的部分工作过程(截取):
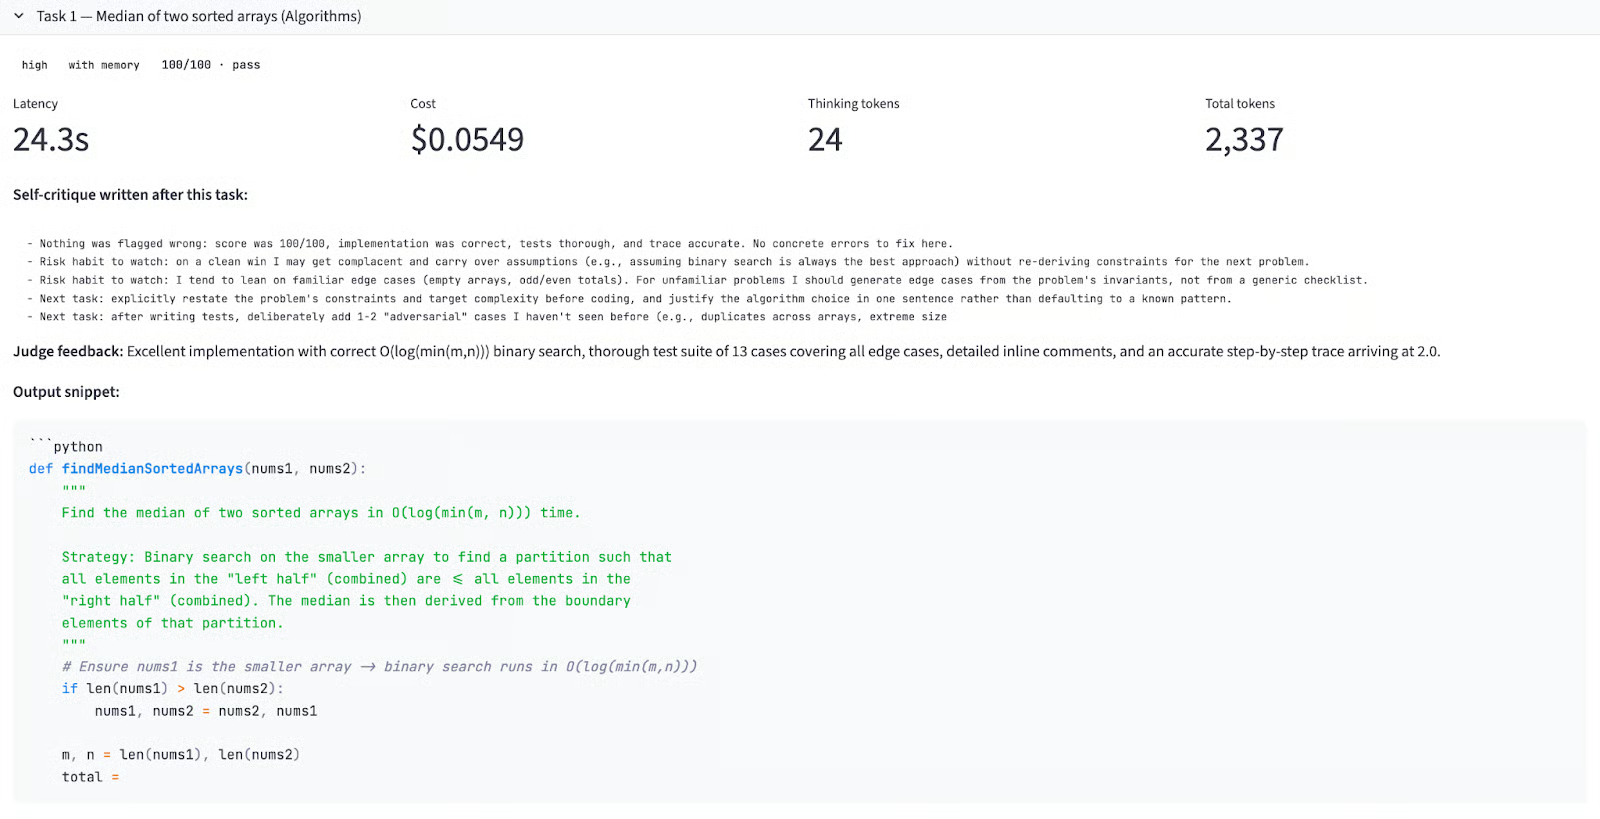
输入提示:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].不同努力等级的记忆增量:
|
努力 |
无记忆 |
有记忆 |
Δ |
|
high |
100 |
100 |
+0.0 |
|
xhigh |
100 |
100 |
+0.0 |
|
max |
100 |
100 |
+0.0 |
六次运行均得 100 分。这对任务 1 来说是预期结果,因为在记忆运行中这是冷启动(尚无前序反思),因此在机制上与无记忆运行完全相同。零差值也验证了对照设置的正确性。
更有意思的是模型在任务 1 后写入记忆文件的内容。即便拿到满分,三种努力等级都给出了前瞻性的自我反思,如下:
high: "需要警惕的习惯:在一次顺利完成后,我可能会自满,并在下一题中沿用未重新推导的假设。我应从问题不变式出发生成边界用例,而非使用通用清单。"
xhigh: "拿到满分,但‘没有问题’本身就是一个值得怀疑的自我评估——我应审视评审标准是否已足够全面。"
max:"警惕自满:100 分并不意味着方案在各个维度都最优。我仍应自问是否明确陈述了二分查找不变式,以及是否给出了正确性证明而非仅仅声称其正确。"
三个版本都独立给出了反自满的警告。xhigh 与 max 版本更进一步,质疑评审本身是否有所遗漏。这是一种元认知,即模型对其自我审查过程写下了带有怀疑态度的笔记。
输出质量: 六个实现均在较短数组上进行二分查找,实现 O(log(min(m, n))),严格优于 O(log(m+n))。
所有运行的评审反馈:
"实现出色,使用正确的 O(log(min(m,n))) 二分查找;包含覆盖全面边界情况的 13 个用例测试套件;内联注释详尽;手动推演逐步准确得到 2.0。"
这是记忆机制产生最戏剧化结果的地方:在 high 努力下提升 37 分,而在 xhigh 努力下下降 37 分,且两者使用的是同一份记忆文件。
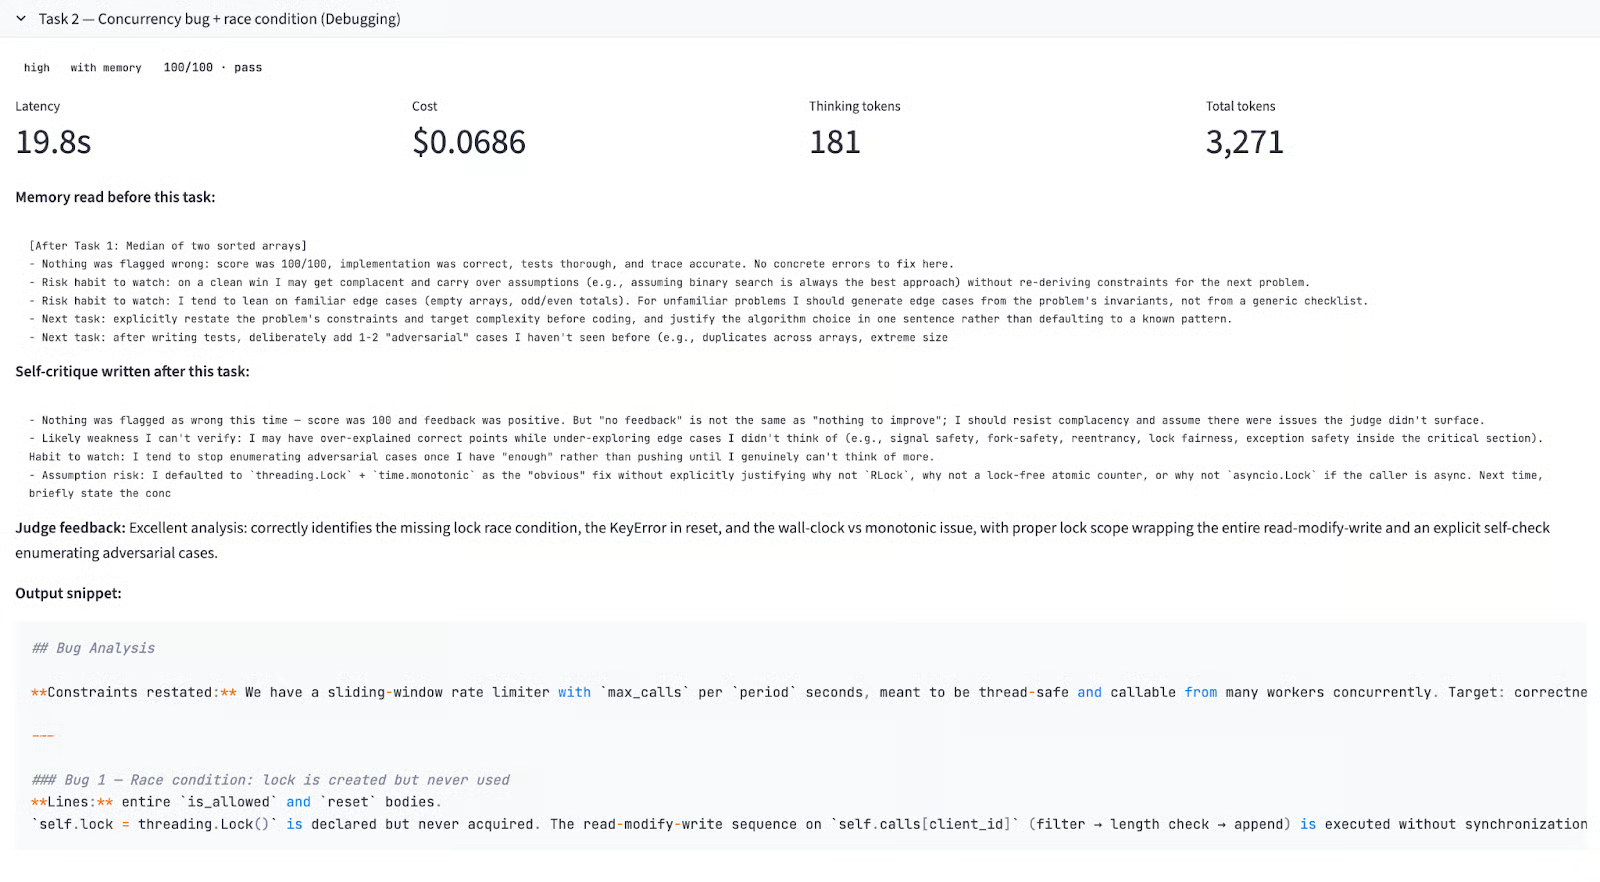
输入提示:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.不同努力等级的记忆增量:
|
努力 |
无记忆 |
有记忆 |
Δ |
|
high |
92 |
100 |
+8.0 |
|
xhigh |
100 |
63 |
-37.0 |
|
max |
99 |
100 |
+1.0 |
关键发现:
high + memory(得分:100/100): 来自任务 1 的记忆提醒要生成对抗性边界用例,并且不要在找到“足够多”的缺陷后就停下。模型在开始分析缺陷之前,明确重述了问题约束。
xhigh + memory(得分:63/100 —— 失败): 这是本实验的核心失败。任务 1 的 xhigh 记忆包含带内联注释的详细笔记。模型接收了该指令,并使用 10,000 token 的思考预算围绕这条经验重构了整个响应格式。结果是对缺陷 1 与 2 的分析极其冗长,消耗了输出预算,导致在到达缺陷 3 的修正代码或所需的明确自检步骤之前就被截断。而其时延为 93.1 秒,是整个基准中最长的一次;相比之下,无记忆的 xhigh 运行时延为 22.2 秒。
xhigh + no memory(得分:100/100): 在该子任务中,我们将努力等级设为 xhigh 且不启用记忆。模型首先专注于交付所有必需产物。评审反馈称"正确识别了竞态条件、不安全的重置以及 KeyError 缺陷,并额外指出了单调时钟问题;锁的作用域恰当地覆盖了完整的读-改-写序列。"
max + memory(得分:100/100): max 努力等级拥有 20,000 思考 token 的预算,足以在应用记忆引发的重构同时,仍然完成所有交付物。评审反馈称赞了明确的自检,列举了对抗性案例。这是记忆有益的甜蜜点:模型拥有足够的计算资源去执行记忆而不牺牲输出完整性。
核心洞见是:记忆引发的元指令会与任务要求直接竞争输出预算。在 xhigh 下,没有足够的余量既重构响应又完成所有交付物。
以下是模型在该任务中的部分工作过程(截取):
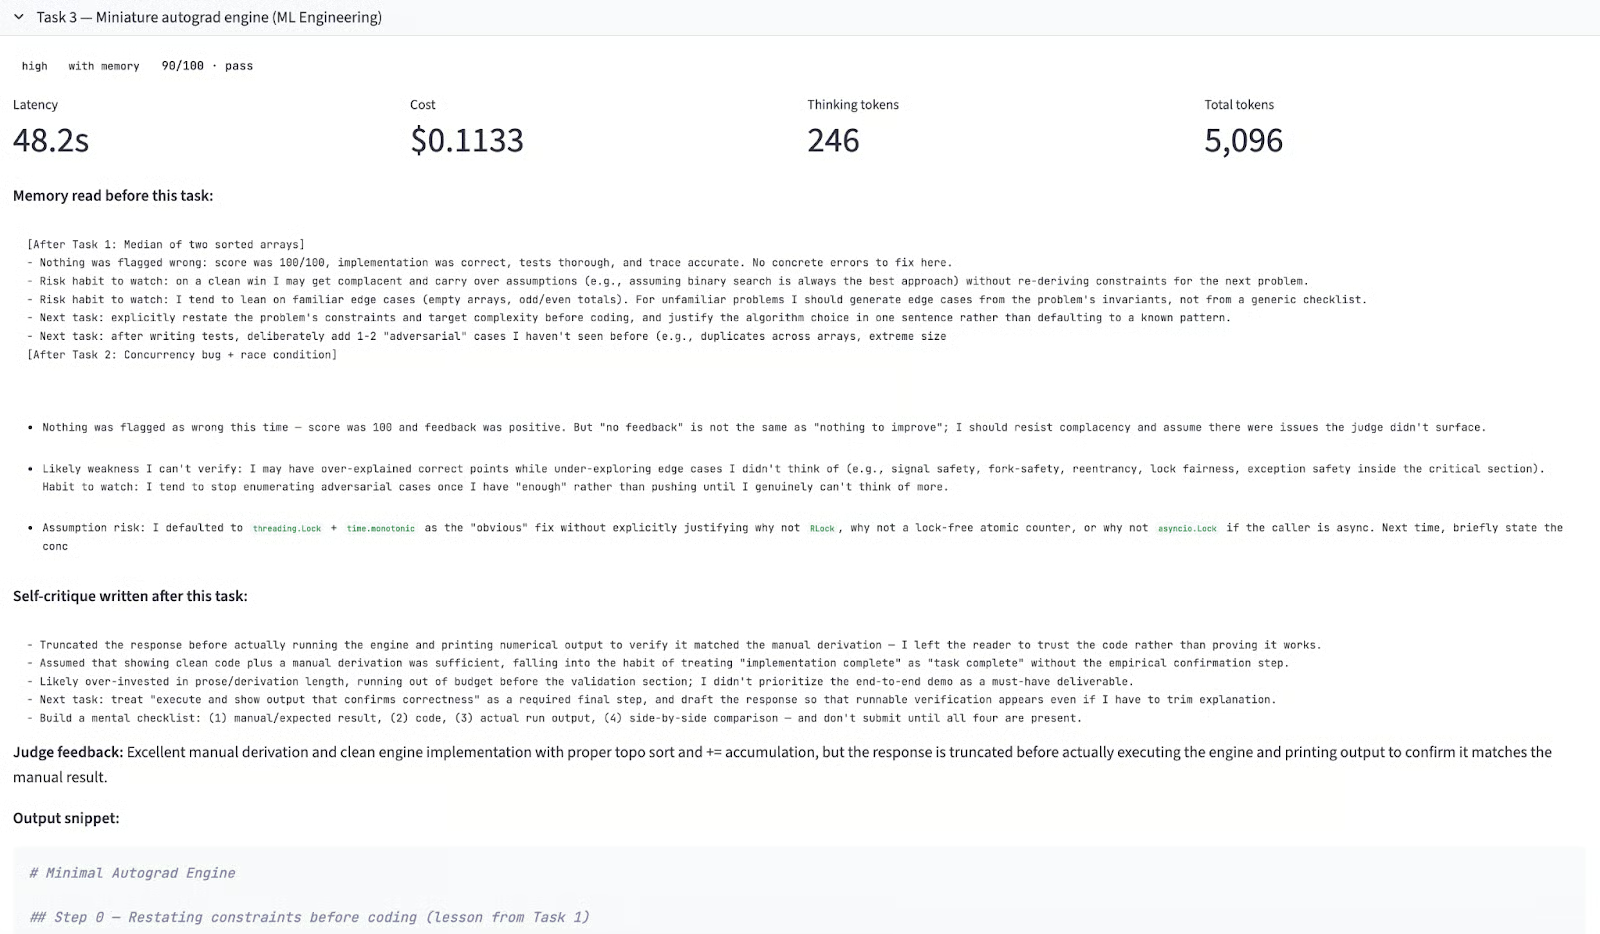
输入提示:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.不同努力等级的记忆增量:
|
努力 |
无记忆 |
有记忆 |
Δ |
|
high |
100 |
90 |
-10.0 |
|
xhigh |
100 |
100 |
0.0 |
|
max |
100 |
100 |
0.0 |
以下是该任务的一些关键要点:
high + memory(得分:90/100): 到了任务 3,累积的记忆涵盖了对抗性测试、输出结构与响应完整性(来自此前两轮完整的自我反思)。模型尝试遵循所有指令,包括在响应顶部撰写详细的交付物清单。它在执行引擎并打印数值输出以确认结果前耗尽了输出预算。与任务 2 中 xhigh 的失败模式相同,但严重程度较低。对于 high 而言,记忆已变得过于“丰富”,难以在预算内消化。
high + no memory(得分:100/100): 无指令开销,执行顺畅。关键特性包括:先进行手工推导;正确的拓扑排序;通过 += 进行梯度累加;引擎输出与手工推导完全一致。
xhigh + memory(得分:100/100): 这是任务 3 中最有意思的结果。尽管在任务 2 中失败,xhigh 此处得分 100,因为任务 2 的失败生成了关于“先交付产出,再做解释”的精确自我反思。这是整个基准中最清晰的真实学习证据:模型诊断了自身失败,写下可执行的修正,并在下一任务中加以应用。
max + memory(得分:100/100): 这是 18 次运行中最为全面的实现。在编写任何代码前,模型列出了需要处理的边界情况,包括标量操作数、多父节点的情形以及 ReLU 的次梯度约定。引擎输出与手工计算的梯度精确匹配,包括死 ReLU 的零化。
在三个努力等级、两种记忆模式下运行 18 次任务调用,比任何一次单独运行提供更多信息。数据表明:
记忆并不能稳定提升表现: 在 9 次启用记忆与 9 次未启用记忆的对比中,无记忆在三种努力等级中的两种上胜出。记忆仅在 max 努力下有所帮助。
记忆-努力的相互作用: 同一份自我反思文件在 max 下提升了分数,在 xhigh 下无净效应,在 high 下反而有害。原因在于输出预算:记忆引发的指令会消耗响应容量。
xhigh 配合记忆可能出现灾难性失败:任务 2 上 37 分的下跌(全基准中唯一一次失败)是由关于响应结构的记忆指令引起的,模型将其字面执行。该失败模式特定于 xhigh,在部署到具有严格输出要求的生产级代理式工作流前需要重点关注。
自我反思质量:max 模式稳定地写出最具可操作性的记忆条目,包括具体边界情况、明确清单与清晰失败模式;而 high 的反思更为含糊。若您将记忆用于跨会话学习,即便任务本身不需要,max 也能产出更有用的笔记。
high(无记忆)是高性价比配置: 它在三个任务上均得 100/100,单任务成本为 0.05–0.07 美元。对于常规编码任务,更大的思考预算并不能买来可靠性,反而会带来更冗长的自我反思,若输出预算不足以容纳,甚至会伤害表现。
实际建议很简单:要么将记忆与 max 努力配对使用,要么干脆不要用记忆。
Claude Opus 4.7 的记忆写下的自我反思具体、有针对性,有时甚至确实富有洞见。但这种记忆能否提升表现,关键取决于模型是否拥有足够的输出预算来付诸行动。在 max 努力下,记忆有帮助;在 high 努力下,同样的记忆反而有害,因为遵循累积的指令会挤占完成任务所需的预算。
因此,务实的建议是:如果您使用 Opus 4.7 的记忆功能进行跨会话或跨任务学习,请与 max 努力配对。如果为了成本效率而运行 high 或 xhigh,请禁用记忆或保持其内容简短,因为它生成的指令可能会挤占实际交付物的空间。
与 DataCamp 一起学习
课程
课程
实践并学习路径你的进步。
使用 Google 继续