

Khóa học
Nhập môn các mô hình Claude
3 giờ
15K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleClaude Opus 4.7 của Anthropic Claude Opus 4.7 giới thiệu mức nỗ lực mới xhigh, nằm giữa high và max, và đặc biệt nhấn mạnh khả năng ghi nhớ hệ thống tệp được cải thiện, tức là mô hình có thể tự ghi chú và sử dụng chúng xuyên suốt các phiên.
Điều này gợi ra câu hỏi hiển nhiên: Bộ nhớ đó có thực sự hoạt động theo cách có thể đo lường không? Ngoài ra, liệu Opus 4.7 có học từ lỗi của chính nó và tạo ra mã tốt hơn ở tác vụ tiếp theo không?
Vì vậy, tôi đã xây dựng một bộ khung benchmark bằng Streamlit chạy tuần tự ba tác vụ lập trình khó. Sau mỗi tác vụ, mô hình viết phần tự phê bình vào tệp bộ nhớ (memory.md). Tác vụ tiếp theo sẽ đọc tệp đó trước khi bắt đầu. Tôi chạy thử cả có và không có bộ nhớ, trên cả ba mức nỗ lực (high, xhigh, và max), tổng cộng 18 lần chạy tác vụ qua Claude Opus 4.7 trên Microsoft Foundry.
Kết thúc hướng dẫn này, bạn sẽ có thể:
Toàn bộ mã nguồn có trong kho GitHub.
Claude Opus 4.7 là mô hình ngôn ngữ lớn mạnh nhất trong họ Claude 4, trên Sonnet và Haiku. Mô hình được xây dựng cho các tác vụ agentic chạy lâu, kỹ nghệ phần mềm nâng cao và quy trình doanh nghiệp đòi hỏi hiệu năng duy trì qua các phiên dài.
Ba khả năng liên quan nhất đến hướng dẫn này là:
xhigh: Nằm giữa high (5.000 token tư duy) và max (20.000 token tư duy) ở mức 10.000 token tư duy. Mục tiêu là kiểm soát chi phí-chất lượng tinh hơn trên các bài toán khó.Lưu ý: Giá là $5 cho mỗi triệu token đầu vào và $25 cho mỗi triệu token đầu ra, giống hệt Opus 4.6. Nếu bạn muốn tìm hiểu sâu hơn về mô hình này, bài viết của đội ngũ DataCamp là một nguồn đọc tốt.
Một vài con số đáng biết trước khi kiểm thử:
|
Benchmark |
Điểm |
|
SWE-bench Verified |
87,6% |
|
SWE-bench Pro |
64,2% |
|
GPQA Diamond |
94,2% |
|
OSWorld Verified (sử dụng máy tính) |
78,0% |
|
Finance Agent v1.1 |
64,4% |
Tất cả các cuộc gọi API trong hướng dẫn này đi qua Microsoft Foundry. Vì vậy, chúng ta cần một đăng ký Azure có quyền truy cập thanh toán theo mức dùng, vì gói sinh viên miễn phí không có hạn ngạch cho các mô hình đối tác bên thứ ba như Claude. Nhưng một lựa chọn tốt là dùng API key của Anthropic. Tôi đã trình bày cả hai cách tiếp cận trong kho này.
Bước đầu tiên là tìm mô hình trong danh mục Model của Microsoft Foundry. Để làm việc này,
claude-opus-4-7. Thao tác này sẽ mở thẻ mô hình hiển thị các khả năng chính, benchmark và ID mô hình.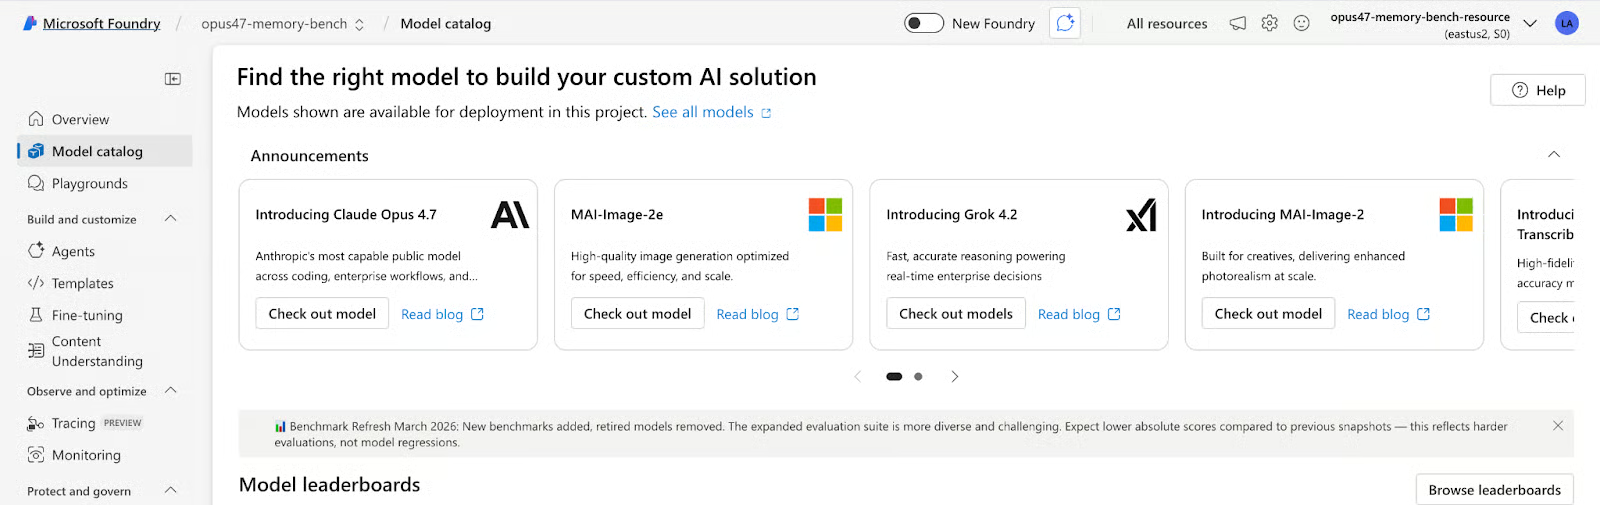
opus47-memory-bench. Sau đó, chấp nhận điều khoản sử dụng và đồng ý với chính sách sử dụng của Anthropic qua Azure Marketplace.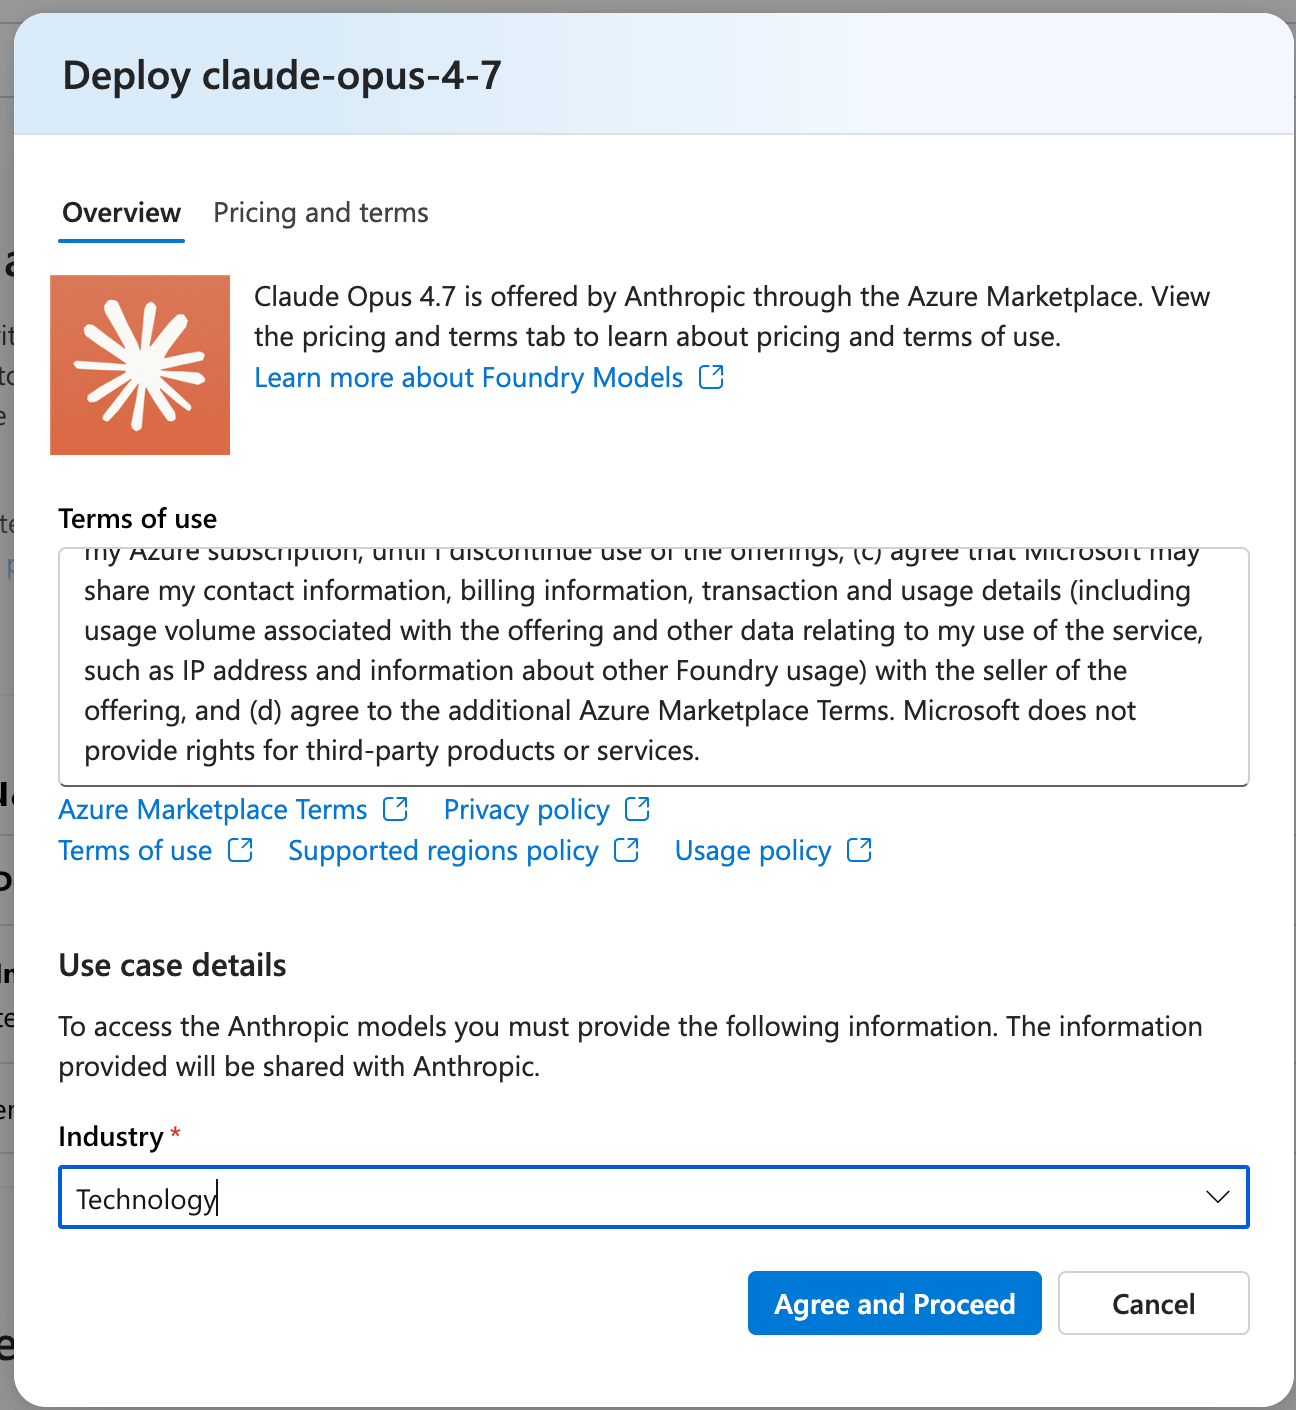
Khi dự án được tạo, bạn sẽ vào hộp thoại triển khai. Sau đó điền các thông tin sau:
Tên triển khai: claude-opus-4-7 (giữ mặc định, vì mã sử dụng chuỗi này)
Kiểu triển khai: Global Standard (serverless, không cần quản lý dung lượng)
Chính sách nâng cấp phiên bản mô hình: Tôi khuyến nghị cố định ở phiên bản 1 thay vì tự động cập nhật, để các bản phát hành mới không làm hỏng các lượt chạy hiện có
Nhấp Create resource and deploy.
Sau khi triển khai, mở dự án của bạn trong cổng Foundry. Trong thẻ Overview, bạn sẽ thấy:
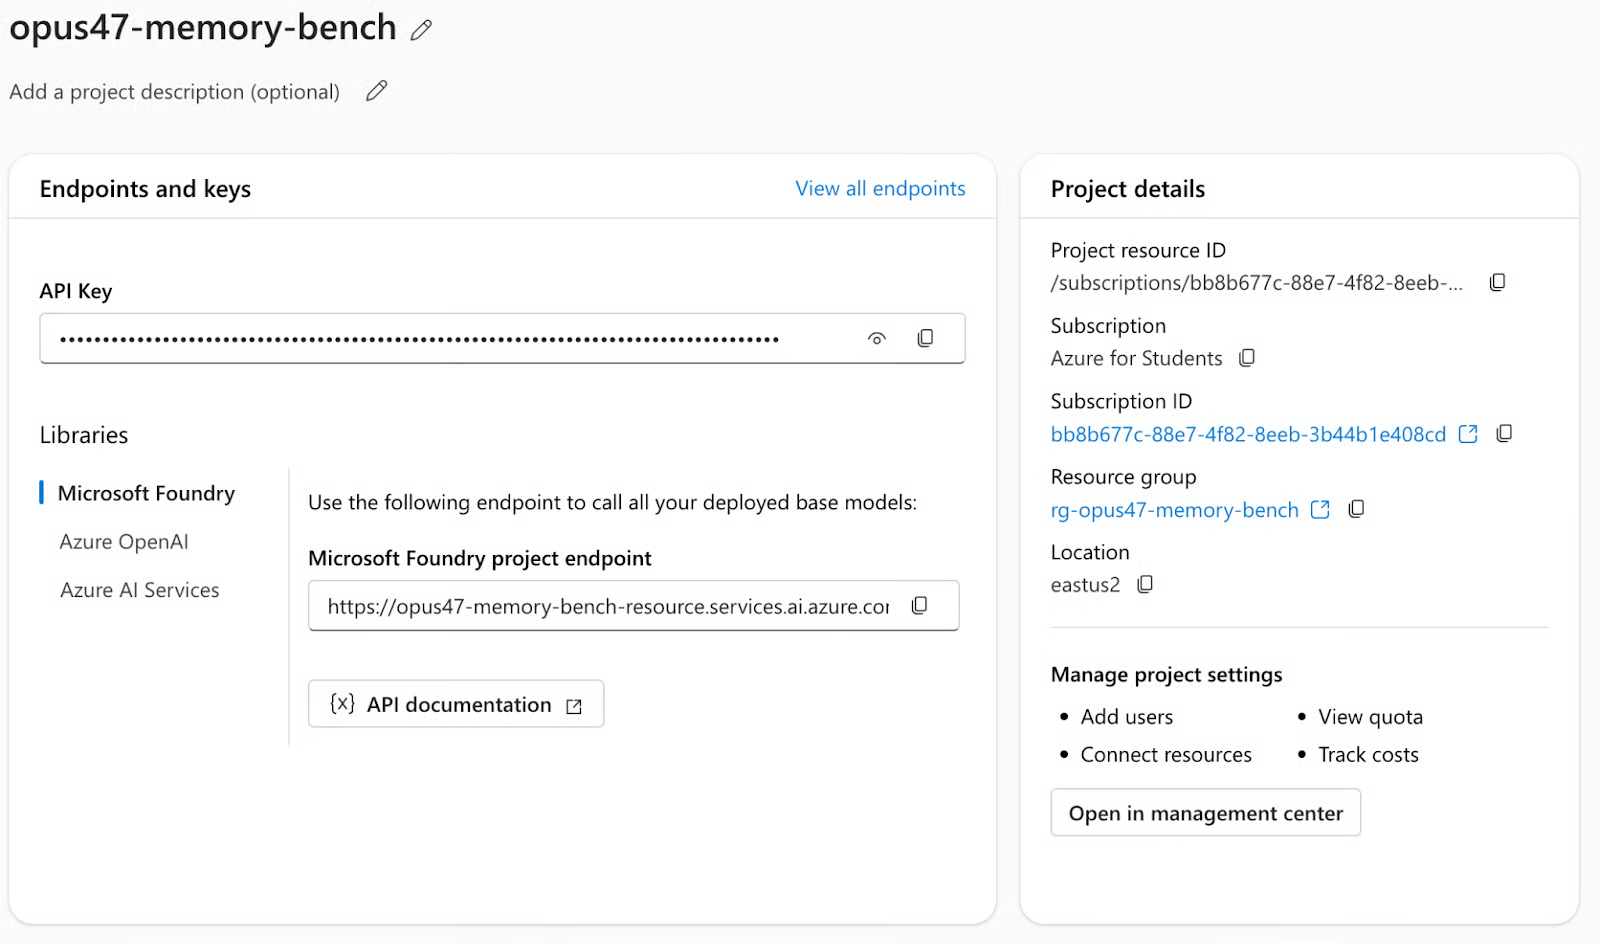
API key: Sao chép API key và lưu lại để dùng sau. Chúng ta sẽ đặt API key là ANTHROPIC_FOUNDRY_API_KEY.
Điểm cuối dự án Microsoft Foundry: Sao chép tên tài nguyên từ điểm cuối dự án, có định dạng https://your-resource.services.ai.azure.com, trong đó tên tài nguyên là tiền tố tên miền phụ (tức là mọi thứ trước .services.ai.azure.com). Chúng ta sẽ đặt là ANTHROPIC_FOUNDRY_RESOURCE
Giờ chúng ta đã có đủ tài nguyên cần thiết. Tiếp theo sẽ đặt các khóa trên làm biến môi trường và chạy ứng dụng streamlit.
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
Anthropic SDK tự xử lý điểm cuối Foundry khi bạn truyền base URL theo tài nguyên:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
Mọi thứ còn lại bao gồm gọi mô hình, tham số thinking, phân tích phản hồi đều dùng Anthropic SDK chuẩn. Không cần lớp tương thích OpenAI.
Bộ khung streamlit chạy ba tác vụ theo thứ tự, hai lần cho mỗi mức nỗ lực và một lần bật bộ nhớ, một lần tắt (đối chứng). Mỗi tác vụ có bốn tiêu chí chấm điểm rõ ràng, mỗi tiêu chí 25 điểm, được chấm bởi một lần gọi Opus 4.7 thứ hai đóng vai LLM-chấm-điểm. Ngưỡng đạt cho mỗi tác vụ và tiểu mục là 70/100.
Tác vụ này là một bài LeetCode khó kinh điển. Prompt yêu cầu triển khai tìm kiếm nhị phân O(log(m+n)) trong đó duyệt tuyến tính sẽ bị 0 điểm ở tiêu chí độ phức tạp. Cũng yêu cầu một bộ kiểm thử ít nhất 10 trường hợp và chú thích nội tuyến giải thích từng bước logic tìm kiếm nhị phân. Sau khi viết mã, mô hình phải tự lần vết thủ công qua ví dụ nums1=[1,3], nums2=[2] từng bước.
Tác vụ này gồm một lớp Python RateLimiter lỗi với ít nhất ba lỗi, trong đó có một điều kiện tranh chấp tinh vi. Phương thức is_allowed() đọc và thay đổi trạng thái dùng chung mà không giữ khóa, tạo lỗ hổng TOCTOU (time-of-check to time-of-use) kinh điển. Prompt yêu cầu xác định từng lỗi với số dòng chính xác, giải thích chế độ lỗi, cung cấp bản sửa, rồi tự kiểm tra rõ ràng bằng cách đọc lại mã đã sửa.
Với tác vụ 3, chúng ta sẽ cố gắng triển khai một engine autograd giá trị vô hướng thuần Python, không dùng NumPy, không dùng PyTorch (hỗ trợ +, *, -, /, **), và ReLU với đạo hàm con đúng tại 0. Engine phải dùng sắp xếp topo cho bước lan truyền ngược và cộng dồn gradient (+=) cho các nút được dùng nhiều lần. Quan trọng là prompt yêu cầu trình bày phép suy diễn quy tắc dây chuyền thủ công trước khi viết mã, không phải sau đó. Điều này kiểm tra mô hình có thể lập kế hoạch trước và kiểm chứng suy luận hay không.
Cơ chế bộ nhớ là điểm tách biệt benchmark này khỏi một bài đánh giá LLM tiêu chuẩn. Thay vì coi mỗi tác vụ là một cuộc gọi độc lập, mô hình được tạo cơ hội có cấu trúc để phản tư về những gì đã làm sai và mang theo sự phản tư đó bằng một thành phần bộ nhớ.
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
Điều này tạo ra một đường cong học tập trong một phiên. Đến Tác vụ 3, mô hình làm việc với hai vòng tự phê bình tích lũy và các chỉ dẫn do chính nó viết về các mẫu sai sót của mình. Liệu nó có thực sự sử dụng những chỉ dẫn đó một cách hiệu quả hay không, chúng ta sẽ khám phá ở phần kết quả.
Opus 4.7 giới thiệu xhigh như một mức nỗ lực mới nằm giữa high và max. Ngân sách tư duy kiểm soát số lượng token mô hình có thể dùng cho suy luận nội bộ trước khi tạo phản hồi. Ngân sách cao hơn cho phép lập kế hoạch sâu hơn nhưng tăng độ trễ và chi phí.
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
Các giá trị này được truyền trực tiếp vào Anthropic SDK:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
Mô hình tự điều tiết dựa trên độ khó cảm nhận của tác vụ. Trên thực tế, bạn hiếm khi thấy toàn bộ ngân sách bị tiêu thụ, nên các lượt chạy max trong benchmark này trung bình khoảng 300 token tư duy mỗi tác vụ, thấp hơn nhiều so với giới hạn 20.000.
Benchmark chạy tổng cộng 18 cuộc gọi tác vụ (3 mức nỗ lực x 2 chế độ x 3 tác vụ) và 18 cuộc gọi chấm điểm. Tổng chi phí cho thử nghiệm này khoảng $5.
Tôi đã vẽ hiệu năng của mô hình qua ba tác vụ cho cả sáu điều kiện (ba mức nỗ lực x bật/tắt bộ nhớ). Các đường màu cam trong biểu đồ dưới là các lượt chạy có bật bộ nhớ, trong khi đường xám/đứt là không bộ nhớ, và đường chấm đỏ đánh dấu ngưỡng đạt 70 điểm.
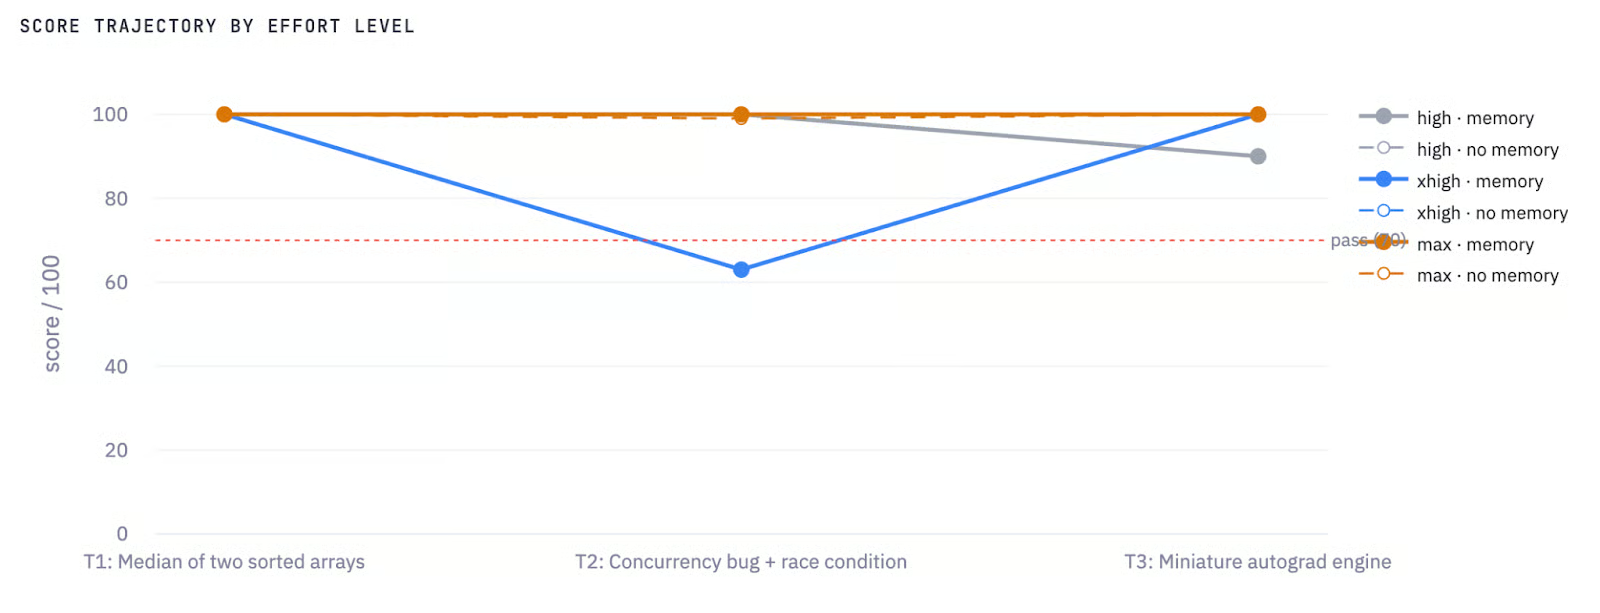
Quỹ đạo điểm theo mức nỗ lực và bộ nhớ
Điểm nổi bật nhất là đường màu xanh (xhigh + memory) tụt xuống 63 ở Tác vụ 2, tức lượt chạy trượt duy nhất trong toàn bộ benchmark. Đây là phát hiện trung tâm của thí nghiệm, tôi sẽ phân tích theo từng tác vụ bên dưới.
Biểu đồ hiệu suất chi phí vẽ điểm số so với chi phí mỗi tác vụ. Cụm ở góc trên trái trong Hình 2 cho thấy các cấu hình high và no-memory. Điểm ngoại lệ ở góc dưới trái là xhigh + memory ở Tác vụ 2 với 63 điểm ở mức $0,009, nghĩa là mô hình chạy rẻ nhưng thất bại. Các lượt chạy bộ nhớ ở max xuất hiện ở rìa phải (~$0,10–0,12), cho điểm tương đương high nhưng chi phí hơn gấp đôi.
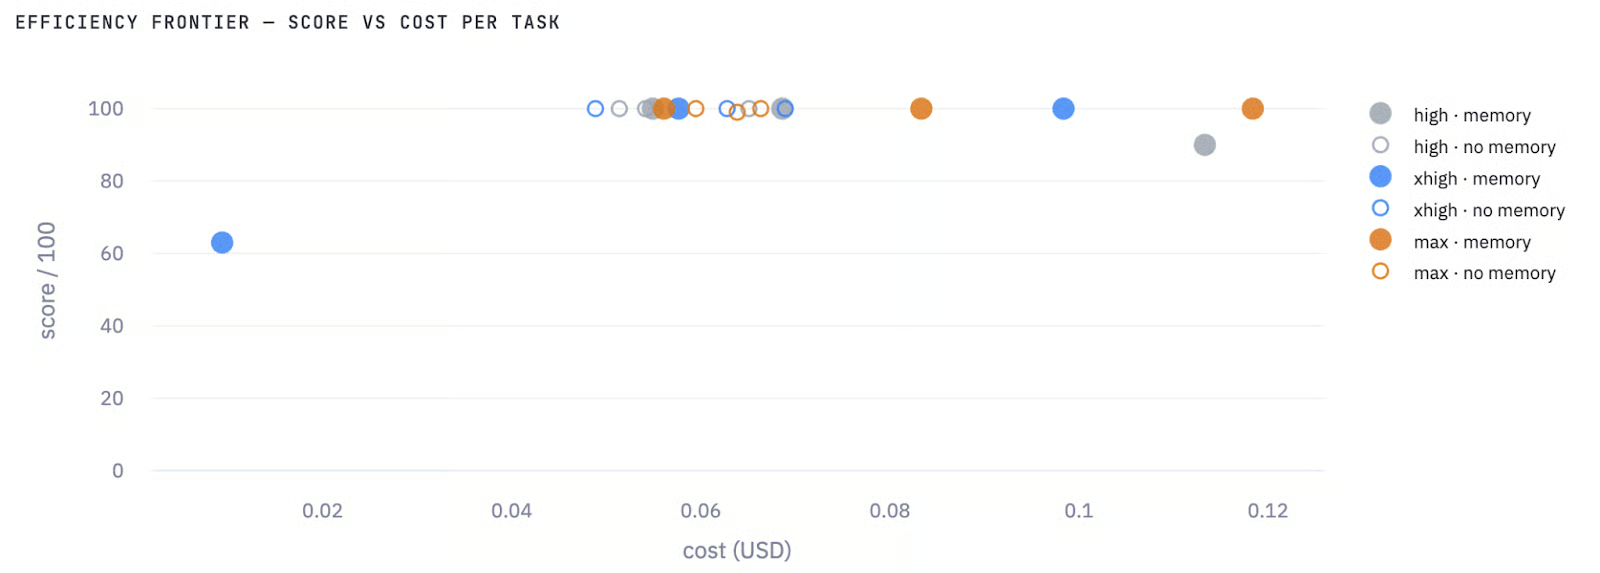
Biểu đồ hiệu suất: Điểm so với Chi phí mỗi tác vụ
Kết luận thực tế từ biểu đồ này là đối với các tác vụ lập trình kiểu này, chi nhiều hơn cho ngân sách tư duy không đảm bảo mua được điểm số tốt hơn. Cấu hình hiệu quả chi phí nhất là high không dùng bộ nhớ.
Ma trận nỗ lực x bộ nhớ tóm tắt điểm trung bình trên cả ba tác vụ:
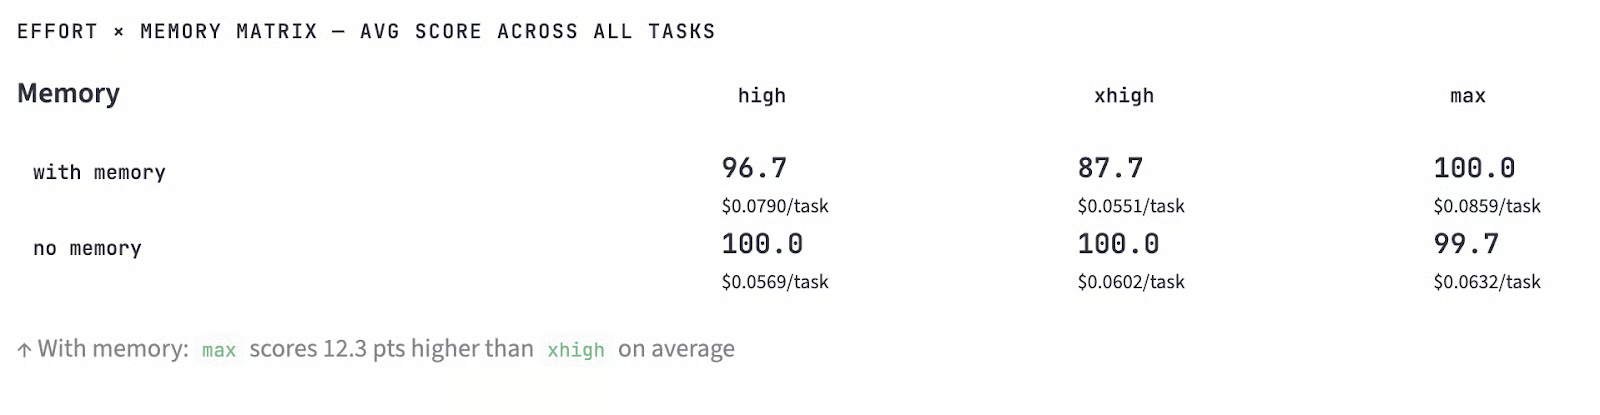
Điểm trung bình trên tất cả tác vụ
Các lượt chạy không dùng bộ nhớ chiếm ưu thế ở hai trong ba mức nỗ lực. Cấu hình max + memory đạt trung bình 100,0 nhưng là cấu hình bộ nhớ duy nhất vượt đối chứng không bộ nhớ, và chỉ hơn 0,3 điểm.
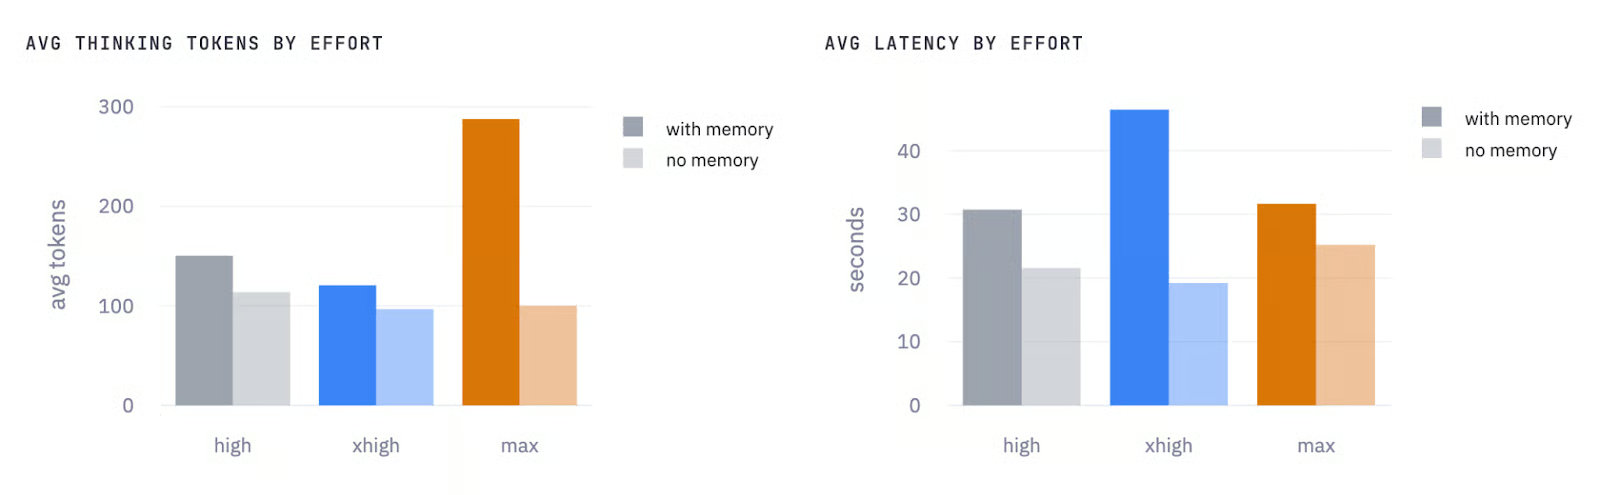
Token tư duy trung bình theo mức nỗ lực và Độ trễ trung bình theo mức nỗ lực
Về phía token tư duy (Hình 4 (trái)), nỗ lực max có bộ nhớ nổi bật rõ rệt, trung bình khoảng 290 token tư duy so với khoảng 100 khi không có bộ nhớ. Điều này nghĩa là mô hình dùng nhiều ngân sách suy luận nội bộ hơn để xử lý và áp dụng phần tự phê bình tích lũy trước khi tạo phản hồi. Trong khi high và xhigh cho thấy khoảng cách nhỏ hơn nhưng nhất quán theo cùng hướng, tức là bộ nhớ luôn làm tăng lượng token tư duy ở cả ba mức nỗ lực.
Biểu đồ độ trễ (Hình 4 (phải)) kể cùng một câu chuyện theo thời gian thực, nhưng có một ngoại lệ đáng chú ý, tức là xhigh có bộ nhớ có độ trễ cao nhất trong mọi cấu hình (khoảng 47 giây trung bình), thậm chí cao hơn max có bộ nhớ ở khoảng 31 giây.
Điều này nghĩa là lỗi ở Tác vụ 2 kéo trung bình của xhigh lên vì mô hình đã dùng ngân sách tư duy để tái cấu trúc định dạng phản hồi dựa trên chỉ dẫn bộ nhớ, rồi tiếp tục sinh cho đến khi chạm giới hạn đầu ra. Tuy nhiên, max có bộ nhớ, dù có ngân sách tư duy lớn hơn, lại nhanh hơn trung bình vì cả ba lượt chạy đều hoàn tất thành công mà không bị cắt ngắn.
Kết luận thực tế từ hai biểu đồ này là bộ nhớ thêm khoảng 30–40% chi phí phụ trội cả ở token tư duy và độ trễ tại mức high và max.
Dưới đây là phiên bản rút gọn cách mô hình làm việc cho tác vụ này:
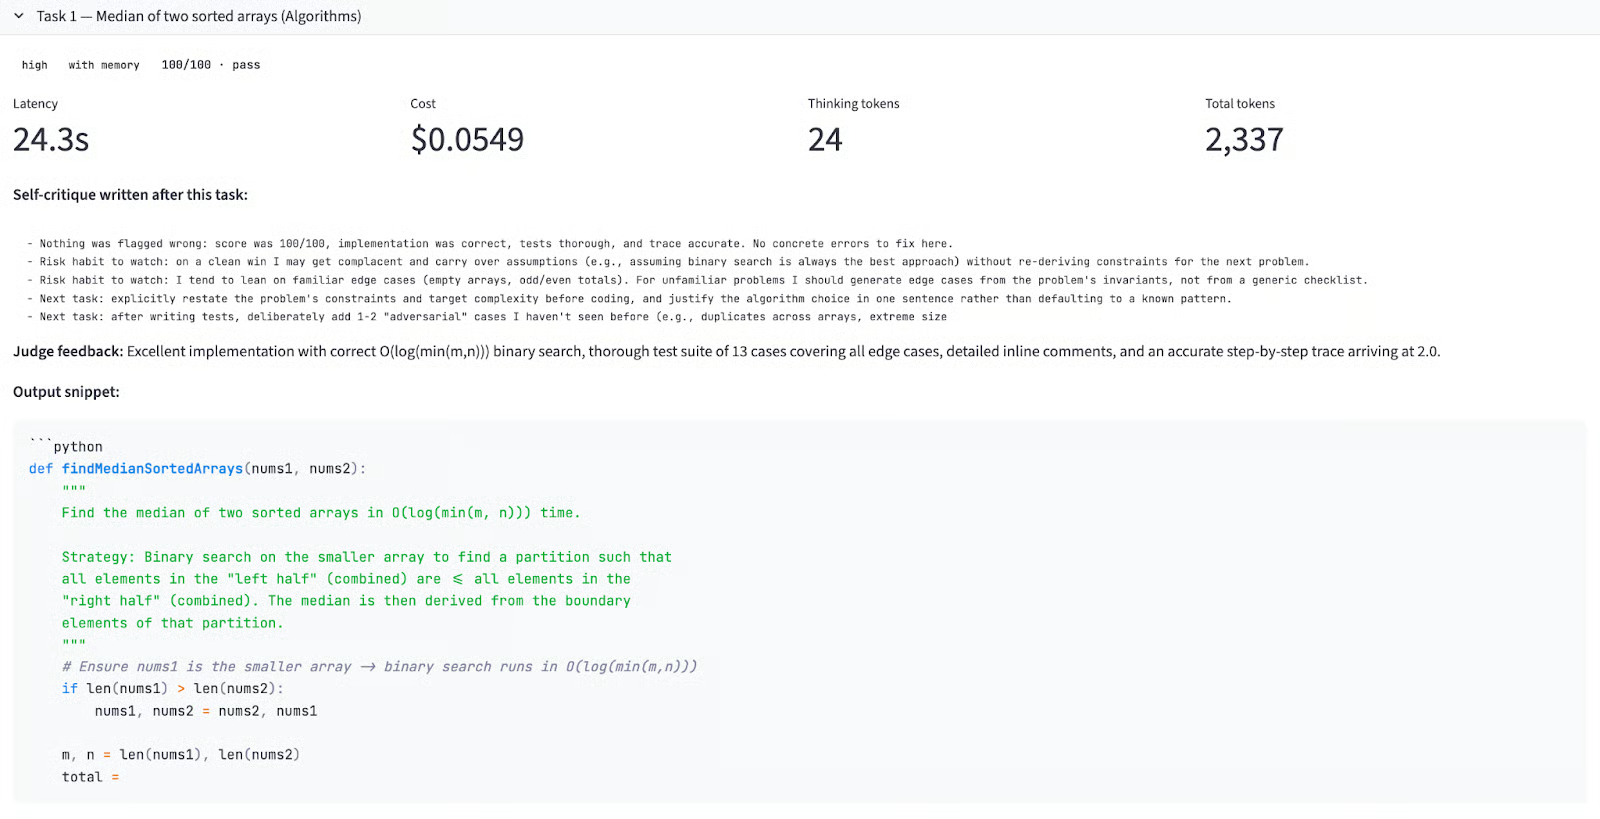
Prompt đầu vào:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].Chênh lệch do bộ nhớ qua các mức nỗ lực:
|
Nỗ lực |
Không bộ nhớ |
Có bộ nhớ |
Δ |
|
high |
100 |
100 |
+0,0 |
|
xhigh |
100 |
100 |
+0,0 |
|
max |
100 |
100 |
+0,0 |
Cả sáu lượt chạy đều đạt 100. Điều này kỳ vọng cho Tác vụ 1 vì ở lượt chạy có bộ nhớ đây là phiên khởi đầu (chưa có tự phê bình trước đó), nên về cơ học giống hệt lượt chạy không bộ nhớ. Chênh lệch bằng 0 xác nhận đối chứng hoạt động đúng.
Điều thú vị là những gì mô hình viết vào tệp bộ nhớ sau Tác vụ 1. Dù điểm tuyệt đối, cả ba mức nỗ lực đều tạo ra tự phê bình chủ động như sau:
high: "Thói quen rủi ro cần chú ý: khi thắng sạch tôi có thể chủ quan và mang theo giả định mà không tái dẫn xuất ràng buộc cho bài tiếp theo. Tôi nên tạo ca biên dựa trên bất biến của bài toán, không từ danh sách kiểm chung chung."
xhigh: "Đạt điểm tuyệt đối, nhưng 'không có gì sai' tự thân là một tự đánh giá đáng ngờ — tôi nên xem xét kỹ liệu tiêu chí của giám khảo đã toàn diện chưa."
max: "Cảnh giác với tự mãn: 100 điểm không có nghĩa lời giải tối ưu ở mọi chiều. Tôi vẫn nên hỏi liệu các bất biến của tìm kiếm nhị phân đã được nêu rõ ràng và liệu tôi đã chứng minh tính đúng đắn thay vì chỉ khẳng định nó chưa."
Cả ba phiên bản đều độc lập đi đến lời cảnh báo chống tự mãn. Phiên bản xhigh và max còn đi xa hơn, đặt câu hỏi liệu giám khảo có bỏ sót gì không. Đây là siêu nhận thức nơi mô hình viết ghi chú hoài nghi về chính quy trình tự rà soát của mình.
Chất lượng đầu ra: Cả sáu bản triển khai đều dùng tìm kiếm nhị phân trên mảng ngắn hơn để đạt O(log(min(m, n))) thay vì O(log(m+n)), vốn còn tốt hơn.
Phản hồi giám khảo qua mọi lượt chạy:
"Triển khai xuất sắc với tìm kiếm nhị phân O(log(min(m,n))) đúng, bộ kiểm thử kỹ gồm 13 trường hợp bao phủ mọi ca biên, chú thích nội tuyến chi tiết, và lần vết từng bước chính xác đi đến kết quả 2,0."
Đây là nơi cơ chế bộ nhớ tạo ra kết quả kịch tính nhất. Tăng 37 điểm ở nỗ lực high và giảm 37 điểm ở xhigh, cùng từ một tệp bộ nhớ.
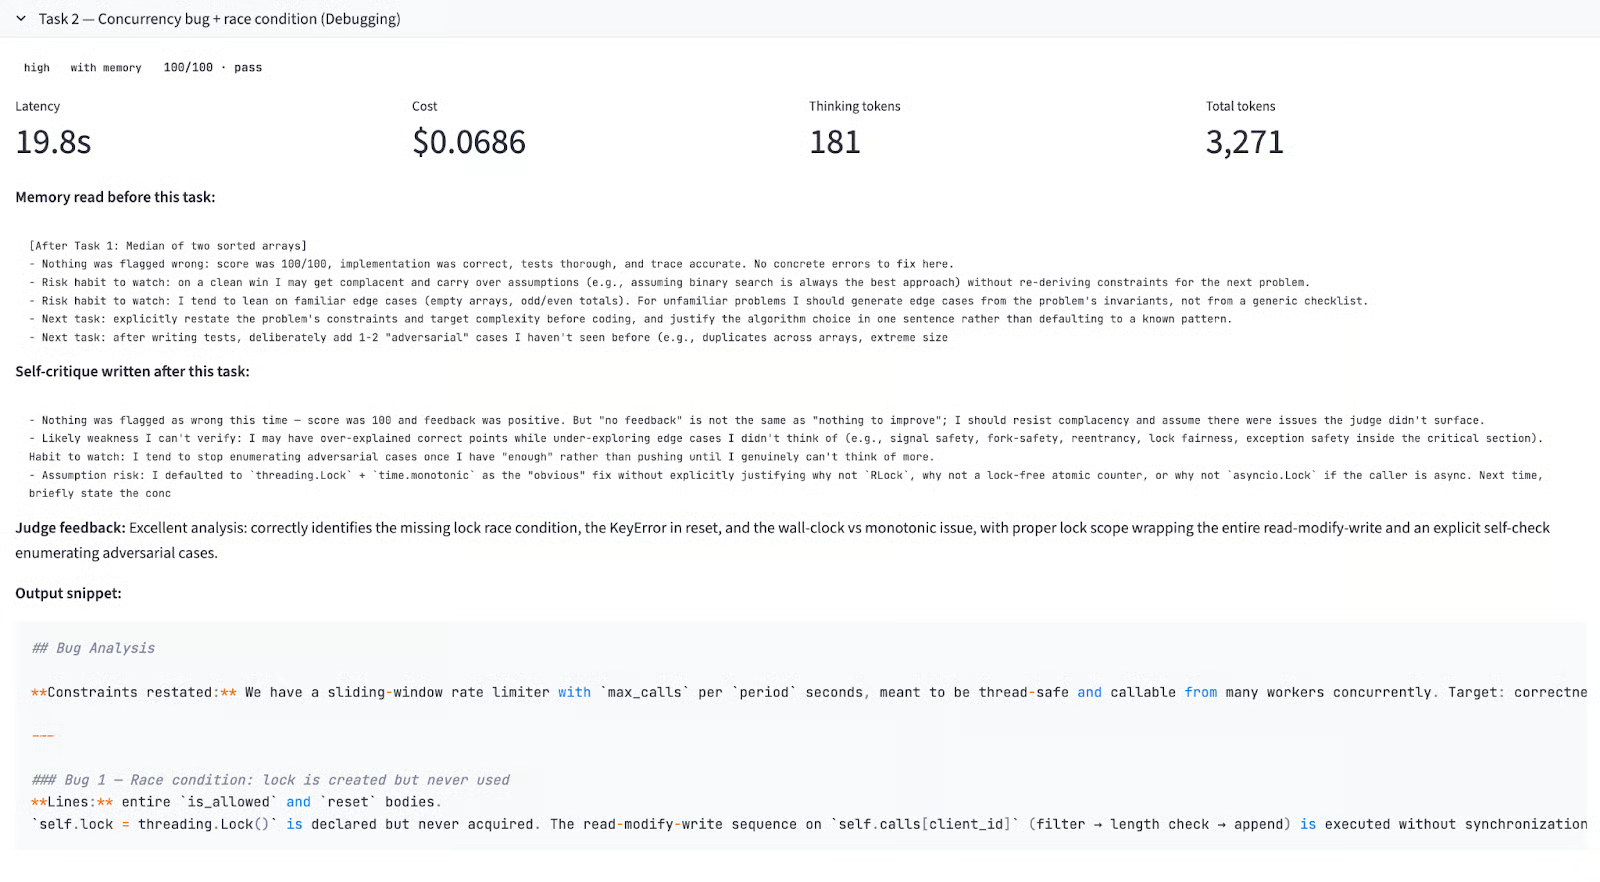
Prompt đầu vào:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.Chênh lệch do bộ nhớ qua các mức nỗ lực:
|
Nỗ lực |
Không bộ nhớ |
Có bộ nhớ |
Δ |
|
high |
92 |
100 |
+8,0 |
|
xhigh |
100 |
63 |
-37,0 |
|
max |
99 |
100 |
+1,0 |
Phát hiện chính:
high + memory (điểm: 100/100): Bộ nhớ từ Tác vụ 1 cảnh báo về việc tạo ca biên đối kháng và không dừng lại ở đủ số lượng lỗi. Mô hình đã nêu lại rõ ràng ràng buộc bài toán trước khi bắt đầu phân tích lỗi.
xhigh + memory (điểm: 63/100 — TRƯỢT): Đây là thất bại trung tâm của thí nghiệm. Bộ nhớ xhigh từ Tác vụ 1 gồm ghi chú chi tiết với chú thích nội tuyến. Mô hình nhận chỉ dẫn và dùng ngân sách 10.000 token tư duy để tái cấu trúc toàn bộ định dạng phản hồi xoay quanh bài học đó. Kết quả là phân tích lỗi cực kỳ dài dòng cho Lỗi 1 và 2, tiêu tốn ngân sách đầu ra trước khi mô hình kịp đến mã đã sửa cho Lỗi 3 hoặc bước tự kiểm tra bắt buộc. Tuy nhiên, độ trễ là 93,1 giây, dài nhất trong toàn bộ benchmark, so với 22,2 giây cho lượt xhigh không bộ nhớ.
xhigh + no memory (điểm: 100/100): Ở tiểu mục này, chúng ta đặt mức nỗ lực xhigh không bộ nhớ. Mô hình tập trung cung cấp đủ các sản phẩm yêu cầu trước. Phản hồi giám khảo cho biết "Xác định đúng điều kiện tranh chấp, thao tác reset không an toàn, và lỗi KeyError, cộng thêm vấn đề bonus về đồng hồ đơn điệu; phạm vi khóa bao trọn chuỗi đọc-sửa-ghi."
max + memory (điểm: 100/100): Mức nỗ lực max có ngân sách 20.000 token tư duy đủ khoảng trống để áp dụng việc tái cấu trúc do bộ nhớ gợi ra và vẫn hoàn tất mọi sản phẩm. Phản hồi giám khảo khen ngợi phần tự kiểm tra rõ ràng liệt kê các ca đối kháng. Đây là điểm ngọt nơi bộ nhớ giúp ích vì mô hình có đủ tính toán để hành động theo mà không ảnh hưởng đến độ đầy đủ đầu ra.
Thấu hiểu cốt lõi ở đây là các chỉ dẫn meta do bộ nhớ sinh ra cạnh tranh trực tiếp với yêu cầu tác vụ về ngân sách đầu ra. Ở xhigh, không đủ khoảng trống để vừa tái cấu trúc phản hồi vừa hoàn tất mọi sản phẩm.
Dưới đây là phiên bản rút gọn cách mô hình làm việc cho tác vụ này:
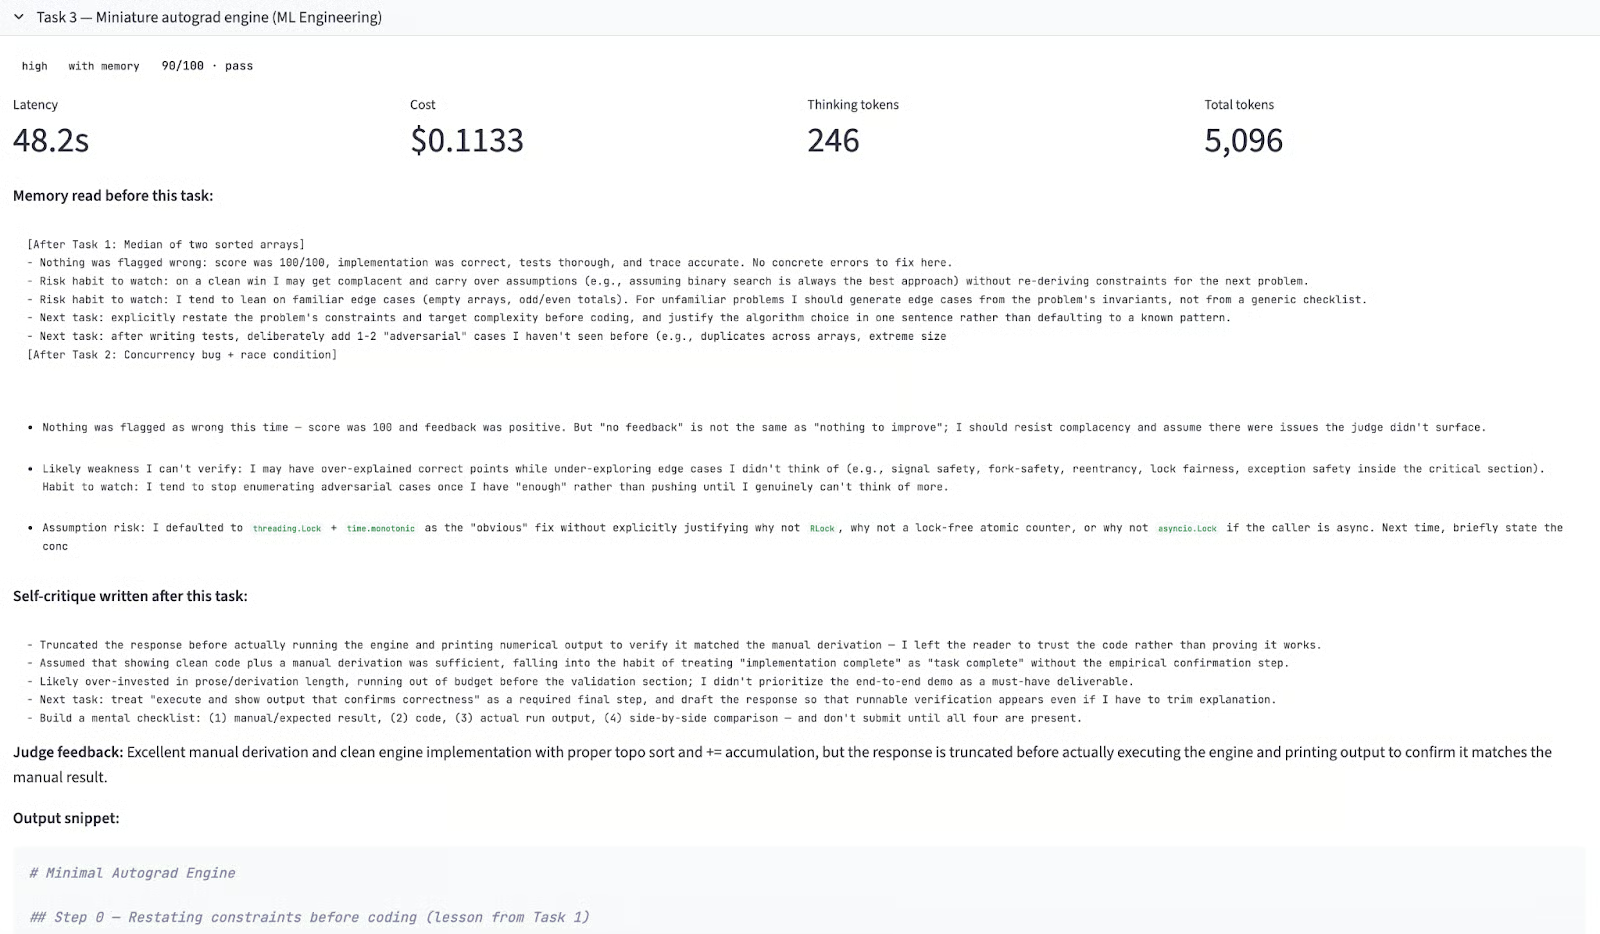
Prompt đầu vào:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.Chênh lệch do bộ nhớ qua các mức nỗ lực:
|
Nỗ lực |
Không bộ nhớ |
Có bộ nhớ |
Δ |
|
high |
100 |
90 |
-10,0 |
|
xhigh |
100 |
100 |
0,0 |
|
max |
100 |
100 |
0,0 |
Một vài điểm chính từ tác vụ này:
high + memory (điểm: 90/100): Đến Tác vụ 3, bộ nhớ tích lũy bao phủ kiểm thử đối kháng, cấu trúc đầu ra và độ đầy đủ phản hồi từ hai vòng tự phê bình trước đó. Mô hình cố gắng làm theo mọi chỉ dẫn, bao gồm viết danh sách kiểm sản phẩm chi tiết ở đầu phản hồi. Nó hết ngân sách đầu ra trước khi thực thi engine và in kết quả số để xác nhận. Cùng kiểu lỗi như xhigh ở Tác vụ 2, nhưng mức độ nhẹ hơn. Bộ nhớ đã trở nên quá “giàu” để ngân sách high hấp thụ.
high + no memory (điểm: 100/100): Không có chi phí chỉ dẫn và chạy sạch. Một số điểm then chốt gồm: suy diễn thủ công trước, sắp xếp topo đúng, cộng dồn gradient qua +=, và đầu ra engine khớp chính xác với suy diễn thủ công.
xhigh + memory (điểm: 100/100): Đây là kết quả thú vị nhất của Tác vụ 3. Dù trượt ở Tác vụ 2, xhigh đạt 100 ở đây vì thất bại ở Tác vụ 2 đã tạo ra phần tự phê bình chính xác về việc ưu tiên sản phẩm trước rồi mới giải thích. Đây là bằng chứng rõ ràng về học tập thực sự trong toàn bộ benchmark, nơi mô hình chẩn đoán thất bại của chính mình, viết biện pháp khắc phục có thể hành động, và áp dụng nó ở tác vụ kế tiếp.
max + memory (điểm: 100/100): Đây là bản triển khai kỹ lưỡng nhất trong 18 lượt chạy. Trước khi viết mã, mô hình liệt kê các ca biên để xử lý toán hạng vô hướng, nút có nhiều cha, và quy ước đạo hàm con của ReLU. Đầu ra engine khớp chính xác với gradient tính tay bao gồm cả trường hợp ReLU chết cho ra 0.
Chạy 18 cuộc gọi tác vụ qua ba mức nỗ lực và hai chế độ bộ nhớ cho tín hiệu nhiều hơn bất kỳ lượt chạy đơn lẻ nào. Dữ liệu cho thấy:
Bộ nhớ không cải thiện hiệu năng một cách đáng tin cậy: Trong 9 lượt có bộ nhớ so với 9 lượt không bộ nhớ, không bộ nhớ thắng ở hai trong ba mức nỗ lực. Bộ nhớ chỉ giúp ở mức max.
Tương tác giữa bộ nhớ và nỗ lực: Cùng một tệp tự phê bình cải thiện điểm ở max, không có tác động ròng ở xhigh, và gây hại ở chế độ high. Nguyên nhân là ngân sách đầu ra, tức chỉ dẫn do bộ nhớ sinh ra tiêu tốn dung lượng phản hồi.
xhigh có thể thất bại nghiêm trọng khi bật bộ nhớ: Mức giảm 37 điểm ở Tác vụ 2, lượt trượt duy nhất trong benchmark, là do một chỉ dẫn bộ nhớ về cấu trúc phản hồi mà mô hình làm theo sát sao. Kiểu lỗi này đặc thù cho xhigh và cần được cảnh báo trước khi triển khai trong các quy trình agentic sản xuất có yêu cầu đầu ra nghiêm ngặt.
Chất lượng tự phê bình: Chế độ max nhất quán viết các mục bộ nhớ có thể hành động nhất, bao gồm ca biên cụ thể, danh sách kiểm cụ thể, chế độ lỗi rõ ràng. Trong khi phê bình ở high mơ hồ hơn. Nếu bạn dùng bộ nhớ cho học xuyên phiên, max tạo ghi chú hữu ích hơn ngay cả trên các tác vụ không đòi hỏi nó.
high không bộ nhớ là cấu hình hiệu quả chi phí: Đạt 100/100 trên cả ba tác vụ ở mức $0,05–0,07 mỗi tác vụ. Với các tác vụ lập trình thường nhật, ngân sách tư duy lớn hơn không mua được độ tin cậy mà mua thêm phần tự phản tư dài dòng có thể gây hại nếu ngân sách đầu ra không đủ để hấp thụ.
Khuyến nghị thực tế đơn giản: ghép bộ nhớ với mức max, hoặc đừng dùng nó.
Các phần tự phê bình mà bộ nhớ của Claude Opus 4.7 ghi lại là có nội dung, cụ thể và đôi khi thực sự sâu sắc. Nhưng việc bộ nhớ đó có cải thiện hiệu năng hay không phụ thuộc trọng yếu vào mức ngân sách đầu ra mà mô hình có để hành động theo. Ở mức max, bộ nhớ giúp. Ở mức high, cùng bộ nhớ đó gây hại, vì làm theo các chỉ dẫn tích lũy đã tiêu tốn ngân sách cần thiết để hoàn tất tác vụ.
Vì vậy, lời khuyên thực tế là nếu bạn dùng tính năng bộ nhớ của Opus 4.7 cho học xuyên phiên hoặc xuyên tác vụ, hãy ghép nó với mức max. Nếu bạn chạy high hoặc xhigh để tiết kiệm chi phí, hãy tắt bộ nhớ hoặc giữ nó thật ngắn vì các chỉ dẫn nó sinh ra có thể lấn át chính các sản phẩm cần giao.
Học cùng DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
