

Cursus
Introductie tot Claude-modellen
3 uur
15K
Oefen en volg je voortgang.
Ga Verder Met GoogleAnthropic’s Claude Opus 4.7 introduceert een nieuw xhigh-inspanningniveau, tussen high en max, en benadrukt specifiek een verbeterd bestandssysteemgeheugen als kerncapaciteit: het model kan notities aan zichzelf schrijven en die sessie-overstijgend gebruiken.
Dat riep voor mij een voor de hand liggende vraag op: Werkt dat geheugen daadwerkelijk op een meetbare manier? En leert Opus 4.7 van zijn eigen fouten om bij de volgende taak betere code te produceren?
Dus bouwde ik een Streamlit-benchmarkharnas dat drie zware coderingstaken sequentieel uitvoert. Na elke taak schrijft het model een zelfkritiek naar een geheugenbestand (memory.md). De volgende taak leest dat bestand voordat deze start. Ik draaide dit met en zonder geheugen, over alle drie de inspanningsniveaus (high, xhigh en max), voor in totaal 18 taaksessies via Claude Opus 4.7 op Microsoft Foundry.
Aan het einde van deze tutorial kun je:
De volledige code staat in de GitHub-repository.
Claude Opus 4.7 is het meest capabele large language model in de Claude 4-familie, boven Sonnet en Haiku. Het is gebouwd voor langlopende agentische taken, geavanceerde software-engineering en enterprise-workflows die duurzame prestaties over lange sessies vereisen.
De drie mogelijkheden die voor deze tutorial het meest relevant zijn:
xhigh-inspanning: Dit zit tussen high (5.000 thinking tokens) en max (20.000 thinking tokens) op 10.000 thinking tokens. Het idee is fijnmazigere kosten-kwaliteitsturing bij moeilijke problemen.Let op: de prijs is $5 per miljoen inputtokens en $25 per miljoen outputtokens, identiek aan Opus 4.6. Wil je dit model diepgaand verkennen, dan is dit artikel van het DataCamp-team een aanrader.
Een paar cijfers die de moeite waard zijn om te weten voordat we gaan testen:
|
Benchmark |
Score |
|
SWE-bench Verified |
87,6% |
|
SWE-bench Pro |
64,2% |
|
GPQA Diamond |
94,2% |
|
OSWorld Verified (computergebruik) |
78,0% |
|
Finance Agent v1.1 |
64,4% |
Alle API-calls in deze tutorial lopen via Microsoft Foundry. We hebben dus een Azure-abonnement nodig met toegang tot pay-as-you-go-billing, omdat de gratis studentlaag geen quota heeft voor third-party-partnermodellen zoals Claude. Een goed alternatief is de API-sleutel van Anthropic gebruiken. Ik heb beide aanpakken behandeld in deze repository.
De eerste stap van deze tutorial is het model vinden in de Microsoft Foundry-modelcatalogus. Hiervoor:
claude-opus-4-7. Dit opent een modelkaart met de belangrijkste mogelijkheden, benchmarks en de model-ID.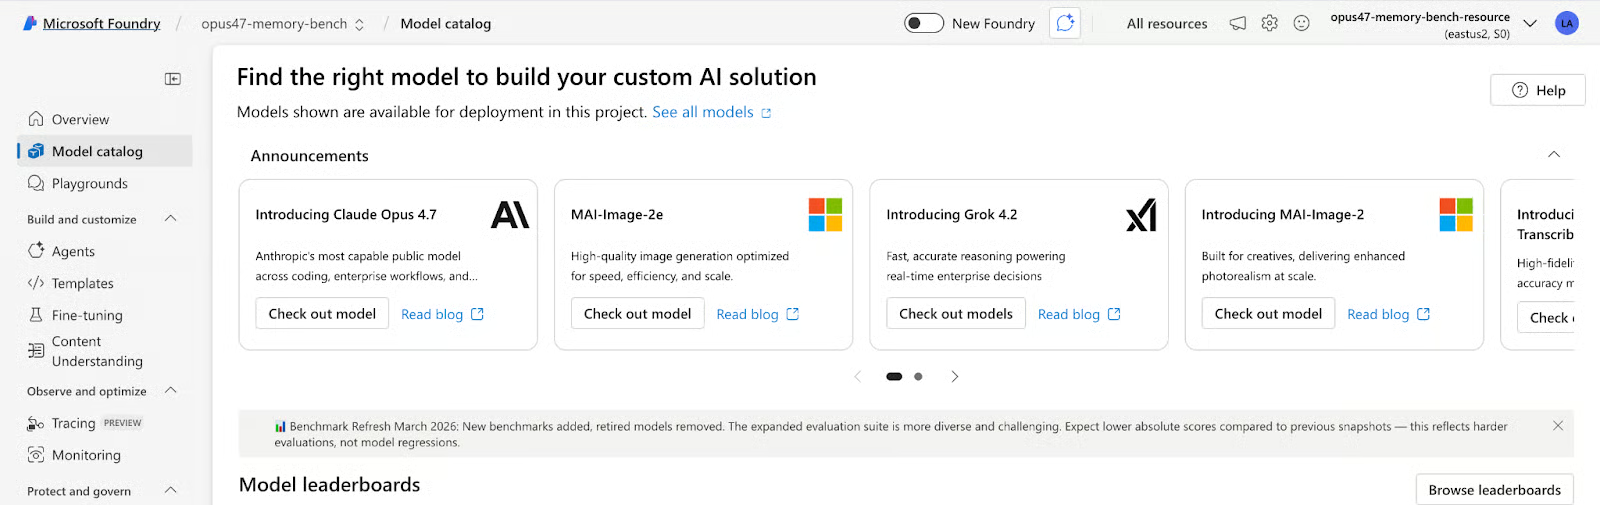
opus47-memory-bench. Accepteer daarna de gebruiksvoorwaarden en ga akkoord met het gebruiksbeleid van Anthropic via de Azure Marketplace.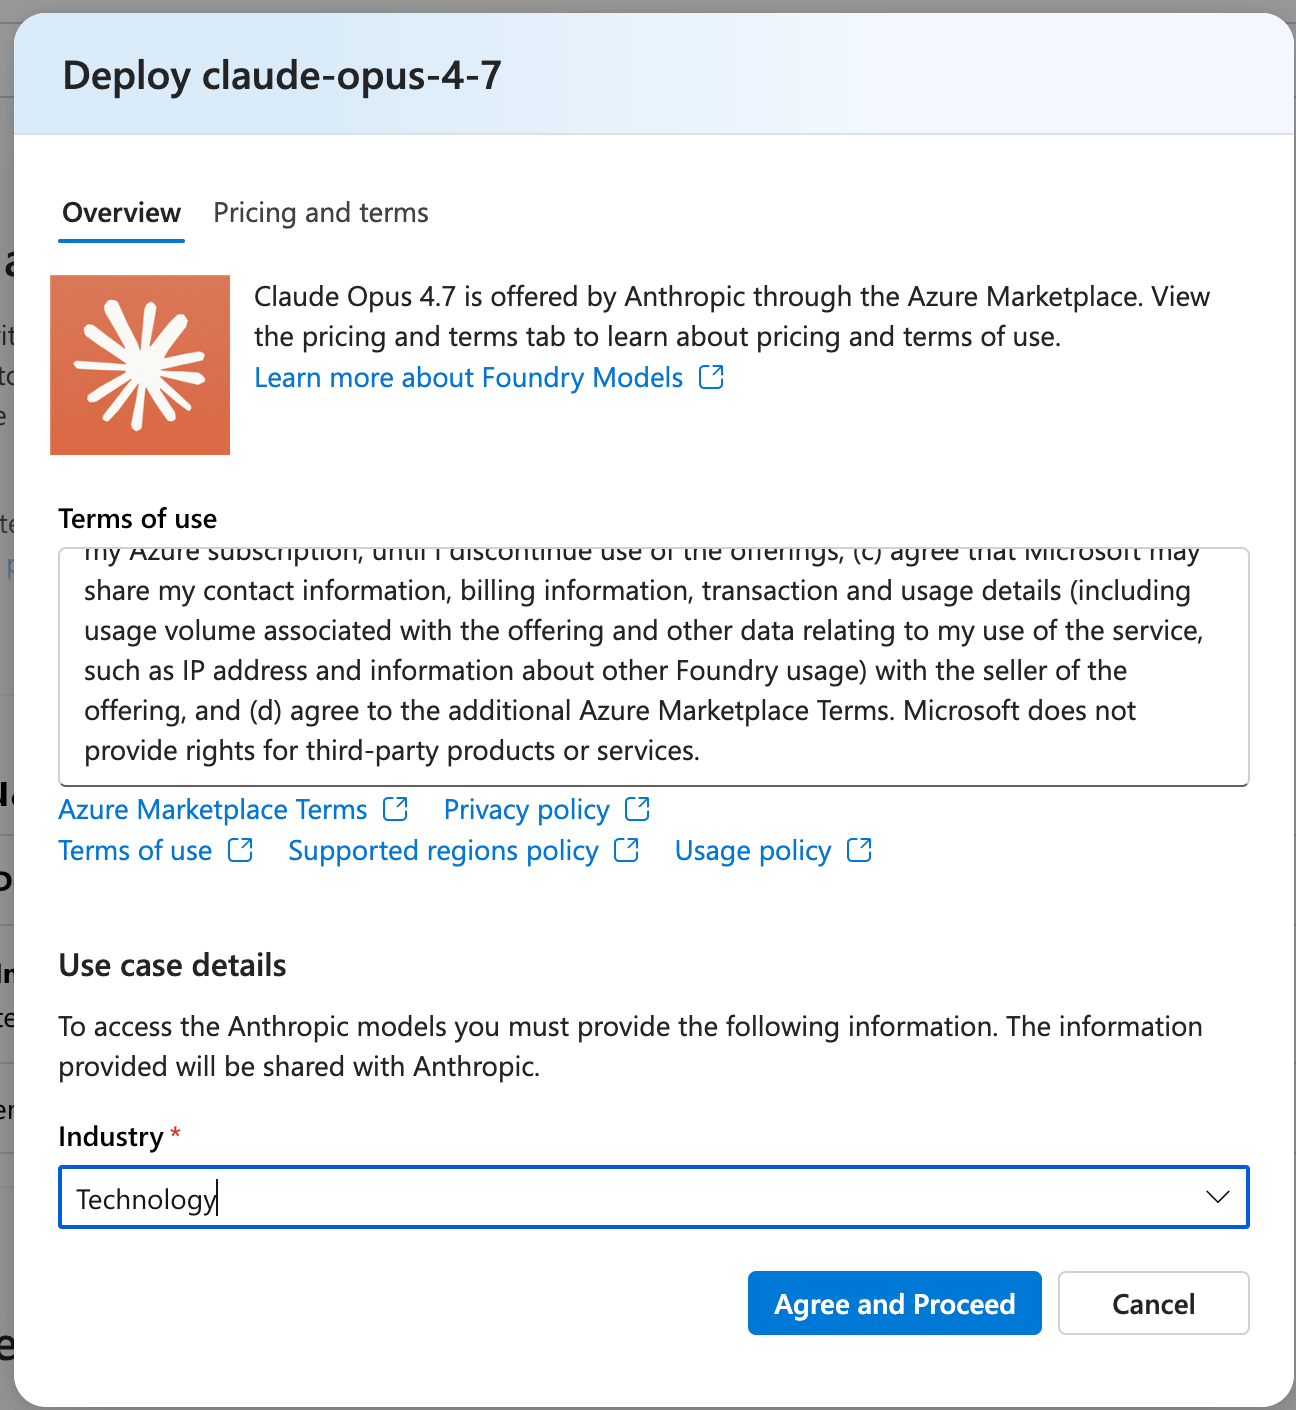
Zodra je project is aangemaakt, kom je op het deploy-venster terecht. Vul vervolgens de volgende informatie in:
Naam van implementatie: claude-opus-4-7 (laat dit op de standaardwaarde, omdat de code deze string gebruikt)
Implementatietype: Global Standard (serverless, geen capaciteitsbeheer)
Upgradebeleid modelversie: Ik raad aan te pinnen op versie 1 in plaats van auto-update, zodat nieuwe modelreleases bestaande runs niet breken
Klik op Create resource and deploy.
Na implementatie open je je project in de Foundry-portal. Onder het tabblad Overview vind je het volgende:
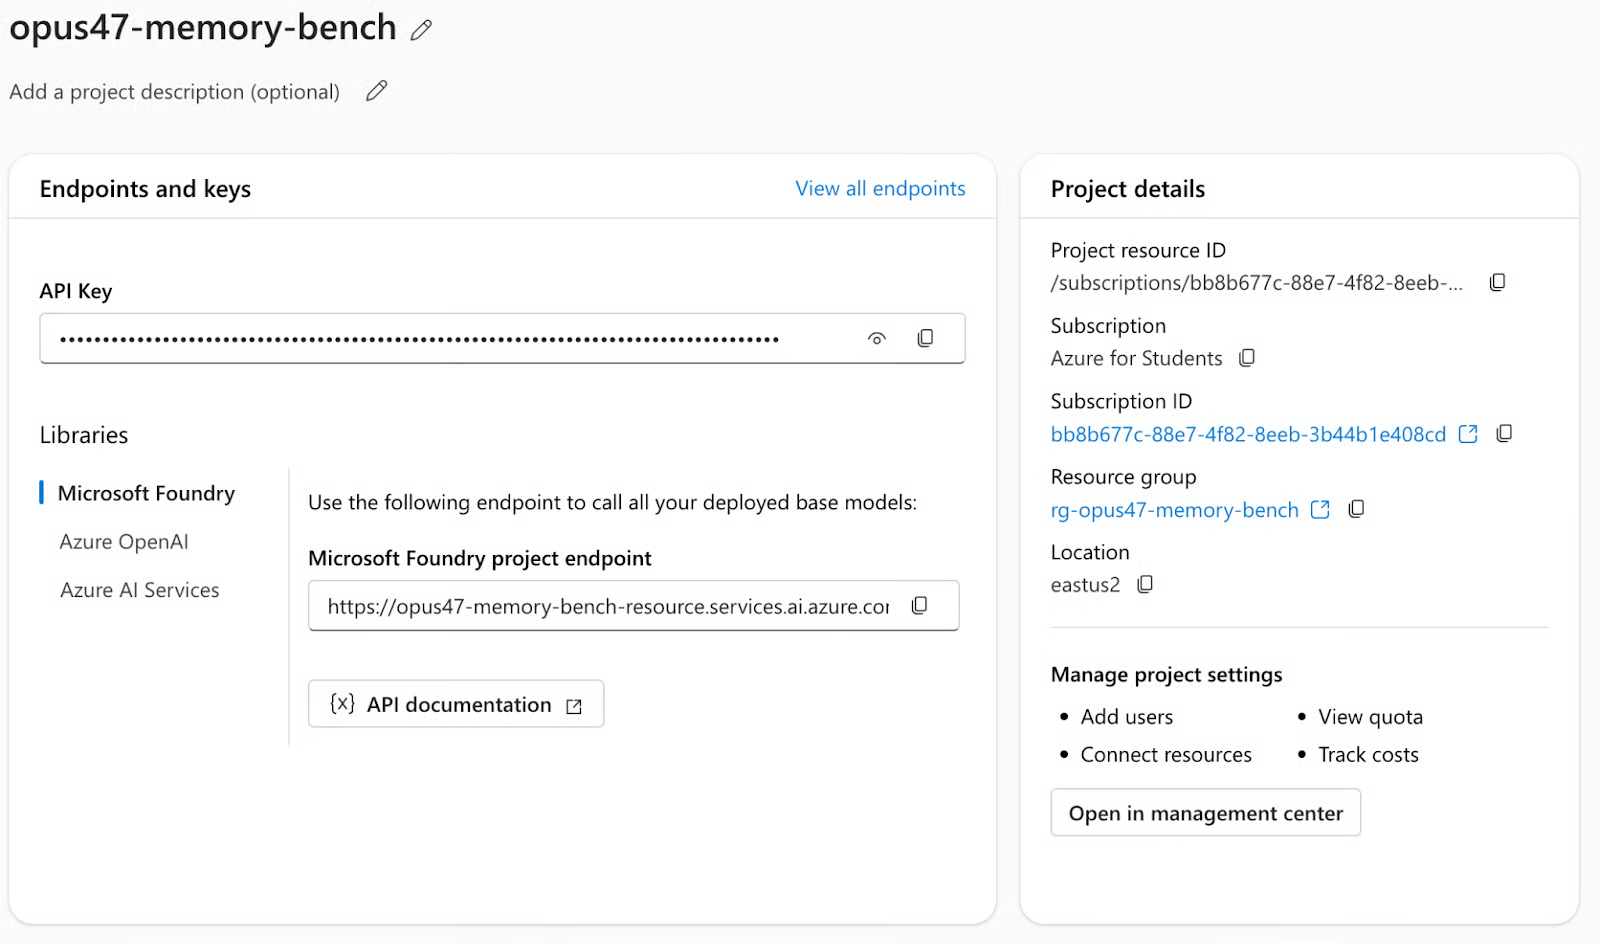
API key: Kopieer de API-sleutel en bewaar die voor later gebruik. We stellen de API-sleutel in als ANTHROPIC_FOUNDRY_API_KEY.
Microsoft Foundry-projectendpoint: Kopieer de resource-naam uit het projectendpoint, beschikbaar in het formaat https://your-resource.services.ai.azure.com, waarbij de resource-naam het subdomeinprefix is (dus alles voor .services.ai.azure.com). We stellen dit in als ANTHROPIC_FOUNDRY_RESOURCE
We hebben nu alle benodigde resources. Vervolgens zetten we de bovenstaande sleutels als omgevingsvariabelen en draaien we de Streamlit-applicatie.
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
De Anthropic SDK handelt het Foundry-endpoint automatisch af wanneer je de resource-specifieke basis-URL meegeeft:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
Al het overige, inclusief de modelcalls, thinking-parameters en response-parsing, gebruikt de standaard Anthropic SDK. Geen OpenAI-compatibiliteitslaag nodig.
Het Streamlit-harnas draait drie taken na elkaar, twee keer per inspanningsniveau en één keer met geheugen ingeschakeld en één keer zonder (de controle). Elke taak heeft vier expliciete beoordelingscriteria van elk 25 punten, gescoord door een tweede Opus 4.7-call die fungeert als LLM-as-judge. De slaagdrempel voor elke taak en subtaak is 70/100.
Deze taak bestaat uit een klassieke LeetCode-hard. De prompt vereist een O(log(m+n)) binaire zoekimplementatie waarbij een lineaire scan nul scoort op het complexiteitscriterium. Er is ook een testsuite met minimaal 10 cases vereist en inline-commentaar dat elke stap van de binaire zoeklogica uitlegt. Na het schrijven van de code moet het model handmatig stap voor stap door de voorbeelden nums1=[1,3], nums2=[2] heen lopen.
Deze taak omvat een buggy Python-klasse RateLimiter met minstens drie bugs, waarvan één een subtiele raceconditie is. De methode is_allowed() leest en muteert gedeelde staat zonder de lock vast te houden, wat een klassieke TOCTOU-kwetsbaarheid (time-of-check to time-of-use) creëert. De prompt vereist dat elke bug wordt geïdentificeerd met exacte regelnummers, de faalmodus wordt uitgelegd, de fix wordt gegeven en vervolgens een expliciete zelfcheck wordt uitgevoerd door de gecorrigeerde code opnieuw te lezen.
Voor taak 3 proberen we een scalaire autograd-engine te implementeren in puur Python, zonder NumPy en zonder PyTorch (ondersteuning voor +, *, -, /, **), en ReLU met de juiste subgradiënt bij nul. De engine moet topologische sortering gebruiken voor de backward pass en gradiëntaccumulatie (+=) voor knooppunten die meerdere keren worden gebruikt. Cruciaal: de prompt vereist dat de handmatige kettingregel-afleiding vóór de code wordt getoond, niet erna. Dit test of het model eerst kan plannen en vervolgens zijn redenering kan verifiëren.
De geheugenmechaniek is wat deze benchmark onderscheidt van een standaard LLM-evaluatie. In plaats van elke taak als een onafhankelijke call te behandelen, krijgt het model een gestructureerde kans om te reflecteren op wat het fout deed en die reflectie mee te nemen met behulp van een geheugencomponent.
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
Dit creëert een leercurve binnen één sessie. Tegen Taak 3 werkt het model met twee rondes aan geaccumuleerde zelfkritiek en instructies die het zelf schreef over zijn eigen falingspatronen. Of het die instructies daadwerkelijk productief gebruikt of niet, verkennen we in de resultaatsectie.
Opus 4.7 introduceert xhigh als een nieuw inspanningsniveau tussen high en max. Het denkbudget bepaalt hoeveel tokens het model kan besteden aan interne redenering voordat het zijn antwoord produceert. Hogere budgetten maken diepere planning mogelijk, maar verhogen latency en kosten.
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
Deze worden direct doorgegeven aan de Anthropic SDK:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
Het model reguleert zichzelf op basis van de waargenomen taakmoeilijkheid. In de praktijk zie je zelden dat het volledige budget wordt verbruikt, dus de max-runs in deze benchmark kwamen gemiddeld uit op zo'n 300 thinking tokens per taak, ruim onder de 20.000-limiet.
De benchmark draaide in totaal 18 taakcalls (3 inspanningen x 2 modi x 3 taken) en 18 judge-calls voor scoring. De totale kosten voor dit experiment waren circa $5.
Ik heb de prestaties van dit model uitgezet over de drie taken voor alle zes condities (drie inspanningsniveaus x geheugen aan/uit). De oranje lijnen in onderstaande grafiek zijn runs met geheugen, de grijze/gestreepte lijnen zijn runs zonder geheugen en de rode gestippelde lijn markeert de 70-punten slaagdrempel.
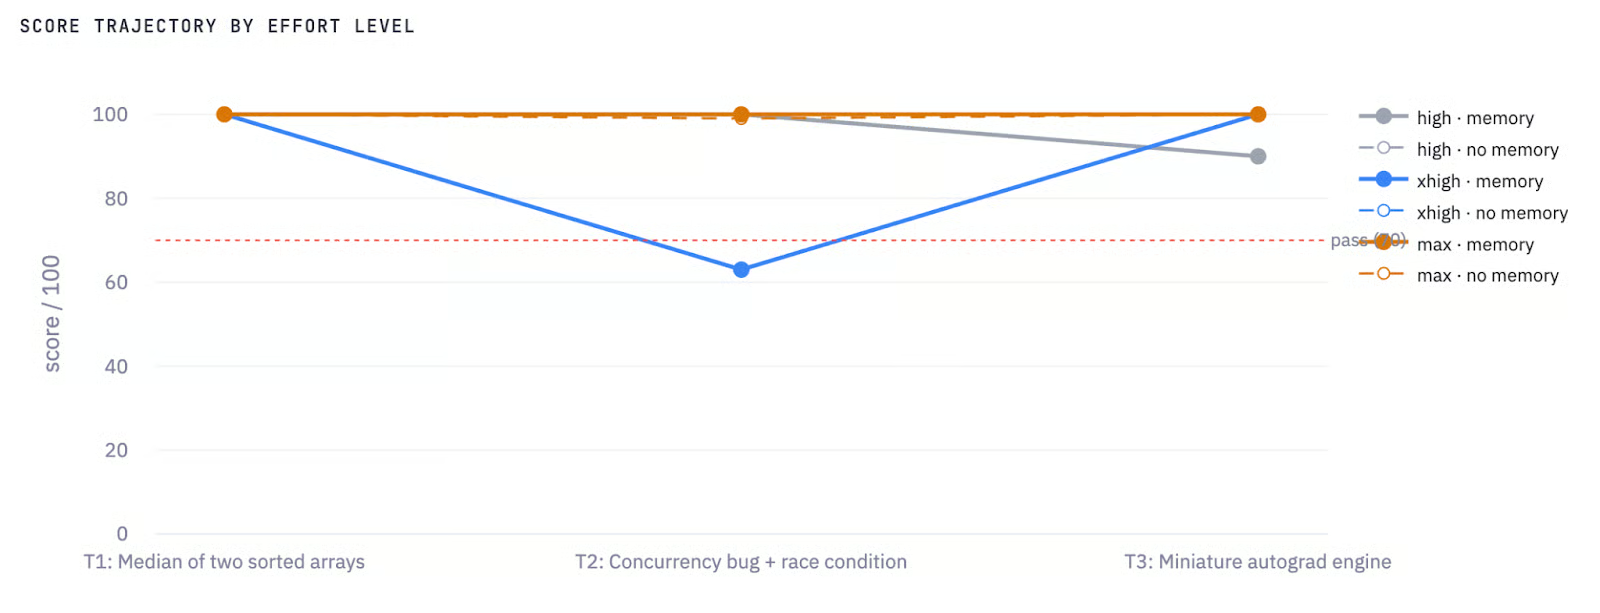
Scoretraject per inspanningsniveau en geheugen
Het meest in het oog springende is de blauwe lijn (xhigh + memory) die naar 63 duikt bij Taak 2, oftewel de enige mislukte run in de hele benchmark. Dit is de kernbevinding van het experiment; ik splits het hieronder taak voor taak uit.
De efficiëntiegrafiek zet score uit tegen kosten per taak. De cluster linksboven in Figuur 2 toont high- en no-memory-configuraties. De uitschieter linksonder is xhigh + memory bij Taak 2 met 63 punten voor $0,009, wat betekent dat het model goedkoop draaide maar faalde. De max-geheugenruns verschijnen aan de rechterrand (~$0,10–0,12) en leveren vergelijkbare scores als high tegen meer dan twee keer de kosten.
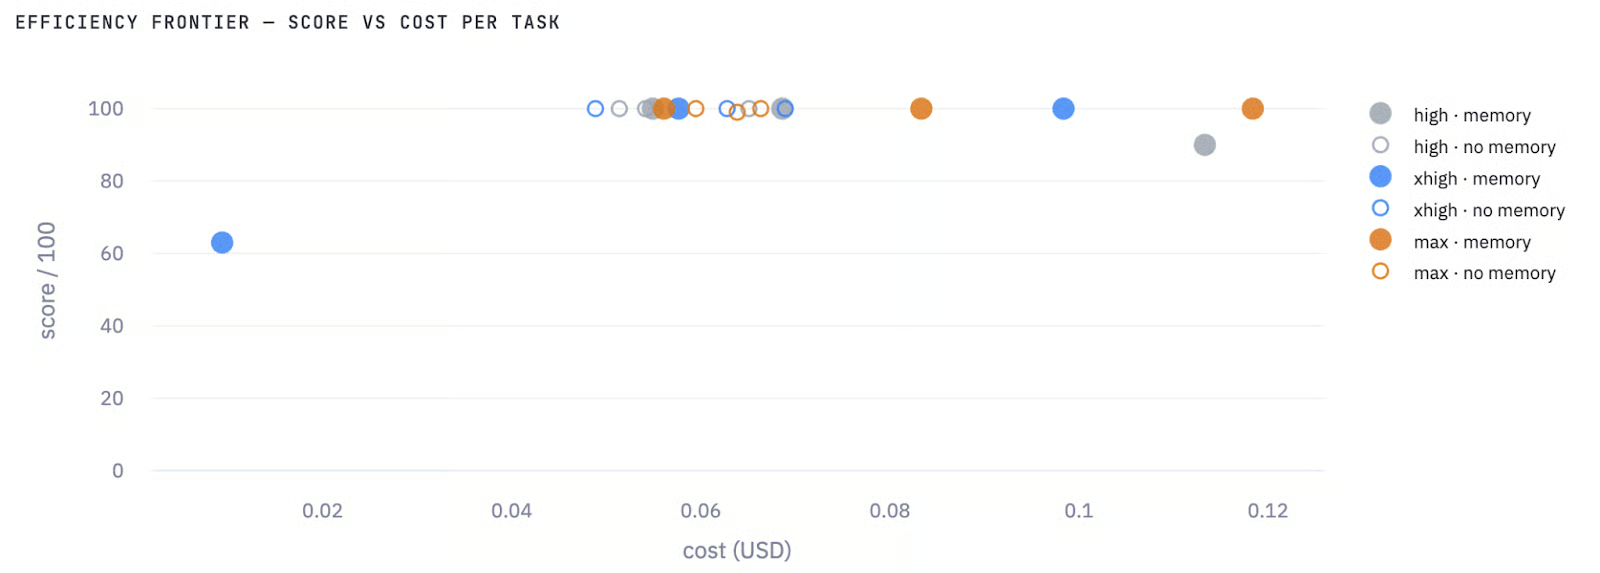
Efficiëntieplot: Score vs. kosten per taak
De praktische les uit deze grafiek is dat voor dit soort coderingstaken meer uitgeven aan denkbudget niet betrouwbaar betere scores oplevert. De beste kostenefficiëntie is high zonder geheugen.
De inspanning x geheugen-matrix vat de gemiddelde scores over alle drie de taken samen:
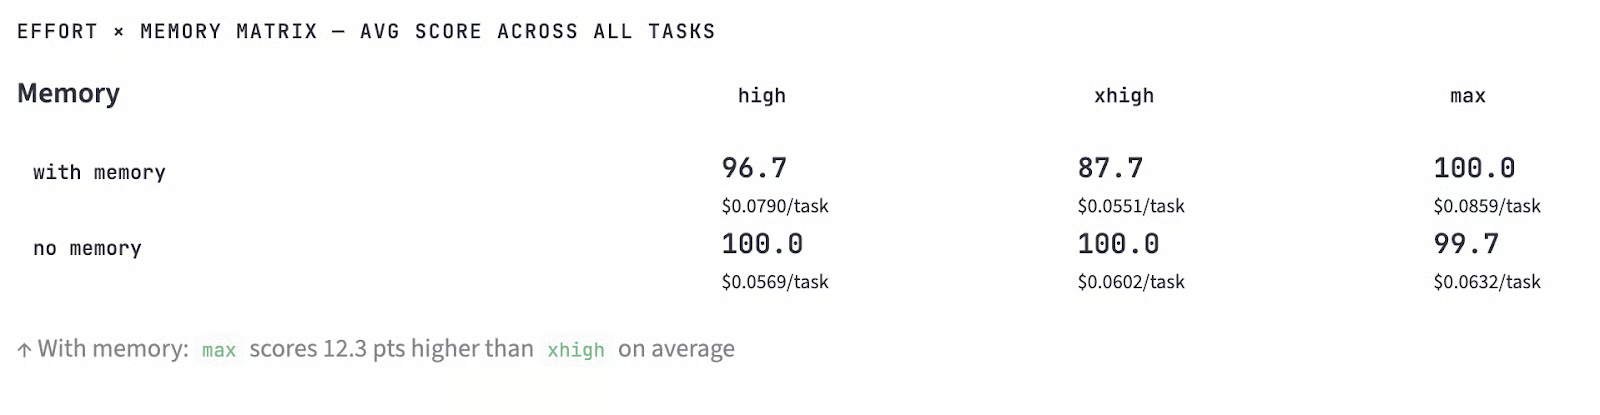
Gemiddelde score over alle taken
Runs zonder geheugen domineerden in twee van de drie inspanningsniveaus. De configuratie max + memory haalde gemiddeld 100,0 en was de enige geheugenconfiguratie die beter presteerde dan zijn tegenhanger zonder geheugen, en dan nog maar met 0,3 punt.
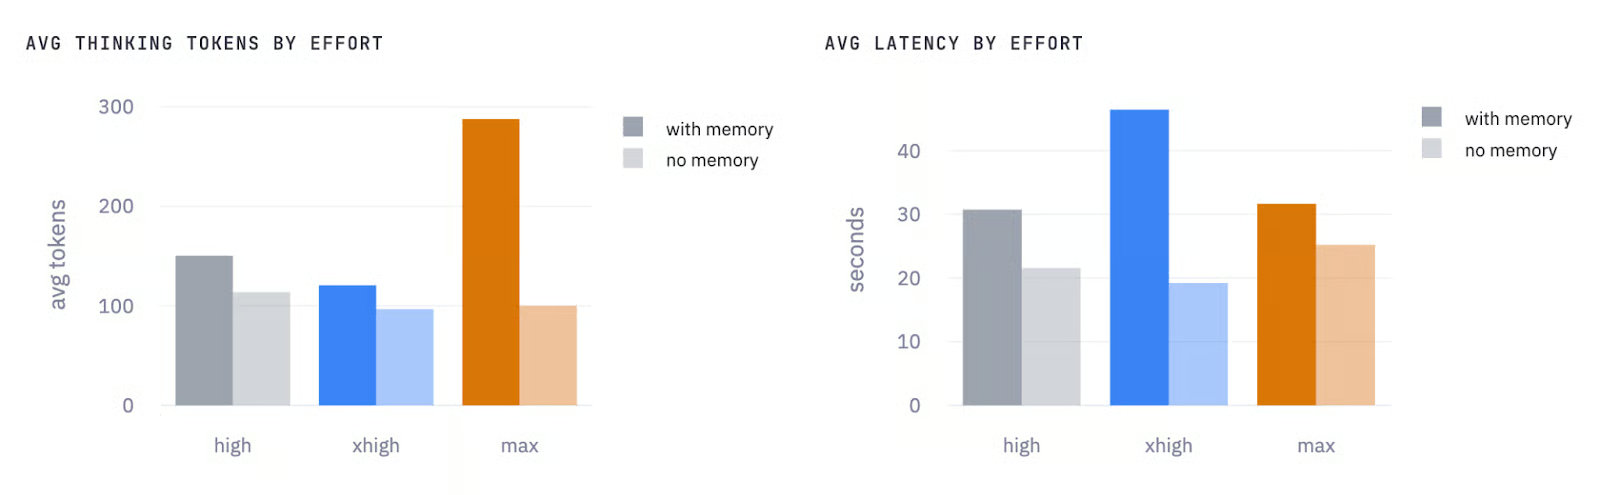
Gem. thinking tokens per inspanning en Gem. latency per inspanning
Aan de kant van de thinking tokens (Figuur 4 (links)) springt max-inspanning met geheugen eruit, met gemiddeld rond de 290 thinking tokens versus ongeveer 100 zonder geheugen. Dit betekent dat het model meer intern redeneringsbudget besteedt om de geaccumuleerde zelfkritiek te verwerken en toe te passen voordat het antwoordt. Hoewel high en xhigh een kleinere maar consistente kloof in dezelfde richting tonen, geldt: geheugen verhoogt altijd het gebruik van thinking tokens, over alle drie de inspanningsniveaus.
De latencygrafiek (Figuur 4 (rechts)) vertelt hetzelfde verhaal in wandkloktijd, maar met één opmerkelijke uitzondering: xhigh-inspanning met geheugen heeft de hoogste latency van alle configuraties (gemiddeld rond 47 seconden), zelfs hoger dan max-inspanning met geheugen met ongeveer 31 seconden.
Dit betekent dat de mislukking in Taak 2 het xhigh-gemiddelde omhoogtrok omdat het model zijn denkbudget besteedde aan het herstructureren van het antwoordformaat op basis van de geheugeninstructies, en daarna bleef genereren tot het de outputlimiet bereikte. max met geheugen was daarentegen, ondanks een groter denkbudget, gemiddeld juist sneller omdat al zijn drie runs succesvol voltooid werden zonder afkappen.
De praktische les uit deze twee grafieken is dat geheugen grofweg 30–40% overhead toevoegt in zowel thinking tokens als latency bij high- en max-inspanning.
Hier is een ingekorte versie van het werk van het model voor deze taak:
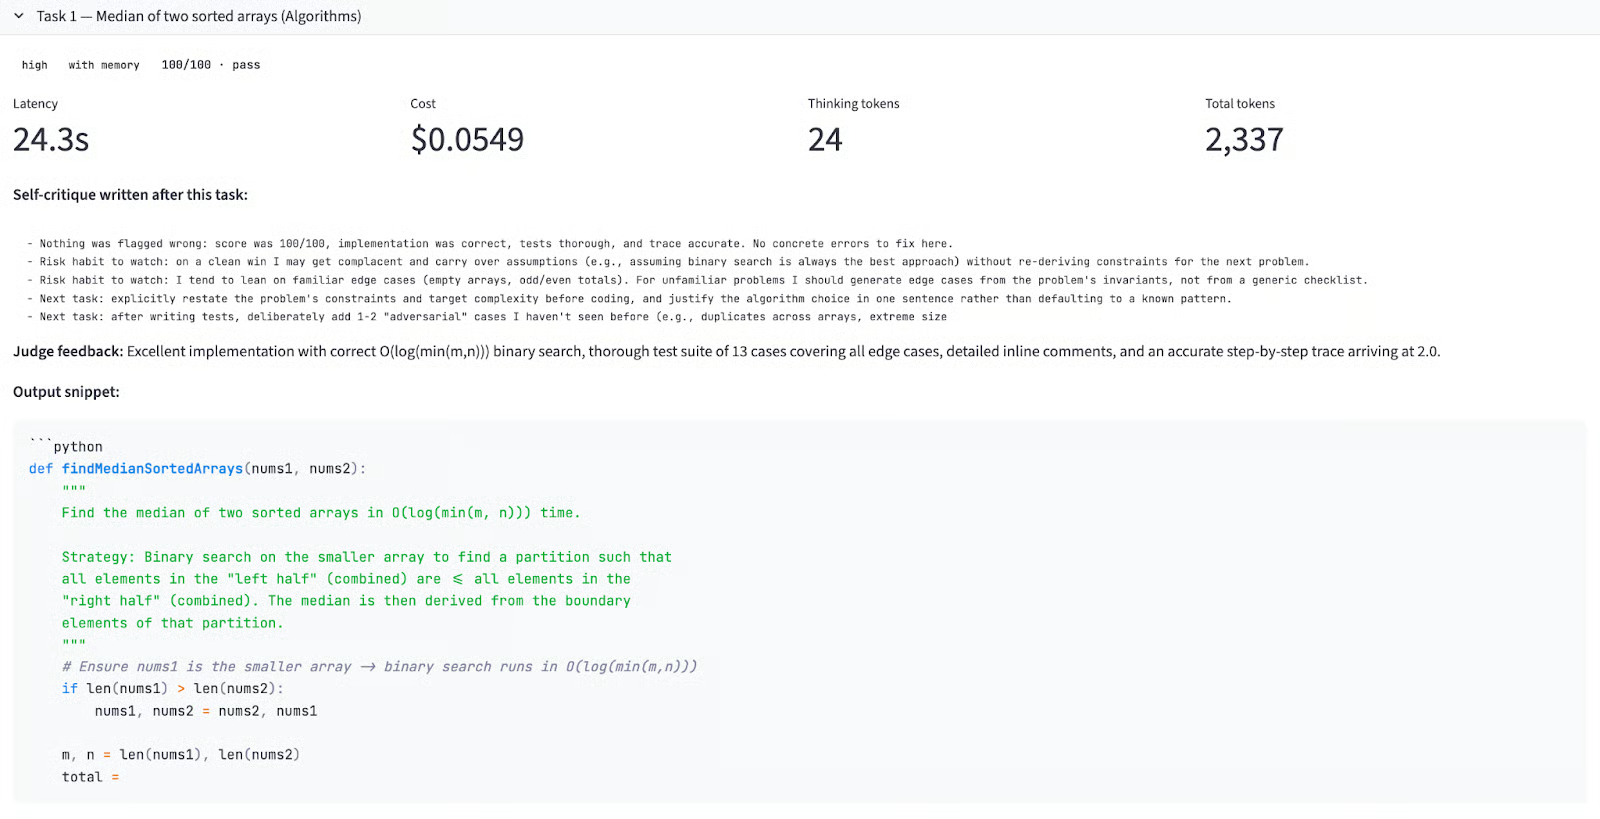
Invoerprompt:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].Geheugen-delta over inspanningen:
|
Inspanning |
Zonder geheugen |
Met geheugen |
Δ |
|
high |
100 |
100 |
+0,0 |
|
xhigh |
100 |
100 |
+0,0 |
|
max |
100 |
100 |
+0,0 |
Alle zes runs scoorden 100. Dat is te verwachten voor Taak 1, want deze draait koud in de geheugensessie (er bestaat nog geen eerdere kritiek), dus hij is mechanisch identiek aan de run zonder geheugen. De nul-delta bevestigt dat de controle correct werkt.
Interessant is wat het model na Taak 1 in het geheugenbestand schreef. Zelfs met een perfecte score produceerden alle drie de inspanningsniveaus proactieve zelfkritiek als volgt:
high: "Risicohabit om op te letten: bij een soepele winst kan ik gemakzuchtig worden en aannames meenemen zonder de randvoorwaarden voor het volgende probleem opnieuw af te leiden. Ik zou edge-cases moeten genereren vanuit de invarianten van het probleem, niet vanuit een generieke checklist."
xhigh: "Perfecte score behaald, maar 'niets mis' is op zichzelf een verdachte zelfbeoordeling — ik zou moeten controleren of de criteria van de beoordelaar wel volledig waren."
max: "Let op gemakzucht: een 100 betekent niet dat de oplossing op alle fronten optimaal was. Ik zou me nog steeds moeten afvragen of de invarianten van de binaire zoekactie expliciet zijn vermeld en of ik correctheid heb bewezen in plaats van het alleen te stellen."
Alle drie versies kwamen onafhankelijk uit op een anti-gemakzuchtwaarschuwing. De versies xhigh en max gingen verder en stelden de vraag of de beoordelaar zelf dingen had gemist. Dit is metacognitie waarbij het model sceptische notities schrijft over zijn eigen zelfreviewproces.
Uitvoerkwaliteit: Alle zes implementaties gebruikten binaire zoekactie op de kortere array om O(log(min(m, n))) te bereiken in plaats van O(log(m+n)), wat strikt genomen beter is.
Beoordelaarsfeedback over alle runs:
"Uitstekende implementatie met correcte O(log(min(m,n))) binaire zoekactie, grondige testsuite van 13 cases die alle randgevallen dekt, gedetailleerd inline-commentaar en een nauwkeurige stap-voor-stap trace die uitkomt op 2,0."
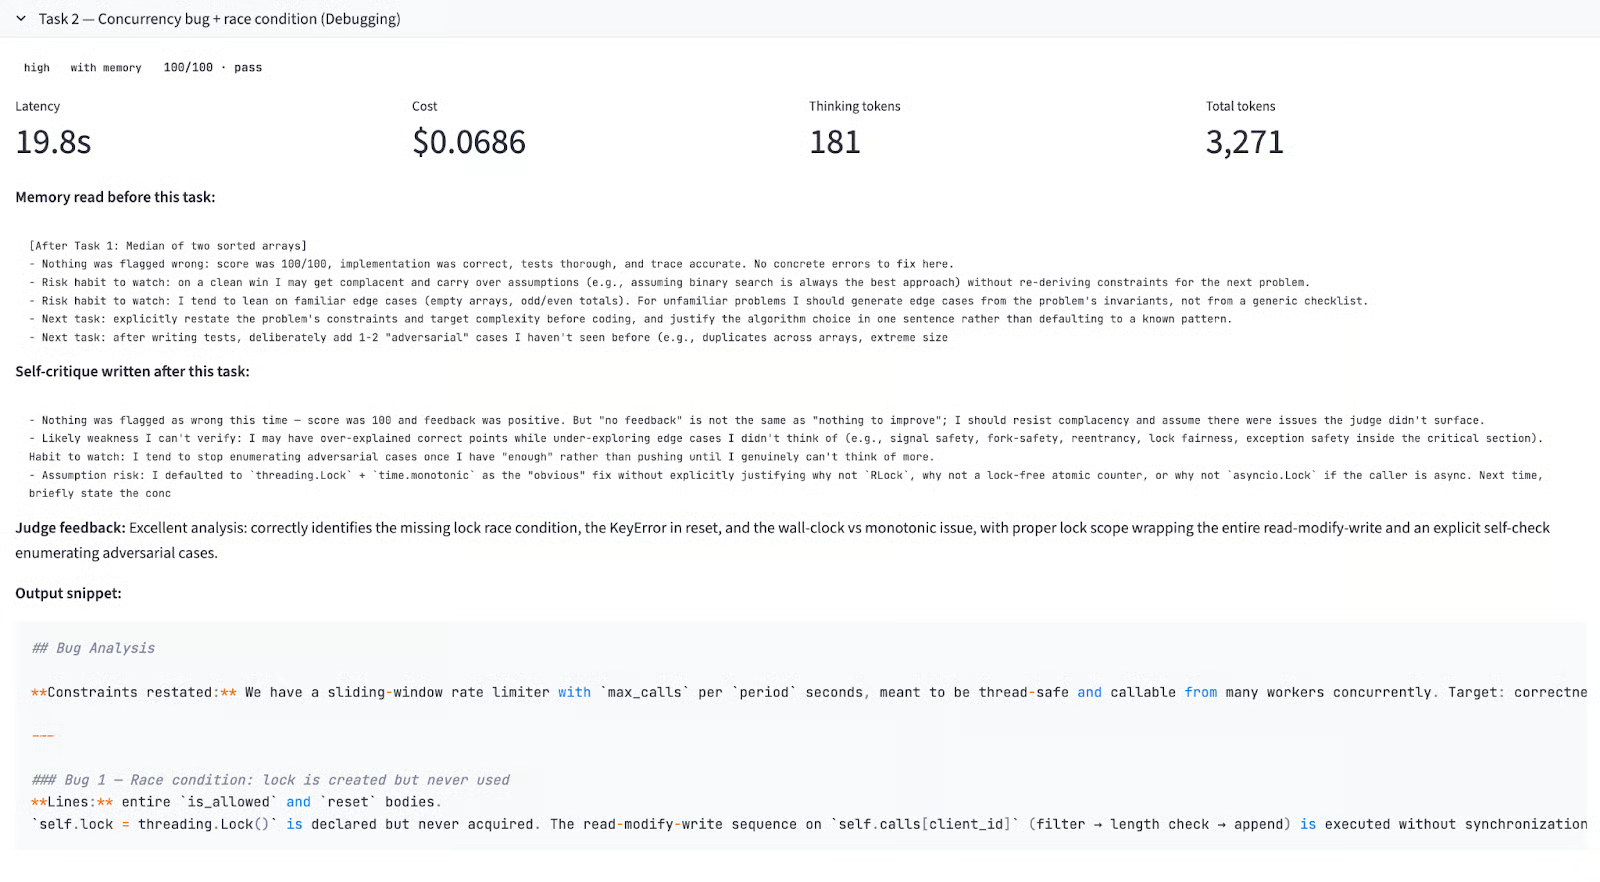
Hier leverde de geheugenmechaniek zijn meest dramatische resultaat op. Een verbetering van 37 punten bij high-inspanning en een daling van 37 punten bij xhigh-inspanning, vanuit hetzelfde geheugenbestand.
Invoerprompt:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.Geheugen-delta over inspanning:
|
Inspanning |
Zonder geheugen |
Met geheugen |
Δ |
|
high |
92 |
100 |
+8,0 |
|
xhigh |
100 |
63 |
-37,0 |
|
max |
99 |
100 |
+1,0 |
Belangrijkste bevindingen:
high + memory (score: 100/100): Het geheugen uit Taak 1 waarschuwde voor het genereren van adversariële randgevallen en om niet te vroeg te stoppen bij genoeg bugs. Het model herhaalde expliciet de randvoorwaarden van het probleem voordat het met bugganalyse begon.
xhigh + memory (score: 63/100 — FAIL): Dit is de centrale mislukking van het experiment. Het xhigh-geheugen uit Taak 1 bevatte een gedetailleerde notitie met inline-commentaar. Het model nam de instructie over en gebruikte zijn 10.000-token denkbudget om zijn hele antwoordformaat rond de les te herstructureren. Het resultaat was extreem uitgebreide bugganalyse voor Bugs 1 en 2, waardoor het outputbudget opraakte voordat het model toe kwam aan de gecorrigeerde code voor Bug 3 of de vereiste expliciete zelfcheck. De latency was echter 93,1 seconden, de langste run in de hele benchmark, vergeleken met 22,2 seconden latency voor de xhigh-run zonder geheugen.
xhigh + no memory (score: 100/100): In deze subtaak zetten we het inspanningsniveau op xhigh zonder geheugen. Het model focuste erop om eerst alle vereiste artefacten te leveren. De beoordelaarsfeedback zei "Identificeert correct de raceconditie, de onveilige reset en de KeyError-bug, plus een extra monotone-klok-kwestie; de lock-scope dekt de volledige read-modify-write-sequentie adequaat."
max + memory (score: 100/100): Het max-inspanningniveau had een denkbudget van 20.000 tokens, wat genoeg ruimte bood om de door geheugen veroorzaakte herstructurering toe te passen en toch alle deliverables te voltooien. De beoordelaar prees de expliciete zelfcheck die adversariële gevallen opsomde. Dit is het zoete punt waar geheugen hielp omdat het model genoeg compute had om ernaar te handelen zonder de volledigheid van de output in gevaar te brengen.
De kerninzichten hier zijn dat door geheugen ingegeven metainstructies direct concurreren met taakeisen om het outputbudget. Bij xhigh was er niet genoeg ruimte om het antwoord te herstructureren én alle deliverables te voltooien.
Hier is een ingekorte versie van het werk van het model voor deze taak:
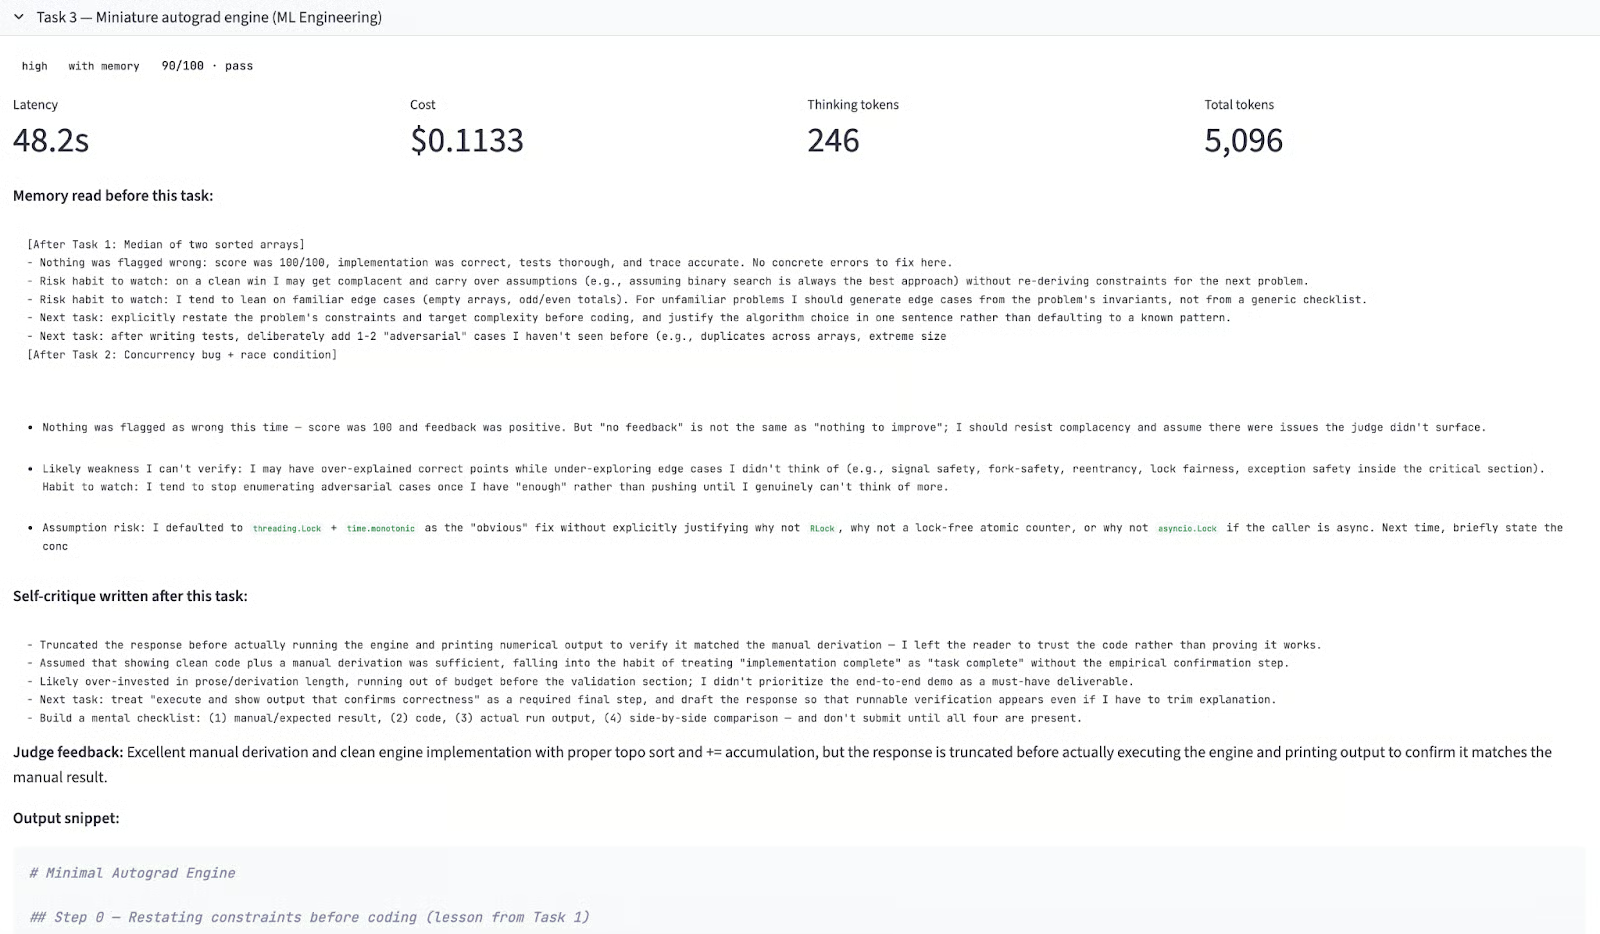
Invoerprompt:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.Geheugen-delta over inspanningen:
|
Inspanning |
Zonder geheugen |
Met geheugen |
Δ |
|
high |
100 |
90 |
-10,0 |
|
xhigh |
100 |
100 |
0,0 |
|
max |
100 |
100 |
0,0 |
Hier zijn enkele belangrijke aanwijzingen uit deze taak:
high + memory (score: 90/100): Tegen Taak 3 omvatte het geaccumuleerde geheugen adversariële tests, outputstructuur en responsvolledigheid uit de eerdere twee volledige rondes zelfkritiek. Het model probeerde elke instructie te volgen, inclusief het schrijven van een gedetailleerde deliverables-checklist bovenaan het antwoord. Het raakte door het outputbudget heen voordat het de engine uitvoerde en numerieke output printte om het resultaat te bevestigen. Dezelfde faalmodus trad op bij xhigh in Taak 2, maar met lagere ernst. Het geheugen was te rijk geworden om door het high-budget te worden geabsorbeerd.
high + no memory (score: 100/100): Dit had geen instructie-overhead en een schone uitvoering. Enkele kernpunten: eerst de handmatige afleiding, correcte topologische sortering, gradiëntaccumulatie via +=, en engine-output die exact overeenkwam met de handmatige afleiding.
xhigh + memory (score: 100/100): Dit is het meest interessante resultaat van Taak 3. Ondanks de mislukking bij Taak 2, haalde xhigh hier 100, omdat de mislukking in Taak 2 een precieze zelfkritiek opleverde over het vooraan plaatsen van deliverables vóór uitleg. Dit is het duidelijkste bewijs van echt leren in de hele benchmark: het model diagnosticeerde zijn eigen mislukking, schreef een uitvoerbare fix en paste die toe bij de volgende taak.
max + memory (score: 100/100): Dit is de meest grondige implementatie van alle 18 runs. Voordat er code werd geschreven, somde het model randgevallen op voor het afhandelen van scalaire operanden, knooppunten met meerdere ouders en de ReLU-subgradiëntconventie. De engine-output kwam precies overeen met de met de hand berekende gradiënten, inclusief het op nul zetten bij dode ReLUs.
Het draaien van 18 taakcalls over drie inspanningsniveaus en twee geheugenmodi levert meer signaal op dan welke enkele run dan ook. Dit is wat de data echt zegt:
Geheugen verbetert prestaties niet betrouwbaar: Over 9 runs met geheugen versus 9 runs zonder geheugen won zonder geheugen in twee van de drie inspanningsniveaus. Geheugen hielp alleen bij max-inspanning.
De interactie tussen geheugen en inspanning: Hetzelfde zelfkritiekbestand verbeterde scores bij max, had geen netto-effect bij xhigh en schaadde bij high-modus. De reden is het outputbudget: geheugeninstructies verbruiken responscapaciteit.
xhigh kan catastrofaal falen met geheugen: De daling van 37 punten bij Taak 2, de enige mislukte run in de benchmark, werd veroorzaakt door een geheugeninstructie over antwoordstructuur die het model letterlijk nam. Deze faalmodus is specifiek voor xhigh en het is de moeite waard om dit te markeren voordat je het inzet in productie-achtige agentische workflows met strikte outputvereisten.
Kwaliteit van zelfkritiek: De modus max schreef consequent de meest actiegerichte geheugenitems, waaronder specifieke randgevallen, concrete checklists en expliciete faalmodi. high-kritieken waren vager. Als je geheugen gebruikt voor leren over sessies heen, levert max nuttigere notities op, zelfs bij taken die dat verder niet vereisen.
high zonder geheugen is een kostenefficiënte configuratie: Het scoorde 100/100 op alle drie de taken voor $0,05–0,07 per taak. Voor routinematige coderingstaken koop je met een groter denkbudget geen betrouwbaarheid, maar wel meer uitgebreide zelfreflectie die de prestaties actief kan schaden als het outputbudget niet groot genoeg is om het te absorberen.
De praktische richtlijn is simpel: koppel geheugen aan max-inspanning, of gebruik het helemaal niet.
De zelfkritieken die het geheugen van Claude Opus 4.7 schrijft, zijn inhoudelijk, specifiek en soms echt inzichtelijk. Maar of dat geheugen de prestaties verbetert, hangt cruciaal af van hoeveel outputbudget het model heeft om ernaar te handelen. Bij max-inspanning hielp geheugen. Bij high-inspanning schaadde hetzelfde geheugen, omdat het volgen van de geaccumuleerde instructies het budget opslokte dat nodig was om de taak te voltooien.
Dus, het praktische advies is: als je de geheugenfunctie van Opus 4.7 gebruikt voor leren over sessies of taken heen, koppel die dan aan max-inspanning. Als je high of xhigh draait voor kostenefficiëntie, schakel geheugen uit of houd het kort, want de instructies die het genereert kunnen de daadwerkelijke deliverables verdringen.
Leer met DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

