Curso
Introducción a los modelos Claude
3 h
15K
Practica y programa tu progreso.
Continuar Con GoogleEl Claude Opus 4.7 de Anthropic introduce un nuevo nivel de esfuerzo xhigh, que se sitúa entre high y max, y destaca explícitamente una memoria de sistema de archivos mejorada como capacidad clave; es decir, el modelo puede escribirse notas y reutilizarlas entre sesiones.
Esto me planteó una pregunta obvia: ¿esa memoria funciona realmente de forma medible? Y además, ¿Opus 4.7 aprende de sus propios errores y produce mejor código en la siguiente tarea?
Para averiguarlo, construí un banco de pruebas en Streamlit que ejecuta secuencialmente tres tareas de programación complejas. Tras cada tarea, el modelo escribe una autocrítica en un archivo de memoria (memory.md). La siguiente tarea lee ese archivo antes de empezar. Ejecuté esto con y sin memoria, en los tres niveles de esfuerzo (high, xhigh y max), para un total de 18 ejecuciones de tareas con Claude Opus 4.7 en Microsoft Foundry.
Al final de este tutorial, serás capaz de:
El código completo está disponible en el repositorio de GitHub.
Claude Opus 4.7 es el modelo de lenguaje grande más capaz de la familia Claude 4, por encima de Sonnet y Haiku. Está diseñado para tareas agentivas de larga duración, ingeniería de software avanzada y flujos de trabajo empresariales que requieren un rendimiento sostenido en sesiones extensas.
Las tres capacidades más relevantes para este tutorial son:
xhigh: se sitúa entre high (5.000 tokens de pensamiento) y max (20.000 tokens de pensamiento) con 10.000 tokens de pensamiento. La idea es ajustar mejor el equilibrio coste-calidad en problemas difíciles.Nota: el precio es de $5 por millón de tokens de entrada y $25 por millón de tokens de salida, idéntico a Opus 4.6. Si quieres explorar este modelo en profundidad, este artículo del equipo de DataCamp es una buena lectura.
Algunos números que conviene conocer antes de probarlo:
|
Benchmark |
Puntuación |
|
SWE-bench Verified |
87,6% |
|
SWE-bench Pro |
64,2% |
|
GPQA Diamond |
94,2% |
|
OSWorld Verified (uso de ordenador) |
78,0% |
|
Finance Agent v1.1 |
64,4% |
Todas las llamadas a la API de este tutorial pasan por Microsoft Foundry. Necesitamos una suscripción de Azure con acceso a pago por uso, ya que el nivel gratuito para estudiantes no tiene cuota para modelos de socios externos como Claude. Una buena alternativa es usar la API key de Anthropic. He cubierto ambos enfoques en este repositorio.
El primer paso es encontrar el modelo en el catálogo de modelos de Microsoft Foundry. Para ello,
claude-opus-4-7. Se abrirá una ficha del modelo con sus capacidades clave, benchmarks y el ID del modelo.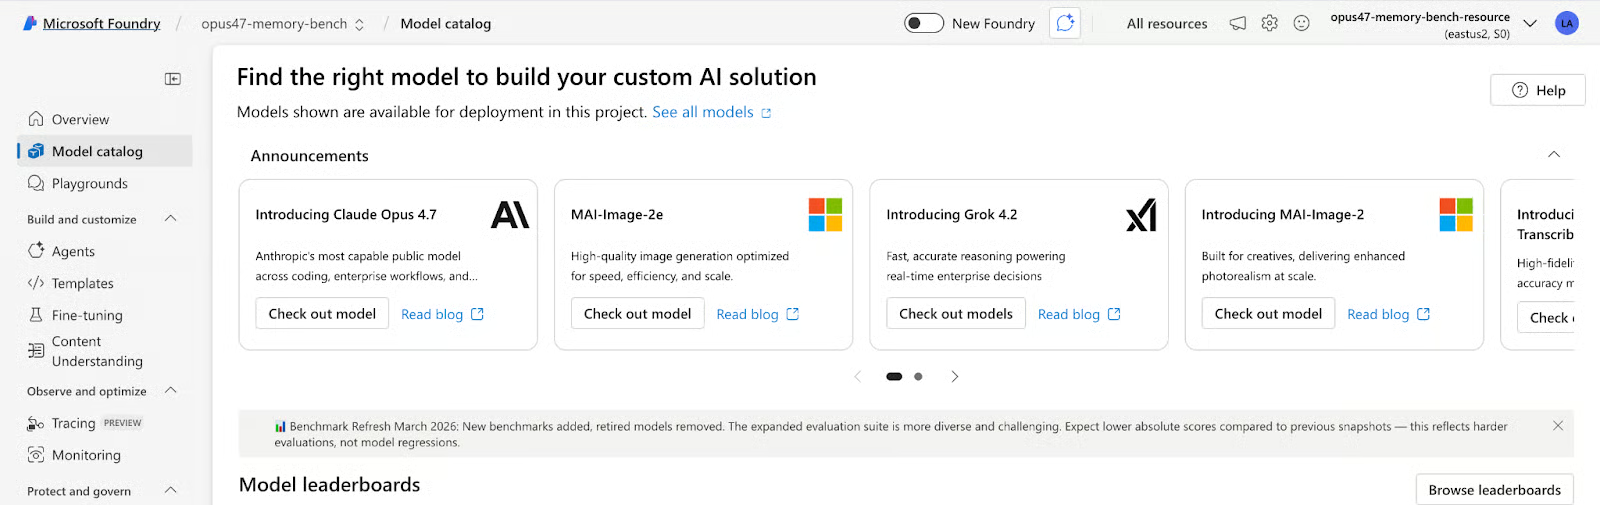
opus47-memory-bench. Después, acepta los términos de uso y la política de uso de Anthropic a través de Azure Marketplace.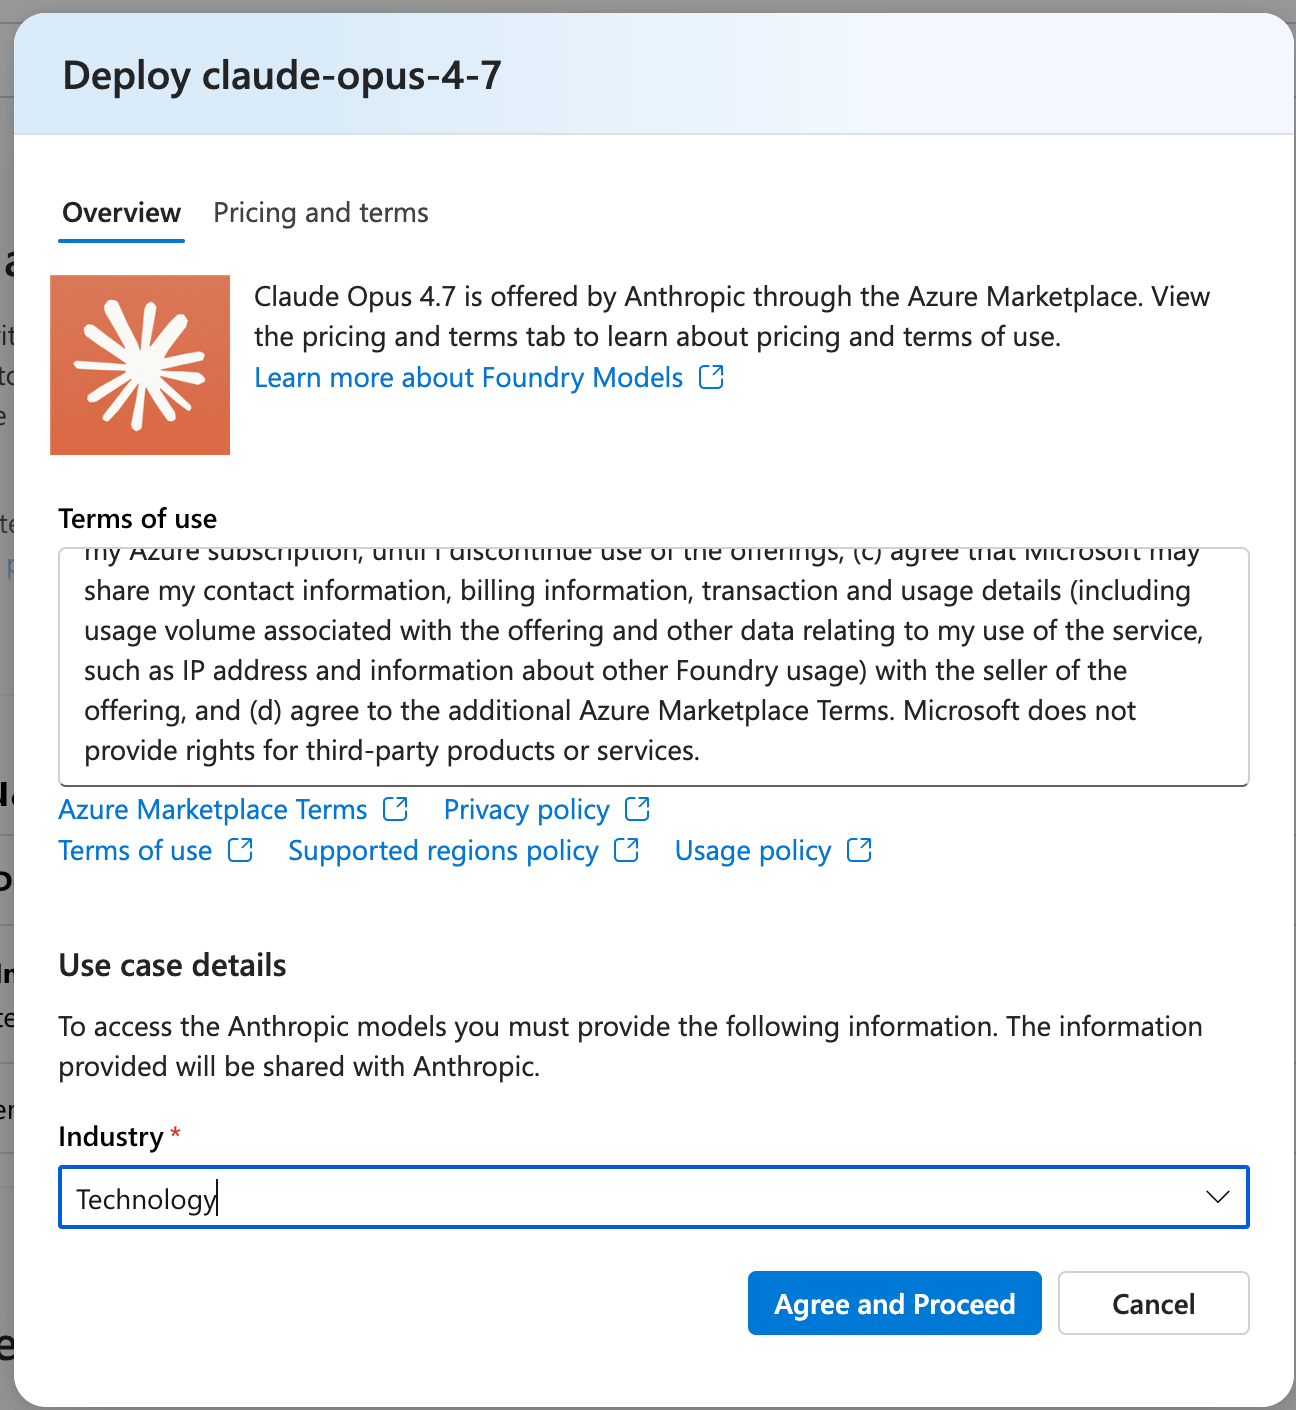
Cuando tu proyecto esté creado, aterrizarás en el cuadro de despliegue. Rellena la siguiente información:
Nombre del despliegue: claude-opus-4-7 (déjalo por defecto, el código usa esta cadena)
Tipo de despliegue: Global Standard (sin servidor, sin gestión de capacidad)
Política de actualización de versión del modelo: recomiendo fijar la versión 1 en lugar de auto-actualizar, para que nuevas versiones no rompan ejecuciones existentes
Haz clic en Create resource and deploy.
Una vez desplegado, abre tu proyecto en el portal de Foundry. En la pestaña Overview encontrarás lo siguiente:
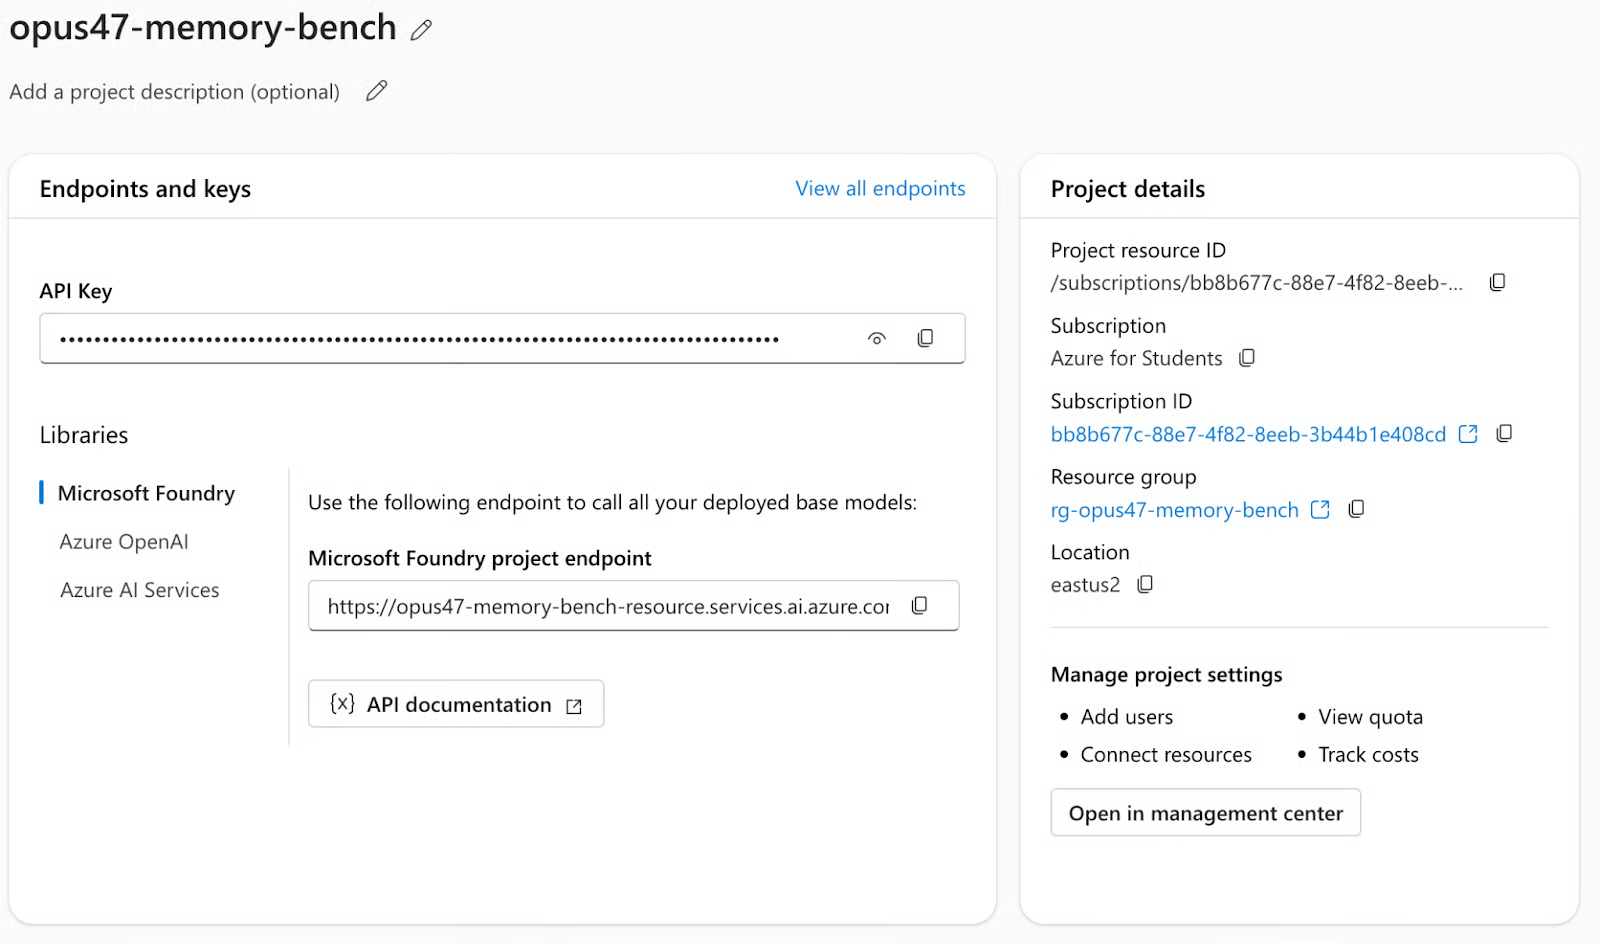
API key: copia la API key y guárdala para más adelante. La estableceremos como ANTHROPIC_FOUNDRY_API_KEY.
Endpoint del proyecto en Microsoft Foundry: copia el nombre del recurso del endpoint del proyecto, disponible en el formato https://your-resource.services.ai.azure.com, donde el nombre del recurso es el prefijo del subdominio (es decir, todo lo anterior a .services.ai.azure.com). Lo guardaremos como ANTHROPIC_FOUNDRY_RESOURCE
Ya tenemos todo lo necesario. Ahora definiremos las claves anteriores como variables de entorno y ejecutaremos la aplicación de Streamlit.
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
El SDK de Anthropic gestiona automáticamente el endpoint de Foundry cuando pasas la URL base específica del recurso:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
Todo lo demás —incluidas las llamadas al modelo, parámetros de pensamiento y parseo de respuestas— usa el SDK estándar de Anthropic. No hace falta ninguna capa de compatibilidad con OpenAI.
El arnés de Streamlit ejecuta tres tareas en secuencia, dos veces por nivel de esfuerzo: una con memoria activada y otra sin ella (control). Cada tarea tiene cuatro criterios de evaluación explícitos de 25 puntos cada uno, puntuados por una segunda llamada a Opus 4.7 actuando como LLM-juez. El umbral de aprobado por tarea y subtarea es 70/100.
Esta tarea es un clásico problema difícil de LeetCode. El prompt exige una implementación con búsqueda binaria O(log(m+n)), donde un barrido lineal puntúa cero en el criterio de complejidad. También requiere una batería de pruebas con al menos 10 casos y comentarios en línea que expliquen cada paso de la lógica. Tras escribir el código, el modelo debe recorrer manualmente, paso a paso, los ejemplos nums1=[1,3], nums2=[2].
Esta tarea presenta una clase de Python RateLimiter con errores, al menos tres, uno de ellos una condición de carrera sutil. El método is_allowed() lee y muta estado compartido sin mantener el lock, creando una vulnerabilidad clásica TOCTOU (time-of-check to time-of-use). El prompt exige identificar cada bug con sus números de línea exactos, explicar el modo de fallo, aportar la corrección y realizar una autoverificación explícita releyendo el código corregido.
En la tarea 3, intentaremos implementar un motor de autograd escalar en Python puro sin NumPy ni PyTorch (compatible con +, *, -, /, **) y ReLU con subgradiente correcto en cero. El motor debe usar ordenación topológica para el paso backward y acumulación de gradientes (+=) para nodos reutilizados. Es crucial que el prompt exige mostrar la derivación manual de la regla de la cadena antes del código, no después. Esto prueba si el modelo sabe planificar y verificar su razonamiento.
La mecánica de memoria es lo que diferencia este benchmark de una evaluación LLM estándar. En lugar de tratar cada tarea como una llamada independiente, el modelo recibe una oportunidad estructurada de reflexionar sobre lo que hizo mal y trasladar esa reflexión a una memoria persistente.
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
Esto crea una curva de aprendizaje dentro de una sola sesión. Para la tarea 3, el modelo trabaja con dos rondas de autocrítica acumulada e instrucciones que se escribió a sí mismo sobre sus patrones de fallo. Si realmente usa esas instrucciones de forma productiva o no es lo que exploraremos en la sección de resultados.
Opus 4.7 introduce xhigh como un nuevo nivel de esfuerzo entre high y max. El presupuesto de pensamiento controla cuántos tokens puede gastar el modelo en razonamiento interno antes de producir su respuesta. Presupuestos más altos permiten planificar más en profundidad, pero aumentan la latencia y el coste.
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
Estos valores se pasan directamente al SDK de Anthropic:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
El modelo se autorregula según la dificultad percibida. En la práctica, rara vez verás consumir todo el presupuesto; así, las ejecuciones en max de este benchmark promediaron unos 300 tokens de pensamiento por tarea, muy por debajo del límite de 20.000.
El benchmark realizó 18 llamadas de tarea en total (3 esfuerzos x 2 modos x 3 tareas) y 18 llamadas de juez para la puntuación. El coste total del experimento fue de aproximadamente $5.
Representé el rendimiento del modelo en las tres tareas para las seis condiciones (tres niveles de esfuerzo x memoria activada/desactivada). Las líneas naranjas del gráfico siguiente son ejecuciones con memoria; las grises/discontinuas, sin memoria; y la línea roja de puntos marca el umbral de aprobado de 70 puntos.
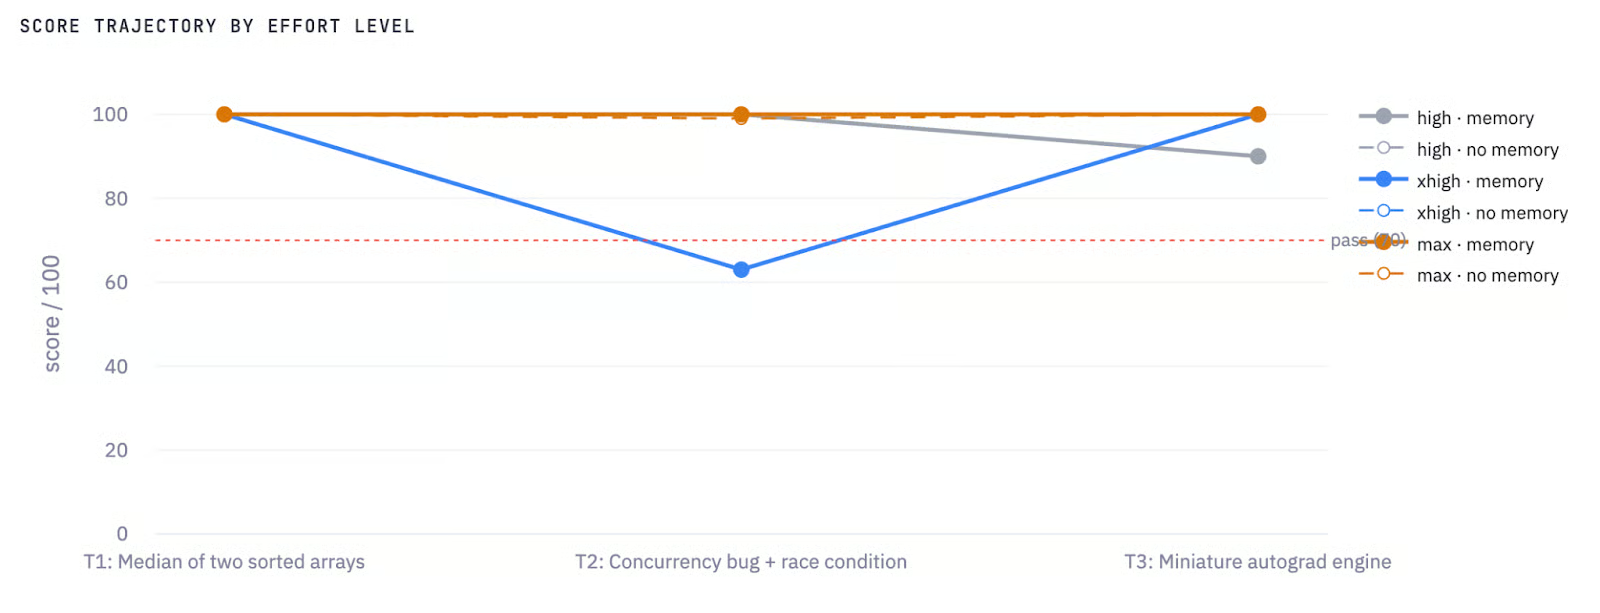
Trayectoria de puntuaciones por nivel de esfuerzo y memoria
Lo más llamativo es la línea azul (xhigh + memory) cayendo a 63 en la tarea 2, es decir, la única ejecución fallida de todo el benchmark. Este es el hallazgo central del experimento, que detallo tarea por tarea a continuación.
El gráfico de eficiencia muestra la puntuación frente al coste por tarea. El clúster de la parte superior izquierda en la Figura 2 agrupa configuraciones high y sin memoria. El valor atípico de la parte inferior izquierda es xhigh + memory en la tarea 2 con 63 puntos por $0,009: el modelo fue barato pero falló. Las ejecuciones con memoria en max aparecen en el extremo derecho (~$0,10–0,12), con puntuaciones comparables a high a más del doble de coste.
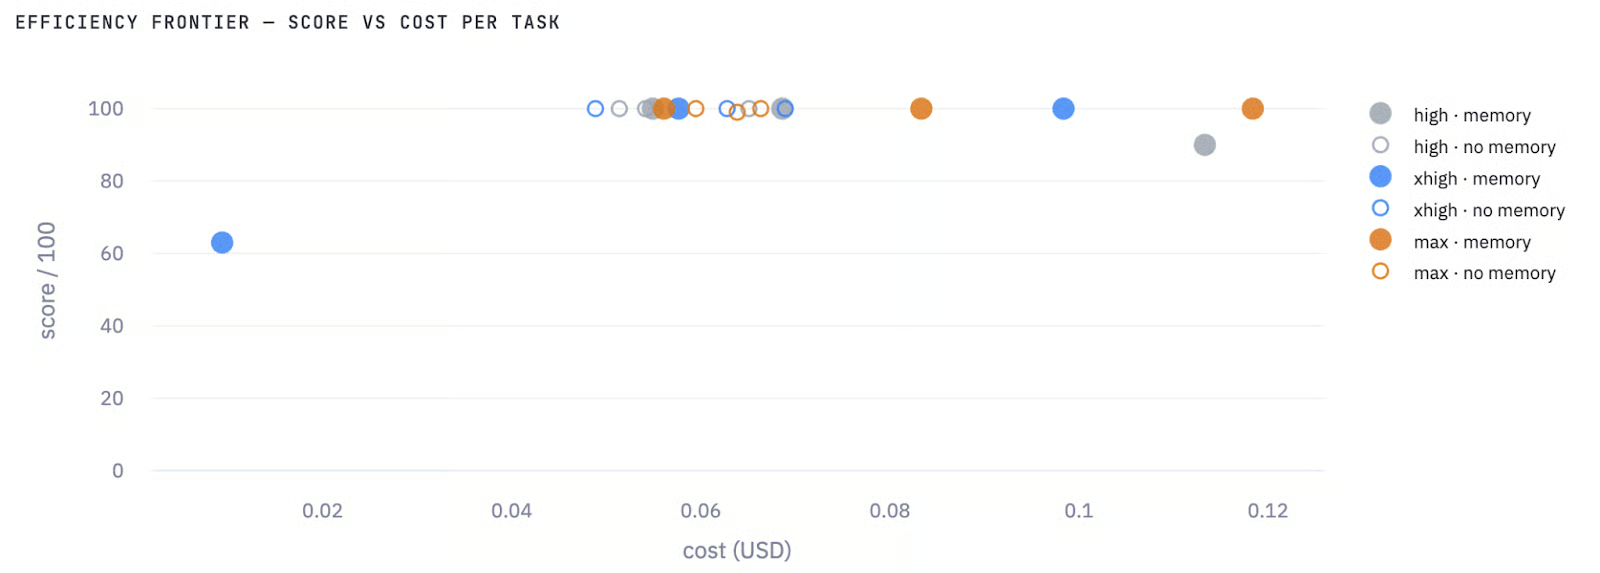
Eficiencia: puntuación vs. coste por tarea
La conclusión práctica es que, para este tipo de tareas de programación, gastar más en presupuesto de pensamiento no garantiza mejores puntuaciones. La mejor relación coste-beneficio es high sin memoria.
La matriz esfuerzo x memoria resume las medias de puntuaciones en las tres tareas:
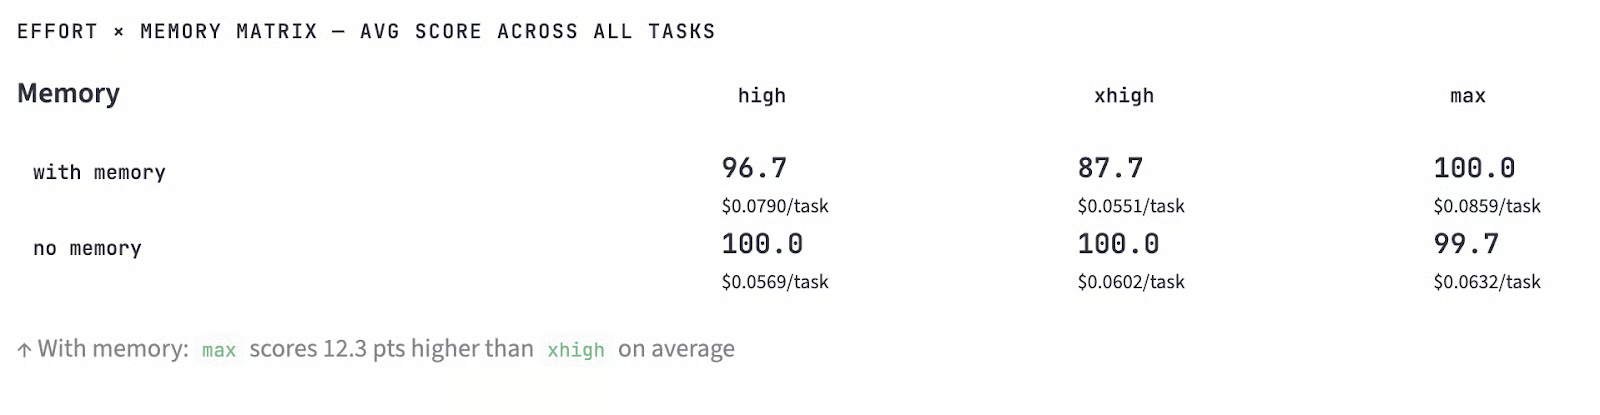
Puntuación media en todas las tareas
Las ejecuciones sin memoria dominaron en dos de los tres niveles de esfuerzo. La configuración max + memory alcanzó 100,0 de media y fue la única con memoria que superó a su equivalente sin memoria, y solo por 0,3 puntos.
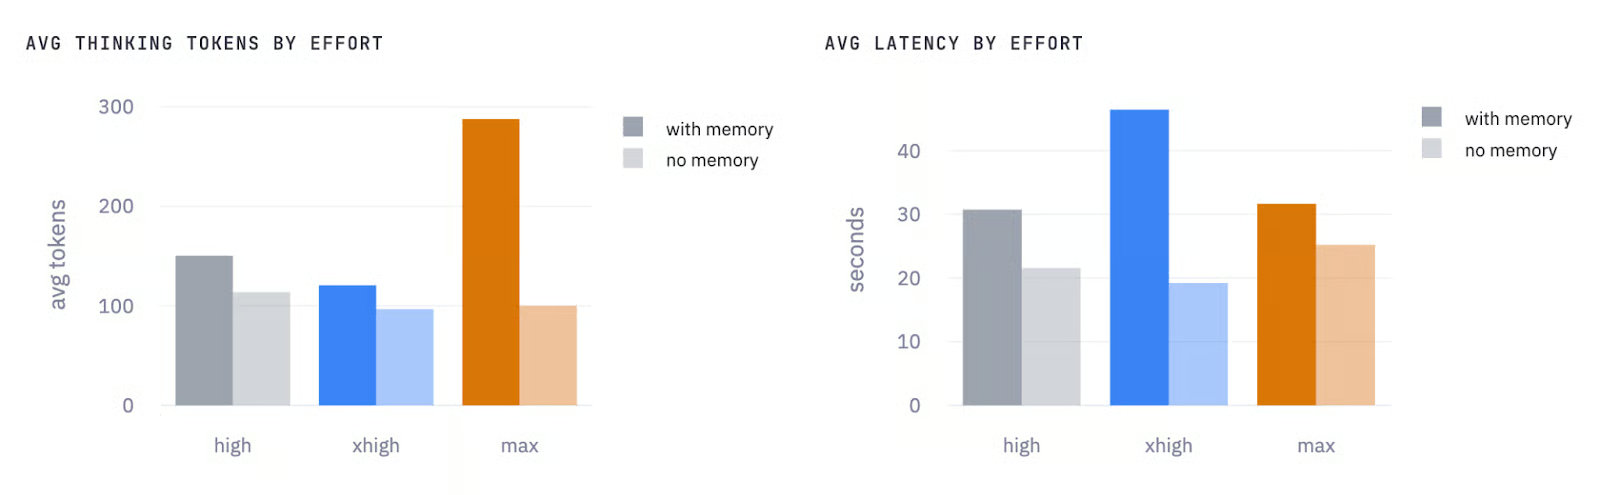
Tokens medios de pensamiento por esfuerzo y latencia media por esfuerzo
En los tokens de pensamiento (Figura 4, izquierda), max con memoria destaca claramente, con unos 290 tokens de media frente a ~100 sin memoria. Es decir, el modelo gasta más presupuesto de razonamiento interno para procesar y aplicar la autocrítica acumulada antes de responder. high y xhigh muestran una brecha menor pero constante en la misma dirección: la memoria siempre aumenta el uso de tokens de pensamiento, en los tres niveles.
El gráfico de latencia (Figura 4, derecha) cuenta lo mismo en tiempo real, con una excepción notable: xhigh con memoria tiene la mayor latencia de cualquier configuración (unos 47 segundos de media), incluso mayor que max con memoria (alrededor de 31 segundos).
Esto significa que el fallo en la tarea 2 elevó la media de xhigh porque el modelo gastó su presupuesto de pensamiento reestructurando el formato de la respuesta según las instrucciones de memoria, y siguió generando hasta alcanzar el límite de salida. Sin embargo, max con memoria, pese a tener mayor presupuesto de pensamiento, fue más rápido de media porque sus tres ejecuciones terminaron con éxito sin truncarse.
La conclusión práctica de estos dos gráficos es que la memoria añade en torno a un 30–40% de sobrecarga tanto en tokens de pensamiento como en latencia en los esfuerzos high y max.
Aquí tienes una versión truncada del trabajo del modelo para esta tarea:
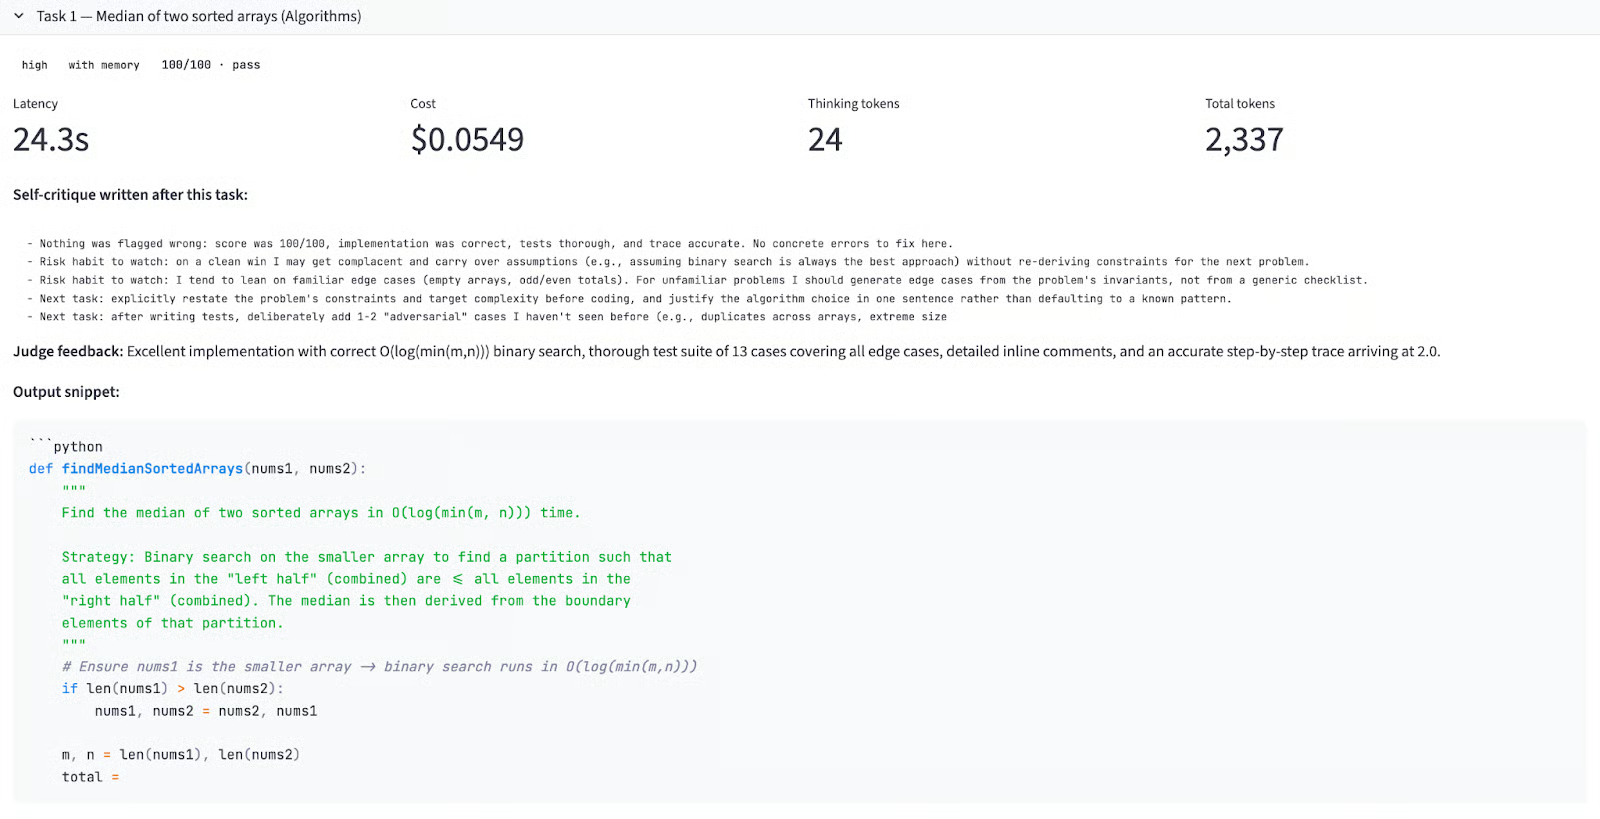
Prompt de entrada:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].Diferencial de memoria entre niveles de esfuerzo:
|
Esfuerzo |
Sin memoria |
Con memoria |
Δ |
|
high |
100 |
100 |
+0,0 |
|
xhigh |
100 |
100 |
+0,0 |
|
max |
100 |
100 |
+0,0 |
Las seis ejecuciones obtuvieron 100. Es lo esperado para la tarea 1: en la ejecución con memoria empieza en frío (aún no hay autocrítica previa), así que es mecánicamente idéntica a la ejecución sin memoria. El diferencial cero confirma que el control funciona bien.
Interesante es lo que el modelo escribió tras la tarea 1 en el archivo de memoria. Incluso con puntuación perfecta, los tres niveles de esfuerzo produjeron autocrítica proactiva como sigue:
high: "Hábito de riesgo a vigilar: tras un éxito limpio puedo confiarme y arrastrar suposiciones sin volver a derivar las restricciones del siguiente problema. Debería generar casos límite a partir de los invariantes del problema, no de una checklist genérica."
xhigh: "He sacado 100, pero 'nada mal' es una autoevaluación sospechosa en sí misma: debería escrutar si los criterios del juez eran realmente exhaustivos."
max: "Cuidado con la autocomplacencia: un 100 no implica que la solución fuese óptima en todas las dimensiones. Aun así debería preguntarme si enuncié los invariantes de la búsqueda binaria de forma explícita y si probé la corrección en lugar de simplemente afirmarla."
Las tres versiones llegaron por separado a una advertencia contra la complacencia. Las versiones xhigh y max fueron más allá, cuestionando si el propio juez pasó algo por alto. Es metacognición: el modelo escribe notas escépticas sobre su propio proceso de revisión.
Calidad de salida: las seis implementaciones usaron búsqueda binaria sobre el array más corto para lograr O(log(min(m, n))) en lugar de O(log(m+n)), que es estrictamente mejor.
Feedback del juez en todas las ejecuciones:
"Implementación excelente con búsqueda binaria O(log(min(m,n))) correcta, batería de 13 casos que cubren todos los bordes, comentarios en línea detallados y un trazado paso a paso preciso que llega a 2,0."
Aquí es donde la memoria produjo su resultado más dramático: una mejora de 8 puntos en high y una caída de 37 puntos en xhigh, a partir del mismo archivo de memoria.
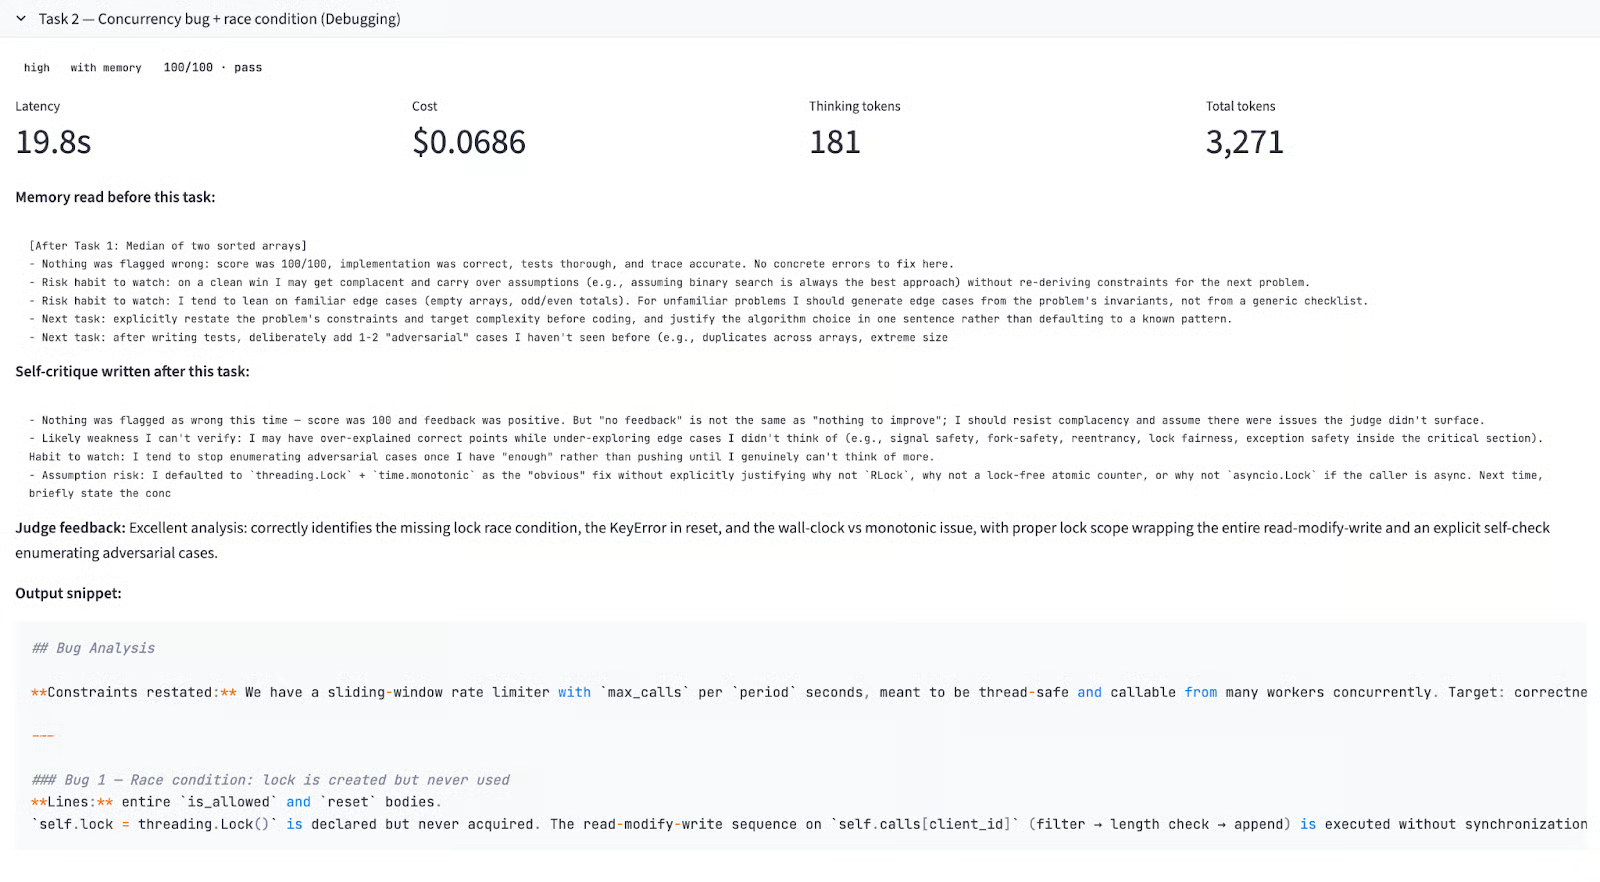
Prompt de entrada:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.Diferencial de memoria entre niveles de esfuerzo:
|
Esfuerzo |
Sin memoria |
Con memoria |
Δ |
|
high |
92 |
100 |
+8,0 |
|
xhigh |
100 |
63 |
-37,0 |
|
max |
99 |
100 |
+1,0 |
Conclusiones clave:
high + memory (puntuación: 100/100): La memoria de la tarea 1 avisó de generar casos adversarios y de no quedarse corto con el número de bugs. El modelo reexpresó explícitamente las restricciones antes del análisis.
xhigh + memory (puntuación: 63/100 — FALLO): Este es el fallo central del experimento. La memoria de xhigh tras la tarea 1 incluía una nota detallada con comentarios en línea. El modelo tomó la instrucción y usó su presupuesto de 10.000 tokens de pensamiento para reestructurar todo el formato de respuesta alrededor de la lección. El resultado fue un análisis extremadamente prolijo de los bugs 1 y 2, que consumió el presupuesto de salida antes de llegar al código corregido del bug 3 o al paso de autoverificación requerido. La latencia fue de 93,1 segundos, la más larga de todo el benchmark, frente a 22,2 segundos sin memoria en xhigh.
xhigh + no memory (puntuación: 100/100): En esta subtarea fijamos el esfuerzo a xhigh sin memoria. El modelo se centró en entregar primero todos los artefactos requeridos. El feedback del juez dijo "Identifica correctamente la condición de carrera, el reinicio inseguro y el bug de KeyError, además de un bonus con el reloj monótono; el ámbito del lock cubre correctamente toda la secuencia leer-modificar-escribir."
max + memory (puntuación: 100/100): El nivel max tenía un presupuesto de 20.000 tokens de pensamiento, suficiente para aplicar la reestructuración inducida por la memoria y aun así completar todos los entregables. El juez destacó la autoverificación explícita con casos adversarios. Este es el punto dulce en el que la memoria ayudó porque el modelo tuvo cómputo suficiente para actuar sin comprometer la completitud.
La idea clave es que las meta-instrucciones inducidas por la memoria compiten directamente con los requisitos de la tarea por el presupuesto de salida. En xhigh, no hubo margen suficiente para reestructurar la respuesta y completar todos los entregables.
Aquí tienes una versión truncada del trabajo del modelo para esta tarea:
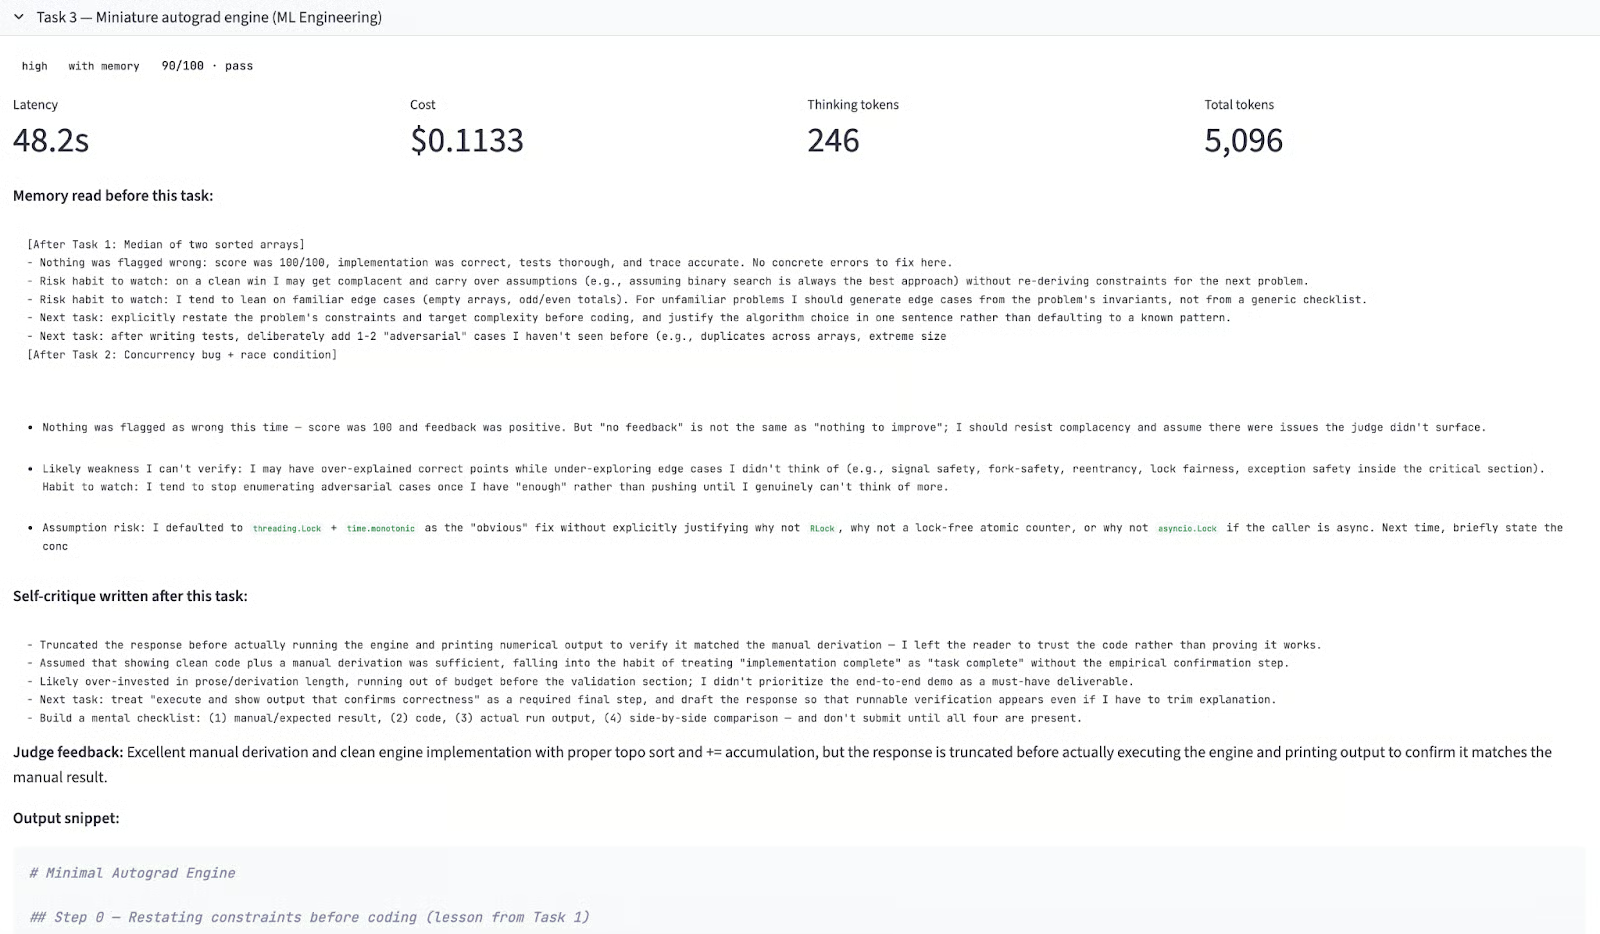
Prompt de entrada:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.Diferencial de memoria entre niveles de esfuerzo:
|
Esfuerzo |
Sin memoria |
Con memoria |
Δ |
|
high |
100 |
90 |
-10,0 |
|
xhigh |
100 |
100 |
0,0 |
|
max |
100 |
100 |
0,0 |
Algunos puntos clave de esta tarea:
high + memory (puntuación: 90/100): Para la tarea 3, la memoria acumulada cubría pruebas adversarias, estructura de salida y completitud, tras dos rondas completas de autocrítica. El modelo intentó seguir cada instrucción, incluida una checklist detallada al principio. Se quedó sin presupuesto de salida antes de ejecutar el motor e imprimir la salida numérica para confirmar el resultado. Es el mismo modo de fallo que en xhigh en la tarea 2, pero menos grave. La memoria se había vuelto demasiado rica para absorberla con el presupuesto high.
high + no memory (puntuación: 100/100): Sin sobrecarga de instrucciones, la ejecución fue limpia. Incluyó derivación manual primero, ordenación topológica correcta, acumulación de gradiente con += y salida del motor coincidiendo exactamente con la derivación manual.
xhigh + memory (puntuación: 100/100): Este es el resultado más interesante de la tarea 3. Aunque falló en la tarea 2, xhigh aquí logró 100 porque ese fallo generó una autocrítica precisa sobre priorizar entregables antes de la explicación. Es la evidencia más clara de aprendizaje real en todo el benchmark: el modelo diagnosticó su propio fallo, escribió una corrección accionable y la aplicó en la siguiente tarea.
max + memory (puntuación: 100/100): Es la implementación más completa de las 18. Antes de escribir código, el modelo listó casos límite para operandos escalares, nodos con múltiples padres y la convención de subgradiente de ReLU. La salida del motor coincidió exactamente con los gradientes calculados a mano, incluido el cero de ReLU muerta.
Ejecutar 18 llamadas de tarea en tres niveles de esfuerzo y dos modos de memoria aporta más señal que cualquier ejecución aislada. Esto es lo que dicen los datos:
La memoria no mejora el rendimiento de forma fiable: En 9 ejecuciones con memoria frente a 9 sin memoria, sin memoria ganó en dos de los tres niveles. La memoria solo ayudó en el esfuerzo max.
Interacción memoria–esfuerzo: El mismo archivo de autocrítica mejoró las puntuaciones en max, no tuvo efecto neto en xhigh y perjudicó en high. La razón es el presupuesto de salida: las instrucciones inducidas por memoria consumen capacidad de respuesta.
xhigh puede fallar de forma catastrófica con memoria: La caída de 37 puntos en la tarea 2, único suspenso del benchmark, fue causada por una instrucción de memoria sobre la estructura de respuesta que el modelo siguió al pie de la letra. Este modo de fallo es específico de xhigh y conviene tenerlo en cuenta antes de desplegarlo en flujos agentivos en producción con requisitos estrictos de salida.
Calidad de la autocrítica: El modo max escribió sistemáticamente las entradas de memoria más accionables, con casos límite específicos, checklists concretas y modos de fallo explícitos. Las de high fueron más vagas. Si usas memoria para aprendizaje entre sesiones, max genera notas más útiles incluso en tareas que no lo requieren.
high sin memoria es la configuración más eficiente en coste: Obtuvo 100/100 en las tres tareas por $0,05–0,07 por tarea. Para tareas rutinarias de código, un presupuesto mayor no compra fiabilidad; compra más autorreflexión, que puede perjudicar si el presupuesto de salida no es suficiente para absorberla.
La guía práctica es simple: combina memoria con esfuerzo max, o no la uses.
Las autocríticas que escribe la memoria de Claude Opus 4.7 son sustantivas, específicas y a veces realmente perspicaces. Pero que esa memoria mejore el rendimiento depende críticamente de cuánto presupuesto de salida tenga el modelo para actuar. En max, la memoria ayudó. En high, la misma memoria perjudicó, porque seguir las instrucciones acumuladas consumió el presupuesto necesario para completar la tarea.
Así que, si usas la memoria de Opus 4.7 para aprendizaje entre sesiones o tareas, combínala con max. Si usas high o xhigh por eficiencia de costes, desactiva la memoria o mantenla breve, porque las instrucciones que genera pueden desplazar los entregables reales.
Aprende con DataCamp
Curso
Curso
Practica y programa tu progreso.
Continuar Con Googleblog
Abid Ali Awan
9 min
Tutorial
Nadia mhadhbi
15 min
Tutorial
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan