Kurs
Einführung in die Claude-Modelle
3 Std.
15K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleAnthropics Claude Opus 4.7 führt eine neue Aufwandsstufe xhigh ein, die zwischen high und max liegt, und hebt insbesondere den verbesserten Dateisystem‑Speicher als Schlüsselkompetenz hervor, d. h. das Modell kann sich selbst Notizen schreiben und sie über Sitzungen hinweg nutzen.
Damit stellte sich für mich eine naheliegende Frage: Funktioniert der Speicher tatsächlich messbar? Und lernt Opus 4.7 aus eigenen Fehlern, um in der nächsten Aufgabe besseren Code zu schreiben?
Also habe ich ein Streamlit‑Benchmark‑Harness gebaut, das drei anspruchsvolle Coding‑Aufgaben nacheinander ausführt. Nach jeder Aufgabe schreibt das Modell eine Selbstkritik in eine Speicherdatei (memory.md). Die nächste Aufgabe liest diese Datei vor dem Start ein. Ich habe das mit und ohne Speicher über alle drei Aufwandsstufen (high, xhigh und max) ausgeführt – insgesamt 18 Durchläufe mit Claude Opus 4.7 auf Microsoft Foundry.
Am Ende dieses Tutorials kannst du:
Den vollständigen Code findest du im GitHub‑Repository.
Claude Opus 4.7 ist das leistungsfähigste Sprachmodell der Claude‑4‑Familie, über Sonnet und Haiku. Es ist auf lang laufende, agentische Aufgaben, fortgeschrittene Softwareentwicklung und Enterprise‑Workflows ausgelegt, die über lange Sitzungen hinweg konstante Leistung erfordern.
Für dieses Tutorial sind drei Fähigkeiten besonders relevant:
xhigh‑Aufwandsstufe: Diese liegt zwischen high (5.000 Thinking‑Tokens) und max (20.000 Thinking‑Tokens) bei 10.000 Thinking‑Tokens. Die Idee: feinere Kosten‑Qualitäts‑Steuerung bei harten Problemen.Hinweis: Die Preise liegen bei 5 $ pro Million Eingabetokens und 25 $ pro Million Ausgabetokens, identisch zu Opus 4.6. Wenn du tiefer einsteigen willst, ist dieser Artikel vom DataCamp‑Team lesenswert.
Ein paar Zahlen vorab:
|
Benchmark |
Score |
|
SWE-bench Verified |
87,6% |
|
SWE-bench Pro |
64,2% |
|
GPQA Diamond |
94,2% |
|
OSWorld Verified (Computerbenutzung) |
78,0% |
|
Finance Agent v1.1 |
64,4% |
Alle API‑Aufrufe in diesem Tutorial laufen über Microsoft Foundry. Du brauchst also ein Azure‑Abonnement mit Pay‑as‑you‑go‑Abrechnung, denn der kostenlose Studierenden‑Tarif hat kein Kontingent für Partnermodelle wie Claude. Eine gute Alternative ist der API‑Schlüssel von Anthropic. Beide Wege habe ich in diesem Repository beschrieben.
Zuerst suchst du das Modell im Microsoft Foundry Model Catalog. Dafür:
claude-opus-4-7. Es öffnet sich eine Modellkarte mit Kernfunktionen, Benchmarks und der Modell‑ID.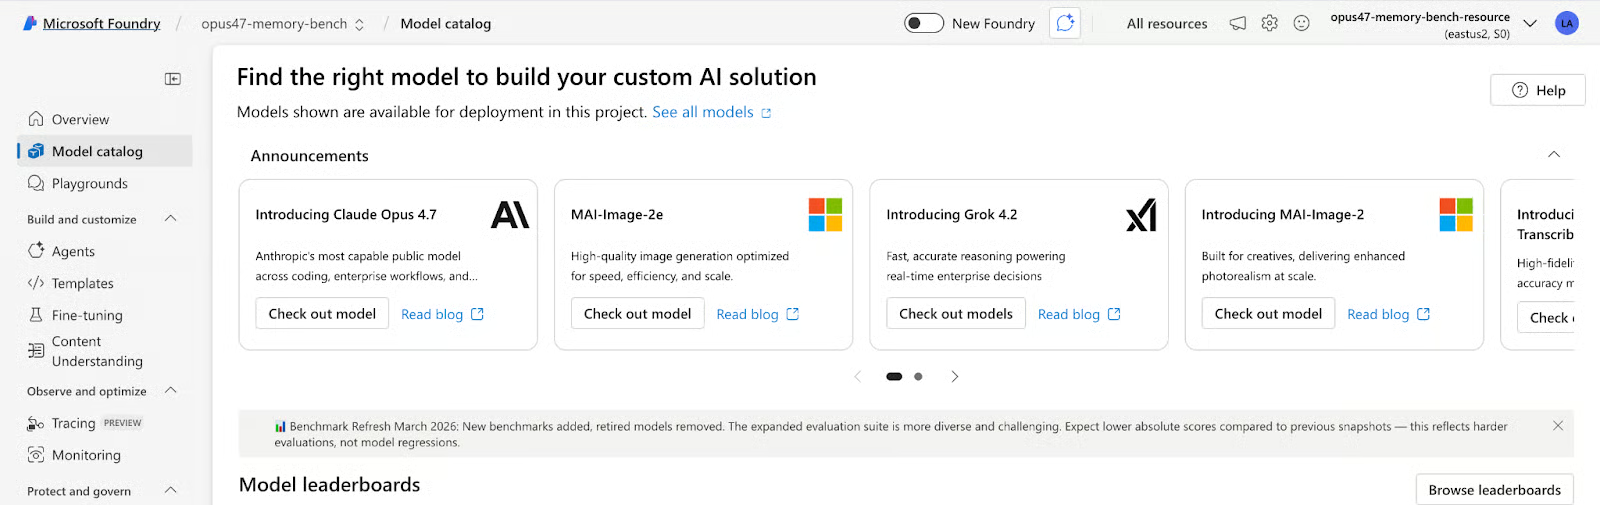
opus47-memory-bench. Akzeptiere die Nutzungsbedingungen und stimme den Richtlinien von Anthropic im Azure Marketplace zu.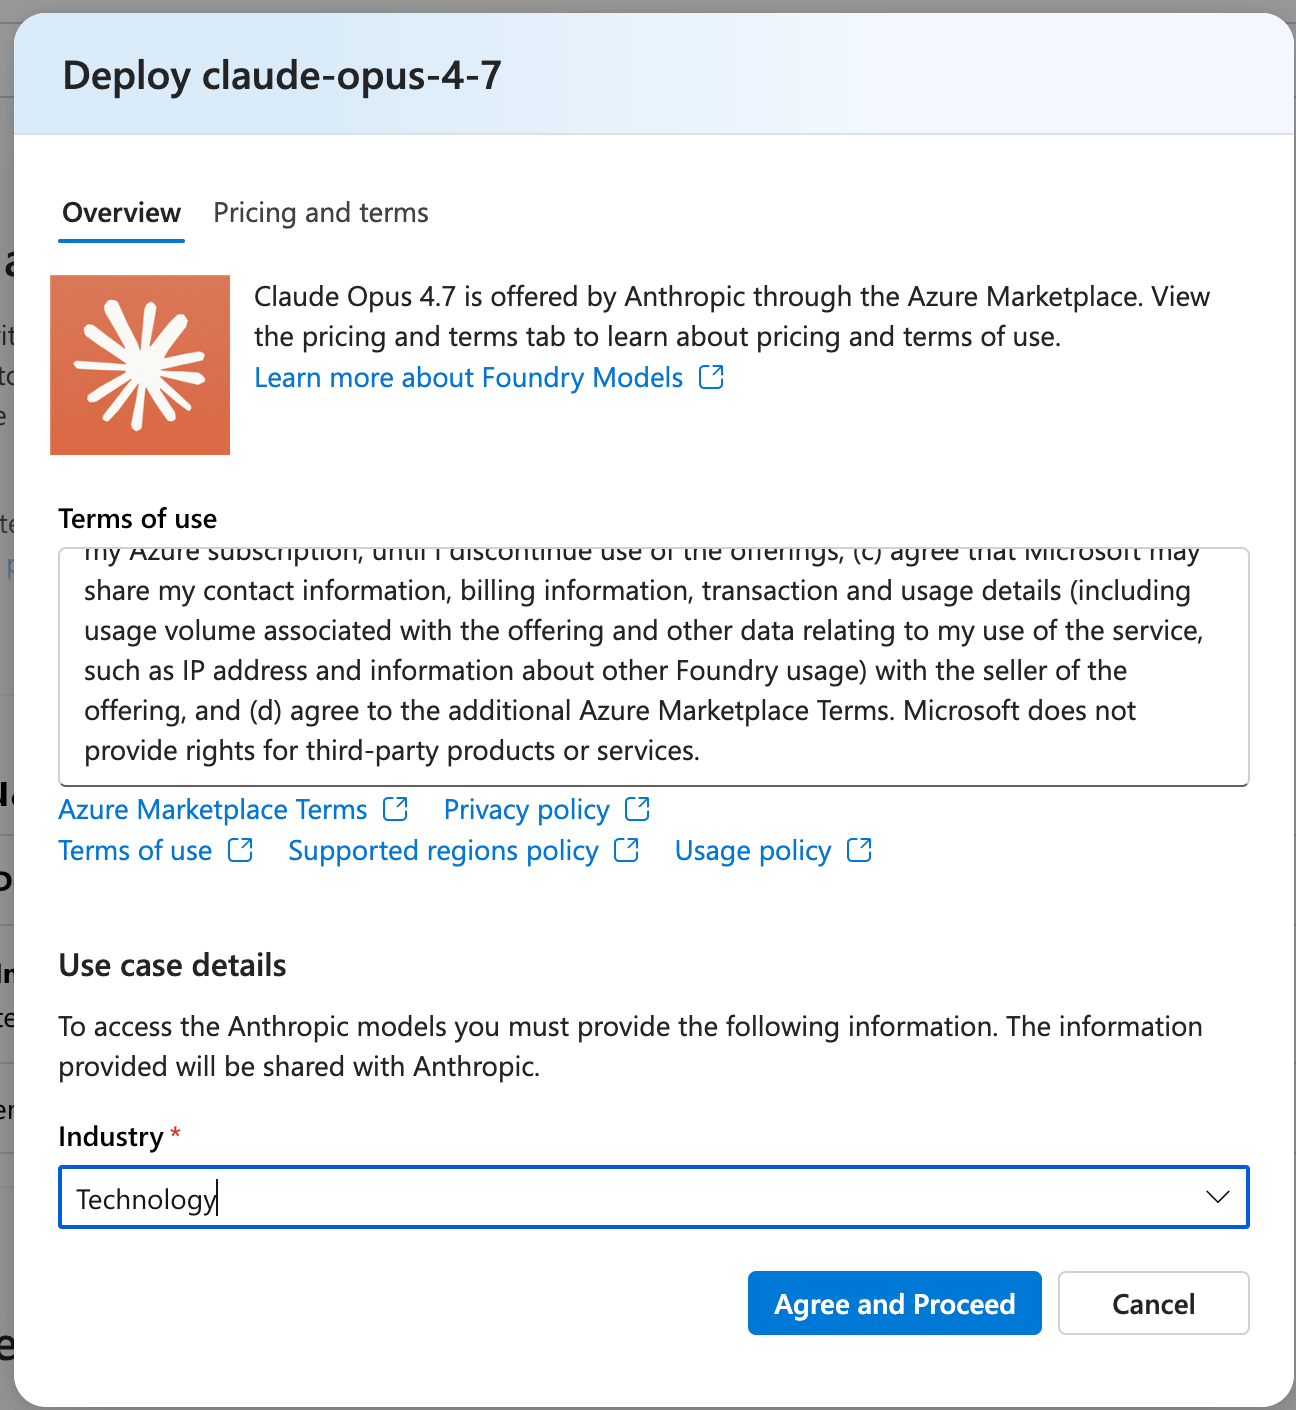
Sobald dein Projekt erstellt ist, landest du im Bereitstellungsdialog. Fülle dann Folgendes aus:
Deployment name: claude-opus-4-7 (bei Standard belassen, da der Code diesen String verwendet)
Deployment type: Global Standard (serverlos, kein Kapazitätsmanagement)
Model version upgrade policy: Ich empfehle, auf Version 1 zu pinnen statt Auto‑Update zu nutzen, damit neue Releases bestehende Runs nicht brechen
Klicke auf Create resource and deploy.
Nach der Bereitstellung öffnest du dein Projekt im Foundry‑Portal. Unter Overview findest du:
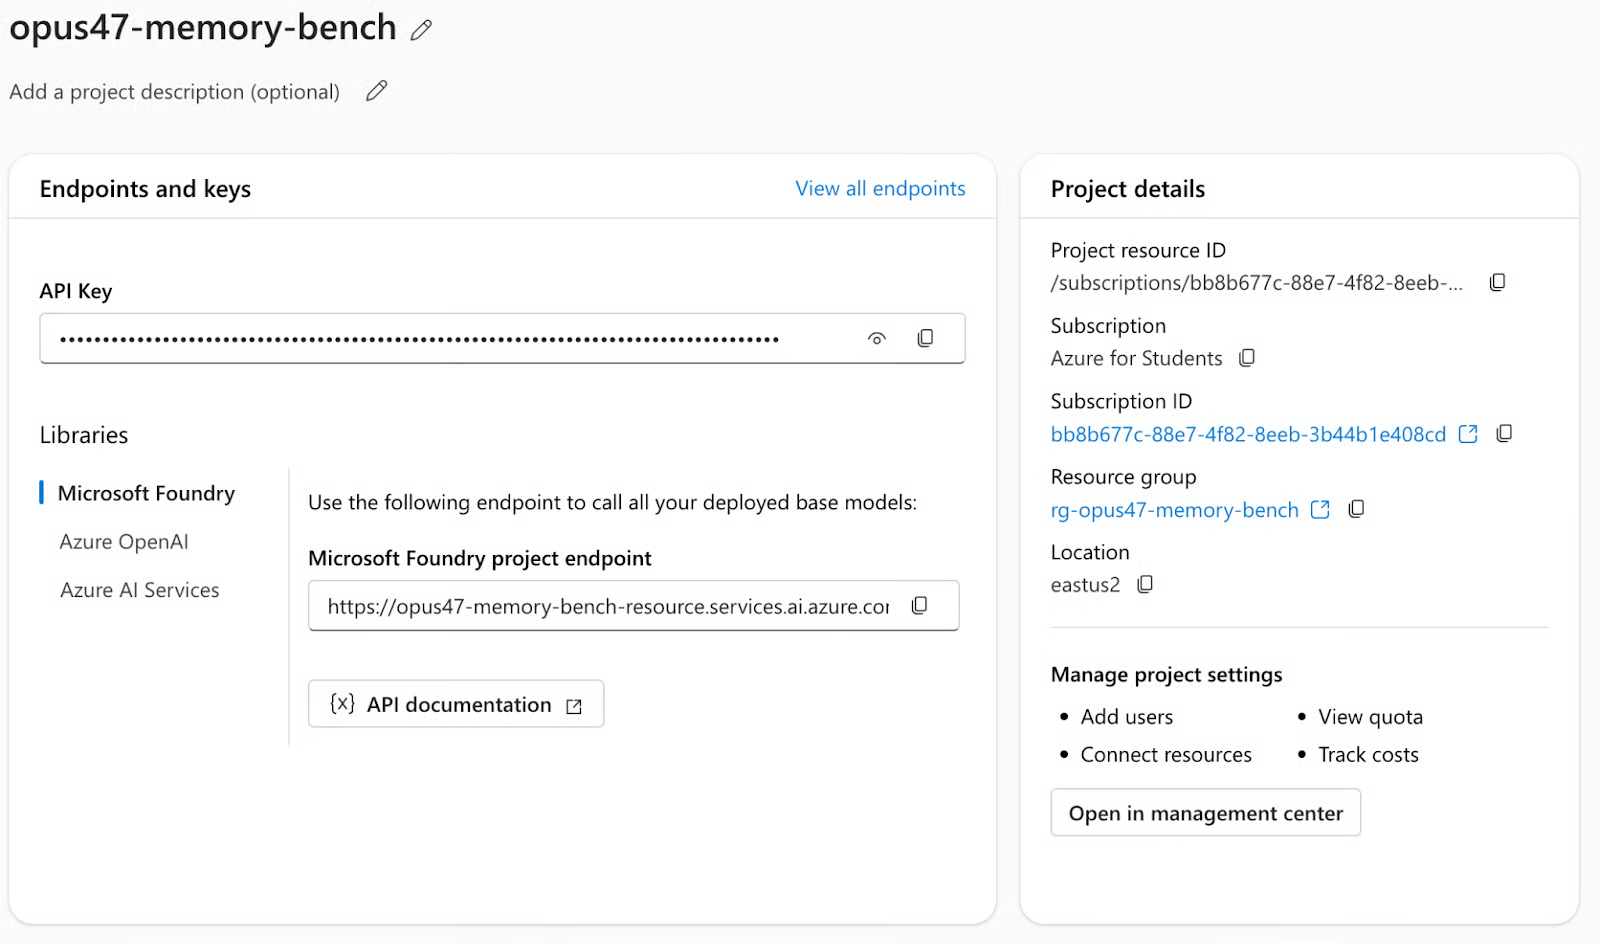
API key: Kopiere den API‑Schlüssel und bewahre ihn auf. Wir setzen ihn als ANTHROPIC_FOUNDRY_API_KEY.
Microsoft Foundry project endpoint: Kopiere den Ressourcennamen aus dem Projekt‑Endpoint im Format https://your-resource.services.ai.azure.com. Der Ressourcenname ist das Subdomain‑Präfix (also alles vor .services.ai.azure.com). Wir setzen ihn als ANTHROPIC_FOUNDRY_RESOURCE
Jetzt haben wir alles Nötige. Als Nächstes setzen wir die obigen Keys als Umgebungsvariablen und starten die Streamlit‑App.
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
Das Anthropic SDK behandelt den Foundry‑Endpoint automatisch, wenn du die ressourcenspezifische Basis‑URL übergibst:
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
Alles Weitere – Modellaufrufe, Thinking‑Parameter, Response‑Parsing – nutzt das Standard‑Anthropic‑SDK. Keine OpenAI‑Kompatibilitätsschicht nötig.
Das Streamlit‑Harness führt drei Aufgaben der Reihe nach aus, pro Aufwandsstufe zweimal: einmal mit Speicher aktiviert und einmal ohne (Kontrolllauf). Jede Aufgabe hat vier explizite Bewertungskriterien à 25 Punkte, bewertet von einem zweiten Opus‑4.7‑Aufruf als LLM‑als‑Richter. Die Bestehensgrenze je Aufgabe und Teilaufgabe liegt bei 70/100.
Diese Aufgabe ist ein klassisches LeetCode‑Hard‑Problem. Der Prompt verlangt eine Binärsuche mit O(log(m+n)), wobei ein linearer Scan beim Komplexitätskriterium null Punkte erhält. Zudem wird eine Testsuite mit mindestens 10 Fällen und Inline‑Kommentare gefordert, die jeden Schritt der Binärsuch‑Logik erklären. Nach dem Code muss das Modell den Ablauf für nums1=[1,3], nums2=[2] manuell Schritt für Schritt durchgehen.
Hier gibt es eine fehlerhafte Python‑Klasse RateLimiter mit mindestens drei Bugs, darunter eine subtile Race‑Condition. Die Methode is_allowed() liest und verändert gemeinsamen Zustand ohne Lock und erzeugt so eine klassische TOCTOU‑Schwachstelle (time‑of‑check to time‑of‑use). Der Prompt verlangt, jeden Bug mit exakten Zeilennummern zu identifizieren, das Fehlverhalten zu erklären, den Fix zu liefern und anschließend eine explizite Selbstprüfung durch erneutes Lesen des korrigierten Codes durchzuführen.
Für Aufgabe 3 implementieren wir eine skalarwertige Autograd‑Engine in purem Python ohne NumPy, ohne PyTorch (unterstützt +, *, -, /, **) sowie ReLU mit korrektem Subgradienten bei Null. Die Engine muss für den Backward‑Pass eine topologische Sortierung verwenden und Gradienten akkumulieren (+=) für Knoten, die mehrfach genutzt werden. Entscheidend ist, dass die manuelle Herleitung per Kettenregel vor dem Code gezeigt wird, nicht danach. So wird geprüft, ob das Modell zuerst planen und dann seine Begründung verifizieren kann.
Der Speicher ist das, was dieses Benchmark von einer Standard‑LLM‑Eval trennt. Statt jede Aufgabe als unabhängigen Aufruf zu behandeln, bekommt das Modell die strukturierte Gelegenheit, über Fehler zu reflektieren und diese Reflexion mithilfe einer Speicherkomponente mitzunehmen.
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
So entsteht eine Lernkurve innerhalb einer Sitzung. Bis Aufgabe 3 arbeitet das Modell mit zwei Runden angesammelter Selbstkritik und Anweisungen, die es sich selbst über eigene Fehlermuster geschrieben hat. Ob es diese Anweisungen produktiv nutzt oder nicht, schauen wir uns im Ergebnisabschnitt an.
Opus 4.7 führt xhigh als neue Aufwandsstufe zwischen high und max ein. Das Denk‑Budget steuert, wie viele Tokens das Modell für internes Reasoning ausgeben darf, bevor es antwortet. Höhere Budgets erlauben tiefere Planung, erhöhen aber Latenz und Kosten.
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
Diese Werte werden direkt an das Anthropic SDK übergeben:
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
Das Modell reguliert sich je nach wahrgenommener Schwierigkeit selbst. In der Praxis wird das volle Budget selten ausgeschöpft; in diesem Benchmark lagen die max‑Runs im Schnitt bei rund 300 Thinking‑Tokens pro Aufgabe – weit unter dem Limit von 20.000.
Insgesamt liefen 18 Aufgabenaufrufe (3 Aufwände × 2 Modi × 3 Aufgaben) plus 18 Richteraufrufe. Die Gesamtkosten lagen bei ca. 5 $.
Ich habe die Leistung über alle drei Aufgaben für alle sechs Bedingungen (drei Aufwandsstufen × Speicher an/aus) geplottet. Die orangenen Linien unten sind Läufe mit Speicher, die grauen/gestrichelten ohne Speicher, die rote gepunktete Linie markiert die Bestehensgrenze von 70 Punkten.
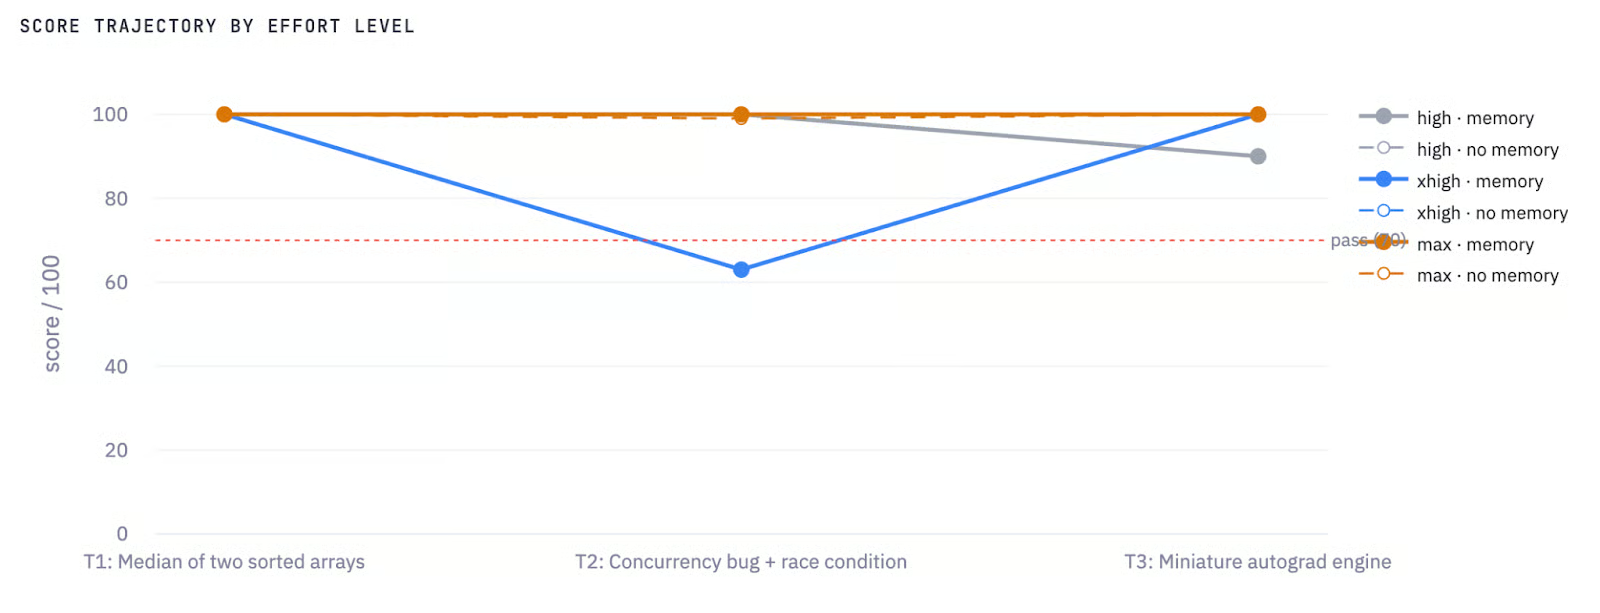
Score‑Trajectory nach Aufwandsstufe und Speicher
Auffällig ist die blaue Linie (xhigh + memory), die bei Aufgabe 2 auf 63 abstürzt – der einzige Fehlversuch im gesamten Benchmark. Das ist das zentrale Ergebnis des Experiments; ich breche es unten pro Aufgabe auf.
Das Effizienzdiagramm stellt Score gegen Kosten pro Aufgabe dar. Der Cluster oben links in Abbildung 2 zeigt high‑ und no‑memory‑Konfigurationen. Der Ausreißer unten links ist xhigh + memory in Aufgabe 2 mit 63 Punkten bei 0,009 $, d. h. das Modell lief günstig, scheiterte aber. Die max‑Speicherläufe liegen am rechten Rand (~0,10–0,12 $) und liefern vergleichbare Scores zu high bei mehr als doppelten Kosten.
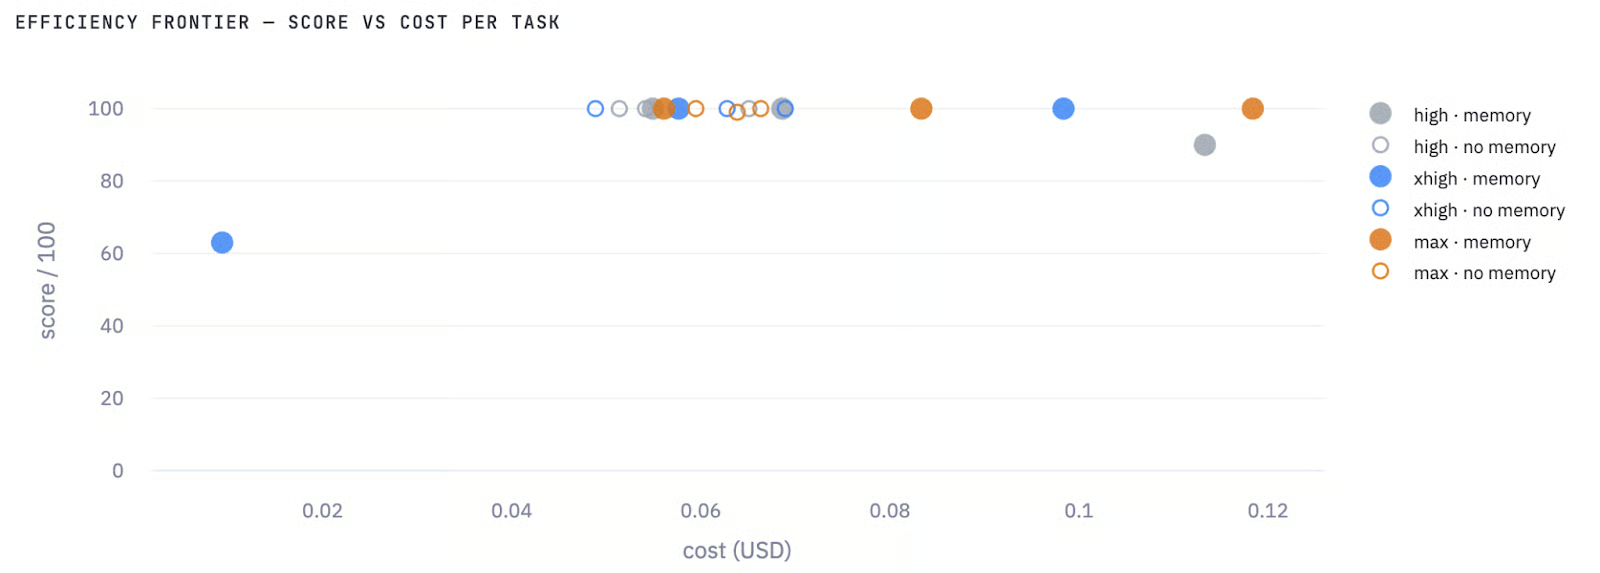
Effizienz: Score vs. Kosten pro Aufgabe
Die praktische Quintessenz: Bei diesen Coding‑Aufgaben erkauft ein höheres Denk‑Budget nicht verlässlich bessere Scores. Am kosteneffizientesten ist high ohne Speicher.
Die Aufwand‑×‑Speicher‑Matrix fasst die durchschnittlichen Scores über alle drei Aufgaben zusammen:
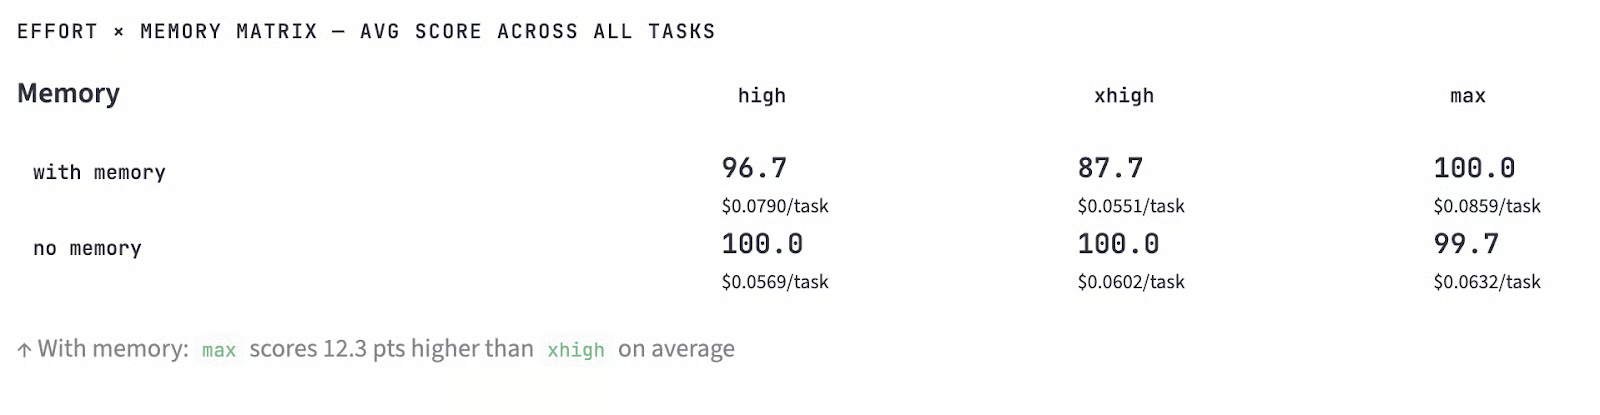
Durchschnittsscore über alle Aufgaben
Läufe ohne Speicher lagen in zwei von drei Aufwandsstufen vorn. Die Konfiguration max + memory erreichte im Schnitt 100,0 und war die einzige Speicher‑Variante, die ihr Pendant ohne Speicher übertraf – und das nur um 0,3 Punkte.
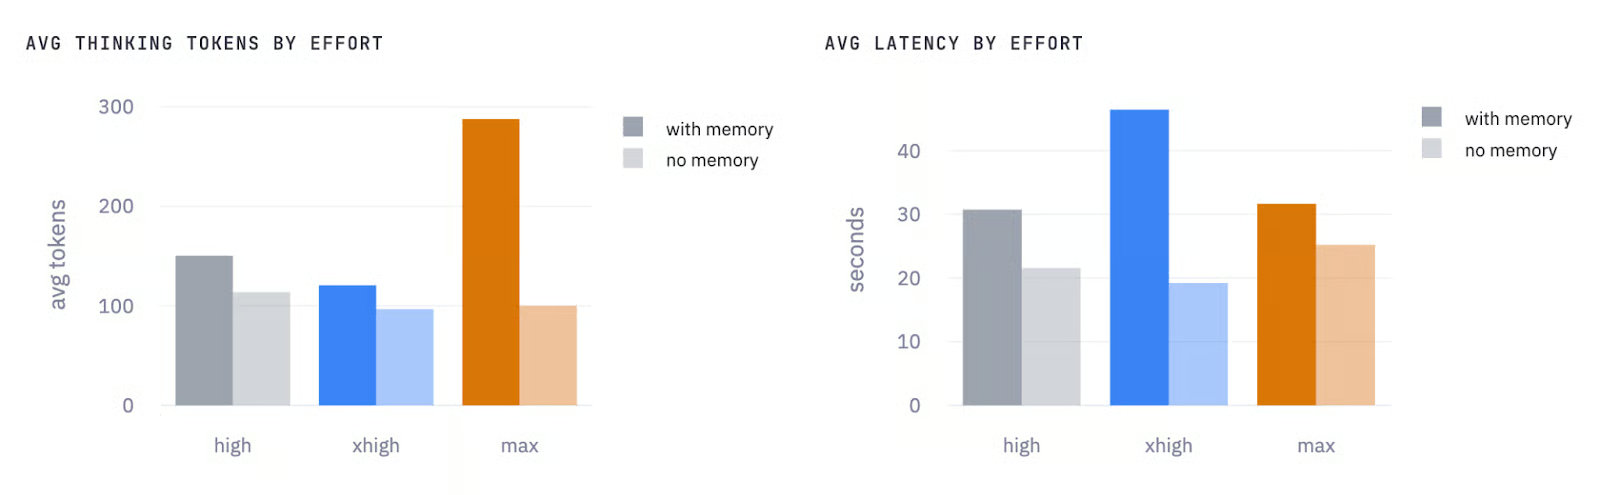
Ø Thinking‑Tokens nach Aufwand und Ø Latenz nach Aufwand
Auf der Thinking‑Token‑Seite (Abbildung 4 links) fällt max mit Speicher deutlich auf, mit im Schnitt rund 290 Thinking‑Tokens gegenüber ca. 100 ohne Speicher. Das heißt: Das Modell nutzt mehr internes Reasoning‑Budget, um die angesammelte Selbstkritik zu verarbeiten und anzuwenden. high und xhigh zeigen eine kleinere, aber konsistente Lücke in die gleiche Richtung – Speicher erhöht den Verbrauch an Thinking‑Tokens über alle drei Aufwandsstufen.
Das Latenzdiagramm (Abbildung 4 rechts) erzählt in Echtzeit dieselbe Geschichte – mit einer Ausnahme: xhigh mit Speicher hat die höchste Latenz aller Konfigurationen (im Schnitt rund 47 Sekunden), sogar höher als max mit Speicher (rund 31 Sekunden).
Das bedeutet: Der Fehlschlag in Aufgabe 2 hat den xhigh‑Durchschnitt nach oben gezogen, weil das Modell sein Denk‑Budget dafür verbrauchte, das Antwortformat anhand der Speicher‑Instruktionen umzustrukturieren, und dann weiter generierte, bis es das Ausgabelimit erreichte. max mit Speicher war trotz größerem Denk‑Budget im Schnitt schneller, weil alle drei Läufe ohne Trunkierung erfolgreich endeten.
Die praktische Erkenntnis: Speicher fügt bei high und max rund 30–40 % Overhead bei Thinking‑Tokens und Latenz hinzu.
Hier ein gekürzter Auszug aus der Bearbeitung des Modells:
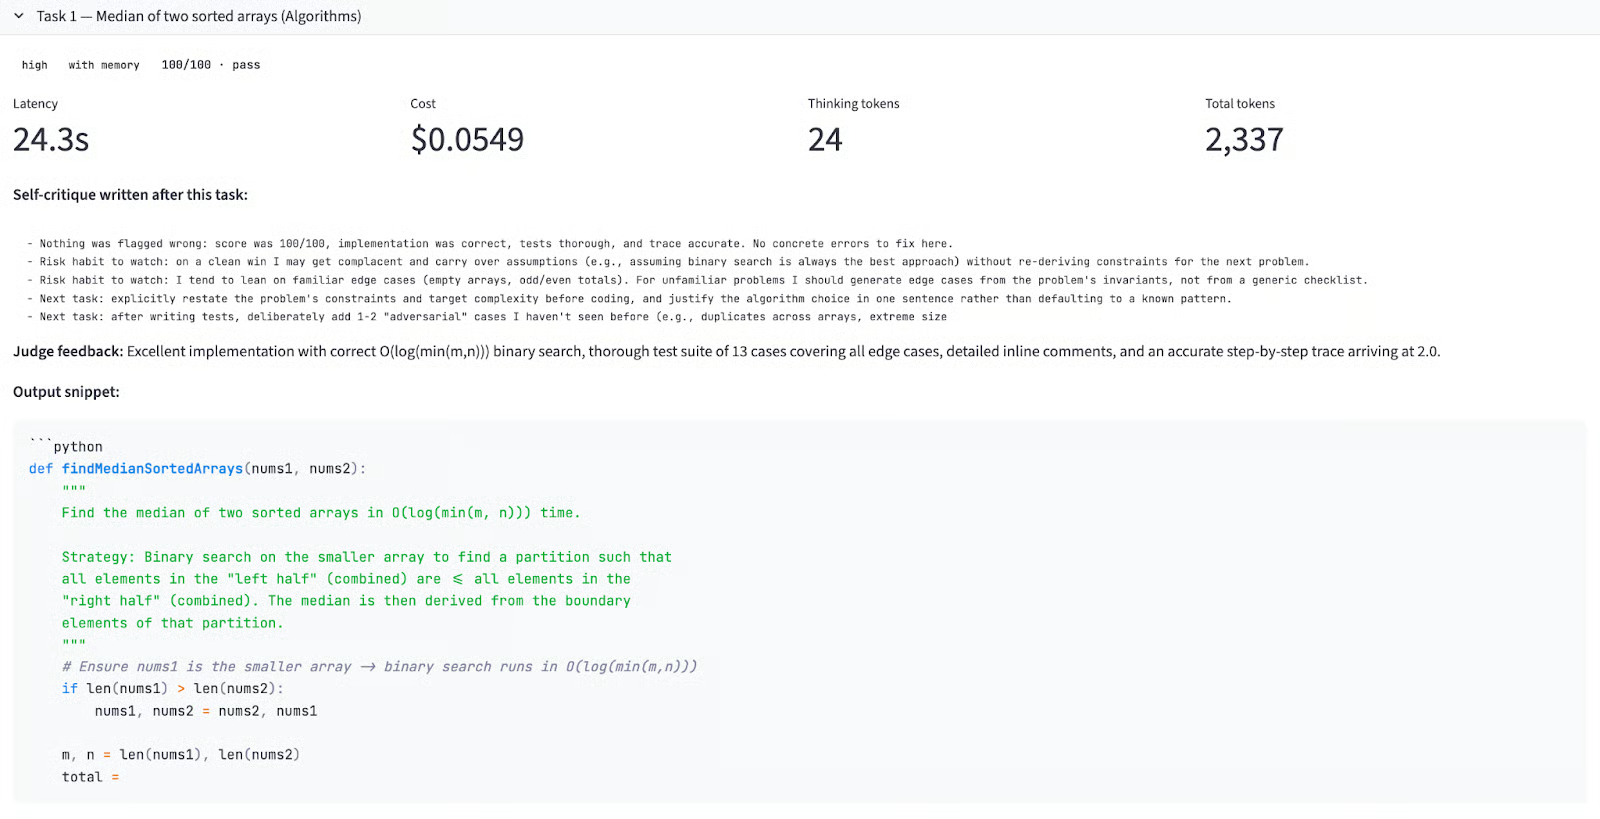
Input‑Prompt:
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].Memory‑Delta über Aufwandsstufen:
|
Aufwand |
Ohne Speicher |
Mit Speicher |
Δ |
|
high |
100 |
100 |
+0,0 |
|
xhigh |
100 |
100 |
+0,0 |
|
max |
100 |
100 |
+0,0 |
Alle sechs Läufe erzielten 100. Das ist erwartbar: Aufgabe 1 läuft bei den Speicher‑Runs kalt (es existiert noch keine vorherige Kritik) und ist daher mechanisch identisch zum Lauf ohne Speicher. Das Null‑Delta bestätigt, dass die Kontrolle funktioniert.
Interessant ist, was das Modell nach Aufgabe 1 in die Speicherdatei schrieb. Trotz perfekter Punktzahl lieferten alle drei Aufwandsstufen proaktive Selbstkritik, etwa so:
high: "Risk habit to watch: on a clean win I may get complacent and carry over assumptions without re-deriving constraints for the next problem. I should generate edge cases from the problem's invariants, not from a generic checklist."
xhigh: "Got a perfect score, but 'nothing wrong' is itself a suspicious self-assessment — I should scrutinize whether the judge's criteria were comprehensive."
max: "Watch for complacency: a 100 doesn't mean the solution was optimal in every dimension. I should still ask whether the binary search invariants were stated explicitly and whether I proved correctness rather than just asserted it."
Alle drei Varianten kamen unabhängig zu einer Anti‑Selbstzufriedenheits‑Warnung. xhigh und max gingen weiter und stellten in Frage, ob der Richter selbst alles abgedeckt hatte. Das ist Metakognition: Das Modell schreibt skeptische Notizen über seinen eigenen Review‑Prozess.
Output‑Qualität: Alle sechs Implementierungen nutzten Binärsuche auf dem kürzeren Array und erreichten O(log(min(m, n))) statt O(log(m+n)) – das ist strikt besser.
Richter‑Feedback über alle Läufe:
"Excellent implementation with correct O(log(min(m,n))) binary search, thorough test suite of 13 cases covering all edge cases, detailed inline comments, and an accurate step-by-step trace arriving at 2.0."
Hier produzierte die Speicher‑Mechanik ihr drastischstes Ergebnis: +37 Punkte bei high und −37 Punkte bei xhigh – basierend auf derselben Speicherdatei.
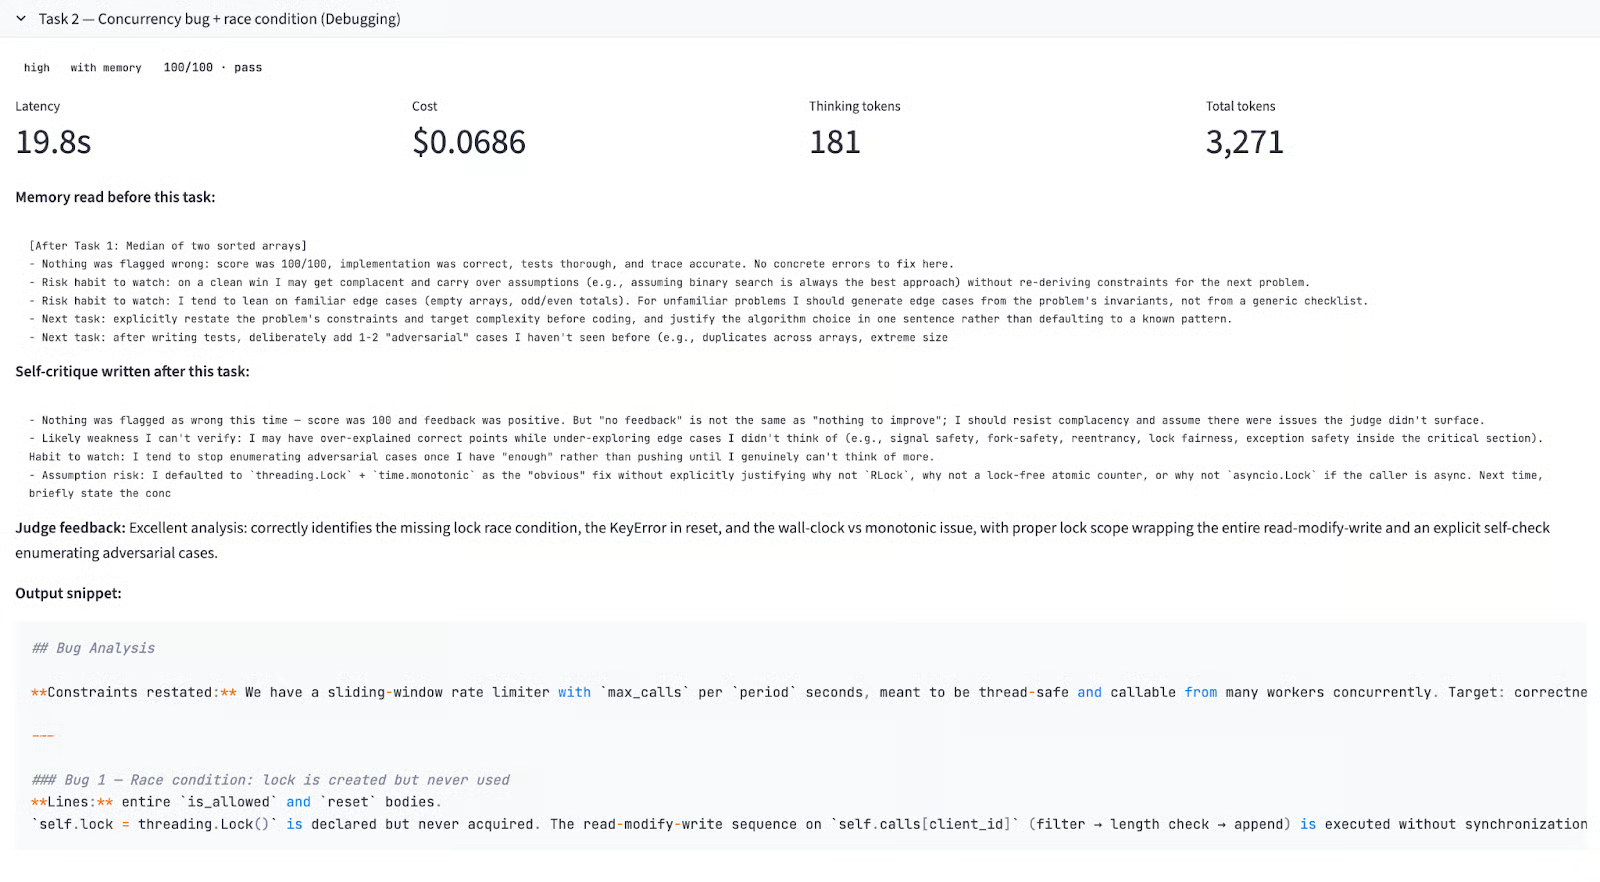
Input‑Prompt:
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.Memory‑Delta über Aufwandsstufen:
|
Aufwand |
Ohne Speicher |
Mit Speicher |
Δ |
|
high |
92 |
100 |
+8,0 |
|
xhigh |
100 |
63 |
-37,0 |
|
max |
99 |
100 |
+1,0 |
Zentrale Erkenntnisse:
high + memory (Score: 100/100): Der Speicher aus Aufgabe 1 warnte davor, zu wenige Bugs zu finden und forderte adversarielle Edge‑Cases. Das Modell formulierte vor der Bug‑Analyse die Problem‑Constraints explizit neu.
xhigh + memory (Score: 63/100 — FAIL): Das ist der zentrale Fehlschlag des Experiments. Der xhigh‑Speicher aus Aufgabe 1 enthielt eine detaillierte Notiz mit Inline‑Kommentaren. Das Modell nahm die Instruktion auf und nutzte sein 10.000‑Token‑Denk‑Budget, um das gesamte Antwortformat daran auszurichten. Ergebnis war eine extrem ausführliche Bug‑Analyse für Bugs 1 und 2, die das Ausgabelimit verbrauchte, bevor das Modell den korrigierten Code für Bug 3 oder den geforderten expliziten Selbstcheck erreichte. Die Latenz lag jedoch bei 93,1 Sekunden – der längste Lauf im gesamten Benchmark – gegenüber 22,2 Sekunden ohne Speicher bei xhigh.
xhigh + no memory (Score: 100/100): Hier setzten wir xhigh ohne Speicher ein. Das Modell lieferte zuerst alle geforderten Artefakte. Das Richter‑Feedback: "Correctly identifies the race condition, the unsafe reset, and the KeyError bug, plus a bonus monotonic-clock issue; lock scope properly covers the full read-modify-write sequence."
max + memory (Score: 100/100): Die Aufwandsstufe max hatte mit 20.000 Thinking‑Tokens genug Spielraum, um die speicherinduzierte Umstrukturierung vorzunehmen und dennoch alles zu liefern. Das Richter‑Feedback lobte den expliziten Selbstcheck mit adversariellen Fällen. Das ist der Sweet Spot, in dem Speicher half, weil genug Compute vorhanden war, ohne die Vollständigkeit zu gefährden.
Der Kern: Speicherinduzierte Meta‑Instruktionen konkurrieren direkt mit den Aufgabenanforderungen um Ausgabebudget. Bei xhigh gab es nicht genug Spielraum, um die Antwort umzustrukturieren und alle Deliverables zu vervollständigen.
Hier ein gekürzter Auszug aus der Bearbeitung des Modells:
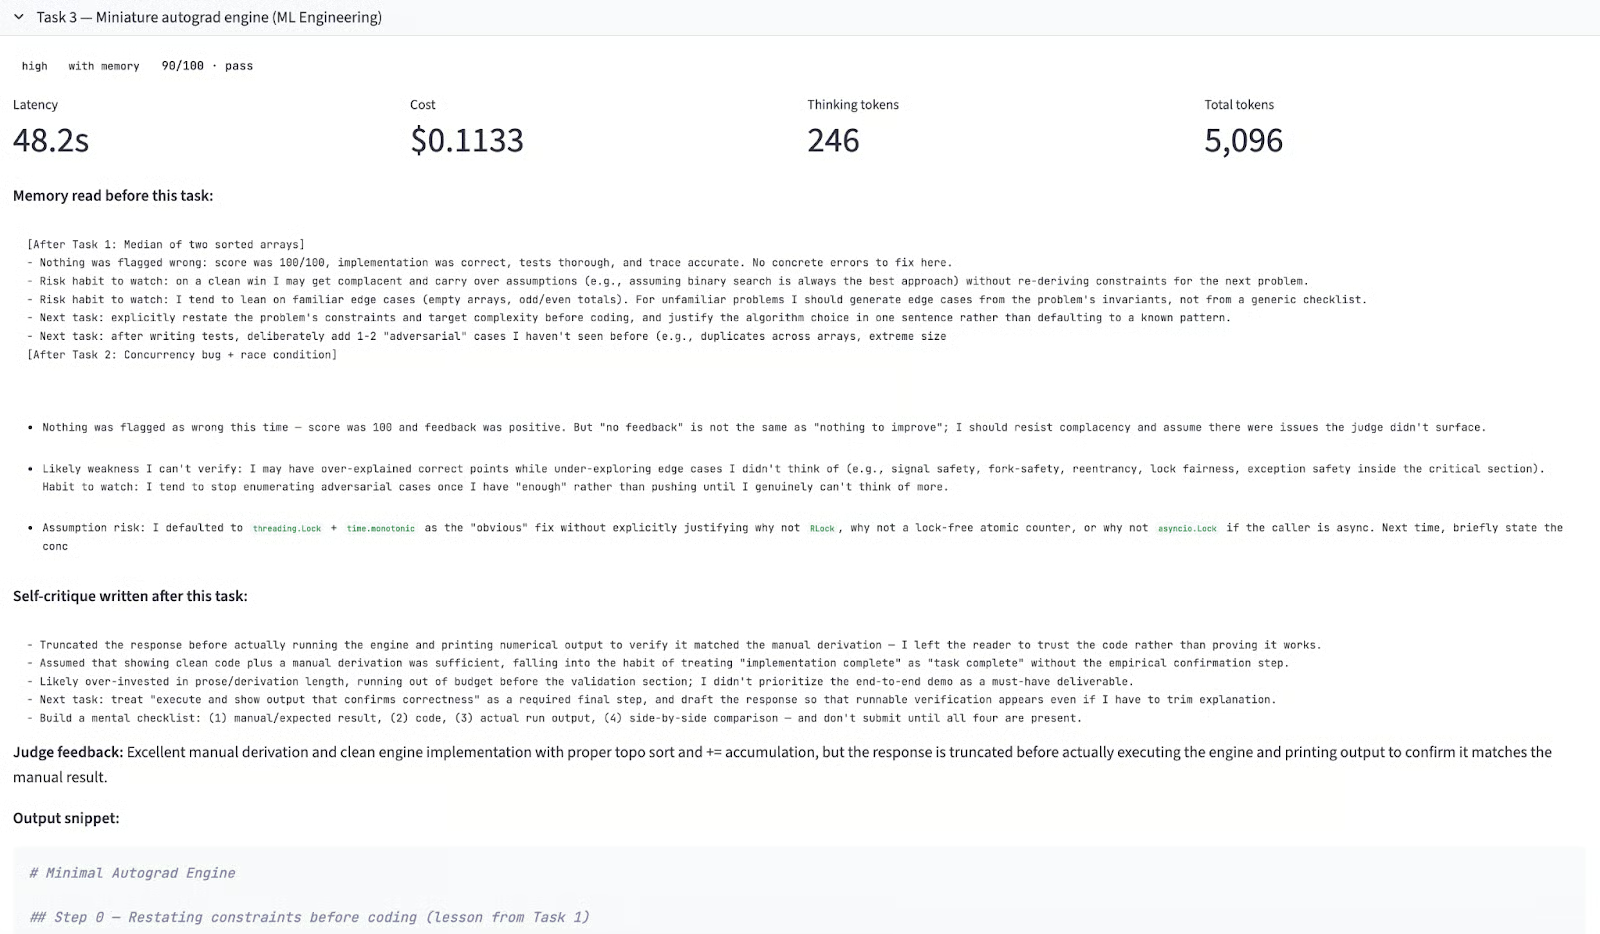
Input‑Prompt:
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.Memory‑Delta über Aufwandsstufen:
|
Aufwand |
Ohne Speicher |
Mit Speicher |
Δ |
|
high |
100 |
90 |
-10,0 |
|
xhigh |
100 |
100 |
0,0 |
|
max |
100 |
100 |
0,0 |
Einige wichtige Punkte aus dieser Aufgabe:
high + memory (Score: 90/100): Bis Aufgabe 3 umfasste der angesammelte Speicher adversarielle Tests, Output‑Struktur und Antwort‑Vollständigkeit aus zwei vollen Runden Selbstkritik. Das Modell versuchte, jede Instruktion zu befolgen, inklusive einer detaillierten Deliverables‑Checkliste am Anfang. Es ging das Ausgabeludget aus, bevor die Engine ausgeführt und numerische Outputs zum Abgleich gedruckt wurden. Dasselbe Fehlmuster wie bei xhigh in Aufgabe 2, aber weniger stark. Der Speicher war für das high‑Budget zu „reich“.
high + no memory (Score: 100/100): Ohne Instruktions‑Overhead lief die Ausführung sauber. Wichtige Merkmale: erst manuelle Herleitung, korrekte topologische Sortierung, Gradientenakkumulation via +=, Engine‑Output entspricht exakt der manuellen Herleitung.
xhigh + memory (Score: 100/100): Das interessanteste Ergebnis in Aufgabe 3. Trotz des Fehlschlags in Aufgabe 2 erreichte xhigh hier 100, weil der Fehlschlag eine präzise Selbstkritik erzeugte, die verlangte, Deliverables vor Erklärungen voranzustellen. Das ist der klarste Beleg für echtes Lernen im gesamten Benchmark: Das Modell diagnostizierte den Fehler, schrieb eine umsetzbare Korrektur und setzte sie in der nächsten Aufgabe um.
max + memory (Score: 100/100): Das ist die gründlichste Implementierung aller 18 Läufe. Noch vor dem Code listete das Modell Edge‑Cases zu skalaren Operanden, Knoten mit mehreren Eltern und die ReLU‑Subgradienten‑Konvention. Der Engine‑Output entsprach exakt den per Hand berechneten Gradienten inklusive Dead‑ReLU‑Nullsetzung.
18 Aufgabenaufrufe über drei Aufwandsstufen und zwei Speichermodi liefern mehr Signal als ein Einzelrun. Das sagen die Daten:
Speicher verbessert die Performance nicht verlässlich: In 9 Läufen mit Speicher vs. 9 ohne gewann „ohne Speicher“ in zwei von drei Aufwandsstufen. Speicher half nur bei max.
Die Interaktion zwischen Speicher und Aufwand: Dieselbe Selbstkritik‑Datei verbesserte die Scores bei max, hatte netto keinen Effekt bei xhigh und schadete bei high. Grund ist das Ausgabebudget: Speicher‑Instruktionen verbrauchen Antwort‑Kapazität.
xhigh kann mit Speicher katastrophal scheitern: Der 37‑Punkte‑Absturz in Aufgabe 2 – der einzige Fehlversuch – wurde durch eine Speicherinstruktion zum Antwortaufbau ausgelöst, die das Modell wörtlich nahm. Dieser Fehlmodus ist spezifisch für xhigh und sollte markiert werden, bevor man es in produktiven, agentischen Workflows mit strikten Output‑Anforderungen einsetzt.
Qualität der Selbstkritik: Der Modus max schrieb konsequent die umsetzbarsten Speicher‑Einträge – inklusive spezifischer Edge‑Cases, konkreter Checklisten, expliziter Fehlermuster. high‑Kritiken waren vager. Für Cross‑Session‑Lernen liefert max nützlichere Notizen – auch bei Aufgaben, die es sonst nicht erfordern.
high ohne Speicher ist die kosteneffiziente Konfiguration: 100/100 in allen drei Aufgaben bei 0,05–0,07 $ pro Aufgabe. Für Routine‑Coding kaufst du dir mit mehr Denk‑Budget keine höhere Zuverlässigkeit, sondern mehr Selbstdialog – der schaden kann, wenn das Ausgabebudget nicht groß genug ist.
Die praktische Empfehlung ist einfach: Kopple Speicher mit max – oder lass ihn weg.
Die Selbstkritiken, die Claude Opus 4.7 in den Speicher schreibt, sind substanziell, spezifisch und teils wirklich aufschlussreich. Ob dieser Speicher die Leistung verbessert, hängt jedoch entscheidend davon ab, wie viel Ausgabebudget dem Modell zur Verfügung steht, um darauf zu reagieren. Bei max half der Speicher. Bei high schadete derselbe Speicher, weil das Befolgen der angesammelten Instruktionen das Budget für die eigentliche Aufgabe auffraß.
Praktischer Rat: Wenn du die Speicherfunktion von Opus 4.7 für Lernen über Sitzungen/Aufgaben hinweg nutzt, kombiniere sie mit max. Wenn du high oder xhigh der Kosten wegen fährst, deaktiviere den Speicher oder halte ihn knapp, damit die Instruktionen nicht die eigentlichen Deliverables verdrängen.
Mit DataCamp lernen
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Nisha Arya Ahmed
15 Min.
Tutorial
Stephen Gruppetta
12 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Mark Pedigo
10 Min.