Cours
Introduction aux modèles Claude
3 h
15K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleLe Claude Opus 4.7 d’Anthropic introduit un nouveau niveau d’effort xhigh, intermédiaire entre high et max, et met spécifiquement en avant une meilleure mémoire de type système de fichiers comme capacité clé, c’est-à-dire que le modèle peut écrire des notes pour lui-même et les réutiliser entre les sessions.
Cela m’a posé une question évidente : cette mémoire fonctionne-t-elle vraiment de manière mesurable ? Et Opus 4.7 apprend-il de ses erreurs pour produire un meilleur code à la tâche suivante ?
J’ai donc conçu un banc d’essai avec Streamlit qui exécute trois tâches de codage difficiles de façon séquentielle. Après chaque tâche, le modèle écrit une auto-critique dans un fichier mémoire (memory.md). La tâche suivante lit ce fichier avant de démarrer. J’ai exécuté le tout avec et sans mémoire, sur les trois niveaux d’effort (high, xhigh et max), pour un total de 18 exécutions via Claude Opus 4.7 sur Microsoft Foundry.
À la fin de ce tutoriel, vous serez en mesure de :
Le code complet est disponible dans le dépôt GitHub.
Claude Opus 4.7 est le LLM le plus performant de la famille Claude 4, au-dessus de Sonnet et Haiku. Il est conçu pour des tâches agentiques de longue durée, l’ingénierie logicielle avancée et des workflows d’entreprise qui exigent des performances soutenues sur de longues sessions.
Les trois capacités les plus pertinentes pour ce tutoriel sont :
xhigh : intermédiaire entre high (5 000 jetons de réflexion) et max (20 000), à 10 000 jetons. L’idée est d’affiner le pilotage coût-qualité sur les problèmes difficiles.Note : la tarification est de 5 $ par million de jetons en entrée et 25 $ par million de jetons en sortie, identique à Opus 4.6. Pour approfondir, cet article de l’équipe DataCamp est une excellente lecture.
Quelques chiffres à connaître avant le test :
|
Benchmark |
Score |
|
SWE-bench Verified |
87,6 % |
|
SWE-bench Pro |
64,2 % |
|
GPQA Diamond |
94,2 % |
|
OSWorld Verified (computer use) |
78,0 % |
|
Finance Agent v1.1 |
64,4 % |
Toutes les requêtes d’API de ce tutoriel passent par Microsoft Foundry. Il faut donc un abonnement Azure avec facturation à l’usage, car l’offre étudiante gratuite n’inclut pas de quota pour les modèles partenaires tiers comme Claude. Une bonne alternative est d’utiliser la clé API d’Anthropic. J’ai couvert les deux approches dans ce dépôt.
La première étape consiste à localiser le modèle dans le catalogue Microsoft Foundry Model. Pour cela,
claude-opus-4-7. Vous ouvrirez une fiche modèle présentant ses capacités clés, benchmarks et l’ID du modèle.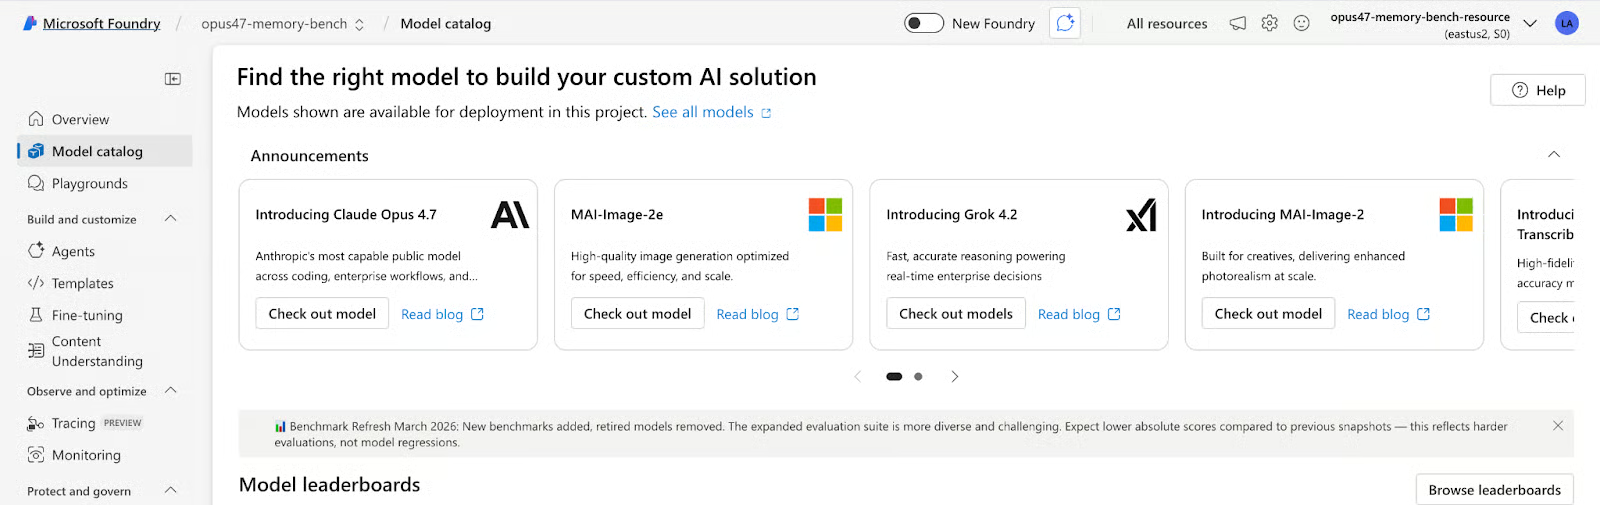
opus47-memory-bench. Puis acceptez les conditions d’utilisation et lisez et approuvez la politique d’utilisation d’Anthropic via Azure Marketplace.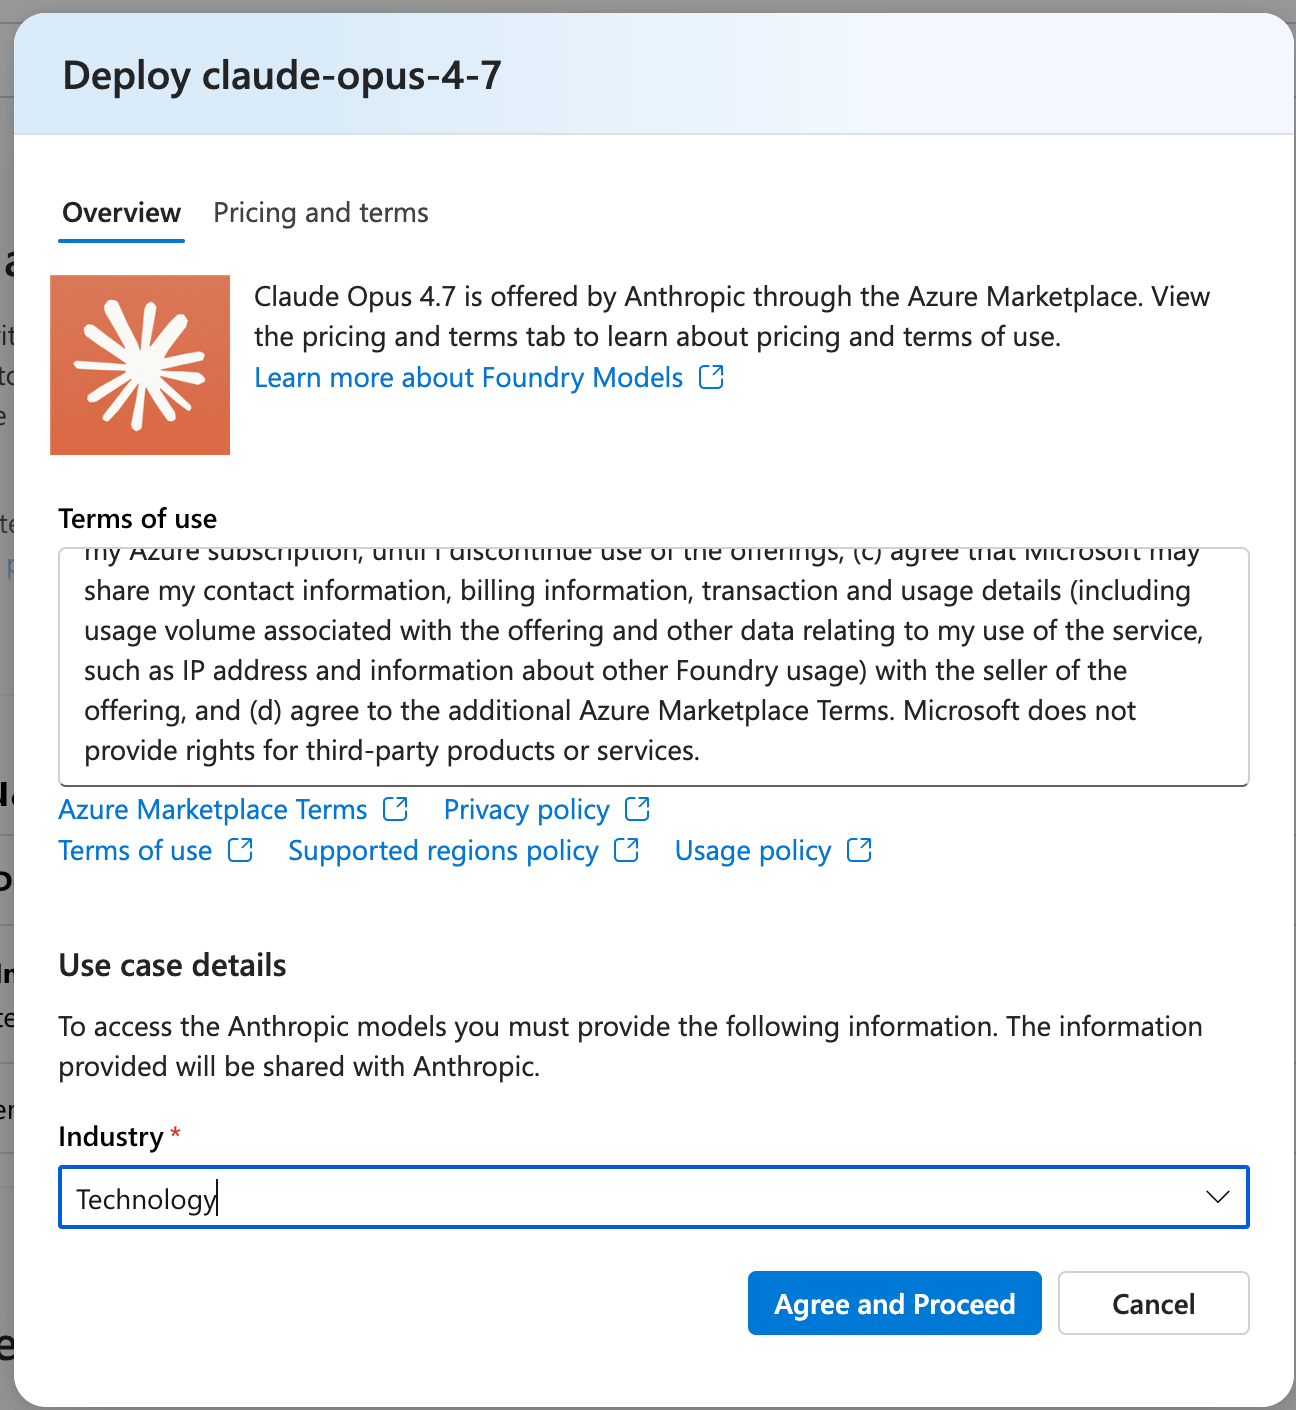
Une fois le projet créé, vous arrivez sur la boîte de dialogue de déploiement. Renseignez les informations suivantes :
Nom du déploiement : claude-opus-4-7 (conservez la valeur par défaut, le code s’y réfère)
Type de déploiement : Global Standard (sans serveur, pas de gestion de capacité)
Politique de mise à niveau de version : je recommande d’épingler à la version 1 plutôt que l’auto‑mise à jour afin d’éviter qu’une nouvelle version ne casse des exécutions existantes
Cliquez sur Create resource and deploy.
Une fois déployé, ouvrez votre projet dans le portail Foundry. Sous l’onglet Overview, vous trouverez :
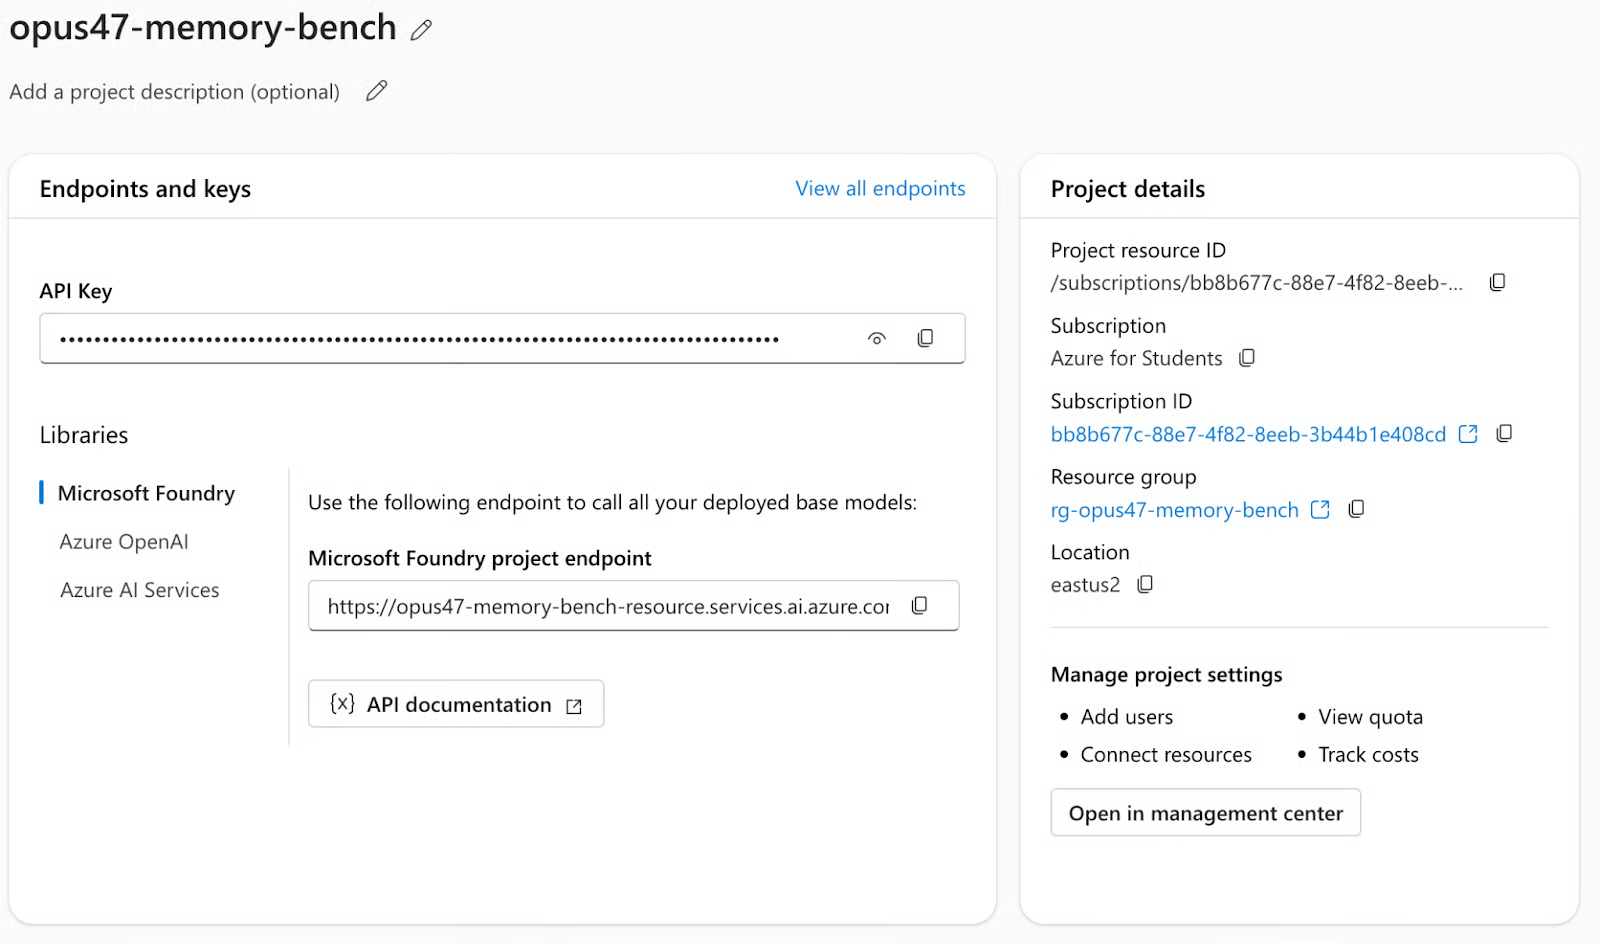
Clé API : copiez la clé API et conservez-la. Nous la définirons en tant que ANTHROPIC_FOUNDRY_API_KEY.
Point de terminaison du projet Microsoft Foundry : copiez le nom de ressource depuis l’URL du point de terminaison, au format https://your-resource.services.ai.azure.com, où le nom de ressource est le préfixe de sous‑domaine (tout ce qui précède .services.ai.azure.com). Nous l’enregistrerons en tant que ANTHROPIC_FOUNDRY_RESOURCE
Nous avons désormais tout le nécessaire. Nous allons définir les clés ci‑dessus en variables d’environnement et lancer l’application Streamlit.
pip install -r requirements.txt
export ANTHROPIC_FOUNDRY_API_KEY="your-key"
export ANTHROPIC_FOUNDRY_RESOURCE="your-resource-name"
streamlit run app.py
Le SDK Anthropic gère automatiquement le point de terminaison Foundry lorsque vous fournissez l’URL de base spécifique à la ressource :
import anthropic
client = anthropic.Anthropic(
    api_key=os.environ["ANTHROPIC_FOUNDRY_API_KEY"],
base_url=f"https://{os.environ['ANTHROPIC_FOUNDRY_RESOURCE']}.services.ai.azure.com/anthropic/",
)
Tout le reste — appels au modèle, paramètres de réflexion, parsing des réponses — utilise le SDK Anthropic standard. Pas besoin de couche de compatibilité OpenAI.
Le harnais Streamlit exécute trois tâches à la suite, deux fois par niveau d’effort, une fois avec mémoire activée et une fois sans (témoin). Chaque tâche a quatre critères d’évaluation explicites à 25 points chacun, notés par un second appel à Opus 4.7 jouant le rôle d’LLM‑juge. Le seuil de réussite par tâche et sous‑tâche est de 70/100.
Cette tâche correspond à un classique LeetCode « hard ». L’invite exige une implémentation en recherche binaire en O(log(m+n)) ; un parcours linéaire obtient zéro sur le critère de complexité. Elle requiert aussi une suite de tests d’au moins 10 cas et des commentaires en ligne expliquant chaque étape de la logique de recherche binaire. Après avoir écrit le code, le modèle doit dérouler manuellement l’exemple nums1=[1,3], nums2=[2] pas à pas.
Cette tâche propose une classe Python RateLimiter boguée avec au moins trois défauts, dont une condition de concurrence subtile. La méthode is_allowed() lit et modifie un état partagé sans tenir le verrou, créant une vulnérabilité TOCTOU (time‑of‑check to time‑of‑use). L’invite demande d’identifier chaque bug avec ses numéros de ligne précis, d’expliquer le mode de défaillance, de fournir la correction, puis d’effectuer une auto‑vérification explicite en relisant le code corrigé.
Pour la tâche 3, nous allons implémenter un moteur d’autodifférentiation scalaire en pur Python, sans NumPy ni PyTorch (prise en charge de +, *, -, /, **) et ReLU avec un sous‑gradient correct en zéro. Le moteur doit utiliser un tri topologique pour le passage arrière et l’accumulation des gradients (+=) pour les nœuds utilisés plusieurs fois. Point crucial : l’invite demande de montrer la dérivation manuelle par règle de chaîne avant le code, et non après. Cela teste la capacité du modèle à planifier puis vérifier son raisonnement.
La mécanique de mémoire distingue ce benchmark d’une évaluation LLM standard. Plutôt que de traiter chaque tâche comme un appel indépendant, on donne au modèle une opportunité structurée de réfléchir à ses erreurs et d’emporter cette réflexion via un composant mémoire.
MEMORY_WRITE_PROMPT = """You just completed a coding task. Write a concise self-critique.
Task: {task_name}
Your score: {score}/100
Judge feedback: {feedback}
Write 3-5 bullet points covering:
- Exactly what you got wrong or incomplete
- What habits or assumptions caused those mistakes
- Specific things to do differently on the NEXT task"""
Cela crée une courbe d’apprentissage au sein d’une même session. À la tâche 3, le modèle travaille avec deux séries d’auto‑critiques accumulées et des consignes qu’il s’est données sur ses propres schémas d’échec. Reste à voir dans les résultats s’il les utilise réellement de manière productive.
Opus 4.7 introduit xhigh comme nouveau niveau d’effort entre high et max. Le budget de réflexion contrôle le nombre de jetons que le modèle peut consacrer à son raisonnement interne avant de produire sa réponse. Des budgets plus élevés autorisent des plans plus profonds mais augmentent latence et coût.
EFFORT_LEVELS = {
    "high":  {"thinking_tokens": 5_000},
    "xhigh": {"thinking_tokens": 10_000},
    "max":   {"thinking_tokens": 20_000},
}
Ces paramètres sont transmis directement au SDK Anthropic :
resp = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=8000,
    thinking={"type": "enabled", "budget_tokens": thinking_budget},
    messages=[{"role": "user", "content": user_msg}],
)
Le modèle s’autorégule selon la difficulté perçue. En pratique, on observe rarement la consommation totale du budget ; ainsi les exécutions max de ce benchmark ont tourné autour de 300 jetons de réflexion par tâche, bien en‑dessous de la limite de 20 000.
Le benchmark a exécuté 18 appels de tâche au total (3 efforts × 2 modes × 3 tâches) et 18 appels de jugement pour la notation. Le coût total de l’expérience a été d’environ 5 $.
J’ai tracé la performance du modèle sur les trois tâches pour les six configurations (trois niveaux d’effort × mémoire activée/désactivée). Les lignes orange du graphique suivant sont les exécutions avec mémoire, les lignes grises en pointillés sans mémoire et la ligne rouge en pointillés marque le seuil de réussite à 70 points.
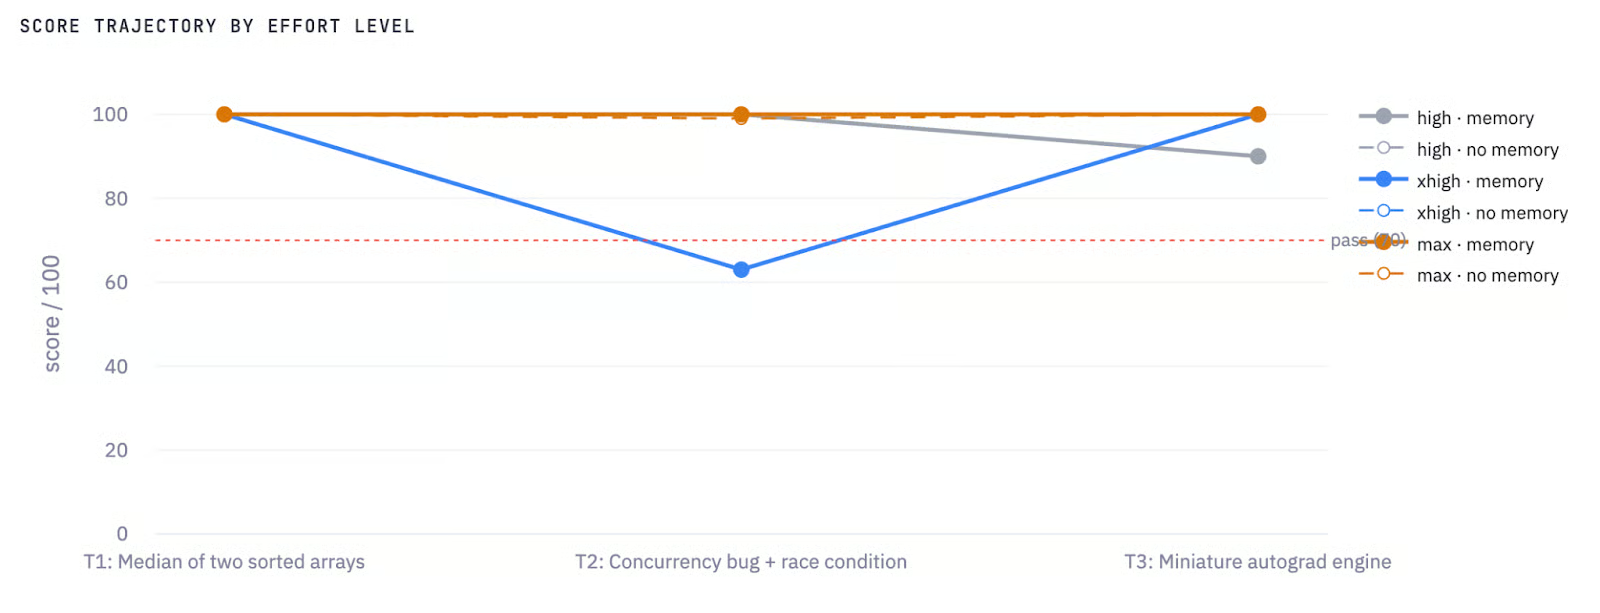
Trajectoire des scores par niveau d’effort et mémoire
L’élément le plus frappant est la ligne bleue (xhigh + memory) chutant à 63 sur la tâche 2, c’est‑à‑dire la seule exécution échouée de tout le benchmark. C’est la conclusion centrale de l’expérience, détaillée tâche par tâche ci‑dessous.
Le graphique d’efficacité trace le score en fonction du coût par tâche. Le groupe en haut à gauche de la figure 2 montre les configurations high et no-memory. La valeur aberrante en bas à gauche est xhigh + memory sur la tâche 2 avec 63 points pour 0,009 $, ce qui signifie que l’exécution a coûté peu mais a échoué. Les exécutions max avec mémoire apparaissent à l’extrémité droite (~0,10–0,12 $), offrant des scores comparables à high pour plus du double du coût.
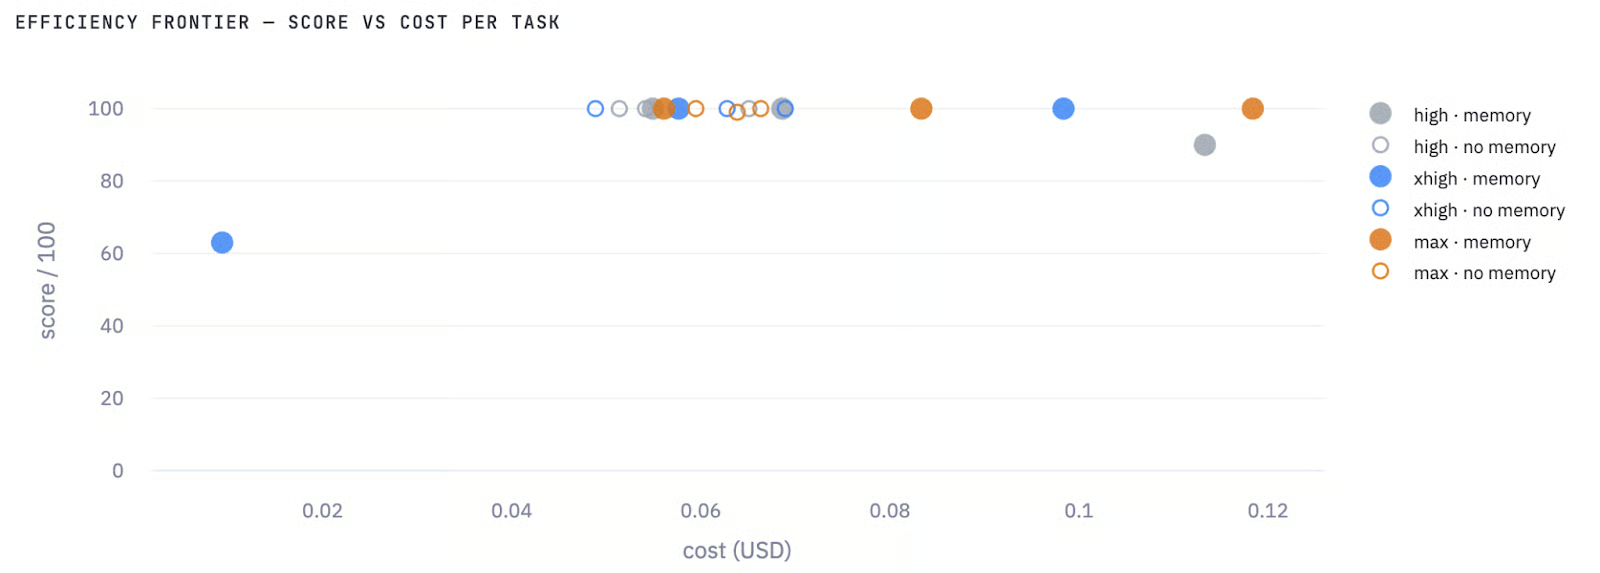
Efficacité : score vs coût par tâche
La leçon pratique est que, pour ces tâches de codage, dépenser plus en budget de réflexion n’achète pas fiablement de meilleurs scores. Le meilleur ratio coût‑efficacité est high sans mémoire.
La matrice effort × mémoire synthétise les scores moyens sur les trois tâches :
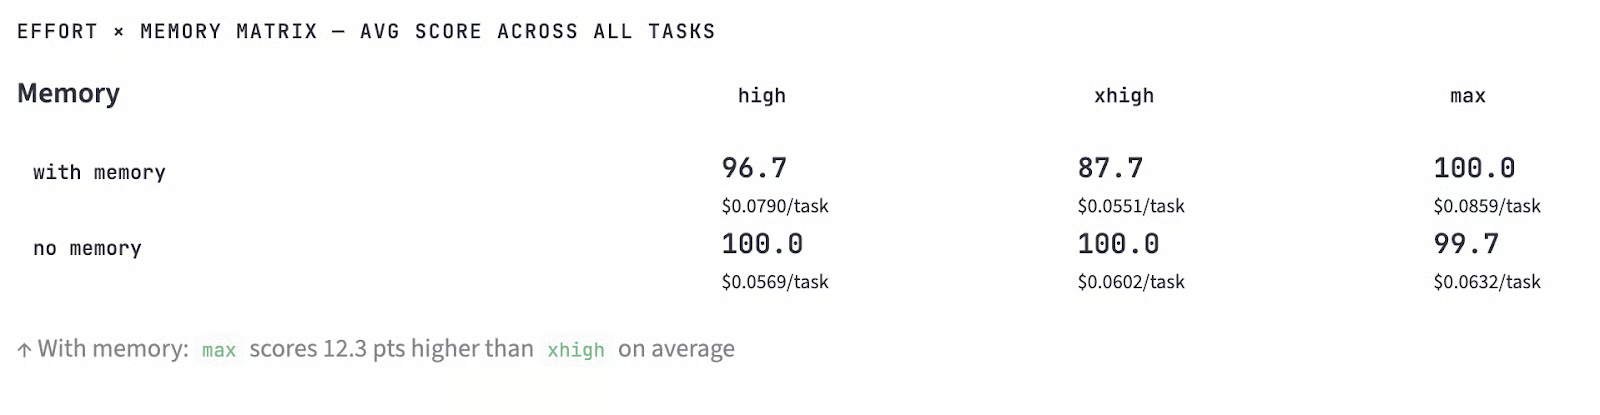
Score moyen sur l’ensemble des tâches
Les exécutions sans mémoire dominent pour deux niveaux d’effort sur trois. La configuration max + memory atteint 100,0 en moyenne — la seule configuration avec mémoire à surpasser son pendant sans mémoire, et de seulement 0,3 point.
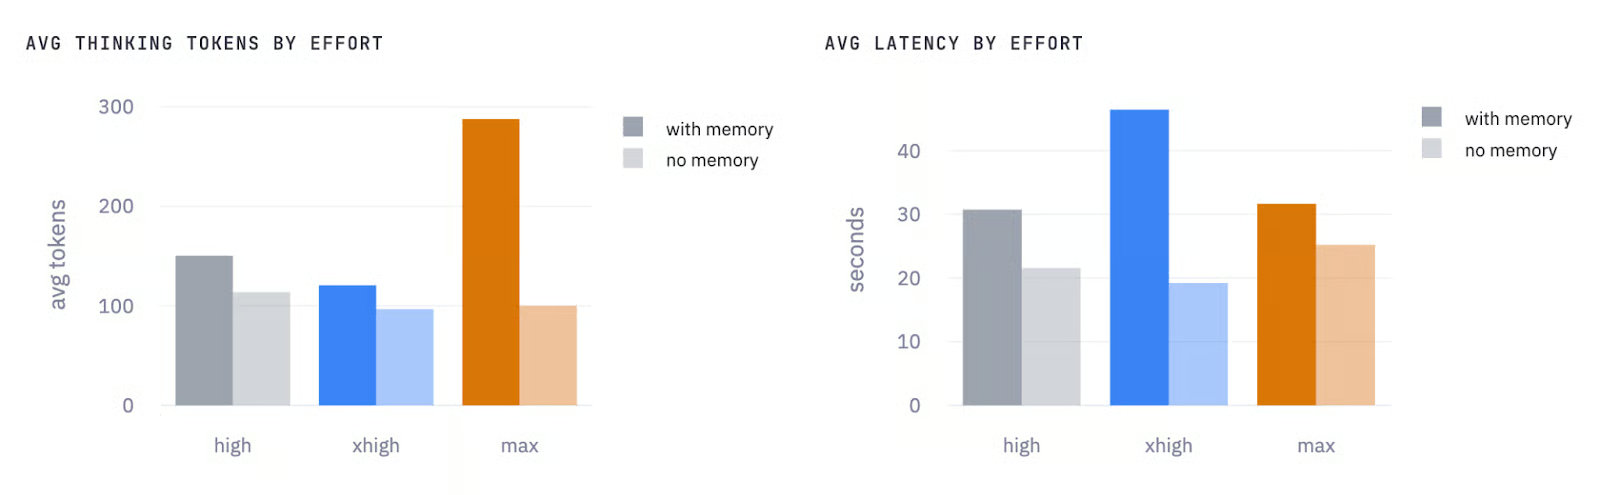
Jetons de réflexion moyens par effort et latence moyenne par effort
Côté jetons de réflexion (figure 4 à gauche), l’effort max avec mémoire se démarque nettement, à ~290 jetons en moyenne contre ~100 sans mémoire. Le modèle consacre donc plus de raisonnement interne pour traiter et appliquer l’auto‑critique accumulée avant de répondre. high et xhigh montrent un écart plus modeste mais régulier dans la même direction : la mémoire augmente toujours l’usage des jetons de réflexion, sur les trois niveaux d’effort.
Le graphique de latence (figure 4 à droite) raconte la même histoire en temps réel, avec une exception notable : l’effort xhigh avec mémoire présente la latence la plus élevée de toutes les configurations (~47 secondes en moyenne), supérieure même à max avec mémoire (~31 secondes).
Autrement dit, l’échec de la tâche 2 a tiré la moyenne de xhigh vers le haut, car le modèle a utilisé son budget de réflexion pour restructurer son format de réponse selon les consignes mémorisées, puis a continué à générer jusqu’à atteindre la limite de sortie. À l’inverse, max avec mémoire, bien que doté d’un budget de réflexion plus grand, a été plus rapide en moyenne, car ses trois exécutions ont abouti sans troncature.
Conclusion pratique : la mémoire ajoute ~30–40 % de surcharge en jetons de réflexion et en latence aux niveaux high et max.
Voici une version tronquée du travail du modèle sur cette tâche :
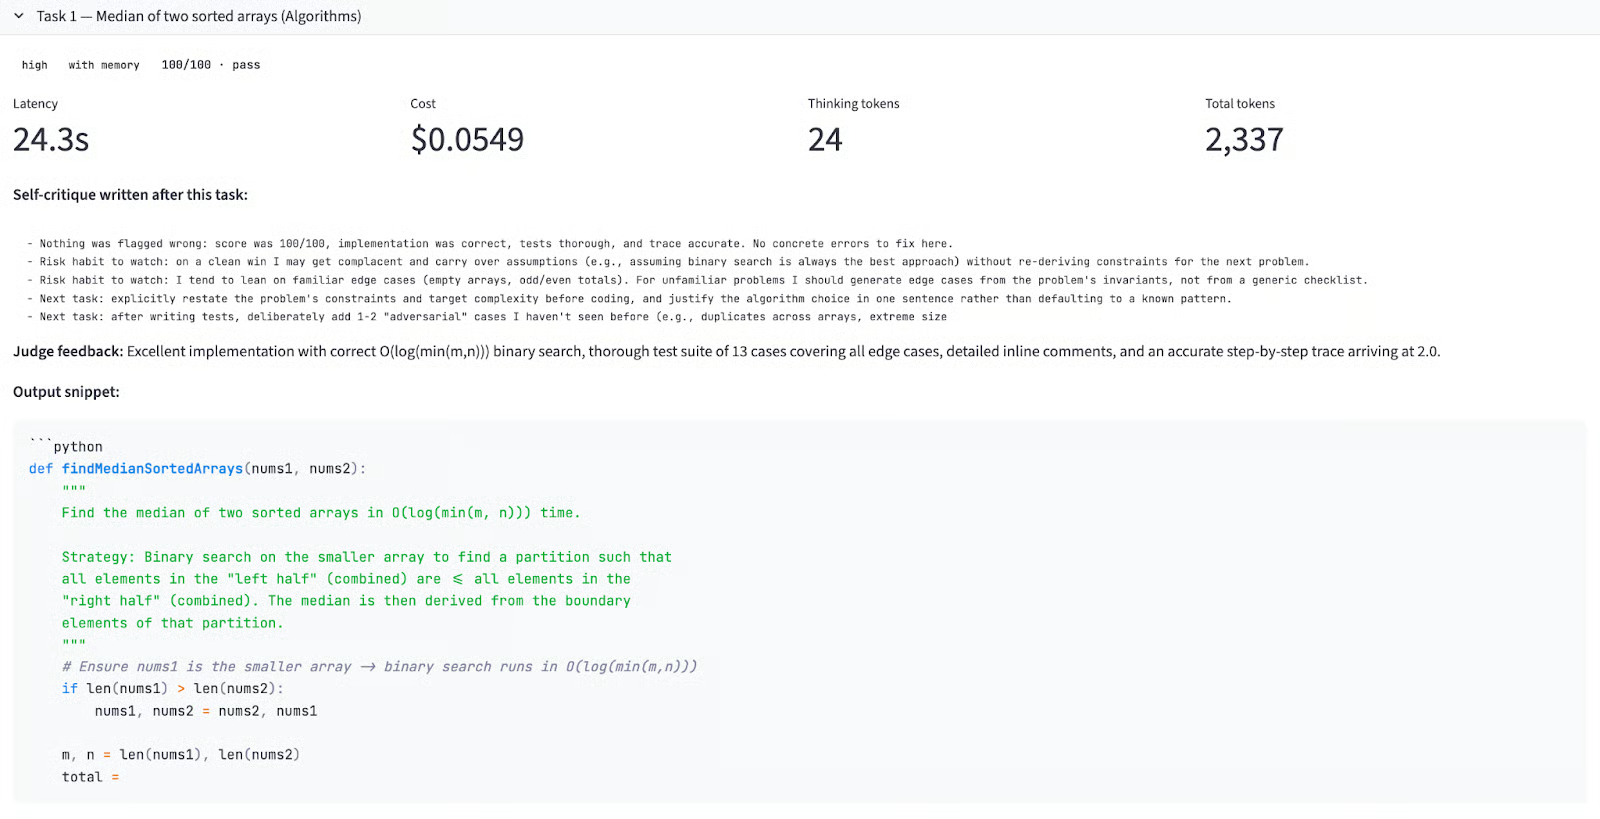
Invite d’entrée :
Implement findMedianSortedArrays(nums1, nums2) in Python with O(log(m+n)) complexity, a 10+ case test suite, inline comments, and a manual trace through [1,3]/[2].Delta mémoire selon les niveaux d’effort :
|
Effort |
Sans mémoire |
Avec mémoire |
Δ |
|
high |
100 |
100 |
+0,0 |
|
xhigh |
100 |
100 |
+0,0 |
|
max |
100 |
100 |
+0,0 |
Les six exécutions ont obtenu 100. C’est attendu pour la tâche 1 puisqu’elle démarre à froid en mode mémoire (aucune critique préalable), donc mécaniquement identique au mode sans mémoire. Le delta nul confirme que le témoin fonctionne.
Intéressant : ce que le modèle a écrit après la tâche 1 dans le fichier mémoire. Malgré un score parfait, les trois niveaux d’effort ont produit une auto‑critique proactive :
high : « Habitude à surveiller : après un succès net, je peux devenir complaisant et emporter des hypothèses sans re‑dériver les contraintes du prochain problème. Je dois générer des cas limites à partir des invariants du problème, pas d’une checklist générique. »
xhigh : « Score parfait, mais “rien à redire” est en soi un auto‑diagnostic suspect — je devrais examiner si les critères du juge étaient vraiment exhaustifs. »
max : « Attention à la complaisance : 100 ne signifie pas que la solution est optimale sur tous les plans. Je devrais quand même vérifier si les invariants de la recherche binaire étaient énoncés explicitement et si j’ai prouvé la correction plutôt que de l’affirmer. »
Les trois versions convergent vers un avertissement anti‑complaisance. Les versions xhigh et max vont plus loin en questionnant le juge lui‑même. C’est une métacognition où le modèle écrit des notes sceptiques sur son propre processus d’auto‑revue.
Qualité de sortie : les six implémentations utilisent la recherche binaire sur le plus petit tableau pour obtenir O(log(min(m, n))) plutôt que O(log(m+n)), ce qui est strictement meilleur.
Retour du juge sur toutes les exécutions :
« Excellente implémentation avec une recherche binaire correcte en O(log(min(m,n))), suite de 13 tests couvrant tous les cas limites, commentaires détaillés en ligne et traçage pas à pas exact aboutissant à 2,0. »
C’est ici que la mécanique de mémoire a produit son effet le plus spectaculaire : +8 points à l’effort high et −37 points à l’effort xhigh, à partir du même fichier mémoire.
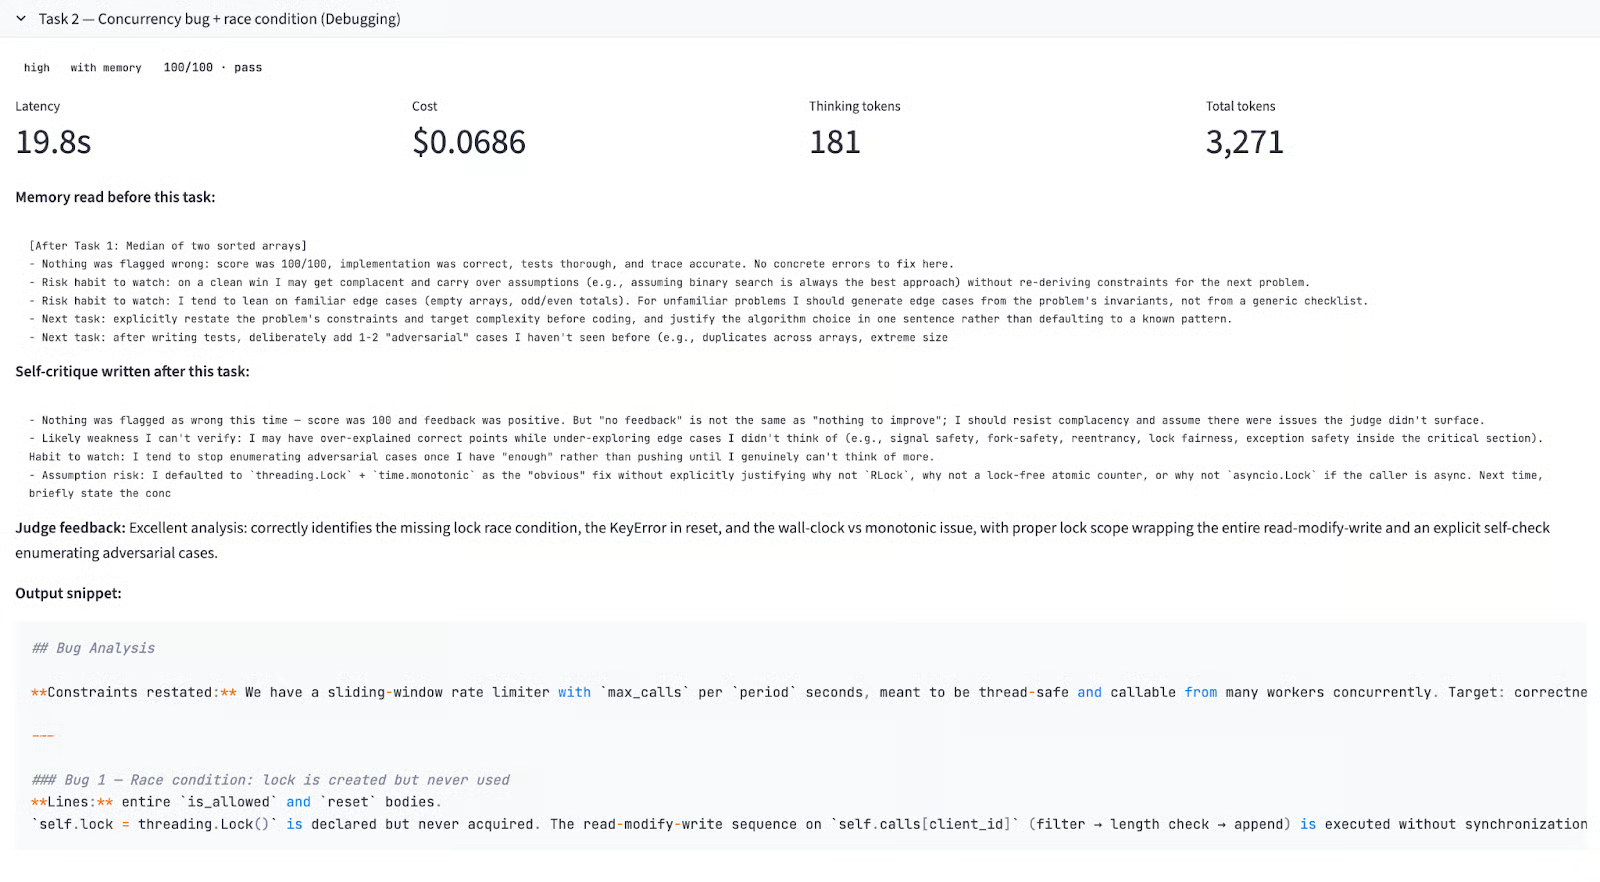
Invite d’entrée :
The buggy RateLimiter class with at least three bugs including a race condition. The model must identify each bug by line number, explain the failure mode, provide the fix, and perform an explicit self-check.Delta mémoire selon les niveaux d’effort :
|
Effort |
Sans mémoire |
Avec mémoire |
Δ |
|
high |
92 |
100 |
+8,0 |
|
xhigh |
100 |
63 |
-37,0 |
|
max |
99 |
100 |
+1,0 |
Conclusions clés :
high + memory (score : 100/100) : la mémoire de la tâche 1 avertissait de générer des cas limites « adversariaux » et de ne pas s’arrêter trop tôt dans la chasse aux bugs. Le modèle a reformulé explicitement les contraintes avant d’analyser les bogues.
xhigh + memory (score : 63/100 — ÉCHEC) : c’est l’échec central de l’expérience. La mémoire xhigh issue de la tâche 1 incluait une note détaillée avec commentaires en ligne. Le modèle a pris l’instruction à la lettre et a utilisé son budget de 10 000 jetons de réflexion pour restructurer tout son format de réponse autour de la leçon. Résultat : une analyse extrêmement verbeuse pour les bogues 1 et 2, qui a épuisé le budget de sortie avant d’atteindre le code corrigé du bug 3 ou l’auto‑vérification requise. La latence a été de 93,1 s — la plus longue du benchmark — contre 22,2 s sans mémoire à xhigh.
xhigh + no memory (score : 100/100) : dans cette sous‑tâche, l’effort xhigh sans mémoire a permis au modèle de livrer d’abord tous les livrables requis. Retour du juge : « Identifie correctement la condition de concurrence, le reset non sécurisé et le bug KeyError, plus un problème de montre monotone ; la portée du verrou couvre bien toute la séquence read‑modify‑write. »
max + memory (score : 100/100) : le niveau max disposait d’un budget de 20 000 jetons de réflexion, offrant la marge nécessaire pour appliquer la restructuration induite par la mémoire tout en complétant tous les livrables. Le juge a salué l’auto‑vérification explicite énumérant des cas adversariaux. C’est le point d’équilibre où la mémoire aide, car le modèle a assez de calcul pour l’exploiter sans compromettre l’exhaustivité.
L’idée clé : les méta‑instructions induites par la mémoire entrent en compétition directe avec les exigences de la tâche pour le budget de sortie. À xhigh, il n’y avait pas assez de marge pour restructurer la réponse et livrer tous les éléments.
Voici une version tronquée du travail du modèle sur cette tâche :
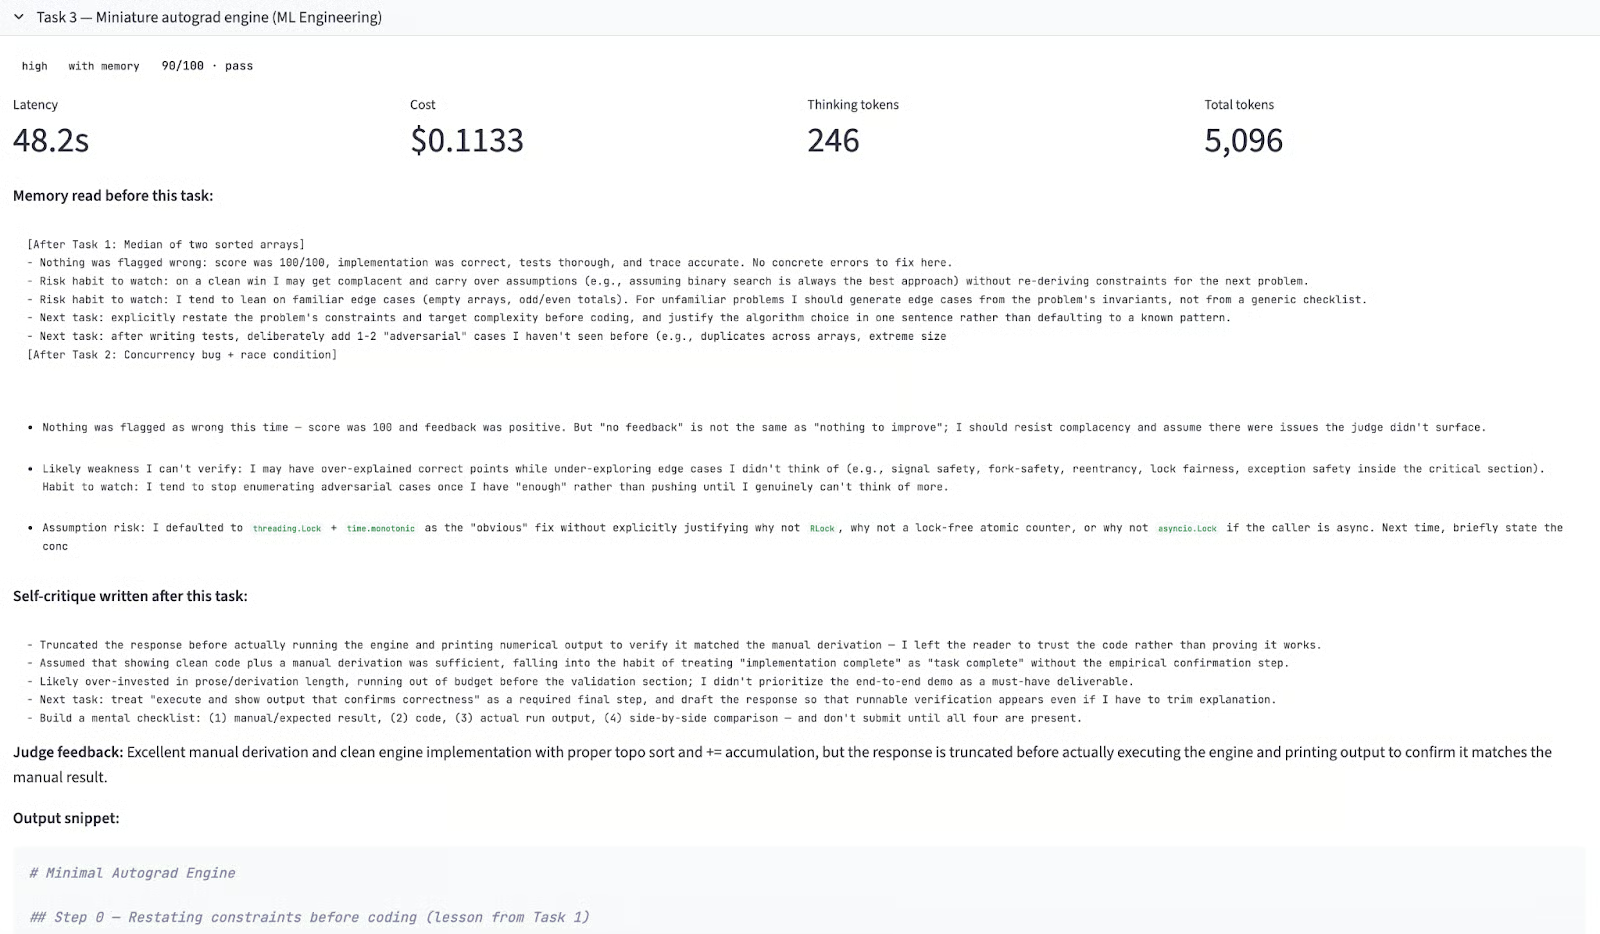
Invite d’entrée :
Implement a scalar autograd engine in pure Python with topological sort, gradient accumulation, and ReLU. Show the manual chain-rule derivation first, then confirm the engine matches.Delta mémoire selon les niveaux d’effort :
|
Effort |
Sans mémoire |
Avec mémoire |
Δ |
|
high |
100 |
90 |
-10,0 |
|
xhigh |
100 |
100 |
0,0 |
|
max |
100 |
100 |
0,0 |
Quelques enseignements clés :
high + memory (score : 90/100) : à la tâche 3, la mémoire accumulée couvrait tests adversariaux, structure de sortie et exhaustivité, issus de deux cycles complets d’auto‑critique. Le modèle a tenté de suivre toutes les consignes, y compris une checklist détaillée des livrables en tête de réponse. Il a manqué de budget de sortie avant d’exécuter le moteur et d’imprimer la sortie numérique de validation. Même mode d’échec que xhigh à la tâche 2, mais en moindre ampleur. La mémoire est devenue trop riche pour le budget high.
high + no memory (score : 100/100) : sans surcharge d’instructions, l’exécution est propre. Points clés : dérivation manuelle en premier, tri topologique correct, accumulation des gradients via +=, et sortie du moteur conforme exactement à la dérivation manuelle.
xhigh + memory (score : 100/100) : résultat le plus intéressant de la tâche 3. Malgré l’échec à la tâche 2, xhigh obtient 100 ici, car l’échec précédent a généré une auto‑critique précise sur le fait de livrer les éléments requis avant l’explication. La preuve la plus claire d’un véritable apprentissage dans tout le benchmark : le modèle diagnostique son échec, écrit un correctif actionnable et l’applique à la tâche suivante.
max + memory (score : 100/100) : l’implémentation la plus aboutie des 18 exécutions. Avant d’écrire le moindre code, le modèle liste les cas limites : opérandes scalaires, nœuds à parents multiples, convention de sous‑gradient ReLU. La sortie du moteur correspond exactement aux gradients calculés à la main, y compris l’annulation en ReLU mort.
Exécuter 18 appels de tâche sur trois niveaux d’effort et deux modes de mémoire apporte davantage de signal qu’une exécution isolée. Voici ce que disent les données :
La mémoire n’améliore pas la performance de façon fiable : sur 9 exécutions avec mémoire vs 9 sans, le mode sans mémoire l’emporte pour deux niveaux d’effort sur trois. La mémoire n’a aidé qu’au niveau max.
Interaction mémoire‑effort : le même fichier d’auto‑critique améliore les scores à max, n’a pas d’effet net à xhigh et nuit à high. La raison tient au budget de sortie : les instructions induites par la mémoire consomment de la capacité de réponse.
xhigh peut échouer de manière catastrophique avec mémoire : la chute de 37 points sur la tâche 2, seul échec du benchmark, a été provoquée par une instruction mémorisée sur la structure de réponse que le modèle a suivie à la lettre. Ce mode d’échec est spécifique à xhigh et doit être signalé avant tout déploiement en production sur des workflows agentiques aux livrables stricts.
Qualité des auto‑critiques : le mode max produit systématiquement les entrées mémoire les plus actionnables (cas limites précis, checklists concrètes, modes de défaillance explicites). Les critiques en high sont plus vagues. Si vous utilisez la mémoire pour l’apprentissage inter‑sessions, max génère des notes plus utiles, même pour des tâches qui n’en nécessitent pas a priori.
high sans mémoire est la configuration la plus économique : 100/100 sur les trois tâches pour 0,05–0,07 $ par tâche. Pour des tâches de codage courantes, un budget de réflexion plus grand n’achète pas de fiabilité, mais une auto‑réflexion plus verbeuse qui peut nuire si le budget de sortie ne peut pas l’absorber.
La recommandation pratique est simple : associez la mémoire à l’effort max, ou n’utilisez pas la mémoire.
Les auto‑critiques que la mémoire de Claude Opus 4.7 rédige sont substantielles, précises et parfois réellement pertinentes. Mais l’impact sur la performance dépend de façon critique du budget de sortie disponible pour les appliquer. À l’effort max, la mémoire a aidé. À l’effort high, la même mémoire a nui, car suivre les consignes accumulées a consommé le budget nécessaire pour terminer la tâche.
Conseil pratique : si vous utilisez la fonction mémoire d’Opus 4.7 pour l’apprentissage entre sessions ou entre tâches, associez‑la à l’effort max. Si vous privilégiez high ou xhigh pour des raisons de coût, désactivez la mémoire ou gardez‑la concise, car ses instructions peuvent évincer les livrables attendus.
Apprenez avec DataCamp
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Stephen Gruppetta
12 min
Tutoriel
Josef Waples
8 min
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Laiba Siddiqui
14 min