Melakukan penelitian yang menyeluruh itu kompleks dan memerlukan perencanaan yang cermat, termasuk bagaimana peserta ditugaskan ke kelompok perlakuan yang menerima treatment (atau intervensi) dibandingkan dengan kelompok kontrol yang tidak menerimanya.
Salah satu pendekatannya adalah menempatkan peserta secara acak ke salah satu kelompok untuk meminimalkan bias. Penugasan acak membantu mengatribusikan perbedaan hasil pada perlakuan, bukan pada variabel lain. Namun, penugasan acak tidak selalu memungkinkan karena keterbatasan etis, praktis, atau logistik. Dalam kasus seperti ini, peneliti beralih ke alternatif, seperti studi observasional karena mereka hanya mengandalkan pengamatan atas apa yang terjadi secara alami di dunia nyata. Meskipun berharga, desain penelitian ini dapat menimbulkan bias seleksi yang memengaruhi hasil studi.
Untuk mengatasi masalah bias seleksi, para peneliti sering menggunakan propensity score—dan itu fokus tulisan ini. Setelah selesai, saya harap Anda mengikuti kursus kami untuk membangun fondasi yang kuat dalam pemikiran kausal. Mulailah dengan Foundations of Inference in Python untuk memahami prinsip inti seperti sebaran penarikan sampel. Lalu, lanjutkan ke Intermediate Regression in Python untuk pengalaman langsung dalam pemodelan (ini adalah keterampilan esensial untuk mengestimasi efek kausal). Inference for Linear Regression in R juga merupakan opsi yang bagus. Sekarang, mari kita mulai!
Apa itu Propensity Score?
Kita memahami bahwa ada situasi ketika penugasan acak bukan pilihan. Selain itu, kita juga harus menangani bias seleksi. Di sinilah metode yang disebut propensity score digunakan untuk menyeimbangkan kelompok dalam studi observasional. Propensity score adalah probabilitas bahwa seorang peserta akan menerima perlakuan tertentu berdasarkan karakteristik yang teramati.
Cara kerjanya
Metode ini dikembangkan oleh Rosenbaum dan Rubin pada 1980-an dan telah banyak digunakan di bidang kesehatan, ilmu sosial, dan ekonomi. Begini cara kerjanya:
- Peneliti mengumpulkan data tentang berbagai karakteristik (misalnya usia, pendidikan, pendapatan) yang mungkin memengaruhi apakah seorang peserta menerima perlakuan atau tidak. Kemudian, propensity score dihitung untuk setiap peserta yang menunjukkan kemungkinan mereka ditempatkan ke kelompok perlakuan berdasarkan karakteristik ini.
- Kini, peneliti dapat mencocokkan peserta dengan propensity score serupa antara kelompok perlakuan dan kontrol atau menerapkan metode pembobotan. Proses ini menciptakan kelompok yang lebih sebanding dalam hal karakteristik dasar.
- Kelompok yang seimbang seperti ini memudahkan peneliti menilai dampak perlakuan dengan lebih akurat sambil mengendalikan faktor perancu yang jika tidak akan membiasakan hasil.
Apa itu confounding
Sebelum kita lanjut, mari pahami apa yang dimaksud dengan confounding.Confounding terjadi ketika sebuah variabel luar, yang dikenal sebagai variabel perancu atau confounder, memengaruhi baik variabel bebas (perlakuan) maupun variabel terikat (hasil), yang berpotensi menimbulkan kesimpulan yang keliru tentang hubungan di antara keduanya.
Sebagai contoh, olahraga fisik adalah perancu untuk studi yang meneliti apakah minum kopi (variabel bebas) terkait dengan produktivitas yang lebih tinggi (variabel terikat). Itu karena orang yang lebih sering berolahraga mungkin juga lebih banyak minum kopi dan memiliki produktivitas lebih tinggi, sehingga sulit untuk mengetahui apakah kopi saja yang memengaruhi produktivitas atau apakah olahraga juga ikut berperan.
Dalam kasus ini, olahraga sebagai faktor perancu dapat menyesatkan peneliti dengan secara keliru menyiratkan hubungan yang lebih kuat antara kopi dan produktivitas daripada yang sebenarnya ada.
Metode Utama Menggunakan Propensity Score
Empat metode utama penerapan propensity score dalam studi observasional adalah pencocokan, stratifikasi, pembobotan probabilitas terbalik, dan penyesuaian kovariat. Mari bahas masing-masing secara rinci.
Propensity score matching
Propensity score matching memasangkan peserta dari kelompok perlakuan dengan peserta dari kelompok kontrol yang memiliki propensity score serupa. Proses pemadanan ini memperhitungkan agar kedua kelompok semirip mungkin, sehingga mengurangi kemungkinan bias. Dengan kata lain, individu dengan probabilitas menerima perlakuan yang sebanding dipasangkan untuk menciptakan sampel yang seimbang.
Pencocokan ideal ketika tujuannya adalah menciptakan kelompok yang langsung sebanding dan mengurangi perbedaan karakteristik semaksimal mungkin. Ukuran sampel yang sedang hingga besar lebih disukai karena memudahkan menemukan pasangan yang baik.
Dalam studi yang menilai dampak kerja jarak jauh terhadap produktivitas karyawan, peneliti dapat mencocokkan karyawan yang bekerja jarak jauh (perlakuan) dengan karyawan serupa yang bekerja di kantor (kontrol) berdasarkan variabel seperti peran pekerjaan, tahun pengalaman, dan metrik kinerja sebelumnya. Ini memungkinkan peneliti membandingkan hasil produktivitas sambil mengurangi dampak perbedaan latar belakang.
Stratifikasi
Stratifikasi adalah proses membagi peserta ke dalam kelompok berbeda, yang juga disebut strata, berdasarkan propensity score mereka. Sering kali, kelompok ini dibagi menjadi kuintil, yaitu lima bagian yang sama. Setiap strata memuat peserta dengan propensity score serupa, dan hasil dalam tiap strata dibandingkan antara kelompok perlakuan dan kontrol.
Metode ini efektif ketika ukuran sampel cukup besar untuk membuat beberapa strata yang bermakna, karena peserta yang terlalu sedikit per strata mungkin tidak menghasilkan perbandingan yang efektif.
Untuk menilai efektivitas obat baru dalam studi kesehatan, pasien dapat distratifikasi menjadi kuintil berdasarkan propensity score yang dihitung dari demografi dan kondisi kesehatan dasar. Setiap strata dapat mencakup pasien dengan karakteristik serupa, yang menghasilkan perbandingan efek perlakuan yang lebih akurat di tiap kelompok.
Inverse probability of treatment weighting (IPTW)
IPW memberikan bobot berdasarkan propensity score untuk memberi lebih banyak "kepentingan" pada observasi tertentu saat mengestimasi efek perlakuan. Peserta dengan kemungkinan lebih rendah untuk berada di kelompok masing-masing diberi bobot lebih besar untuk menyeimbangkan perbedaan karakteristik kelompok.
Karena secara proporsional memanfaatkan data dari kedua kelompok, IPW lebih disukai ketika peneliti perlu menggeneralisasi temuan ke seluruh populasi sampel.
Dalam studi kesehatan masyarakat yang mengevaluasi intervensi komunitas, IPW dapat diterapkan untuk memperhitungkan perbedaan demografis dan sosial-ekonomi antara komunitas yang menerima intervensi dan yang tidak. Ini memungkinkan temuan yang dapat digeneralisasi tanpa membuat pasangan yang dicocokkan. Berikut langkah-langkahnya:
1. Hitung propensity score
- Pertama, estimasikan propensity score untuk setiap individu dalam studi, yang merepresentasikan probabilitas mereka berada di kelompok perlakuan berdasarkan karakteristik dasar.
- Berdasarkan model regresi logistik, propensity score seorang peserta untuk menerima perlakuan adalah 0,8, atau 80%
2. Hitung bobot
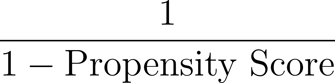
Selanjutnya, kita menghitung bobot berdasarkan invers dari propensity score, seperti di bawah ini:
- Untuk individu dalam kelompok perlakuan (menerima intervensi), bobotnya adalah:
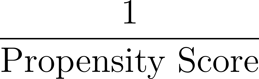
- Untuk individu dalam kelompok kontrol (tidak menerima intervensi), bobotnya adalah:
Dalam contoh kita, untuk individu dengan propensity score 0,8:
- Jika mereka berada di kelompok perlakuan, bobotnya akan:
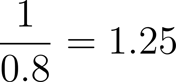
- Jika mereka berada di kelompok kontrol, bobotnya akan:
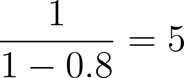
3. Terapkan bobot
Sekarang, terapkan bobot ini ke setiap individu dalam studi untuk membuat "pseudo-populasi" di mana pengaruh masing-masing individu terhadap analisis disesuaikan oleh bobotnya. Pseudo-populasi ini menyeimbangkan karakteristik dasar di seluruh kelompok perlakuan dan kontrol. Dalam pseudo-populasi yang dihasilkan, kemungkinan seorang individu berada di kelompok perlakuan atau kontrol tidak bergantung pada karakteristik dasarnya, sehingga mengurangi confounding.
Sebagai catatan, IPTW dapat digunakan untuk menangani banyak variabel perancu. Ini juga dapat diterapkan pada studi longitudinal untuk memperhitungkan confounding yang bergantung waktu.
Beberapa pertimbangan penting lainnya saat menggunakan IPTW meliputi:
- Menilai keseimbangan antara kelompok terekspos dan tidak terekspos untuk semua karakteristik dasar sebelum dan sesudah pembobotan
- Menangani bobot ekstrem melalui stabilisasi atau pemangkasan bobot
Penyesuaian kovariat
Dalam penyesuaian kovariat, kita menggunakan propensity score sebagai variabel kovariat tambahan dalam model regresi untuk mengendalikan faktor perancu. Penyesuaian ini meningkatkan estimasi efek perlakuan dengan menyesuaikan terhadap propensity score dalam model statistik, sehingga memperhitungkan confounding.
Sebagai contoh, saat meneliti dampak program pelatihan di tempat kerja terhadap kinerja karyawan, peneliti dapat menggunakan propensity score sebagai kovariat dalam model regresi untuk menyesuaikan faktor seperti usia atau tahun pengalaman.
Keuntungan Menggunakan Propensity Score
Sejauh ini, kita telah membahas berbagai desain penelitian, termasuk metode randomisasi dan observasi (ketika randomisasi tidak memungkinkan). Dalam studi observasional, kita membahas pentingnya propensity score dan keempat metodenya. Sekarang, mari bahas keuntungan menggunakan propensity score.
Meningkatkan keseimbangan kovariat
Propensity score memberikan perbandingan yang lebih seimbang antara kelompok perlakuan dan kontrol dengan menyamakan kovariat, atau karakteristik latar belakang, di seluruh kelompok. Ini memungkinkan peneliti menciptakan perbandingan yang lebih adil dengan distribusi variabel kunci (seperti usia, status sosial ekonomi, atau kondisi kesehatan) yang serupa, sehingga menghasilkan estimasi efek perlakuan yang akurat.
Saat mempelajari dampak pembelajaran daring terhadap hasil siswa, propensity score matching dapat menyeimbangkan kinerja akademik sebelumnya, akses internet, dan tingkat motivasi siswa di antara kelompok pembelajaran daring dan tradisional. Ini membantu memastikan bahwa perbedaan hasil lebih mungkin disebabkan oleh metode pembelajaran daripada perbedaan latar belakang siswa.
Mengurangi bias
Propensity score menyesuaikan perbedaan dalam karakteristik yang teramati, sehingga mengurangi bias dalam analisis. Ini sangat berharga dalam studi non-acak, ketika peneliti tidak dapat mengendalikan penugasan perlakuan.
Serbaguna
Propensity score itu fleksibel dan dapat digunakan untuk perlakuan biner (misalnya ya/tidak apakah seseorang menerima perlakuan) maupun perlakuan kontinu (misalnya seberapa banyak perlakuan yang diterima seseorang).
Keterbatasan Propensity Score
Meskipun propensity score itu kuat, penting juga mempertimbangkan keterbatasannya, seperti:
Ketergantungan pada kovariat yang teramati
Propensity score hanya dapat menyesuaikan kovariat yang teramati, yaitu variabel yang diukur peneliti dan dimasukkan ke dalam model. Namun, itu tidak serta-merta memperhitungkan perancu tersembunyi yang mungkin tidak teramati atau tidak terukur. Tak terelakkan, ini tetap menyisakan bias tersembunyi yang belum tertangani dan masih dapat memengaruhi hasil.
Sebagai contoh, saat membandingkan efek dua jenis terapi terhadap hasil kesehatan mental, peneliti mungkin memiliki data tentang usia, jenis kelamin, dan kondisi kesehatan dasar pasien. Namun, jika faktor yang tidak terukur seperti dukungan sosial atau mekanisme koping individu tidak diperhitungkan, faktor tersebut masih bisa memengaruhi hasil terapi.
Memerlukan ukuran sampel besar
Metode propensity score bekerja paling baik dengan dataset besar untuk memastikan terdapat tumpang tindih yang memadai antara kelompok perlakuan dan kontrol. Sampel yang lebih kecil sering kali menyebabkan kurangnya peserta yang cukup dengan propensity score serupa di seluruh kelompok, yang membuat tantangan untuk mencapai pencocokan yang baik atau pembobotan yang bermakna.
Kesalahan spesifikasi model propensity
Memilih variabel dan bentuk fungsional model yang tepat sangat penting untuk menspesifikasi model propensity dengan benar yang selanjutnya memengaruhi akurasinya. Gagal memasukkan variabel yang relevan atau spesifikasi model yang tidak tepat dapat menyebabkan estimasi bias, dan yang lebih buruk lagi masalah seperti ini sulit dideteksi.
Teknik Lanjutan: Pendekatan Doubly Robust dan Bayesian
Teknik lanjutan telah dikembangkan untuk mengatasi beberapa keterbatasan metode propensity score tradisional.
Metode doubly robust
Metode doubly robust adalah pendekatan dua langkah, di mana peneliti terlebih dahulu mengestimasi propensity score lalu mencocokkan atau membobot peserta sesuai. Kemudian, mereka memasang model regresi untuk memprediksi hasil berdasarkan perlakuan dan kovariat lain. Estimasi akhir efek perlakuan diperoleh dengan menyesuaikan baik terhadap propensity score maupun model regresi.
Propensity score Bayesian
Dalam metode Bayesian, ketidakpastian diikutsertakan dalam estimasi propensity score. Ini memungkinkan kita membuat estimasi yang lebih akurat, khususnya dalam situasi dengan ukuran sampel kecil atau ketidakpastian data yang besar. Jika Anda tertarik dengan pendekatan Bayesian, yang semakin umum digunakan, ikuti Fundamentals of Bayesian Data Analysis in R.
Kesalahan Umum dalam Analisis Propensity Score
Saat menggunakan propensity score, ada beberapa kesalahan umum yang perlu dihindari.
Keseimbangan kovariat yang tidak memadai
Setelah menerapkan metode propensity score, penting untuk memeriksa apakah kovariat seimbang antara kelompok perlakuan dan kontrol. Tanpa keseimbangan yang memadai, hasil kita masih bisa bias.
Spesifikasi model yang keliru
Spesifikasi model sangat krusial saat menghitung propensity score, karena spesifikasi yang tidak tepat dapat menyebabkan bias signifikan dalam estimasi efek perlakuan. Peneliti sering melakukan kesalahan baik dengan overfitting model (memasukkan terlalu banyak kovariat) atau dengan menghilangkan perancu penting.
Menyeimbangkan karakteristik kelompok perlakuan dan kontrol membantu kita meminimalkan bias dan memberikan estimasi efek perlakuan yang lebih andal. Namun, seperti metode statistik apa pun, metode ini harus diterapkan dengan hati-hati, dengan memperhatikan potensi keterbatasan dan kesalahan.
Penutup
Saya berharap Anda mengapresiasi propensity score, yang merupakan metode penting untuk meminimalkan bias dalam studi observasional karena mampu menyeimbangkan kelompok perlakuan dan kontrol berdasarkan karakteristik masing-masing. Teknik seperti pencocokan, stratifikasi, dan pembobotan membantu memastikan inferensi kausal yang lebih akurat dengan menangani faktor perancu.
Langkah berikutnya, daftarlah ke jalur karier Statistician in R kami. Jalur lengkap mencakup semuanya mulai dari regresi hingga pengujian hipotesis, analisis faktor hingga bootstrapping. Bahkan jika Anda tidak berencana menjadi seorang statistician, kursus ini tetap merupakan sumber belajar yang hebat dengan banyak materi untuk menjadikan Anda analis atau data scientist yang andal.




Melakukan penelitian yang menyeluruh itu kompleks dan memerlukan perencanaan yang cermat, termasuk bagaimana peserta ditugaskan ke kelompok perlakuan yang menerima treatment (atau intervensi) dibandingkan dengan kelompok kontrol yang tidak menerimanya.
Salah satu pendekatannya adalah menempatkan peserta secara acak ke salah satu kelompok untuk meminimalkan bias. Penugasan acak membantu mengatribusikan perbedaan hasil pada perlakuan, bukan pada variabel lain. Namun, penugasan acak tidak selalu memungkinkan karena keterbatasan etis, praktis, atau logistik. Dalam kasus seperti ini, peneliti beralih ke alternatif, seperti studi observasional karena mereka hanya mengandalkan pengamatan atas apa yang terjadi secara alami di dunia nyata. Meskipun berharga, desain penelitian ini dapat menimbulkan bias seleksi yang memengaruhi hasil studi.
Untuk mengatasi masalah bias seleksi, para peneliti sering menggunakan propensity score—dan itu fokus tulisan ini. Setelah selesai, saya harap Anda mengikuti kursus kami untuk membangun fondasi yang kuat dalam pemikiran kausal. Mulailah dengan Foundations of Inference in Python untuk memahami prinsip inti seperti sebaran penarikan sampel. Lalu, lanjutkan ke Intermediate Regression in Python untuk pengalaman langsung dalam pemodelan (ini adalah keterampilan esensial untuk mengestimasi efek kausal). Inference for Linear Regression in R juga merupakan opsi yang bagus. Sekarang, mari kita mulai!
Apa itu Propensity Score?
Kita memahami bahwa ada situasi ketika penugasan acak bukan pilihan. Selain itu, kita juga harus menangani bias seleksi. Di sinilah metode yang disebut propensity score digunakan untuk menyeimbangkan kelompok dalam studi observasional. Propensity score adalah probabilitas bahwa seorang peserta akan menerima perlakuan tertentu berdasarkan karakteristik yang teramati.
Cara kerjanya
Metode ini dikembangkan oleh Rosenbaum dan Rubin pada 1980-an dan telah banyak digunakan di bidang kesehatan, ilmu sosial, dan ekonomi. Begini cara kerjanya:
Apa itu confounding
Sebelum kita lanjut, mari pahami apa yang dimaksud dengan confounding.Confounding terjadi ketika sebuah variabel luar, yang dikenal sebagai variabel perancu atau confounder, memengaruhi baik variabel bebas (perlakuan) maupun variabel terikat (hasil), yang berpotensi menimbulkan kesimpulan yang keliru tentang hubungan di antara keduanya.
Sebagai contoh, olahraga fisik adalah perancu untuk studi yang meneliti apakah minum kopi (variabel bebas) terkait dengan produktivitas yang lebih tinggi (variabel terikat). Itu karena orang yang lebih sering berolahraga mungkin juga lebih banyak minum kopi dan memiliki produktivitas lebih tinggi, sehingga sulit untuk mengetahui apakah kopi saja yang memengaruhi produktivitas atau apakah olahraga juga ikut berperan.
Dalam kasus ini, olahraga sebagai faktor perancu dapat menyesatkan peneliti dengan secara keliru menyiratkan hubungan yang lebih kuat antara kopi dan produktivitas daripada yang sebenarnya ada.
Metode Utama Menggunakan Propensity Score
Empat metode utama penerapan propensity score dalam studi observasional adalah pencocokan, stratifikasi, pembobotan probabilitas terbalik, dan penyesuaian kovariat. Mari bahas masing-masing secara rinci.
Propensity score matching
Propensity score matching memasangkan peserta dari kelompok perlakuan dengan peserta dari kelompok kontrol yang memiliki propensity score serupa. Proses pemadanan ini memperhitungkan agar kedua kelompok semirip mungkin, sehingga mengurangi kemungkinan bias. Dengan kata lain, individu dengan probabilitas menerima perlakuan yang sebanding dipasangkan untuk menciptakan sampel yang seimbang.
Pencocokan ideal ketika tujuannya adalah menciptakan kelompok yang langsung sebanding dan mengurangi perbedaan karakteristik semaksimal mungkin. Ukuran sampel yang sedang hingga besar lebih disukai karena memudahkan menemukan pasangan yang baik.
Dalam studi yang menilai dampak kerja jarak jauh terhadap produktivitas karyawan, peneliti dapat mencocokkan karyawan yang bekerja jarak jauh (perlakuan) dengan karyawan serupa yang bekerja di kantor (kontrol) berdasarkan variabel seperti peran pekerjaan, tahun pengalaman, dan metrik kinerja sebelumnya. Ini memungkinkan peneliti membandingkan hasil produktivitas sambil mengurangi dampak perbedaan latar belakang.
Stratifikasi
Stratifikasi adalah proses membagi peserta ke dalam kelompok berbeda, yang juga disebut strata, berdasarkan propensity score mereka. Sering kali, kelompok ini dibagi menjadi kuintil, yaitu lima bagian yang sama. Setiap strata memuat peserta dengan propensity score serupa, dan hasil dalam tiap strata dibandingkan antara kelompok perlakuan dan kontrol.
Metode ini efektif ketika ukuran sampel cukup besar untuk membuat beberapa strata yang bermakna, karena peserta yang terlalu sedikit per strata mungkin tidak menghasilkan perbandingan yang efektif.
Untuk menilai efektivitas obat baru dalam studi kesehatan, pasien dapat distratifikasi menjadi kuintil berdasarkan propensity score yang dihitung dari demografi dan kondisi kesehatan dasar. Setiap strata dapat mencakup pasien dengan karakteristik serupa, yang menghasilkan perbandingan efek perlakuan yang lebih akurat di tiap kelompok.
Inverse probability of treatment weighting (IPTW)
IPW memberikan bobot berdasarkan propensity score untuk memberi lebih banyak "kepentingan" pada observasi tertentu saat mengestimasi efek perlakuan. Peserta dengan kemungkinan lebih rendah untuk berada di kelompok masing-masing diberi bobot lebih besar untuk menyeimbangkan perbedaan karakteristik kelompok.
Karena secara proporsional memanfaatkan data dari kedua kelompok, IPW lebih disukai ketika peneliti perlu menggeneralisasi temuan ke seluruh populasi sampel.
Dalam studi kesehatan masyarakat yang mengevaluasi intervensi komunitas, IPW dapat diterapkan untuk memperhitungkan perbedaan demografis dan sosial-ekonomi antara komunitas yang menerima intervensi dan yang tidak. Ini memungkinkan temuan yang dapat digeneralisasi tanpa membuat pasangan yang dicocokkan. Berikut langkah-langkahnya:
1. Hitung propensity score
2. Hitung bobot
Selanjutnya, kita menghitung bobot berdasarkan invers dari propensity score, seperti di bawah ini:
Dalam contoh kita, untuk individu dengan propensity score 0,8:
3. Terapkan bobot
Sekarang, terapkan bobot ini ke setiap individu dalam studi untuk membuat "pseudo-populasi" di mana pengaruh masing-masing individu terhadap analisis disesuaikan oleh bobotnya. Pseudo-populasi ini menyeimbangkan karakteristik dasar di seluruh kelompok perlakuan dan kontrol. Dalam pseudo-populasi yang dihasilkan, kemungkinan seorang individu berada di kelompok perlakuan atau kontrol tidak bergantung pada karakteristik dasarnya, sehingga mengurangi confounding.
Sebagai catatan, IPTW dapat digunakan untuk menangani banyak variabel perancu. Ini juga dapat diterapkan pada studi longitudinal untuk memperhitungkan confounding yang bergantung waktu.
Beberapa pertimbangan penting lainnya saat menggunakan IPTW meliputi:
Penyesuaian kovariat
Dalam penyesuaian kovariat, kita menggunakan propensity score sebagai variabel kovariat tambahan dalam model regresi untuk mengendalikan faktor perancu. Penyesuaian ini meningkatkan estimasi efek perlakuan dengan menyesuaikan terhadap propensity score dalam model statistik, sehingga memperhitungkan confounding.
Sebagai contoh, saat meneliti dampak program pelatihan di tempat kerja terhadap kinerja karyawan, peneliti dapat menggunakan propensity score sebagai kovariat dalam model regresi untuk menyesuaikan faktor seperti usia atau tahun pengalaman.
Keuntungan Menggunakan Propensity Score
Sejauh ini, kita telah membahas berbagai desain penelitian, termasuk metode randomisasi dan observasi (ketika randomisasi tidak memungkinkan). Dalam studi observasional, kita membahas pentingnya propensity score dan keempat metodenya. Sekarang, mari bahas keuntungan menggunakan propensity score.
Meningkatkan keseimbangan kovariat
Propensity score memberikan perbandingan yang lebih seimbang antara kelompok perlakuan dan kontrol dengan menyamakan kovariat, atau karakteristik latar belakang, di seluruh kelompok. Ini memungkinkan peneliti menciptakan perbandingan yang lebih adil dengan distribusi variabel kunci (seperti usia, status sosial ekonomi, atau kondisi kesehatan) yang serupa, sehingga menghasilkan estimasi efek perlakuan yang akurat.
Saat mempelajari dampak pembelajaran daring terhadap hasil siswa, propensity score matching dapat menyeimbangkan kinerja akademik sebelumnya, akses internet, dan tingkat motivasi siswa di antara kelompok pembelajaran daring dan tradisional. Ini membantu memastikan bahwa perbedaan hasil lebih mungkin disebabkan oleh metode pembelajaran daripada perbedaan latar belakang siswa.
Mengurangi bias
Propensity score menyesuaikan perbedaan dalam karakteristik yang teramati, sehingga mengurangi bias dalam analisis. Ini sangat berharga dalam studi non-acak, ketika peneliti tidak dapat mengendalikan penugasan perlakuan.
Serbaguna
Propensity score itu fleksibel dan dapat digunakan untuk perlakuan biner (misalnya ya/tidak apakah seseorang menerima perlakuan) maupun perlakuan kontinu (misalnya seberapa banyak perlakuan yang diterima seseorang).
Keterbatasan Propensity Score
Meskipun propensity score itu kuat, penting juga mempertimbangkan keterbatasannya, seperti:
Ketergantungan pada kovariat yang teramati
Propensity score hanya dapat menyesuaikan kovariat yang teramati, yaitu variabel yang diukur peneliti dan dimasukkan ke dalam model. Namun, itu tidak serta-merta memperhitungkan perancu tersembunyi yang mungkin tidak teramati atau tidak terukur. Tak terelakkan, ini tetap menyisakan bias tersembunyi yang belum tertangani dan masih dapat memengaruhi hasil.
Sebagai contoh, saat membandingkan efek dua jenis terapi terhadap hasil kesehatan mental, peneliti mungkin memiliki data tentang usia, jenis kelamin, dan kondisi kesehatan dasar pasien. Namun, jika faktor yang tidak terukur seperti dukungan sosial atau mekanisme koping individu tidak diperhitungkan, faktor tersebut masih bisa memengaruhi hasil terapi.
Memerlukan ukuran sampel besar
Metode propensity score bekerja paling baik dengan dataset besar untuk memastikan terdapat tumpang tindih yang memadai antara kelompok perlakuan dan kontrol. Sampel yang lebih kecil sering kali menyebabkan kurangnya peserta yang cukup dengan propensity score serupa di seluruh kelompok, yang membuat tantangan untuk mencapai pencocokan yang baik atau pembobotan yang bermakna.
Kesalahan spesifikasi model propensity
Memilih variabel dan bentuk fungsional model yang tepat sangat penting untuk menspesifikasi model propensity dengan benar yang selanjutnya memengaruhi akurasinya. Gagal memasukkan variabel yang relevan atau spesifikasi model yang tidak tepat dapat menyebabkan estimasi bias, dan yang lebih buruk lagi masalah seperti ini sulit dideteksi.
Teknik Lanjutan: Pendekatan Doubly Robust dan Bayesian
Teknik lanjutan telah dikembangkan untuk mengatasi beberapa keterbatasan metode propensity score tradisional.
Metode doubly robust
Metode doubly robust adalah pendekatan dua langkah, di mana peneliti terlebih dahulu mengestimasi propensity score lalu mencocokkan atau membobot peserta sesuai. Kemudian, mereka memasang model regresi untuk memprediksi hasil berdasarkan perlakuan dan kovariat lain. Estimasi akhir efek perlakuan diperoleh dengan menyesuaikan baik terhadap propensity score maupun model regresi.
Propensity score Bayesian
Dalam metode Bayesian, ketidakpastian diikutsertakan dalam estimasi propensity score. Ini memungkinkan kita membuat estimasi yang lebih akurat, khususnya dalam situasi dengan ukuran sampel kecil atau ketidakpastian data yang besar. Jika Anda tertarik dengan pendekatan Bayesian, yang semakin umum digunakan, ikuti Fundamentals of Bayesian Data Analysis in R.
Kesalahan Umum dalam Analisis Propensity Score
Saat menggunakan propensity score, ada beberapa kesalahan umum yang perlu dihindari.
Keseimbangan kovariat yang tidak memadai
Setelah menerapkan metode propensity score, penting untuk memeriksa apakah kovariat seimbang antara kelompok perlakuan dan kontrol. Tanpa keseimbangan yang memadai, hasil kita masih bisa bias.
Spesifikasi model yang keliru
Spesifikasi model sangat krusial saat menghitung propensity score, karena spesifikasi yang tidak tepat dapat menyebabkan bias signifikan dalam estimasi efek perlakuan. Peneliti sering melakukan kesalahan baik dengan overfitting model (memasukkan terlalu banyak kovariat) atau dengan menghilangkan perancu penting.
Menyeimbangkan karakteristik kelompok perlakuan dan kontrol membantu kita meminimalkan bias dan memberikan estimasi efek perlakuan yang lebih andal. Namun, seperti metode statistik apa pun, metode ini harus diterapkan dengan hati-hati, dengan memperhatikan potensi keterbatasan dan kesalahan.
Penutup
Saya berharap Anda mengapresiasi propensity score, yang merupakan metode penting untuk meminimalkan bias dalam studi observasional karena mampu menyeimbangkan kelompok perlakuan dan kontrol berdasarkan karakteristik masing-masing. Teknik seperti pencocokan, stratifikasi, dan pembobotan membantu memastikan inferensi kausal yang lebih akurat dengan menangani faktor perancu.
Langkah berikutnya, daftarlah ke jalur karier Statistician in R kami. Jalur lengkap mencakup semuanya mulai dari regresi hingga pengujian hipotesis, analisis faktor hingga bootstrapping. Bahkan jika Anda tidak berencana menjadi seorang statistician, kursus ini tetap merupakan sumber belajar yang hebat dengan banyak materi untuk menjadikan Anda analis atau data scientist yang andal.