Condurre una ricerca approfondita è complesso e richiede un'attenta pianificazione, incluso come assegnare i partecipanti ai gruppi: quelli che ricevono il trattamento (ovvero l'intervento) e i gruppi di controllo in cui non lo ricevono.
Un approccio è assegnare casualmente i partecipanti a uno dei due gruppi per minimizzare i bias. Questa assegnazione casuale aiuta ad attribuire le differenze negli esiti al trattamento, piuttosto che ad altre variabili. Tuttavia, l'assegnazione casuale non è sempre possibile per limiti etici, pratici o logistici. In questi casi, i ricercatori ricorrono ad alternative, come gli studi osservazionali, che si basano sull'osservare ciò che avviene naturalmente nel mondo reale. Pur essendo preziosi, questi disegni di ricerca possono portare a bias di selezione, influenzando gli esiti dello studio.
Per affrontare il problema del bias di selezione, i ricercatori usano spesso i propensity score — ed è questo il focus di questo post. Quando hai finito, spero che tu segua i nostri corsi per costruire solide basi nel pensiero causale. Inizia con Foundations of Inference in Python per comprendere principi chiave come le distribuzioni campionarie. Poi passa a Intermediate Regression in Python per fare pratica con il modeling (una competenza essenziale per stimare effetti causali). Inference for Linear Regression in R è un'altra ottima opzione. Ora iniziamo!
Che cos'è un Propensity Score?
Capita che l'assegnazione casuale non sia un'opzione. Inoltre, dobbiamo affrontare anche il bias di selezione. Qui entra in gioco un metodo chiamato propensity score, usato per bilanciare i gruppi negli studi osservazionali. Un propensity score è la probabilità che un partecipante riceva un determinato trattamento in base alle sue caratteristiche osservate.
Come funziona
Questo metodo è stato sviluppato da Rosenbaum e Rubin negli anni ’80 ed è ampiamente usato in sanità, scienze sociali ed economia. Ecco come funziona:
- I ricercatori raccolgono dati su varie caratteristiche (ad es. età, istruzione, reddito) che potrebbero influenzare il fatto che un partecipante riceva o meno il trattamento. Si calcola quindi per ciascun partecipante un propensity score che indica la probabilità di essere assegnato al gruppo di trattamento in base a queste caratteristiche.
- A questo punto, i ricercatori possono abbinare partecipanti con propensity score simili tra i gruppi di trattamento e di controllo o applicare metodi di ponderazione. Questo processo crea gruppi più confrontabili in termini di caratteristiche di base.
- Gruppi così bilanciati consentono di valutare più accuratamente l'impatto del trattamento controllando per i fattori confondenti che altrimenti potrebbero introdurre bias nei risultati.
Che cos'è il confondimento
Prima di proseguire, capiamo cosa significa confondimento. Il confondimento si verifica quando una variabile esterna, detta variabile confondente o confondente, influenza sia la variabile indipendente (trattamento) sia la variabile dipendente (esito), portando potenzialmente a conclusioni errate sulla relazione tra le due.
Per esempio, l'esercizio fisico è un confondente in uno studio che esamina se bere caffè (variabile indipendente) è associato a maggiore produttività (variabile dipendente). Questo perché chi fa più esercizio potrebbe anche bere più caffè ed essere più produttivo, rendendo difficile stabilire se sia il caffè a influenzare la produttività o se l'esercizio giochi un ruolo.
In questo caso, l'esercizio, il fattore confondente, potrebbe fuorviare i ricercatori suggerendo falsamente una relazione più forte tra caffè e produttività di quella reale.
Metodi chiave per usare i Propensity Score
I quattro metodi principali per applicare i propensity score negli studi osservazionali sono matching, stratificazione, ponderazione per probabilità inversa e aggiustamento per covariate. Vediamoli nel dettaglio.
Propensity score matching
Il propensity score matching abbina i partecipanti del gruppo di trattamento con partecipanti del gruppo di controllo che hanno propensity score simili. Questo abbinamento fa sì che i gruppi siano il più possibile simili, riducendo così la possibilità di bias. In altre parole, si mettono in coppia individui con probabilità comparabili di ricevere il trattamento per creare un campione bilanciato.
Il matching è ideale quando l'obiettivo è creare gruppi direttamente confrontabili e ridurre quanto più possibile le differenze nelle caratteristiche. È preferibile avere una dimensione campionaria da moderata a grande, perché facilita il reperimento di buoni abbinamenti.
In uno studio che valuta l'impatto del lavoro da remoto sulla produttività dei dipendenti, i ricercatori potrebbero abbinare chi lavora da remoto (trattamento) con dipendenti simili che lavorano in sede (controllo) in base a variabili come ruolo, anni di esperienza e metriche di performance pregresse. Questo permetterebbe di confrontare gli esiti di produttività riducendo l'impatto delle differenze di background.
Stratificazione
La stratificazione consiste nel dividere i partecipanti in gruppi distinti, detti anche strati, in base ai loro propensity score. Spesso questi gruppi sono suddivisi in quintili, cioè in cinque parti uguali. Ogni strato contiene partecipanti con propensity score simili e all'interno di ciascuno si confrontano gli esiti tra trattamento e controllo.
Questo metodo è efficace quando la dimensione del campione è abbastanza grande da creare più strati significativi, perché pochi partecipanti per strato potrebbero non consentire confronti efficaci.
Per valutare l'efficacia di un nuovo farmaco in uno studio sanitario, i pazienti possono essere stratificati in quintili in base a propensity score calcolati da dati demografici e condizioni di salute di base. Ogni strato includerà pazienti con caratteristiche simili, consentendo confronti più accurati dell'effetto del trattamento all'interno di ciascun gruppo.
Inverse probability of treatment weighting (IPTW)
L'IPW assegna pesi basati sui propensity score per dare più "importanza" ad alcune osservazioni nella stima degli effetti del trattamento. Ai partecipanti con minore probabilità di trovarsi nel rispettivo gruppo viene attribuito un peso maggiore per bilanciare le differenze nelle caratteristiche dei gruppi.
Poiché sfrutta proporzionalmente i dati di entrambi i gruppi, l'IPW è preferibile quando i ricercatori devono generalizzare i risultati all'intera popolazione campionaria.
In uno studio di sanità pubblica che valuta un intervento comunitario, l'IPW potrebbe essere applicato per tener conto delle differenze demografiche e socio-economiche tra le comunità che hanno ricevuto l'intervento e quelle che non l'hanno ricevuto. Questo consente risultati generalizzabili senza creare coppie abbinate. Ecco i passaggi:
1. Calcolare il propensity score
- Per prima cosa, stima il propensity score per ciascun individuo nello studio, che rappresenta la sua probabilità di essere nel gruppo di trattamento in base alle caratteristiche di base.
- Sulla base di un modello di regressione logistica, il propensity score di un partecipante che riceve il trattamento è 0,8, ovvero l'80%
2. Calcolare i pesi
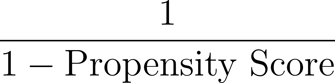
Successivamente, calcoliamo i pesi in base all'inverso del propensity score, come mostrato di seguito:
- Per gli individui nel gruppo di trattamento (che ricevono l'intervento), il peso è:
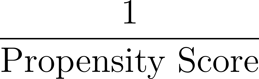
- Per gli individui nel gruppo di controllo (che non ricevono l'intervento), il peso è:
Nel nostro esempio, per l'individuo con un propensity score di 0,8:
- Se si trova nel gruppo di trattamento, il suo peso sarà:
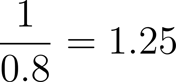
- Se si trova nel gruppo di controllo, il suo peso sarà:
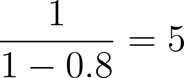
3. Applicare i pesi
Ora applica questi pesi a ciascun individuo nello studio per creare una "pseudo-popolazione" in cui l'influenza di ogni individuo sull'analisi è aggiustata dal suo peso. Questa pseudo-popolazione bilancia le caratteristiche di base tra gruppi di trattamento e controllo. Nella pseudo-popolazione risultante, la probabilità che un individuo sia nel gruppo di trattamento o di controllo è indipendente dalle sue caratteristiche di base, riducendo così il confondimento.
Nota: l'IPTW può essere usato per gestire un gran numero di variabili confondenti. Può anche essere applicato a studi longitudinali per considerare il confondimento dipendente dal tempo.
Altre considerazioni importanti quando si usa l'IPTW includono:
- Valutare il bilanciamento tra gruppi esposti e non esposti per tutte le caratteristiche di base prima e dopo la ponderazione
- Gestire i pesi estremi tramite stabilizzazione o troncamento dei pesi
Aggiustamento per covariate
Nell'aggiustamento per covariate, usiamo i propensity score come una variabile di covariata aggiuntiva in un modello di regressione per controllare i fattori confondenti. Questo aggiustamento migliora la stima dell'effetto del trattamento correggendo per i propensity score all'interno del modello statistico, tenendo così conto del confondimento.
Ad esempio, studiando l'effetto di un programma di formazione aziendale sulla performance dei dipendenti, i ricercatori potrebbero usare i propensity score come covariate in un modello di regressione per aggiustare fattori come età o anni di esperienza.
Vantaggi dell'uso dei Propensity Score
Finora abbiamo discusso diversi disegni di ricerca, inclusi randomizzazione e metodi osservazionali (dove la randomizzazione non è fattibile). Nel caso degli studi osservazionali, abbiamo visto l'importanza dei propensity score e dei loro quattro metodi. Ora vediamo i vantaggi dell'uso dei propensity score.
Migliora il bilanciamento delle covariate
I propensity score consentono un confronto più equilibrato tra gruppi di trattamento e di controllo, uguagliando le covariate, ovvero le caratteristiche di background, tra i gruppi. Questo permette un confronto più equo con distribuzioni simili delle variabili chiave (come età, stato socioeconomico o condizioni di salute), portando a stime più accurate dell'effetto del trattamento.
Studiando l'impatto dell'apprendimento online sui risultati degli studenti, il matching con propensity score potrebbe bilanciare la performance accademica pregressa, l'accesso a Internet e i livelli di motivazione tra gruppi di apprendimento online e tradizionale. Questo aiuta a garantire che le differenze negli esiti siano più probabilmente dovute al metodo di apprendimento piuttosto che alle differenze di background degli studenti.
Riduce i bias
I propensity score aggiustano per differenze nelle caratteristiche osservate, riducendo così il bias nelle analisi. Ciò è particolarmente utile negli studi non randomizzati, dove i ricercatori non possono controllare l'assegnazione al trattamento.
Versatilità
I propensity score sono flessibili e possono essere usati sia con trattamenti binari (ad es. domande sì/no sul fatto che qualcuno abbia ricevuto il trattamento) sia con trattamenti continui (ad es. quanto trattamento è stato ricevuto).
Limiti dei Propensity Score
Pur essendo potenti, è importante considerare anche i limiti dei propensity score, come:
Dipendenza dalle covariate osservate
I propensity score possono aggiustare solo per le covariate osservate, cioè le variabili che i ricercatori hanno misurato e incluso nel modello. Ma questo non tiene necessariamente conto dei confondenti nascosti che potrebbero essere non osservati o non misurati. Inevitabilmente, lascia irrisolti bias nascosti che potrebbero ancora influenzare l'esito.
Ad esempio, confrontando gli effetti di due tipi di terapia sugli esiti di salute mentale, i ricercatori possono avere dati su età, genere e salute di base dei pazienti. Tuttavia, se fattori non misurati come il supporto sociale o i meccanismi di coping individuali non vengono considerati, potrebbero comunque influenzare gli esiti della terapia.
Richiede grandi campioni
I metodi basati sui propensity score funzionano al meglio con dataset ampi, per garantire sufficiente sovrapposizione tra gruppi di trattamento e controllo. Campioni piccoli spesso portano a una carenza di partecipanti con propensity score simili tra gruppi, rendendo difficile ottenere buoni abbinamenti o ponderazioni significative.
Specificazione errata del modello di propensity
Selezionare le variabili giuste e la forma funzionale del modello è cruciale per specificare correttamente il modello di propensity, che a sua volta ne influenza l'accuratezza. Non includere variabili rilevanti o una specificazione inappropriata può portare a stime distorte e, cosa peggiore, problemi di questo tipo sono difficili da rilevare.
Tecniche avanzate: metodi doppiamente robusti e approcci bayesiani
Sono state sviluppate tecniche avanzate per affrontare alcuni limiti dei metodi tradizionali basati sui propensity score.
Metodi doppiamente robusti
I metodi doppiamente robusti sono un approccio in due fasi: prima i ricercatori stimano i propensity score e abbinano o ponderano i partecipanti di conseguenza. Poi adattano un modello di regressione per predire l'esito in base al trattamento e ad altre covariate. La stima finale dell'effetto del trattamento si ottiene aggiustando sia per il propensity score sia per il modello di regressione.
Propensity score bayesiani
Nei metodi bayesiani si incorpora l'incertezza nella stima dei propensity score. Questo consente stime più accurate, in particolare in situazioni con campioni ridotti o maggiore incertezza sui dati. Se ti interessano gli approcci bayesiani, sempre più diffusi, segui il nostro Fundamentals of Bayesian Data Analysis in R.
Errori comuni nell'analisi con Propensity Score
Quando si usano i propensity score, ci sono errori comuni da evitare.
Bilanciamento delle covariate insufficiente
Dopo aver applicato i metodi basati sui propensity score, è importante verificare se le covariate sono bilanciate tra gruppi di trattamento e di controllo. Senza un bilanciamento sufficiente, i risultati potrebbero essere ancora distorti.
Specificazione del modello errata
La specificazione del modello è cruciale quando si calcolano i propensity score, poiché una specificazione impropria può portare a bias significativi nelle stime dell'effetto del trattamento. Errori comuni sono l'overfitting del modello (includendo troppe covariate) o l'omissione di confondenti importanti.
Bilanciare le caratteristiche dei gruppi di trattamento e controllo ci aiuta a minimizzare i bias e fornire stime più affidabili degli effetti del trattamento. Tuttavia, come ogni metodo statistico, va applicato con cura, prestando attenzione a limiti ed errori potenziali.
Considerazioni finali
Spero che tu apprezzi i propensity score, un metodo importante per minimizzare i bias negli studi osservazionali perché bilanciano in modo efficace gruppi di trattamento e di controllo in base alle rispettive caratteristiche. Tecniche come matching, stratificazione e ponderazione aiutano a garantire inferenze causali più accurate affrontando i fattori confondenti.
Come prossimo passo, iscriviti al nostro career track Statistician in R. Il percorso completo copre tutto, dalla regressione ai test d'ipotesi, dall'analisi fattoriale al bootstrapping. Anche se non hai in programma di diventare statistic*ə, il corso resta una grande risorsa ricca di contenuti per diventare un ottimo analyst o data scientist.






Condurre una ricerca approfondita è complesso e richiede un'attenta pianificazione, incluso come assegnare i partecipanti ai gruppi: quelli che ricevono il trattamento (ovvero l'intervento) e i gruppi di controllo in cui non lo ricevono.
Un approccio è assegnare casualmente i partecipanti a uno dei due gruppi per minimizzare i bias. Questa assegnazione casuale aiuta ad attribuire le differenze negli esiti al trattamento, piuttosto che ad altre variabili. Tuttavia, l'assegnazione casuale non è sempre possibile per limiti etici, pratici o logistici. In questi casi, i ricercatori ricorrono ad alternative, come gli studi osservazionali, che si basano sull'osservare ciò che avviene naturalmente nel mondo reale. Pur essendo preziosi, questi disegni di ricerca possono portare a bias di selezione, influenzando gli esiti dello studio.
Per affrontare il problema del bias di selezione, i ricercatori usano spesso i propensity score — ed è questo il focus di questo post. Quando hai finito, spero che tu segua i nostri corsi per costruire solide basi nel pensiero causale. Inizia con Foundations of Inference in Python per comprendere principi chiave come le distribuzioni campionarie. Poi passa a Intermediate Regression in Python per fare pratica con il modeling (una competenza essenziale per stimare effetti causali). Inference for Linear Regression in R è un'altra ottima opzione. Ora iniziamo!
Che cos'è un Propensity Score?
Capita che l'assegnazione casuale non sia un'opzione. Inoltre, dobbiamo affrontare anche il bias di selezione. Qui entra in gioco un metodo chiamato propensity score, usato per bilanciare i gruppi negli studi osservazionali. Un propensity score è la probabilità che un partecipante riceva un determinato trattamento in base alle sue caratteristiche osservate.
Come funziona
Questo metodo è stato sviluppato da Rosenbaum e Rubin negli anni ’80 ed è ampiamente usato in sanità, scienze sociali ed economia. Ecco come funziona:
Che cos'è il confondimento
Prima di proseguire, capiamo cosa significa confondimento. Il confondimento si verifica quando una variabile esterna, detta variabile confondente o confondente, influenza sia la variabile indipendente (trattamento) sia la variabile dipendente (esito), portando potenzialmente a conclusioni errate sulla relazione tra le due.
Per esempio, l'esercizio fisico è un confondente in uno studio che esamina se bere caffè (variabile indipendente) è associato a maggiore produttività (variabile dipendente). Questo perché chi fa più esercizio potrebbe anche bere più caffè ed essere più produttivo, rendendo difficile stabilire se sia il caffè a influenzare la produttività o se l'esercizio giochi un ruolo.
In questo caso, l'esercizio, il fattore confondente, potrebbe fuorviare i ricercatori suggerendo falsamente una relazione più forte tra caffè e produttività di quella reale.
Metodi chiave per usare i Propensity Score
I quattro metodi principali per applicare i propensity score negli studi osservazionali sono matching, stratificazione, ponderazione per probabilità inversa e aggiustamento per covariate. Vediamoli nel dettaglio.
Propensity score matching
Il propensity score matching abbina i partecipanti del gruppo di trattamento con partecipanti del gruppo di controllo che hanno propensity score simili. Questo abbinamento fa sì che i gruppi siano il più possibile simili, riducendo così la possibilità di bias. In altre parole, si mettono in coppia individui con probabilità comparabili di ricevere il trattamento per creare un campione bilanciato.
Il matching è ideale quando l'obiettivo è creare gruppi direttamente confrontabili e ridurre quanto più possibile le differenze nelle caratteristiche. È preferibile avere una dimensione campionaria da moderata a grande, perché facilita il reperimento di buoni abbinamenti.
In uno studio che valuta l'impatto del lavoro da remoto sulla produttività dei dipendenti, i ricercatori potrebbero abbinare chi lavora da remoto (trattamento) con dipendenti simili che lavorano in sede (controllo) in base a variabili come ruolo, anni di esperienza e metriche di performance pregresse. Questo permetterebbe di confrontare gli esiti di produttività riducendo l'impatto delle differenze di background.
Stratificazione
La stratificazione consiste nel dividere i partecipanti in gruppi distinti, detti anche strati, in base ai loro propensity score. Spesso questi gruppi sono suddivisi in quintili, cioè in cinque parti uguali. Ogni strato contiene partecipanti con propensity score simili e all'interno di ciascuno si confrontano gli esiti tra trattamento e controllo.
Questo metodo è efficace quando la dimensione del campione è abbastanza grande da creare più strati significativi, perché pochi partecipanti per strato potrebbero non consentire confronti efficaci.
Per valutare l'efficacia di un nuovo farmaco in uno studio sanitario, i pazienti possono essere stratificati in quintili in base a propensity score calcolati da dati demografici e condizioni di salute di base. Ogni strato includerà pazienti con caratteristiche simili, consentendo confronti più accurati dell'effetto del trattamento all'interno di ciascun gruppo.
Inverse probability of treatment weighting (IPTW)
L'IPW assegna pesi basati sui propensity score per dare più "importanza" ad alcune osservazioni nella stima degli effetti del trattamento. Ai partecipanti con minore probabilità di trovarsi nel rispettivo gruppo viene attribuito un peso maggiore per bilanciare le differenze nelle caratteristiche dei gruppi.
Poiché sfrutta proporzionalmente i dati di entrambi i gruppi, l'IPW è preferibile quando i ricercatori devono generalizzare i risultati all'intera popolazione campionaria.
In uno studio di sanità pubblica che valuta un intervento comunitario, l'IPW potrebbe essere applicato per tener conto delle differenze demografiche e socio-economiche tra le comunità che hanno ricevuto l'intervento e quelle che non l'hanno ricevuto. Questo consente risultati generalizzabili senza creare coppie abbinate. Ecco i passaggi:
1. Calcolare il propensity score
2. Calcolare i pesi
Successivamente, calcoliamo i pesi in base all'inverso del propensity score, come mostrato di seguito:
Nel nostro esempio, per l'individuo con un propensity score di 0,8:
3. Applicare i pesi
Ora applica questi pesi a ciascun individuo nello studio per creare una "pseudo-popolazione" in cui l'influenza di ogni individuo sull'analisi è aggiustata dal suo peso. Questa pseudo-popolazione bilancia le caratteristiche di base tra gruppi di trattamento e controllo. Nella pseudo-popolazione risultante, la probabilità che un individuo sia nel gruppo di trattamento o di controllo è indipendente dalle sue caratteristiche di base, riducendo così il confondimento.
Nota: l'IPTW può essere usato per gestire un gran numero di variabili confondenti. Può anche essere applicato a studi longitudinali per considerare il confondimento dipendente dal tempo.
Altre considerazioni importanti quando si usa l'IPTW includono:
Aggiustamento per covariate
Nell'aggiustamento per covariate, usiamo i propensity score come una variabile di covariata aggiuntiva in un modello di regressione per controllare i fattori confondenti. Questo aggiustamento migliora la stima dell'effetto del trattamento correggendo per i propensity score all'interno del modello statistico, tenendo così conto del confondimento.
Ad esempio, studiando l'effetto di un programma di formazione aziendale sulla performance dei dipendenti, i ricercatori potrebbero usare i propensity score come covariate in un modello di regressione per aggiustare fattori come età o anni di esperienza.
Vantaggi dell'uso dei Propensity Score
Finora abbiamo discusso diversi disegni di ricerca, inclusi randomizzazione e metodi osservazionali (dove la randomizzazione non è fattibile). Nel caso degli studi osservazionali, abbiamo visto l'importanza dei propensity score e dei loro quattro metodi. Ora vediamo i vantaggi dell'uso dei propensity score.
Migliora il bilanciamento delle covariate
I propensity score consentono un confronto più equilibrato tra gruppi di trattamento e di controllo, uguagliando le covariate, ovvero le caratteristiche di background, tra i gruppi. Questo permette un confronto più equo con distribuzioni simili delle variabili chiave (come età, stato socioeconomico o condizioni di salute), portando a stime più accurate dell'effetto del trattamento.
Studiando l'impatto dell'apprendimento online sui risultati degli studenti, il matching con propensity score potrebbe bilanciare la performance accademica pregressa, l'accesso a Internet e i livelli di motivazione tra gruppi di apprendimento online e tradizionale. Questo aiuta a garantire che le differenze negli esiti siano più probabilmente dovute al metodo di apprendimento piuttosto che alle differenze di background degli studenti.
Riduce i bias
I propensity score aggiustano per differenze nelle caratteristiche osservate, riducendo così il bias nelle analisi. Ciò è particolarmente utile negli studi non randomizzati, dove i ricercatori non possono controllare l'assegnazione al trattamento.
Versatilità
I propensity score sono flessibili e possono essere usati sia con trattamenti binari (ad es. domande sì/no sul fatto che qualcuno abbia ricevuto il trattamento) sia con trattamenti continui (ad es. quanto trattamento è stato ricevuto).
Limiti dei Propensity Score
Pur essendo potenti, è importante considerare anche i limiti dei propensity score, come:
Dipendenza dalle covariate osservate
I propensity score possono aggiustare solo per le covariate osservate, cioè le variabili che i ricercatori hanno misurato e incluso nel modello. Ma questo non tiene necessariamente conto dei confondenti nascosti che potrebbero essere non osservati o non misurati. Inevitabilmente, lascia irrisolti bias nascosti che potrebbero ancora influenzare l'esito.
Ad esempio, confrontando gli effetti di due tipi di terapia sugli esiti di salute mentale, i ricercatori possono avere dati su età, genere e salute di base dei pazienti. Tuttavia, se fattori non misurati come il supporto sociale o i meccanismi di coping individuali non vengono considerati, potrebbero comunque influenzare gli esiti della terapia.
Richiede grandi campioni
I metodi basati sui propensity score funzionano al meglio con dataset ampi, per garantire sufficiente sovrapposizione tra gruppi di trattamento e controllo. Campioni piccoli spesso portano a una carenza di partecipanti con propensity score simili tra gruppi, rendendo difficile ottenere buoni abbinamenti o ponderazioni significative.
Specificazione errata del modello di propensity
Selezionare le variabili giuste e la forma funzionale del modello è cruciale per specificare correttamente il modello di propensity, che a sua volta ne influenza l'accuratezza. Non includere variabili rilevanti o una specificazione inappropriata può portare a stime distorte e, cosa peggiore, problemi di questo tipo sono difficili da rilevare.
Tecniche avanzate: metodi doppiamente robusti e approcci bayesiani
Sono state sviluppate tecniche avanzate per affrontare alcuni limiti dei metodi tradizionali basati sui propensity score.
Metodi doppiamente robusti
I metodi doppiamente robusti sono un approccio in due fasi: prima i ricercatori stimano i propensity score e abbinano o ponderano i partecipanti di conseguenza. Poi adattano un modello di regressione per predire l'esito in base al trattamento e ad altre covariate. La stima finale dell'effetto del trattamento si ottiene aggiustando sia per il propensity score sia per il modello di regressione.
Propensity score bayesiani
Nei metodi bayesiani si incorpora l'incertezza nella stima dei propensity score. Questo consente stime più accurate, in particolare in situazioni con campioni ridotti o maggiore incertezza sui dati. Se ti interessano gli approcci bayesiani, sempre più diffusi, segui il nostro Fundamentals of Bayesian Data Analysis in R.
Errori comuni nell'analisi con Propensity Score
Quando si usano i propensity score, ci sono errori comuni da evitare.
Bilanciamento delle covariate insufficiente
Dopo aver applicato i metodi basati sui propensity score, è importante verificare se le covariate sono bilanciate tra gruppi di trattamento e di controllo. Senza un bilanciamento sufficiente, i risultati potrebbero essere ancora distorti.
Specificazione del modello errata
La specificazione del modello è cruciale quando si calcolano i propensity score, poiché una specificazione impropria può portare a bias significativi nelle stime dell'effetto del trattamento. Errori comuni sono l'overfitting del modello (includendo troppe covariate) o l'omissione di confondenti importanti.
Bilanciare le caratteristiche dei gruppi di trattamento e controllo ci aiuta a minimizzare i bias e fornire stime più affidabili degli effetti del trattamento. Tuttavia, come ogni metodo statistico, va applicato con cura, prestando attenzione a limiti ed errori potenziali.
Considerazioni finali
Spero che tu apprezzi i propensity score, un metodo importante per minimizzare i bias negli studi osservazionali perché bilanciano in modo efficace gruppi di trattamento e di controllo in base alle rispettive caratteristiche. Tecniche come matching, stratificazione e ponderazione aiutano a garantire inferenze causali più accurate affrontando i fattori confondenti.
Come prossimo passo, iscriviti al nostro career track Statistician in R. Il percorso completo copre tutto, dalla regressione ai test d'ipotesi, dall'analisi fattoriale al bootstrapping. Anche se non hai in programma di diventare statistic*ə, il corso resta una grande risorsa ricca di contenuti per diventare un ottimo analyst o data scientist.