开展扎实的研究十分复杂,需进行周密规划,其中包括如何将参与者分配到包含处理(或称干预)的处理组,以及未接受处理的对照组。
一种方法是将参与者随机分配到任一组,以尽量减少偏差。随机分配有助于将结果差异归因于处理本身,而非其他变量。然而,由于伦理、实际或后勤方面的限制,随机分配并非总是可行。在这种情况下,研究者会转向其他选择,如观察性研究,因为它们仅依赖于对现实世界中自然发生情况的观察。尽管有价值,这些研究设计可能导致选择偏差,从而影响研究结果。
为解决选择偏差问题,研究人员常使用倾向评分——这正是本文的重点。阅读完后,欢迎您选修我们的课程,为因果思维打下坚实基础。先从Foundations of Inference in Python开始,了解抽样分布等核心原理。随后学习Intermediate Regression in Python,获得建模的实操经验(这是估计因果效应的关键技能)。Inference for Linear Regression in R也是很好的选择。现在,让我们开始吧!
什么是倾向评分?
我们知道,在某些情境下随机分配并不可行。除此之外,我们还必须应对选择偏差。这时就会用到一种称为倾向评分的方法,用于在观察性研究中平衡各组。倾向评分是指基于被试的可观测特征,其接受特定处理的概率。
其工作原理
该方法由 Rosenbaum 和 Rubin 于 20 世纪 80 年代提出,并被广泛应用于医疗、社会科学和经济学领域。其基本流程如下:
- 研究者收集多种可能影响参与者是否接受处理的特征数据(如年龄、教育、收入)。随后为每位参与者计算倾向评分,用以体现其基于这些特征被分配到处理组的可能性。
- 接着,研究者可在处理组与对照组间匹配倾向评分相似的参与者,或采用加权方法。该过程可在基线特征方面构建更具可比性的组别。
- 这种平衡后的分组更便于研究者在控制潜在混杂因素的同时,更准确地评估处理的影响。
什么是混杂
在进一步展开之前,先来理解“混杂”的含义。当一个外在变量(称为混杂变量或混杂因子)同时影响自变量(处理)和因变量(结果)时,就会发生混杂,从而可能导致对二者关系的错误结论。
例如,在研究饮用咖啡(自变量)是否与更高的生产力(因变量)相关时,体育锻炼就是一个混杂因素。这是因为更多锻炼的人可能也更常喝咖啡且生产力更高,导致难以判断仅咖啡是否影响生产力,还是锻炼也部分起了作用。
在这种情况下,锻炼这一混杂因素可能会误导研究者,虚假地暗示咖啡与生产力之间存在比实际更强的关系。
使用倾向评分的关键方法
在观察性研究中应用倾向评分的四种主要方法是匹配、分层、逆概率加权以及协变量调整。下面分别介绍。
倾向评分匹配
倾向评分匹配将处理组的参与者与对照组中倾向评分相近的参与者配对。该配对过程尽量确保两组尽可能相似,从而降低偏差的可能性。换言之,将具有相似接受处理概率的个体配对,以构建平衡的样本。
当目标是构建可直接比较的组别,并尽量减少特征差异时,匹配是理想选择。样本量以中到大为佳,有助于找到更好的匹配对象。
在评估远程办公对员工生产力影响的研究中,研究者可根据岗位、工作年限和既往绩效等变量,将远程办公员工(处理)与相似的现场办公员工(对照)进行匹配。这样可在减少背景差异影响的同时比较生产力结果。
分层
分层是指根据倾向评分将参与者划分为不同的组(层)。通常按五分位(即五等分)进行划分。每个层内包含倾向评分相近的参与者,并在每个层内比较处理组与对照组的结果。
当样本量足够大、可构建若干具备实际意义的层时,该方法更有效;若每层参与者过少,可能无法进行有效比较。
在评估新药疗效的医疗研究中,可基于人口统计学与基线健康状况计算的倾向评分将患者分为五分位层。每层包含特征相近的患者,从而在各层内更准确地比较治疗效果。
处理的逆概率加权(IPTW)
IPW 基于倾向评分分配权重,在估计处理效应时为某些观测赋予更高“重要性”。对其所在组概率较低的参与者给予更大权重,以平衡组间特征差异。
由于它按比例利用两组的数据,当研究者需要将发现推广到整个样本总体时,IPW 更受青睐。
在评估社区干预的公共卫生研究中,可应用 IPW 来考虑接受干预与未接受干预社区之间在人口与社会经济方面的差异。这样无需创建匹配对也能得到可推广的结论。步骤如下:
1. 计算倾向评分
- 首先为研究中的每个个体估计倾向评分,表示其基于基线特征进入处理组的概率。
- 基于逻辑回归模型,某参与者接受处理的倾向评分为 0.8,即 80%
2. 计算权重
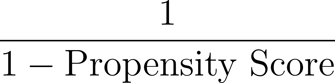
接下来根据倾向评分的倒数计算权重,如下所示:
- 对于处理组个体(接受干预),权重为:
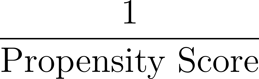
- 对于未接受干预的对照组个体,权重为:
在我们的示例中,对于倾向评分为 0.8 的个体:
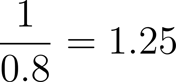
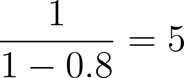
3. 应用权重
现在,将这些权重应用于研究中的每个个体,创建一个“伪总体”,其中每个个体对分析的影响由其权重进行调整。该伪总体在处理组与对照组之间平衡了基线特征。在生成的伪总体中,个体处于处理组或对照组的可能性与其基线特征相互独立,从而减少混杂。
需要说明的是,IPTW 可用于处理大量混杂变量,也可应用于纵向研究以处理时间相关的混杂。
使用 IPTW 时的其他重要考虑包括:
- 在加权前后评估暴露组与未暴露组在所有基线特征上的平衡性
- 通过权重稳定化或截断来处理极端权重
协变量调整
在协变量调整中,我们将倾向评分作为回归模型中的一个额外协变量来控制混杂因素。通过在统计模型内对倾向评分进行调整,从而改进处理效应的估计并考虑混杂。
例如,在研究职场培训项目对员工绩效的影响时,研究者可将倾向评分作为协变量纳入回归模型,以调整年龄或工作年限等因素。
使用倾向评分的优势
到目前为止,我们已讨论了不同的研究设计,包括随机化和(随机化不可行时的)观察性方法。在观察性研究中,我们阐述了倾向评分及其四种方法的重要性。现在,让我们来看看使用倾向评分的优势。
改善协变量平衡
通过在组间使协变量(或背景特征)相当,倾向评分可在处理组与对照组之间提供更平衡的比较。这使研究者能在关键变量(如年龄、社会经济地位或健康状况)具有相似分布的前提下,进行更公平的比较,从而更准确地估计处理效应。
在研究在线学习对学生结果影响时,倾向评分匹配可在在线与传统学习组之间平衡学生既往学业表现、上网条件与动机水平。这有助于确保结果差异更可能来自学习方式本身,而非学生背景差异。
降低偏差
倾向评分通过调整可观测特征差异来降低分析中的偏差。这在无法控制处理分配的非随机化研究中特别有价值。
通用性强
倾向评分灵活,可用于二元处理(如是否接受处理的“是/否”问题)和连续处理(如接受处理的剂量或强度)。
倾向评分的局限性
尽管倾向评分十分有用,但也需考虑其局限性,例如:
依赖于可观测协变量
倾向评分只能调整可观测协变量,即研究者测量并纳入模型的变量。但这未必能控制未观测或未测量的潜在混杂因素。难免仍会有隐性偏差未被处理,进而影响结果。
例如,在比较两种疗法对心理健康结果的影响时,研究者或许拥有患者年龄、性别与基线健康状况的数据。但若未测量的因素(如社会支持或个体应对机制)未被控制,仍可能影响疗法的效果。
需要较大的样本量
倾向评分方法在大型数据集上表现最佳,以确保处理组与对照组之间有足够的重叠。样本量较小时,往往难以在各组间找到足够倾向评分相近的参与者,从而难以实现良好的匹配或具意义的加权。
倾向模型设定错误
正确选择变量与模型的函数形式对于恰当设定倾向模型至关重要,并会影响其准确性。若遗漏相关变量或模型设定不当,可能导致有偏估计;更糟的是,这类问题往往难以察觉。
进阶技术:双重稳健与贝叶斯方法
为应对传统倾向评分方法的一些局限,已经发展出进阶技术。
双重稳健方法
双重稳健方法是一个两步法:研究者先估计倾向评分,并据此进行匹配或加权;随后拟合回归模型,根据处理与其他协变量预测结果。最终的处理效应估计通过同时调整倾向评分与回归模型获得。
贝叶斯倾向评分
在贝叶斯方法中,会将不确定性纳入倾向评分的估计。这使我们在样本量较小或数据不确定性较大的情况下,能够做出更准确的估计。如果您对日益常见的贝叶斯方法感兴趣,欢迎选修我们的Fundamentals of Bayesian Data Analysis in R。
倾向评分分析中的常见错误
使用倾向评分时,有一些常见错误需要避免。
协变量平衡不足
在应用倾向评分方法后,务必检查处理组与对照组之间的协变量是否达到平衡。若平衡不足,结果仍可能存在偏差。
模型设定不当
在计算倾向评分时,模型设定至关重要,设定不当会导致处理效应估计产生显著偏差。常见错误包括过拟合(纳入过多协变量)或遗漏重要的混杂因素。
平衡处理组与对照组的特征有助于我们最小化偏差,并提供更可靠的处理效应估计。但与任何统计方法一样,必须谨慎应用,并关注潜在的局限与错误。
结语
希望您能认识到倾向评分的价值:它是观察性研究中最小化偏差的重要方法,因为它能根据各自特征很好地平衡处理组与对照组。匹配、分层与加权等技术通过解决混杂因素,有助于确保更准确的因果推断。
下一步,欢迎报名我们的Statistician in R职业路径。完整路径涵盖从回归到假设检验、从因子分析到自助法的一切内容。即便您不打算成为统计学家,该课程仍是极佳的学习资源,能帮助您成为出色的分析师或数据科学家。


开展扎实的研究十分复杂,需进行周密规划,其中包括如何将参与者分配到包含处理(或称干预)的处理组,以及未接受处理的对照组。
一种方法是将参与者随机分配到任一组,以尽量减少偏差。随机分配有助于将结果差异归因于处理本身,而非其他变量。然而,由于伦理、实际或后勤方面的限制,随机分配并非总是可行。在这种情况下,研究者会转向其他选择,如观察性研究,因为它们仅依赖于对现实世界中自然发生情况的观察。尽管有价值,这些研究设计可能导致选择偏差,从而影响研究结果。
为解决选择偏差问题,研究人员常使用倾向评分——这正是本文的重点。阅读完后,欢迎您选修我们的课程,为因果思维打下坚实基础。先从Foundations of Inference in Python开始,了解抽样分布等核心原理。随后学习Intermediate Regression in Python,获得建模的实操经验(这是估计因果效应的关键技能)。Inference for Linear Regression in R也是很好的选择。现在,让我们开始吧!
什么是倾向评分?
我们知道,在某些情境下随机分配并不可行。除此之外,我们还必须应对选择偏差。这时就会用到一种称为倾向评分的方法,用于在观察性研究中平衡各组。倾向评分是指基于被试的可观测特征,其接受特定处理的概率。
其工作原理
该方法由 Rosenbaum 和 Rubin 于 20 世纪 80 年代提出,并被广泛应用于医疗、社会科学和经济学领域。其基本流程如下:
什么是混杂
在进一步展开之前,先来理解“混杂”的含义。当一个外在变量(称为混杂变量或混杂因子)同时影响自变量(处理)和因变量(结果)时,就会发生混杂,从而可能导致对二者关系的错误结论。
例如,在研究饮用咖啡(自变量)是否与更高的生产力(因变量)相关时,体育锻炼就是一个混杂因素。这是因为更多锻炼的人可能也更常喝咖啡且生产力更高,导致难以判断仅咖啡是否影响生产力,还是锻炼也部分起了作用。
在这种情况下,锻炼这一混杂因素可能会误导研究者,虚假地暗示咖啡与生产力之间存在比实际更强的关系。
使用倾向评分的关键方法
在观察性研究中应用倾向评分的四种主要方法是匹配、分层、逆概率加权以及协变量调整。下面分别介绍。
倾向评分匹配
倾向评分匹配将处理组的参与者与对照组中倾向评分相近的参与者配对。该配对过程尽量确保两组尽可能相似,从而降低偏差的可能性。换言之,将具有相似接受处理概率的个体配对,以构建平衡的样本。
当目标是构建可直接比较的组别,并尽量减少特征差异时,匹配是理想选择。样本量以中到大为佳,有助于找到更好的匹配对象。
在评估远程办公对员工生产力影响的研究中,研究者可根据岗位、工作年限和既往绩效等变量,将远程办公员工(处理)与相似的现场办公员工(对照)进行匹配。这样可在减少背景差异影响的同时比较生产力结果。
分层
分层是指根据倾向评分将参与者划分为不同的组(层)。通常按五分位(即五等分)进行划分。每个层内包含倾向评分相近的参与者,并在每个层内比较处理组与对照组的结果。
当样本量足够大、可构建若干具备实际意义的层时,该方法更有效;若每层参与者过少,可能无法进行有效比较。
在评估新药疗效的医疗研究中,可基于人口统计学与基线健康状况计算的倾向评分将患者分为五分位层。每层包含特征相近的患者,从而在各层内更准确地比较治疗效果。
处理的逆概率加权(IPTW)
IPW 基于倾向评分分配权重,在估计处理效应时为某些观测赋予更高“重要性”。对其所在组概率较低的参与者给予更大权重,以平衡组间特征差异。
由于它按比例利用两组的数据,当研究者需要将发现推广到整个样本总体时,IPW 更受青睐。
在评估社区干预的公共卫生研究中,可应用 IPW 来考虑接受干预与未接受干预社区之间在人口与社会经济方面的差异。这样无需创建匹配对也能得到可推广的结论。步骤如下:
1. 计算倾向评分
2. 计算权重
接下来根据倾向评分的倒数计算权重,如下所示:
在我们的示例中,对于倾向评分为 0.8 的个体:
3. 应用权重
现在,将这些权重应用于研究中的每个个体,创建一个“伪总体”,其中每个个体对分析的影响由其权重进行调整。该伪总体在处理组与对照组之间平衡了基线特征。在生成的伪总体中,个体处于处理组或对照组的可能性与其基线特征相互独立,从而减少混杂。
需要说明的是,IPTW 可用于处理大量混杂变量,也可应用于纵向研究以处理时间相关的混杂。
使用 IPTW 时的其他重要考虑包括:
协变量调整
在协变量调整中,我们将倾向评分作为回归模型中的一个额外协变量来控制混杂因素。通过在统计模型内对倾向评分进行调整,从而改进处理效应的估计并考虑混杂。
例如,在研究职场培训项目对员工绩效的影响时,研究者可将倾向评分作为协变量纳入回归模型,以调整年龄或工作年限等因素。
使用倾向评分的优势
到目前为止,我们已讨论了不同的研究设计,包括随机化和(随机化不可行时的)观察性方法。在观察性研究中,我们阐述了倾向评分及其四种方法的重要性。现在,让我们来看看使用倾向评分的优势。
改善协变量平衡
通过在组间使协变量(或背景特征)相当,倾向评分可在处理组与对照组之间提供更平衡的比较。这使研究者能在关键变量(如年龄、社会经济地位或健康状况)具有相似分布的前提下,进行更公平的比较,从而更准确地估计处理效应。
在研究在线学习对学生结果影响时,倾向评分匹配可在在线与传统学习组之间平衡学生既往学业表现、上网条件与动机水平。这有助于确保结果差异更可能来自学习方式本身,而非学生背景差异。
降低偏差
倾向评分通过调整可观测特征差异来降低分析中的偏差。这在无法控制处理分配的非随机化研究中特别有价值。
通用性强
倾向评分灵活,可用于二元处理(如是否接受处理的“是/否”问题)和连续处理(如接受处理的剂量或强度)。
倾向评分的局限性
尽管倾向评分十分有用,但也需考虑其局限性,例如:
依赖于可观测协变量
倾向评分只能调整可观测协变量,即研究者测量并纳入模型的变量。但这未必能控制未观测或未测量的潜在混杂因素。难免仍会有隐性偏差未被处理,进而影响结果。
例如,在比较两种疗法对心理健康结果的影响时,研究者或许拥有患者年龄、性别与基线健康状况的数据。但若未测量的因素(如社会支持或个体应对机制)未被控制,仍可能影响疗法的效果。
需要较大的样本量
倾向评分方法在大型数据集上表现最佳,以确保处理组与对照组之间有足够的重叠。样本量较小时,往往难以在各组间找到足够倾向评分相近的参与者,从而难以实现良好的匹配或具意义的加权。
倾向模型设定错误
正确选择变量与模型的函数形式对于恰当设定倾向模型至关重要,并会影响其准确性。若遗漏相关变量或模型设定不当,可能导致有偏估计;更糟的是,这类问题往往难以察觉。
进阶技术:双重稳健与贝叶斯方法
为应对传统倾向评分方法的一些局限,已经发展出进阶技术。
双重稳健方法
双重稳健方法是一个两步法:研究者先估计倾向评分,并据此进行匹配或加权;随后拟合回归模型,根据处理与其他协变量预测结果。最终的处理效应估计通过同时调整倾向评分与回归模型获得。
贝叶斯倾向评分
在贝叶斯方法中,会将不确定性纳入倾向评分的估计。这使我们在样本量较小或数据不确定性较大的情况下,能够做出更准确的估计。如果您对日益常见的贝叶斯方法感兴趣,欢迎选修我们的Fundamentals of Bayesian Data Analysis in R。
倾向评分分析中的常见错误
使用倾向评分时,有一些常见错误需要避免。
协变量平衡不足
在应用倾向评分方法后,务必检查处理组与对照组之间的协变量是否达到平衡。若平衡不足,结果仍可能存在偏差。
模型设定不当
在计算倾向评分时,模型设定至关重要,设定不当会导致处理效应估计产生显著偏差。常见错误包括过拟合(纳入过多协变量)或遗漏重要的混杂因素。
平衡处理组与对照组的特征有助于我们最小化偏差,并提供更可靠的处理效应估计。但与任何统计方法一样,必须谨慎应用,并关注潜在的局限与错误。
结语
希望您能认识到倾向评分的价值:它是观察性研究中最小化偏差的重要方法,因为它能根据各自特征很好地平衡处理组与对照组。匹配、分层与加权等技术通过解决混杂因素,有助于确保更准确的因果推断。
下一步,欢迎报名我们的Statistician in R职业路径。完整路径涵盖从回归到假设检验、从因子分析到自助法的一切内容。即便您不打算成为统计学家,该课程仍是极佳的学习资源,能帮助您成为出色的分析师或数据科学家。