Thực hiện nghiên cứu bài bản là công việc phức tạp và đòi hỏi lập kế hoạch cẩn thận, bao gồm cả cách phân bổ người tham gia vào các nhóm điều trị chứa can thiệp so với các nhóm đối chứng không nhận can thiệp.
Một cách tiếp cận là phân bổ ngẫu nhiên người tham gia vào hai nhóm để giảm thiểu thiên lệch. Phân bổ ngẫu nhiên giúp quy kết khác biệt về kết quả cho can thiệp, thay vì do các biến số khác. Tuy nhiên, phân bổ ngẫu nhiên không phải lúc nào cũng khả thi do hạn chế về đạo đức, thực tiễn hoặc hậu cần. Khi đó, các nhà nghiên cứu sử dụng các lựa chọn thay thế như nghiên cứu quan sát, vốn dựa trên việc quan sát những gì tự nhiên xảy ra trong thế giới thực. Dù hữu ích, các thiết kế này có thể dẫn đến thiên lệch chọn mẫu, ảnh hưởng đến kết quả nghiên cứu.
Để xử lý vấn đề thiên lệch chọn mẫu, các nhà nghiên cứu thường sử dụng điểm khuynh hướng — và đó là trọng tâm của bài viết này. Khi đọc xong, hy vọng bạn sẽ tham gia các khóa học của chúng tôi để xây nền tảng vững chắc về tư duy nhân quả. Bắt đầu với Foundations of Inference in Python để hiểu các nguyên lý cốt lõi như phân phối mẫu. Sau đó chuyển sang Intermediate Regression in Python để thực hành mô hình hóa (đây là kỹ năng thiết yếu để ước lượng hiệu ứng nhân quả). Inference for Linear Regression in R cũng là một lựa chọn tuyệt vời. Giờ thì bắt đầu thôi!
Điểm Khuynh Hướng là gì?
Chúng ta hiểu rằng có những tình huống không thể phân bổ ngẫu nhiên. Bên cạnh đó, cần phải xử lý cả thiên lệch chọn mẫu. Khi ấy, một phương pháp gọi là điểm khuynh hướng được dùng để cân bằng các nhóm trong nghiên cứu quan sát. Điểm khuynh hướng là xác suất một người tham gia sẽ nhận một can thiệp cụ thể dựa trên các đặc điểm quan sát được của họ.
Cách thức hoạt động
Phương pháp này do Rosenbaum và Rubin phát triển vào thập niên 1980 và được sử dụng rộng rãi trong y tế, khoa học xã hội và kinh tế. Cách hoạt động như sau:
- Nhà nghiên cứu thu thập dữ liệu về nhiều đặc điểm (ví dụ: tuổi, học vấn, thu nhập) có thể ảnh hưởng đến việc một người tham gia có nhận can thiệp hay không. Sau đó tính điểm khuynh hướng cho từng người tham gia, phản ánh khả năng họ được phân vào nhóm can thiệp dựa trên các đặc điểm này.
- Tiếp đó, nhà nghiên cứu có thể ghép cặp những người có điểm khuynh hướng tương tự giữa nhóm can thiệp và đối chứng hoặc áp dụng phương pháp cho trọng số. Quy trình này tạo ra các nhóm so sánh hơn về đặc điểm ban đầu.
- Các nhóm đã cân bằng giúp đánh giá chính xác hơn tác động của can thiệp, đồng thời kiểm soát các yếu tố gây nhiễu có thể làm sai lệch kết quả.
Yếu tố gây nhiễu là gì
Trước khi đi tiếp, hãy hiểu khái niệm gây nhiễu (confounding). Gây nhiễu xảy ra khi một biến bên ngoài, gọi là biến gây nhiễu, ảnh hưởng cả biến độc lập (can thiệp) lẫn biến phụ thuộc (kết quả), có thể dẫn đến kết luận sai về mối quan hệ giữa chúng.
Ví dụ, tập thể dục là một biến gây nhiễu trong nghiên cứu xem liệu uống cà phê (biến độc lập) có liên quan đến năng suất cao hơn (biến phụ thuộc) hay không. Bởi những người tập thể dục nhiều có thể cũng uống nhiều cà phê và có năng suất cao hơn, khiến khó xác định liệu chỉ riêng cà phê ảnh hưởng đến năng suất hay tập thể dục cũng đóng góp một phần.
Trong trường hợp này, tập thể dục — yếu tố gây nhiễu — có thể dẫn dắt các nhà nghiên cứu hiểu sai bằng cách gợi ý một mối liên hệ mạnh hơn giữa cà phê và năng suất so với thực tế.
Các Phương Pháp Chính Khi Dùng Điểm Khuynh Hướng
Bốn phương pháp chủ đạo để áp dụng điểm khuynh hướng trong nghiên cứu quan sát là ghép cặp, phân tầng, cho trọng số xác suất nghịch đảo và điều chỉnh đồng biến. Hãy lần lượt thảo luận chi tiết.
Ghép cặp theo điểm khuynh hướng
Ghép cặp theo điểm khuynh hướng sẽ bắt cặp người tham gia từ nhóm can thiệp với người ở nhóm đối chứng có điểm khuynh hướng tương tự. Quá trình này đảm bảo các nhóm giống nhau nhất có thể, từ đó giảm khả năng thiên lệch. Nói cách khác, những cá nhân có xác suất nhận can thiệp tương đương sẽ được ghép cặp để tạo mẫu cân bằng.
Ghép cặp lý tưởng khi mục tiêu là tạo ra các nhóm so sánh trực tiếp và giảm khác biệt về đặc điểm tối đa. Cỡ mẫu trung bình đến lớn là phù hợp hơn vì giúp dễ tìm được cặp ghép tốt.
Trong một nghiên cứu đánh giá tác động của làm việc từ xa đến năng suất nhân viên, nhà nghiên cứu có thể ghép những nhân viên làm từ xa (can thiệp) với nhân viên tương đồng làm tại văn phòng (đối chứng) dựa trên biến như vai trò công việc, số năm kinh nghiệm và các chỉ số hiệu suất trước đó. Điều này cho phép so sánh kết quả năng suất đồng thời giảm tác động của khác biệt nền tảng.
Phân tầng
Phân tầng là quá trình chia người tham gia thành các nhóm riêng biệt, còn gọi là tầng (strata), dựa trên điểm khuynh hướng. Thường các nhóm được chia theo năm phần bằng nhau (quintile). Mỗi tầng chứa các cá nhân có điểm khuynh hướng tương tự và so sánh kết quả giữa nhóm can thiệp và đối chứng trong từng tầng.
Phương pháp này hiệu quả khi cỡ mẫu đủ lớn để tạo ra nhiều tầng có ý nghĩa; nếu ít người mỗi tầng, so sánh có thể không hiệu quả.
Để đánh giá hiệu quả của một loại thuốc mới trong nghiên cứu y tế, bệnh nhân có thể được phân thành năm tầng theo điểm khuynh hướng tính từ nhân khẩu học và tình trạng sức khỏe ban đầu. Mỗi tầng gồm bệnh nhân có đặc điểm tương tự, giúp so sánh hiệu ứng điều trị chính xác hơn trong từng nhóm.
Cho trọng số xác suất nghịch đảo điều trị (IPTW)
IPW gán trọng số dựa trên điểm khuynh hướng để tăng “độ quan trọng” cho một số quan sát khi ước lượng hiệu ứng điều trị. Những người có khả năng thấp thuộc về nhóm của họ sẽ được gán trọng số lớn hơn để cân bằng khác biệt đặc điểm giữa các nhóm.
Vì tận dụng dữ liệu tỷ lệ từ cả hai nhóm, IPW phù hợp khi cần khái quát hóa phát hiện cho toàn bộ quần thể mẫu.
Trong một nghiên cứu y tế công cộng đánh giá một can thiệp cộng đồng, IPW có thể được áp dụng để tính đến khác biệt nhân khẩu và kinh tế - xã hội giữa các cộng đồng nhận can thiệp và không nhận. Điều này cho phép rút ra kết luận khái quát mà không cần tạo cặp ghép. Các bước như sau:
1. Tính điểm khuynh hướng
- Trước hết, ước lượng điểm khuynh hướng cho mỗi cá nhân trong nghiên cứu, biểu thị xác suất họ thuộc nhóm can thiệp dựa trên đặc điểm ban đầu.
- Dựa trên mô hình hồi quy logistic, điểm khuynh hướng một người nhận can thiệp là 0,8, tức 80%
2. Tính trọng số
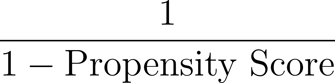
Tiếp theo, tính trọng số dựa trên nghịch đảo của điểm khuynh hướng, như dưới đây:
- Với các cá nhân trong nhóm can thiệp (nhận can thiệp), trọng số là:
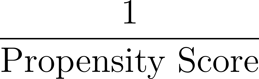
- Đối với các cá nhân trong nhóm đối chứng (không nhận can thiệp), trọng số là:
Trong ví dụ của chúng ta, với cá nhân có điểm khuynh hướng 0,8:
- Nếu thuộc nhóm can thiệp, trọng số của họ sẽ là:
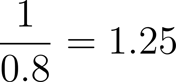
- Nếu thuộc nhóm đối chứng, trọng số của họ sẽ là:
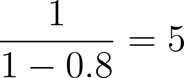
3. Áp dụng trọng số
Bây giờ, áp dụng các trọng số này cho từng cá nhân trong nghiên cứu để tạo ra một “giả quần thể” (pseudo-population) mà trong đó mức độ ảnh hưởng của mỗi cá nhân lên phân tích được điều chỉnh bằng trọng số của họ. Giả quần thể này cân bằng các đặc điểm ban đầu giữa nhóm can thiệp và đối chứng. Trong giả quần thể thu được, khả năng một cá nhân thuộc nhóm can thiệp hay đối chứng độc lập với đặc điểm ban đầu của họ, nhờ đó giảm gây nhiễu.
Lưu ý, IPTW có thể xử lý số lượng lớn biến gây nhiễu. Nó cũng có thể áp dụng cho nghiên cứu dọc để tính đến gây nhiễu phụ thuộc thời gian.
Một số cân nhắc quan trọng khác khi dùng IPTW gồm:
- Đánh giá cân bằng giữa nhóm phơi nhiễm và không phơi nhiễm cho mọi đặc điểm ban đầu trước và sau khi cho trọng số
- Xử lý các trọng số cực đoan bằng cách ổn định hoặc cắt cụt trọng số
Điều chỉnh đồng biến
Trong điều chỉnh đồng biến, chúng ta sử dụng điểm khuynh hướng như một biến đồng biến bổ sung trong mô hình hồi quy để kiểm soát các yếu tố gây nhiễu. Việc điều chỉnh này cải thiện ước lượng hiệu ứng can thiệp bằng cách điều chỉnh theo điểm khuynh hướng trong mô hình thống kê, từ đó tính đến gây nhiễu.
Ví dụ, khi nghiên cứu ảnh hưởng của một chương trình đào tạo tại nơi làm việc đến hiệu suất nhân viên, nhà nghiên cứu có thể dùng điểm khuynh hướng như đồng biến trong mô hình hồi quy để điều chỉnh các yếu tố như tuổi hoặc số năm kinh nghiệm.
Ưu Điểm của Việc Sử Dụng Điểm Khuynh Hướng
Đến đây, chúng ta đã thảo luận các thiết kế nghiên cứu khác nhau, gồm ngẫu nhiên hóa và phương pháp quan sát (khi không thể ngẫu nhiên hóa). Với nghiên cứu quan sát, chúng ta đã nói về tầm quan trọng của điểm khuynh hướng và bốn phương pháp. Giờ hãy bàn về lợi ích của điểm khuynh hướng.
Cải thiện cân bằng đồng biến
Điểm khuynh hướng mang lại so sánh cân bằng hơn giữa nhóm can thiệp và đối chứng bằng cách làm tương đương các đồng biến, hay đặc điểm nền, giữa các nhóm. Điều này cho phép so sánh công bằng hơn với phân phối tương tự của các biến then chốt (như tuổi, tình trạng kinh tế - xã hội, hay tình trạng sức khỏe), từ đó ước lượng chính xác hiệu ứng can thiệp.
Khi nghiên cứu tác động của học trực tuyến đến kết quả học tập, ghép cặp theo điểm khuynh hướng có thể cân bằng thành tích học tập trước đó, khả năng truy cập internet và mức độ động lực của học sinh giữa nhóm học trực tuyến và truyền thống. Điều này giúp đảm bảo khác biệt về kết quả nhiều khả năng là do phương thức học hơn là do khác biệt nền tảng của học sinh.
Giảm thiên lệch
Điểm khuynh hướng điều chỉnh các khác biệt ở đặc điểm quan sát được, từ đó giảm thiên lệch trong phân tích. Điều này đặc biệt hữu ích trong nghiên cứu không ngẫu nhiên, nơi nhà nghiên cứu không thể kiểm soát việc phân bổ can thiệp.
Tính linh hoạt
Điểm khuynh hướng linh hoạt và có thể dùng với cả can thiệp nhị phân (ví dụ: có/không nhận can thiệp) và can thiệp liên tục (ví dụ: mức độ nhận can thiệp).
Hạn Chế của Điểm Khuynh Hướng
Mặc dù mạnh mẽ, điểm khuynh hướng cũng có những hạn chế cần lưu ý, chẳng hạn như:
Phụ thuộc vào đồng biến quan sát được
Điểm khuynh hướng chỉ có thể điều chỉnh các đồng biến quan sát được, tức các biến mà nhà nghiên cứu đã đo lường và đưa vào mô hình. Điều đó không nhất thiết tính đến các yếu tố gây nhiễu ẩn, chưa quan sát hoặc chưa đo lường. Hệ quả là vẫn còn các thiên lệch tiềm ẩn chưa được xử lý có thể ảnh hưởng kết quả.
Ví dụ, khi so sánh tác động của hai loại trị liệu lên kết quả sức khỏe tâm thần, nhà nghiên cứu có thể có dữ liệu về tuổi, giới và tình trạng sức khỏe ban đầu. Tuy nhiên, nếu các yếu tố chưa đo lường như hỗ trợ xã hội hay cơ chế đối phó cá nhân không được tính đến, chúng vẫn có thể ảnh hưởng kết quả trị liệu.
Cần cỡ mẫu lớn
Các phương pháp điểm khuynh hướng hoạt động tốt nhất với bộ dữ liệu lớn để đảm bảo có đủ vùng chồng lấp giữa nhóm can thiệp và đối chứng. Mẫu nhỏ thường dẫn đến thiếu đủ người có điểm khuynh hướng tương tự giữa các nhóm, khiến khó đạt ghép cặp tốt hoặc cho trọng số có ý nghĩa.
Đặc tả mô hình khuynh hướng sai
Việc chọn biến và dạng hàm phù hợp của mô hình rất quan trọng để đặc tả đúng mô hình khuynh hướng, từ đó ảnh hưởng độ chính xác. Bỏ sót biến liên quan hoặc đặc tả mô hình không phù hợp có thể dẫn đến ước lượng thiên lệch, và tệ hơn là các vấn đề này còn khó phát hiện.
Kỹ Thuật Nâng Cao: Phương Pháp Kép Bền Vững và Tiếp Cận Bayes
Các kỹ thuật nâng cao đã được phát triển để khắc phục một số hạn chế của phương pháp điểm khuynh hướng truyền thống.
Phương pháp kép bền vững (Doubly robust)
Phương pháp kép bền vững là cách tiếp cận hai bước: trước tiên, nhà nghiên cứu ước lượng điểm khuynh hướng và ghép cặp hoặc cho trọng số người tham gia tương ứng. Sau đó, họ khớp một mô hình hồi quy để dự đoán kết quả dựa trên can thiệp và các đồng biến khác. Ước lượng hiệu ứng can thiệp cuối cùng thu được bằng cách điều chỉnh cả theo điểm khuynh hướng và mô hình hồi quy.
Điểm khuynh hướng Bayes
Trong các phương pháp Bayes, bất định được tích hợp vào quá trình ước lượng điểm khuynh hướng. Điều này cho phép đưa ra ước lượng chính xác hơn, đặc biệt trong bối cảnh cỡ mẫu nhỏ hoặc mức độ bất định về dữ liệu cao. Nếu bạn quan tâm đến các tiếp cận Bayes, vốn ngày càng phổ biến, hãy tham gia Fundamentals of Bayesian Data Analysis in R.
Lỗi Phổ Biến Trong Phân Tích Điểm Khuynh Hướng
Khi sử dụng điểm khuynh hướng, có một số sai lầm thường gặp cần tránh.
Cân bằng đồng biến không đầy đủ
Sau khi áp dụng các phương pháp điểm khuynh hướng, cần kiểm tra xem các đồng biến đã cân bằng giữa nhóm can thiệp và đối chứng hay chưa. Nếu không đủ cân bằng, kết quả vẫn có thể bị thiên lệch.
Đặc tả mô hình sai
Đặc tả mô hình là yếu tố then chốt khi tính điểm khuynh hướng, vì đặc tả không đúng có thể dẫn tới thiên lệch đáng kể trong ước lượng hiệu ứng can thiệp. Lỗi thường gặp là quá khớp mô hình (đưa quá nhiều đồng biến) hoặc bỏ sót các yếu tố gây nhiễu quan trọng.
Cân bằng đặc điểm giữa nhóm can thiệp và đối chứng giúp giảm thiên lệch và cung cấp ước lượng đáng tin cậy hơn về hiệu ứng can thiệp. Tuy nhiên, giống như bất kỳ phương pháp thống kê nào, chúng cần được áp dụng cẩn trọng, chú ý đến các hạn chế và sai sót tiềm ẩn.
Kết Luận
Tôi hy vọng bạn đánh giá cao điểm khuynh hướng, một phương pháp quan trọng để giảm thiểu thiên lệch trong nghiên cứu quan sát, vì chúng giúp cân bằng nhóm can thiệp và đối chứng dựa trên đặc điểm tương ứng. Các kỹ thuật như ghép cặp, phân tầng và cho trọng số giúp đảm bảo suy luận nhân quả chính xác hơn bằng cách xử lý các yếu tố gây nhiễu.
Bước tiếp theo, hãy đăng ký lộ trình nghề nghiệp Statistician in R của chúng tôi. Lộ trình đầy đủ bao quát mọi thứ từ hồi quy đến kiểm định giả thuyết, phân tích nhân tố đến bootstrapping. Ngay cả khi bạn không định trở thành nhà thống kê, khóa học vẫn là nguồn tài nguyên tuyệt vời với nhiều nội dung học tập giúp bạn trở thành nhà phân tích hoặc nhà khoa học dữ liệu xuất sắc.


Thực hiện nghiên cứu bài bản là công việc phức tạp và đòi hỏi lập kế hoạch cẩn thận, bao gồm cả cách phân bổ người tham gia vào các nhóm điều trị chứa can thiệp so với các nhóm đối chứng không nhận can thiệp.
Một cách tiếp cận là phân bổ ngẫu nhiên người tham gia vào hai nhóm để giảm thiểu thiên lệch. Phân bổ ngẫu nhiên giúp quy kết khác biệt về kết quả cho can thiệp, thay vì do các biến số khác. Tuy nhiên, phân bổ ngẫu nhiên không phải lúc nào cũng khả thi do hạn chế về đạo đức, thực tiễn hoặc hậu cần. Khi đó, các nhà nghiên cứu sử dụng các lựa chọn thay thế như nghiên cứu quan sát, vốn dựa trên việc quan sát những gì tự nhiên xảy ra trong thế giới thực. Dù hữu ích, các thiết kế này có thể dẫn đến thiên lệch chọn mẫu, ảnh hưởng đến kết quả nghiên cứu.
Để xử lý vấn đề thiên lệch chọn mẫu, các nhà nghiên cứu thường sử dụng điểm khuynh hướng — và đó là trọng tâm của bài viết này. Khi đọc xong, hy vọng bạn sẽ tham gia các khóa học của chúng tôi để xây nền tảng vững chắc về tư duy nhân quả. Bắt đầu với Foundations of Inference in Python để hiểu các nguyên lý cốt lõi như phân phối mẫu. Sau đó chuyển sang Intermediate Regression in Python để thực hành mô hình hóa (đây là kỹ năng thiết yếu để ước lượng hiệu ứng nhân quả). Inference for Linear Regression in R cũng là một lựa chọn tuyệt vời. Giờ thì bắt đầu thôi!
Điểm Khuynh Hướng là gì?
Chúng ta hiểu rằng có những tình huống không thể phân bổ ngẫu nhiên. Bên cạnh đó, cần phải xử lý cả thiên lệch chọn mẫu. Khi ấy, một phương pháp gọi là điểm khuynh hướng được dùng để cân bằng các nhóm trong nghiên cứu quan sát. Điểm khuynh hướng là xác suất một người tham gia sẽ nhận một can thiệp cụ thể dựa trên các đặc điểm quan sát được của họ.
Cách thức hoạt động
Phương pháp này do Rosenbaum và Rubin phát triển vào thập niên 1980 và được sử dụng rộng rãi trong y tế, khoa học xã hội và kinh tế. Cách hoạt động như sau:
Yếu tố gây nhiễu là gì
Trước khi đi tiếp, hãy hiểu khái niệm gây nhiễu (confounding). Gây nhiễu xảy ra khi một biến bên ngoài, gọi là biến gây nhiễu, ảnh hưởng cả biến độc lập (can thiệp) lẫn biến phụ thuộc (kết quả), có thể dẫn đến kết luận sai về mối quan hệ giữa chúng.
Ví dụ, tập thể dục là một biến gây nhiễu trong nghiên cứu xem liệu uống cà phê (biến độc lập) có liên quan đến năng suất cao hơn (biến phụ thuộc) hay không. Bởi những người tập thể dục nhiều có thể cũng uống nhiều cà phê và có năng suất cao hơn, khiến khó xác định liệu chỉ riêng cà phê ảnh hưởng đến năng suất hay tập thể dục cũng đóng góp một phần.
Trong trường hợp này, tập thể dục — yếu tố gây nhiễu — có thể dẫn dắt các nhà nghiên cứu hiểu sai bằng cách gợi ý một mối liên hệ mạnh hơn giữa cà phê và năng suất so với thực tế.
Các Phương Pháp Chính Khi Dùng Điểm Khuynh Hướng
Bốn phương pháp chủ đạo để áp dụng điểm khuynh hướng trong nghiên cứu quan sát là ghép cặp, phân tầng, cho trọng số xác suất nghịch đảo và điều chỉnh đồng biến. Hãy lần lượt thảo luận chi tiết.
Ghép cặp theo điểm khuynh hướng
Ghép cặp theo điểm khuynh hướng sẽ bắt cặp người tham gia từ nhóm can thiệp với người ở nhóm đối chứng có điểm khuynh hướng tương tự. Quá trình này đảm bảo các nhóm giống nhau nhất có thể, từ đó giảm khả năng thiên lệch. Nói cách khác, những cá nhân có xác suất nhận can thiệp tương đương sẽ được ghép cặp để tạo mẫu cân bằng.
Ghép cặp lý tưởng khi mục tiêu là tạo ra các nhóm so sánh trực tiếp và giảm khác biệt về đặc điểm tối đa. Cỡ mẫu trung bình đến lớn là phù hợp hơn vì giúp dễ tìm được cặp ghép tốt.
Trong một nghiên cứu đánh giá tác động của làm việc từ xa đến năng suất nhân viên, nhà nghiên cứu có thể ghép những nhân viên làm từ xa (can thiệp) với nhân viên tương đồng làm tại văn phòng (đối chứng) dựa trên biến như vai trò công việc, số năm kinh nghiệm và các chỉ số hiệu suất trước đó. Điều này cho phép so sánh kết quả năng suất đồng thời giảm tác động của khác biệt nền tảng.
Phân tầng
Phân tầng là quá trình chia người tham gia thành các nhóm riêng biệt, còn gọi là tầng (strata), dựa trên điểm khuynh hướng. Thường các nhóm được chia theo năm phần bằng nhau (quintile). Mỗi tầng chứa các cá nhân có điểm khuynh hướng tương tự và so sánh kết quả giữa nhóm can thiệp và đối chứng trong từng tầng.
Phương pháp này hiệu quả khi cỡ mẫu đủ lớn để tạo ra nhiều tầng có ý nghĩa; nếu ít người mỗi tầng, so sánh có thể không hiệu quả.
Để đánh giá hiệu quả của một loại thuốc mới trong nghiên cứu y tế, bệnh nhân có thể được phân thành năm tầng theo điểm khuynh hướng tính từ nhân khẩu học và tình trạng sức khỏe ban đầu. Mỗi tầng gồm bệnh nhân có đặc điểm tương tự, giúp so sánh hiệu ứng điều trị chính xác hơn trong từng nhóm.
Cho trọng số xác suất nghịch đảo điều trị (IPTW)
IPW gán trọng số dựa trên điểm khuynh hướng để tăng “độ quan trọng” cho một số quan sát khi ước lượng hiệu ứng điều trị. Những người có khả năng thấp thuộc về nhóm của họ sẽ được gán trọng số lớn hơn để cân bằng khác biệt đặc điểm giữa các nhóm.
Vì tận dụng dữ liệu tỷ lệ từ cả hai nhóm, IPW phù hợp khi cần khái quát hóa phát hiện cho toàn bộ quần thể mẫu.
Trong một nghiên cứu y tế công cộng đánh giá một can thiệp cộng đồng, IPW có thể được áp dụng để tính đến khác biệt nhân khẩu và kinh tế - xã hội giữa các cộng đồng nhận can thiệp và không nhận. Điều này cho phép rút ra kết luận khái quát mà không cần tạo cặp ghép. Các bước như sau:
1. Tính điểm khuynh hướng
2. Tính trọng số
Tiếp theo, tính trọng số dựa trên nghịch đảo của điểm khuynh hướng, như dưới đây:
Trong ví dụ của chúng ta, với cá nhân có điểm khuynh hướng 0,8:
3. Áp dụng trọng số
Bây giờ, áp dụng các trọng số này cho từng cá nhân trong nghiên cứu để tạo ra một “giả quần thể” (pseudo-population) mà trong đó mức độ ảnh hưởng của mỗi cá nhân lên phân tích được điều chỉnh bằng trọng số của họ. Giả quần thể này cân bằng các đặc điểm ban đầu giữa nhóm can thiệp và đối chứng. Trong giả quần thể thu được, khả năng một cá nhân thuộc nhóm can thiệp hay đối chứng độc lập với đặc điểm ban đầu của họ, nhờ đó giảm gây nhiễu.
Lưu ý, IPTW có thể xử lý số lượng lớn biến gây nhiễu. Nó cũng có thể áp dụng cho nghiên cứu dọc để tính đến gây nhiễu phụ thuộc thời gian.
Một số cân nhắc quan trọng khác khi dùng IPTW gồm:
Điều chỉnh đồng biến
Trong điều chỉnh đồng biến, chúng ta sử dụng điểm khuynh hướng như một biến đồng biến bổ sung trong mô hình hồi quy để kiểm soát các yếu tố gây nhiễu. Việc điều chỉnh này cải thiện ước lượng hiệu ứng can thiệp bằng cách điều chỉnh theo điểm khuynh hướng trong mô hình thống kê, từ đó tính đến gây nhiễu.
Ví dụ, khi nghiên cứu ảnh hưởng của một chương trình đào tạo tại nơi làm việc đến hiệu suất nhân viên, nhà nghiên cứu có thể dùng điểm khuynh hướng như đồng biến trong mô hình hồi quy để điều chỉnh các yếu tố như tuổi hoặc số năm kinh nghiệm.
Ưu Điểm của Việc Sử Dụng Điểm Khuynh Hướng
Đến đây, chúng ta đã thảo luận các thiết kế nghiên cứu khác nhau, gồm ngẫu nhiên hóa và phương pháp quan sát (khi không thể ngẫu nhiên hóa). Với nghiên cứu quan sát, chúng ta đã nói về tầm quan trọng của điểm khuynh hướng và bốn phương pháp. Giờ hãy bàn về lợi ích của điểm khuynh hướng.
Cải thiện cân bằng đồng biến
Điểm khuynh hướng mang lại so sánh cân bằng hơn giữa nhóm can thiệp và đối chứng bằng cách làm tương đương các đồng biến, hay đặc điểm nền, giữa các nhóm. Điều này cho phép so sánh công bằng hơn với phân phối tương tự của các biến then chốt (như tuổi, tình trạng kinh tế - xã hội, hay tình trạng sức khỏe), từ đó ước lượng chính xác hiệu ứng can thiệp.
Khi nghiên cứu tác động của học trực tuyến đến kết quả học tập, ghép cặp theo điểm khuynh hướng có thể cân bằng thành tích học tập trước đó, khả năng truy cập internet và mức độ động lực của học sinh giữa nhóm học trực tuyến và truyền thống. Điều này giúp đảm bảo khác biệt về kết quả nhiều khả năng là do phương thức học hơn là do khác biệt nền tảng của học sinh.
Giảm thiên lệch
Điểm khuynh hướng điều chỉnh các khác biệt ở đặc điểm quan sát được, từ đó giảm thiên lệch trong phân tích. Điều này đặc biệt hữu ích trong nghiên cứu không ngẫu nhiên, nơi nhà nghiên cứu không thể kiểm soát việc phân bổ can thiệp.
Tính linh hoạt
Điểm khuynh hướng linh hoạt và có thể dùng với cả can thiệp nhị phân (ví dụ: có/không nhận can thiệp) và can thiệp liên tục (ví dụ: mức độ nhận can thiệp).
Hạn Chế của Điểm Khuynh Hướng
Mặc dù mạnh mẽ, điểm khuynh hướng cũng có những hạn chế cần lưu ý, chẳng hạn như:
Phụ thuộc vào đồng biến quan sát được
Điểm khuynh hướng chỉ có thể điều chỉnh các đồng biến quan sát được, tức các biến mà nhà nghiên cứu đã đo lường và đưa vào mô hình. Điều đó không nhất thiết tính đến các yếu tố gây nhiễu ẩn, chưa quan sát hoặc chưa đo lường. Hệ quả là vẫn còn các thiên lệch tiềm ẩn chưa được xử lý có thể ảnh hưởng kết quả.
Ví dụ, khi so sánh tác động của hai loại trị liệu lên kết quả sức khỏe tâm thần, nhà nghiên cứu có thể có dữ liệu về tuổi, giới và tình trạng sức khỏe ban đầu. Tuy nhiên, nếu các yếu tố chưa đo lường như hỗ trợ xã hội hay cơ chế đối phó cá nhân không được tính đến, chúng vẫn có thể ảnh hưởng kết quả trị liệu.
Cần cỡ mẫu lớn
Các phương pháp điểm khuynh hướng hoạt động tốt nhất với bộ dữ liệu lớn để đảm bảo có đủ vùng chồng lấp giữa nhóm can thiệp và đối chứng. Mẫu nhỏ thường dẫn đến thiếu đủ người có điểm khuynh hướng tương tự giữa các nhóm, khiến khó đạt ghép cặp tốt hoặc cho trọng số có ý nghĩa.
Đặc tả mô hình khuynh hướng sai
Việc chọn biến và dạng hàm phù hợp của mô hình rất quan trọng để đặc tả đúng mô hình khuynh hướng, từ đó ảnh hưởng độ chính xác. Bỏ sót biến liên quan hoặc đặc tả mô hình không phù hợp có thể dẫn đến ước lượng thiên lệch, và tệ hơn là các vấn đề này còn khó phát hiện.
Kỹ Thuật Nâng Cao: Phương Pháp Kép Bền Vững và Tiếp Cận Bayes
Các kỹ thuật nâng cao đã được phát triển để khắc phục một số hạn chế của phương pháp điểm khuynh hướng truyền thống.
Phương pháp kép bền vững (Doubly robust)
Phương pháp kép bền vững là cách tiếp cận hai bước: trước tiên, nhà nghiên cứu ước lượng điểm khuynh hướng và ghép cặp hoặc cho trọng số người tham gia tương ứng. Sau đó, họ khớp một mô hình hồi quy để dự đoán kết quả dựa trên can thiệp và các đồng biến khác. Ước lượng hiệu ứng can thiệp cuối cùng thu được bằng cách điều chỉnh cả theo điểm khuynh hướng và mô hình hồi quy.
Điểm khuynh hướng Bayes
Trong các phương pháp Bayes, bất định được tích hợp vào quá trình ước lượng điểm khuynh hướng. Điều này cho phép đưa ra ước lượng chính xác hơn, đặc biệt trong bối cảnh cỡ mẫu nhỏ hoặc mức độ bất định về dữ liệu cao. Nếu bạn quan tâm đến các tiếp cận Bayes, vốn ngày càng phổ biến, hãy tham gia Fundamentals of Bayesian Data Analysis in R.
Lỗi Phổ Biến Trong Phân Tích Điểm Khuynh Hướng
Khi sử dụng điểm khuynh hướng, có một số sai lầm thường gặp cần tránh.
Cân bằng đồng biến không đầy đủ
Sau khi áp dụng các phương pháp điểm khuynh hướng, cần kiểm tra xem các đồng biến đã cân bằng giữa nhóm can thiệp và đối chứng hay chưa. Nếu không đủ cân bằng, kết quả vẫn có thể bị thiên lệch.
Đặc tả mô hình sai
Đặc tả mô hình là yếu tố then chốt khi tính điểm khuynh hướng, vì đặc tả không đúng có thể dẫn tới thiên lệch đáng kể trong ước lượng hiệu ứng can thiệp. Lỗi thường gặp là quá khớp mô hình (đưa quá nhiều đồng biến) hoặc bỏ sót các yếu tố gây nhiễu quan trọng.
Cân bằng đặc điểm giữa nhóm can thiệp và đối chứng giúp giảm thiên lệch và cung cấp ước lượng đáng tin cậy hơn về hiệu ứng can thiệp. Tuy nhiên, giống như bất kỳ phương pháp thống kê nào, chúng cần được áp dụng cẩn trọng, chú ý đến các hạn chế và sai sót tiềm ẩn.
Kết Luận
Tôi hy vọng bạn đánh giá cao điểm khuynh hướng, một phương pháp quan trọng để giảm thiểu thiên lệch trong nghiên cứu quan sát, vì chúng giúp cân bằng nhóm can thiệp và đối chứng dựa trên đặc điểm tương ứng. Các kỹ thuật như ghép cặp, phân tầng và cho trọng số giúp đảm bảo suy luận nhân quả chính xác hơn bằng cách xử lý các yếu tố gây nhiễu.
Bước tiếp theo, hãy đăng ký lộ trình nghề nghiệp Statistician in R của chúng tôi. Lộ trình đầy đủ bao quát mọi thứ từ hồi quy đến kiểm định giả thuyết, phân tích nhân tố đến bootstrapping. Ngay cả khi bạn không định trở thành nhà thống kê, khóa học vẫn là nguồn tài nguyên tuyệt vời với nhiều nội dung học tập giúp bạn trở thành nhà phân tích hoặc nhà khoa học dữ liệu xuất sắc.