Grondig onderzoek doen is complex en vereist zorgvuldige planning, inclusief hoe deelnemers worden toegewezen aan behandelgroepen die de behandeling (ofwel de interventie) krijgen, versus controlegroepen waar dat niet gebeurt.
Een veelgebruikte aanpak is het willekeurig toewijzen van deelnemers aan een van beide groepen om bias te minimaliseren. Deze randomisatie helpt om verschillen in uitkomsten toe te schrijven aan de behandeling, en niet aan andere variabelen. Randomisatie is echter niet altijd mogelijk vanwege ethische, praktische of logistieke beperkingen. In zulke gevallen grijpen onderzoekers naar alternatieven, zoals observationele studies, omdat die uitgaan van wat er van nature in de echte wereld gebeurt. Hoewel waardevol, kunnen deze onderzoeksopzetten leiden tot selectiebias, die de uitkomsten van de studie beïnvloedt.
Om het probleem van selectiebias aan te pakken, gebruiken onderzoekers vaak propensityscores—en dat is de focus van deze post. Als je klaar bent, hoop ik dat je onze cursussen volgt om een sterke basis in causaal denken op te bouwen. Begin met Foundations of Inference in Python om kernprincipes zoals steekproefverdelingen te begrijpen. Ga vervolgens door met Intermediate Regression in Python voor praktische ervaring met modelleren (dit is een essentiële vaardigheid voor het schatten van causale effecten). Inference for Linear Regression in R is een andere prima optie. Laten we beginnen!
Wat is een propensityscore?
We begrijpen dat er situaties zijn waarin randomisatie geen optie is. Bovendien moeten we ook selectiebias aanpakken. Dit is waar een methode, de propensityscore, wordt gebruikt om groepen in observationele studies in evenwicht te brengen. Een propensityscore is de kans dat een deelnemer een bepaalde behandeling krijgt op basis van zijn of haar geobserveerde kenmerken.
Hoe het werkt
Deze methode is in de jaren tachtig ontwikkeld door Rosenbaum en Rubin en wordt veel gebruikt in de gezondheidszorg, sociale wetenschappen en economie. Zo werkt het:
- Onderzoekers verzamelen gegevens over diverse kenmerken (bijv. leeftijd, opleiding, inkomen) die kunnen beïnvloeden of een deelnemer de behandeling krijgt of niet. Vervolgens wordt voor elke deelnemer een propensityscore berekend die aangeeft hoe waarschijnlijk het is dat hij of zij aan de behandelingsgroep wordt toegewezen op basis van deze kenmerken.
- Daarna kunnen onderzoekers deelnemers met vergelijkbare propensityscores tussen de behandel- en controlegroep matchen of weegmethoden toepassen. Dit proces creëert groepen die qua uitgangskenmerken beter vergelijkbaar zijn.
- Zulke gebalanceerde groepen maken het makkelijker om de impact van de behandeling nauwkeuriger te beoordelen, terwijl er wordt gecontroleerd voor confounders die de resultaten anders zouden kunnen vertekenen.
Wat is confounding
Voordat we verder gaan, is het goed om te begrijpen wat confounding betekent. Confounding treedt op wanneer een externe variabele, een confounder, zowel de onafhankelijke variabele (behandeling) als de afhankelijke variabele (uitkomst) beïnvloedt, wat kan leiden tot onjuiste conclusies over de relatie tussen die twee.
Zo is lichamelijke beweging een confounder in een studie die onderzoekt of koffiedrinken (onafhankelijke variabele) samenhangt met hogere productiviteit (afhankelijke variabele). Mensen die meer sporten drinken mogelijk ook meer koffie en zijn productiever, waardoor het lastig is te bepalen of koffie op zichzelf de productiviteit beïnvloedt of dat beweging deels verantwoordelijk is.
In dit geval kan beweging, de confounder, onderzoekers misleiden door ten onrechte een sterkere relatie tussen koffie en productiviteit te suggereren dan er werkelijk is.
Belangrijke methoden voor het gebruik van propensityscores
De vier belangrijkste methoden om propensityscores toe te passen in observationele studies zijn matching, stratificatie, inverse waarschijnlijkheidsweging en covariaataanpassing. Laten we ze elk in detail bespreken.
Propensity score matching
Bij propensity score matching worden deelnemers uit de behandelingsgroep gekoppeld aan deelnemers uit de controlegroep met vergelijkbare propensityscores. Dit koppelproces zorgt ervoor dat de groepen zo gelijk mogelijk zijn, waardoor de kans op bias afneemt. Met andere woorden, individuen met vergelijkbare kansen om de behandeling te krijgen worden gekoppeld om een gebalanceerde steekproef te creëren.
Matching is ideaal wanneer het doel is om direct vergelijkbare groepen te creëren en verschillen in kenmerken zo veel mogelijk te verkleinen. Een middelgrote tot grote steekproef is wenselijk, omdat dat het vinden van goede matches vergemakkelijkt.
In een studie naar de impact van thuiswerken op medewerkerproductiviteit kunnen onderzoekers thuiswerkers (behandeling) matchen met vergelijkbare medewerkers op locatie (controle) op basis van variabelen zoals functierol, aantal jaren ervaring en eerdere prestatiecijfers. Zo kunnen productiviteitsuitkomsten worden vergeleken met minder invloed van achtergrondverschillen.
Stratificatie
Stratificatie is het opdelen van deelnemers in afzonderlijke groepen, ook wel strata, op basis van hun propensityscores. Vaak worden deze groepen opgedeeld in kwintielen, dus vijf gelijke delen. Elk stratum bevat deelnemers met vergelijkbare propensityscores, en binnen elk stratum worden de uitkomsten tussen behandel- en controlegroep vergeleken.
Deze methode is effectief wanneer de steekproef groot genoeg is om meerdere zinvolle strata te creëren, omdat te weinig deelnemers per stratum niet tot effectieve vergelijkingen leidt.
Om de effectiviteit van een nieuw medicijn te beoordelen in een zorgstudie, kunnen patiënten in kwintielen worden gestratificeerd op basis van propensityscores berekend uit demografie en uitgangsgezondheid. Elk stratum kan patiënten met vergelijkbare kenmerken bevatten, wat leidt tot nauwkeurigere vergelijkingen van behandeleffecten binnen elke groep.
Inverse probability of treatment weighting (IPTW)
IPW kent gewichten toe op basis van propensityscores om bepaalde observaties meer "gewicht" te geven bij het schatten van behandeleffecten. Deelnemers met een lagere waarschijnlijkheid om in hun respectieve groep te zitten, krijgen meer gewicht om verschillen in groepskenmerken te balanceren.
Omdat het proportioneel gebruikmaakt van gegevens uit beide groepen, heeft IPW de voorkeur wanneer onderzoekers bevindingen willen generaliseren naar de gehele steekproefpopulatie.
In een publieke gezondheidsstudie naar een gemeenschapsinterventie kan IPW worden toegepast om rekening te houden met demografische en sociaaleconomische verschillen tussen gemeenschappen die de interventie wel en niet kregen. Zo ontstaan generaliseerbare bevindingen zonder matched pairs te maken. De stappen zijn:
1. Bereken de propensityscore
- Schat eerst voor ieder individu in de studie de propensityscore, die de kans weergeeft om in de behandelingsgroep te zitten op basis van uitgangskenmerken.
- Op basis van een logistisch regressiemodel is de propensityscore van een deelnemer om de behandeling te krijgen 0,8, ofwel 80%
2. Bereken gewichten
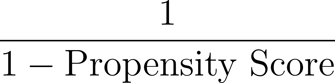
Vervolgens berekenen we gewichten op basis van het inverse van de propensityscore, zoals hieronder getoond:
- Voor individuen in de behandelingsgroep (die de interventie krijgen) is het gewicht:
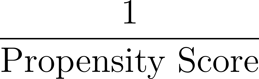
- Voor individuen in de controlegroep (die de interventie niet krijgen) is het gewicht:
In ons voorbeeld, voor de persoon met een propensityscore van 0,8:
- Als die in de behandelingsgroep zit, is het gewicht:
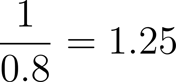
- Als die in de controlegroep zit, is het gewicht:
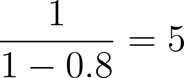
3. Pas gewichten toe
Pas deze gewichten nu toe op ieder individu in de studie om een "pseudo-populatie" te creëren waarin de invloed van elk individu op de analyse wordt aangepast door zijn of haar gewicht. Deze pseudo-populatie brengt de uitgangskenmerken in balans tussen de behandel- en controlegroepen. In de resulterende pseudo-populatie is de kans dat iemand in de behandel- of controlegroep zit onafhankelijk van zijn of haar uitgangskenmerken, waardoor confounding afneemt.
Terzijde: IPTW kan worden gebruikt om een groot aantal confounders aan te pakken. Het kan ook worden toegepast op longitudinale studies om te corrigeren voor tijdsafhankelijke confounding.
Andere belangrijke aandachtspunten bij IPTW zijn onder meer:
- Het beoordelen van de balans tussen blootgestelde en niet-blootgestelde groepen voor alle uitgangskenmerken vóór en na weging
- Omgaan met extreme gewichten via gewichts-stabilisatie of truncatie
Covariaataanpassing
Bij covariaataanpassing gebruiken we de propensityscores als een extra covariaat in een regressiemodel om voor confounders te corrigeren. Deze aanpassing verbetert de schatting van het behandeleffect door binnen het statistische model te corrigeren voor propensityscores, en zo rekening te houden met confounding.
Bijvoorbeeld: bij het bestuderen van het effect van een werkplek-trainingsprogramma op prestaties van medewerkers kunnen onderzoekers propensityscores als covariaten in een regressiemodel gebruiken om te corrigeren voor factoren zoals leeftijd of aantal jaren ervaring.
Voordelen van het gebruik van propensityscores
Tot nu toe hebben we verschillende onderzoeksopzetten besproken, waaronder randomisatie en observationeel onderzoek (waar randomisatie niet haalbaar is). In het geval van observationele studies bespraken we het belang van propensityscores en de vier methoden. Nu bespreken we de voordelen van het gebruik van propensityscores.
Verbetert covariaatbalans
Propensityscores zorgen voor een meer evenwichtige vergelijking tussen de behandel- en controlegroep door covariaten, of achtergrondkenmerken, tussen groepen gelijk te trekken. Zo kunnen onderzoekers eerlijker vergelijken met vergelijkbare verdelingen van sleutelvariabelen (zoals leeftijd, sociaaleconomische status of gezondheidscondities), wat leidt tot een nauwkeuriger schatting van het behandeleffect.
Bij het bestuderen van de impact van online leren op studieresultaten kan propensity score matching het eerdere academische niveau, internettoegang en motivatieniveau van studenten in balans brengen tussen online en traditioneel onderwijs. Zo is de kans groter dat verschillen in uitkomsten te wijten zijn aan de leermethode en niet aan verschillen in studentenachtergrond.
Vermindert bias
Propensityscores corrigeren voor verschillen in geobserveerde kenmerken en verminderen zo de bias in analyses. Dit is vooral waardevol in niet-gerandomiseerde studies, waar onderzoekers de behandeltoewijzing niet kunnen controleren.
Veelzijdigheid
Propensityscores zijn flexibel en kunnen worden gebruikt bij zowel binaire behandelingen (bijv. ja/nee-vragen over of iemand een behandeling kreeg) als continue behandelingen (bijv. hoeveel van een behandeling iemand kreeg).
Beperkingen van propensityscores
Hoewel propensityscores krachtig zijn, is het ook belangrijk hun beperkingen te overwegen, zoals:
Afhankelijkheid van geobserveerde covariaten
Propensityscores kunnen alleen corrigeren voor geobserveerde covariaten, dus de variabelen die onderzoekers hebben gemeten en in het model hebben opgenomen. Dat houdt geen rekening met verborgen confounders die onopgemerkt of ongemeten blijven. Onvermijdelijk blijven verborgen biases zo onopgelost die de uitkomst alsnog kunnen beïnvloeden.
Bijvoorbeeld: bij het vergelijken van de effecten van twee therapievormen op mentale gezondheidsuitkomsten hebben onderzoekers mogelijk data over leeftijd, geslacht en uitgangsgezondheid. Maar als niet-gemeten factoren zoals sociale steun of individuele copingmechanismen buiten beschouwing blijven, kunnen die alsnog therapie-uitkomsten beïnvloeden.
Vereist grote steekproeven
Methoden met propensityscores werken het best met grote datasets, zodat er voldoende overlap is tussen de behandel- en controlegroep. Kleinere steekproeven leiden vaak tot te weinig deelnemers met vergelijkbare propensityscores over groepen heen, wat het lastig maakt om goede matches of betekenisvolle weging te bereiken.
Misspecificatie van het propensitymodel
Het selecteren van de juiste variabelen en functionele vorm van het model is cruciaal om het propensitymodel correct te specificeren, wat de nauwkeurigheid beïnvloedt. Het niet opnemen van relevante variabelen of een ongeschikte modelspecificatie kan leiden tot vertekende schattingen, en het lastige is dat dit soort fouten vaak moeilijk te detecteren zijn.
Geavanceerde technieken: dubbeltrobuste en Bayesiaanse benaderingen
Er zijn geavanceerde technieken ontwikkeld om enkele beperkingen van traditionele propensityscore-methoden aan te pakken.
Dubbeltrobuste methoden
Dubbeltrobuste methoden zijn een tweestapsbenadering, waarbij onderzoekers eerst propensityscores schatten en deelnemers overeenkomstig matchen of wegen. Vervolgens passen ze een regressiemodel toe om de uitkomst te voorspellen op basis van de behandeling en andere covariaten. De uiteindelijke schatting van het behandeleffect wordt verkregen door zowel voor de propensityscore als voor het regressiemodel te corrigeren.
Bayesiaanse propensityscores
In Bayesiaanse methoden wordt onzekerheid meegenomen in de schatting van propensityscores. Dit maakt nauwkeurigere schattingen mogelijk, vooral in situaties met kleinere steekproeven of grotere onzekerheid over de data. Als je geïnteresseerd bent in Bayesiaanse benaderingen, die alleen maar gebruikelijker worden, volg dan onze Fundamentals of Bayesian Data Analysis in R.
Veelvoorkomende fouten in propensityscore-analyse
Bij het gebruik van propensityscores zijn er veelgemaakte fouten die je moet vermijden.
Onvoldoende covariaatbalans
Na het toepassen van propensityscore-methoden is het belangrijk te controleren of de covariaten in balans zijn tussen de behandel- en controlegroepen. Zonder voldoende balans kunnen onze resultaten nog steeds vertekend zijn.
Onjuiste modelspecificatie
Modelspecificatie is cruciaal bij het berekenen van propensityscores, omdat een verkeerde specificatie kan leiden tot aanzienlijke vertekeningen in schattingen van behandeleffecten. Onderzoekers maken vaak fouten door het model te overfitten (te veel covariaten opnemen) of door belangrijke confounders weg te laten.
Het balanceren van de kenmerken van behandel- en controlegroepen helpt bias te minimaliseren en betrouwbaardere schattingen van behandeleffecten te geven. Maar zoals bij elke statistische methode moeten ze zorgvuldig worden toegepast, met oog voor potentiële beperkingen en fouten.
Tot slot
Hopelijk waardeer je propensityscores, een belangrijke methode om bias in observationele studies te minimaliseren doordat ze behandel- en controlegroepen goed balanceren op basis van hun respectieve kenmerken. Technieken zoals matching, stratificatie en weging helpen om nauwkeurigere causale conclusies te trekken door confounders aan te pakken.
Als volgende stap kun je je inschrijven voor onze Statistician in R-carrièreroute. Het volledige traject behandelt alles van regressie tot hypothesetoetsing, van factoranalyse tot bootstrapping. Ook als je geen statisticus wilt worden, is de cursus een geweldige bron met veel leerstof om je een sterke analist of data scientist te maken.


Grondig onderzoek doen is complex en vereist zorgvuldige planning, inclusief hoe deelnemers worden toegewezen aan behandelgroepen die de behandeling (ofwel de interventie) krijgen, versus controlegroepen waar dat niet gebeurt.
Een veelgebruikte aanpak is het willekeurig toewijzen van deelnemers aan een van beide groepen om bias te minimaliseren. Deze randomisatie helpt om verschillen in uitkomsten toe te schrijven aan de behandeling, en niet aan andere variabelen. Randomisatie is echter niet altijd mogelijk vanwege ethische, praktische of logistieke beperkingen. In zulke gevallen grijpen onderzoekers naar alternatieven, zoals observationele studies, omdat die uitgaan van wat er van nature in de echte wereld gebeurt. Hoewel waardevol, kunnen deze onderzoeksopzetten leiden tot selectiebias, die de uitkomsten van de studie beïnvloedt.
Om het probleem van selectiebias aan te pakken, gebruiken onderzoekers vaak propensityscores—en dat is de focus van deze post. Als je klaar bent, hoop ik dat je onze cursussen volgt om een sterke basis in causaal denken op te bouwen. Begin met Foundations of Inference in Python om kernprincipes zoals steekproefverdelingen te begrijpen. Ga vervolgens door met Intermediate Regression in Python voor praktische ervaring met modelleren (dit is een essentiële vaardigheid voor het schatten van causale effecten). Inference for Linear Regression in R is een andere prima optie. Laten we beginnen!
Wat is een propensityscore?
We begrijpen dat er situaties zijn waarin randomisatie geen optie is. Bovendien moeten we ook selectiebias aanpakken. Dit is waar een methode, de propensityscore, wordt gebruikt om groepen in observationele studies in evenwicht te brengen. Een propensityscore is de kans dat een deelnemer een bepaalde behandeling krijgt op basis van zijn of haar geobserveerde kenmerken.
Hoe het werkt
Deze methode is in de jaren tachtig ontwikkeld door Rosenbaum en Rubin en wordt veel gebruikt in de gezondheidszorg, sociale wetenschappen en economie. Zo werkt het:
Wat is confounding
Voordat we verder gaan, is het goed om te begrijpen wat confounding betekent. Confounding treedt op wanneer een externe variabele, een confounder, zowel de onafhankelijke variabele (behandeling) als de afhankelijke variabele (uitkomst) beïnvloedt, wat kan leiden tot onjuiste conclusies over de relatie tussen die twee.
Zo is lichamelijke beweging een confounder in een studie die onderzoekt of koffiedrinken (onafhankelijke variabele) samenhangt met hogere productiviteit (afhankelijke variabele). Mensen die meer sporten drinken mogelijk ook meer koffie en zijn productiever, waardoor het lastig is te bepalen of koffie op zichzelf de productiviteit beïnvloedt of dat beweging deels verantwoordelijk is.
In dit geval kan beweging, de confounder, onderzoekers misleiden door ten onrechte een sterkere relatie tussen koffie en productiviteit te suggereren dan er werkelijk is.
Belangrijke methoden voor het gebruik van propensityscores
De vier belangrijkste methoden om propensityscores toe te passen in observationele studies zijn matching, stratificatie, inverse waarschijnlijkheidsweging en covariaataanpassing. Laten we ze elk in detail bespreken.
Propensity score matching
Bij propensity score matching worden deelnemers uit de behandelingsgroep gekoppeld aan deelnemers uit de controlegroep met vergelijkbare propensityscores. Dit koppelproces zorgt ervoor dat de groepen zo gelijk mogelijk zijn, waardoor de kans op bias afneemt. Met andere woorden, individuen met vergelijkbare kansen om de behandeling te krijgen worden gekoppeld om een gebalanceerde steekproef te creëren.
Matching is ideaal wanneer het doel is om direct vergelijkbare groepen te creëren en verschillen in kenmerken zo veel mogelijk te verkleinen. Een middelgrote tot grote steekproef is wenselijk, omdat dat het vinden van goede matches vergemakkelijkt.
In een studie naar de impact van thuiswerken op medewerkerproductiviteit kunnen onderzoekers thuiswerkers (behandeling) matchen met vergelijkbare medewerkers op locatie (controle) op basis van variabelen zoals functierol, aantal jaren ervaring en eerdere prestatiecijfers. Zo kunnen productiviteitsuitkomsten worden vergeleken met minder invloed van achtergrondverschillen.
Stratificatie
Stratificatie is het opdelen van deelnemers in afzonderlijke groepen, ook wel strata, op basis van hun propensityscores. Vaak worden deze groepen opgedeeld in kwintielen, dus vijf gelijke delen. Elk stratum bevat deelnemers met vergelijkbare propensityscores, en binnen elk stratum worden de uitkomsten tussen behandel- en controlegroep vergeleken.
Deze methode is effectief wanneer de steekproef groot genoeg is om meerdere zinvolle strata te creëren, omdat te weinig deelnemers per stratum niet tot effectieve vergelijkingen leidt.
Om de effectiviteit van een nieuw medicijn te beoordelen in een zorgstudie, kunnen patiënten in kwintielen worden gestratificeerd op basis van propensityscores berekend uit demografie en uitgangsgezondheid. Elk stratum kan patiënten met vergelijkbare kenmerken bevatten, wat leidt tot nauwkeurigere vergelijkingen van behandeleffecten binnen elke groep.
Inverse probability of treatment weighting (IPTW)
IPW kent gewichten toe op basis van propensityscores om bepaalde observaties meer "gewicht" te geven bij het schatten van behandeleffecten. Deelnemers met een lagere waarschijnlijkheid om in hun respectieve groep te zitten, krijgen meer gewicht om verschillen in groepskenmerken te balanceren.
Omdat het proportioneel gebruikmaakt van gegevens uit beide groepen, heeft IPW de voorkeur wanneer onderzoekers bevindingen willen generaliseren naar de gehele steekproefpopulatie.
In een publieke gezondheidsstudie naar een gemeenschapsinterventie kan IPW worden toegepast om rekening te houden met demografische en sociaaleconomische verschillen tussen gemeenschappen die de interventie wel en niet kregen. Zo ontstaan generaliseerbare bevindingen zonder matched pairs te maken. De stappen zijn:
1. Bereken de propensityscore
2. Bereken gewichten
Vervolgens berekenen we gewichten op basis van het inverse van de propensityscore, zoals hieronder getoond:
In ons voorbeeld, voor de persoon met een propensityscore van 0,8:
3. Pas gewichten toe
Pas deze gewichten nu toe op ieder individu in de studie om een "pseudo-populatie" te creëren waarin de invloed van elk individu op de analyse wordt aangepast door zijn of haar gewicht. Deze pseudo-populatie brengt de uitgangskenmerken in balans tussen de behandel- en controlegroepen. In de resulterende pseudo-populatie is de kans dat iemand in de behandel- of controlegroep zit onafhankelijk van zijn of haar uitgangskenmerken, waardoor confounding afneemt.
Terzijde: IPTW kan worden gebruikt om een groot aantal confounders aan te pakken. Het kan ook worden toegepast op longitudinale studies om te corrigeren voor tijdsafhankelijke confounding.
Andere belangrijke aandachtspunten bij IPTW zijn onder meer:
Covariaataanpassing
Bij covariaataanpassing gebruiken we de propensityscores als een extra covariaat in een regressiemodel om voor confounders te corrigeren. Deze aanpassing verbetert de schatting van het behandeleffect door binnen het statistische model te corrigeren voor propensityscores, en zo rekening te houden met confounding.
Bijvoorbeeld: bij het bestuderen van het effect van een werkplek-trainingsprogramma op prestaties van medewerkers kunnen onderzoekers propensityscores als covariaten in een regressiemodel gebruiken om te corrigeren voor factoren zoals leeftijd of aantal jaren ervaring.
Voordelen van het gebruik van propensityscores
Tot nu toe hebben we verschillende onderzoeksopzetten besproken, waaronder randomisatie en observationeel onderzoek (waar randomisatie niet haalbaar is). In het geval van observationele studies bespraken we het belang van propensityscores en de vier methoden. Nu bespreken we de voordelen van het gebruik van propensityscores.
Verbetert covariaatbalans
Propensityscores zorgen voor een meer evenwichtige vergelijking tussen de behandel- en controlegroep door covariaten, of achtergrondkenmerken, tussen groepen gelijk te trekken. Zo kunnen onderzoekers eerlijker vergelijken met vergelijkbare verdelingen van sleutelvariabelen (zoals leeftijd, sociaaleconomische status of gezondheidscondities), wat leidt tot een nauwkeuriger schatting van het behandeleffect.
Bij het bestuderen van de impact van online leren op studieresultaten kan propensity score matching het eerdere academische niveau, internettoegang en motivatieniveau van studenten in balans brengen tussen online en traditioneel onderwijs. Zo is de kans groter dat verschillen in uitkomsten te wijten zijn aan de leermethode en niet aan verschillen in studentenachtergrond.
Vermindert bias
Propensityscores corrigeren voor verschillen in geobserveerde kenmerken en verminderen zo de bias in analyses. Dit is vooral waardevol in niet-gerandomiseerde studies, waar onderzoekers de behandeltoewijzing niet kunnen controleren.
Veelzijdigheid
Propensityscores zijn flexibel en kunnen worden gebruikt bij zowel binaire behandelingen (bijv. ja/nee-vragen over of iemand een behandeling kreeg) als continue behandelingen (bijv. hoeveel van een behandeling iemand kreeg).
Beperkingen van propensityscores
Hoewel propensityscores krachtig zijn, is het ook belangrijk hun beperkingen te overwegen, zoals:
Afhankelijkheid van geobserveerde covariaten
Propensityscores kunnen alleen corrigeren voor geobserveerde covariaten, dus de variabelen die onderzoekers hebben gemeten en in het model hebben opgenomen. Dat houdt geen rekening met verborgen confounders die onopgemerkt of ongemeten blijven. Onvermijdelijk blijven verborgen biases zo onopgelost die de uitkomst alsnog kunnen beïnvloeden.
Bijvoorbeeld: bij het vergelijken van de effecten van twee therapievormen op mentale gezondheidsuitkomsten hebben onderzoekers mogelijk data over leeftijd, geslacht en uitgangsgezondheid. Maar als niet-gemeten factoren zoals sociale steun of individuele copingmechanismen buiten beschouwing blijven, kunnen die alsnog therapie-uitkomsten beïnvloeden.
Vereist grote steekproeven
Methoden met propensityscores werken het best met grote datasets, zodat er voldoende overlap is tussen de behandel- en controlegroep. Kleinere steekproeven leiden vaak tot te weinig deelnemers met vergelijkbare propensityscores over groepen heen, wat het lastig maakt om goede matches of betekenisvolle weging te bereiken.
Misspecificatie van het propensitymodel
Het selecteren van de juiste variabelen en functionele vorm van het model is cruciaal om het propensitymodel correct te specificeren, wat de nauwkeurigheid beïnvloedt. Het niet opnemen van relevante variabelen of een ongeschikte modelspecificatie kan leiden tot vertekende schattingen, en het lastige is dat dit soort fouten vaak moeilijk te detecteren zijn.
Geavanceerde technieken: dubbeltrobuste en Bayesiaanse benaderingen
Er zijn geavanceerde technieken ontwikkeld om enkele beperkingen van traditionele propensityscore-methoden aan te pakken.
Dubbeltrobuste methoden
Dubbeltrobuste methoden zijn een tweestapsbenadering, waarbij onderzoekers eerst propensityscores schatten en deelnemers overeenkomstig matchen of wegen. Vervolgens passen ze een regressiemodel toe om de uitkomst te voorspellen op basis van de behandeling en andere covariaten. De uiteindelijke schatting van het behandeleffect wordt verkregen door zowel voor de propensityscore als voor het regressiemodel te corrigeren.
Bayesiaanse propensityscores
In Bayesiaanse methoden wordt onzekerheid meegenomen in de schatting van propensityscores. Dit maakt nauwkeurigere schattingen mogelijk, vooral in situaties met kleinere steekproeven of grotere onzekerheid over de data. Als je geïnteresseerd bent in Bayesiaanse benaderingen, die alleen maar gebruikelijker worden, volg dan onze Fundamentals of Bayesian Data Analysis in R.
Veelvoorkomende fouten in propensityscore-analyse
Bij het gebruik van propensityscores zijn er veelgemaakte fouten die je moet vermijden.
Onvoldoende covariaatbalans
Na het toepassen van propensityscore-methoden is het belangrijk te controleren of de covariaten in balans zijn tussen de behandel- en controlegroepen. Zonder voldoende balans kunnen onze resultaten nog steeds vertekend zijn.
Onjuiste modelspecificatie
Modelspecificatie is cruciaal bij het berekenen van propensityscores, omdat een verkeerde specificatie kan leiden tot aanzienlijke vertekeningen in schattingen van behandeleffecten. Onderzoekers maken vaak fouten door het model te overfitten (te veel covariaten opnemen) of door belangrijke confounders weg te laten.
Het balanceren van de kenmerken van behandel- en controlegroepen helpt bias te minimaliseren en betrouwbaardere schattingen van behandeleffecten te geven. Maar zoals bij elke statistische methode moeten ze zorgvuldig worden toegepast, met oog voor potentiële beperkingen en fouten.
Tot slot
Hopelijk waardeer je propensityscores, een belangrijke methode om bias in observationele studies te minimaliseren doordat ze behandel- en controlegroepen goed balanceren op basis van hun respectieve kenmerken. Technieken zoals matching, stratificatie en weging helpen om nauwkeurigere causale conclusies te trekken door confounders aan te pakken.
Als volgende stap kun je je inschrijven voor onze Statistician in R-carrièreroute. Het volledige traject behandelt alles van regressie tot hypothesetoetsing, van factoranalyse tot bootstrapping. Ook als je geen statisticus wilt worden, is de cursus een geweldige bron met veel leerstof om je een sterke analist of data scientist te maken.