Kapsamlı araştırma yürütmek karmaşıktır ve dikkatli planlama gerektirir; buna, katılımcıların tedavi (diğer bir deyişle müdahale) içeren gruplara karşı, içermeyen kontrol gruplarına nasıl atandığı da dahildir.
Böyle bir yaklaşım, yanlılığı en aza indirmek için katılımcıları rastgele olarak iki gruptan birine atamaktır. Bu rastgele atama, sonuçlardaki farklılıkların diğer değişkenler yerine tedaviye atfedilmesine yardımcı olur. Ancak etik, pratik ya da lojistik sınırlamalar nedeniyle rastgele atama her zaman mümkün değildir. Böyle durumlarda araştırmacılar, gerçek dünyada doğal olarak gerçekleşeni gözlemlemeye dayanan gözlemsel çalışmalar gibi alternatiflere başvurur. Değerli olmakla birlikte, bu araştırma tasarımları seçim yanlılığına yol açabilir ve çalışmanın sonuçlarını etkileyebilir.
Seçim yanlılığı sorununu ele almak için araştırmacılar sıklıkla eğilim skorlarını kullanır—ve bu yazının odağı da budur. Bitirdiğinizde, nedensel düşünmede güçlü bir temel oluşturmak için kurslarımıza katılmanızı umuyorum. Örnekleme dağılımları gibi temel ilkeleri anlamak için Foundations of Inference in Python ile başlayın. Ardından, modelleme konusunda uygulamalı deneyim için Intermediate Regression in Python kursuna geçin (nedensel etkileri tahmin etmek için temel bir beceridir). Inference for Linear Regression in R da harika bir seçenektir. Şimdi başlayalım!
Eğilim Skoru Nedir?
Rastgele atamanın bir seçenek olmadığı durumlar olduğunu biliyoruz. Buna ek olarak, seçim yanlılığını da ele almamız gerekir. İşte burada, gözlemsel çalışmalarda grupları dengelemek için eğilim skoru adı verilen bir yöntem devreye girer. Eğilim skoru, bir katılımcının gözlemlenen özelliklerine dayanarak belirli bir tedaviyi alma olasılığıdır.
Nasıl çalışır
Bu yöntem 1980'lerde Rosenbaum ve Rubin tarafından geliştirilmiştir ve sağlık, sosyal bilimler ve ekonomi alanlarında yaygın olarak kullanılmaktadır. İşte nasıl çalıştığı:
- Araştırmacılar, katılımcının tedaviyi alıp almamasını etkileyebilecek çeşitli özelliklere (örn. yaş, eğitim, gelir) ilişkin verileri toplar. Daha sonra, bu özelliklere dayanarak her katılımcının tedavi grubuna atanma olasılığını gösteren bir eğilim skoru hesaplanır.
- Artık araştırmacılar, tedavi ve kontrol grupları arasında benzer eğilim skorlarına sahip katılımcıları eşleştirebilir veya ağırlıklandırma yöntemleri uygulayabilir. Bu süreç, başlangıç özellikleri açısından daha karşılaştırılabilir gruplar oluşturur.
- Böyle dengelenmiş gruplar, aksi halde sonuçları çarpıtabilecek karıştırıcı faktörleri kontrol ederken tedavinin etkisini daha doğru biçimde değerlendirmeyi kolaylaştırır.
Karıştırıcılık (confounding) nedir
İlerlemeye devam etmeden önce, karıştırıcılığın ne anlama geldiğini anlayalım. Karıştırıcılık, karıştırıcı değişken ya da karıştırıcı (confounder) olarak bilinen dış bir değişkenin hem bağımsız değişkeni (tedavi) hem de bağımlı değişkeni (sonuç) etkilemesiyle ortaya çıkar; bu da aralarındaki ilişki hakkında yanlış sonuçlara yol açabilir.
Örneğin, kahve içmenin (bağımsız değişken) daha yüksek üretkenlikle (bağımlı değişken) ilişkili olup olmadığını inceleyen bir çalışmada fiziksel egzersiz bir karıştırıcıdır. Çünkü daha fazla egzersiz yapan kişiler daha fazla kahve içebilir ve daha yüksek üretkenliğe sahip olabilir; bu da yalnızca kahvenin mi üretkenliği etkilediğini yoksa egzersizin de kısmen sorumlu olup olmadığını söylemeyi zorlaştırır.
Bu durumda, karıştırıcı faktör olan egzersiz, kahve ve üretkenlik arasındaki ilişkinin gerçekte olduğundan daha güçlü olduğunu yanlış bir şekilde düşündürerek araştırmacıları yanıltabilir.
Eğilim Skorlarını Kullanmanın Temel Yöntemleri
Gözlemsel çalışmalarda eğilim skorlarını uygulamanın dört temel yöntemi eşleştirme, tabakalama, ters olasılık ağırlıklandırması ve ortak değişken ayarlamasıdır. Her birini ayrıntılı olarak ele alalım.
Eğilim skoruyla eşleştirme
Eğilim skoruyla eşleştirme, tedavi grubundaki katılımcıları, benzer eğilim skorlarına sahip kontrol grubundaki katılımcılarla eşler. Bu eşleştirme süreci, grupların mümkün olduğunca benzer olmasını gözeterek yanlılık olasılığını azaltır. Başka bir deyişle, tedaviyi alma olasılıkları karşılaştırılabilir olan bireyler, dengeli bir örneklem oluşturmak üzere eşleştirilir.
Amaç doğrudan karşılaştırılabilir gruplar oluşturmak ve özellik farklılıklarını olabildiğince azaltmak olduğunda eşleştirme idealdir. İyi eşleşmeler bulmayı kolaylaştırdığından, orta ila büyük bir örneklem büyüklüğü tercih edilir.
Uzaktan çalışmanın çalışan üretkenliği üzerindeki etkisini değerlendiren bir çalışmada, araştırmacılar uzaktan çalışanları (tedavi) iş rolü, kıdem yılı ve önceki performans metrikleri gibi değişkenlere göre benzer ofiste çalışanlarla (kontrol) eşleştirebilir. Bu, arka plan farklılıklarının etkisini azaltırken üretkenlik sonuçlarının karşılaştırılmasına olanak tanır.
Tabakalama
Tabakalama, katılımcıların eğilim skorlarına göre tabaka adı verilen ayrı gruplara ayrılmasıdır. Çoğu zaman bu gruplar beş eşit parçaya, yani beşlik dilimlere ayrılır. Her tabaka, benzer eğilim skorlarına sahip katılımcıları içerir ve her tabaka içinde tedavi ve kontrol grupları arasındaki sonuçlar karşılaştırılır.
Bu yöntem, anlamlı sayıda tabaka oluşturmak için örneklem büyüklüğünün yeterince büyük olduğu durumlarda etkilidir; zira tabaka başına daha az katılımcı, etkili karşılaştırmalara yol açmayabilir.
Bir sağlık çalışmasının parçası olarak yeni bir ilacın etkinliğini değerlendirmek için hastalar, demografik bilgiler ve başlangıç sağlık durumlarından hesaplanan eğilim skorlarına göre beşlik dilimlere ayrılabilir. Her tabaka benzer özelliklere sahip hastaları içererek her grup içinde daha doğru tedavi etkisi karşılaştırmalarına yol açar.
Tedavinin ters olasılığıyla ağırlıklandırma (IPTW)
IPW, tedavi etkilerini tahmin ederken bazı gözlemlere daha fazla "önem" vermek için eğilim skorlarına dayalı ağırlıklar atar. Kendi gruplarında yer alma olasılığı daha düşük olan katılımcılara, grup özelliklerindeki farklılıkları dengelemek için daha yüksek ağırlık verilir.
Her iki gruptan verileri orantılı olarak kullandığı için, IPW bulguların tüm örneklem popülasyonuna genelleştirilmesi gerektiğinde tercih edilir.
Bir toplum sağlığı müdahalesini değerlendiren halk sağlığı çalışmasında, müdahale alan ve almayan topluluklar arasındaki demografik ve sosyoekonomik farklılıkları hesaba katmak için IPW uygulanabilir. Bu, eşleştirilmiş çiftler oluşturmadan genellenebilir bulgular sağlar. Adımlar şunlardır:
1. Eğilim skorunu hesaplayın
- Öncelikle, çalışmadaki her birey için, başlangıç özelliklerine dayanarak tedavi grubunda yer alma olasılığını temsil eden eğilim skorunu tahmin edin.
- Lojistik regresyon modeline göre, bir katılımcının tedavi alma eğilim skoru 0,8, yani %80'dir
2. Ağırlıkları hesaplayın
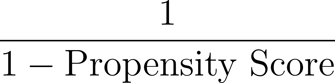
Sonra, aşağıda gösterildiği gibi eğilim skorunun tersi üzerinden ağırlıkları hesaplarız:
- Tedavi grubundaki (müdahale alan) bireyler için ağırlık şudur:
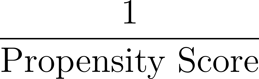
- Kontrol grubundaki (müdahale almayan) bireyler için ağırlık şudur:
Örneğimizde, eğilim skoru 0,8 olan birey için:
- Tedavi grubundaysa ağırlığı şöyle olur:
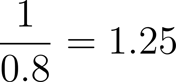
- Kontrol grubundaysa ağırlığı şöyle olur:
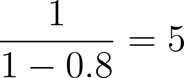
3. Ağırlıkları uygulayın
Şimdi, bu ağırlıkları çalışmadaki her bireye uygulayarak, her bireyin analiz üzerindeki etkisinin ağırlığıyla ayarlandığı bir "sözde-popülasyon" oluşturun. Bu sözde-popülasyon, tedavi ve kontrol grupları arasında başlangıç özelliklerini dengeler. Ortaya çıkan sözde-popülasyonda, bir bireyin tedavi ya da kontrol grubunda yer alma olasılığı başlangıç özelliklerinden bağımsızdır ve bu da karıştırıcılığı azaltır.
Not olarak, IPTW çok sayıda karıştırıcı değişkeni ele almak için kullanılabilir. Zaman bağımlı karıştırıcılığı hesaba katmak üzere boylamsal çalışmalara da uygulanabilir.
IPTW kullanırken diğer bazı önemli hususlar şunlardır:
- Ağırlıklandırma öncesi ve sonrası tüm başlangıç özellikleri için maruz kalan ve kalmayan gruplar arasındaki dengenin değerlendirilmesi
- Aşırı ağırlıkların ağırlık istikrarlaştırma veya kırpma (truncation) yoluyla ele alınması
Ortak değişken ayarlaması
Ortak değişken ayarlamasında, karıştırıcı faktörleri kontrol etmek için eğilim skorlarını bir regresyon modelinde ek bir ortak değişken olarak kullanırız. Bu ayarlama, istatistiksel model içinde eğilim skorlarına göre düzeltme yaparak tedavi etkisi tahminini iyileştirir ve böylece karıştırıcılığı hesaba katar.
Örneğin, bir işyeri eğitim programının çalışan performansı üzerindeki etkisi incelenirken, araştırmacılar yaş ya da kıdem yılı gibi faktörleri ayarlamak için eğilim skorlarını regresyon modelinde ortak değişken olarak kullanabilir.
Eğilim Skorlarını Kullanmanın Avantajları
Şimdiye kadar rastgeleleştirme ve gözlemsel araştırma yöntemleri (rastgeleleştirmenin mümkün olmadığı yerler) dahil farklı araştırma tasarımlarını tartıştık. Gözlemsel çalışmalarda eğilim skorlarının ve dört yönteminin önemini ele aldık. Şimdi, eğilim skorlarını kullanmanın avantajlarını tartışalım.
Ortak değişken dengesini iyileştirir
Eğilim skorları, ortak değişkenleri ya da arka plan özelliklerini gruplar arasında eşitleyerek tedavi ve kontrol grupları arasında daha dengeli bir karşılaştırma sağlar. Bu, yaş, sosyoekonomik durum veya sağlık koşulları gibi kilit değişkenlerin benzer dağılımlarıyla daha adil bir karşılaştırma yapmaya olanak tanır ve tedavi etkisinin doğru tahmin edilmesine yol açar.
Çevrimiçi öğrenmenin öğrenci çıktıları üzerindeki etkisi incelenirken, eğilim skoruyla eşleştirme; çevrimiçi ve geleneksel öğrenme grupları arasında öğrencilerin önceki akademik performansını, internet erişimini ve motivasyon düzeylerini dengeleyebilir. Bu, sonuçlardaki farklılıkların öğrenci arka planlarındaki farklılıklardan ziyade öğrenme yönteminden kaynaklanma olasılığını artırır.
Yanlılığı azaltır
Eğilim skorları, gözlemlenen özelliklerdeki farklılıkları ayarlayarak analizlerdeki yanlılığı azaltır. Bu, araştırmacıların tedavi atamasını kontrol edemediği rastgeleleştirilmemiş çalışmalarda özellikle değerlidir.
Çok yönlülük
Eğilim skorları esnektir ve hem ikili tedavilerde (örn. birinin tedavi alıp almadığına dair evet/hayır soruları) hem de sürekli tedavilerde (örn. birinin ne kadar tedavi aldığı) kullanılabilir.
Eğilim Skorlarının Sınırlamaları
Eğilim skorları güçlü olmakla birlikte, şu tür sınırlamalarını da dikkate almak önemlidir:
Gözlemlenen ortak değişkenlere bağımlılık
Eğilim skorları yalnızca gözlemlenen ortak değişkenler için ayarlama yapabilir; yani araştırmacıların ölçtüğü ve modele dahil ettiği değişkenler için. Ancak bu, gözlemlenmeyen ya da ölçülmeyen gizli karıştırıcıları mutlaka hesaba katmaz. Kaçınılmaz olarak, sonucu hâlâ etkileyebilecek gizli yanlılıkları ele alınmamış bırakır.
Örneğin, iki terapi türünün ruh sağlığı sonuçları üzerindeki etkilerini karşılaştırırken, araştırmacıların hastaların yaşı, cinsiyeti ve başlangıç sağlığına ilişkin verileri olabilir. Ancak sosyal destek veya bireysel başa çıkma mekanizmaları gibi ölçülmeyen faktörler göz ardı edilirse, yine de terapi sonuçlarını etkileyebilirler.
Büyük örneklem büyüklükleri gerektirir
Eğilim skoru yöntemleri, tedavi ve kontrol grupları arasında yeterli örtüşme olmasını sağlamak için büyük veri kümeleriyle en iyi şekilde çalışır. Daha küçük örneklemler, gruplar arasında benzer eğilim skorlarına sahip yeterli katılımcı olmaması sorununa sıkça yol açar; bu da iyi eşleşmeler elde etmeyi veya anlamlı ağırlıklandırma yapmayı zorlaştırır.
Eğilim modeli belirtiminin hatalı olması
Doğru değişken seçimi ve modelin fonksiyonel biçimi, eğilim modelinin doğruluğunu doğrudan etkilediğinden kritik öneme sahiptir. İlgili değişkenleri modele dahil etmemek veya uygunsuz model belirtimi önyargılı tahminlere yol açabilir; dahası bu tür sorunlar çoğu zaman tespit edilmesi zor olur.
İleri Teknikler: Çifte Sağlam ve Bayesçi Yaklaşımlar
Geleneksel eğilim skoru yöntemlerinin bazı sınırlamalarını gidermek için gelişmiş teknikler geliştirilmiştir.
Çifte sağlam yöntemler
Çifte sağlam yöntemler iki aşamalı bir yaklaşımdır: Araştırmacılar önce eğilim skorlarını tahmin eder ve buna göre katılımcıları eşleştirir ya da ağırlıklandırır. Ardından, sonucu tedavi ve diğer ortak değişkenlere göre tahmin etmek için bir regresyon modeli kurarlar. Nihai tedavi etkisi tahmini, hem eğilim skoru hem de regresyon modeli için yapılan düzeltmelerle elde edilir.
Bayesçi eğilim skorları
Bayesçi yöntemlerde, eğilim skorlarının tahminine belirsizlik dahil edilir. Bu, özellikle daha küçük örneklem büyüklüklerinde ya da veriye ilişkin belirsizliğin yüksek olduğu durumlarda daha doğru tahminler yapmamıza olanak tanır. Eğer giderek daha yaygın hale gelen Bayesçi yaklaşımlar ilginizi çekiyorsa, Fundamentals of Bayesian Data Analysis in R kursumuzu alın.
Eğilim Skoru Analizinde Yaygın Hatalar
Eğilim skorlarını kullanırken kaçınılması gereken yaygın hatalar vardır.
Yetersiz ortak değişken dengesi
Eğilim skoru yöntemleri uygulandıktan sonra, ortak değişkenlerin tedavi ve kontrol grupları arasında dengeli olup olmadığını kontrol etmek önemlidir. Yeterli denge olmadan sonuçlarımız hâlâ önyargılı olabilir.
Yanlış model belirtimi
Eğilim skorları hesaplanırken model belirtimi kritiktir; hatalı belirtim, tedavi etkisi tahminlerinde önemli önyargılara yol açabilir. Araştırmacılar çoğu zaman modeli aşırı uyumlayarak (çok fazla ortak değişken ekleyerek) ya da önemli karıştırıcıları dışarıda bırakarak hata yapar.
Tedavi ve kontrol gruplarının özelliklerini dengelemek, yanlılığı en aza indirmemize ve tedavi etkilerine dair daha güvenilir tahminler sunmamıza yardımcı olur. Ancak, her istatistiksel yöntem gibi, potansiyel sınırlamalara ve hatalara dikkat ederek dikkatli uygulanmaları gerekir.
Son Düşünceler
Gözlemsel çalışmalarda yanlılığı en aza indirmek için önemli bir yöntem olan eğilim skorlarının, tedavi ve kontrol gruplarını kendi özelliklerine göre iyi bir şekilde dengelediğini umarım takdir edersiniz. Eşleştirme, tabakalama ve ağırlıklandırma gibi teknikler, karıştırıcı faktörleri ele alarak daha doğru nedensel çıkarımlar yapılmasını sağlar.
Bir sonraki adım olarak, Statistician in R kariyer yolumuza kaydolun. Tüm yol, regresyondan hipotez testine, faktör analizinden yeniden örneklemeye kadar her şeyi kapsar. İstatistikçi olmayı planlamıyor olsanız bile, bu yol sizi harika bir analist ya da veri bilimci yapacak çok sayıda öğrenme içeriğine sahip mükemmel bir kaynaktır.






Kapsamlı araştırma yürütmek karmaşıktır ve dikkatli planlama gerektirir; buna, katılımcıların tedavi (diğer bir deyişle müdahale) içeren gruplara karşı, içermeyen kontrol gruplarına nasıl atandığı da dahildir.
Böyle bir yaklaşım, yanlılığı en aza indirmek için katılımcıları rastgele olarak iki gruptan birine atamaktır. Bu rastgele atama, sonuçlardaki farklılıkların diğer değişkenler yerine tedaviye atfedilmesine yardımcı olur. Ancak etik, pratik ya da lojistik sınırlamalar nedeniyle rastgele atama her zaman mümkün değildir. Böyle durumlarda araştırmacılar, gerçek dünyada doğal olarak gerçekleşeni gözlemlemeye dayanan gözlemsel çalışmalar gibi alternatiflere başvurur. Değerli olmakla birlikte, bu araştırma tasarımları seçim yanlılığına yol açabilir ve çalışmanın sonuçlarını etkileyebilir.
Seçim yanlılığı sorununu ele almak için araştırmacılar sıklıkla eğilim skorlarını kullanır—ve bu yazının odağı da budur. Bitirdiğinizde, nedensel düşünmede güçlü bir temel oluşturmak için kurslarımıza katılmanızı umuyorum. Örnekleme dağılımları gibi temel ilkeleri anlamak için Foundations of Inference in Python ile başlayın. Ardından, modelleme konusunda uygulamalı deneyim için Intermediate Regression in Python kursuna geçin (nedensel etkileri tahmin etmek için temel bir beceridir). Inference for Linear Regression in R da harika bir seçenektir. Şimdi başlayalım!
Eğilim Skoru Nedir?
Rastgele atamanın bir seçenek olmadığı durumlar olduğunu biliyoruz. Buna ek olarak, seçim yanlılığını da ele almamız gerekir. İşte burada, gözlemsel çalışmalarda grupları dengelemek için eğilim skoru adı verilen bir yöntem devreye girer. Eğilim skoru, bir katılımcının gözlemlenen özelliklerine dayanarak belirli bir tedaviyi alma olasılığıdır.
Nasıl çalışır
Bu yöntem 1980'lerde Rosenbaum ve Rubin tarafından geliştirilmiştir ve sağlık, sosyal bilimler ve ekonomi alanlarında yaygın olarak kullanılmaktadır. İşte nasıl çalıştığı:
Karıştırıcılık (confounding) nedir
İlerlemeye devam etmeden önce, karıştırıcılığın ne anlama geldiğini anlayalım. Karıştırıcılık, karıştırıcı değişken ya da karıştırıcı (confounder) olarak bilinen dış bir değişkenin hem bağımsız değişkeni (tedavi) hem de bağımlı değişkeni (sonuç) etkilemesiyle ortaya çıkar; bu da aralarındaki ilişki hakkında yanlış sonuçlara yol açabilir.
Örneğin, kahve içmenin (bağımsız değişken) daha yüksek üretkenlikle (bağımlı değişken) ilişkili olup olmadığını inceleyen bir çalışmada fiziksel egzersiz bir karıştırıcıdır. Çünkü daha fazla egzersiz yapan kişiler daha fazla kahve içebilir ve daha yüksek üretkenliğe sahip olabilir; bu da yalnızca kahvenin mi üretkenliği etkilediğini yoksa egzersizin de kısmen sorumlu olup olmadığını söylemeyi zorlaştırır.
Bu durumda, karıştırıcı faktör olan egzersiz, kahve ve üretkenlik arasındaki ilişkinin gerçekte olduğundan daha güçlü olduğunu yanlış bir şekilde düşündürerek araştırmacıları yanıltabilir.
Eğilim Skorlarını Kullanmanın Temel Yöntemleri
Gözlemsel çalışmalarda eğilim skorlarını uygulamanın dört temel yöntemi eşleştirme, tabakalama, ters olasılık ağırlıklandırması ve ortak değişken ayarlamasıdır. Her birini ayrıntılı olarak ele alalım.
Eğilim skoruyla eşleştirme
Eğilim skoruyla eşleştirme, tedavi grubundaki katılımcıları, benzer eğilim skorlarına sahip kontrol grubundaki katılımcılarla eşler. Bu eşleştirme süreci, grupların mümkün olduğunca benzer olmasını gözeterek yanlılık olasılığını azaltır. Başka bir deyişle, tedaviyi alma olasılıkları karşılaştırılabilir olan bireyler, dengeli bir örneklem oluşturmak üzere eşleştirilir.
Amaç doğrudan karşılaştırılabilir gruplar oluşturmak ve özellik farklılıklarını olabildiğince azaltmak olduğunda eşleştirme idealdir. İyi eşleşmeler bulmayı kolaylaştırdığından, orta ila büyük bir örneklem büyüklüğü tercih edilir.
Uzaktan çalışmanın çalışan üretkenliği üzerindeki etkisini değerlendiren bir çalışmada, araştırmacılar uzaktan çalışanları (tedavi) iş rolü, kıdem yılı ve önceki performans metrikleri gibi değişkenlere göre benzer ofiste çalışanlarla (kontrol) eşleştirebilir. Bu, arka plan farklılıklarının etkisini azaltırken üretkenlik sonuçlarının karşılaştırılmasına olanak tanır.
Tabakalama
Tabakalama, katılımcıların eğilim skorlarına göre tabaka adı verilen ayrı gruplara ayrılmasıdır. Çoğu zaman bu gruplar beş eşit parçaya, yani beşlik dilimlere ayrılır. Her tabaka, benzer eğilim skorlarına sahip katılımcıları içerir ve her tabaka içinde tedavi ve kontrol grupları arasındaki sonuçlar karşılaştırılır.
Bu yöntem, anlamlı sayıda tabaka oluşturmak için örneklem büyüklüğünün yeterince büyük olduğu durumlarda etkilidir; zira tabaka başına daha az katılımcı, etkili karşılaştırmalara yol açmayabilir.
Bir sağlık çalışmasının parçası olarak yeni bir ilacın etkinliğini değerlendirmek için hastalar, demografik bilgiler ve başlangıç sağlık durumlarından hesaplanan eğilim skorlarına göre beşlik dilimlere ayrılabilir. Her tabaka benzer özelliklere sahip hastaları içererek her grup içinde daha doğru tedavi etkisi karşılaştırmalarına yol açar.
Tedavinin ters olasılığıyla ağırlıklandırma (IPTW)
IPW, tedavi etkilerini tahmin ederken bazı gözlemlere daha fazla "önem" vermek için eğilim skorlarına dayalı ağırlıklar atar. Kendi gruplarında yer alma olasılığı daha düşük olan katılımcılara, grup özelliklerindeki farklılıkları dengelemek için daha yüksek ağırlık verilir.
Her iki gruptan verileri orantılı olarak kullandığı için, IPW bulguların tüm örneklem popülasyonuna genelleştirilmesi gerektiğinde tercih edilir.
Bir toplum sağlığı müdahalesini değerlendiren halk sağlığı çalışmasında, müdahale alan ve almayan topluluklar arasındaki demografik ve sosyoekonomik farklılıkları hesaba katmak için IPW uygulanabilir. Bu, eşleştirilmiş çiftler oluşturmadan genellenebilir bulgular sağlar. Adımlar şunlardır:
1. Eğilim skorunu hesaplayın
2. Ağırlıkları hesaplayın
Sonra, aşağıda gösterildiği gibi eğilim skorunun tersi üzerinden ağırlıkları hesaplarız:
Örneğimizde, eğilim skoru 0,8 olan birey için:
3. Ağırlıkları uygulayın
Şimdi, bu ağırlıkları çalışmadaki her bireye uygulayarak, her bireyin analiz üzerindeki etkisinin ağırlığıyla ayarlandığı bir "sözde-popülasyon" oluşturun. Bu sözde-popülasyon, tedavi ve kontrol grupları arasında başlangıç özelliklerini dengeler. Ortaya çıkan sözde-popülasyonda, bir bireyin tedavi ya da kontrol grubunda yer alma olasılığı başlangıç özelliklerinden bağımsızdır ve bu da karıştırıcılığı azaltır.
Not olarak, IPTW çok sayıda karıştırıcı değişkeni ele almak için kullanılabilir. Zaman bağımlı karıştırıcılığı hesaba katmak üzere boylamsal çalışmalara da uygulanabilir.
IPTW kullanırken diğer bazı önemli hususlar şunlardır:
Ortak değişken ayarlaması
Ortak değişken ayarlamasında, karıştırıcı faktörleri kontrol etmek için eğilim skorlarını bir regresyon modelinde ek bir ortak değişken olarak kullanırız. Bu ayarlama, istatistiksel model içinde eğilim skorlarına göre düzeltme yaparak tedavi etkisi tahminini iyileştirir ve böylece karıştırıcılığı hesaba katar.
Örneğin, bir işyeri eğitim programının çalışan performansı üzerindeki etkisi incelenirken, araştırmacılar yaş ya da kıdem yılı gibi faktörleri ayarlamak için eğilim skorlarını regresyon modelinde ortak değişken olarak kullanabilir.
Eğilim Skorlarını Kullanmanın Avantajları
Şimdiye kadar rastgeleleştirme ve gözlemsel araştırma yöntemleri (rastgeleleştirmenin mümkün olmadığı yerler) dahil farklı araştırma tasarımlarını tartıştık. Gözlemsel çalışmalarda eğilim skorlarının ve dört yönteminin önemini ele aldık. Şimdi, eğilim skorlarını kullanmanın avantajlarını tartışalım.
Ortak değişken dengesini iyileştirir
Eğilim skorları, ortak değişkenleri ya da arka plan özelliklerini gruplar arasında eşitleyerek tedavi ve kontrol grupları arasında daha dengeli bir karşılaştırma sağlar. Bu, yaş, sosyoekonomik durum veya sağlık koşulları gibi kilit değişkenlerin benzer dağılımlarıyla daha adil bir karşılaştırma yapmaya olanak tanır ve tedavi etkisinin doğru tahmin edilmesine yol açar.
Çevrimiçi öğrenmenin öğrenci çıktıları üzerindeki etkisi incelenirken, eğilim skoruyla eşleştirme; çevrimiçi ve geleneksel öğrenme grupları arasında öğrencilerin önceki akademik performansını, internet erişimini ve motivasyon düzeylerini dengeleyebilir. Bu, sonuçlardaki farklılıkların öğrenci arka planlarındaki farklılıklardan ziyade öğrenme yönteminden kaynaklanma olasılığını artırır.
Yanlılığı azaltır
Eğilim skorları, gözlemlenen özelliklerdeki farklılıkları ayarlayarak analizlerdeki yanlılığı azaltır. Bu, araştırmacıların tedavi atamasını kontrol edemediği rastgeleleştirilmemiş çalışmalarda özellikle değerlidir.
Çok yönlülük
Eğilim skorları esnektir ve hem ikili tedavilerde (örn. birinin tedavi alıp almadığına dair evet/hayır soruları) hem de sürekli tedavilerde (örn. birinin ne kadar tedavi aldığı) kullanılabilir.
Eğilim Skorlarının Sınırlamaları
Eğilim skorları güçlü olmakla birlikte, şu tür sınırlamalarını da dikkate almak önemlidir:
Gözlemlenen ortak değişkenlere bağımlılık
Eğilim skorları yalnızca gözlemlenen ortak değişkenler için ayarlama yapabilir; yani araştırmacıların ölçtüğü ve modele dahil ettiği değişkenler için. Ancak bu, gözlemlenmeyen ya da ölçülmeyen gizli karıştırıcıları mutlaka hesaba katmaz. Kaçınılmaz olarak, sonucu hâlâ etkileyebilecek gizli yanlılıkları ele alınmamış bırakır.
Örneğin, iki terapi türünün ruh sağlığı sonuçları üzerindeki etkilerini karşılaştırırken, araştırmacıların hastaların yaşı, cinsiyeti ve başlangıç sağlığına ilişkin verileri olabilir. Ancak sosyal destek veya bireysel başa çıkma mekanizmaları gibi ölçülmeyen faktörler göz ardı edilirse, yine de terapi sonuçlarını etkileyebilirler.
Büyük örneklem büyüklükleri gerektirir
Eğilim skoru yöntemleri, tedavi ve kontrol grupları arasında yeterli örtüşme olmasını sağlamak için büyük veri kümeleriyle en iyi şekilde çalışır. Daha küçük örneklemler, gruplar arasında benzer eğilim skorlarına sahip yeterli katılımcı olmaması sorununa sıkça yol açar; bu da iyi eşleşmeler elde etmeyi veya anlamlı ağırlıklandırma yapmayı zorlaştırır.
Eğilim modeli belirtiminin hatalı olması
Doğru değişken seçimi ve modelin fonksiyonel biçimi, eğilim modelinin doğruluğunu doğrudan etkilediğinden kritik öneme sahiptir. İlgili değişkenleri modele dahil etmemek veya uygunsuz model belirtimi önyargılı tahminlere yol açabilir; dahası bu tür sorunlar çoğu zaman tespit edilmesi zor olur.
İleri Teknikler: Çifte Sağlam ve Bayesçi Yaklaşımlar
Geleneksel eğilim skoru yöntemlerinin bazı sınırlamalarını gidermek için gelişmiş teknikler geliştirilmiştir.
Çifte sağlam yöntemler
Çifte sağlam yöntemler iki aşamalı bir yaklaşımdır: Araştırmacılar önce eğilim skorlarını tahmin eder ve buna göre katılımcıları eşleştirir ya da ağırlıklandırır. Ardından, sonucu tedavi ve diğer ortak değişkenlere göre tahmin etmek için bir regresyon modeli kurarlar. Nihai tedavi etkisi tahmini, hem eğilim skoru hem de regresyon modeli için yapılan düzeltmelerle elde edilir.
Bayesçi eğilim skorları
Bayesçi yöntemlerde, eğilim skorlarının tahminine belirsizlik dahil edilir. Bu, özellikle daha küçük örneklem büyüklüklerinde ya da veriye ilişkin belirsizliğin yüksek olduğu durumlarda daha doğru tahminler yapmamıza olanak tanır. Eğer giderek daha yaygın hale gelen Bayesçi yaklaşımlar ilginizi çekiyorsa, Fundamentals of Bayesian Data Analysis in R kursumuzu alın.
Eğilim Skoru Analizinde Yaygın Hatalar
Eğilim skorlarını kullanırken kaçınılması gereken yaygın hatalar vardır.
Yetersiz ortak değişken dengesi
Eğilim skoru yöntemleri uygulandıktan sonra, ortak değişkenlerin tedavi ve kontrol grupları arasında dengeli olup olmadığını kontrol etmek önemlidir. Yeterli denge olmadan sonuçlarımız hâlâ önyargılı olabilir.
Yanlış model belirtimi
Eğilim skorları hesaplanırken model belirtimi kritiktir; hatalı belirtim, tedavi etkisi tahminlerinde önemli önyargılara yol açabilir. Araştırmacılar çoğu zaman modeli aşırı uyumlayarak (çok fazla ortak değişken ekleyerek) ya da önemli karıştırıcıları dışarıda bırakarak hata yapar.
Tedavi ve kontrol gruplarının özelliklerini dengelemek, yanlılığı en aza indirmemize ve tedavi etkilerine dair daha güvenilir tahminler sunmamıza yardımcı olur. Ancak, her istatistiksel yöntem gibi, potansiyel sınırlamalara ve hatalara dikkat ederek dikkatli uygulanmaları gerekir.
Son Düşünceler
Gözlemsel çalışmalarda yanlılığı en aza indirmek için önemli bir yöntem olan eğilim skorlarının, tedavi ve kontrol gruplarını kendi özelliklerine göre iyi bir şekilde dengelediğini umarım takdir edersiniz. Eşleştirme, tabakalama ve ağırlıklandırma gibi teknikler, karıştırıcı faktörleri ele alarak daha doğru nedensel çıkarımlar yapılmasını sağlar.
Bir sonraki adım olarak, Statistician in R kariyer yolumuza kaydolun. Tüm yol, regresyondan hipotez testine, faktör analizinden yeniden örneklemeye kadar her şeyi kapsar. İstatistikçi olmayı planlamıyor olsanız bile, bu yol sizi harika bir analist ya da veri bilimci yapacak çok sayıda öğrenme içeriğine sahip mükemmel bir kaynaktır.